
Nota del autor: análisis del mecanismo Claude Dreaming que Anthropic reveló en su blog de ingeniería. El artículo cubre la estructura de memoria de 4 capas, los datos experimentales de CL-Bench y Wiki, los casos de corrección de errores y los riesgos de ingeniería. También explica cómo los desarrolladores pueden adoptar la idea de «ordenar la memoria entre sesiones» para montar su propio sistema de memoria para Agents.
El 6 de noviembre de 2026, Anthropic publicó en su blog de ingeniería el artículo The components of agent memory. Es la primera vez que se explica de forma sistemática cómo Claude Dreaming corrige errores, ordena la memoria y construye una base de conocimiento entre sesiones. La cuenta oficial de X publicó el artículo a la vez, y la documentación de Claude Managed Agents ya incluye una interfaz en vista previa de investigación para Dreams.
Esto no es otro concepto de «ponerle una base de datos vectorial a tu Agent». Anthropic muestra con varios grupos de experimentos que a un Agent de larga duración no le basta con guardar el historial. También necesita verificar, corregir, integrar y organizar la memoria de forma continua para que la información antigua ayude de verdad en la siguiente tarea.
Valor principal: al terminar este artículo conocerás la estructura de memoria de 4 capas de Claude Dreaming y los datos clave de sus experimentos. También sabrás cuándo funciona y cuándo resulta perjudicial, y cómo aprovechar la idea en tu propio Agent.
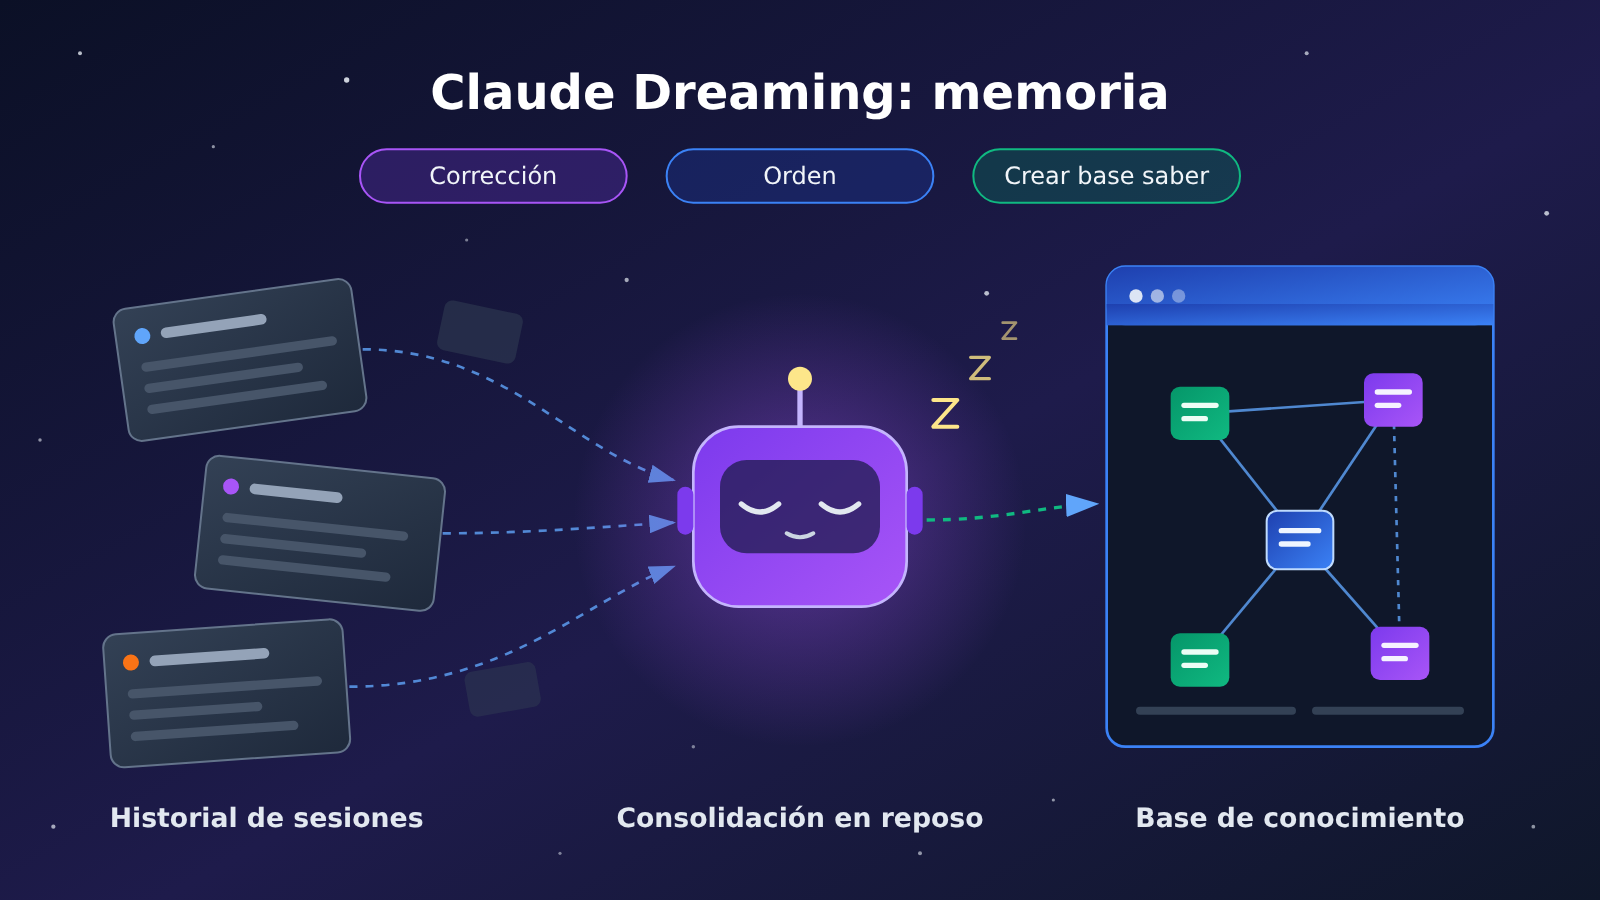
Claude Dreaming: resumen de la información clave
| Elemento | Detalle |
|---|---|
| Fecha de publicación | 2026-11-06, blog de Anthropic Engineering |
| Concepto central | Dreaming: un proceso en segundo plano que, entre sesiones, usa el historial para reorganizar y mantener la memoria |
| Capas de memoria | 4 capas: Transcripts, Memory notes, Memory representations e Injected context |
| Forma del producto | Dreams en Claude Managed Agents, actualmente en Research Preview; hay que solicitar acceso |
| Material complementario | Cookbook oficial «Dreaming with a dynamic workflow», publicado el 2026-11-02 |
| Alcance del impacto | Agentes de ejecución prolongada, tareas entre sesiones, construcción de bases de conocimiento internas de empresas |
Antes de entrar en Dreaming, conviene aclarar algunos términos. Un Transcript es el registro completo de una sesión: las entradas del usuario, las salidas del agente, las invocaciones de herramientas y sus resultados. Una Memory Note es un hecho, regla o lección persistente, destilado a partir de la experiencia previa. Un Memory Store es el espacio de almacenamiento persistente donde se guardan los archivos de memoria entre sesiones. La idea de Dreaming se parece a Sleep-time Compute: aprovechar la capacidad de cómputo ociosa, fuera de la interacción principal, para procesar el contexto que ya existe.
Por qué la memoria de un agente no puede limitarse a guardar conversaciones pasadas
Cuando muchos equipos construyen la memoria de un agente, lo primero que hacen es guardar todas las conversaciones y buscarlas cuando hacen falta. El problema es que los registros históricos, los resúmenes de sesión y el conocimiento recuperable son tres cosas distintas. Un registro es solo una pila de eventos en bruto, un resumen puede perder detalles clave, y únicamente el conocimiento verificado y bien organizado ayuda de forma fiable en la siguiente tarea.
Guardar todas las conversaciones tal cual trae tres riesgos: información duplicada, estados antiguos que quedan obsoletos y errores que se van acumulando. Un registro mal escrito lo leerán una y otra vez las sesiones posteriores, y así el error se trata como un hecho y se sigue ejecutando. La conclusión de Anthropic es directa: más memoria no es mejor memoria; hay que seleccionarla, verificarla y organizarla.
El experimento con Pokémon Red muestra muy bien esta diferencia. Hacia los 10.000 pasos, Sonnet 3.7 había creado 413 archivos y 225 carpetas, y solo consiguió 1 medalla. Fable 5 creó apenas 9 archivos de memoria normales, 2 carpetas y un global.md, y aun así consiguió 4 medallas.
La diferencia está en qué se anota. Sonnet 3.7 guardaba un montón de estados de juego en constante cambio, y esos registros quedaban obsoletos enseguida. Fable 5 se centraba más en estrategias, reglas ya verificadas y planes de acción. De ahí sale un principio de diseño: la memoria a largo plazo debería priorizar el conocimiento que es difícil volver a obtener del entorno actual, y no hace falta anotar el estado en tiempo real que se puede leer directamente cada vez.
Los 4 niveles del sistema de memoria de Claude
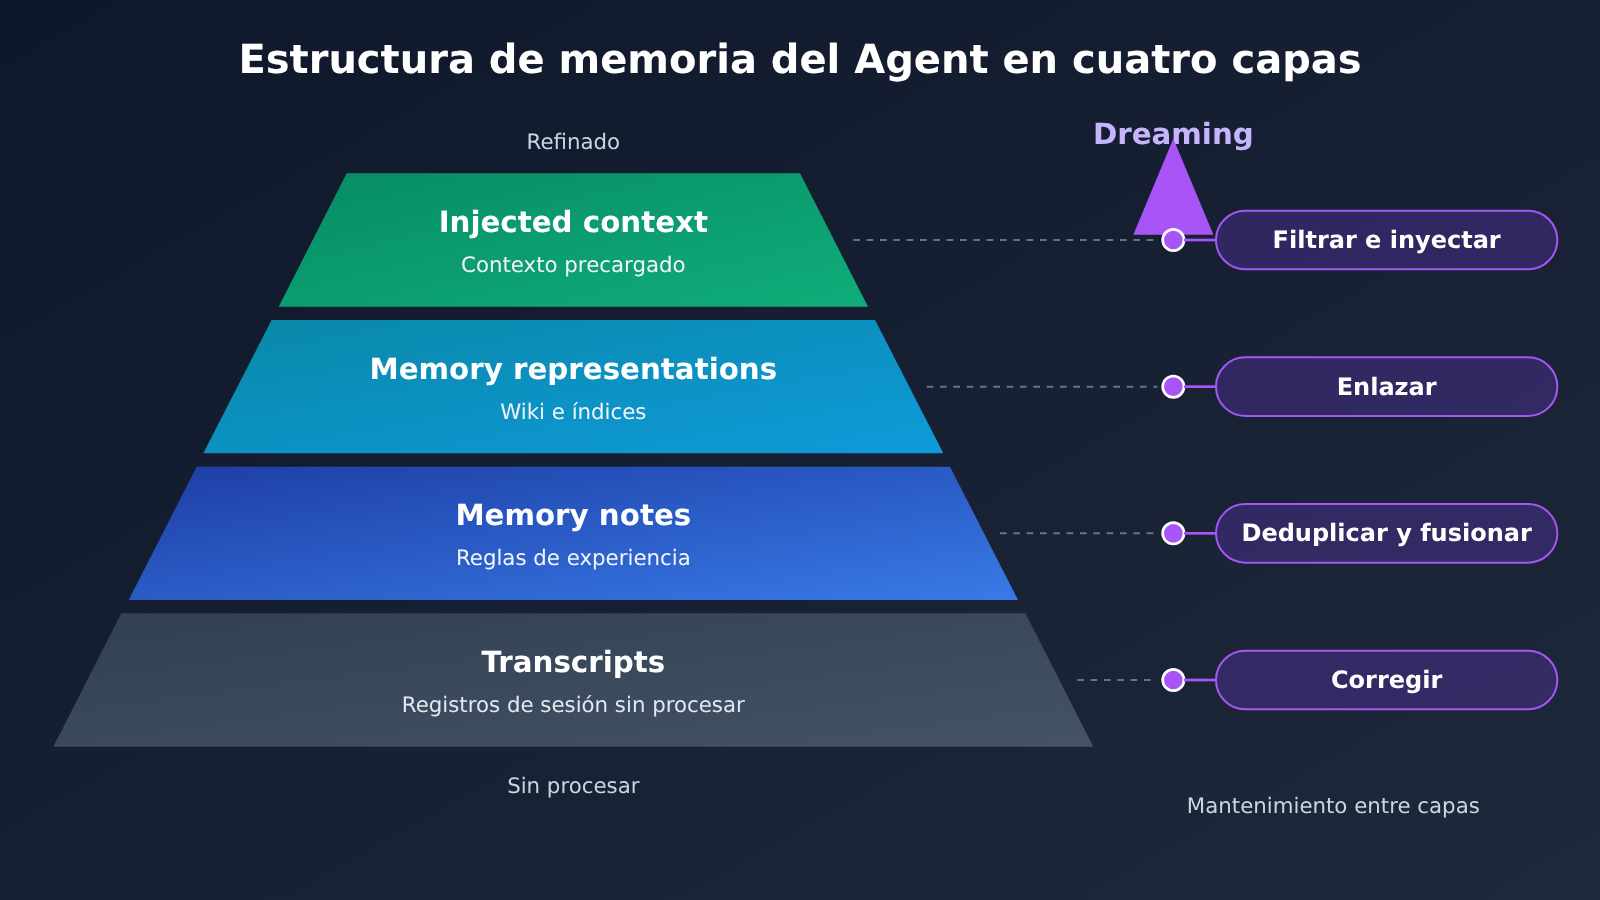
Anthropic divide la memoria de un Agent en 4 niveles. Cada uno tiene una responsabilidad, una frecuencia de escritura y un coste de lectura distintos.
| Nivel | Contenido | Función | Forma de lectura |
|---|---|---|---|
| Transcripts | Registro completo de las sesiones | Log de eventos con búsqueda; es la evidencia original para rastrear los hechos | Consulta bajo demanda |
| Memory notes | Hechos importantes, experiencias y reglas anotados durante las tareas | Acumula experiencia reutilizable | Lectura bajo demanda |
| Memory representations | Representaciones estructuradas como wikis, índices y enlaces | Organiza las relaciones entre los conocimientos y permite buscar entre documentos | Navegación y consulta |
| Injected context | Una pequeña cantidad de memorias de alto valor | Se precarga al iniciar una sesión nueva | Inyección automática |
Estos 4 niveles van de lo «crudo» a lo «refinado». El Transcript es el que contiene más información, pero también es voluminoso y tiene mucho ruido. El Injected context es el más refinado, pero cada elemento ocupa espacio en la ventana de contexto de la nueva sesión, así que solo se reserva para la información con mayor relevancia (Salience).
El papel de Dreaming es el mantenimiento entre niveles. Vuelve a los Transcripts para corregir registros antiguos, fusiona la información duplicada de las Memory notes, construye wikis e índices, y decide qué contenido merece inyectarse de antemano al comenzar una sesión nueva (Context Injection).
Cómo Claude Dreaming corrige errores, organiza y construye bases de conocimiento
Corrección con Dreaming: el caso de navegación en Mt. Moon
Anthropic documentó un error de navegación. El Agent recordó mal la ubicación del Pokémon Center cercano a Mt. Moon, y en las sesiones siguientes siguió intentando una y otra vez la misma ruta equivocada.
Después de revisar de nuevo las Transcripts históricas, Dreaming encontró el registro original erróneo y corrigió el archivo de memoria. El Agent que usó la memoria corregida llegó a Cerulean City en la acción número 1,935. La versión sin corrección repitió el fallo muchas veces y al final no logró cumplir el objetivo.
Este caso muestra que Dreaming hace algo más que resumir: puede volver a la experiencia original y comprobar si un recuerdo sigue siendo válido. Por eso, las Transcripts guardadas adquieren un nuevo uso: son una base de evidencias que se puede consultar y verificar una y otra vez.
Efecto de la memoria en Claude: datos del experimento CL-Bench
Anthropic probó el efecto de la memoria con las tareas de bases de datos de CL-Bench 1.0. La siguiente tabla recoge el mean reward que aparece en el informe oficial.
| Modelo | Sin memoria | Con memoria | Mejora |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
Ojo: estos datos corresponden solo a esta tarea y no son una puntuación general de la capacidad de memoria de un Agent. Lo más interesante es un fenómeno: cuanto más potente es el modelo, más tiende a registrar reglas verificadas, causas de errores y trampas que podría encontrarse en el futuro, en lugar de copiar tal cual las conversaciones anteriores. La mejora de Sonnet 4.6 es muy limitada, lo que indica que la eficacia de un sistema de memoria depende en gran medida de la «calidad de registro» del propio modelo.
Efecto de Dreaming al construir una base de conocimiento Wiki
El experimento más grande usó unos 350,000 archivos internos, con un total aproximado de 420M Tokens. Anthropic fue construyendo un Wiki de conocimiento a lo largo de 128 sesiones de Dreaming y después evaluó el resultado con tareas de preguntas y respuestas.
| Método de recuperación | Puntuación | Notas |
|---|---|---|
| Wiki solo (antes → después de construirlo) | 13% → 48% | El efecto se nota a medida que el Wiki va tomando forma |
| Search solo | 53% | Línea base |
| Search + Wiki (antes → después de construirlo) | 54% → 61% | Ahorra en promedio unos 20,000 Tokens por pregunta |
| Tareas de síntesis entre archivos (fusiones y adquisiciones) | Wiki 87% vs Search solo 73% | La ventaja en síntesis entre documentos es la más clara |
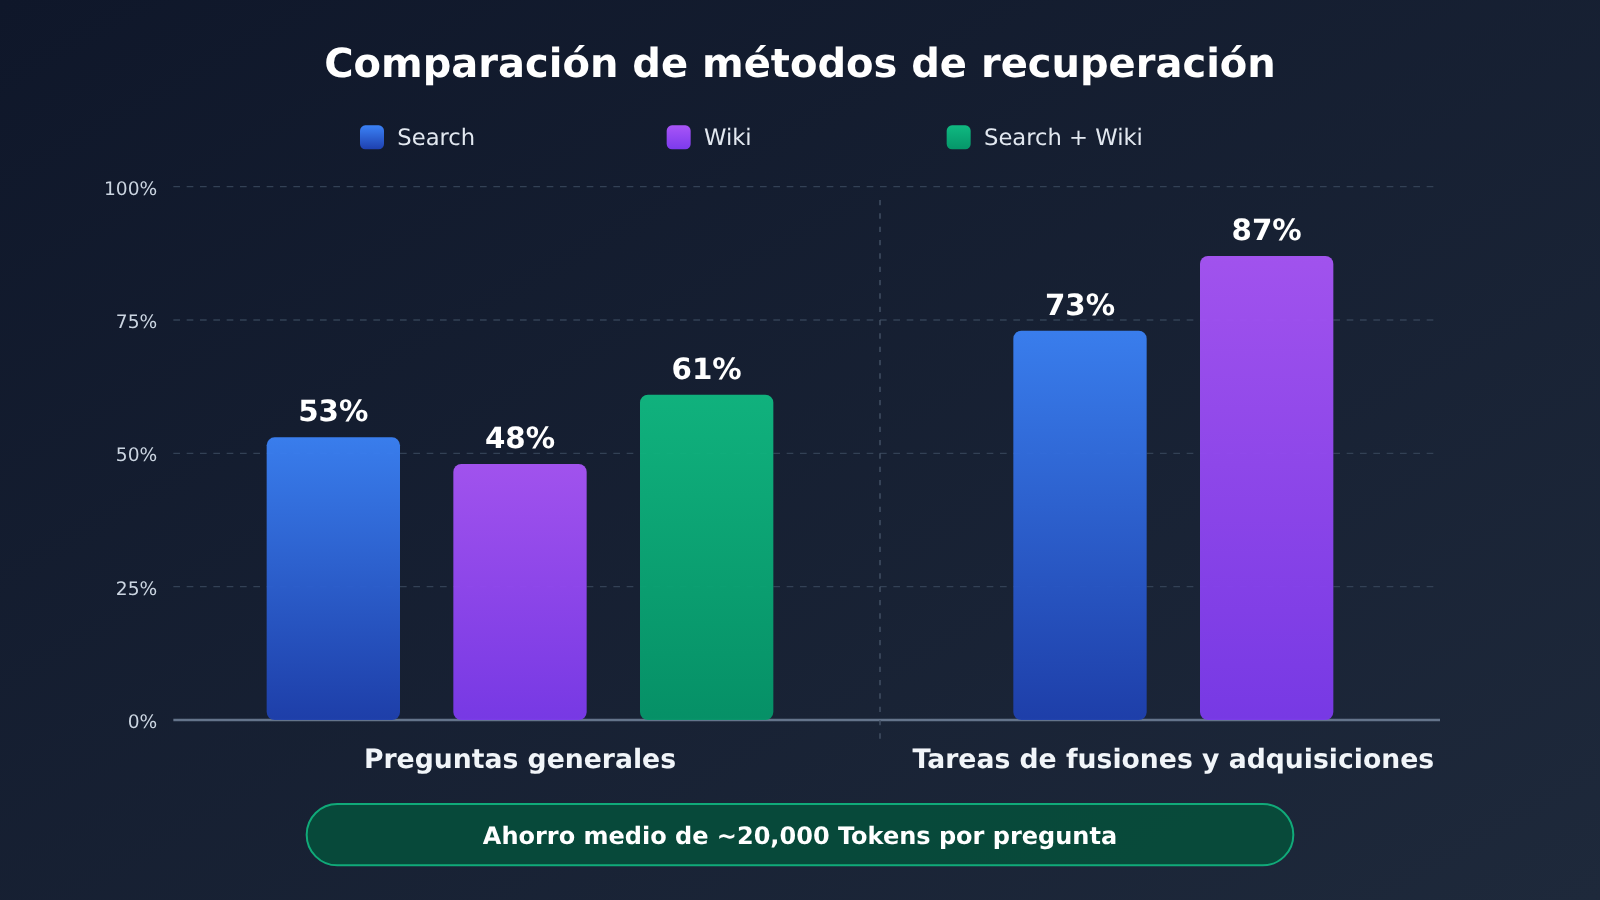
📊 Nota sobre el gráfico: todos los datos anteriores provienen de experimentos publicados en el blog de ingeniería de Anthropic. Si quieres hacer una validación similar a pequeña escala con tu propio corpus, puedes invocar los modelos de Claude a través de APIYI (apiyi.com) y comparar el rendimiento y el consumo de Tokens entre dos enfoques: «solo recuperación» y «recuperación + Wiki organizado».
El valor de la memoria estructurada se resume en dos puntos. Primero, crea enlaces e índices que permiten sintetizar información repartida en varios archivos. Segundo, reduce la cantidad de texto original que hay que volver a leer en cada recuperación, lo que baja el costo en Tokens.
Análisis de impacto: por qué el reordenamiento de memoria de Claude Dreaming a veces funciona y a veces perjudica
Anthropic no presenta Dreaming como una solución universal: en el artículo incluye varios contraejemplos. Para la práctica de ingeniería, esta parte puede ser más valiosa que los datos positivos.
5 tipos de riesgos de ingeniería en la organización de memoria
- Registro excesivo: como ocurría con Sonnet 3.7, que guardaba una gran cantidad de estado volátil, la memoria se infla muy rápido y también se queda obsoleta muy rápido.
- Información desactualizada: el entorno cambió, pero la memoria sigue anclada en la versión antigua. Si no se verifica contra la fuente, seguirá confundiendo al Agent.
- Sobrescritura por escritura compartida: en un experimento de organización de contratos, varios Agents escribían a la vez en la misma tabla resumen y de 57 datos clave solo se conservaron 41, es decir, cerca del 72 %. Al cambiar a una página independiente por contrato, con un único Agent como responsable de escribir y conservando las cláusulas originales, se mantuvieron los 57 datos.
- Inflación del tamaño del Wiki: en una prueba, los archivos originales ocupaban solo 115 KB, pero el Wiki generado llegó a 203 KB. Es decir, la organización terminó generando más información en lugar de menos.
- Sin beneficio en tareas sencillas: en preguntas cuya respuesta se puede encontrar directamente en un solo archivo, el Wiki no aportó una mejora apreciable y solo añadió costes de mantenimiento.
Qué implica para los desarrolladores
- La memoria necesita capas: los registros en bruto, las reglas de experiencia, el conocimiento estructurado y el contexto preinyectado se almacenan por separado, cada uno con su propia estrategia de escritura y lectura.
- El origen debe ser trazable: cada entrada de memoria debería poder rastrearse hasta su Transcript correspondiente; es la condición necesaria para poder corregir errores.
- Serializar o particionar las escrituras: evita que varios Agents escriban a la vez en el mismo archivo y prioriza la estructura de «una entidad, una página».
- Limpieza periódica: el Wiki y las Memory notes también necesitan deduplicación, fusión y retirada de contenido. Si no, su tamaño solo irá en aumento.
Qué implica para la industria
- El foco de la investigación sobre memoria de Agents está pasando de «recuperar con precisión» a «comprobar si la memoria en sí es correcta y si se está manteniendo».
- Sleep-time Compute tiene visos de convertirse en una arquitectura habitual: el coste de la organización se traslada a las horas de inactividad, lo que reduce la carga de contexto durante la interacción principal.
- La memoria estructurada encaja mejor en tareas que abarcan varios archivos, múltiples turnos y acumulación a largo plazo. Para preguntas y respuestas simples y puntuales, la recuperación pura sigue siendo la opción más económica.
Cómo llevar la idea de Claude Dreaming a tus propios agentes
Condiciones de uso del preview de investigación oficial de Dreams
Según la documentación actual de Anthropic, Dreams es una función dentro de Claude Managed Agents, en estado de Research Preview, y para usarla hay que solicitar acceso. Al hacer la llamada es necesario enviar dos cabeceras Beta: managed-agents-2026-04-01 y dreaming-2026-04-21.
Su entrada es un Memory Store ya existente más entre 1 y 100 sesiones históricas, y su salida es un Memory Store nuevo; el Store original no se modifica. La tarea se ejecuta de forma asíncrona, normalmente tarda desde unos minutos hasta varias horas, y se factura según el precio estándar por token del modelo elegido. Los modelos compatibles son principalmente Opus 5.5 y Sonnet 5.5. Además, por ahora no cumple con Zero Data Retention ni con los requisitos de HIPAA, así que conviene evaluarlo bien antes de trabajar con datos sensibles.
Diseño del flujo de trabajo dinámico en el Cookbook
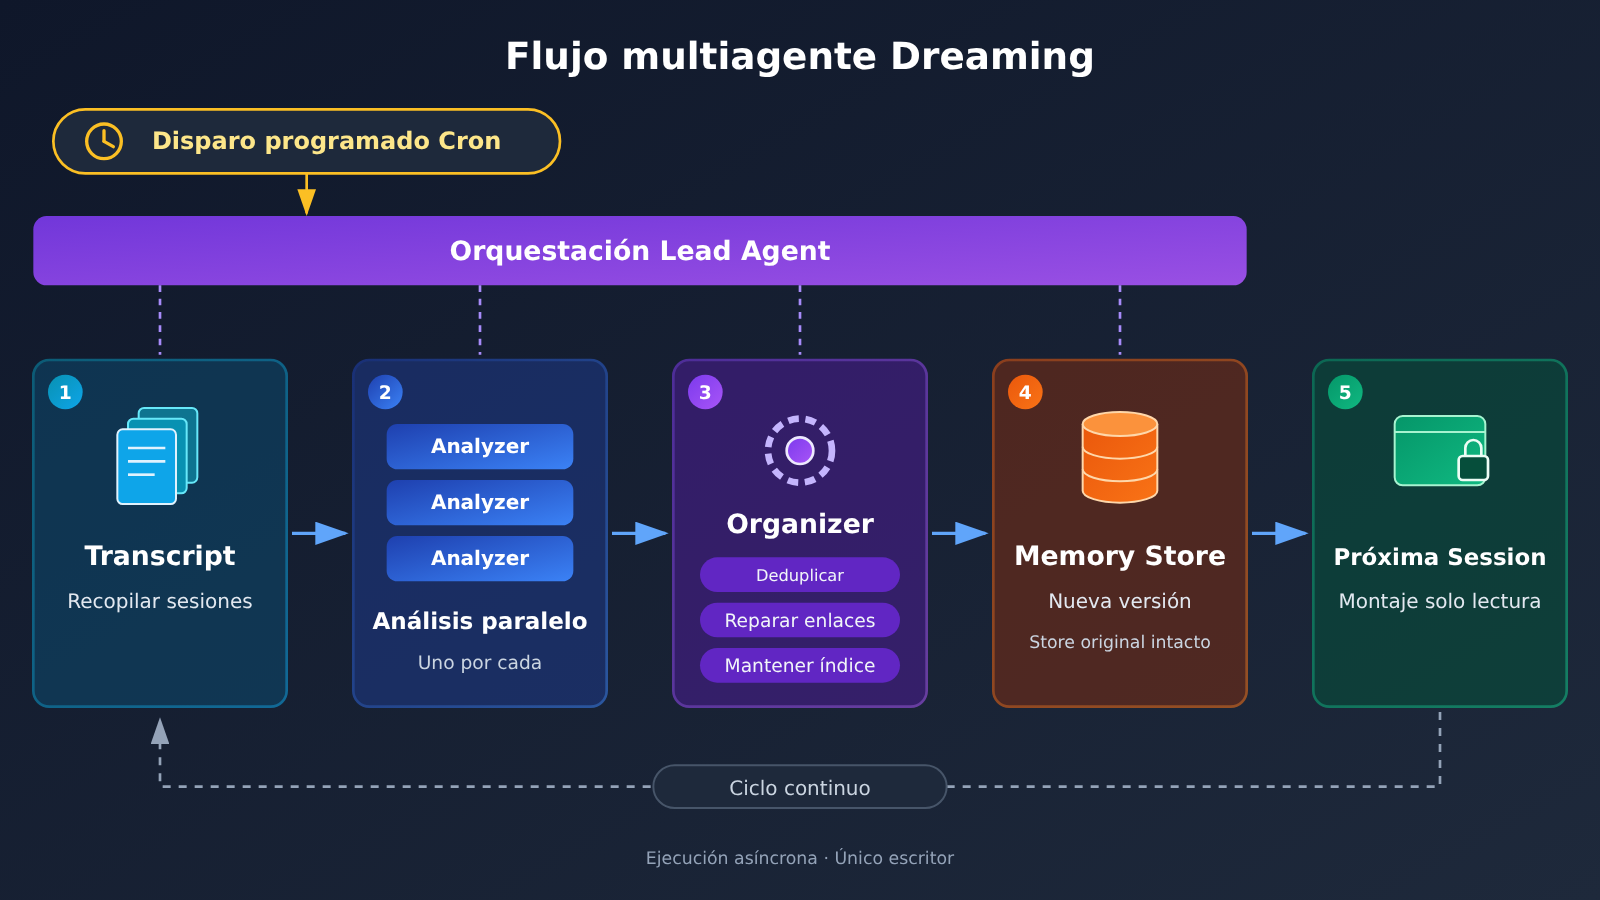
El Cookbook oficial propone un flujo de trabajo multiagente que puedes montar tú mismo. Por defecto, un Lead Agent orquesta el proceso, cada Analyzer Agent se encarga de una Transcript y el Organizer Agent elimina duplicados, repara enlaces y mantiene el índice. El Memory Store ya organizado se monta en la siguiente Session, normalmente en modo de solo lectura. También se puede ejecutar con Cron de forma programada, por ejemplo para organizar cada noche las Sessions del día anterior.
El Cookbook incluye además un ejemplo de costes. Con 11 Transcripts de ejemplo (283 KB en total), la ejecución tarda unos 2,5 minutos y cuesta alrededor de $0.36. Con 50 Transcripts largas (unos 12 MB), usando la configuración optimizada para costes, el gasto ronda los $8 y el proceso dura unos 10 minutos. Son resultados de experimentos concretos, no tarifas fijas.
Crea tu propio flujo de consolidación de memoria entre sesiones con modelos Claude
Una aclaración importante: APIYI ofrece la interfaz de invocación de los modelos de la serie Claude, pero eso no significa que ofrezca las APIs de Managed Agents, Memory Stores o Dreams. Aun así, la idea central de Dreaming (leer los transcripts en segundo plano, extraer reglas ya verificadas y pasárselas a un único escritor para que las organice) se puede implementar sin problema con invocaciones normales del modelo. Aquí tienes un ejemplo mínimo en el que Claude analiza el registro de una sesión y devuelve memorias candidatas.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # Sustitúyelo por un modelo Claude disponible en la lista de modelos
    messages=[
        {"role": "system", "content": "只提炼经过验证的规则、错误原因和未来陷阱,忽略易变状态,每条注明来源行号。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
Ver el código completo (Analyzer + Organizer de escritura única)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # Una página por tema, escrita en serie por un único proceso para evitar sobrescrituras concurrentes
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# Se puede lanzar cada noche con Cron; en la siguiente sesión solo se carga, en modo lectura, la página de índice de memory_store
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 Consejo para empezar rápido: cuando estés montando el prototipo, puedes usar APIYI (apiyi.com) para probar con una misma clave API distintos modelos Claude como Analyzer y como Organizer. Compara qué combinación extrae reglas más precisas y gasta menos tokens, y luego decide la configuración para producción.
Las diferencias entre las dos rutas se pueden resumir en la siguiente tabla:
| Aspecto | Dreams de Anthropic Managed Agents | Organización de memoria propia sobre la API del modelo |
|---|---|---|
| Cómo se obtiene | Vista previa de investigación: hay que solicitar acceso y enviar las cabeceras Beta | Llamada directa a la API de los modelos Claude |
| Almacenamiento de memoria | Memory Store oficial; la salida es un Store nuevo | Se implementa uno mismo con archivos, base de datos o una Wiki |
| Programación y concurrencia | Tareas asíncronas gestionadas por Anthropic | Hay que montar el Cron, la cola y el control de escritura única por cuenta propia |
| Corrección de errores y permisos | Ya vienen integrados en el flujo oficial | Requiere diseñar la verificación de fuentes y los permisos |
| Plataformas disponibles | Anthropic oficial | APIYI apiyi.com (invocación del modelo) y API oficial |
Preguntas frecuentes sobre Claude Dreaming
P1: ¿Qué es Claude Dreaming?
Dreaming es un proceso de mantenimiento de memoria en segundo plano entre sesiones, propuesto por Anthropic. A partir de los transcripts históricos corrige registros antiguos, fusiona información duplicada, construye una Wiki y sus índices, y filtra el contexto de alto valor que conviene inyectar por adelantado en las nuevas sesiones.
P2: ¿En qué se diferencia Dreaming de un resumen de conversación normal o de la búsqueda vectorial?
Un resumen solo comprime la información y la búsqueda solo se encarga de encontrarla. Dreaming vuelve al transcript original para comprobar si lo que recuerda sigue siendo válido; por ejemplo, en el caso Mt. Moon corrigió una orientación errónea. Además se ocupa de crear enlaces entre documentos: en tareas de síntesis que cruzan varios archivos, la Wiki obtuvo una puntuación del 87 %, frente al 73 % de la búsqueda pura.
Q3: ¿Se puede usar ya Claude Dreaming?
El blog de ingeniería correspondiente se publicó el 6 de noviembre de 2026. Dreams aparece por ahora como Research Preview dentro de Claude Managed Agents: hay que solicitar acceso y enviar dos cabeceras Beta para poder invocarlo.
P4: Si no tengo acceso a Managed Agents, ¿puedo aplicar la idea de Dreaming?
Sí. Siguiendo el flujo de «recopilar transcripts, analizar en segundo plano, consolidar con escritura única, montar en solo lectura y mantener de forma periódica» se puede construir una versión simplificada con llamadas normales al modelo. A través de APIYI apiyi.com puedes invocar los modelos Claude con una interfaz compatible con OpenAI para hacer el análisis y la consolidación. El almacenamiento, la programación y los permisos tienes que implementarlos tú.
P5: ¿APIYI ofrece directamente la funcionalidad Claude Dreaming?
No. APIYI apiyi.com ofrece la interfaz de invocación de modelos como Claude, pero no incluye Managed Agents, Memory Stores ni la API de Dreams de Anthropic. Sirve para llamar al modelo y montar tu propio flujo de organización de memoria; los usuarios nuevos pueden empezar con la cuota de prueba gratuita para validar la propuesta.
P6: ¿Qué limitaciones conocidas tiene Dreaming?
En preguntas simples que se responden con un solo archivo, la Wiki no aporta una ventaja clara. La consolidación puede inflar el volumen: por ejemplo, un original de 115 KB generó una Wiki de 203 KB. Si varios agentes comparten la escritura, se pierden hechos. El Dreams oficial todavía no cumple con ZDR ni con los requisitos de HIPAA, y las tareas tardan desde unos minutos hasta varias horas.
Claude Dreaming: puntos clave (Key Takeaways)
- La memoria no es solo almacenamiento: guardar todas las conversaciones acumula información duplicada, obsoleta y errónea, así que hay que verificarla y organizarla.
- Estructura de memoria en 4 capas: Transcripts, Memory notes, Memory representations e Injected context, cada una con su función.
- La corrección de errores depende del registro original: Dreaming vuelve al Transcript para contrastar los datos y corrigió una ubicación errónea que provocaba fallos repetidos.
- La Wiki destaca en tareas que cruzan documentos: en la tarea de fusiones y adquisiciones, la Wiki obtuvo un 87 %, frente al 73 % de la recuperación pura, con un ahorro medio de unos 20 000 tokens por pregunta.
- Organizar también tiene efectos secundarios: las escrituras concurrentes pueden perder hechos, la Wiki tiende a inflarse y en tareas sencillas no hace falta.
- Montarlo por tu cuenta es viable: si invocas modelos Claude a través de APIYI (apiyi.com), puedes implementar una versión simplificada de la consolidación de memoria entre sesiones.
Conclusión
Claude Dreaming nos deja tres ideas principales:
- La clave de la memoria a largo plazo es su mantenimiento: solo una memoria verificada, depurada de duplicados y bien organizada ayuda de forma fiable en la siguiente tarea.
- Qué se recuerda importa más que cuánto se recuerda: da prioridad a las reglas, las causas de los errores y las trampas que son difíciles de volver a obtener del entorno, y evita guardar estados que cambian con facilidad.
- La memoria estructurada depende del escenario: las tareas que abarcan varios archivos, muchas rondas y acumulación a largo plazo justifican una Wiki; en tareas simples de recuperación no compensa añadir ese coste de mantenimiento.
Si tu Agent ya funciona a lo largo de varias sesiones, puedes empezar por el ciclo mínimo: «conservar el Transcript, consolidar una vez cada noche de forma secuencial y montar la página índice en modo solo lectura». Te recomendamos validar rápidamente este flujo invocando modelos Claude a través de APIYI (apiyi.com), una plataforma que ofrece una interfaz compatible con OpenAI y crédito de prueba gratuito para nuevos usuarios.
📚 Referencias
- The components of agent memory: artículo original del blog de ingeniería de Anthropic, que presenta la estructura de memoria de 4 capas y el experimento Dreaming
- Enlace:
anthropic.com/research/components-of-agent-memory -
Descripción: fuente original de los datos experimentales de CL-Bench, Pokémon, Wiki y organización de contratos
-
Dreaming with a dynamic workflow: Cookbook oficial de Claude
- Enlace:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
Descripción: ejemplo de flujo de trabajo multiagente con Lead, Analyzer y Organizer, junto con una referencia de costes
-
Publicación oficial de Anthropic en X: nota de lanzamiento del blog de ingeniería sobre Dreaming
- Enlace:
x.com/AnthropicAI/status/2118814753154064501 - Descripción: confirma la fecha de publicación y el posicionamiento oficial
Autor: equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal de APIYI. Encontrarás más información en el centro de documentación: docs.apiyi.com


