
Hinweis des Autors: Multimodell-Anwendungen sollten über ein einheitliches Nachrichtenformat, eine Anbieter-Adapterschicht und ein Fähigkeitsregister die Unterschiede bei Tool-Aufrufen, Reasoning-Status, Streaming-Ausgabe, strukturierten Daten und Caching handhaben.
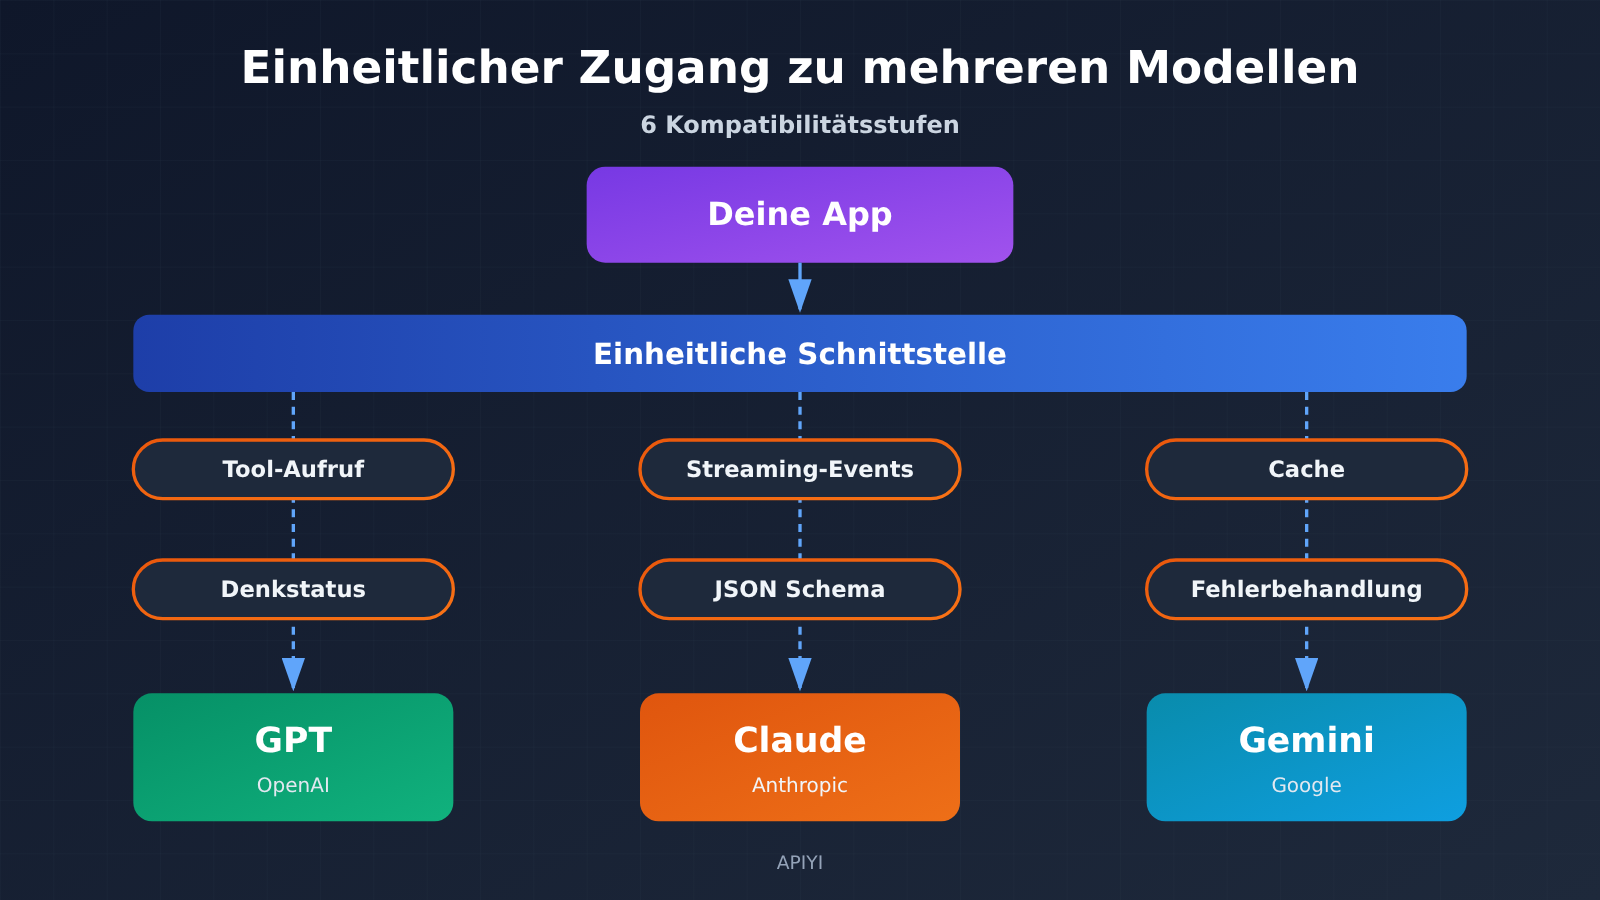
GPT, Claude und Gemini können alle normale Textaufrufe ausführen; Claude und Gemini bieten außerdem offizielle OpenAI-SDK-kompatible Zugänge. Produktionsanwendungen müssen beim Modellwechsel 6 Arten von Kompatibilitätsproblemen lösen: Nachrichtenrollen und Systemanweisungen, Tool-Aufrufprotokoll, Reasoning-Parameter und Thinking-Status, Streaming-Ereignisse, strukturierte Ausgabe und Multimodalität, Cache-Abrechnung und Fehlerbehandlung. Ein bloßer Austausch der Model ID reicht für einfache Frage-und-Antwort-Szenarien; mehrstufige Tool-Aufrufe, Wiederaufnahme nach Streaming-Abbrüchen und Kostenkalkulation müssen separat behandelt werden. Ein relativ solider Engineering-Ansatz ist „einheitliche Geschäftsschnittstelle + Anbieter-Adapterschicht (Provider Adapter) + Modellfähigkeitsregister“. So lässt sich der Modellwechsel als wartbare Produktfunktion verwalten.
Im Folgenden vergleichen wir zunächst die strukturellen Unterschiede der drei nativen APIs und erläutern, welche Szenarien die OpenAI-kompatible Schnittstelle abdecken kann. Danach zerlegen wir die 6 Arten von Kompatibilitätsproblemen einzeln und zeigen, welche realen Störungen sie verursachen; anschließend stellen wir eine sechsschichtige Integrationsarchitektur und lauffähigen einheitlichen Aufrufcode vor. Zum Schluss listen wir sechs Kompatibilitätstests vor dem Produktivstart auf und erklären, wie ein einheitliches API-Gateway und die Anpassung nativer Fähigkeiten zusammenarbeiten.
To Know: Glossar zur API-Kompatibilität mehrerer Modelle
| Begriff | Erklärung |
|---|---|
| API | Die Schnittstelle, über die eine Anwendung Anfragen an einen Modelldienst sendet und die Ergebnisse zurückbekommt. |
| SDK | Ein Software-Entwicklungs-Kit, das die Details des Schnittstellenaufrufs kapselt. |
| Native API | Die vom Hersteller selbst entworfene Hauptschnittstelle, zum Beispiel OpenAI Responses, Claude Messages oder Gemini Interactions. |
| Kompatible Schnittstelle | Ein Adapter-Einstiegspunkt, der ein anderes Anfrageformat (meist das OpenAI-Format) verwendet, damit man dasselbe SDK für den Aufruf nutzen kann. |
| Funktionsaufruf (Function Calling) | Das Modell fordert die Anwendung mit strukturierten Parametern auf, eine bestimmte externe Funktion auszuführen. |
| Aufruf-ID | Die Kennung, die eine vom Modell ausgelöste Tool-Anfrage mit dem von der Anwendung zurückgelieferten Ausführungsergebnis verknüpft. |
| Denk-Signatur (Thought / Thinking Signature) | Verschlüsselte Zustandsdaten, mit denen einige Modelle den Kontext von Reasoning und Tool-Aufrufen speichern; sie müssen unverändert zurückgegeben werden. |
| Streaming-Ausgabe (Streaming) | Der Server liefert das Ergebnis ereignisweise in Abschnitten zurück, sodass die Oberfläche es schon während des Empfangs anzeigen kann. |
| JSON Schema | Eine Spezifikation, die die Struktur von JSON-Daten und die Prüfregeln dafür beschreibt. |
| Prompt-Caching (Zwischenspeichern von Eingabeaufforderungen) | Wiederkehrende Eingabe-Präfixe verwenden das bereits berechnete Ergebnis erneut, um Latenz und Kosten zu senken. |
| TTL | Die Lebensdauer eines Cache-Eintrags; nach Ablauf muss er neu geschrieben werden. |
| Anbieter-Adapter (Provider Adapter) | Eine Komponente, die eine einheitliche Anfrage in das native Format eines Herstellers umwandelt und die Antwort wieder ins einheitliche Format zurückübersetzt. |
| Fähigkeitsregister | Eine Konfigurationsliste, die festhält, welche Parameter und Funktionen jedes Modell und jeder Anbindungsendpunkt tatsächlich unterstützt. |
| Idempotent | Dieselbe Operation hat einmal wie auch mehrfach ausgeführt dieselbe Wirkung – das verhindert doppelte Abbuchungen oder doppelt versendete Nachrichten bei Wiederholungsversuchen. |
1 Kompatibilität mit mehreren Modell-APIs: Warum ein Modellwechsel nicht nur den Model ID betrifft
Alle drei Anbieter lassen sich über ein einziges model-Feld ansteuern, doch Aufbau des Request-Bodys, Struktur der Response-Objekte und Verwaltung des Kontextstatus unterscheiden sich deutlich. Bei normalen Frage-Antwort-Szenarien beschränken sich die Unterschiede auf Feldnamen, der Anpassungsaufwand bleibt gering. Bei Agenten-Anwendungen, die auf Tool-Aufrufe, Reasoning-Zustände und Streaming-Events angewiesen sind, werden diese Unterschiede direkt zu Produktionsausfällen.
1.1 Vergleich der nativen APIs von GPT, Claude und Gemini
Die folgende Tabelle beschreibt ausschließlich die nativen APIs, ohne Kompatibilitätsschicht oder Gateway-Endpunkte.
| Dimension | OpenAI (nativ) | Claude (nativ) | Gemini (nativ) |
|---|---|---|---|
| Primäre Schnittstelle | Responses API, /v1/responses |
Messages API, /v1/messages |
Interactions API (GA im Juni 2026, offiziell für neue Projekte empfohlen); generateContent wird weiterhin unterstützt |
| Eingabeorganisation | model + input |
model + messages + max_tokens, system getrennt vom Nachrichtenarray |
Native Interactions-Struktur, zusätzlich system_instruction-Regeln |
| Ausgabestruktur | Ausgabeelemente unterschiedlichen Typs: Text, Reasoning-Elemente, function_call usw. |
content blocks: text, thinking, tool_use usw. |
steps: Modellausgabe, Tool-Aufrufe, Reasoning und weitere Schritte |
| Erkennung des Abschlusses | Abschlussereignis der Antwort / Typ des Ausgabeelements | stop_reason (normales Ende, Tool-Ausführung erforderlich usw.) |
Schritttyp und Interaktionsstatus |
| Kontextfortsetzung | previous_response_id |
Anwendung überträgt die vollständige Nachrichtenhistorie selbst zurück | previous_interaction_id, optionaler serverseitiger Sitzungsstatus |
| Integrierte Tools | Plattform-Tools + benutzerdefinierte Funktionen | überwiegend benutzerdefinierte Tools | integrierte Tools wie Google Search, URL Context, Codeausführung; Drittanbieter-Tools werden von der Anwendung ausgeführt |
Wie die Tabelle zeigt, teilen sich die drei Anbieter bei der Frage „Wer speichert den Kontext?“ in zwei Lager. OpenAI und Gemini unterstützen die serverseitige Fortsetzung des Kontexts, während bei Claude Messages die Anwendung die Historie selbst zurücküberträgt. Ist der Sitzungsspeicher der Anwendung nur für eine dieser Varianten ausgelegt, kommt es beim Wechsel zu einem anderen Anbieter zu Kontextverlust oder doppelt gesendeten Nachrichten.
1.2 Wie viel lässt sich mit OpenAI-kompatiblen Schnittstellen lösen?
Claude und Gemini bieten beide einen Kompatibilitätseingang für das OpenAI SDK. Der offizielle Kompatibilitätsendpunkt von Gemini ist generativelanguage.googleapis.com/v1beta/openai/; bei Verwendung des OpenAI-Clients genügt es, base_url, API-Schlüssel und model anzupassen. Die Kompatibilitätsdokumentation von Claude grenzt den unterstützten Umfang dagegen klar ein. Die bekannten Einschränkungen mit Stand 2026-11-13 sind:
- Der Parameter
strictin Tool-Definitionen wird ignoriert, wodurch die strikten Einschränkungen für Tool-Parameter nicht mehr greifen. - Prompt Caching wird nicht unterstützt.
- Eingaben der Typen audio und file werden nicht unterstützt.
system– unddeveloper-Nachrichten werden an den Anfang gezogen und zusammengeführt.- Felder rund um
thinkingweichen von der nativen API ab.
Kompatible Schnittstellen eignen sich für drei Szenarien: normale Chats, Single-Turn-Generierung sowie den schnellen Vergleich der Antwortqualität verschiedener Modelle. Die Migration komplexer Agenten betrifft strikte Tool-Parameter, Caching, Dateieingaben und mehrstufige Reasoning-Zustände. Für diese Funktionen muss man zur nativen API zurückkehren oder sie vor dem Go-live Punkt für Punkt verifizieren. Ein praktisches Kriterium: Taucht eine Funktion, auf die die Anwendung angewiesen ist, ausschließlich in der nativen Dokumentation auf, nimmt man sie in ein Fähigkeitsregister auf und überlässt sie einem dedizierten Adapter.
2 Die sechs häufigsten Kompatibilitätsprobleme beim Wechsel zwischen GPT-, Claude- und Gemini-Modellen
2.1 Rollen von Nachrichten und Systemanweisungen kompatibel behandeln
OpenAI unterscheidet Rollen wie developer und system. Bei Claude steht die system-Anweisung außerhalb des Nachrichtenarrays. Gemini verwendet system_instruction, und auch die Inhalte von Nutzer und Modell folgen eigenen Strukturregeln. Alle drei bringen dasselbe zum Ausdruck – „Priorität der Anweisung + mehrstufiger Verlauf“ –, doch die Felder, in denen das steckt, liegen jeweils an ganz anderen Stellen.
Häufige Fehler entstehen durch bequemes Zusammenkleben: Systemanweisung, Verlaufsnachrichten und Tool-Ergebnisse werden zu einem einzigen String zusammengesetzt und dem Modell als Nutzereingabe übergeben. Das läuft zwar durch, schwächt aber die Priorität der Anweisung ab – das Modell kann die Tool-Ausgaben aus dem Verlauf als neue Anforderung des Nutzers missverstehen. Richtig ist, die Rollensemantik innerhalb der Anwendung zu bewahren und die Zuordnung zu den Feldern der jeweiligen Anbieter dem Adapter zu überlassen. Außerdem ist zu beachten, dass die Claude-Kompatibilitätsschicht system und developer zusammenführt; Eingabeaufforderungs-Designs, die auf einer Trennung der beiden Ebenen beruhen, sollten daher praktisch getestet werden.
2.2 Tool-Aufrufprotokoll und Kompatibilitätsbehandlung von Aufruf-IDs
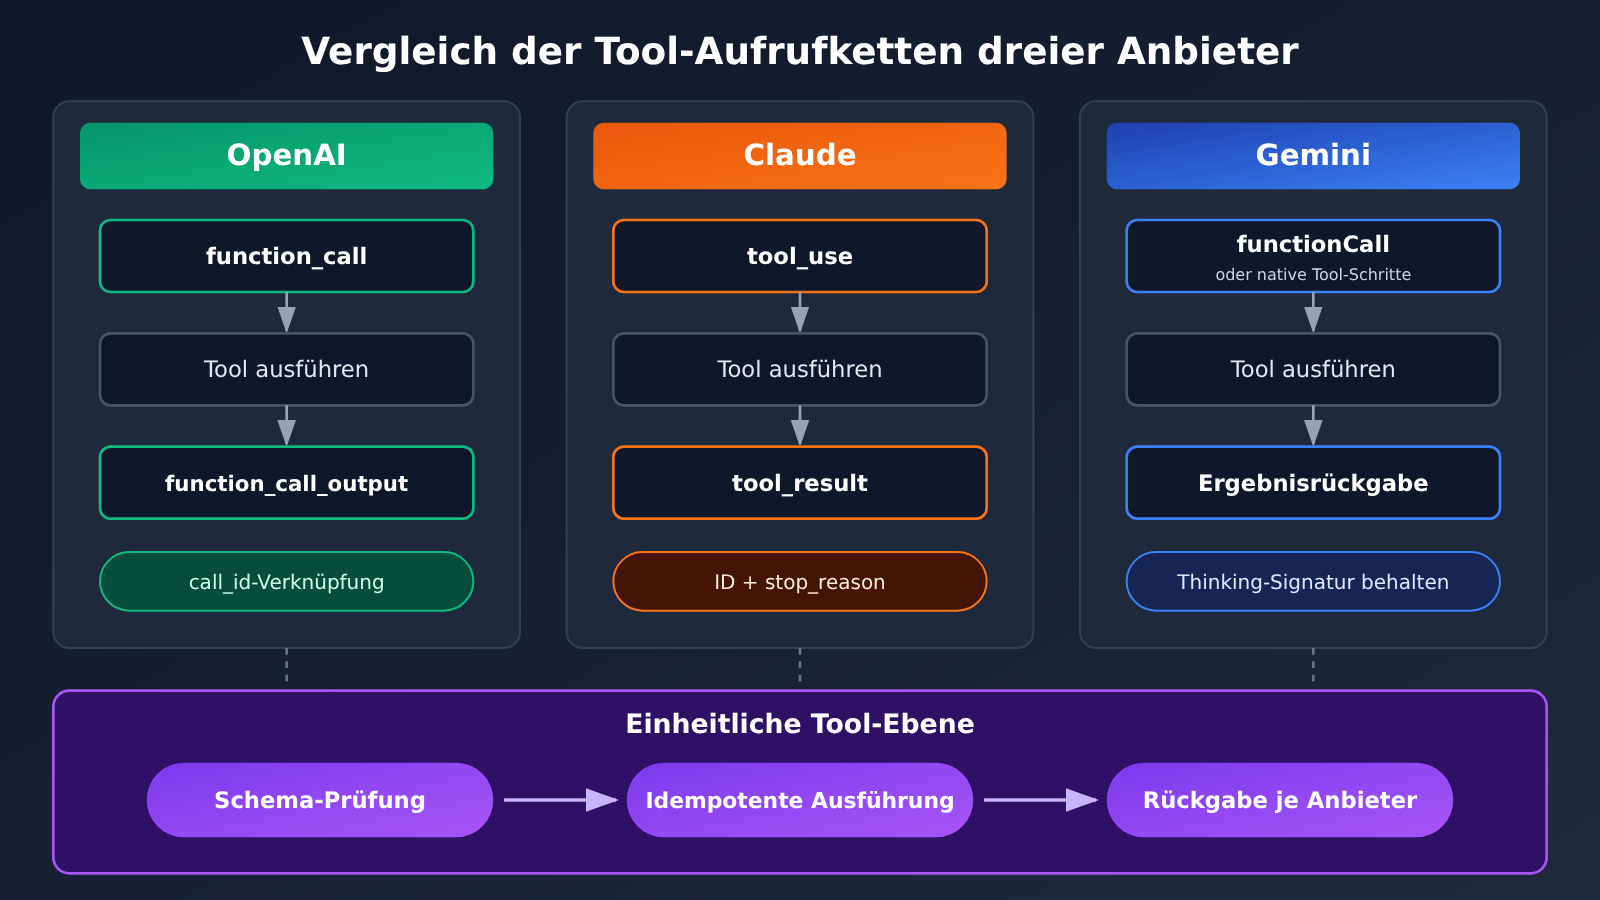
Alle drei unterstützen Function Calling. Der Aufrufablauf sieht folgendermaßen aus:
| Schritt | OpenAI | Claude | Gemini |
|---|---|---|---|
| Modell initiiert Aufruf | function_call-Ausgabeelement |
tool_use-Inhaltsblock |
functionCall / native Werkzeugschritte |
| Zuordnungs-ID | call_id |
ID von tool_use |
entsprechende Aufruf-ID |
| Rückgabe durch die Anwendung | function_call_output |
tool_result-Inhaltsblock |
entsprechende Ergebnisrückgabestruktur |
| Fortsetzung erforderlich? | anhand des Ausgabeelements beurteilt | stop_reason zeigt an, dass Werkzeuge ausgeführt werden müssen |
anhand des Schrittstatus beurteilt |
| Inferenzstatus | Reasoning-Elemente müssen möglicherweise mit dem Verlauf übergeben werden | Thinking-Blöcke müssen möglicherweise unverändert zurückgegeben werden | im stateless-Modus müssen Thought-Blöcke und Signaturen beibehalten werden |
Die Werkzeugschicht muss sechs Informationen vollständig speichern: die Aufruf-ID, den Funktionsnamen, das Parameter-JSON, die Beziehung zwischen parallelen Aufrufen, das Ausführungsergebnis sowie die Angabe, ob das Modell eine Fortsetzung der Inferenz verlangt. Parallele Aufrufe sind die fehleranfälligste Stelle. Wenn das Modell mehrere Werkzeuganfragen auf einmal initiiert, die Anwendung aber nur eines der Ergebnisse zurückgibt oder die Ergebnisse den IDs falsch zuordnet, führt dies in der nächsten Runde zu Parameterfehlern – oder das Modell setzt seine Antwort auf Basis falscher Daten fort.
Es empfiehlt sich, in der einheitlichen Werkzeugschicht die Parameter zunächst mit JSON Schema zu validieren und erst nach erfolgreicher Validierung die tatsächlichen externen Operationen auszuführen. Die vom Modell generierten Parameter sind nicht immer gültig; eine frühzeitige Validierung fängt Fehler ab, bevor das „externe System aufgerufen“ wird.
2.3 Kompatible Behandlung von Denkmodus und Kontextstatus
Die Namen und Bedeutungen der Inferenzparameter sind bei den drei Anbietern nicht deckungsgleich:
- OpenAI: Verwendet Parameter wie
reasoning.effort. GPT-6 Astra und GPT-6.1 Sol akzeptierenreasoning.effort=nonenicht; auch die Tool-Aufrufe dieser beiden Modelle setzen die Responses API voraus. - Claude: Die neue Modellgeneration setzt überwiegend auf Adaptive Thinking, kombiniert mit Denk-Konfigurationen wie effort. Einige neue Modelle unterstützen den alten manuellen Denkmodus mit festem
budget_tokensnicht mehr. - Gemini: Verschiedene Modelle nutzen thinking level oder budget; ob sich die Inferenz abschalten lässt und welche Stufen verfügbar sind, hängt vom jeweiligen Modell ab. Auch die Regeln zur Parameterzuordnung unterscheiden sich zwischen der nativen API und dem OpenAI-kompatiblen Endpunkt.
Wenn in der Produktoberfläche drei Stufen der Inferenzintensität – „Schnell, Standard, Gründlich“ – angeboten werden, drücken die Stufenbezeichnungen die Produktabsicht aus. Der Adapter muss sie in die Parameter umsetzen, die jedes Modell tatsächlich unterstützt; die drei Anbieter erhalten bei derselben Stufe nicht dieselben Rechenressourcen. Außerdem kann die Denkzusammenfassung, die der Nutzer sieht, von der tatsächlich abgerechneten Anzahl der Denk-Tokens abweichen. Für die Kostenstatistik sind die vom API zurückgegebenen Nutzungsfelder maßgeblich.
Der verschlüsselte Zustand bei Tool-Aufrufen über mehrere Runden ist das Problem, das langlaufende Agenten am leichtesten übersehen:
- Die reasoning-Einträge und Tool-Aufrufe von OpenAI Responses müssen möglicherweise zusammen mit dem Verlauf weitergegeben werden.
- Die
thinking– undredacted_thinking-Blöcke von Claude können verschlüsselte Zustände enthalten; bei der Rückgabe nach der Tool-Ausführung muss die ursprüngliche Struktur erhalten bleiben. - Der stateless Modus von Gemini Interactions verlangt, dass thought-Blöcke und Signaturen unverändert bleiben; im stateful Modus kann ein Teil des Zustands serverseitig verwaltet werden.
Wer nur den im Chatfenster angezeigten Text speichert, kann die Inferenzhistorie des Modells nicht vollständig wiederherstellen. Ein typisches Fehlerbild: Der Agent meldet nach dem dritten Tool-Aufruf plötzlich einen Fehler oder beginnt, bereits abgeschlossene Schritte zu wiederholen. Die Ursache ist meist, dass in einer Zwischenrunde ein Signaturblock verloren gegangen ist.
2.4 Vereinheitlichung der Streaming-Ereignisse
Die drei Anbieter unterscheiden sich in Ereignistypen, Reihenfolge und Endsignalen beim Streaming. OpenAI Responses kann response.output_text.delta, Tool-Call-Deltas sowie ein Response-Abschlussereignis ausgeben. Der Claude-Messages-Stream verwendet Ereignisse wie message_start, content_block_delta, message_delta. Die native Gemini-API verwendet wiederum ihre eigene Ausgabe- und Schrittstruktur.
Wenn das Frontend die Roh-Ereignisse der Anbieter direkt parst, muss der Frontend-Code bei jeder Integration eines neuen Modells angepasst werden. Besser ist es, im Backend einheitlich in ein internes Ereignisprotokoll zu konvertieren:
| Internes Ereignis | Bedeutung | Verarbeitungshinweis |
|---|---|---|
text_delta |
Text-Delta | Direkt anhängen und anzeigen |
reasoning_summary |
Denk-Zusammenfassung | Einklappbar darstellen, Abrechnung richtet sich nach usage |
tool_call_start |
Tool-Call-Start | Call-ID und Funktionsname erfassen |
tool_call_args |
Parameter-Fragmente | Nach Call-ID oder Index zusammenfügen, erst nach vollständiger Sammlung parsen |
tool_result |
Tool-Ausführungsergebnis | Eins-zu-eins-Zuordnung zur Call-ID |
usage |
Nutzungsstatistik | Eingabe-, Cache-, Denk- und Ausgabe-Token unterscheiden |
completed |
Normales Ende | Ein eindeutiges Endsignal muss empfangen werden |
error |
Fehler oder Verbindungsabbruch | Zwischen wiederholbar und nicht wiederholbar unterscheiden |
Beim Streaming gibt es drei häufige Fehlerquellen. Erstens: Die Parameter-Fragmente mehrerer Tool-Calls treffen abwechselnd ein; wenn man sie in Ankunftsreihenfolge zusammenfügt, kommt es zu Verwechslungen. Zweitens: JSON-Parameter werden an beliebigen Zeichenpositionen getrennt; wenn man schon nach der Hälfte parst, wird eine Exception ausgelöst. Drittens: Die Verbindung bricht mittendrin ab, ohne dass ein Abschlussereignis empfangen wird, und die Oberfläche bleibt dauerhaft im Zustand „Generiert“. Die Konvertierungsschicht muss diese drei Fälle explizit behandeln.
2.5 JSON Schema: strukturierte Ausgaben und Unterschiede bei multimodalen Fähigkeiten
Alle drei Anbieter bieten strukturierte Ausgaben, doch bei den unterstützten JSON-Schema-Features, den Strict-Modi und der Kombination mit Tool-Aufrufen gibt es Unterschiede. Claude unterscheidet offiziell zwei Mechanismen: JSON outputs legt die Struktur der finalen Antwort fest, Strict tool use die Struktur der Parameter von Tool-Aufrufen. Bei einigen Modellen entstehen im Strict-Format zusätzliche Kosten für das Kompilieren oder Caching des Schemas.
Aus engineering-Perspektive empfiehlt es sich, dass die Anwendung ein eigenes Standard-JSON-Schema pflegt und in einer Fähigkeits-Registry festhält, welche Schema-Features welches Modell unterstützt. Features, die nicht unterstützt werden, konvertiert der Adapter in eine abgestufte Variante. Unabhängig davon, wie strikt ein Modell laut Hersteller ist, sollte die Anwendung stets eine eigene Validierung durchführen und bei Fehlschlag in einen kontrollierten Retry- oder Fehlerpfad wechseln.
Bei Multimodalität gilt dasselbe. „Unterstützt Bild-Input“ beschreibt nur die Fähigkeitskategorie; konkret vergleichen sollte man folgende Punkte: akzeptierte Dateitypen, Größen und Bildanzahl, Video- und Audio-Fähigkeiten, Upload-Verfahren für Dateien, Obergrenze des Kontextfensters und tatsächlich nutzbarer Bereich, maximale Output-Token sowie die Frage, ob Tool-Aufrufe mit multimodalem Input kombinierbar sind. Dass die Claude-Kompatibilitätsschicht keine audio- und file-Inputs unterstützt, ist eine konkrete Einschränkung, die in die Registry gehört.
2.6 Modellübergreifende Unterschiede bei Caching, Abrechnung und Fehlerbehandlung
Die Mechanismen für das Caching von Eingabeaufforderungen (Prompts) unterscheiden sich bei den drei Anbietern deutlich:
- OpenAI: GPT-5.6 und spätere Modelle unterstützen implizites Caching sowie explizite Cache-Breakpoints; die TTL gibt es in zwei Varianten – 30 Minuten und 12 Stunden.
- Claude: Über
cache_controllässt sich automatisches oder explizites Caching festlegen, mit den beiden Modi 5 Minuten und 1 Stunde; in der OpenAI-kompatiblen Schicht wird diese Funktion nicht unterstützt. - Gemini: Die neuen Modelle bieten automatisches, implizites Caching; einige APIs und Modelle unterstützen das explizite Anlegen von Cache-Objekten.
Nach einem Modellwechsel lässt sich der Cache des ursprünglichen Anbieters in der Regel nicht weiterverwenden. Wer mitten in einer Sitzung von Claude zu Gemini wechselt, wird für die erste Anfrage nach der vollständigen Eingabe abgerechnet. Geht die Kostenschätzung standardmäßig davon aus, dass „der Cache immer trifft“, fallen die Abweichungen auf der Rechnung umso größer aus, je häufiger die Wechselstrategie gewechselt wird.
Auch bei den Standardpreisen gibt es deutliche Unterschiede zwischen den Anbietern. Die offiziellen Standardpreise mit Stand 2026-11-13 (USD / Million Token):
| Modell | Eingabe | Ausgabe | Anmerkung |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Tool-Aufrufe erfordern die Responses API |
| GPT-6.1 Sol | $1 | $5 | Tool-Aufrufe erfordern die Responses API |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | Aktionspreis bis 2026-12-31; ab 2027-01-01 ist eine Anpassung auf $1.50 / $7.50 geplant |
Diese Tabelle dient dazu, die Abrechnungsunterschiede zu veranschaulichen. Die Modelle unterscheiden sich in ihren Fähigkeiten und Nutzungsbedingungen, ein hoher oder niedriger Preis lässt sich nicht direkt in einen Leistungsvergleich umrechnen. Ebenfalls nicht enthalten sind Kosten für Cache-Schreibvorgänge, Tool-Aufrufe, Service-Stufen und Aufschläge von Drittanbietern.
💰 Tipp zur Kostenkalkulation: Bei Multi-Modell-Anwendungen sollte die Abrechnung nach folgenden Positionen getrennt erfasst werden: normale Eingabe, Cache-Schreibvorgang, Cache-Treffer, Denk- und Ausgabeanteil, Tool-Kosten sowie Zuschläge für langen Kontext. Wenn Sie mehrere Modelle über APIYI apiyi.com einheitlich aufrufen, sehen Sie die Nutzung der einzelnen Modelle an einer Stelle und können so die Routing-Strategie mit den tatsächlichen Kosten abgleichen.
Bei der Fehlerbehandlung unterscheiden sich die drei Anbieter in Anfragefrequenz, Token-Rate, Kontingenten, Timeouts und Fehlerformaten. Eine Anwendung sollte deshalb eine einheitliche Fehlerklassifikation aufbauen: fehlgeschlagene Authentifizierung, nicht unterstütztes Modell, ungültige Parameter, zu große Anfrage bzw. Kontextüberschreitung, 429-Ratenlimit, Serverfehler, Verbindungsabbruch, unterbrochener Antwortstream und fehlgeschlagener Tool-Aufruf.
Beim Modell-Fallback muss außerdem berücksichtigt werden, ob die Aufgabe Seiteneffekte hat. Läuft beim Hauptmodell erst nach der Tool-Ausführung ein Timeout auf und das System wechselt automatisch auf das Ersatzmodell, um die gesamte Aufgabe erneut auszuführen, können Vorgänge wie Bezahlen, E-Mails versenden oder Dateien ändern zweimal ausgeführt werden. Die Lösung: Versehen Sie Tools mit Seiteneffekten mit Idempotenz-Schlüsseln, und setzen Sie den Fallback nur ab den „noch nicht ausgeführten Schritten“ fort.
3 Wie sollte eine kompatible Architektur für Multi-Modell-APIs gestaltet sein
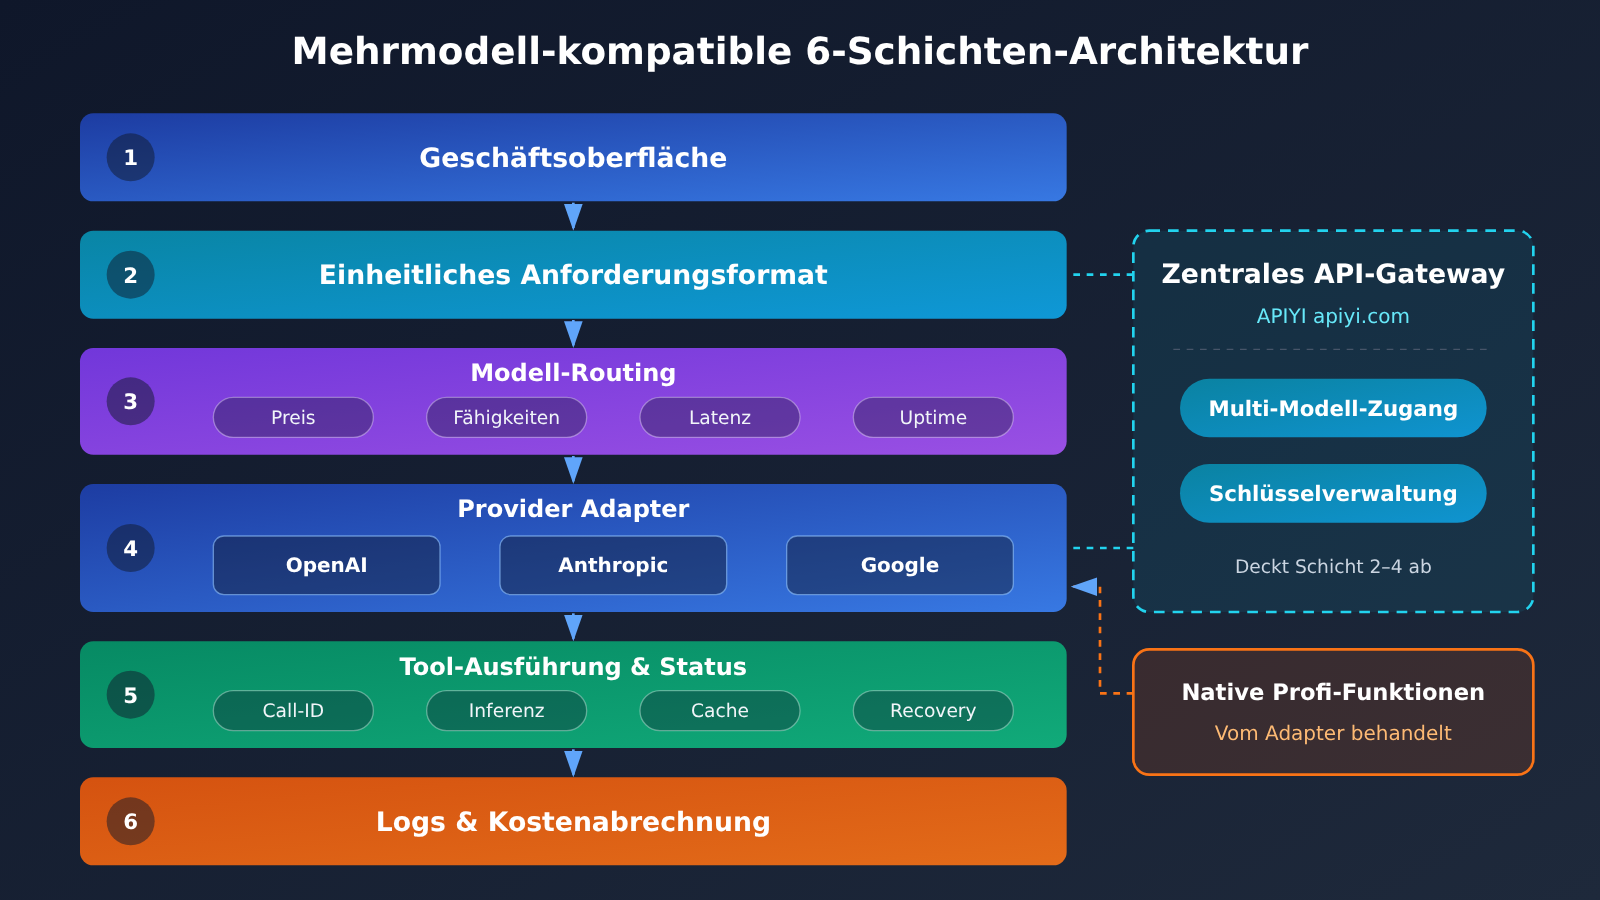
Die empfohlene sechsstufige Struktur sieht wie folgt aus:
- Geschäftliche Oberfläche: Nutzer stellen Fragen, laden Materialien hoch und wählen Modell und Aufgabe.
- Einheitliches Anforderungsformat: Eine einheitliche Struktur für Nachrichtenverlauf, Anhänge, Werkzeugliste, Anforderungen an strukturierte Ausgabe, Reasoning-Intensität und Aufgaben-ID.
- Modell-Routing: Auswahl von GPT, Claude oder Gemini anhand von Preis, Fähigkeit, Latenz, Verfügbarkeit und Geschäftsregeln.
- Provider-Adapter: Wandelt Standardanforderungen in die jeweiligen nativen Formate um und bildet die zurückgegebenen Ergebnisse wieder auf das interne Format ab.
- Werkzeugausführung und Zustandsverwaltung: Verwaltung von Aufruf-ID, Ausführungsprotokoll, Konversationskontext, Anbieter-Reasoning-Status, Cache und Fehlerwiederherstellung.
- Protokollierung und Kostenabrechnung: Erfassung von Modell, Token, tatsächlichen Kosten, Latenz, Cache, Fehlern und Werkzeugaufrufen für jede Anfrage.
3.1 Einheitliches Format für Nachrichten und Tools festlegen
Der Kern des einheitlichen Formats besteht darin, den Verlauf in zwei Ebenen zu speichern. Die erste Ebene ist der universelle Standardverlauf: Nutzernachrichten, die endgültige Antwort des Modells, Tool-Anfragen und Tool-Ergebnisse – alles, was jeder Anbieter verstehen kann. Die zweite Ebene ist anbieterspezifischer Zustand, etwa Reasoning-Einträge, Thinking-Signaturen oder Thought-Blöcke. Er wird pro Anbieter getrennt abgelegt und nur dann unverändert zurückgegeben, wenn derselbe Anbieter angefragt wird.
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # Einheitliche Aufruf-ID; der Adapter bildet sie auf die Anbieter-ID ab und umgekehrt
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # Muss bei Tools mit Seiteneffekten gesetzt werden

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # Multimodale Blöcke, z. B. Text und Bilder
    tool_calls: list[ToolCall] = field(default_factory=list)
    # Anbieterspezifischer Zustand: Schlüssel ist der Anbietername, Wert sind unverändert gespeicherte Signatur-/Reasoning-Blöcke
    vendor_state: dict[str, Any] = field(default_factory=dict)
Beim Modellwechsel liest der Adapter die Standardfelder und erzeugt eine neue Anfrage. Teile von vendor_state, die zu anderen Anbietern gehören, werden nicht gesendet; Teile, die zum Zielanbieter gehören, werden unverändert zurückgegeben.
3.2 Native APIs über Provider-Adapter anbinden
Jeder Adapter übernimmt drei Aufgaben:
- Eingabeumwandlung: Rollenzuordnung (z. B.
systemin ein separates Feld bei Claude verschieben), Umwandlung von Tool-Definitionen, Schema-Downgrade, Zuordnung von Reasoning-Stufen. - Ausgabeumwandlung: Native Antworten und Streaming-Events in die internen Events aus Abschnitt 2.4 umwandeln, Tool-Call-IDs in einheitliche IDs abbilden.
- Zustandsverwaltung: Anbieterspezifische Zustände wie Signaturen und Reasoning-Elemente extrahieren und speichern und entscheiden, ob serverseitige Fortsetzung (
previous_response_id,previous_interaction_id) oder eine vollständige Rückgabe der Historie verwendet wird.
Einfache Frage-Antwort-Szenarien können über den gemeinsamen Adapter im OpenAI-kompatiblen Format laufen. Für Szenarien, die strikte Tool-Parameter, Cache-Steuerung oder verschlüsselte Denkzustände erfordern, implementiert man dann jeweils native Adapter. So bleibt der Komfort des einheitlichen Einstiegspunkts erhalten, und gleichzeitig bekommen erweiterte Fähigkeiten einen klaren Platz.
3.3 Verfügbare Funktionen über ein Capability-Register bestimmen
Das Capability-Register erfasst die tatsächliche Unterstützung pro „Modell + Endpunkt“-Kombination. Dasselbe Modell kann über die native API und über die Kompatibilitätsschicht zwei verschiedene Einträge haben. Hier ein Strukturbeispiel – konkrete Werte müssen anhand der offiziellen Dokumentation und Ihrer eigenen Testergebnisse ermittelt werden:
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # Tool-Calls erfordern die Responses API
  reasoning_effort: [low, medium, high]   # akzeptiert kein none
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # Kompatibilitätsschicht ignoriert strict
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
Die Routing-Schicht fragt das Register ab, bevor sie ein Modell auswählt. Enthält eine Anfrage eine Datei, werden Einträge mit file_input: false ausgeschlossen. Braucht man strikte Tool-Parameter, werden nur Einträge mit strict_tools: true ausgewählt. Auch die Produktoberfläche kann darauf basierend Optionen ausblenden, die das aktuelle Modell nicht unterstützt – so lösen Nutzer seltener Fehler aus.
4 Tests und Beobachtung vor dem Launch der Multi-Modell-API-Kompatibilität
4.1 Sechs Kompatibilitätstests von einfacher Frage-Antwort bis zur mehrstufigen Tool-Kette
Nach aufsteigender Komplexität absolvieren Sie nacheinander die folgenden sechs Tests:
- Normale Frage-Antwort: Denselben Prompt an drei Modelle senden und prüfen, ob Antwortinhalt und Token-Statistik normal sind.
- Streaming-Ausgabe: Bestätigen, dass die Ausgabe kontinuierlich eintrifft und ein korrektes Endsignal empfangen wird.
- Tool-Aufruf: Das Modell ruft ein Wetterabfrage- oder Datenabfrage-Tool auf, die Anwendung führt es aus und übermittelt das Ergebnis zurück.
- Multi-Tool-Schleife: Mehr als zwei aufeinanderfolgende Runden von Tool-Aufrufen, wobei Verlauf und Aufruf-IDs vollständig sein müssen.
- Strukturiertes JSON: Ausgabe nach demselben Schema und Validierung der Struktur mit einem anwendungsseitigen Validator.
- Modellwechsel: Dieselbe Geschäftssitzung wechselt zwischen GPT, Claude und Gemini, und es wird bestätigt, dass Kontext, Tool-Aufzeichnungen und endgültige Antworten normal sind.
Die Tests 4 und 6 decken Probleme mit dem Inferenzzustand am besten auf und sollten in die Continuous-Integration-Pipeline aufgenommen werden. Bei jedem Upgrade einer Modellversion oder Wechsel des Zugangs-Endpunkts sollten sie erneut ausgeführt werden.
4.2 Einheitliche Beobachtung von Kosten und Stabilität etablieren
Bei jeder Anfrage sollten mindestens folgende Felder protokolliert werden: Modell und Endpunkt, Erfolgsquote der Anfrage, Fehlertyp (gemäß der Klassifizierung in Abschnitt 2.6), Latenz bis zum ersten Token und Gesamtdauer der Aufgabe, aufgeschlüsselte Token (Eingabe, Cache-Schreiben, Cache-Treffer, Denken, Ausgabe), Anzahl der Tool-Aufrufe und Fehlschläge, Anzahl der Wiederholungen und Fallbacks.
Bei der Bewertung eines Modells sollten die Gesamtdauer und die Gesamtkosten der vollständigen Aufgabe betrachtet werden; die Daten einer einzelnen Anfrage haben nur begrenzten Referenzwert. Ein Modell mit niedrigem Stückpreis kann in Summe sogar teurer sein, wenn es eine hohe Fehlerquote bei Tool-Parametern aufweist und mehrere Wiederholungsrunden benötigt.
5 Die Rolle eines einheitlichen API-Gateways bei der Kompatibilität mehrerer Modell-APIs
5.1 Anbindungs- und Wartungskosten
Drei Modelle gleichzeitig zu nutzen bedeutet drei Konten, drei Schlüssel, drei Abrechnungen und drei SDK-Konfigurationen. Ein einheitliches API-Gateway bündelt diese Arbeit in einem einzigen Einstiegspunkt: zentrale Verwaltung von Modellanbindung und Zugangsdaten, weniger Konfigurationspflege pro Anbieter, Auswahl und Wechsel des Modells auf Konfigurationsebene sowie eine einheitliche Beobachtung von Nutzung und Kosten. Für Teams, die Modellergebnisse häufig vergleichen müssen, sinkt damit auch die Hürde, ein neues Modell auszuprobieren.
5.2 Die Positionierung von APIYI: Aufgabenteilung zwischen einheitlichem Einstiegspunkt und Anpassung nativer Fähigkeiten
APIYI ist eine API-Aggregationsplattform für große KI-Sprachmodelle. Mit einem einzigen API-Schlüssel lassen sich über eine OpenAI-kompatible Schnittstelle gängige Modelle wie OpenAI, Claude und Gemini aufrufen – abgerechnet nach Verbrauch. Damit eignet sich APIYI für die Ebene des „einheitlichen Aufrufeinstiegspunkts“ in der Architektur: normale Frage-Antwort-Interaktionen, Streaming-Ausgabe, Modellvergleiche und Multi-Modell-Routing lassen sich direkt anbinden.
Ein einheitlicher Aufrufeinstiegspunkt und vollständige Übereinstimmung mit den nativen Fähigkeiten des Herstellers sind zwei verschiedene technische Anforderungen. Bei der Anbindung eines konkreten Modells muss im Fähigkeitsregister weiterhin Punkt für Punkt geprüft werden, in welchem Umfang Tool-Aufrufe, Reasoning-Status, Multimodalität, Caching und strukturierte Ausgabe unterstützt werden. Bei Ketten, die auf native Fähigkeiten wie die Responses API, cache_control oder verschlüsselte Signaturen angewiesen sind, sollte man erst nach Bestätigung, dass der entsprechende Endpunkt tatsächlich verfügbar ist, live gehen – oder einen eigenen nativen Adapter dafür vorhalten.
Schneller Einstieg in die Kompatibilität mit mehreren Modell-APIs
Minimalbeispiel: Drei Modelle mit derselben Eingabeaufforderung vergleichen
Der folgende Code ruft mit demselben OpenAI-SDK-Client nacheinander drei Modelle auf – das entspricht Test 1 aus Abschnitt 4.1.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

# Modell-IDs gemäß der Modellliste der Plattform
MODELS = ["你的GPT模型ID", "你的Claude模型ID", "你的Gemini模型ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
Vollständige Implementierung ansehen: einheitliche Streaming-Events + Fähigkeitsregister + Tool-Validierung
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

# Fähigkeitsregister: Werte dienen nur als Strukturbeispiel, bitte anhand der offiziellen Dokumentation und eigener Testergebnisse pflegen
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # Tool-Aufrufe müssen über den Responses-Adapter laufen
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """Einheitliche Fehlerklassifizierung, entscheidet über die Wiederholbarkeit"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # mit Backoff wiederholbar
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # Parameterfehler oder Kontextüberschreitung – nicht blind wiederholen
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """Wandelt einen Stream im OpenAI-kompatiblen Format in interne, einheitliche Ereignisse um"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # Parameterfragmente paralleler Tool-Aufrufe nach Index zusammensetzen
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # Stream mittendrin abgebrochen

EXECUTED_KEYS: set[str] = set()   # In der Produktion bitte durch persistenten Speicher ersetzen

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """Erst Parameter validieren, dann idempotent ausführen"""
    try:
        args = json.loads(call["args"])   # erst parsen, wenn alle Fragmente vollständig sind
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# Anwendungsbeispiel
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 Schnellstart: Melden Sie sich bei APIYI apiyi.com an, um kostenloses Testguthaben zu erhalten, und führen Sie mit dem obigen Code unter demselben Key die ersten beiden Tests aus Abschnitt 4.1 aus. Tests zu Tool-Aufrufen und mehrstufiger Inferenz validieren Sie bitte Modell für Modell anhand der Fähigkeitsregistrierung.
Häufige Fragen (FAQ)
Q1: Worum geht es bei Multi-Modell-API-Kompatibilität hauptsächlich?
Gemeint sind die Unterschiede, die eine Anwendung beim Wechsel zwischen GPT, Claude und Gemini aufgrund der unterschiedlichen nativen API-Strukturen bewältigen muss. Sie lassen sich in sechs Kategorien unterteilen: Nachrichtenrollen, Tool-Aufrufe, Inferenzstatus, Streaming-Ereignisse, strukturierte Ausgaben und Multimodalität sowie Cache-Abrechnung und Fehlerbehandlung.
Q2: Braucht man beim Aufruf von Claude und Gemini über die OpenAI-kompatible Schnittstelle noch eine Anpassungsschicht?
Für normale Chats lässt sich die kompatible Schnittstelle direkt verwenden. Sobald es um strenge Tool-Parameter, Prompt Caching, Dateieingaben oder verschlüsselte Denkzustände geht, ist eine Anpassungsschicht nötig. Am Beispiel der offiziellen Claude-Kompatibilitätsschicht: Sie ignoriert `strict` und unterstützt weder Caching noch audio/file-Eingaben. Solche Unterschiede gehören in die Fähigkeitsregistrierung.
Q3: Sollten neue Gemini-Projekte die Interactions API oder generateContent verwenden?
Die Interactions API ist im Juni 2026 in den GA-Status übergegangen, und Google empfiehlt neuen Projekten, sie vorrangig einzusetzen. Sie unterstützt serverseitigen Sitzungszustand, `previous_interaction_id` und die steps-Struktur. `generateContent` wird weiterhin unterstützt; bestehende Projekte können nach Plan migrieren.
Q4: Wie geht man mit dem Verlauf um, wenn mitten in einer Sitzung das Modell gewechselt wird?
Benutzernachrichten, endgültige Antworten, Tool-Anfragen und Tool-Ergebnisse werden als Standardhistorie gespeichert und nach dem Wechsel vom Ziel-Adapter neu zusammengesetzt. Herstellerspezifische Zustände wie Signaturen und Reasoning-Elemente werden separat gespeichert und nur beim Aufruf desselben Anbieters unverändert zurückgesendet. Außerdem lässt sich der Cache des ursprünglichen Anbieters nach einem Wechsel in der Regel nicht wiederverwenden, sodass für die erste Runde die vollen Eingabekosten eingeplant werden müssen.
Q5: Wie lässt sich die Kompatibilität der drei Modelle in meinem Geschäftsfall schnell überprüfen?
Empfohlen ist folgendes Vorgehen:
1. Besuchen Sie APIYI apiyi.com, registrieren Sie ein Konto und erhalten Sie einen API-Schlüssel sowie kostenloses Testguthaben.
2. Verwenden Sie den Code aus diesem Artikel, setzen Sie base_url auf die API-Adresse von APIYI und tragen Sie die drei Modell-IDs ein.
3. Führen Sie die sechs Tests aus Abschnitt 4.1 schrittweise aus und protokollieren Sie Erfolgsrate, Fehlertypen, Kosten und Gesamtdauer.
Q6: Was ist beim Einrichten eines automatischen Modell-Fallbacks zu beachten?
Zuerst ist zu prüfen, ob die Aufgabe Nebenwirkungen hat. Tools wie Zahlungen, E-Mail-Versand oder Dateiänderungen müssen einen Idempotenzschlüssel mitführen; beim Fallback wird dann ab dem nicht abgeschlossenen Schritt fortgesetzt, damit die gesamte Aufgabe nicht erneut ausgeführt wird. Für Rate-Limits und Serverfehler eignet sich ein Retry mit Backoff; bei Parameterfehlern und Überschreitung des Kontextfensters muss die Anfrage korrigiert und dann erneut gesendet werden.
Q7: Wie lassen sich die Kosten beim Multi-Modell-Routing kontrollieren?
Erfassen Sie die Kosten Token-genau nach Einzelposten und vergleichen Sie die Gesamtkosten einer vollständigen Aufgabe. Die drei Anbieter unterscheiden sich deutlich im Preis – so kostet die Ausgabe bei GPT-6 Astra 50 US-Dollar pro Million Token, während Gemini 3.8 Flash derzeit zum Aktionspreis von 3,75 US-Dollar angeboten wird. Wenn Sie die Nutzung aller Modelle zentral bei APIYI apiyi.com einsehen, erkennen Sie teure Pfade schneller und können die Routing-Regeln entsprechend anpassen.
Q8: Welche Grenzen hat ein einheitliches API-Gateway?
Das Gateway vereinheitlicht den Aufrufeingang, die Schlüssel und die Abrechnung. Ob die herstellereigenen erweiterten Funktionen (etwa der exklusive Tool-Aufruf der Responses API, `cache_control` oder die Rückgabe verschlüsselter Signaturen) verfügbar sind, hängt davon ab, was der jeweilige Endpunkt unterstützt – das muss Punkt für Punkt in der Praxis getestet werden. Ketten, die auf diese Funktionen angewiesen sind, sollten den nativen Adapter als Ergänzung beibehalten.
Kernpunkte zur Kompatibilität mehrerer Modell-APIs
- Modell wechseln ≠ ID wechseln: Einfache Frage-Antwort-Abläufe lassen sich direkt migrieren; bei Agent-Ketten müssen sechs Arten von Unterschieden behandelt werden.
- Die Kompatibilitätsschicht hat Grenzen: Die Claude-Kompatibilitätsschicht ignoriert
strictund unterstützt weder Caching noch Dateieingaben. - Signaturen müssen unverändert gespeichert werden: Der Verlust von thinking-/thought-Signaturen ist eine häufige Ursache für Fehler in mehrstufigen Tool-Ketten.
- Streaming-Ereignisse vereinheitlichen: Das Backend gibt 8 interne Ereignistypen aus, das Frontend bindet nur an ein einziges Protokoll an.
- Eine Fähigkeitsregistrierung steuert das Routing: Die tatsächlich unterstützten Funktionen werden pro Einheit aus „Modell + Endpunkt“ erfasst.
- Fallbacks müssen idempotent sein: Tools mit Seiteneffekten bekommen einen Idempotenzschlüssel, um doppelte Ausführung zu verhindern.
- Erst testen, dann live gehen: Mit dem kostenlosen Kontingent von APIYI apiyi.com die sechs Kompatibilitätstests erfolgreich durchlaufen.
Zusammenfassung
Wenn eine Anwendung gleichzeitig GPT, Claude und Gemini anbinden soll, ist der Schlüssel, die Unterschiede in wenigen zentralen Komponenten zu bündeln:
- Einheitliches Nachrichten- und Werkzeugformat: Standardverlauf und herstellerspezifischer Zustand werden in getrennten Schichten gespeichert, sodass der Kontext beim Modellwechsel nicht verloren geht.
- Provider-Adapter: übernimmt die Eingabeumwandlung, die Ausgabeumwandlung und die Zustandsbehandlung; native Premium-Funktionen werden hier implementiert.
- Fähigkeitsregister: dokumentiert wahrheitsgemäß, welche Modelle und Endpunkte Werkzeuge, Reasoning, Multimodalität, Schemas und Caching unterstützen, und entscheidet über Routing und UI-Optionen.
Darauf aufbauend sichern sechs Kompatibilitätstests und eine Kostenbeobachtung pro Einzelposten die Qualität vor dem Launch ab. In der Phase normaler Aufrufe und Modellvergleiche empfiehlt es sich, über APIYI apiyi.com mit einem einzigen Key schnell eine Multi-Modell-Validierung durchzuführen und anschließend anhand der Testergebnisse zu entscheiden, welche Pfade eine native Anpassung benötigen.
📚 Referenzen
- OpenAI Function Calling: Werkzeugaufrufe,
call_idundfunction_call_output - Link:
developers.openai.com/api/docs/guides/function-calling -
Beschreibung: maßgebliche Dokumentation des Werkzeugaufruf-Protokolls der Responses API
-
OpenAI-Leitfaden zur Migration auf die neuesten Modelle: Reasoning-Parameter und Schnittstellenanforderungen der GPT-6-Serie
- Link:
developers.openai.com/api/docs/guides/latest-model -
Beschreibung: Grenzen der Werte von
reasoning.effortund Anforderungen der Responses API -
OpenAI Prompt Caching: Cache-Breakpoints und TTL
- Link:
developers.openai.com/api/docs/guides/prompt-caching -
Beschreibung: implizite und explizite Caching-Mechanismen
-
Claude-Kompatibilität mit dem OpenAI SDK: Umfang und Grenzen der Kompatibilitätsschicht
- Link:
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
Beschreibung: Unterschiede bei
strict, Caching, Dateieingaben, system-Zusammenführung und dergleichen -
Claude Extended Thinking: Adaptive Thinking und Thinking-Signaturen
- Link:
platform.claude.com/docs/en/build-with-claude/extended-thinking -
Beschreibung: Regeln für die Rückgabe von Thinking-Blöcken bei mehrstufigen Werkzeugaufrufen
-
Claude Structured Outputs und Caching: JSON-Ouputs, Strict Tool Use,
cache_control - Link:
platform.claude.com/docs/en/build-with-claude/structured-outputs - Link:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Beschreibung: strukturierte Constraints und Caching-Modi
-
Gemini Interactions API und OpenAI-Kompatibilität: neue Schnittstelle und Kompatibilitätseinstieg
- Link:
ai.google.dev/gemini-api/docs/interactions-overview - Link:
ai.google.dev/gemini-api/docs/openai -
Beschreibung: steps-Struktur, Sitzungszustand und Mapping kompatibler Parameter
-
Gemini Thinking-Signaturen, Werkzeugaufrufe und Caching
- Link:
ai.google.dev/gemini-api/docs/thought-signatures - Link:
ai.google.dev/gemini-api/docs/function-calling - Link:
ai.google.dev/gemini-api/docs/caching -
Beschreibung: Beibehaltung von Signaturen im stateless-Modus, Werkzeugprotokoll und explizites Caching
-
Offizielle Preisseiten der drei Anbieter
- Link:
developers.openai.com/api/docs/pricing - Link:
platform.claude.com/docs/en/models/sonnet-5-5/overview - Link:
ai.google.dev/gemini-api/docs/pricing - Beschreibung: Datenquellen der Preistabelle in diesem Artikel, Stand der Prüfung 2026-11-13
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com


