
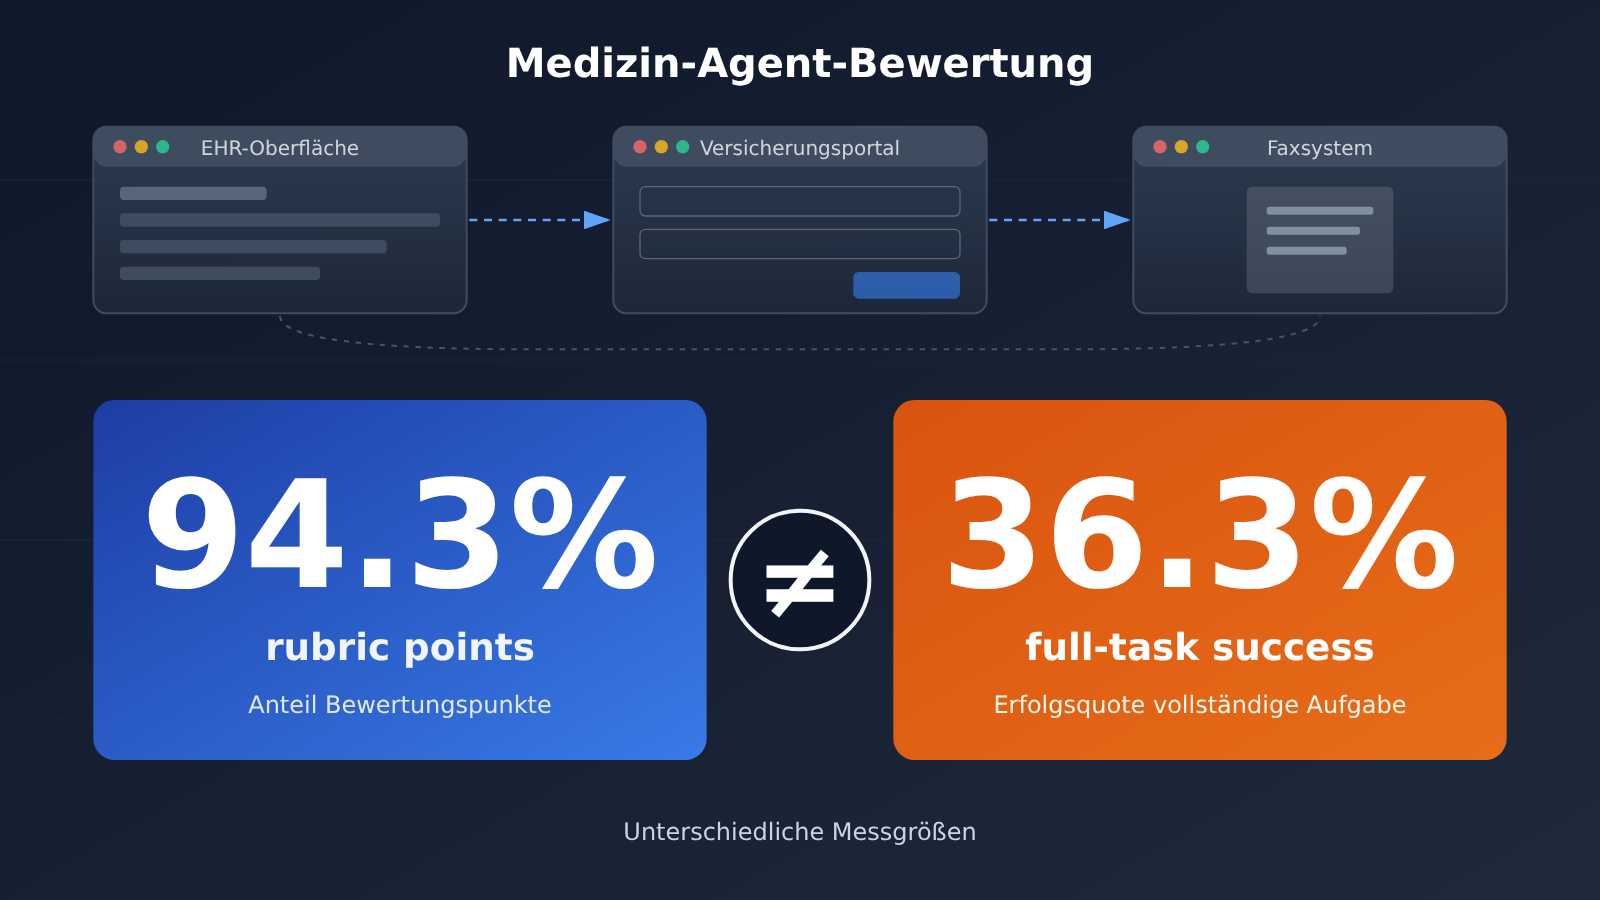
94.3% bedeuten nicht, dass 94.3% der medizinischen Verwaltungsaufgaben vollständig erledigt wurden. Die 94.3%, die OpenAI am 16. November 2026 für GPT-6 Astra veröffentlicht hat, sind der bei HealthAdminBench erreichte Anteil an rubric points (Bewertungspunkten); die 36.3% für Claude Opus 4.6 CUA in einer Arbeit des Stanford Shah Lab sind die Erfolgsquote bei vollständigen Aufgaben (full-task success). Die erste Kennzahl misst, „wie viele Bewertungspunkte erfüllt wurden“, die zweite, „bei wie vielen Aufgaben alle Erfolgskriterien erfüllt sind“. Es handelt sich nicht um dieselbe Kennzahl, und beide gehören nicht in dieselbe Rangliste.
Ein medizinischer Agent kann bei Einzeloperationen wie Informationsrecherche, Dokumentenverarbeitung und Formularausfüllung hervorragend abschneiden und trotzdem einen systemübergreifenden Geschäftsprozess nicht zuverlässig zu Ende bringen. Ob ein Agent echten Produktionsnutzen bietet, lässt sich nur beurteilen, wenn man Teilaufgabenleistung, End-to-End-Erfolgsquote, Fehlertypen, Ausführungskosten und menschliche Eingriffe gemeinsam betrachtet; eine einzelne Punktzahl reicht dafür nicht.
Das erfahren Sie in diesem Artikel:
- Was 94.3% und 36.3% jeweils messen und warum man sie nicht direkt vergleichen kann
- Wie sich die Aufgaben von HealthAdminBench zusammensetzen, woher die Bewertungspunkte stammen und welche zwei Validierungsmechanismen es gibt
- Ein Bewertungsrahmen für Produktionsumgebungen, der sich auf andere Unternehmens-Agenten übertragen lässt
Überblick: Der Teil mit den objektiven Fakten erläutert der Reihe nach, warum das Ergebnis von 94.3% Aufmerksamkeit erregt hat, was HealthAdminBench tatsächlich misst, worin sich Teilaufgabenerfolg und Erfolg bei vollständigen Aufgaben unterscheiden, an welchen Stellen medizinische Agenten am häufigsten scheitern und warum dasselbe Modell je nach Ausführungsrahmen unterschiedlich abschneiden kann; der analytische Teil behandelt, wie sich ein umfassender Evaluierungsrahmen aufbauen lässt, wie man Kosten kalkuliert und welche Abwägungen Unternehmen im Einsatz treffen sollten.
Zum Verständnis: Die 7 Konzepte der Evaluation medizinischer Agenten
| Konzept | Kurze Erklärung |
|---|---|
| Computer Use | Die Fähigkeit, Aufgaben zu erledigen, indem die Software-Oberfläche beobachtet und Klicks, Eingaben, Scrollen und ähnliche Aktionen simuliert werden |
| EHR | Elektronisches Patientenaktensystem – die zentrale Software in Krankenhäusern zur Speicherung von Patienten- und Behandlungsinformationen |
| MCP | Ein Standardprotokoll zum Auffinden und Aufrufen externer Tools |
| RPA | Ein Automatisierungsansatz, bei dem wiederkehrende Abläufe über vordefinierte Regeln oder Skripte ausgeführt werden |
| Rubrik-Punkte | Bewertungspunkte, die nach den Evaluationsregeln vergeben werden und messen, inwieweit einzelne Anforderungen erfüllt sind |
| End-to-End-Erfolgsrate | Anteil der vollständigen Aufgaben, die alle Erfolgsbedingungen erfüllen; scheitert eine kritische Bedingung, gilt die Aufgabe als fehlgeschlagen |
| Trace | Nachweis der Ausführung in Form von aufgezeichnetem Ablauf, Aktionen und Oberflächenzuständen |
Auswirkungen der Evaluation medizinischer Agenten auf einen Blick
- Entwickler und technische Verantwortliche: Für die Auswahl darf nicht ausschließlich eine einzelne, vom Anbieter veröffentlichte Punktzahl herangezogen werden. Vielmehr müssen der Ausführungsmechanismus, die End-to-End-Abschlussrate und die Gesamtkosten – einschließlich Screenshots, Wiederholungsversuchen und Laufzeitumgebung – anhand der eigenen Aufgaben überprüft werden.
- Medizinische Einrichtungen und Workflow-Verantwortliche: Es gilt, vier Arten von Evidenz zu unterscheiden: Demonstrationen in synthetischen Umgebungen, Benchmark-Evaluierungen, Pilotprojekte in Einrichtungen und Produktionsfälle. Beim Deployment müssen menschliche Freigaben, das Prinzip der minimalen Berechtigungen und die Auditierung von Aktionen umgesetzt werden.
Faktenlage: Die Bewertung medizinischer Agents hinter 94,3 % und 36,3 %
Warum der Wert von 94,3 % Aufmerksamkeit erregt
Am 16. November 2026 stellte OpenAI Fortschritte bei Computer-Use-Agents für medizinische Teams vor und veröffentlichte dazu mehrere Bewertungsdatensätze. GPT-6 Astra erreicht in HealthAdminBench 94,3 %, GPT-6 Luna 91,8 % – beide wurden mit maximalem Reasoning-Aufwand (maximum reasoning effort) evaluiert. Gleichzeitig gab OpenAI an, dass eine einzelne Aufgabe mit Luna 0,085 US-Dollar kostet und damit 98 % günstiger ist als mit Astra.
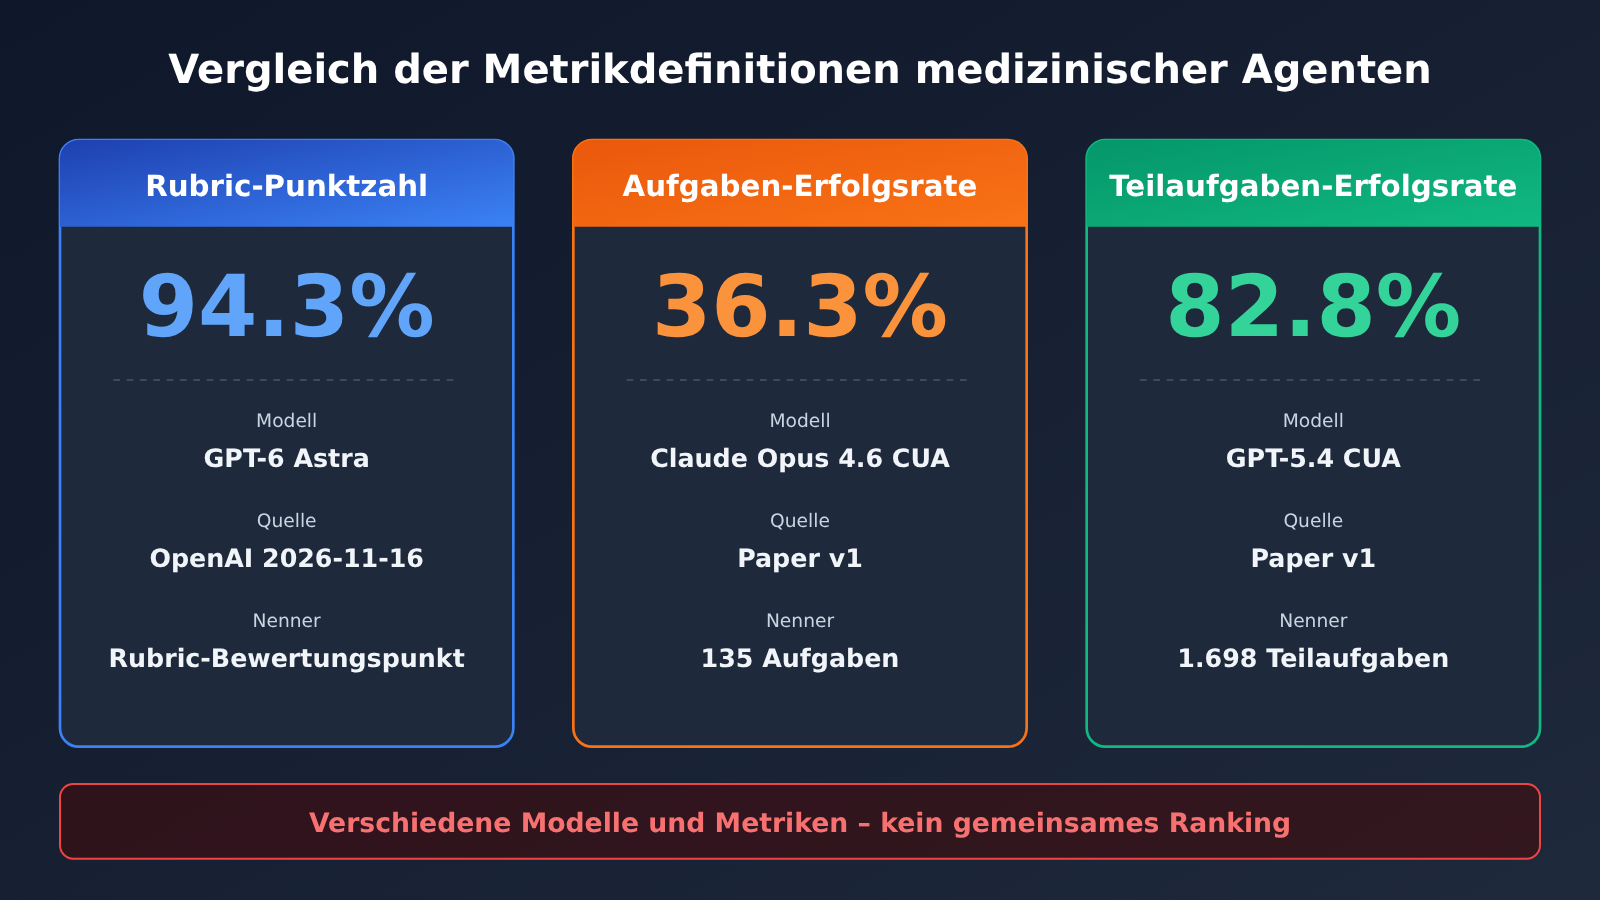
Bemerkenswert sind diese Zahlen, weil die zuvor von Stanford veröffentlichten HealthAdminBench-Ergebnisse deutlich niedriger lagen. Wichtig ist dabei: Die von OpenAI genannten 94,3 % und 91,8 % sind der Anteil erreichter Rubric-Punkte und keine unabhängig ermittelte Erfolgsquote bei vollständigen Aufgaben. Auch die beiden anderen Werte aus derselben Mitteilung stammen aus unterschiedlichen Auswertungsschritten und haben jeweils einen anderen Nenner:
| Kennzahl | Wert | Nenner/Bezugsgröße | Was sie nicht aussagt |
|---|---|---|---|
| HealthAdminBench-Score (Astra) | 94,3 % | Anteil der Rubric-Punkte | Erfolgsquote bei vollständigen Aufgaben |
| HealthAdminBench-Score (Luna) | 91,8 % | Anteil der Rubric-Punkte | Erfolgsquote bei vollständigen Aufgaben |
| Sicherheit bei klinischen Aufgaben (Astra) | 99 % | 325 geprüfte Aufgaben | medizinische Diagnosegenauigkeit |
| Anteil hoher ärztlicher Zustimmung (Astra) | 93 % | 646 ärztliche Bewertungen | Erfolgsquote – und ebenso wenig 646 Ärztinnen und Ärzte |
| Kosten pro Aufgabe (Luna) | 0,085 $ | Kosten pro Aufgabe unter bestimmten Testbedingungen | Preis für den Produktivbetrieb |
Diese drei Datensätze haben unterschiedliche Nenner und lassen sich nicht zu einer „Gesamtgenauigkeit“ zusammenrechnen. Hinzu kommt: Der OpenAI-Text veröffentlicht weder Ergebnisse pro Aufgabe noch die vollständige Versuchskonfiguration, Konfidenzintervalle oder alle Fehlerfälle. Von außen lässt sich derzeit nicht unabhängig prüfen, woraus sich die 94,3 % zusammensetzen. Die Kosten pro Aufgabe liegen bei Astra bei rund 4,25 US-Dollar – dieser Wert ist aus dem Rückgang um 98 % zurückgerechnet und keine offiziell genannte Zahl.
Was misst HealthAdminBench eigentlich?
HealthAdminBench wurde vom Shah Lab der Stanford University entwickelt und bewertet speziell die Leistung von Agenten zur Computerbedienung bei medizinischen Verwaltungsaufgaben. Die öffentlich zugänglichen Versionen unterscheiden sich: Die frühe Projektseite beschreibt 70 Aufgaben, 947 Bewertungspunkte und 6 Agenten; die Paper-Version 2604.09937v1 wurde auf 135 Aufgaben, 1.698 überprüfbare Teilaufgaben und 7 Modellkonfigurationen erweitert. Dieser Artikel orientiert sich an der Paper-Version; die Daten der frühen Webseite dienen nur als historischer Vergleich.
Die vier simulierten GUI-Umgebungen der Paper-Version sind EHR, Versicherungsabrechnungsportal A, Versicherungsabrechnungsportal B und ein Faxportal. Die 135 Aufgaben gliedern sich in drei Kategorien von Verwaltungsabläufen:
| Aufgabentyp | Anzahl | Hauptinhalt |
|---|---|---|
| Vorautorisierung (Prior Authorization) | 60 | Prüfung der Versicherungsberechtigung, Zusammenstellung der Krankenakte, Einreichung des Vorautorisierungsantrags |
| Widersprüche und Ablehnungsmanagement (Appeals and Denials Management) | 60 | Prüfung von Ablehnungen, Zusammenstellung von Nachweisen, Vorbereitung und Einreichung von Widersprüchen |
| DME-Auftragsbearbeitung (DME Order Processing) | 15 | Sammlung von Unterlagen zu medizinischen Hilfsmitteln, Auftragserteilung, Dokumentation der Ergebnisse |
Die 1.698 Bewertungspunkte entstehen durch zwei Mechanismen. 1.177 davon verwenden deterministische Prüfungen und verifizieren den Systemzustand mit strukturierten Verfahren wie JMESPath – etwa ob der richtige Patient gefunden wurde, ob die vorgegebenen Felder ausgefüllt sind oder ob der korrekte Auftrag erzeugt wurde. Der Ansatz ähnelt klassischen Softwaretests. Die übrigen 521 Punkte überlässt man einem LLM Judge; bewertet wird vor allem, ob die Dokumentinhalte ausreichend sind und ob die eingereichten Unterlagen den Anforderungen entsprechen – also Bereiche, die sich mit Regeln kaum direkt prüfen lassen.
Alle Aufgaben verwenden synthetische Patientendaten, keine echten Patientendatensätze. Das bedeutet: Der Benchmark bietet eine reproduzierbare Testumgebung. Er testet nicht in realen Produktionssystemen von Krankenhäusern und misst auch nicht direkt die Ergebnisse der Patientenversorgung.
Worin unterscheidet sich der Teilerfolg vom Erfolg einer vollständigen Aufgabe?
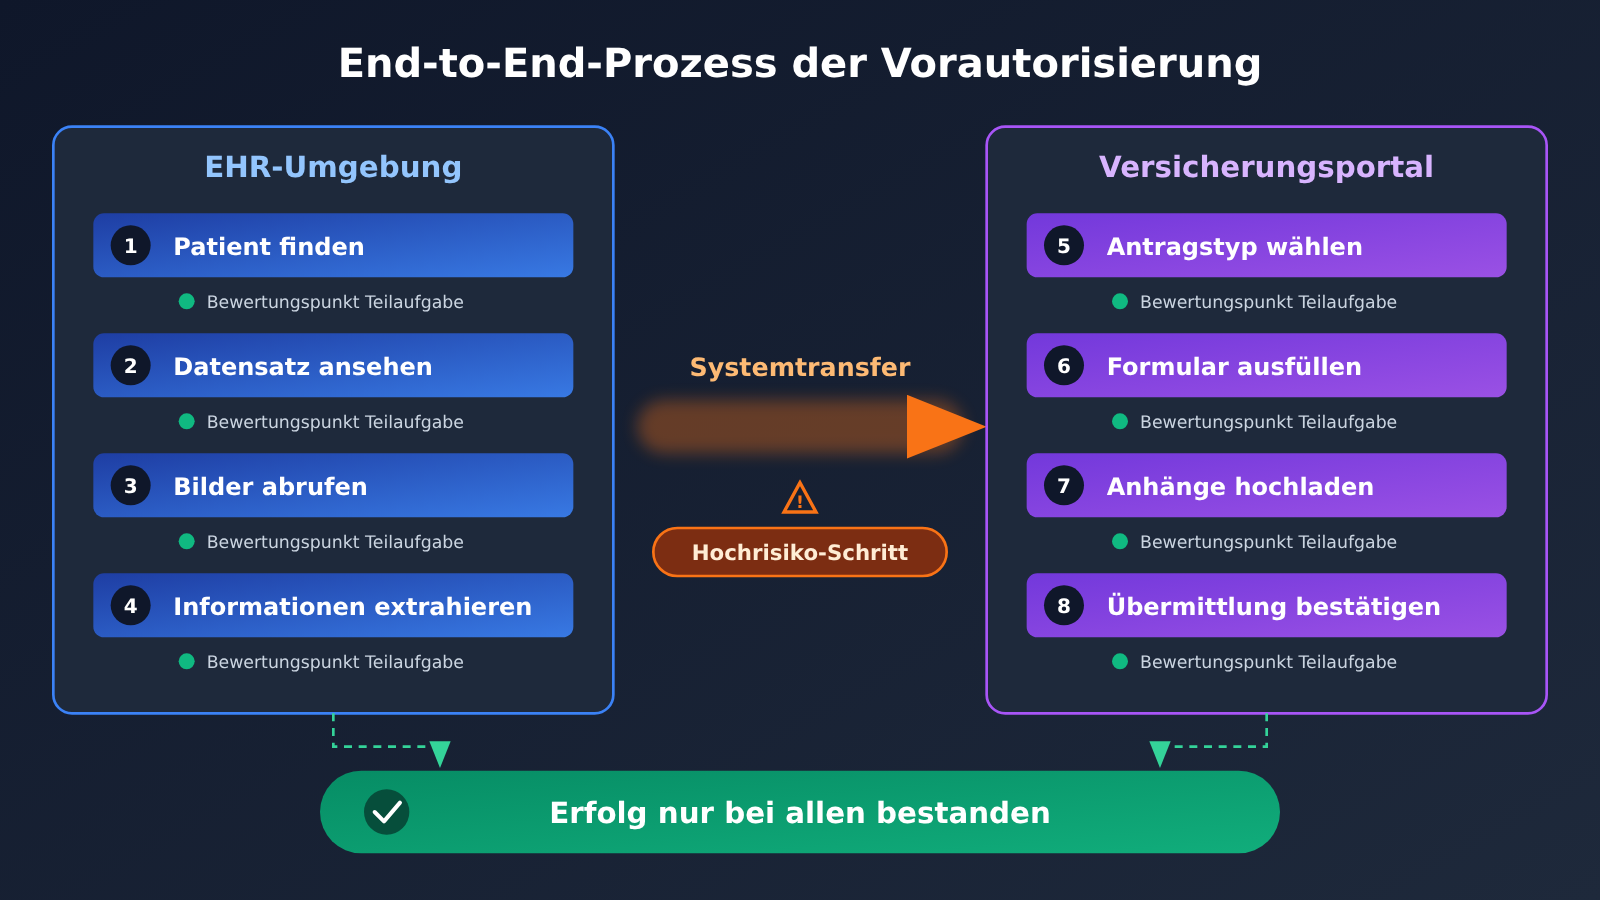
Am einfachsten lässt sich der Unterschied anhand eines Antrags auf Vorabgenehmigung nachvollziehen. Wie die Forschungsunterlagen beschreiben, kann eine Aufgabe zur Vorabgenehmigung vom Agenten verlangen, nacheinander Folgendes zu erledigen:
- Den richtigen Patienten in der EHR finden
- Die Behandlungsunterlagen des Patienten einsehen
- Bildgebungsuntersuchungen und Unterlagen zu früheren Behandlungen finden
- Feststellen, welche Nachweise der Versicherungsantrag erfordert
- Die benötigten Informationen aus der Krankenakte extrahieren
- Das Portal des Versicherungsträgers aufrufen
- Den richtigen Antragstyp auswählen
- Das Antragsformular ausfüllen
- Die erforderlichen Unterlagen anhängen
- Den Antrag absenden und den Status bestätigen
Zwischen diesen zehn Schritten besteht eine starke Abhängigkeit. Wird in Schritt 1 der falsche Patient gewählt, ist jeder weitere Schritt – egal wie korrekt ausgeführt – falsch; laufen die ersten neun Schritte alle korrekt, aber in Schritt 9 wird ein Anhang vergessen oder in Schritt 10 nicht tatsächlich abgesendet, gilt die gesamte Aufgabe dennoch als fehlgeschlagen. Die Erfolgsquote auf Teilebene misst, „wie viele der zehn Schritte korrekt ausgeführt wurden“, die Erfolgsquote der vollständigen Aufgabe misst, „ob alle zehn Schritte korrekt ausgeführt wurden“.
Die in der Arbeit angegebenen Daten zeigen diesen Unterschied deutlich: Die Erfolgsquote auf Teilebene von GPT-5.4 CUA liegt bei 82,8 %, während die Erfolgsquote der vollständigen Aufgabe von Claude Opus 4.6 CUA bei 36,3 % liegt. Diese beiden Zahlen gehören zu unterschiedlichen Modellen und lassen sich ebenfalls nicht direkt vergleichen, doch gemeinsam belegen sie einen Tatbestand: Das Abschließen einzelner Aktionen und das Abschließen eines gesamten Geschäftsprozesses sind zwei verschiedene Fähigkeiten.
Auch die Website früherer Studien berichtete über einen ähnlichen Unterschied: Die beste Erfolgsquote der vollständigen Aufgabe von Claude Opus 4.5 lag bei 22,9 %, die Erfolgsquote auf Teilebene von Gemini 3 bei 76,4 %. Da sich Aufgabenumfang und Versionen unterscheiden, lassen sich diese Zahlen nur zur Beobachtung von Trends heranziehen und nicht zusammen mit den Ergebnissen der Arbeit oder denen von OpenAI in dieselbe Rangliste aufnehmen.
In welchen Schritten scheitern medizinische Agenten am häufigsten?
Die Studie veröffentlicht die Ergebnisse zweier CUA-Konfigurationen nach Unteraufgabenkategorien:
| Unteraufgabenkategorie | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| Informationsbeschaffung | 96.5% | 96.1% |
| Dokumenterstellung | 74.3% | 84.4% |
| Formularausfüllung | 88.9% | 84.9% |
| Aufgabenlösung | 70.7% | 66.2% |
| Dokumentverarbeitung | 92.3% | 94.3% |
| Klinisches Reasoning | 61.3% | 77.0% |
Ein wichtiger Hinweis: Die 94.3% von GPT-5.4 CUA bei der Dokumentverarbeitung in der Tabelle sind nur eine numerische Koinzidenz mit den 94.3% der gesamten Rubrik-Punkte (rubric points) von GPT-6 Astra, die OpenAI veröffentlicht hat – Modelle, Metriken und Quellen sind völlig unterschiedlich.
Betrachtet man die Einzelposten, ist die Informationsbeschaffung nahezu gesättigt, während klinisches Reasoning, Aufgabenlösung und Dokumenterstellung relativ schwach abschneiden. Die Studie weist zugleich darauf hin, dass Dokumentverarbeitung (Document Handling) und systemübergreifende Datenübertragung (Cross-system Data Transfer) die Hauptursachen für End-to-End-Fehler sind. Eine frühere Webversion berichtete, dass fünf von sechs Modellen bei der Unteraufgabe Dokumentverarbeitung eine Genauigkeit von unter 20 % erreichten, doch das gehört zu einer anderen Version der Aufgabenstellung und lässt sich nicht direkt mit der obigen Tabelle vergleichen.
Warum ist die systemübergreifende Übertragung besonders fehleranfällig? Im Vorautorisierungsprozess müssen dieselben Informationen aus dem EHR ausgelesen, im Kontext des Agenten gespeichert und anschließend in eine andere Formularstruktur des Versicherungsportals geschrieben werden; Anhänge können zudem über ein Faxportal laufen. Jede Übertragung ist eine Gelegenheit für Fehler, und ein Fehler in der vorgelagerten Stufe wird unverändert in das nachgelagerte System kopiert. Zu den in den OpenAI-Unterlagen aufgeführten Risiken gehören auch „die Weitergabe fehlerhafter Informationen von einem System an ein anderes“ und „die falsche Meldung eines abgeschlossenen Auftrags, wenn der Systemzustand unklar ist“.
Warum dasselbe Modell je nach Ausführungsrahmen unterschiedliche Ergebnisse liefert
Die Studie führte Ablationsexperimente zur Eingabeaufforderungs-Gestaltung und zur Beobachtungsart durch. Drei zentrale Erkenntnisse:
- Portal Guidance (Anleitung zur Portalbedingung) führt in der Regel zu besseren Ergebnissen als eine reine Aufgabenbeschreibung
- Die Beobachtung über den Accessibility Tree (Barrierefreiheitsstrukturbaum) ist meist besser als die reine Beobachtung per Screenshot
- Kombiniert man Portal Guidance mit strukturierten Seiteninformationen, ist die End-to-End-Performance in der Regel besser
Die Studie weist außerdem darauf hin, dass eine echte Produktionsumgebung nicht unbedingt einen vollständigen Accessibility Tree bereitstellen kann. Mit anderen Worten: Die Leistung eines Agenten hängt nicht nur vom zugrunde liegenden Modell ab, sondern auch vom Harness, der Art der Seitenbeobachtung, der Eingabeaufforderung und der Aufgabenbeschreibung.
Auch die Entwicklerdokumentation von OpenAI spiegelt diese Unterschiede in den Ausführungspfaden wider. Die offiziellen Leitfäden beschreiben getrennt ComputerToolset, BrowserToolset und den Einstieg über den gehosteten Browser; für GPT-6 Astra empfiehlt die aktuelle Dokumentation den Ansatz über Code Execution, also dass das Modell Code wie Playwright generiert, um die Benutzeroberfläche zu bedienen, während das Computer Tool weiterhin als optionale Variante besteht. Die Dokumentation betont zudem, dass die vom Modell generierte Bedienanweisung nicht bedeutet, dass die Aktion bereits erfolgreich war: Die Anwendung muss sie ausführen und das Ergebnis anschließend per neuem Screenshot oder auf andere Weise verifizieren.
Das von CVS Health als Open Source veröffentlichte CUA Agent Kit (Apache-2.0) zeigt einen anderen technischen Ansatz. Der im README offengelegte Mechanismus lautet: Zunächst erkundet ein Computer-use Agent den Workflow und speichert Screenshots, Aktionen und Traces als Belege. Dann überführt ein Codex Skill die erfolgreiche Trajektorie in deterministischen Code, der von Ingenieuren geprüft wird; die anschließenden deterministischen Läufe benötigen keinen Modellschlüssel mehr. Damit werden „herausfinden, wie man es macht“ und „es stabil und wiederholbar tun“ in zwei getrennte Probleme zerlegt.
Analyse und Einschätzung: Wie bewertet man einen wirklich einsatzfähigen medizinischen Agenten
Wie bewertet man einen wirklich einsatzfähigen Agenten?
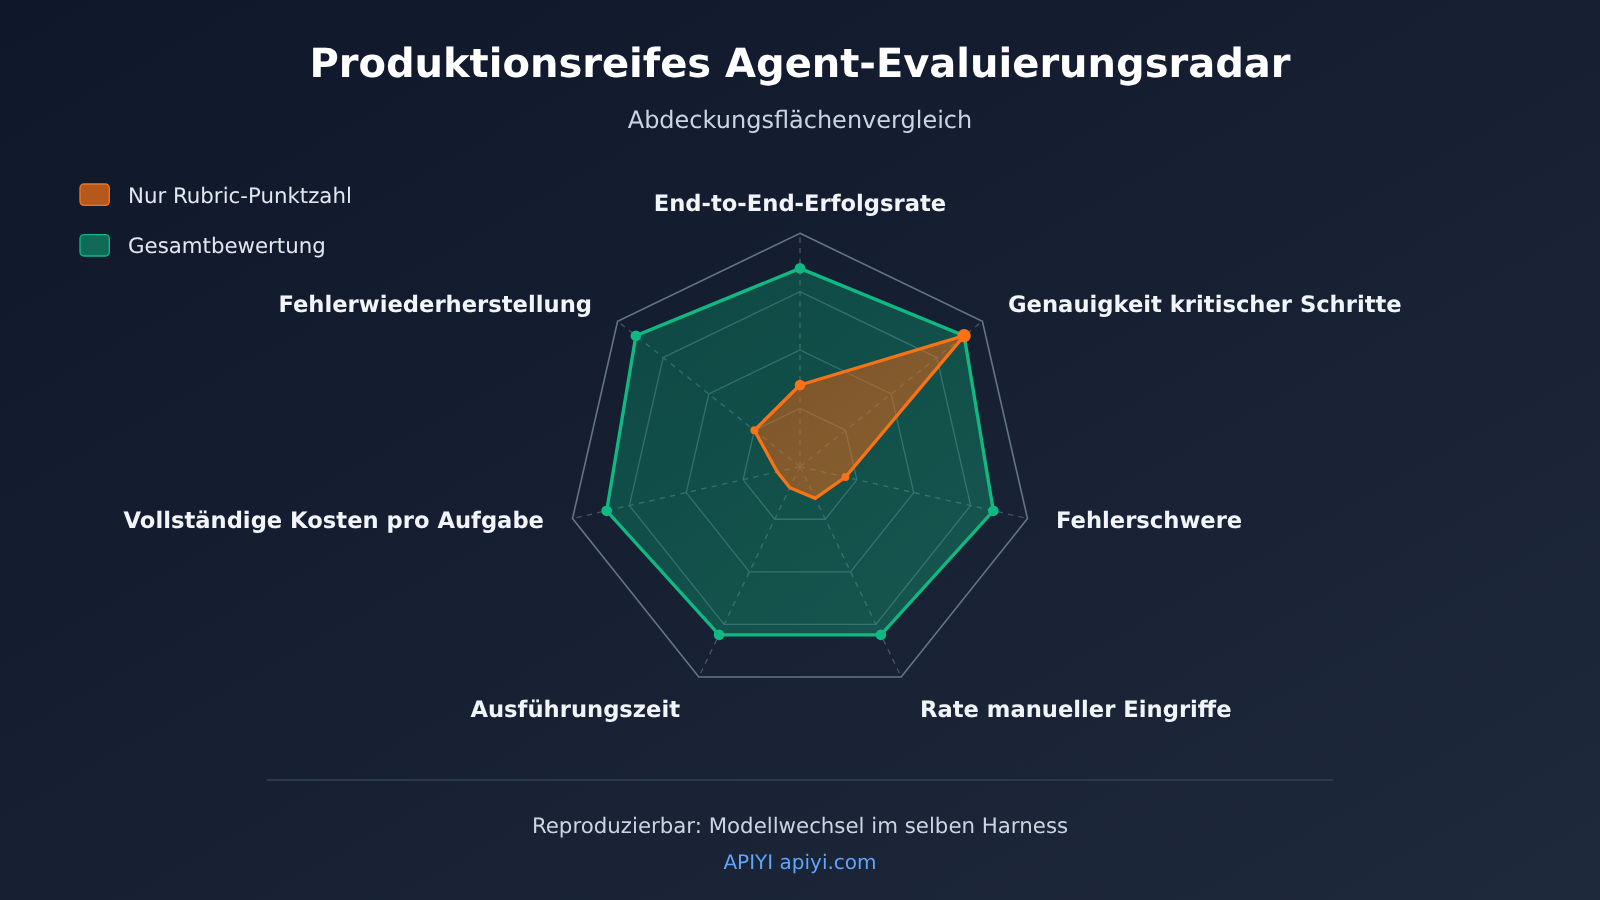
Das Folgende ist die Einschätzung dieses Artikels und kein offizieller Standard irgendeiner Institution. Wir sind der Meinung, dass Rubric-Point-Scores wie 94,3 % geeignet sind, die Frage zu beantworten, „wie viel Fortschritt das Modell bei einer lokalen Fähigkeit gemacht hat“, aber nicht ausreichen, um die Frage zu beantworten, „ob es in einen Produktionsprozess integriert werden kann“. Die letztere Frage erfordert eine Reihe sich gegenseitig beschränkender Kennzahlen:
| Bewertungsdimension | Was gemessen wird | Warum sie benötigt wird | Datenquelle |
|---|---|---|---|
| End-to-End-Erfolgsrate | Anteil der vollständigen Aufgaben, die alle Erfolgsbedingungen erfüllen | Das Geschäft zählt nur das Endergebnis | Validierung des finalen Systemzustands |
| Genauigkeit kritischer Schritte | Trefferquote bei Schlüsselpunkten wie Patient auswählen, absenden, Anhänge hochladen | Ein Fehler bei einem kritischen Schritt macht alles zunichte | Deterministische Prüfung |
| Schweregrad von Fehlern | Ob es sich beim Fehler um eine behebbare Auslassung oder um falsch geschriebene Daten bzw. falsch versendete Nachrichten handelt | Das Risiko bei gleicher Fehlerrate unterscheidet sich enorm | Manuelle Prüfung + Klassifizierungs-Tags |
| Menschliche Eingriffsrate | Anteil der Fälle, die menschliche Übernahme oder Freigabe-Korrekturen erfordern | Entscheidet über die tatsächlich eingesparte Arbeitskraft | Freigabeprotokolle |
| Ausführungszeit | Dauer pro Aufgabe und Long-Tail-Dauer | Beeinflusst Durchsatz und Warteschlangen | Trace-Zeitstempel |
| Vollständige Kosten pro Aufgabe | Summe aus Modell, Screenshots, Wiederholungen, Laufzeitumgebung und Wartung | Der Token-Stückpreis repräsentiert nicht die tatsächlichen Kosten | Abrechnung + Betriebsprotokolle |
| Fähigkeit zur Ausnahmewiederherstellung | Ob das System bei Mehrdeutigkeit, Timeouts oder Seitenänderungen stoppen oder zurückrollen kann | Im medizinischen Szenario muss es „stoppen können“ | Fehlerinjektionstests |
Der Kern dieses Rahmens besteht darin, „wie viele Schritte richtig gemacht wurden“ und „wie viele Dinge tatsächlich erledigt wurden“ getrennt zu berichten und beide dann mit dem Schweregrad von Fehlern und der menschlichen Eingriffsrate zu korrigieren. Die von Ambience vorgestellte Lösung veranschaulicht genau die Dimension „Ausnahmewiederherstellung“: Wenn die Krankenakte mehrdeutig ist, hält der Agent an, fragt den Arzt und reicht den Antrag auf Vorabgenehmigung erst ein, nachdem der Arzt zugestimmt hat. Dies ist lediglich das von diesem Unternehmen vorgestellte Governance-Konzept und bedeutet nicht, dass alle medizinischen Agenten standardmäßig über dieselbe Konfiguration verfügen.
Auch Stichprobenumfang und Anzahl der Wiederholungen müssen offengelegt werden. Eine Studie zum Vergleich von RPA und Agenten (DOI: 10.1080/23311975.2026.2724760) führte in den beiden Prozessen P2 und P3 jede Technologie jeweils 10-mal aus, doch bei P1 wurde der Agent nur einmal ausgeführt und scheiterte, weshalb dieser nicht in die nachfolgende Statistik aufgenommen wurde; die Studie verwendete eine Werkzeugkonfiguration aus dem Jahr 2025 und kann nicht als direktes Ergebnis für Modelle aus dem Jahr 2026 gelten. Dieses Beispiel zeigt, dass man beim Lesen von Evaluierungsergebnissen zuerst prüfen sollte, wie oft hinter jeder Zahl tatsächlich gelaufen wurde und welche Ergebnisse ausgeschlossen wurden.
Praxisbewährte Umsetzung der Evaluierung medizinischer Agents: selbst fahren unter demselben Harness
Für Entwicklungsteams ist der pragmatischste Weg, das Ausführungsframework festzuschreiben und auf dem eigenen Aufgabensatz parallel zwei Metriksätze zu erfassen: Teilaufgaben und End-to-End. Das folgende Beispiel nutzt einen LLM Judge, um die vom Agent eingereichten Materialien zu bewerten; die Schnittstelle ist mit dem OpenAI SDK kompatibel:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle, verschiedene Judge-Modelle umschaltbar
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
Vollständige Implementierung ansehen: Erfolgsquote der Teilaufgaben und End-to-End-Erfolgsquote gleichzeitig berechnen
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # Ob es ein kritischer Schritt ist (bei Fehlschlag scheitert die gesamte Aufgabe)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # Retry-Token bereits enthalten, nicht doppelt addieren

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """LLM Judge für Teilaufgaben einsetzen, die sich nur schwer regelbasiert erfassen lassen"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 Technischer Hinweis: Der Teilaufgaben-Score und die End-to-End-Erfolgsquote sollten am besten im selben Harness und auf derselben Aufgabensammlung nebeneinander ausgewiesen werden. Über die OpenAI-kompatible Schnittstelle von APIYI apiyi.com lässt sich mit einem einzigen API-Schlüssel zwischen Modellen wie OpenAI, Claude oder Gemini wechseln – als Ausführungs- oder als Judge-Modell. Das reduziert die Variablen, die durch unterschiedliche Anbindungswege entstehen.
Kostenkalkulation und Modellschichtung für medizinische Agenten
Der Token-Preis ist nur der Ausgangspunkt. Nach den von OpenAI am 17. November 2026 veröffentlichten Standard-Preisen für kurze Kontexte kostet GPT-6 Astra beim Input, Output und gecachten Input 10, 50 bzw. 1 US-Dollar pro Million Token, GPT-6 Luna 0,10, 0,50 und 0,01 US-Dollar. Verarbeitungsgeschwindigkeit, Kontextlänge und Region beeinflussen die tatsächliche Abrechnung. Computer Use ist ein mehrstufiger Aufruf: Jeder Screenshot zählt als visueller Input. Bei der Kalkulation sollten Sie daher die visuellen bzw. Text-Eingaben und die abgerechneten Ausgaben pro Runde getrennt erfassen und zusätzlich Tools, Laufzeitumgebung und Engineering-Wartung einrechnen. Sind die durch Wiederholungsversuche verbrauchten Token bereits in der Gesamtsumme enthalten, dürfen Sie sie nicht noch einmal dazuzählen.
Gemessen an der Differenz zwischen 0,085 US-Dollar und rund 4,25 US-Dollar dürfte die Modellschichtung zum Standard werden: Komplexe Aufgaben, die starke Schlussfolgerungen erfordern, gehen an leistungsfähige Modelle; stark strukturierte, häufig anfallende Aufgaben an kostengünstige Modelle; und bereits bewährte feste Abläufe werden nach dem Ansatz von CVS zu deterministischem Code verfestigt. Anmerkung: Diese Kosten pro Einzelaufgabe stammen aus bestimmten Benchmark-Bedingungen und taugen nicht als Produktionspreisangabe.
💰 Kostenoptimierung: Bevor Sie die Schichtung auswählen, sollten Sie mit einem kleinen Stapel echter Aufgaben die End-to-End-Erfolgsquote und die vollständigen Kosten pro Aufgabe für die einzelnen Modelle messen. APIYI apiyi.com rechnet nach Verbrauch ab; neue Nutzer erhalten ein kostenloses Testkontingent, sodass sich solche Vergleichsreihen in der Projektphase kostengünstig durchführen lassen.
Vom medizinischen Agenten zum Unternehmens-Agenten: Übertragbare Evaluierungsansätze
Die Besonderheit der medizinischen Verwaltung liegt in ihrem hohen Risiko und der starken Regulierung. Doch die Probleme, die dabei zutage treten, existieren in Unternehmensprozessen wie der Versicherungsabwicklung, der Finanzabstimmung oder der Abwicklung von Lieferkettenbelegen gleichermaßen: mehrere Systeme, starke Abhängigkeiten, das Hin- und Hertragen von Daten zwischen Systemen. Unsere Einschätzung ist, dass sich die folgenden vier Prinzipien direkt übertragen lassen:
- Berichte aufschlüsseln: Teilaufgaben-Scores und End-to-End-Erfolgsraten getrennt ausweisen, niemals Ersteres anstelle von Letzterem verwenden
- Evidenzgrade kennzeichnen: Demonstrationen in synthetischen Umgebungen, Hersteller-Selbsteinschätzungen, Drittanbieter-Benchmarks, Unternehmenspiloten und Produktionsfälle jeweils getrennt zuordnen, nicht vermischen
- Erst das Harness fixieren, dann vergleichen: Sobald sich Beobachtungsmethode, Eingabeaufforderungen oder Portal-Anleitung ändern, sind die Ergebnisse nicht mehr vergleichbar
- Governance vor Scores: Minimale Berechtigungen, manuelle Freigabe kritischer Aktionen, Statusverifizierung nach Operationen, vollständiges Trace-Logging und Mechanismen zum Stoppen bei Anomalien sollten bereits vor dem Go-Live als Abnahmekriterien festgelegt werden
Bei der Durchführung eines PoC im Unternehmen kann man die Aufgaben-Sets nach „kritischen Schritten“ taggen, zunächst eine End-to-End-Baseline ermitteln und dann schrittweise Portal-Anleitungen, strukturierte Beobachtung oder Code-Fixierung einführen, um den tatsächlichen Beitrag jeder Änderung zur vollständigen Erfolgsrate zu beobachten. Wenn dieselbe Aufgabensammlung schnell zwischen mehreren Modellen reproduziert werden soll, kann man sie über den einheitlichen Zugang von APIYI apiyi.com anbinden, um die Engineering-Kosten für den Quervergleich zu senken.
Zu den Entwicklungen, die es weiter zu beobachten gilt, gehören: ob OpenAI die aufgabenbezogenen Ergebnisse und Versuchskonfigurationen hinter den 94,3 % veröffentlicht; ob nachfolgende Versionen von HealthAdminBench unter derselben Metrik vollständige Aufgaben-Erfolgsraten neuer Modelle veröffentlichen; und ob mehr Institutionen die menschliche Eingriffsrate und Fehlerklassifizierungsdaten im realen Produktionsumfeld offenlegen können. Bis diese Informationen vorliegen, sind alle Aussagen darüber, dass „die medizinische Verwaltung bereits vollständig automatisiert werden kann“, reine Vermutungen.
Die 94,3 % belegen einen bedeutenden Fortschritt des Modells an den Bewertungspunkten; die 36,3 % hingegen erinnern daran: Ob ein Geschäftsprozess zuverlässig abgeschlossen werden kann, muss letztlich an vollständigen Aufgaben, in realen Systemen und unter menschlicher Aufsicht überprüft werden. Wie das englische Sprichwort sagt: „The proof of the pudding is in the eating.“ (Ob der Pudding gut ist, zeigt sich erst beim Essen; die tatsächliche Wirkung muss sich in der Praxis beweisen.)
Referenzen
- OpenAI: Advancing computer-use agents for healthcare teams: Evaluierungsdaten und Kooperationsbeispiele wie 94,3 %, 91,8 %, 99 % und 93 %
- Link:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- Link:
- HealthAdminBench-Paper 2604.09937v1: 135 Aufgaben, 1.698 Teilaufgaben, Teilergebnisse und Ablationsexperimente
- Link:
arxiv.org/html/2604.09937v1
- Link:
- HealthAdminBench-Projektseite und Code-Repository: Benchmark-Umgebung und Evaluierungsimplementierung
- Link:
som-shahlab.github.io/health-admin-bench-website/ - Link:
github.com/som-shahlab/health-admin-bench
- Link:
- Frühe Forschungsseite des Stanford Shah Lab: historische Version mit 70 Aufgaben und 947 Bewertungspunkten
- Link:
shahlab.stanford.edu/doku.php?id=healthadminbench
- Link:
- OpenAI Computer Use – Entwicklerdokumentation und API-Preise: Ausführungspfade und Standard-Preise
- Link:
developers.openai.com/api/docs/guides/tools-computer-use - Link:
developers.openai.com/api/docs/pricing
- Link:
- CVS Health CUA Agent Kit: Mechanismen für Erkundung, Nachweise, Code-Härtung und Engineer-Review
- Link:
github.com/cvs-health/cua-agent-kit
- Link:
- Vergleichsstudie zu RPA und Agenten: Anzahl wiederholter Ausführungen und Erläuterung der P1-Ausnahmen
- Link:
doi.org/10.1080/23311975.2026.2724760
- Link:
- Cambridge Dictionary: Bedeutung des Sprichworts „proof of the pudding is in the eating“
- Link:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Besuchen Sie uns bei APIYI auf apiyi.com, um sich über Agent-Evaluierungspraxis auszutauschen. Weitere Integrationshinweise finden Sie im Dokumentationszentrum unter docs.apiyi.com.


