
Anmerkung des Autors: Eine Zerlegung von Qwen4-Max auf Platz 6 des Code Arena WebDev Leaderboards – die Zusammensetzung der Top sechs, die Abstände innerhalb der chinesischen Modelle, der Rückstand zu den führenden Modellen und die richtige Art, Stimmenzahl und Kosten pro Aufgabe zu lesen.
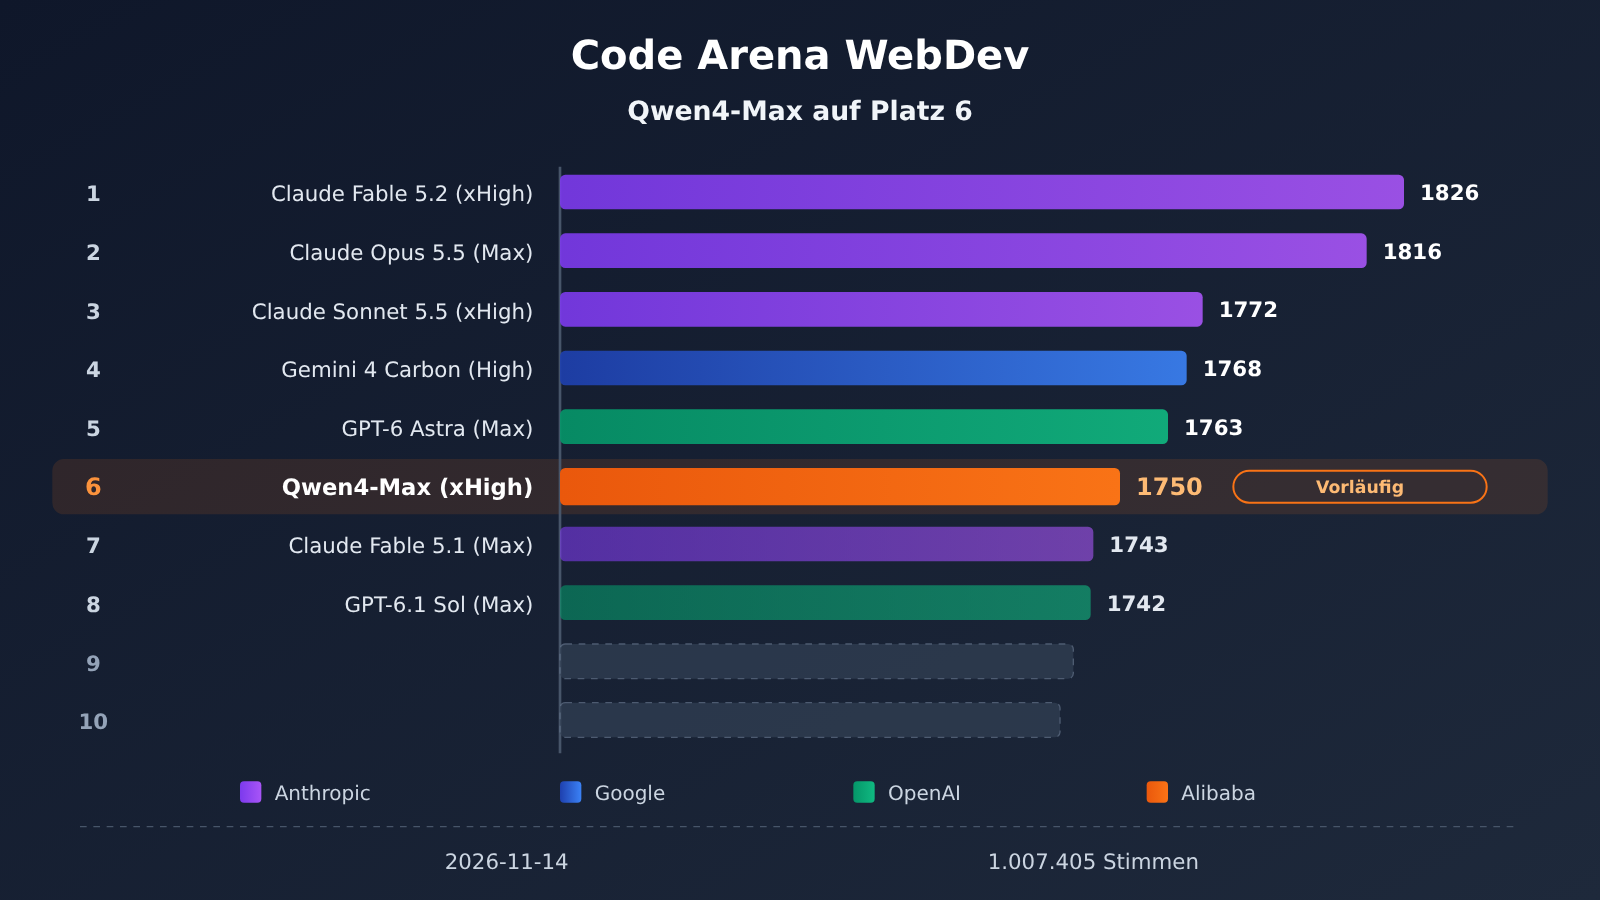
Zuerst das Fazit: Auf dem Code Arena WebDev Leaderboard von arena.ai (Kategorie Overall, laut Seite Stand 14.11.2026) liegt Qwen4-Max (xHigh) mit 1750 Punkten auf Platz 6. Damit schafft es erstmals ein chinesisches Modell in die Top sechs dieser Rangliste – und es ist das einzige Modell unter den ersten sechs, das nicht aus einem US-amerikanischen Labor stammt.
Das ist keine PR-Botschaft, die Platz 6 als Platz 1 verkauft. Qwen4-Max trägt auf dem Leaderboard das Kennzeichen „Preliminary“, hat nur 1.814 Stimmen, und die Platzierung kann sich noch verschieben. In derselben offiziellen Grafik von Alibaba liegt es bei Terminal-Bench und ProgramBench weiterhin deutlich hinter Opus 5.5 und GPT-6 Astra.
Der Kernnutzen: Nach der Lektüre dieses Artikels haben Sie die Metadaten des Leaderboards in der Hand, die Sie selbst nachprüfen können – und Sie wissen, wie man den 6. Platz von Qwen4-Max sinnvoll einsetzt und wie besser nicht.
Qwen4-Max in Code Arena WebDev: Die wichtigsten Punkte zu Platz 6
Bevor wir über den Rang sprechen, sollten wir zuerst die Metadaten der Rangliste offenlegen. Jede Aussage über einen „Platz“ sollte mit Datum, Stimmenzahl und Anzahl der teilnehmenden Modelle abgeglichen werden; sonst lässt sich kaum beurteilen, ob die Platzierung belastbar ist.
| Punkt | Daten (öffentliche Daten aus derselben Rangliste) | Wie man es liest |
|---|---|---|
| Rangliste und Kategorie | arena.ai Code Arena WebDev, Overall | Steht nur für die Präferenz bei Blindtests im Bereich Webentwicklung |
| Datum der Seite | 2026-11-14 | Der Rang ändert sich laufend mit den Stimmen |
| Gesamtstimmen / Anzahl der Modelle | 1,007,405 Stimmen / 159 Modelle | Große Stichprobe, aber die Stimmenzahl je Modell variiert stark |
| Qwen4-Max: Rang und Punktzahl | Platz 6, 1750 Punkte | Das einzige Modell unter den Top 6, das nicht aus einem US-Labor stammt |
| Qwen4-Max: Stimmenzahl und Kennzeichnung | 1,814 Stimmen, Preliminary | Noch in der vorläufigen Bewertungsphase |
| Kosten pro Aufgabe (P50) | $4.18 | Der in der Rangliste ermittelte Median, nicht der Einzelpreis des Modells |
Die Ranglisten-Methodik von Qwen4-Max im Detail
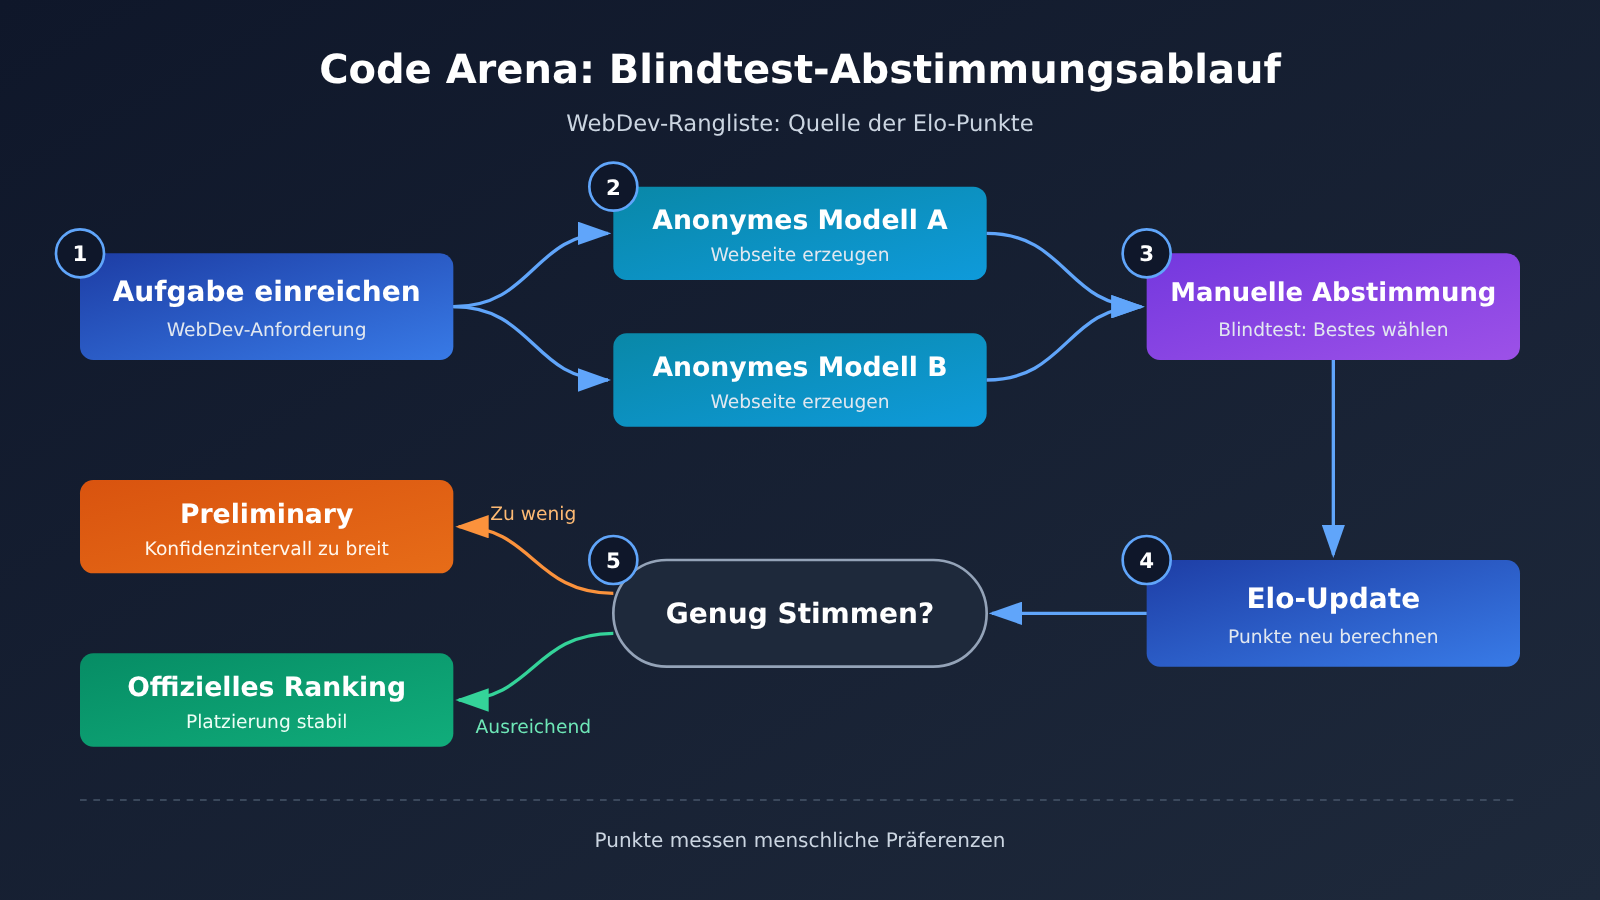
Die Elo-Punktzahl von Code Arena stammt aus menschlichen Blindtest-Abstimmungen: Nutzer geben dieselbe Webentwicklungsaufgabe vor, sehen die Ergebnisse zweier anonymer Modelle und stimmen dann für die bessere Variante. Die Punktzahl spiegelt wider, „welche Webseite menschliche Prüfer besser finden“; sie misst eine Präferenz und keine umfassende Produktivitätsgesamtpunktzahl.
Auch die Bedeutung der Kennzeichnung Preliminary sollte man verstehen. Sie zeigt, dass das Modell noch nicht oft genug an Duellen teilgenommen hat und das Konfidenzintervall entsprechend breit ist. Auch Gemini 4 Carbon (High) auf Platz 4 derselben Rangliste trägt diese Kennzeichnung. Deshalb wäre es nicht überraschend, wenn sich die Plätze 4 bis 6 in den nächsten Wochen verschieben.
Wer sind die Top 6 der Code Arena WebDev: Das Gegnerfeld von Qwen4-Max
Eine vollständige Top 10 macht die Position von Qwen4-Max anschaulicher. Die ersten fünf Plätze gehen komplett an drei US-Labore, allein Anthropic belegt davon drei.
| Rang | Modell | Punktzahl | Labor | Anmerkung |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | Spitzenplatz |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | P50 pro Aufgabe $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Vorläufig | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | P50 pro Aufgabe $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | Alibaba | Vorläufig, 1.814 Stimmen |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
Was die Top-5-Konstellation für Qwen4-Max bedeutet
Unter den ersten sechs entfallen drei Plätze auf Anthropic (Fable 5.2, Opus 5.5, Sonnet 5.5), je einer auf Google und OpenAI sowie einer auf Alibaba. Anders gesagt: Qwen4-Max hat sich einen Platz zwischen den Flaggschiffen von drei führenden Laboren erobert, statt in einer wenig umkämpften Rangliste einen Platz abzustauben.
Ein weiteres bemerkenswertes Detail: Die Plätze 6 bis 8 liegen sehr dicht beieinander – 1750, 1743, 1742, weniger als 10 Punkte Unterschied. Der Vorsprung von Qwen4-Max vor Claude Fable 5.1 und GPT-6.1 Sol ist kleiner als die 13 Punkte, um die es hinter GPT-6 Astra liegt. Wie stabil der Rang ist, lässt sich erst beurteilen, wenn die Zahl der Stimmen steigt.
Qwen4-Max im Feld der inländischen Modelle
Betrachtet man nur die inländischen Modelle, ist der Vorsprung von Qwen4-Max recht deutlich. Es ist das einzige inländische Modell in den Top 10; der Zweitplatzierte taucht erst auf Rang 13 auf.
| Rang unter den inländischen Modellen | Modell | Punkte | Ranglistenplatz | Abstand zu Qwen4-Max |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | Rang 6 | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | Rang 13 | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | Rang 16 | −74 |
| 4 | Qwen3.8-Max | 1670 | Rang 18 | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | Rang 18 | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | Rang 19 | −89 |
| 7 | Kimi K3 (Max) | 1658 | Rang 20 | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | Rang 26 | −111 |
| 9 | Hy4 preview | 1632 | Rang 27 | −118 |
| 10 | GLM-5.3 (Max) | 1622 | Rang 31 | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | Rang 33 | −129 |
Zwei Dimensionen des Abstands innerhalb der inländischen Modelle
Die erste Ebene ist der Generationssprung. Qwen4-Max liegt 74 Punkte über der eigenen vorherigen Generation Qwen3.8-Max (0902), und der Rang springt von Platz 16 auf Platz 6. In derselben Rangliste und mit demselben Abstimmungsmechanismus ist dieser Zuwachs durchaus beachtlich.
Die zweite Ebene ist der Abstand zum zweitplatzierten inländischen Modell. Qwen4-Max liegt 64 Punkte über Kimi K3.1 Pro; dieser Abstand kommt den 66 Punkten nahe, mit denen es hinter Opus 5.5 zurückliegt. Das heißt: Qwen4-Max steht derzeit in der Mitte zwischen den inländischen Modellen und der globalen Spitze – nach unten hat es die inländischen Konkurrenten abgehängt, nach oben ist es noch ein Stück von der Spitze entfernt.
Zu bedenken ist: Die inländischen Ränge 2 bis 7 drängen sich zwischen 1686 und 1658 zusammen, die Punktabstände sind sehr klein. Diese Rangliste heranzuziehen, um die Reihenfolge dieser Anbieter festzulegen, bringt wenig.
Wie weit liegt Qwen4-Max von den globalen Spitzenmodellen entfernt?
Punktabstände auf Code Arena WebDev
Wenn man die Punktabstände zwischen Qwen4-Max und den Spitzenmodellen auflistet und mit der allgemeinen Elo-Formel (400-Punkte-Skala) grob eine „Siegquote im direkten Duell“ schätzt, lässt sich besser einordnen, was diese Abstände praktisch bedeuten. Die konkrete statistische Methode der Arena kann von Standard-Elo abweichen; die folgenden Siegquoten dienen nur als anschauliche Orientierung:
- Gegen Platz 5, GPT-6 Astra: 1750 vs 1763, 13 Punkte Unterschied, geschätzte Siegquote im direkten Duell etwa 48%, im Grunde auf Augenhöhe.
- Gegen Platz 2, Opus 5.5: 66 Punkte Unterschied, geschätzte Siegquote im direkten Duell etwa 41%.
- Gegen Platz 1, Fable 5.2: 76 Punkte Unterschied, geschätzte Siegquote im direkten Duell etwa 39%.
- Gegen das zweitbeste chinesische Modell, Kimi K3.1 Pro: 64 Punkte Vorsprung, geschätzte Siegquote im direkten Duell etwa 59%.
Die Punktespanne der gesamten Rangliste reicht von 1071 bis 1826. Auf dieser Skala sind die 76 Punkte Abstand von Qwen4-Max zur Spitze nicht besonders groß. Das zeigt aber auch, dass bei den Präferenzen für Webentwicklung die Spitzenmodelle von Anthropic bei den Bewertenden nach wie vor besser ankommen.
Weitere Benchmarks im selben Diagramm: Hoher Elo-Wert heißt nicht automatisch stark bei Terminal-Aufgaben
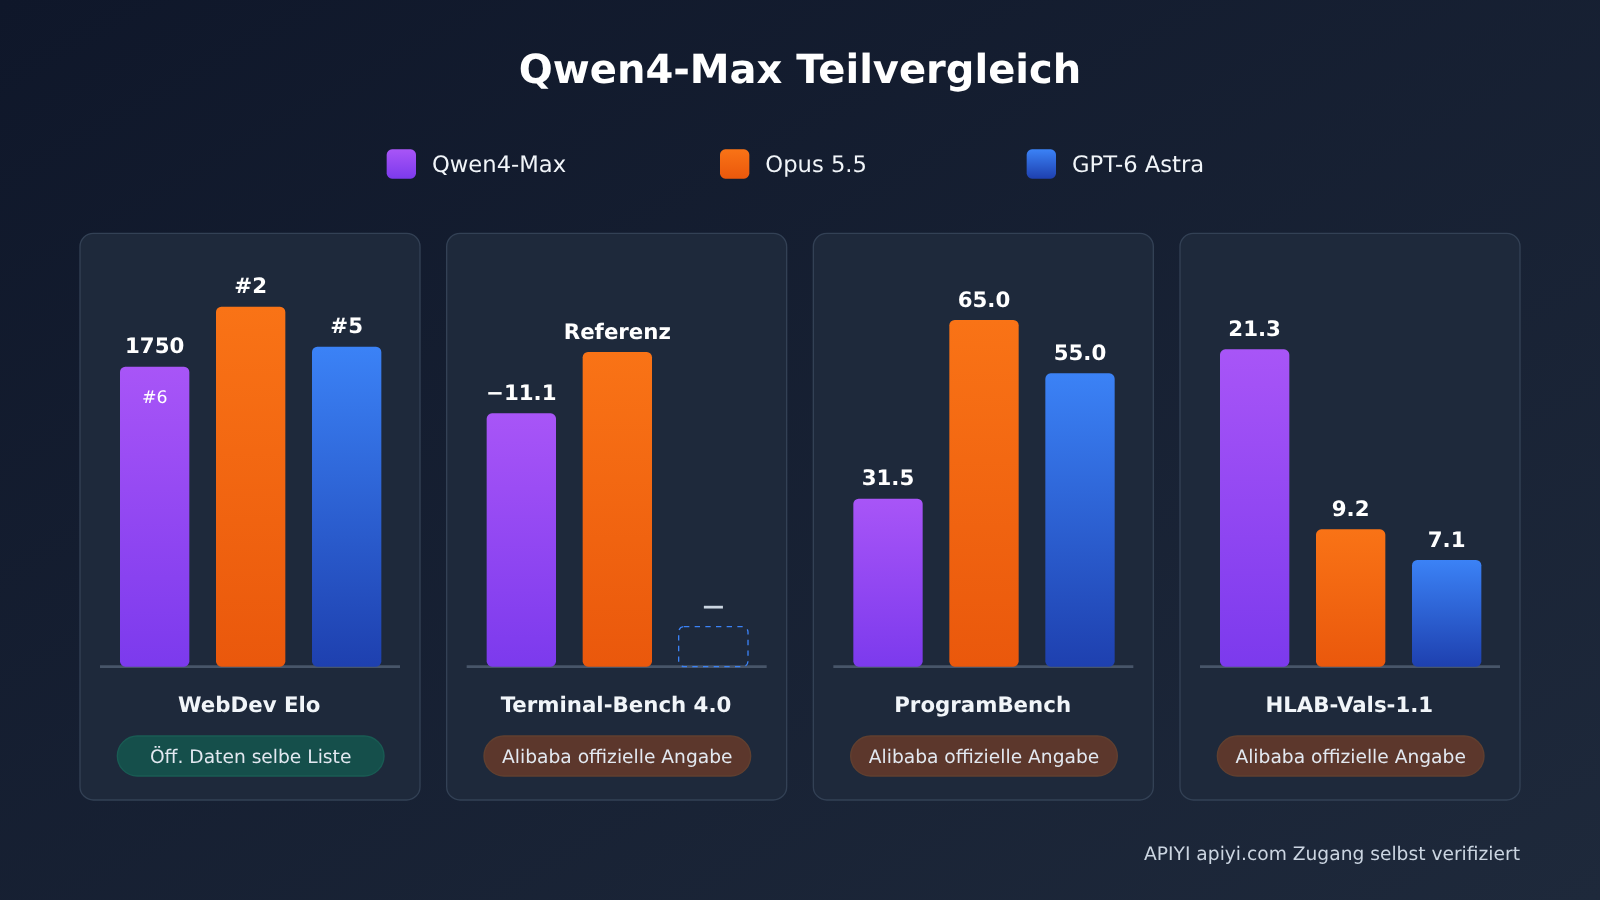
Alibaba verwendete bei der Veröffentlichung von Qwen4-Max ein gemeinsames Diagramm für mehrere Benchmarks. Die folgenden Daten sind sämtlich von Alibaba offiziell selbst gemeldet, keine Daten der Arena-Rangliste und auch keine von Dritten reproduzierten Ergebnisse.
| Benchmark (offiziell selbst gemeldet) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | Sonstige |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
Diese Tabelle macht eine entscheidende Sache deutlich: Qwen4-Max erzielt im Blindtest für Webentwicklung hohe Werte, bei Benchmarks für Terminalbedienung und Engineering-Programmierung ist der Abstand jedoch weiterhin deutlich. Bei Terminal-Bench 4.0 liegt es 11.1 Punkte unter Opus 5.5; das Kimi-Modell im Diagramm erreicht mit 67.2 sogar einen höheren Wert. Bei ProgramBench liegt sein Wert von 31.5 bei weniger als der Hälfte von Opus 5.5.
Es gibt aber auch Bereiche, in denen es klar vorn liegt. Bei HLAB-Vals-1.1 erreicht Qwen4-Max 21.3, deutlich mehr als die 9.2 von Opus 5.5 und die 7.1 von GPT-6 Astra. Bei AA-Briefcase liegt es ebenfalls über GPT-6 Astra. Genauer gesagt: Die Fähigkeitsverteilung von Qwen4-Max unterscheidet sich von der der Spitzenmodelle, statt dass es ihnen „in allen Bereichen nahekommt“.
Stimmenzahl und Kosten von Qwen4-Max richtig lesen
Stimmenzahl: Was 1.814 Stimmen bedeuten
Ob ein Rang stabil bleibt, hängt stark von der Stimmenzahl ab. Die 1.814 Stimmen für Qwen4-Max machen weniger als 0,2 % der rund 1 Million Gesamtstimmen aus – und liegen auch deutlich unter denen mehrerer chinesischer Modelle in derselben Rangliste.
| Modell | Rang | Stimmen | Kosten pro Aufgabe (P50) | Status |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 6 | 1.814 | 4,18 $ | Preliminary |
| Kimi K3.1 Pro (Max) | 13 | 5.215 | 0,89 $ | — |
| Qwen3.8-Max (0902) | 16 | 23.030 | 1,91 $ | — |
| Claude Opus 5.5 (Max) | 2 | öffentliche Daten derselben Rangliste | 8,99 $ | — |
| GPT-6 Astra (Max) | 5 | öffentliche Daten derselben Rangliste | 9,43 $ | — |
Qwen3.8-Max hat etwa 12,7-mal so viele Stimmen wie Qwen4-Max; seine Punktzahl kommt einem „stabilen Wert“ näher. Die 1.750 Punkte von Qwen4-Max wirken derzeit eher wie ein früher Messwert – sie könnten später nach oben oder nach unten korrigiert werden. Wenn man diesen Rang zitiert, sollte man am besten alle drei Einschränkungen nennen: „Preliminary“, „1.814 Stimmen“ und „2026-11-14“.
Kosten pro Aufgabe (P50): nicht der Preis pro Modell-Token
Die Kosten pro Aufgabe (P50) in dieser Rangliste bezeichnen den Median der Ausgaben für eine einzelne Aufgabe auf der jeweiligen Benchmark. Sie werden stark von der Ausgabelänge des Modells und der Stufe der Inferenzintensität (z. B. xHigh, Max) beeinflusst und lassen sich nicht als Preis pro Million Tokens eines Modells vergleichen.
Nach dieser Messgröße entsprechen die $4,18 von Qwen4-Max etwa 46 % von Opus 5.5 ($8,99) und 44 % von GPT-6 Astra ($9,43), liegen aber etwa beim 4,7-Fachen von Kimi K3.1 Pro ($0,89) und beim 2,2-Fachen der Vorgängergeneration Qwen3.8-Max ($1,91). Wenn in Ihrem Szenario die Kosten pro Aufgabe eine Rolle spielen, lohnt sich auch Kimi K3.1 Pro: Das Modell erreicht 1686 Punkte zu rund einem Fünftel der Kosten – das sollte man in die Bewertung einbeziehen.
Offizieller Preis von Qwen4-Max und aktueller Preis bei APIYI
Die folgenden Preise gelten pro 1 Mio. Tokens, Stand: 2026-11-16:
- Offizieller Preis von Qwen4-Max: Eingabe $1,5, Ausgabe $4,5, Cache-Lesen $0,075.
- Bei APIYI erhältliches Qwen-Flaggschiff
qwen3.8-max: Eingabe $1,65, Ausgabe $4,95, Cache-Lesen $0,20625.
Zur Klarstellung: qwen4-max ist derzeit noch nicht bei APIYI verfügbar, wir werden dieses Modell so bald wie möglich aufnehmen. Die beiden sind unterschiedliche Modelle, die obigen Preise lassen sich daher nicht direkt miteinander vergleichen. Die tatsächlich verfügbaren Modelle und Preise entnehmen Sie bitte der Modellliste auf der APIYI-Plattform apiyi.com.
Drei Schritte: Rangliste prüfen, Preise vergleichen, Endpunkt wechseln
Nachdem man ein Ranking gelesen hat, machen Entwickler meist drei Dinge: Platzierungen prüfen, Preise vergleichen und das Modell testweise ins eigene Projekt einbinden. Empfohlen wird diese Reihenfolge:
- Rangliste prüfen: Öffnen Sie die Code Arena WebDev-Seite auf arena.ai und prüfen Sie, ob sich Datum, Stimmenzahl und Preliminary-Kennzeichnung geändert haben.
- Preise vergleichen: Prüfen Sie in der Modellliste von APIYI apiyi.com die aktuell verfügbaren Qwen-Modelle und ihre aktuellen Preise und ob
qwen4-maxbereits gelistet ist. - Endpunkt wechseln: Ändern Sie in Ihrem vorhandenen OpenAI-kompatiblen SDK die base_url auf
https://api.apiyi.com/v1, tragen Sie als Modell-ID zunächstqwen3.8-maxein und wechseln Sie später, sobald das neue Modell verfügbar ist, für einen Vergleich aufqwen4-max.
🚀 Schnellstart-Tipp: Wenn Sie den Unterschied zwischen der Qwen-Serie und Claude, GPT und Gemini an Ihren eigenen WebDev-Aufgaben testen möchten, können Sie über APIYI apiyi.com mit einem einzigen API-Schlüssel mehrere Modelle über dieselbe Schnittstelle aufrufen. Neue Nutzer erhalten ein kostenloses Testkontingent – ideal, um zuerst eine kleine Stichprobe laufen zu lassen und dann die Modellwahl zu treffen.
Analyse der Stärken und Schwächen von Qwen4-Max
Stärken von Qwen4-Max
- Webentwicklungs-Präferenzwert führt die chinesischen Modelle an: 1750 Punkte, 64 Punkte mehr als das zweitbeste chinesische Modell und 74 Punkte mehr als die Vorgängergeneration.
- Der Abstand zur Spitzengruppe ist teilweise schon klein: zum fünftplatzierten GPT-6 Astra sind es nur 13 Punkte, mit den Plätzen 7 und 8 ist es nahezu gleichauf.
- Kosten pro Aufgabe niedriger als bei den Top-Flaggschiffen: P50 $4.18, weniger als die Hälfte von Opus 5.5 und GPT-6 Astra.
- Bei einigen Benchmarks klare Vorteile: Bei HLAB-Vals-1.1 liegt die offiziell selbst gemeldete Punktzahl deutlich vor Opus 5.5 und GPT-6 Astra.
Einschränkungen von Qwen4-Max
- Platzierung noch nicht stabil: Preliminary-Kennzeichnung plus 1,814 Stimmen; beim Zitieren müssen die Einschränkungen angegeben werden.
- Schwächer bei Terminal- und Engineering-Programmierbenchmarks: Bei Terminal-Bench 4.0 und ProgramBench liegt es deutlich unter Opus 5.5 und GPT-6 Astra; für Agent- oder Kommandozeilen-Automatisierung muss es separat bewertet werden.
- Kosten pro Aufgabe höher als bei einigen chinesischen Modellen: deutlich teurer als Kimi K3.1 Pro und Qwen3.8-Max; in kostenempfindlichen Szenarien nicht unbedingt sinnvoll.
Wann man nicht nur das Code Arena WebDev-Ranking betrachten sollte
Wenn Sie hauptsächlich mit Terminalbedienung, langkettigen Codeänderungen oder mehrstufigen Agent-Aufgaben arbeiten, überschätzen Sie die tatsächliche Leistung von Qwen4-Max, wenn Sie nur den WebDev-Elo betrachten. Dann kommen Benchmarks wie Terminal-Bench dem tatsächlichen Bedarf näher. Ebenso sollten Sie bei einem festen Budget die Kosten pro Aufgabe zusammen mit der Punktzahl betrachten, statt nur der Platzierung nachzujagen. Am besten beantwortet dieses Ranking die Frage: „Wer erstellt aus Sicht menschlicher Prüfer die bessere Webseite?“
Häufig gestellte Fragen (FAQ)
F1: Ist der 6. Platz von Qwen4-Max im Code Arena WebDev-Ranking ein echter Rang?
Ja, es ist der tatsächlich auf der Ranking-Seite angezeigte Rang (14.11.2026, Kategorie Overall, 1750 Punkte). Er trägt jedoch den Vermerk „Preliminary“ und basiert nur auf 1.814 Stimmen, sodass sich der Rang später noch ändern kann. Beim Zitieren empfiehlt es sich, diese Bedingungen anzugeben.
F2: Wie groß ist der Abstand zwischen Qwen4-Max und GPT-6 Astra bzw. Opus 5.5?
Im Code Arena WebDev liegt Qwen4-Max 13 Punkte unter GPT-6 Astra, 66 Punkte unter Opus 5.5 und 76 Punkte unter dem Spitzenreiter Fable 5.2. Auf den von Alibaba offiziell selbst gemeldeten Benchmarks Terminal-Bench 4.0 und ProgramBench ist der Abstand zu diesen beiden Modellen jedoch deutlich größer.
F3: Wie weit liegt Qwen4-Max unter den chinesischen Modellen vorn?
Es ist das einzige chinesische Modell in den Top Ten und liegt 64 Punkte über dem zweitplatzierten chinesischen Modell Kimi K3.1 Pro (Platz 13, 1686 Punkte) sowie 74 Punkte über der eigenen Vorgängergeneration Qwen3.8-Max (0902).
F4: Für welche Szenarien eignet sich Qwen4-Max am besten?
Gemessen an diesem Ranking eignet es sich eher für WebDev-Aufgaben wie die Generierung von Web-Frontends, Landingpages und interaktiven Prototypen. Für Terminal-Automatisierung, groß angelegte Codeänderungen auf Engineering-Ebene und ähnliche Szenarien empfiehlt es sich, Terminal-Benchmarks zu konsultieren und eigene Stichproben zur Validierung durchzuführen.
F5: Wie ruft man die Qwen-Modellreihe über die API für Vergleichstests auf?
Sie können sich bei APIYI apiyi.com registrieren und einen API-Schlüssel erhalten, im OpenAI-kompatiblen SDK die `base_url` auf `https://api.apiyi.com/v1` setzen und als Modell-ID `qwen3.8-max` angeben. `qwen4-max` ist derzeit noch nicht verfügbar; wir werden es so bald wie möglich aufnehmen. Nach der Aufnahme genügt ein Wechsel der Modell-ID, um den Vergleich umzustellen.
F6: Ist der Aufwand von 4,18 $ pro Aufgabe der Preis von Qwen4-Max?
Nein. Die 4,18 $ sind der mediane Aufwand pro Aufgabe (P50) aus der Ranking-Statistik und werden von der Ausgabelänge und der Reasoning-Stufe beeinflusst. Der Modell-Einzelpreis richtet sich nach den Preisen für Input, Output und Cache-Lesen pro 1 Mio. Tokens; die aktuellen Preise können Sie in der Modellliste von APIYI apiyi.com nachprüfen.
Qwen4-Max Code Arena WebDev: die wichtigsten Erkenntnisse
- Rang: In der Rangliste vom 14.11.2026 auf Platz 6 mit 1750 Punkten – erstmals ein chinesisches Modell unter den Top 6.
- Aufteilung: Die Top 5 sind komplett belegt – drei Plätze für Anthropic, je einer für Google und OpenAI.
- Stabilität: Preliminary-Kennzeichnung bei 1.814 Stimmen, die Platzierung kann sich also noch verschieben.
- Abstand zu chinesischen Modellen: 64 Punkte Vorsprung vor Kimi K3.1 Pro, 74 Punkte vor der vorherigen Generation.
- Grenzen des Modells: Bei Terminal-Bench und ProgramBench liegen die offiziell selbst gemeldeten Werte weiterhin hinter den Spitzenreitern.
- Kostenbasis: P50 $4.18 ist der Median pro Aufgabe, nicht der Preis des Modells.
- Einstieg: Man kann zunächst bei APIYI mit
qwen3.8-maxeine Vergleichspipeline aufbauen und später auf das neue Modell umstellen, sobald es verfügbar ist.
Zusammenfassung
Die Leistung von Qwen4-Max in der Code Arena WebDev-Rangliste lässt sich in drei Punkten zusammenfassen:
- Erstmals unter den Top 6: 1750 Punkte, das einzige Modell eines nicht-US-amerikanischen Labors unter den ersten sechs – nur 13 Punkte hinter Platz 5.
- Die Platzierung ist noch ein früher Messwert: Preliminary, 1.814 Stimmen – beim Zitieren sollte man Datum und Stimmenzahl angeben.
- Elo bedeutet nicht automatisch umfassende Stärke: Bei den offiziell selbst gemeldeten Terminal- und Engineering-Programmierbenchmarks liegt es weiterhin hinter Opus 5.5 und GPT-6 Astra.
Wenn Sie eine Auswahl treffen, sollten Sie diese Rangliste als einen Referenzpunkt für „Vorlieben bei der Webentwicklung“ betrachten und dazu Ihre eigenen Aufgabenbeispiele und Ihr Kostenbudget heranziehen. Empfehlenswert ist, über APIYI apiyi.com mit einer einheitlichen Schnittstelle die Kandidatenmodelle auf demselben Aufgabensatz zu vergleichen und die Schlussfolgerung aus Ihren eigenen Daten zu ziehen.
📚 Referenzen
- arena.ai Code Arena WebDev-Rangliste: Quelle für Platzierung, Punktzahl, Stimmen und Kosten pro Aufgabe in diesem Artikel
- Link:
arena.ai -
Hinweis: Die Seite ist mit 2026-11-14 datiert, Kategorie Overall; die aktuellen Platzierungen und die Preliminary-Markierung können Sie selbst überprüfen
-
Offizielle Veröffentlichungsgrafik zu Alibaba Qwen4-Max: Quelle für Benchmark-Werte wie Terminal-Bench 4.0 und ProgramBench
- Link: Die offiziellen Veröffentlichungskanäle von Qwen sind maßgeblich
- Hinweis: Die relevanten Daten im Artikel sind offizielle Eigenangaben und keine Reproduktion durch Dritte
Autor: APIYI-Technikteam
Technischer Austausch: Sie erreichen uns über die Startseite von APIYI. Hinweise zur Modelllistung und Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com


