
Zusammenfassung: Dieser Artikel berechnet mit derselben Workload, wie sich die Kosten von Prompt Caching auf die vier Bereiche Cache-Schreiben, Cache-Lesen, dynamische Eingabe und Ausgabe verteilen – und zeigt, wie Trefferquote, TTL und Aufrufrhythmus die tatsächliche Ersparnis beeinflussen.
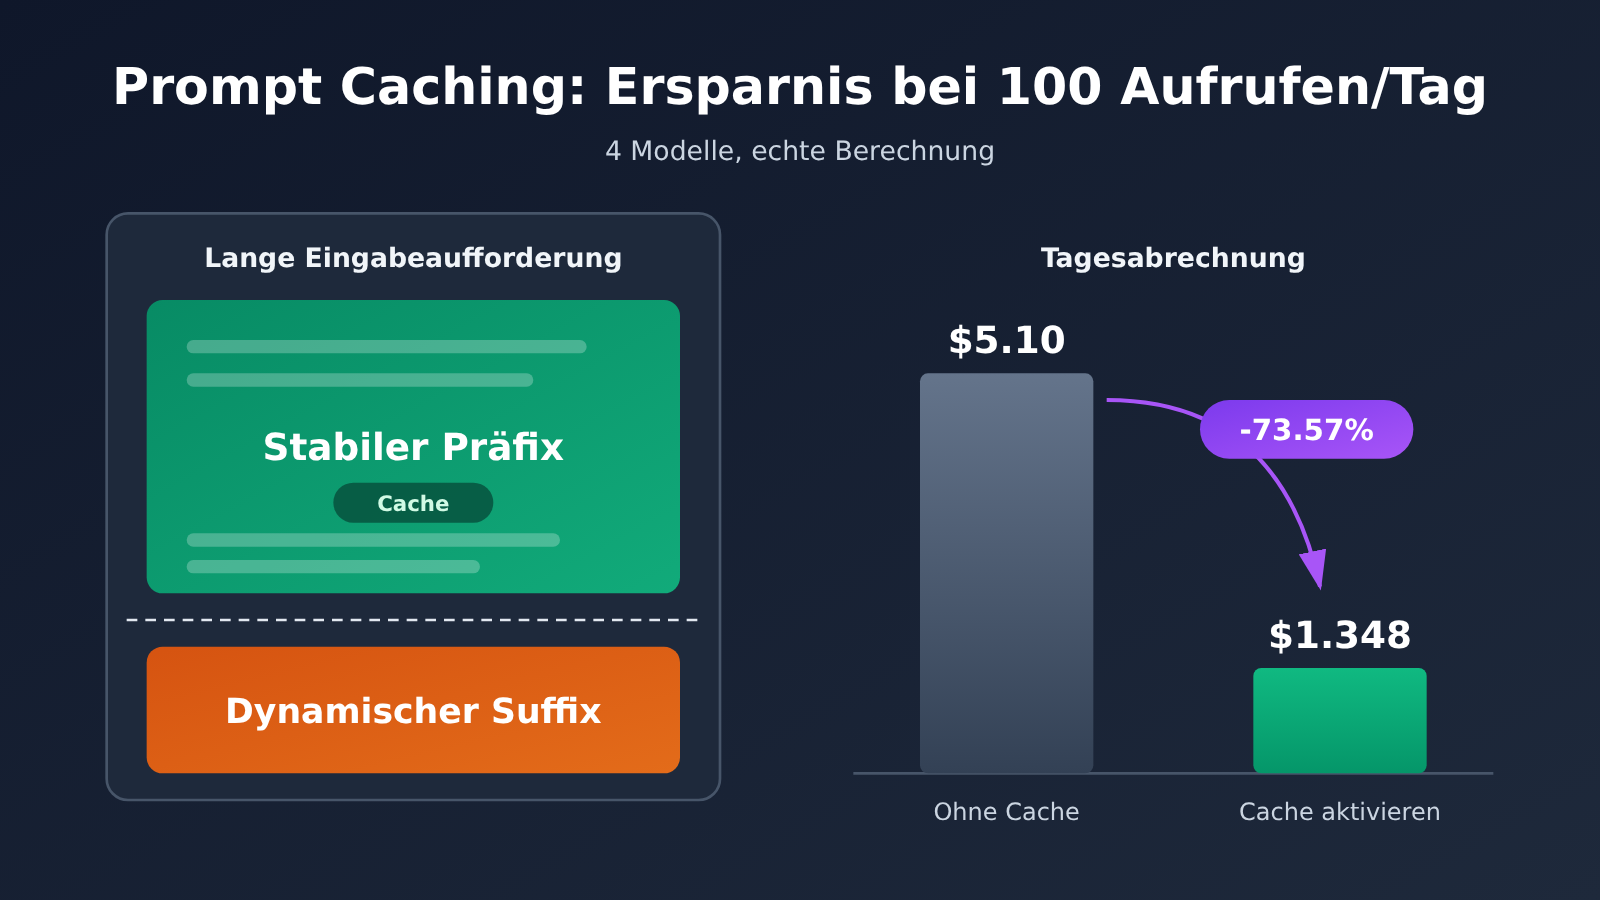
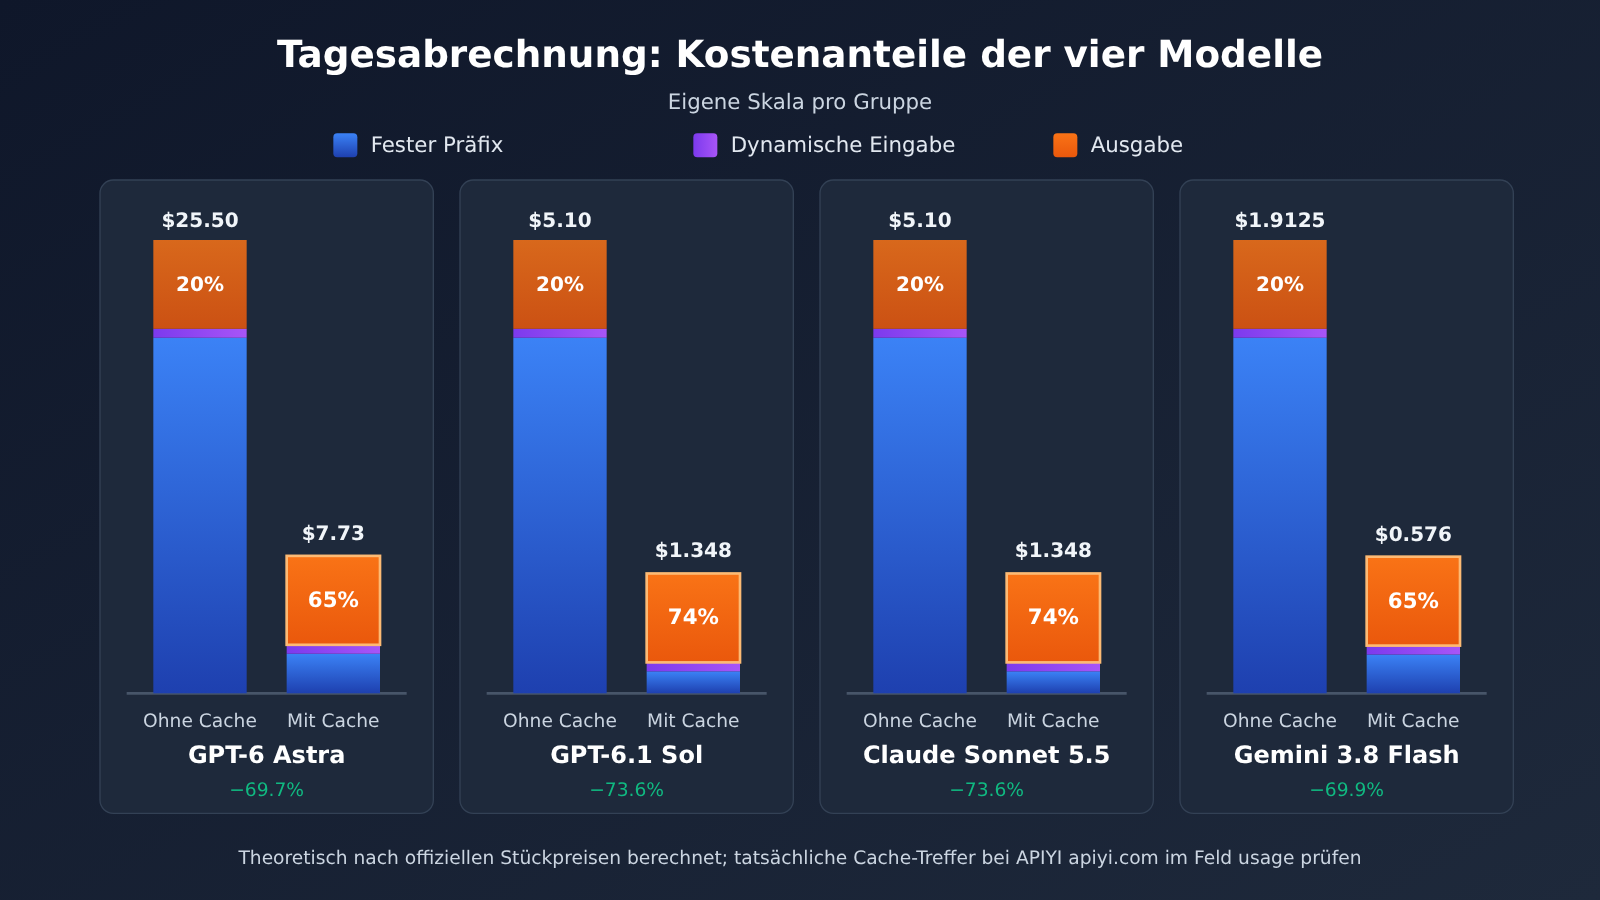
Fazit: Die hier definierte Workload besteht aus einem festen Prefix von 20K Token pro Aufruf, 500 Token dynamischer Eingabe und 1K Token Ausgabe, bei 100 Aufrufen pro Tag. Unter der idealen Annahme „erster Aufruf schreibt, die folgenden 99 treffen alle“ sinkt die komplette Tagesrechnung von GPT-6.1 Sol von $5.10 auf $1.348 – ein Rückgang von rund 73.57 %. Bei Claude Sonnet 5.5 kommt dasselbe Ergebnis heraus, GPT-6 Astra geht von $25.50 auf $7.73 (rund 69.69 % weniger), Gemini 3.8 Flash von $1.9125 auf $0.576 (rund 69.88 %). Betrachtet man nur den festen Prefix, liegt die Ersparnis zwischen 88 % und 94 %. Dass die Gesamtrechnung weniger stark sinkt, liegt daran, dass Ausgabe-Token und dynamische Eingabe keinen Cache-Rabatt bekommen. Alle Zahlen sind Budgetrechnungen auf Basis der offiziellen Stückpreise, keine echten Rechnungen. Durchgängig wird der Standardtarif für kurzen Kontext verwendet, Stand der Preisprüfung: 2026-11-13.
Was euch erwartet: Teil 1 erklärt, welcher Abschnitt der Anfrage beim Caching wiederverwendet wird und welcher Teil der Rechnung davon betroffen ist. Teil 2 vergleicht die Cache-Regeln von OpenAI, Claude und Gemini. Teil 3 listet die Formeln für die vier Modelle Punkt für Punkt auf, sodass ihr selbst nachrechnen könnt. Teil 4 zeigt anhand einer Rechnung zu TTL und Aufrufrhythmus, warum die Trefferquote sinkt. Teil 5 behandelt den Aufbau der Eingabeaufforderung, die Wahl der TTL, Codebeispiele und Methoden zur Überwachung der Trefferquote. Teil 6 diskutiert, nach welchen Kriterien man die Token-Kosten in Szenarien mit massenhafter KI-Produktion steuert.
To Know: Vorbereitung der Prompt-Caching-Terminologie
| Begriff | Erklärung |
|---|---|
| Token | Die Einheit, in der das Modell Text zählt. Die API rechnet nach der Token-Anzahl ab, der Stückpreis wird üblicherweise als „US-Dollar / Million Token (MTok)“ angegeben |
| Prompt Caching | Der bereits verarbeitete Prompt-Präfix wird zwischengespeichert; bei späteren Anfragen mit identischem Präfix wird er direkt wiederverwendet, um die Kosten für wiederholte Verarbeitung zu senken |
| Stabiler Präfix | Der wortgleiche Anfangsteil eines Prompts über mehrere Anfragen hinweg, etwa Rollenbeschreibung, Schreibvorgaben, Referenztexte, Wissensdatenbank |
| Dynamische Eingabe | Inhalte, die sich mit jeder Anfrage ändern, etwa die aktuellen Nachrichtenmaterialien des Tages, Artikeltitel, Nutzeranforderungen |
| Cache-Schreiben | Der stabile Präfix wird erstmals verarbeitet und in den Cache geschrieben; der Stückpreis liegt meist über dem einer normalen Eingabe |
| Cache-Lesen | Bei späteren Anfragen wird ein vorhandener Cache getroffen und zu einem deutlich niedrigeren Stückpreis als eine normale Eingabe abgerechnet |
| Cache-Treffer | Der Präfix der neuen Anfrage stimmt Token für Token mit einem verfügbaren Cache überein, die Wiederverwendung gelingt |
| TTL | Die Lebensdauer des Caches. OpenAI definiert sie als Mindestlebensdauer und garantiert keinen exakten Löschzeitpunkt |
| Cache-Breakpoint | Die Stelle im Prompt, die markiert, dass „der cachebare Präfix hier endet“ |
| Implizites / explizites Caching | Beim impliziten Caching entscheidet das System automatisch über die Wiederverwendung; beim expliziten Caching deklariert der Entwickler aktiv einen Breakpoint oder legt ein Cache-Objekt an |
| Vollständige Aufgabenkosten | Die Summe aus Eingabe, Ausgabe und gegebenenfalls anfallenden Tool-Kosten eines Aufrufs; sie ist der echte Nenner für die Messung des Einsparungsanteils |
1 Prompt Caching spart Geld – wo genau?
1.1 Was Prompt Caching wiederverwendet
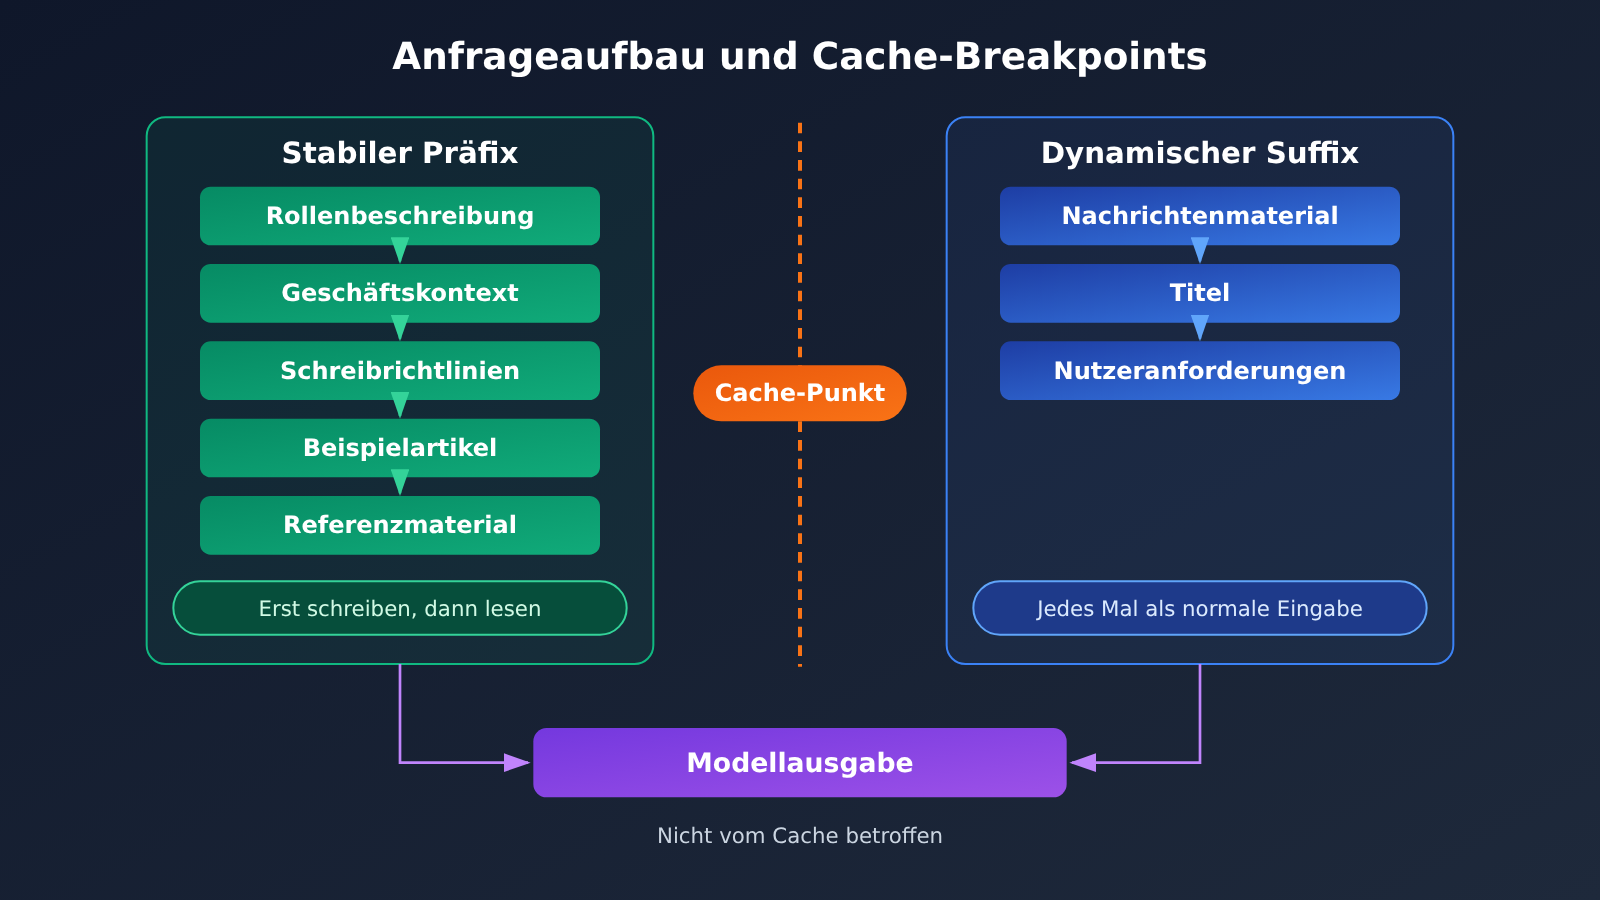
Nehmen wir als Beispiel eine KI-Schreibplattform. Jede Anfrage zur Erzeugung eines Artikels besteht aus zwei Teilen. Der erste Teil ist der feste Inhalt: Rollenbeschreibung, Geschäftskontext, Schreibrichtlinien, Beispielartikel, Terminologie und Referenzmaterial. Der zweite Teil ist der dynamische Inhalt: die aktuellen Nachrichtenmaterialien des Tages, der Artikeltitel und die konkreten Anforderungen des Nutzers.
Prompt Caching verwendet den ersten Teil wieder, genauer gesagt das Token für Token identische Präfix. Beim Cache-Abgleich muss die Token-Sequenz vollständig übereinstimmen; bloße semantische Ähnlichkeit zählt nicht als Treffer. Eine geänderte Formulierung, eine andere Reihenfolge der Absätze oder eine Neuordnung der Tool-Definitionen können dazu führen, dass das Präfix zu neuem Inhalt wird und der Cache ungültig wird.
Daher gilt für die Cache-Optimierung ein Grundprinzip: Stabile Inhalte nach vorne, veränderliche Inhalte nach hinten.
1.2 Welche Kostenanteile Prompt Caching einspart
Die Abrechnung eines einzelnen Aufrufs lässt sich in fünf Posten aufteilen, wobei nur die Kosten für das feste Präfix durch den Cache verändert werden:
| Kostenposten | Ohne Cache | Mit aktiviertem Cache |
|---|---|---|
| Festes Präfix | Jedes Mal zum normalen Input-Preis | Erstmalig zum Schreibpreis, bei Treffer zum Lesepreis |
| Dynamischer Input | Normaler Input-Preis | Normaler Input-Preis, unverändert |
| Modellausgabe | Ausgabepreis | Ausgabepreis, unverändert |
| Tool-Kosten | Nach Tool-Regeln | Nach Tool-Regeln, unverändert |
| Expliziter Cache-Speicher (Gemini) | Keiner | Zusätzlich nach Speicherdauer berechnet |
Diese Tabelle verdeutlicht einen wichtigen Unterschied: Die Einsparquote beim festen Präfix und die Einsparquote der Gesamtrechnung sind zwei verschiedene Kennzahlen. Erstere misst nur die Reduktion des gecachten Anteils, letztere die Reduktion der gesamten Rechnung. Je länger die Ausgabe, desto niedriger die letztere.
2. Worin unterscheiden sich die Prompt-Caching-Regeln von GPT, Claude und Gemini?
2.1 OpenAI Prompt-Caching: 30m und 12h
Laut OpenAI-Dokumentation gilt für GPT-5.6 und nachfolgende Modelle: Die Mindestlänge des gecachten Präfixes beträgt in der Regel 1.024 sichtbare Input-Token; unterstützt werden die Modi „implizit“ (implicit) und „explizit“ (explicit). Im expliziten Modus markieren Entwickler in geeigneten Nachrichteninhaltsblöcken prompt_cache_breakpoint und legen damit die Grenze des gecachten Präfixes eindeutig fest.
Die TTL beträgt standardmäßig 30 Minuten. Über die Responses API lässt sich mit prompt_cache_options.ttl = "12h" eine Mindestlebensdauer von 12 Stunden auswählen. Die Abrechnung erfolgt getrennt nach Schreiben und Lesen:
- Schreiben bei 30 Minuten: 1,25-mal der normale Input-Preis
- Schreiben bei 12 Stunden: 2,5-mal der normale Input-Preis
- Cache-Lesen: bei den meisten neuen Modellen 0,1-mal der normale Input-Preis, bei GPT-6.1 Sol und GPT-6.1 Terra 0,05-mal
Mit prompt_cache_key lassen sich die Cache-Abrechnungen für verschiedene Nutzer oder Workspaces voneinander trennen. Bei GPT-5.6 und nachfolgenden Modellen wird das Cache-Routing bereits automatisch vom Anbieter verwaltet.
2.2 Claude Prompt Caching: 5m und 1h
Claude unterstützt automatisches oder explizites Caching über cache_control. Die standardmäßige Gültigkeitsdauer beträgt 5 Minuten, und jeder Treffer erneuert die Gültigkeit. Die 5 Minuten werden ab dem Schreib- oder Lesevorgang des Cache berechnet; die Zeit, die für die Erzeugung der Antwort benötigt wird, zählt ebenfalls mit. Bei Aufgaben mit langen Ausgaben ist das tatsächlich verfügbare Intervall daher kürzer als 5 Minuten.
Die Abrechnungsfaktoren lauten: Schreiben für 5 Minuten das 1.25-Fache, Schreiben für 1 Stunde das 2-Fache, normaler Lesevorgang das 0.1-Fache. Bei Claude Sonnet 5.5 und Claude Opus 5.5 sinkt der Lesetarif auf das 0.05-Fache. Der Standardpreis von Sonnet 5.5 lautet: Eingabe $2, Schreiben für 5 Minuten $2.50, Schreiben für 1 Stunde $4, Lesen $0.10, Ausgabe $10 (alle Angaben in US-Dollar pro Million Token).
2.3 Gemini Context Caching: implizit und explizit
Gemini 2.5 und neuere Modelle aktivieren standardmäßig implizites Caching, ohne zusätzliche Konfiguration. Die Mindestanforderung an die Eingabe variiert je nach Modell: Bei Gemini 3.8 Flash sind es 4,096 Token, bei Gemini 2.5 Flash und 2.5 Pro 2,048 Token. Google empfiehlt, gemeinsam genutzte Inhalte an den Anfang der Eingabeaufforderung zu stellen und denselben Präfix innerhalb kurzer Zeit wiederzuverwenden.
Explizites Caching erfordert, dass Entwickler aktiv ein Cache-Objekt anlegen und dessen Lebensdauer festlegen. Die Kosten setzen sich aus drei Teilen zusammen: dem Inhalt des Cache, den nachfolgenden Lesevorgängen und der Speicherdauer. Die Gemini Interactions API unterstützt derzeit nur implizites Caching; wenn ein explizites Cache-Objekt benötigt wird, verwendet man die generateContent API.
Die Preise von Gemini 3.8 Flash mit Stand 31. Dezember 2026 lauten: Eingabe $0.75, Ausgabe $3.75, Cache-Lesevorgang $0.075, expliziter Cache-Speicher $0.50 / Million Token / Stunde. Ab dem 1. Januar 2027 will Google offiziell auf $1.50, $7.50, $0.15, $1.00 umstellen. Alle vier Preise verdoppeln sich im gleichen Verhältnis, daher bleiben die im Folgenden berechneten Einsparquoten unverändert; die absoluten Beträge verdoppeln sich.
2.4 Vergleich der Prompt-Caching-Regeln der drei Anbieter
| Kriterium | OpenAI | Claude | Gemini |
|---|---|---|---|
| Caching-Methode | implizit / expliziter Breakpoint | cache_control automatisch / explizit |
implizit (Standard) / explizites Cache-Objekt |
| Standard-TTL | 30 Minuten (Mindestlebensdauer) | 5 Minuten, bei Treffer aufgefrischt | implizit vom System verwaltet; explizit selbst festgelegte Dauer |
| Optionen für lange TTL | 12 Stunden (Responses API) | 1 Stunde | explizites Cache, frei konfigurierbar |
| Schreibtarif | 30 Min.: 1,25-fach; 12 Std.: 2,5-fach | 5 Min.: 1,25-fach; 1 Std.: 2-fach | implizit beim ersten Mal als normale Eingabe abgerechnet |
| Lesetarif | 0,1-fach (Sol / Terra: 0,05-fach) | 0,1-fach (Sonnet / Opus 5.5: 0,05-fach) | 3.8 Flash: $0,075 / MTok |
| Zusätzliche Kosten | keine Speichergebühren | keine Speichergebühren | explizites Caching: Speichergebühr pro Stunde |
| Mindest-Präfix | in der Regel 1.024 Token | gemäß offizieller Dokumentation | 3.8 Flash: 4.096 Token |
3 100 Aufrufe pro Tag – wie viel spart Prompt Caching wirklich?
3.1 Einheitliche Berechnungsgrundlagen
Die folgende theoretische Kalkulation basiert auf den offiziellen Stückpreisen und ist keine tatsächliche Nutzerrechnung. Es gelten diese einheitlichen Annahmen:
- Pro Aufruf ein fester Prefix von 20.000 Token, dynamische Eingabe 500 Token, Ausgabe 1.000 Token
- 100 Aufrufe pro Tag, immer mit demselben Modell
- Die dynamischen Inhalte stehen vollständig hinter dem stabilen Prefix
- Cache-Szenario: 1. Aufruf schreibt, die folgenden 99 Aufrufe treffen vollständig; alle Aufrufe erfolgen innerhalb der TTL, oder die Gültigkeit wird bei jedem Treffer verlängert
- Aufschläge von Drittanbietern, Mengenrabatte und Tool-Gebühren bleiben unberücksichtigt
- Der 20K-Prefix löst bei GPT-6 Astra keine zusätzliche Langkontext-Abrechnung aus, die ab 272K Token greift
Die Berechnungsformel lautet einheitlich:
Einzelkosten = Token-Anzahl × Aufrufanzahl ÷ 1,000,000 × Stückpreis (USD / MTok)
Prefix-Kosten nach Caching = 20,000 × 1 ÷ 1,000,000 × Schreibpreis + 20,000 × 99 ÷ 1,000,000 × Lesepreis
3.2 Die vollständige Formel für GPT-6 Astra
Einzelpreise von GPT-6 Astra: normale Eingabe $10, Ausgabe $50, 30-Minuten-Schreiben $12.50, Cache-Lesen $1.
Ohne Cache:
- Fester Präfix: 20,000 × 100 ÷ 1,000,000 × $10 = $20
- Dynamische Eingabe: 500 × 100 ÷ 1,000,000 × $10 = $0.50
- Ausgabe: 1,000 × 100 ÷ 1,000,000 × $50 = $5
- Gesamt pro Tag: $25.50
30-Minuten-Cache:
- Erster Schreibvorgang: 20,000 ÷ 1,000,000 × $12.50 = $0.25
- 99 Lesevorgänge: 20,000 × 99 ÷ 1,000,000 × $1 = $1.98
- Dynamische Eingabe: $0.50; Ausgabe: $5
- Gesamt pro Tag: $7.73
Die vollständige Abrechnung spart $17.77, also rund 69.69%. Der feste Präfix sinkt von $20 auf $2.23 – eine Einsparung von etwa 88.85%.
3.3 GPT-6.1 Sol, Claude Sonnet 5.5, Gemini 3.8 Flash
GPT-6.1 Sol (Eingabe $2, Ausgabe $10, 30-Minuten-Schreiben $2.50, Lesen $0.10):
- Ohne Cache: Präfix $4 + dynamische Eingabe $0.10 + Ausgabe $1 = $5.10
- Mit Cache: Schreiben $0.05 + Lesen $0.198 + dynamische Eingabe $0.10 + Ausgabe $1 = $1.348
- Einsparung $3.752, also rund 73.57%; der Präfix sinkt von $4 auf $0.248 – eine Einsparung von etwa 93.8%
Bei Claude Sonnet 5.5 (5-Minuten-Cache) sind die Einzelpreise mit denen von GPT-6.1 Sol identisch, und auch Rechenweg und Ergebnis stimmen überein: von $5.10 auf $1.348. Voraussetzung ist, dass die Abstände zwischen den Aufrufen die 5-Minuten-Gültigkeit durchgehend einhalten.
Gemini 3.8 Flash (impliziter Cache, beim ersten Mal zum normalen Eingabepreis von $0.75):
- Ohne Cache: Präfix $1.50 + dynamische Eingabe $0.0375 + Ausgabe $0.375 = $1.9125
- Mit Cache: erster Präfix $0.015 + 99 Lesevorgänge $0.1485 + dynamische Eingabe $0.0375 + Ausgabe $0.375 = $0.576
- Einsparung $1.3365, also rund 69.88%; der Präfix sinkt von $1.50 auf $0.1635 – eine Einsparung von etwa 89.1%
- Dieses Ergebnis setzt voraus, dass der implizite Cache vollständig greift, und enthält keine Speichergebühren für den expliziten Cache.
3.4 Prompt Caching: prozentuale Ersparnis vs. absoluter Betrag
| Modell | Ohne Cache / Tag | Mit Cache / Tag | Ersparnis pro Tag | Ersparnis über 30 Tage (extrapoliert) | Präfix-Ersparnisrate | Ersparnisrate auf die Gesamtrechnung |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
Aus der Tabelle lassen sich zwei Punkte ablesen:
- Der Prozentsatz spiegelt den Rabatt auf die Lesezugriffe wider. Bei GPT-6.1 Sol und Claude Sonnet 5.5 kostet ein zwischengespeicherter Lesezugriff nur das 0.05-Fache einer normalen Eingabe, die Präfix-Ersparnisrate erreicht 93.8% und liegt damit höher als bei Astra und Gemini, deren Lesezugriffe das 0.1-Fache kosten.
- Der absolute Betrag hängt vom Grundpreis ab. Astra hat die niedrigste Ersparnisrate, spart aber $17.77 pro Tag – mehr als das 13-Fache von Gemini 3.8 Flash. Je höher der Stückpreis eines Modells, desto größer der absolute Nutzen, den das aktivierte Caching bringt.
Nach dem Caching steigt der Anteil der Ausgabe an der Rechnung von GPT-6 Astra von rund 20% auf etwa 65% ($5 ÷ $7.73). Der Fokus weiterer Kostenoptimierung verschiebt sich damit auf die Kontrolle der Ausgabelänge. Wichtig zu wissen: Dass die vier Modelle dieselbe Token-Anzahl verwenden, dient nur dem einfacheren Vergleich. Bei derselben Aufgabe unterscheiden sich die tatsächliche Ausgabelänge und die Trefferquote der Modelle durchaus.
💡 Empfehlung zur Auswahl: Liegen die Prozentsätze nah beieinander, achten Sie zuerst auf die Balance zwischen der absoluten täglichen Ersparnis und der Qualität der Aufgabe. Am besten rufen Sie zuerst in APIYI apiyi.com mit derselben Vorlage mehrere Kandidatenmodelle auf, protokollieren die echte Ausgabelänge und die gecachten Token und setzen diese dann in die obige Formel ein, um das Monatsbudget zu schätzen.
4 Warum kann die Prompt-Caching-Rechnung trotz täglich identischer Prompts immer noch hoch sein?
4.1 TTL und Aufrufhäufigkeit bestimmen die Trefferquote
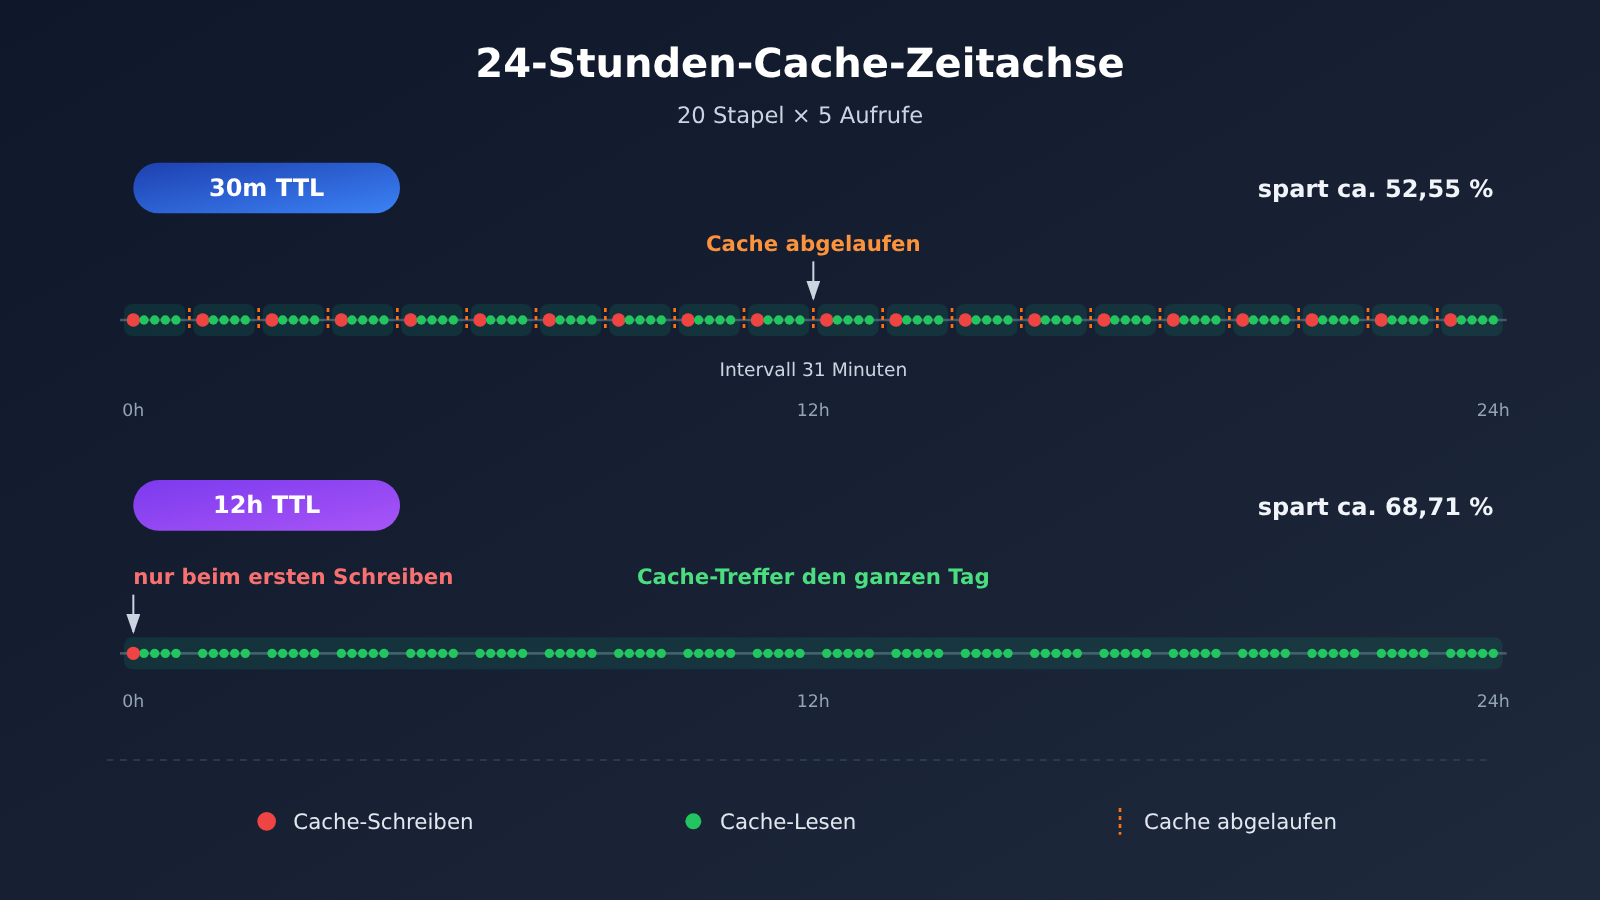
100 Aufrufe pro Tag bedeuten nicht, dass ein einziger Write den ganzen Tag abdeckt. Nehmen wir als Beispiel GPT-6 Astra: 20 Batches pro Tag, pro Batch 5 aufeinanderfolgende Aufrufe, zwischen zwei Batches liegen 31 Minuten.
| Szenario | Schreibvorgänge und Kosten | Lesevorgänge und Kosten | Präfixkosten | zzgl. dynamischer Eingabe und Ausgabe | Tagessumme | Ersparnisrate |
|---|---|---|---|---|---|---|
| Ohne Cache | — | — | $20 | $5.50 | $25.50 | — |
| A: 30m-Cache | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | ca. 52.55% |
| B: 12h-Cache (innerhalb desselben Fensters) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | ca. 68.71% |
In Szenario A überschreitet der Abstand zwischen den Batches 30 Minuten, sodass jeder Batch neu geschrieben werden muss; die Ersparnisrate sinkt von den idealen 69.69% auf 52.55%. In Szenario B kostet ein einzelner Write das Doppelte des 30m-Tarifs, aber es wird nur einmal pro Tag geschrieben – für verstreute Aufrufe ist das also günstiger. Die 12h-Variante deckt nur dasselbe Fenster ab; ob sich derselbe Cache am nächsten Tag wiederverwenden lässt, ist nicht garantiert. Bei Aufgaben mit nur einem oder zwei Aufrufen pro Tag lässt sich allein über identische Prompts kein Cache über Tagesgrenzen hinweg erreichen.
Die Break-even-Punkte der verschiedenen TTLs lassen sich allein anhand des stabilen Präfixes betrachten, wobei normale Eingabe als 1× gerechnet wird:
| Variante | Schreibfaktor | Lesefaktor | 1× Schreiben + 1× Lesen vs. 2× ohne Cache | 1× Schreiben + 2× Lesen vs. 3× ohne Cache | Nötige gültige Lesevorgänge zur Amortisation |
|---|---|---|---|---|---|
| OpenAI 30m | 1.25 | 0.1 | 1.35 < 2 | — | 1× |
| OpenAI 12h | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | 2× |
| Claude Sonnet 5.5 · 5m | 1.25 | 0.05 | 1.30 < 2 | — | 1× |
| Claude Sonnet 5.5 · 1h | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | 2× |
Das Fazit ist eindeutig: Bei kurzen TTLs reicht ein einziger Treffer zur Amortisation; bei langen TTLs braucht es mindestens zwei Treffer innerhalb der Gültigkeitsdauer.
4.2 Cache-Breakpoints und die Reihenfolge der Eingabeaufforderung
Die häufigste Ursache für ein Cache-Miss ist ein veränderter stabiler Präfix. Wer Zeitstempel, Benutzer-IDs, Aufgabenüberschriften oder Echtzeitmaterial an den Anfang der Eingabeaufforderung setzt, erzeugt bei jeder Anfrage einen neuen Präfix – der Cache kann dann nie greifen.
Im impliziten Modus von OpenAI kann es passieren, dass die erste Anfrage auch dynamische Inhalte in den Cache-Bereich einbezieht; ändert sich dieser dynamische Teil später, wird der erwartete stabile Präfix unter Umständen nicht mehr getroffen. Die Lösung besteht darin, am Ende des stabilen Inhalts einen expliziten Cache-Breakpoint zu setzen.
Weitere häufige Ursachen sind:
- Ein anderes Modell, ein anderer Anbieter oder eine andere Service-Organisation wurde verwendet, oder einige Parameter wurden geändert
- Der Agent führt eine Dialogkomprimierung durch, ordnet die Tool-Definitionen neu oder ändert Verlaufsnachrichten – dadurch wird der wiederverwendbare Präfix umgeschrieben
- Ein Drittanbieter-Gateway reicht die Cache-Parameter nicht weiter oder berücksichtigt den Cache-Rabatt nicht in der Abrechnung
4.3 Auswirkungen von Output-Tokens und Tool-Kosten
Der Cache wirkt nur auf den Eingabe-Präfix. Im Astra-Rechenbeispiel aus Abschnitt 3.2 bleibt die Rechnung selbst dann über $5.50 (dynamische Eingabe plus Ausgabe), wenn die Präfixkosten auf null sinken. Bei Aufgaben mit langen Ausgaben und vielen Tool-Aufrufen fällt die Reduktion der Gesamtrechnung deutlich geringer aus als die Einsparquote beim Präfix. Deshalb sollte man nach dem Aktivieren des Caches zusätzlich die Ausgabelänge begrenzen und die Tool-Aufrufe straffen.
5 Wie konfiguriert und überwacht man Prompt Caching in KI-Anwendungen?
5.1 So ordnen Sie stabilen Präfix und dynamischen Suffix an
Sortieren Sie die Inhalte in der Reihenfolge „von niedriger zu hoher Änderungsfrequenz“:
- Werkzeugdefinitionen: Feste Reihenfolge und feste Beschreibungen beibehalten, nicht pro Anfrage dynamisch hinzufügen oder entfernen
- Systemregeln und Schreibkonventionen: Rollenbeschreibung, Markenrichtlinien, Stilanforderungen
- Beispieltexte und Wissensbasis: Umfangreiche Referenzdokumente, bei Versionsupdates komplett ersetzen
- (Cache-Unterbrechungspunkt)
- Dynamische Materialien: Tagesaktuelle Nachrichten, Suchergebnisse, Nutzereingaben
- Aktuelle Aufgabenanweisung: Titel, Wortzahl, konkrete Anforderungen
Das folgende Beispiel ruft über die OpenAI-kompatible Schnittstelle auf und liest die Cache-Token aus der Antwort aus:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

STABLE_PREFIX = """你是一名技术博客作者……(写作规范、范文、术语表,约 20K Token,内容逐字固定)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # Maßgeblich ist der tatsächliche Name in der Modellliste der Plattform
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # Stabiles Präfix ganz am Anfang
        {"role": "user", "content": "今日材料:……\n标题:……"},  # Dynamische Inhalte weiter hinten
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"输入 {resp.usage.prompt_tokens},命中缓存 {cached}")
Vollständigen Code ansehen: Kostenrechner + Trefferquote-Statistik
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """Berechnet die täglichen Kosten (in USD) anhand der offiziellen Stückpreise und gibt (Präfix, dynamische Eingabe, Ausgabe, Gesamt) zurück"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # Name: (Eingabe, Ausgabe, Schreiben, Lesen) USD / Million Token, Prüfdatum 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # Implizites Caching wird beim ersten Mal als normale Eingabe abgerechnet
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},节省 {(base - cached) / base:.2%}")

# Szenario A: Astra 30m, 20 Batches mit jeweils erneutem Schreiben
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- Statistik zur Trefferquote im Live-Betrieb ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"实际缓存命中率:{hit:.2%}")
    return hit
🚀 Tipp für den schnellen Einstieg: Schätzen Sie zunächst mit dem obigen Rechner das Budget, führen Sie dann mit einer echten Vorlage 10–20 Aufrufe durch und prüfen Sie, ob
cached_tokensab dem zweiten Aufruf stabil erscheint. Neue Nutzer können bei APIYI apiyi.com ein kostenloses Testkontingent erhalten, um diesen Schritt zu validieren. Erst wenn die Treffer bestätigt sind, skalieren Sie das Volumen.
5.2 Auswahl von Prompt-Caching-TTL und Cache-Modus
- Hochfrequente, kontinuierliche Aufrufe (mit stabilen Abständen im Bereich weniger Minuten): kurzes Standard-TTL verwenden, also OpenAI 30 Min. und Claude 5 Min. Ein einziger Treffer amortisiert die Kosten bereits, und der Schreibaufschlag ist am niedrigsten. Bei Claude muss die Dauer der Antwortgenerierung in das 5-Minuten-Fenster eingerechnet werden.
- Über den Tag verteilte Aufrufe (Batch-Abstände von mehr als 30 Minuten): OpenAI mit 12 Std. oder Claude mit 1 Std. evaluieren. Solange innerhalb des Fensters mindestens zwei Treffer erzielt werden, ist ein langes TTL günstiger als wiederholtes Schreiben. Szenario B aus Abschnitt 4.1 ist dafür ein Beispiel.
- Gemini-Aufgaben mit sehr langem Präfix, die über längere Zeiträume hinweg wiederverwendet werden sollen: Explizites Caching in Betracht ziehen und dabei die Speicherkosten mitrechnen. Bei Gemini 3.8 Flash beispielsweise kostet das Speichern von 20K Token für 12 Stunden $0.02 × $0.50 × 12 = $0.12. Unter der in diesem Artikel betrachteten Workload ist dieser Betrag im Vergleich zur Tagesabrechnung von $0.576 schon recht deutlich. Wenn implizites Caching eine gute Trefferquote erzielt, die Standardeinstellung beibehalten.
- Häufig wechselnde Präfixe: Zuerst das Präfix stabilisieren, dann über TTL nachdenken. Bei instabilem Präfix bringt auch das beste TTL keine Treffer.
5.3 Die tatsächliche Trefferquote und Abrechnung von Prompt Caching überprüfen
Die usage-Felder der drei Anbieter sehen so aus:
- OpenAI (Responses API):
usage.input_tokens,usage.input_tokens_details.cached_tokens,usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens,usage.cache_creation_input_tokens,usage.cache_read_input_tokens - Gemini: die entsprechenden
usage-Felder der API, zum Beispieltotal_cached_tokens; bei explizitem Caching kommen zusätzlich Objektspeicherkosten hinzu
Empfehlung: Zwei Kennzahlen kontinuierlich verfolgen:
Tatsächliche Cache-Trefferquote = aus dem Cache gelesene Token ÷ gesamte Eingabe-Token
Tatsächliche Ersparnis          = Baseline-Kosten ohne Cache − tatsächliche API-Abrechnungskosten
Die Baseline-Kosten ohne Cache müssen mit demselben Modell, derselben Workload und demselben Ausgabevolumen berechnet werden – sonst ist die Ersparnis nicht vergleichbar. Wenn Sie im APIYI apiyi.com-Konsolen-Dashboard die Abrechnung prüfen, können Sie die usage-Zusammenfassung desselben Zeitraums Punkt für Punkt mit den Abrechnungsdetails abgleichen und so bestätigen, dass die Cache-Token zum Cache-Preis berechnet werden.
6 APIYI-Szenario: Wie lassen sich mit Prompt Caching bei festen Vorlagen und batchweiser KI-Produktion die Kosten senken?
Typische Geschäftsfälle, für die sich Prompt Caching eignet: KI-Schreibplattformen, die täglich dieselbe Artikelvorlage ausführen; Agents, die immer wieder dieselbe Tool-Definition laden; Dokumentenanalysesysteme, die mehrfach dasselbe große Referenzdokument zitieren; sowie Batch-Content-Generierung, die gemeinsame Markenrichtlinien und Stilvorgaben teilt. All diesen Aufgaben ist eines gemeinsam: langer Präfix, hohe Wiederholungsrate, großes Aufrufvolumen – genau der Bereich, in dem der Cache am meisten bringt.
Für Kostenentscheidungen in solchen Szenarien lassen sich drei Kriterien heranziehen:
- Ob das Modell die benötigten Cache-Fähigkeiten bietet. Dazu gehören Mindestpräfixlänge, optionale TTL und der Rabattfaktor beim Lesen. Modelle mit 0,05-fachem Lesepreis erzielen bei langen Präfixaufgaben eine höhere Präfix-Einsparquote.
- Ob Eingabeaufforderung und TTL zur Workload passen. Bei fortlaufender Batch-Verarbeitung kurze TTL; bei Aufgaben, die über einen Zeitplan verteilt laufen, lange TTL erwägen und mit der Formel aus Abschnitt 4.1 die Zahl der Durchläufe bis zur Amortisation berechnen.
- Ob der API-Anbieter Caching vollständig unterstützt und die tatsächlichen Cache-Kosten korrekt abrechnet. Dass der Upstream Caching unterstützt, ist nur eine notwendige Bedingung für die Kostensenkung. Das Gateway muss außerdem Cache-Parameter korrekt weiterreichen, die Cache-Token in der
usagemelden und den Cache-Preis in der Abrechnung abbilden.
Bei Aufrufen über APIYI apiyi.com empfiehlt es sich, Punkt 3 als festen Abnahmeschritt zu etablieren: dieselbe 20K-Vorlage mehrmals hintereinander aufrufen, die Cache-Felder in der usage prüfen und dann mit den Abrechnungsdetails abgleichen. Erst wenn sowohl der technische Treffer als auch die Abrechnung bestätigt sind, dienen die obigen Rechenergebnisse als Grundlage für das Monatsbudget.
Häufige Fragen (FAQ)
F1: Was ist Prompt-Caching?
Es speichert die bereits verarbeiteten, identischen Präfixe einer Eingabeaufforderung zwischen. Treffen spätere Anfragen auf einen Cache, wird deutlich weniger als der normale Eingabepreis berechnet. Für einen Treffer müssen die Token exakt übereinstimmen – daher eignet es sich für Szenarien wie feste Vorlagen, feste Wissensdatenbanken oder feste Tool-Definitionen.
F2: Warum spart das Präfix über 90 %, die gesamte Rechnung aber nur rund 70 %?
Der Cache wirkt nur auf das feste Präfix; dynamische Eingaben und Ausgaben werden weiterhin zum Originalpreis abgerechnet. Am Beispiel von GPT-6.1 Sol: Von einer Tagesrechnung von $1.348 nach Caching entfallen $1 auf die Ausgabe und $0.10 auf die dynamische Eingabe. Je länger die Ausgabe, desto niedriger die Sparquote auf der Gesamtrechnung.
F3: Lohnt sich Caching, wenn ich nur ein- oder zweimal am Tag aufrufe?
Der Nutzen ist gering. Bei OpenAI 12h und Claude 1h muss man innerhalb der Gültigkeitsdauer mindestens zweimal einen Treffer erzielen, um die Kosten wieder hereinzuholen; eine Wiederverwendung über Tagesgrenzen hinweg ist nicht garantiert. Sinnvoller ist es, gleichartige Aufgaben gebündelt im selben Zeitfenster auszuführen und so die Trefferzahl innerhalb des Fensters zu erhöhen.
F4: 30m oder 12h wählen?
Das hängt vom Aufrufabstand ab. Liegt der Abstand stabil unter 30 Minuten, nimm 30m – ein Treffer genügt, um die Kosten wieder hereinzuholen. Sind die Abstände zwischen den Batches länger und über den Tag verteilt, nimm 12h. Am Beispiel von GPT-6 Astra mit 20 Batches pro Tag: Bei 12h liegen die Tageskosten bei $7.98, bei 30m bei $12.10.
F5: Funktioniert das Caching auch, wenn ich über eine API-Aggregationsplattform aufrufe?
Das hängt davon ab, wie die Plattform die Cache-Parameter weitergibt und wie sie die Abrechnung umsetzt. Empfohlen: Bei APIYI apiyi.com mit dem kostenlosen Testkontingent denselben Prompt mehrfach hintereinander aufrufen, die Felder wie `cached_tokens` in usage prüfen und mit der Abrechnungsdetails abgleichen. Erst wenn sicher ist, dass der Cache sowohl trifft als auch zum Cache-Preis abgerechnet wird, im großen Stil nutzen.
F6: Die Cache-Trefferquote fällt plötzlich – wo zuerst nachsehen?
In dieser Reihenfolge prüfen: Ob dynamische Inhalte wie Zeitstempel oder IDs ins Präfix geraten sind; ob sich die Reihenfolge der Tool-Definitionen geändert hat; ob der Agent Verlaufsnachrichten komprimiert oder umgeschrieben hat; ob Modell oder Parameter gewechselt wurden; ob der Aufrufabstand die TTL überschreitet. Mit der Trefferquoten-Formel aus Abschnitt 5.3 und einer stündlichen Auswertung lässt sich der Zeitpunkt der Veränderung schnell eingrenzen.
F7: Gemini – implizites oder explizites Caching wählen?
Implizites Caching ist standardmäßig aktiviert, verursacht keine Speicherkosten und wird bevorzugt genutzt, sobald das Präfix die Mindestlänge des Modells überschreitet (bei 3.8 Flash 4,096 Token). Explizites Caching eignet sich für sehr lange Inhalte, die deterministisch wiederverwendet werden sollen, kostet aber stündliche Speichergebühren und erfordert die generateContent API. Die Interactions API unterstützt derzeit nur implizites Caching.
Zusammenfassung
Die Kernpunkte von Prompt-Caching:
- Wo gespart wird: Nur die Kosten für den festen Präfix sinken. Bei der in diesem Artikel betrachteten Arbeitslast liegt die Präfix-Ersparnis bei 88,85 %–93,8 %, die Ersparnis auf der Gesamtrechnung bei 69,69 %–73,57 %.
- Wie viel gespart wird: GPT-6.1 Sol und Claude Sonnet 5.5 sinken pro Tag von 5,10 $ auf 1,348 $, GPT-6 Astra von 25,50 $ auf 7,73 $. Je höher der Stückpreis, desto größer die absolute Ersparnis.
- Welche Frequenz am lohnendsten ist: Aufrufe mit hoher Frequenz, kontinuierlichem Fluss und langem Präfix. Bei kurzer TTL amortisiert sich ein einziger Treffer, bei langer TTL braucht es zwei Treffer.
- Wie man es umsetzt: Stabile Inhalte vorne, dynamische Inhalte hinten, am Ende der stabilen Inhalte einen Breakpoint setzen; die TTL passend zum Aufrufrhythmus wählen; die Trefferquote kontinuierlich über das Feld
usageüberwachen. - Voraussetzung für die Gültigkeit: Der Cache muss technisch treffen und bei der Abrechnung tatsächlich zum Cache-Tarif abgerechnet werden.
Empfohlen: Berechnen Sie zuerst mit dem Rechner aus diesem Artikel das Budget, validieren Sie dann bei APIYI apiyi.com mit echten Templates die Trefferquote und die Abrechnung – und skalieren Sie erst, wenn beides bestätigt ist.
📚 Referenzen
- OpenAI Prompt-Caching-Leitfaden: Caching-Modi, Breakpoints, TTL und Abrechnungsfaktoren
- Link:
developers.openai.com/api/docs/guides/prompt-caching -
Beschreibung: Parameterbeschreibung für
prompt_cache_options,prompt_cache_breakpoint -
OpenAI Modelle und Preise: Stückpreise von GPT-6 Astra und GPT-6.1 Sol
- Link:
developers.openai.com/api/docs/pricing - Link:
developers.openai.com/api/docs/models/gpt-6-astra - Link:
developers.openai.com/api/docs/models/gpt-6.1-sol -
Beschreibung: Standardtarif für kurzen Kontext, Prüfdatum 2026-11-13
-
Claude Prompt-Caching-Dokumentation:
cache_control, Schreib- und Lesefaktoren für 5m / 1h - Link:
platform.claude.com/docs/en/build-with-claude/prompt-caching - Link:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
Beschreibung: Sonnet 5.5 mit Cache-Lese-Tarif von 0,05×
-
Gemini Context Caching und Preise: Implizites / explizites Caching, Speichergebühren und Preisanpassung 2027
- Link:
ai.google.dev/gemini-api/docs/caching - Link:
ai.google.dev/gemini-api/docs/pricing - Beschreibung: Minimale Cache-Länge je Modell und Umfang der API-Unterstützung
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com


