
Fazit: API-Kosten für KI-Artikel – erst Aufrufe, dann das fertige Produkt
Laut dem Preisschnappschuss in diesem Artikel belaufen sich die theoretischen Kosten für eine einzelne Generierung bei 10.000 Eingabe- und 3.000 Ausgabe-Token auf etwa 0,0066–0,10 USD. Um einen veröffentlichungsfertigen Artikel zu erstellen, kommen noch Kosten für Überarbeitung, Überprüfung, Tool-Aufrufe und manuelle Bearbeitung hinzu.
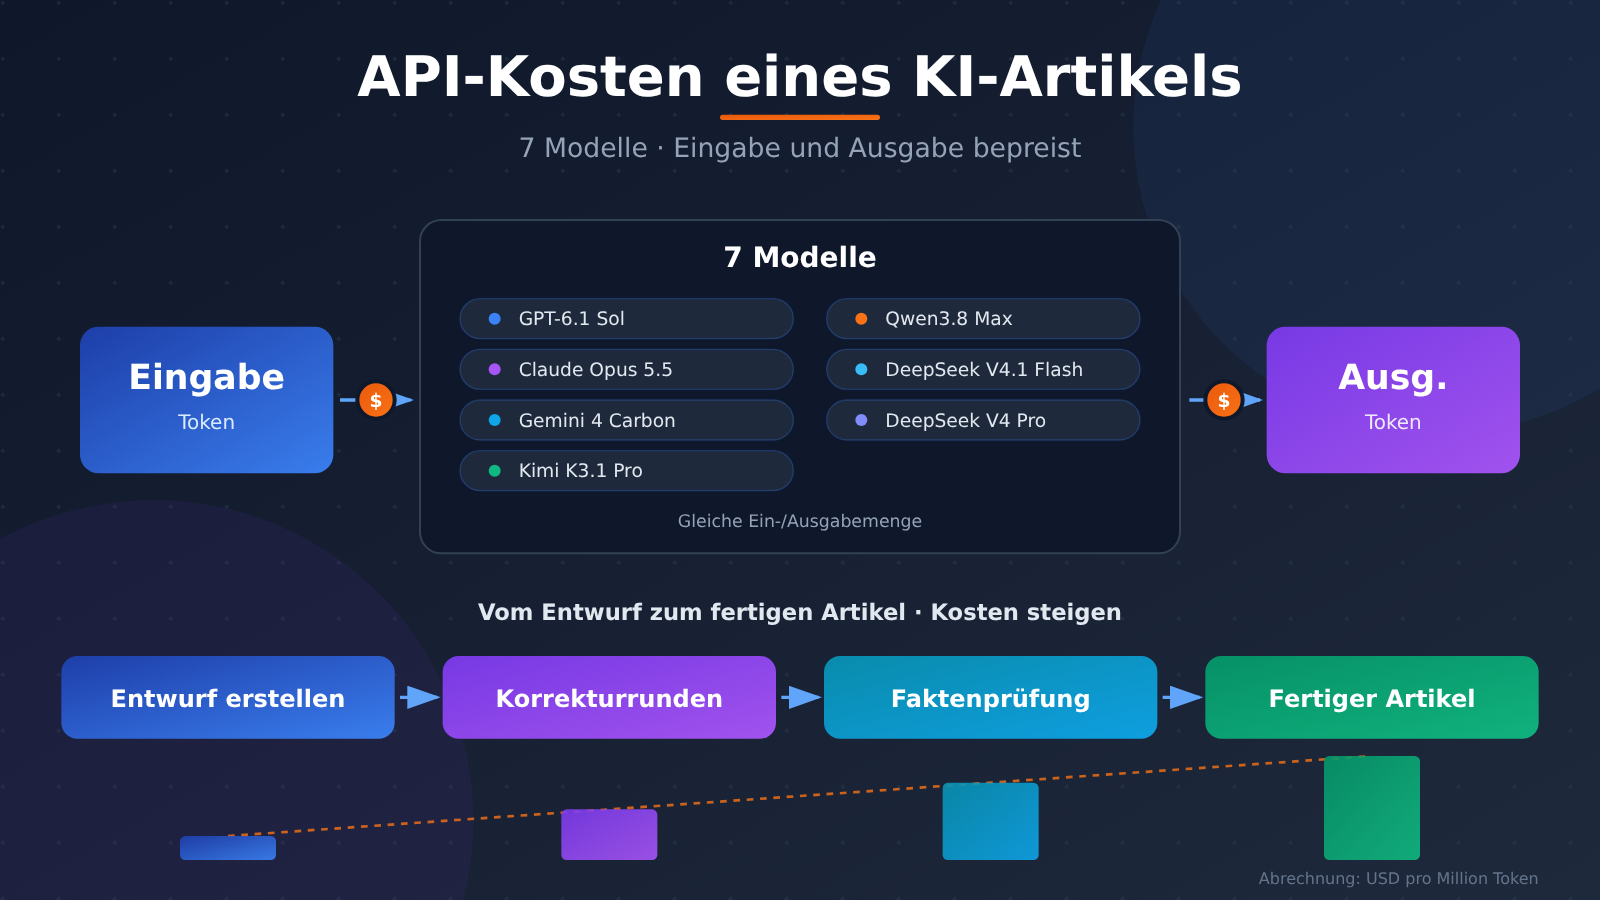
Wirklich vergleichbar ist der „Preis pro qualifiziertem Artikel“. Dieser Artikel vergleicht sieben Modelle bei gleicher Ein- und Ausgabemenge und erklärt dann, wie Kanal, Caching, Inferenz und Überarbeitungsrunden die Rechnung verändern.
Was folgt: Der Kostenkalkulationspfad für KI-Artikel-APIs
- Die Eingabe-, Ausgabe- und Abrechnungsformeln verstehen.
- Die Kosten von sieben Modellen bei drei Aufgabenumfängen vergleichen.
- Plattformpreise, offizielle Regionalpreise und zeitabhängige Regeln unterscheiden.
- Anhand von Aufrufprotokollen und Bearbeitungszeit das Produktionsschema festlegen.
Schnellstart-Tipp: Über die einheitliche Schnittstelle von APIYI apiyi.com können Sie dasselbe Datenpaket testen. Neue Nutzer erhalten ein kostenloses Testkontingent; die genauen Kontingente und Anwendungsregeln entnehmen Sie bitte den aktuellen Angaben der Plattform.
API-Kosten für KI-Artikel: Zuerst die Maßeinheit klären
Token ist die Einheit, mit der eine API Text misst – einen festen Umrechnungsfaktor zur Anzahl der Schriftzeichen gibt es nicht. Materialpakete, Eingabeaufforderungen, die Artikelplanung und die übermittelten bisherigen Gesprächsverläufe belegen alle Eingabe-Token.
Ein- und Ausgabepreise werden üblicherweise als „US-Dollar pro Million Token“ angegeben. Alle Simulationen in diesem Artikel verwenden die regulären Ein- und Ausgabepreise; Caching, zusätzliche Inferenz, Mengenrabatte und Tool-Gebühren bleiben außen vor.
Die Formel lautet:
$$
C=\frac{T_{\text{Eingabe}}}{1{,}000{,}000}P_{\text{Eingabe}}
+\frac{T_{\text{Ausgabe}}}{1{,}000{,}000}P_{\text{Ausgabe}}
$$
Am Beispiel von GPT-6.1 Sol mit 10.000 Eingabe- und 3.000 Ausgabe-Token:
$$
C=0.01\times2+0.003\times10=0.05\text{ US-Dollar}
$$
Dieses Geld kauft genau eine Generierung. Ob der Artikel direkt veröffentlicht werden kann, hängt davon ab, ob Fakten, Struktur und Schreibstil stimmen – die Rechnung unterschreibt nicht anstelle der Redaktion.
API-Kosten für KI-Artikel: Preisvergleich von Eingabe und Ausgabe bei 7 Modellen
Die folgende Tabelle basiert auf einem Preis-Snapshot von APIYI apiyi.com vom 12. November 2026, 10:45 (UTC+8). Alle Angaben in US-Dollar pro Million Token, Abrechnung nutzungsbasiert pro Token.
| Modell | Eingabepreis | Ausgabepreis | Preisverhältnis Ausgabe/Eingabe |
|---|---|---|---|
| GPT-6.1 Sol | 2,00 | 10,00 | 5-fach |
| Claude Opus 5.5 | 4,00 | 20,00 | 5-fach |
| Gemini 4 Carbon | 2,00 | 10,00 | 5-fach |
| Kimi K3.1 Pro | 2,00 | 10,00 | 5-fach |
| Qwen3.8 Max | 1,65 | 4,95 | 3-fach |
| DeepSeek V4.1 Flash | 0,30 | 1,20 | 4-fach |
| DeepSeek V4 Pro | 1,32 | 3,96 | 3-fach |
| Vergleichspunkt | Hinweis zur Anbindung |
|---|---|
| Verfügbare Plattformen | APIYI apiyi.com; offizielle Hersteller-API – Region und Abrechnungsregeln müssen jeweils separat geprüft werden |
Ausgabe-Token sind in der Regel teurer, aber bei sehr langen Dokumentenpaketen können auch die Eingabekosten zum Hauptposten werden. Bei der Auswahl sollte man deshalb beide Preisspalten betrachten und nicht nur die Artikellänge im Auge haben.
API-Kosten für KI-Artikel: Welche Preisunterschiede gibt es bei der direkten offiziellen Anbindung?
Die folgenden Regeln für die direkte offizielle Anbindung wurden bis zum 12. November 2026 abgefragt. Sie dienen dem Abgleich von Kanalunterschieden und fließen nicht in die obige Plattform-Preistabelle ein.
| Modell/Kanal | Offizieller Preis oder Regel |
|---|---|
| GPT-6.1 Sol, Standard | Eingabe 2, Ausgabe 10 |
| Claude Opus 5.5, Standardaufruf | Eingabe 4, Ausgabe 20 |
| Gemini 4 Carbon, Standardaufruf | Einführungsphase bis 30. November: Eingabe 2, Ausgabe 10; ab 1. Dezember: Eingabe 4, Ausgabe 20 |
| Qwen3.8 Max, Peking/USA Virginia Global | Eingabe 1,65, Ausgabe 4,951 |
| Qwen3.8 Max, Singapur International | Eingabe 2, Ausgabe 6 |
| Kimi K3.1 Pro, Alibaba Cloud Peking/Singapur | jeweils 1,837/9,611 bzw. 2/10 |
| DeepSeek, beide Modelle | Peak-Preise entsprechen den Werten in der obigen Tabelle, außerhalb der Peak-Zeiten halbiert |
Die Gemini-Preisanpassung gilt für die direkte offizielle Anbindung von Google; bei Drittanbieter-Kanälen sind die jeweiligen Ankündigungen zu prüfen. Der Plattform-Ausgabepreis von Qwen (4,95) und der offizielle Preis in einigen Regionen (4,951) sollten ebenfalls getrennt ausgewiesen bleiben.
Bei DeepSeek gelten offiziell als Peak-Zeiten werktags Pekinger Zeit 09:00–12:00 und 14:00–18:00; außerhalb dieser Zeiten und an Wochenenden gilt die Nicht-Peak-Regelung, gesetzliche Feiertage werden gesondert berechnet.
Nach den offiziellen Nicht-Peak-Preisen kostet Flash bei der Eingabe 0,15 und bei der Ausgabe 0,60; Pro bei der Eingabe 0,66 und bei der Ausgabe 1,98. Ob sich eine zeitliche Planung tatsächlich lohnt, hängt davon ab, ob der genutzte Kanal diese Regelung auch anwendet.
API-Kosten für KI-Artikel: Wie lassen sich Materialumfang und drei Überarbeitungsrunden berechnen?
Vergleichen wir zunächst zwei Materialumfänge. Alle Angaben sind theoretische Simulationen; die Ausgabe-Token stehen für die vom Modell gezählte Länge, nicht für die Anzahl chinesischer Zeichen.
| Modell | 50.000 Eingabe-Token + 5.000 Ausgabe-Token | 100.000 Eingabe-Token + 10.000 Ausgabe-Token | Drei Runden kumuliert |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
Einheit: US-Dollar. Alle drei Spalten verwenden den zuvor genannten Plattform-Snapshot; Cache- und sonstige Kosten sind nicht berücksichtigt.
Nehmen wir als Beispiel eine GPT-Aufgabe mit 50.000 Eingabe- und 5.000 Ausgabe-Token:
$$
C=0.05\times2+0.005\times10=0.15\text{US-Dollar}
$$
Davon entfallen 0.10 US-Dollar auf die Eingabe und 0.05 US-Dollar auf die Ausgabe. Bei materialintensiven Aufgaben ist es oft sinnvoller, zuerst das Eingabematerial aufzubereiten, statt ein paar Absätze des Haupttexts zu kürzen.
Der Wert „Drei Runden kumuliert“ folgt diesem Ablauf mit separaten Aufrufen:
- Erster Entwurf: Eingabe 10.000, Ausgabe 3.000 Token.
- Überarbeitung: Materialpaket plus erster Entwurf, Eingabe 13.000, Ausgabe 3.000 Token.
- Finalisierung: Materialpaket plus vorherige Version, Eingabe 13.000, Ausgabe 3.000 Token.
Insgesamt 36.000 Eingabe- und 9.000 Ausgabe-Token. Die entsprechenden GPT-Kosten betragen:
$$
C=0.036\times2+0.009\times10=0.162\text{US-Dollar}
$$
Das ist das 3.24-Fache der Kosten für die erste Erzeugung. Bei diesem Ablauf wird nur die jeweils letzte Version mitgeführt; würde in jeder Runde die gesamte Historie mitgeschickt, stiege die Eingabemenge weiter an.
Die folgende Grafik eignet sich, um die Kostenunterschiede bei derselben Aufgabe zu zeigen. Die Daten stammen aus den oben genannten Formeln; es handelt sich nicht um Ergebnisse einer Qualitätsbewertung.
API-Kosten für KI-Artikel: vier oft übersehene Kostenarten
API-Kosten für KI-Artikel: Reasoning-Token und Tool-Aufrufe
Reasoning-Token sind die Inferenzinhalte, die einige Modelle vor der Antwortgenerierung erzeugen. Google rechnet Gemini-Reasoning-Token ausdrücklich den Ausgabekosten zu; auch das zusätzliche Reasoning im Qwen-Thinking-Modus erhöht die Kosten.
Websuche, Seiten-Scraping und ähnliche Tools können separat abgerechnet werden. Modell-Token und Tool-Anfragen sollten getrennt erfasst werden – vor allem, weil eine einzelne Schreibanfrage mehrere Suchvorgänge auslösen kann.
API-Kosten für KI-Artikel: Caching und Batch API
Prompt-Caching (Eingabeaufforderungs-Cache) senkt einen Teil der Eingabekosten, indem identische Präfixe wiederverwendet werden. Wie viel sich am Ende sparen lässt, hängt von der Anzahl der Cache-Treffer, den Schreibkosten und der Gültigkeitsdauer ab.
Der offizielle Cache-Eingabepreis für GPT-6.1 Sol liegt bei 0.10; bei Claude Opus 5.5 kostet das Lesen aus dem Cache 0.20, das Schreiben in den 5-Minuten- bzw. 1-Stunden-Cache 5 bzw. 8 – alle Angaben in US-Dollar pro Million Token.
Die Batch API dient der asynchronen Stapelverarbeitung. Bei Claude erhalten Batch-Eingaben und -Ausgaben offiziell 50 % Rabatt; auch die offiziellen Gemini-Batch-Preise wurden an die Standardpreise zum 1. Dezember angepasst.
Diese Regeln müssen für jeden Zugangskanal separat geprüft werden. So unterstützt etwa Alibaba Cloud Kimi K3.1 Pro kein Batch Inference; bei Qwen Beijing Batch File liegen die Preise bei 0.825/2.475, das Kontextfenster ist auf 256K begrenzt.
Die Kernstrategie ist einfach: Bei stabilen Materialpaketen zuerst Caching prüfen, bei Aufgaben ohne dringende Lieferfrist anschließend Batch evaluieren – und die Cache-Schreibkosten in die Gesamtrechnung einbeziehen.
API-Kosten für KI-Artikel: tatsächliche Tokens mit Code erfassen
Die folgenden Beispiele nutzen eine OpenAI-kompatible Schnittstelle. Der Schlüssel wird über eine Umgebungsvariable gelesen, damit er nicht direkt im Code landet; Modellverfügbarkeit und Parameterunterstützung richten sich nach der aktuellen Dokumentation.
Minimaler Aufruf:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
Vollständiges Beispiel für die Kostenschätzung normaler Tokens:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
Dieser Code dient dazu, die Kosten für normale Tokens zu schätzen. Cache-Details, Reasoning-Abrechnung und Tool-Kosten sollten mit den Nutzungsfeldern des Anbieters und den Abrechnungsprotokollen abgeglichen werden.
API-Kosten für KI-Artikel: Szenarioempfehlungen und Entscheidungshilfen
Für budgetempfindliche Routine-Erstentwürfe können Sie zunächst Flash, Pro und Qwen testen. Bei komplexen Blogs und tiefgehenden Artikeln nehmen Sie GPT, Claude und weitere Modelle in die Auswahl auf und prüfen anhand der Redaktionszeit, ob der höhere Stückpreis sich lohnt.
Im englischsprachigen Ranking des AI Writing Benchmark, das am 11. November 2026 aktualisiert wurde, erreicht GPT-6.1 Sol einen Gesamtwert von 95.3 und in der Kategorie Artikel 98.5 – beides sind Referenzwerte.
Das spricht dafür, GPT in die Tests für englischsprachige Blogs aufzunehmen. Chinesische Texte müssen jedoch separat geprüft werden: Der Test mit langen Finanztexten vom 26. Oktober bis 3. November 2026 umfasste nur 26 Artikel, und die Stichprobe war unausgewogen – er taugt eher als Hinweis auf mögliche Kandidaten.
Empfohlen ist, Materialpaket, Zielumfang und Tool-Berechtigungen einheitlich zu halten, die Bewertung mit verdeckten Modellnamen durchzuführen und Faktenfehler, Überarbeitungsrunden, Redaktionsminuten sowie die endgültige Übernahme zu protokollieren.
Für die abschließende Kalkulation lässt sich verwenden:
$$
C_{\text{geeigneter Artikel}}
=C_{\text{alle API-Aufrufe und zugehörigen Kosten}}
+C_{\text{menschliche Redaktion}}
$$
Die Personalkosten lassen sich als Stundensatz der Redaktion multipliziert mit dem tatsächlichen Zeitaufwand berechnen. Falls die Prüfung zusätzliche API-Aufrufe oder manuelle Arbeit erfordert, sollten diese ebenfalls im entsprechenden Posten erfasst werden, um Doppelbuchungen zu vermeiden.
API-Kosten für KI-Artikel – FAQ: Wie lassen sich 7 Modelle fair vergleichen?
Wenn Sie über APIYI apiyi.com zwischen Modellen wechseln, halten Sie Material, Schreibanforderungen und Tool-Berechtigungen konstant. Mehrere Durchläufe mit protokolliertem Verbrauch machen Stabilität und Überarbeitungskosten leichter erkennbar.
API-Kosten für KI-Artikel – FAQ: Können kostenlose Kontingente die Kostenkalkulation ersetzen?
Das kostenlose Testkontingent von APIYI apiyi.com eignet sich, um Schnittstelle und Schreibstil zu prüfen. Für das langfristige Budget sollten Sie weiterhin mit den aktuellen Stückpreisen und dem tatsächlichen Verbrauch rechnen; Rabattkontingente behandeln Sie getrennt.
Fazit: Bei den API-Kosten für KI-Artikel zählt am Ende die Produktionseffizienz
Die Preisliste dient der Auswahl, das Aufrufprotokoll der Abrechnung, die Bearbeitungshistorie der Entscheidung. Materialverdichtung, Cache-Wiederverwendung und weniger Nacharbeit können unterm Strich wirksamer sein als das Hinterherjagen nach dem niedrigsten Ausgabepreis.
Empfehlenswert ist, Kandidatenmodelle über APIYI (apiyi.com) zu prüfen und sich am Ende für die Lösung zu entscheiden, die zu vertretbaren Gesamtkosten verlässlich brauchbare Artikel liefert – damit Redakteurinnen und Redakteure ihre Zeit dem Urteilsvermögen widmen können.
Referenzen zu den API-Kosten für KI-Artikel
- APIYI Modellpreise und Schnittstellendokumentation: help.apiyi.com. Der Preis-Snapshot der Plattform in diesem Artikel stammt vom 12. November 2026.
- Alibaba Cloud Modellpreise: alibabacloud.com/help/en/model-studio/model-pricing. Zur Gegenprüfung der regionalen Preise.
- Offizielle Ankündigung von Google Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
- AI Writing Benchmark: aiwritingbenchmark.com. Dieser Artikel bezieht sich auf die englischsprachige Rangliste mit Stand vom 11. November 2026.
- Test für tiefgehende chinesische Langtexte: omnitools.ai/evals/longform-writing. Angaben zu Stichprobe und Grenzen der Aufgabenstellung finden sich im Haupttext.
Autor: Technisches Content-Team von APIYI. Austausch zu Modellaufrufen und zur Kostenkalkulation von Artikeln gerne über apiyi.com.


