
ملاحظة الكاتب: تحليل Qwen4-Max صاحب المركز السادس في لوحة Code Arena WebDev: تشكيل المراكز الستة الأولى، والفجوة الداخلية بين النماذج الصينية، والفارق مع النماذج في الصدارة، والطريقة الصحيحة لقراءة عدد الأصوات وتكلفة المهمة الواحدة.
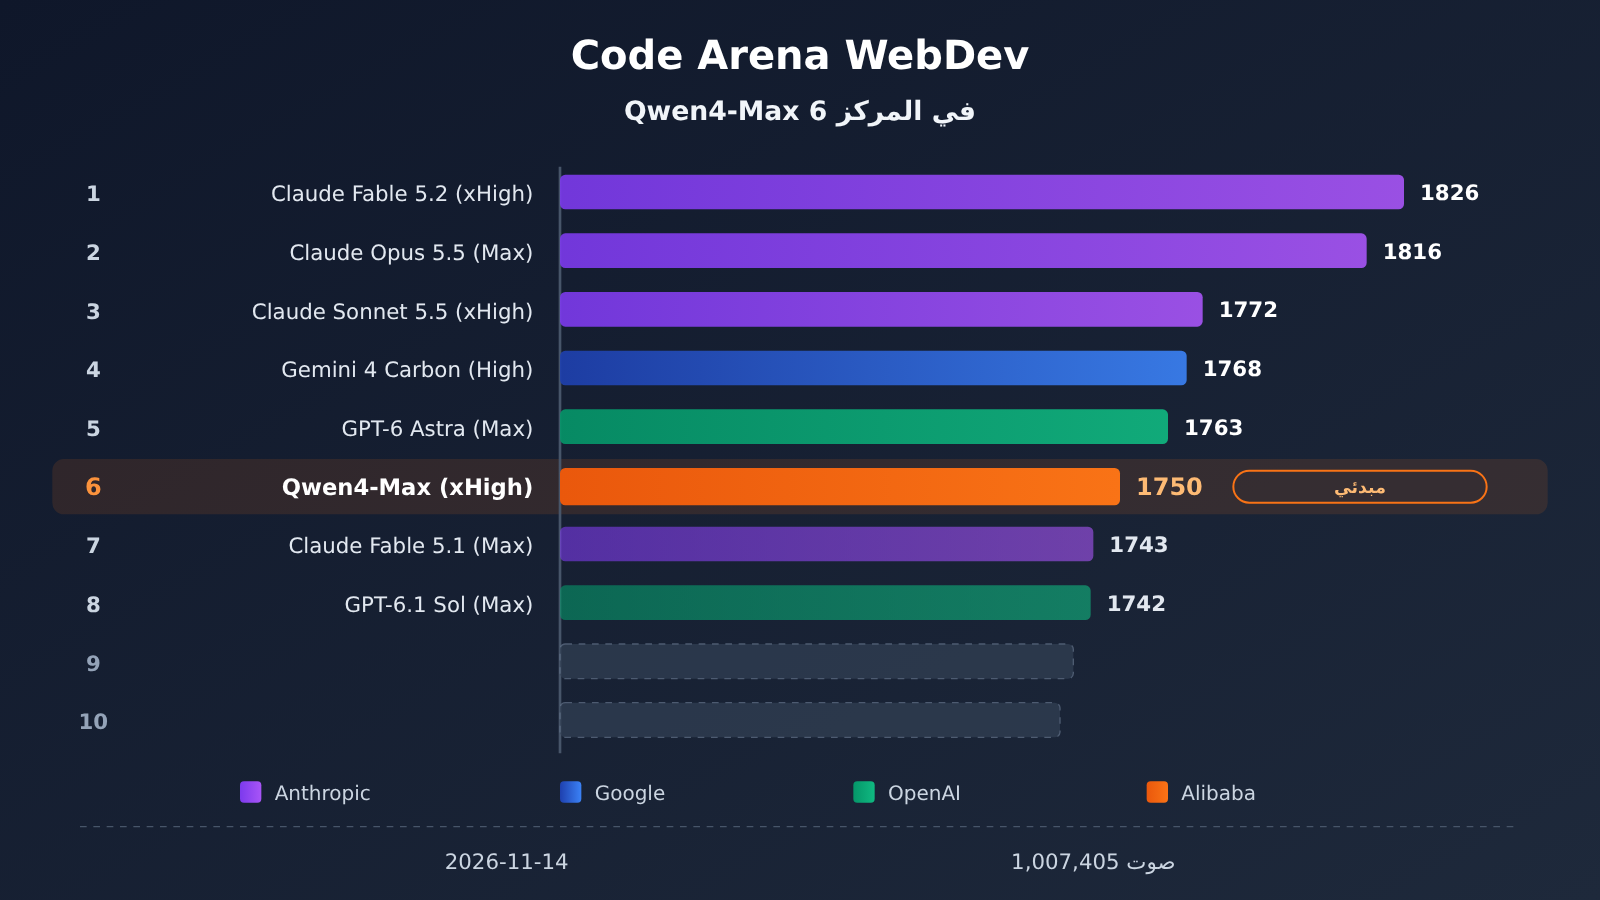
نبدأ بالخلاصة: في لوحة Code Arena WebDev على arena.ai (تصنيف Overall، والصفحة تشير إلى 2026-11-14)، يحتل Qwen4-Max (xHigh) المركز السادس برصيد 1750 نقطة. هذه أول مرة يتمكن فيها نموذج صيني من الدخول إلى المراكز الستة الأولى في هذه اللوحة، وهو النموذج الوحيد بينها الذي لا ينتمي إلى مختبر أمريكي.
هذا ليس مقالًا دعائيًا يحوّل المركز السادس إلى مركز أول. يحمل Qwen4-Max على اللوحة وسم Preliminary، ولديه 1,814 صوتًا فقط، كما أن ترتيبه قد يتغير. وفي الرسم الرسمي نفسه المنشور من علي بابا، لا يزال متأخرًا بوضوح عن Opus 5.5 وGPT-6 Astra في Terminal-Bench وProgramBench.
القيمة الأساسية: بعد قراءة هذا المقال، ستحصل على بيانات وصفية للوحة الترتيب يمكنك فتحها والتحقق منها بنفسك، وستفهم كيف تستخدم المركز السادس الذي حصل عليه Qwen4-Max، وأين لا ينبغي أن تستخدمه.
أبرز نقاط المركز السادس في Qwen4-Max Code Arena WebDev
قبل الحديث عن المركز، لنبدأ بعرض البيانات الوصفية للوحة. أي حديث عن «المركز رقم كذا» ينبغي أن يُسبق بالتحقق من التاريخ وعدد الأصوات وعدد النماذج المشاركة، وإلا يصعب تحديد ما إذا كان المركز موثوقًا.
| النقطة | البيانات (المنشورة على اللوحة نفسها) | كيف تقرأها |
|---|---|---|
| اللوحة والتصنيف | arena.ai Code Arena WebDev، التصنيف الإجمالي | تمثّل فقط تفضيلات الاختبار الأعمى في فئة تطوير الويب |
| تاريخ الصفحة | 2026-11-14 | الترتيب يتغير باستمرار مع استمرار التصويت |
| إجمالي الأصوات / عدد النماذج | 1,007,405 صوتًا / 159 نموذجًا | حجم العينة كبير، لكن عدد الأصوات لكل نموذج يتفاوت بدرجة كبيرة |
| ترتيب Qwen4-Max ودرجته | المركز السادس، 1750 نقطة | النموذج الوحيد من مختبر غير أمريكي بين الستة الأوائل |
| أصوات Qwen4-Max ووسمها | 1,814 صوتًا، Preliminary | لا يزال في مرحلة التقييم الأولي |
| تكلفة المهمة الواحدة P50 | $4.18 | الوسيط الإحصائي المعروض على اللوحة، وليس سعر وحدة النموذج |
شرح معايير القياس في لوحة Qwen4-Max
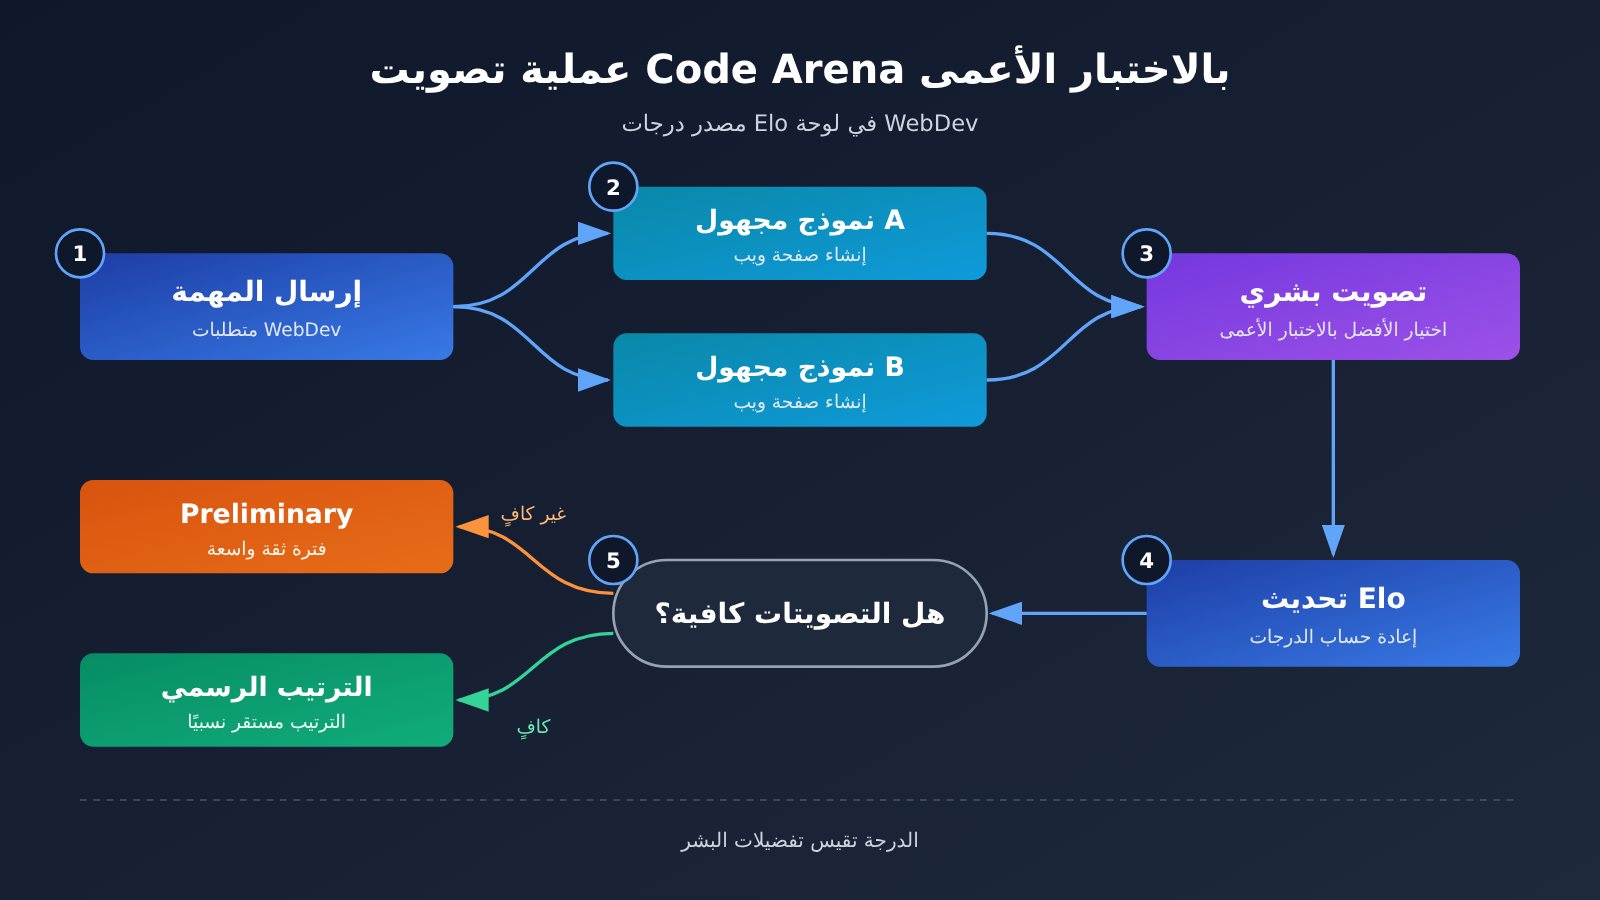
درجات Elo في Code Arena مبنية على تصويت بشري أعمى: يقدّم المستخدم مهمة تطوير ويب واحدة، ثم يرى مخرجات نموذجين مجهولين ويصوّت لأفضل نتيجة. تعكس الدرجة «من يقدّم صفحة ويب أفضل في نظر المراجع البشري»، أي أنها تقيس التفضيل، وليست درجة إجمالية للإنتاجية.
من المهم أيضًا فهم معنى وسم Preliminary. فهو يعني أن عدد المباريات التي شارك فيها النموذج لا يزال غير كافٍ، وأن فاصل الثقة أوسع. ويحمل النموذج Gemini 4 Carbon (High)، صاحب المركز الرابع على اللوحة نفسها، هذا الوسم أيضًا؛ لذلك ليس مستغربًا أن تتبدل المراكز بين الرابع والسادس خلال الأسابيع المقبلة.
من هم أصحاب المراكز الستة الأولى في Code Arena WebDev: خريطة منافسي Qwen4-Max
عرض المراكز العشرة الأولى كاملةً يجعل موقع Qwen4-Max أوضح للعين. فالمراكز الخمسة الأولى تحتكرها ثلاث مختبرات أمريكية، وحدها Anthropic استحوذت على ثلاثة منها.
| الترتيب | النموذج | النقاط | المختبر | ملاحظات |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | المركز الأول |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | P50 لكل مهمة $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | نتائج أولية | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | P50 لكل مهمة $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | علي بابا | نتائج أولية، 1,814 صوتًا |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
ماذا يعني تشكيل المراكز الخمسة الأولى بالنسبة إلى Qwen4-Max
من بين المراكز الستة الأولى، تحتفظ Anthropic بثلاثة مقاعد (Fable 5.2 وOpus 5.5 وSonnet 5.5)، بينما لدى كل من Google وOpenAI مقعد واحد، ولعلي بابا مقعد واحد. بعبارة أخرى، اقتطع Qwen4-Max لنفسه موقعًا بين النماذج الرائدة لثلاثة مختبرات في الصدارة، بدلًا من أن يلتقط ترتيبًا في لوحة مبعثرة.
ثمة تفصيل آخر يستحق الانتباه: المراكز من السادس إلى الثامن متلاصقة جدًا، إذ جاءت بالنقاط 1750 و1743 و1742، بفارق أقل من 10 نقاط بينها. ومقدار تقدّم Qwen4-Max على Claude Fable 5.1 وGPT-6.1 Sol أصغر من الـ13 نقطة التي تفصله عن GPT-6 Astra. أما استقرار الترتيب فلابد من انتظار ارتفاع عدد الأصوات قبل الحكم عليه.
موقع Qwen4-Max بين النماذج المحلية
إذا نظرنا إلى المعسكر المحلي فقط، يصبح تقدم Qwen4-Max واضحًا نسبيًا. فهو النموذج المحلي الوحيد الذي دخل قائمة العشرة الأوائل، ولم يظهر صاحب المركز الثاني إلا في المرتبة 13.
| الترتيب المحلي | النموذج | النقاط | ترتيب القائمة | الفرق مع Qwen4-Max |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | السادس | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | الثالث عشر | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | السادس عشر | −74 |
| 4 | Qwen3.8-Max | 1670 | الثامن عشر | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | الثامن عشر | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | التاسع عشر | −89 |
| 7 | Kimi K3 (Max) | 1658 | العشرون | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | السادس والعشرون | −111 |
| 9 | Hy4 preview | 1632 | السابع والعشرون | −118 |
| 10 | GLM-5.3 (Max) | 1622 | الحادي والثلاثون | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | الثالث والثلاثون | −129 |
دلالتان للفجوة الداخلية بين النماذج المحلية
الدلالة الأولى هي القفزة بين الأجيال. يتفوق Qwen4-Max على الجيل السابق من عائلته Qwen3.8-Max (0902) بـ 74 نقطة، ويرتفع ترتيبه من المرتبة 16 إلى المرتبة 6. وفي القائمة نفسها ونظام التصويت نفسه، يُعد هذا مقدار التحسن ملحوظًا.
الدلالة الثانية هي المسافة بينه وبين النموذج المحلي الثاني. يتفوق Qwen4-Max على Kimi K3.1 Pro بـ 64 نقطة، وهي فجوة قريبة من الـ 66 نقطة التي يتأخر بها عن Opus 5.5. بمعنى آخر، يقف Qwen4-Max حاليًا في موقع وسيط بين المعسكر المحلي وقمة الترتيب العالمي: فقد وسّع الفجوة أسفل منه عن المنافسين المحليين، ولا يزال أمامه طريق إلى المركز الأول.
تجدر الإشارة إلى أن المراكز المحلية من الثاني إلى السابع تتكدس بين 1686 و1658، والفروق بينها ضئيلة. لذا فإن استخدام هذه القائمة لترتيب هذه الشركات بحسب الأسبقية ليس ذا معنى كبير.
كم يبعد Qwen4-Max عن القادة العالميين
الفارق في الدرجات على Code Arena WebDev
سرد الفروق في الدرجات بين Qwen4-Max والنماذج الرائدة، مع تقدير تقريبي لـ”معدل الفوز في المواجهات” وفق صيغة Elo العامة (بمقياس 400 نقطة)، يساعد على فهم المعنى الفعلي لهذه الفروق. وقد تختلف طريقة الإحصاء الدقيقة في الـ arena عن معيار Elo، لذا فمعدلات الفوز التالية للاستدلال الحدسي فقط:
- مقابل المركز الخامس GPT-6 Astra: 1750 مقابل 1763، بفارق 13 نقطة، وهو ما يعادل تقديرياً معدل فوز في المواجهات بنحو 48%، أي أنهما في الأساس متعادلان تقريباً.
- مقابل المركز الثاني Opus 5.5: بفارق 66 نقطة، وهو ما يعادل تقديرياً معدل فوز بنحو 41%.
- مقابل المركز الأول Fable 5.2: بفارق 76 نقطة، وهو ما يعادل تقديرياً معدل فوز بنحو 39%.
- مقابل Kimi K3.1 Pro، ثاني أفضل نموذج محلي: متقدم بـ 64 نقطة، وهو ما يعادل تقديرياً معدل فوز بنحو 59%.
يتراوح نطاق الدرجات في اللوحة بأكملها من 1071 إلى 1826. وعلى هذا المقياس، فإن فارق 76 نقطة بين Qwen4-Max والمتصدر ليس كبيراً، لكنه يشير أيضاً إلى أن النموذج الرائد من Anthropic لا يزال يحظى بترجيح أكبر لدى المراجعين فيما يتعلق بتفضيلات تطوير صفحات الويب.
معايير أخرى في الرسم نفسه: درجة Elo العالية لا تعني بالضرورة تفوقًا في المهام النهائية
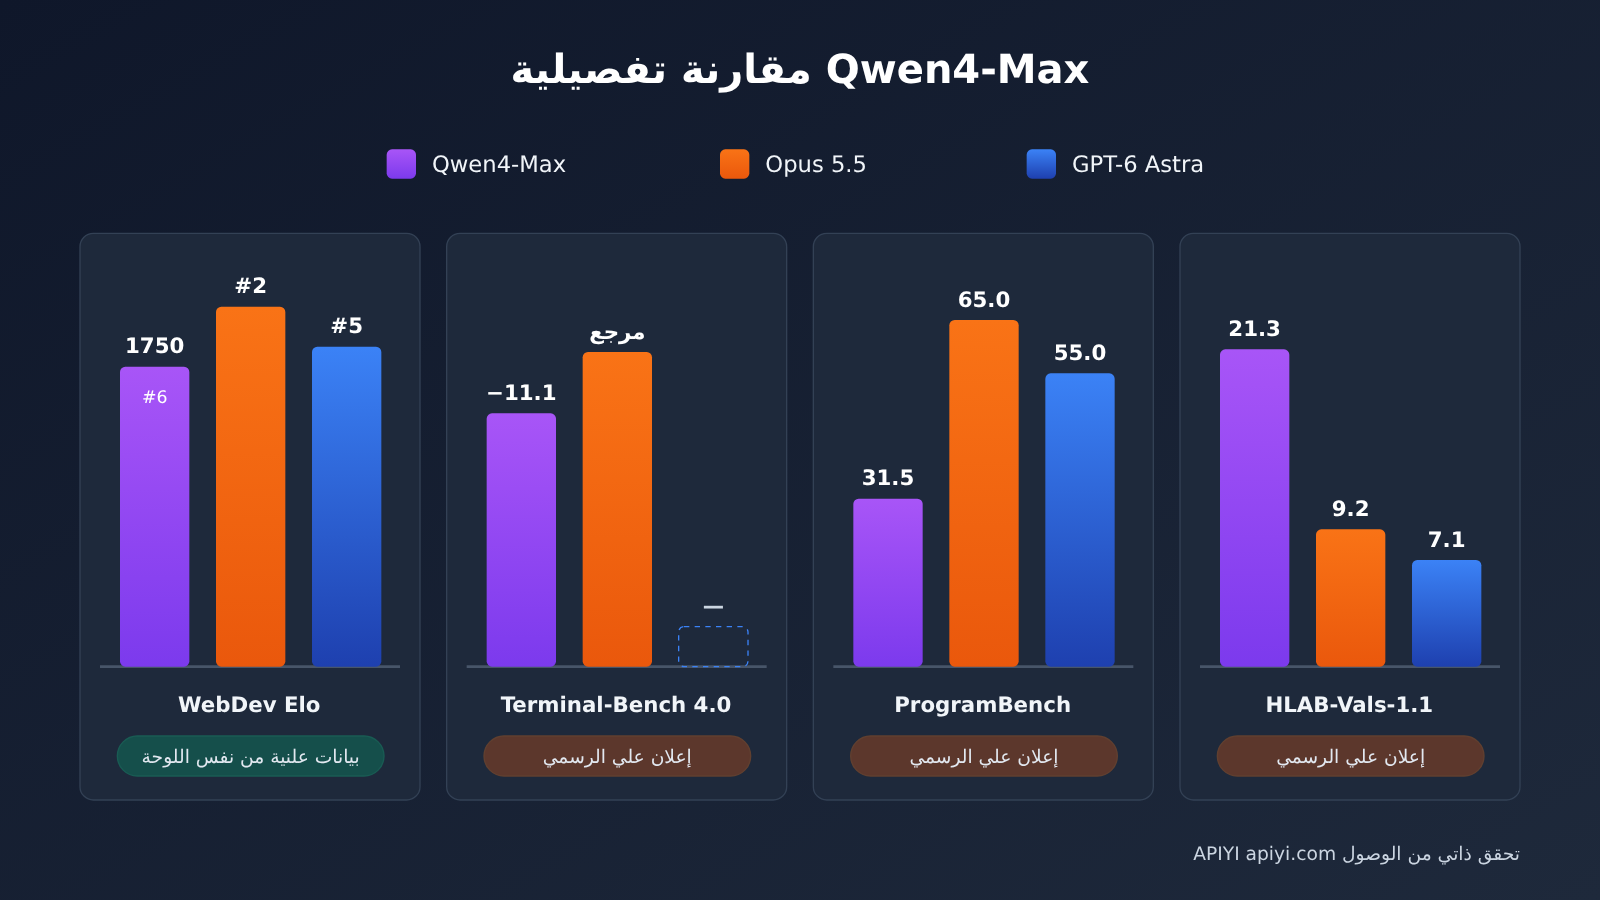
عند إصدار Qwen4-Max، استخدمت علي بابا صورة واحدة تجمع عدة معايير. جميع البيانات التالية مُعلنة من قِبل علي بابا نفسها، وليست بيانات من لوحة arena، ولا نتائج تكرار من طرف ثالث.
| المعيار (مُعلن من الجهة الرسمية) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | أخرى |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
يكشف هذا الجدول أمرًا جوهريًا واحدًا: نال Qwen4-Max درجات عالية في الاختبارات العمياء لتطوير الويب، لكن الفجوة ما تزال واضحة في معايير عمليات الطرفية والبرمجة الهندسية. ففي Terminal-Bench 4.0 يقل بمقدار 11.1 نقطة عن Opus 5.5، بل إن نتيجة نموذج Kimi في الرسم، 67.2، أعلى منه؛ وفي ProgramBench، فإن 31.5 لديه لا تبلغ حتى نصف نتيجة Opus 5.5.
وله أيضًا بنود يتقدم فيها بوضوح. ففي HLAB-Vals-1.1 حصل Qwen4-Max على 21.3، وهو أعلى بكثير من 9.2 لـ Opus 5.5 و7.1 لـ GPT-6 Astra؛ وفي AA-Briefcase يتقدم أيضًا على GPT-6 Astra. لذلك فالوصف الأدق هو: توزّع قدرات Qwen4-Max يختلف عن النماذج الرائدة، وليس أنه «قريب منها بشكل شامل».
كيف نقرأ أصوات Qwen4-Max وتكلفته
الأصوات: ماذا يعني 1,814 صوتًا؟
ثبات المرتبة يعتمد إلى حد كبير على عدد الأصوات. يمثل 1,814 صوتًا لـ Qwen4-Max أقل من 0.2% من إجمالي يقارب مليون صوت، وهو أقل بكثير من عدة نماذج محلية في القائمة نفسها.
| النموذج | المرتبة | الأصوات | تكلفة المهمة الواحدة P50 | الحالة |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | السادس | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | الثالث عشر | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | السادس عشر | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | الثاني | بيانات معلنة في القائمة نفسها | $8.99 | — |
| GPT-6 Astra (Max) | الخامس | بيانات معلنة في القائمة نفسها | $9.43 | — |
عدد أصوات Qwen3.8-Max نحو 12.7 ضعف عدد أصوات Qwen4-Max، ودرجته أقرب إلى «قيمة مستقرة». أما 1750 نقطة لـ Qwen4-Max فتبدو حاليًا أشبه بقراءة مبكرة، وقد ترتفع أو تنخفض لاحقًا. عند الاقتباس بهذه المرتبة، يُفضّل ذكر القيود الثلاثة معًا: «Preliminary، 1,814 صوتًا، 2026-11-14».
تكلفة المهمة الواحدة P50: ليست سعر النموذج للوحدة
تشير تكلفة المهمة الواحدة P50 في هذا التصنيف إلى الوسيط (median) لما تُنفقه من تكلفة في مهمة واحدة على مهام التصنيف نفسه. وهي تتأثر بشدة بطول مخرجات النموذج وبمستوى قوة الاستدلال (مثل xHigh وMax)، ولا يمكن استخدامها لمقارنة سعر النموذج لكل مليون tokens.
وفقًا لهذا المقياس، فإن تكلفة Qwen4-Max البالغة $4.18 تمثل نحو 46% من تكلفة Opus 5.5 ($8.99)، و44% من تكلفة GPT-6 Astra ($9.43)، لكنها تبلغ نحو 4.7 أضعاف تكلفة Kimi K3.1 Pro ($0.89)، و2.2 أضعاف تكلفة الجيل السابق Qwen3.8-Max ($1.91). وإذا كان سيناريو استخدامك حساسًا للتكلفة لكل مهمة، فإن Kimi K3.1 Pro حقق 1686 نقطة بنحو خُمس التكلفة، وهذا أمر يستحق أن يُدرج في التقييم أيضًا.
سعر Qwen4-Max الرسمي والسعر الحالي على APIYI
فيما يلي الأسعار لكل 1M tokens، بتاريخ استخراج بيانات 2026-11-16:
- سعر Qwen4-Max الرسمي: الإدخال $1.5، الإخراج $4.5، القراءة من الذاكرة المؤقتة $0.075.
- نموذج Qwen الرائد المعروض على APIYI
qwen3.8-max: الإدخال $1.65، الإخراج $4.95، القراءة من الذاكرة المؤقتة $0.20625.
تجدر الإشارة إلى أن APIYI لم تُدرج بعد qwen4-max، وسنعمل على إدراج هذا النموذج في أقرب وقت. النموذجان مختلفان، لذا لا يمكن مقارنة الأسعار أعلاه مباشرة ببعضها، وللاطلاع على النماذج والأسعار المتاحة فعليًا يُرجى الرجوع إلى قائمة النماذج على منصة APIYI apiyi.com.
ثلاث خطوات: مراجعة القائمة، ومقارنة السعر، وتبديل نقطة الوصول
بعد قراءة أي قائمة تصنيف، يفعل المطور عادةً ثلاثة أشياء: يتحقق من الترتيب، ويتحقق من السعر، ثم يربط النموذج بمشروعه ويجرّبه. ويُفضّل اتباع هذا الترتيب:
- مراجعة القائمة: افتح صفحة Code Arena WebDev على arena.ai، وتأكد مما إذا كان قد طرأ تغيير على التاريخ أو عدد الأصوات أو علامة Preliminary.
- مقارنة السعر: تصفّح قائمة الطُرز في APIYI apiyi.com للاطلاع على طُرز Qwen المعروضة حاليًا وأسعارها اللحظية، وتأكد مما إذا كان
qwen4-maxقد أُضاف إلى المنصة. - تبديل نقطة الوصول: في الـ SDK المتوافق مع OpenAI الذي تستخدمه حاليًا، غيّر
base_urlإلىhttps://api.apiyi.com/v1، وأدخل معرّف النموذجqwen3.8-maxفي البداية، ثم بعد إضافة الطراز الجديد بدّله إلىqwen4-maxللمقارنة.
🚀 اقتراح للبدء السريع: إذا كنت ترغب في التحقق من الفجوة بين سلسلة Qwen وClaude وGPT وGemini في مهام WebDev الخاصة بك، يمكنك من خلال APIYI apiyi.com استدعاء نماذج من عدة مزوّدين بمفتاح API واحد؛ ويحصل المستخدمون الجدد على رصيد تجريبي مجاني، وهو مناسب لتشغيل دفعة صغيرة من العينات أولًا قبل تحديد الخيار الأنسب.
تحليل إيجابيات وسلبيات Qwen4-Max
مزايا Qwen4-Max
- درجة تفضيل تطوير الويب تتصدر النماذج المحلية: 1750 نقطة، أي أعلى بـ64 نقطة من صاحب المركز الثاني محليًا، وأعلى بـ74 نقطة من الجيل السابق.
- الفجوة مع بعض المتصدرين أصبحت صغيرة جدًا: لا تفصله سوى 13 نقطة عن المركز الخامس GPT-6 Astra، ويكاد يعادل المركزين السابع والثامن.
- تكلفة المهمة الواحدة أقل من الطُرز الرائدة المتصدرة: P50 بقيمة $4.18، أي أقل من نصف تكلفة Opus 5.5 وGPT-6 Astra.
- ميزة فريدة في بعض المعايير: الدرجات المُعلنة رسميًا في HLAB-Vals-1.1 تتفوق بوضوح على Opus 5.5 وGPT-6 Astra.
قيود Qwen4-Max
- الترتيب لم يستقر بعد: يحمل علامة Preliminary مع 1,814 صوتًا، لذا يجب ذكر هذه القيود عند الاقتباس.
- متأخر في معايير البرمجة الطرفية والهندسية: في Terminal-Bench 4.0 وProgramBench هو أدنى بوضوح من Opus 5.5 وGPT-6 Astra، وعند بناء Agent أو أتمتة سطر الأوامر يلزم تقييم منفصل.
- تكلفة المهمة الواحدة أعلى من بعض النماذج المحلية: أغلى بكثير من Kimi K3.1 Pro وQwen3.8-Max، وقد لا يكون مجديًا في السيناريوهات الحساسة للتكلفة.
متى لا ينبغي الاعتماد على لوحة Code Arena WebDev وحدها
إذا كان سيناريوك الأساسي هو عمليات الطرفية، أو تعديل الشيفرة عبر سلاسل طويلة، أو مهام Agent متعددة الخطوات، فإن الاعتماد على WebDev Elo وحده سيضخّم تقييم الأداء الفعلي لـ Qwen4-Max، وهنا تكون معايير من نوع Terminal-Bench أقرب إلى احتياجك. وبالمثل، إذا كانت الميزانية قيدًا صارمًا، فينبغي النظر إلى تكلفة المهمة الواحدة جنبًا إلى جنب مع الدرجات، لا مطاردة الترتيب فقط. أفضل سؤال تجيب عنه هذه اللوحة هو: “من يصنع صفحات ويب أفضل في نظر المراجعين البشريين؟”
الأسئلة الشائعة (FAQ)
س1: هل المركز السادس لـ Qwen4-Max في قائمة Code Arena WebDev مركز حقيقي؟
نعم، إنه المركز الحقيقي الظاهر على صفحة القائمة (2026-11-14، فئة Overall، 1750 نقطة). لكنه يحمل علامة Preliminary، إذ حصل على 1,814 صوتًا فقط، وقد يتغير المركز لاحقًا؛ لذا يُفضّل عند الاقتباس ذكر هذه الشروط.
س2: ما مقدار الفرق بين Qwen4-Max وGPT-6 Astra وOpus 5.5؟
في Code Arena WebDev، يقل Qwen4-Max عن GPT-6 Astra بـ13 نقطة، وعن Opus 5.5 بـ66 نقطة، وعن Fable 5.2 المتصدر بـ76 نقطة. لكن في نتائج Terminal-Bench 4.0 وProgramBench التي أعلنتها Alibaba رسميًا، تبدو الفجوة بينه وبين هذين النموذجين أكبر بوضوح.
س3: كم يتقدم Qwen4-Max على النماذج الصينية الأخرى؟
هو النموذج الصيني الوحيد الذي يدخل العشرة الأوائل؛ يتقدم على Kimi K3.1 Pro، ثاني أفضل نموذج صيني (المركز 13، 1686 نقطة)، بـ64 نقطة، وعلى الجيل السابق من عائلته Qwen3.8-Max (0902) بـ74 نقطة.
س4: ما السيناريوهات الأنسب لـ Qwen4-Max؟
وفقًا لمنهجية هذه القائمة، يناسب أكثر مهام WebDev مثل توليد واجهات الويب الأمامية وصفحات الهبوط والنماذج التفاعلية الأولية. أما أتمتة الطرفية والتعديلات البرمجية الضخمة على مستوى المشاريع، فيُوصى بالرجوع إلى معايير فئة الطرفية وتشغيل عينات بنفسك للتحقق.
س5: كيف يمكن استدعاء نماذج Qwen عبر API لإجراء اختبارات مقارنة؟
يمكنك التسجيل في APIYI apiyi.com والحصول على مفتاح API، ثم في SDK المتوافق مع OpenAI اضبط `base_url` على `https://api.apiyi.com/v1`، واملأ معرّف النموذج بـ `qwen3.8-max`. أما `qwen4-max` فغير متاح حاليًا، وسنعمل على إتاحته في أقرب وقت؛ وبعد توفره يكفي تغيير معرّف النموذج للتبديل والمقارنة.
س6: هل تكلفة المهمة الواحدة 4.18 دولار هي سعر Qwen4-Max؟
لا. إن 4.18 دولار هي الوسيط (P50) لتكلفة المهمة الواحدة في إحصاءات القائمة، وتتأثر بطول الإخراج ومستوى الاستدلال. أما سعر النموذج فيجب النظر إليه لكل 1M tokens من الإدخال والإخراج وقراءة التخزين المؤقت، ويمكن التحقق من الأسعار اللحظية في قائمة الطرازات على APIYI apiyi.com.
أبرز النقاط الرئيسية في Qwen4-Max Code Arena WebDev
- الترتيب: المركز السادس في تصنيف 14-11-2026 برصيد 1750 نقطة، وهي المرة الأولى التي يدخل فيها نموذج صيني ضمن المراكز الستة الأولى.
- التوزيع: المراكز الخمسة الأولى محتلة بالكامل؛ ثلاثة مقاعد لـ Anthropic، ومقعد لـ Google، ومقعد لـ OpenAI.
- الاستقرار: الترتيب يحمل علامة Preliminary مع 1,814 صوتًا، ما يعني أنه قد يتغير.
- الفارق مع المنافسين المحليين: يتقدم على Kimi K3.1 Pro بـ 64 نقطة، وعلى الجيل السابق بـ 74 نقطة.
- حدود القدرات: لا يزال متأخرًا عن الصدارة في اختباري Terminal-Bench وProgramBench وفق ما أعلنته الجهة المطورة.
- طريقة حساب التكلفة: قيمة P50 البالغة 4.18 دولار هي وسيط تكلفة المهمة الواحدة، وليست سعر النموذج نفسه.
- طريقة البدء: يمكنك أولاً استخدام
qwen3.8-maxعبر APIYI لبناء عملية المقارنة، ثم التبديل عند إتاحة الطراز الجديد.
الخلاصة
يمكن تلخيص أداء Qwen4-Max في تصنيف Code Arena WebDev في ثلاث نقاط:
- أول دخول إلى المراكز الستة الأولى: 1750 نقطة، وهو النموذج الوحيد غير التابع لمختبر أمريكي بين الستة الأوائل، ولا يفصله عن المركز الخامس سوى 13 نقطة.
- الترتيب قراءة مبكرة: علامة Preliminary و1,814 صوتًا، لذا يجب ذكر التاريخ وعدد الأصوات بوضوح عند الاقتباس.
- تصنيف Elo لا يعني التفوق الشامل: في اختبارات الطرفية والبرمجة الهندسية التي أعلنتها الجهة المطورة، لا يزال متأخرًا عن Opus 5.5 وGPT-6 Astra.
إذا كنت تختار نموذجًا، فمن المستحسن أن تنظر إلى هذا التصنيف كأحد أبعاد المرجعية الخاصة بـ«تفضيلات تطوير الويب»، ثم تجمع بينه وبين عينات مهامك وميزانيتك التكلفية للحكم. نوصي باستخدام واجهة موحدة عبر APIYI apiyi.com لمقارنة النماذج المرشحة على نفس الدفعة من المهام، والوصول إلى استنتاج بناءً على بياناتك الخاصة.
📚 المراجع
- قائمة Code Arena WebDev على arena.ai: مصدر الترتيب والدرجة والأصوات وتكلفة المهمة الواحدة في هذا المقال
- الرابط:
arena.ai -
ملاحظة: الصفحة تحمل تاريخ 2026-11-14 ضمن تصنيف Overall، ويمكنك بنفسك التحقق من أحدث ترتيب وعلامة Preliminary
-
الرسم التوضيحي الرسمي لإصدار Qwen4-Max من علي بابا: مصدر درجات المعايير مثل Terminal-Bench 4.0 وProgramBench
- الرابط: حسب قنوات الإصدار الرسمية لـ Qwen
- ملاحظة: البيانات الواردة في المقال مُصرّح بها رسميًا من الجهة نفسها، وليست إعادة إنتاج من طرف ثالث
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلك معنا عبر الصفحة الرئيسية لموقع APIYI، وللحصول على إرشادات إدراج الطُرز وطريقة الوصول إليها يمكنك زيارة مركز التوثيق docs.apiyi.com


