
ملاحظة المؤلف: يتحدَّد زمن تنفيذ مهام Codex بمجموعة من العوامل: النموذج، وشدة الاستدلال، ومسار الخدمة، وحلقة الأدوات، والتخزين المؤقت، والشبكة. وبالاعتماد على مقارنة المهمة نفسها في ظروف مختلفة مع تقسيم التوقيت إلى مراحل، يمكن تحديد موضع الاختناق.
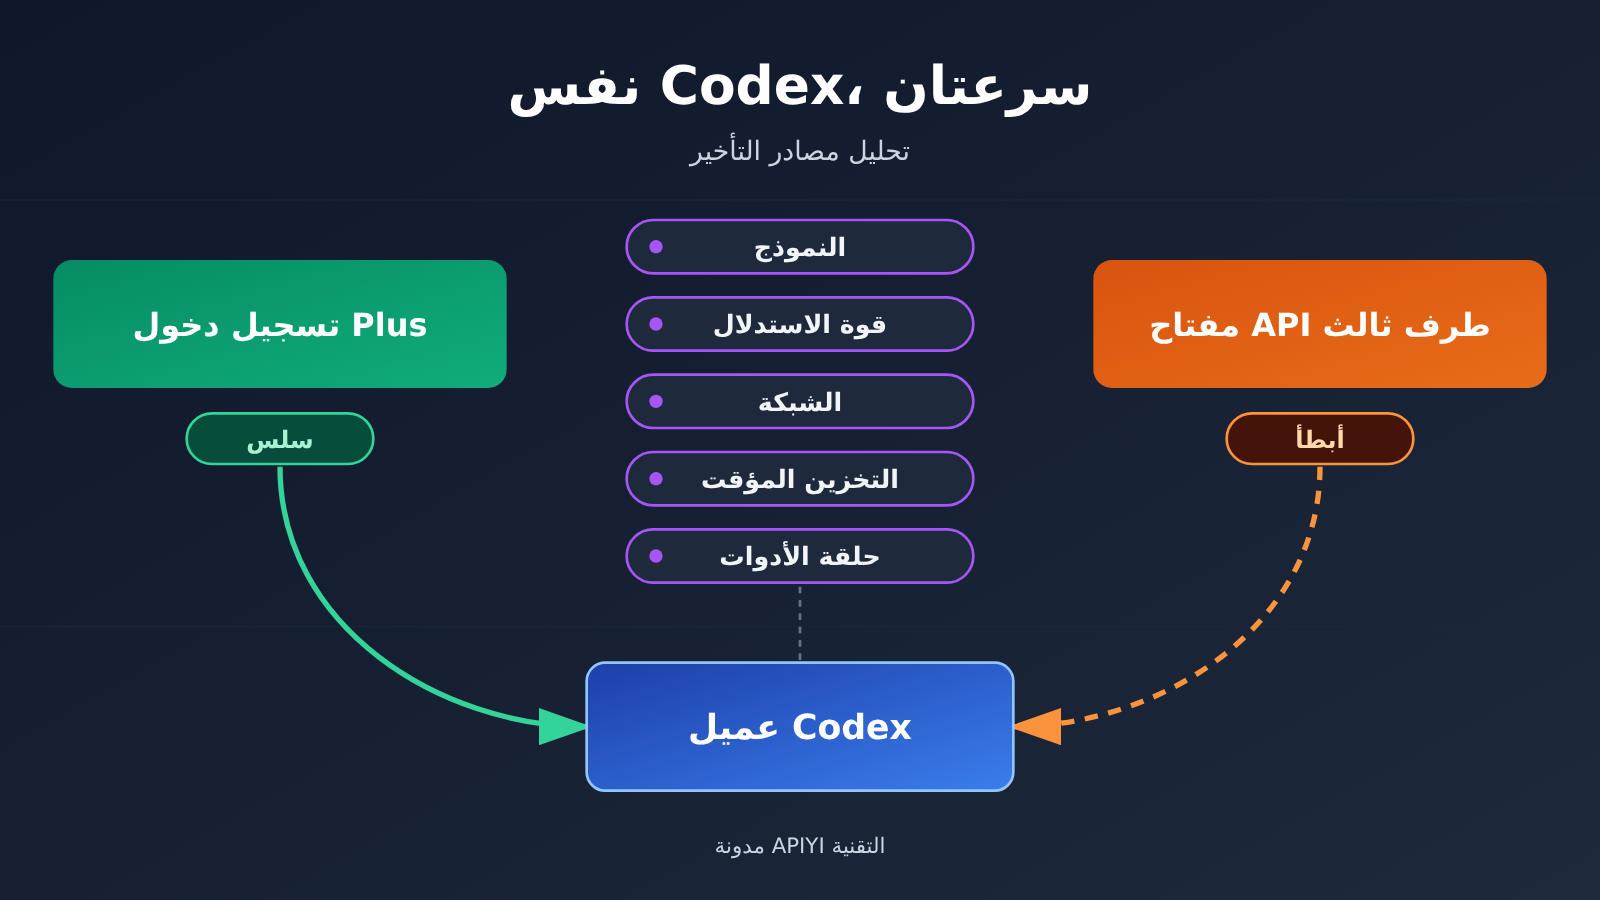
نفس Codex، يكون سريعًا عند تسجيل الدخول عبر ChatGPT Plus، لكنه يتباطأ بعد استبدال ذلك بمفتاح API من طرف ثالث. السبب عادةً أن الاثنين يسلكان مسارات خدمة مختلفة، وحلقة الوكيل (Agent) في Codex تضاعف تراكم التأخير الإضافي في كل جولة طلب. واجهة العميل تبدو واحدة، لكن نشر النموذج، ومستوى الاستدلال، وبروتوكول النقل، وإصابة التخزين المؤقت، ودرجة توافق أحداث الأدوات قد تختلف جميعها. تأخير ثلاث ثوانٍ فقط في الطلب الواحد قد يضيف نحو دقيقة كاملة في مهمة برمجية تحتاج إلى 20 استدعاءً متسلسلًا.
في ما يلي نفكِّك أولًا طريقة عمل Codex ومساري الوصول إليه، ثم نشرح بندًا بندًا مصادر التأخير في واجهات API من طرف ثالث، ونستعين بمشكلتين منشورتين علنًا على GitHub (Issue) كدراستَي حالة. بعد ذلك نعرض أربعة مؤشرات أساسية، وثلاث مجموعات من اختبارات المقارنة، وخطة تحسين مصنَّفة حسب الأعراض، لمساعدتك على تحديد ما إذا كان بطء Codex يعود إلى النموذج أو الشبكة أو التخزين المؤقت أو حلقة الأدوات. وأخيرًا نناقش، عند اختيار API من طرف ثالث، أي المؤشرات تعكس التكلفة الحقيقية أكثر من سعر الوحدة.
للمعرفة: مصطلحات فهم فروقات سرعة Codex
| المصطلح | الشرح |
|---|---|
| Codex Harness | إطار تنفيذ Codex، المسؤول عن تنظيم النموذج والأدوات والسياق ودورة المهام متعددة الجولات. |
| Responses API | واجهة برمجية تقدمها OpenAI تدعم مخرجات النموذج واستدعاء الأدوات وإدارة حالة الجولات المتعددة، ويعتمد عليها Codex في التشغيل. |
| TTFT | Time To First Token، أي زمن الانتظار من إرسال الطلب حتى استلام أول token في المخرجات. |
| TPS | Tokens Per Second، عدد الـ tokens المولدة في الثانية، ويعكس سرعة الإخراج المستمرة. |
| زمن التنفيذ الكلي | الوقت الإجمالي من إرسال المهمة حتى إكمالها نهائيًا، ويشمل كل استدعاءات النموذج وتنفيذ الأدوات. |
| شدة الاستدعاء | درجة عمق تفكير النموذج، مثل low وmedium وhigh؛ والدرجة الأعلى عادةً تعني مخرجات أكثر وزمنًا أطول. |
| استدعاء الأدوات (Tool Calling) | عملية يطلب فيها النموذج من برنامج خارجي قراءة ملفات أو تنفيذ أوامر، ثم يستخدم النتيجة لمواصلة الاستنتاج. |
| التخزين المؤقت للموجه (Prompt Caching) | إعادة استخدام نتائج حسابية جاهزة عندما تتكرر بادئة الإدخال وتتوفر الشروط، لتقليل زمن المعالجة. |
| SSE | Server-Sent Events، يدفع الخادم الأحداث باستمرار عبر اتصال HTTP أحادي الاتجاه. |
| WebSocket | اتصال ثنائي الاتجاه دائم، ويمكن إعادة استخدام الاتصال نفسه لطلبات متعددة الجولات. |
| previous_response_id | معامل في Responses API يشير إلى استجابة الجولة السابقة، ويقلل مع الإدخال التزايدي من النقل المتكرر. |
| فئة الخدمة | خيارات معالجة مختلفة للنموذج نفسه، مثل Standard وFast، وتختلف في السرعة والسعر. |
1 لماذا يمتلك Codex نفسه سرعتين مختلفتين؟
1.1 تسجيل الدخول عبر اشتراك Codex ومفتاح API يسلكان مسارين مختلفين للخدمة
وفقًا لوثائق المصادقة من OpenAI، تدعم Codex CLI وإضافة IDE وتطبيق سطح المكتب طريقتين لتسجيل الدخول: عبر حساب ChatGPT، أو بإدخال مفتاح API. يستهلك تسجيل الدخول عبر ChatGPT حقوق استخدام Codex المرفقة بالاشتراك والحصص المقابلة لها؛ أما مفتاح API فيخضع لقواعد القياس والفوترة وتحديد المعدل الخاصة بحساب API. كما أن اشتراك Plus نفسه لا يتضمن حق استدعاء أي API من OpenAI مجانًا.
عند استخدام مفتاح API من طرف ثالث، لا يتحمل عميل Codex سوى تنظيم المهام، بينما يحدث الاستدلال الفعلي في الخدمة التي تقف خلف تلك الواجهة. وتتحدد النماذج التي تُستدعى فعليًا وطريقة الفوترة وبروتوكول البث وجودة الخدمة من خلال واجهة الطرف الثالث وتنفيذها الخلفي. لذلك، فإن تطابق اسم النموذج المعروض في العميل يعني فقط أنك اخترت الاسم نفسه، ولا يؤكد أن الطلبين مرّا عبر نشر النموذج نفسه أو طوابير الخدمة أو مسارات النقل نفسها.
1.2 حلقة Agent في Codex تجعلها بحاجة إلى طلب النموذج مرارًا وتكرارًا
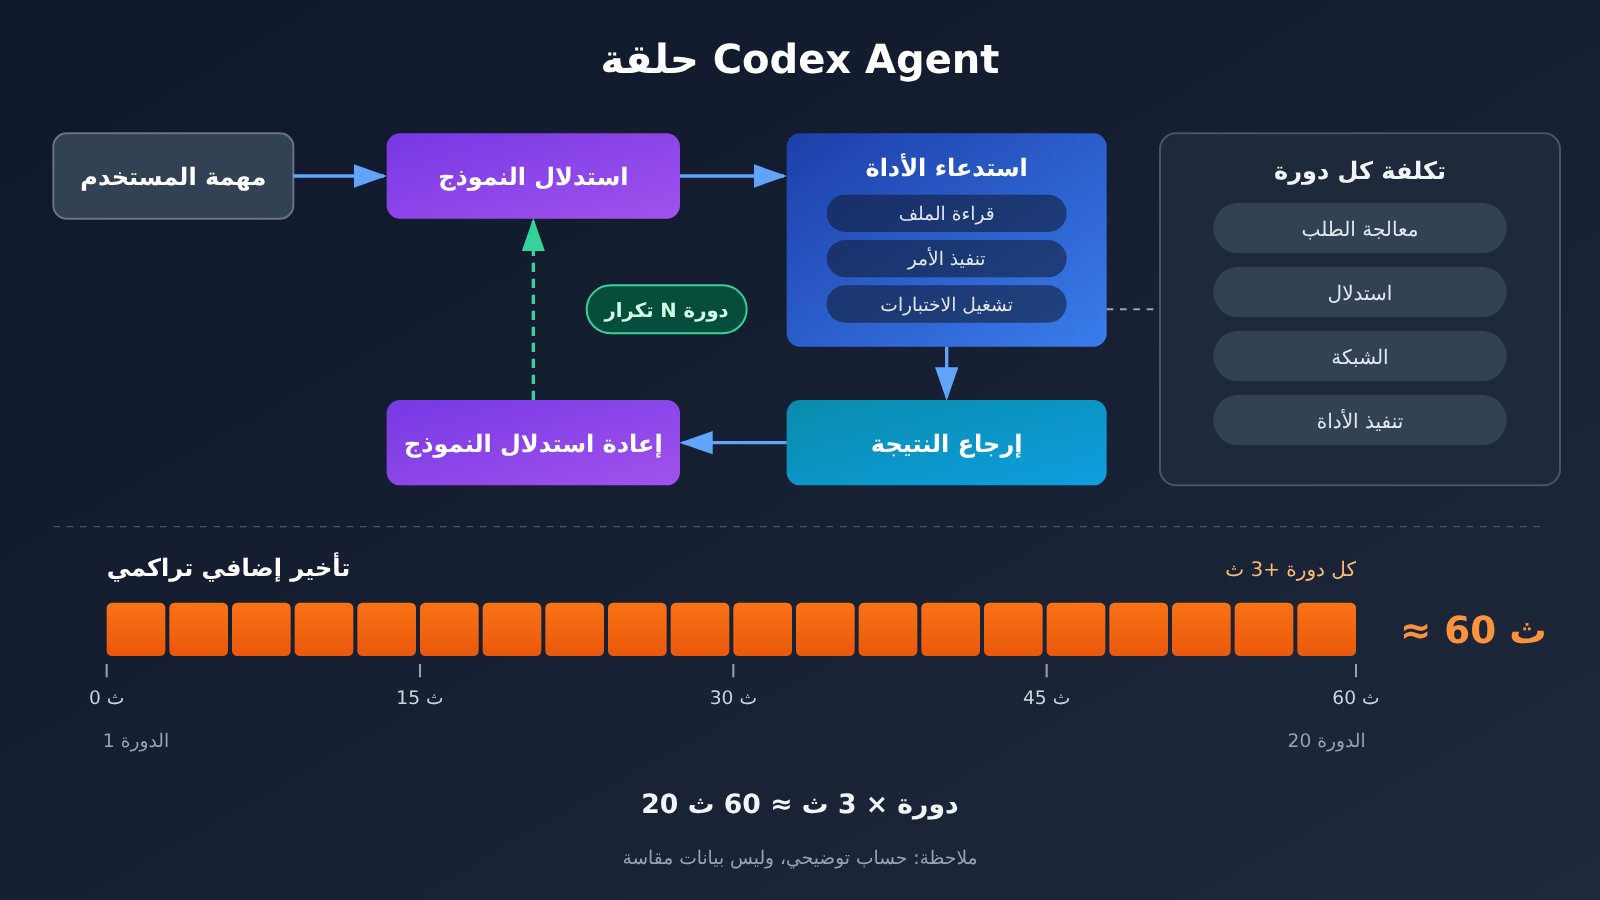
أوضح OpenAI في مقال «Codex as a platform» المنشور في 19 أغسطس 2026 أن Agent Harness مفتوح المصدر الخاص بـ Codex يتولى فهم المهمة، والحفاظ على السياق، واسترجاع قاعدة الشفرة، واستدعاء Shell، وتحرير الملفات، وتشغيل الاختبارات، كما يتعامل مع التعافي من الفشل وموافقة المستخدم وحدود التنفيذ. وهو في جوهره نظام حلقي من نوع «استدلال النموذج ← تنفيذ الأداة ← إعادة الاستدلال».
وصف OpenAI في مقال هندسي بتاريخ 22 أبريل 2026 المسار النموذجي: يطرح المستخدم مهمة تعديل، ويحدد النموذج ما ينبغي فعله، ثم يقرأ Codex ملفًا أو ينفذ أمرًا، وبعد أن تعيد الأداة النتيجة يعيد النموذج التحليل، ثم يواصل استدعاء الأدوات وتعديل الشفرة وتنفيذ الاختبارات وفحص النتائج. وقد تتضمن المهمة المعقدة عشرات الجولات من التبادل بين النموذج والأدوات، وكل جولة منها طلب API كامل.
2 من أين تأتي فروق السرعة عند ربط Codex بواجهات API خارجية؟
نبدأ بجدول يلخّص المصادر الخمسة للتأخير، ثم نفصّل كل مصدر على حدة لاحقًا.
| مصدر التأخير | المؤشر المتأثر أساسًا | السلوك النموذجي | أولوية الفحص |
|---|---|---|---|
| النموذج وقوة الاستدلال | TPS، زمن الاستدلال في الدورة الواحدة | الإخراج يبقى أبطأ باستمرار، ووقت التفكير طويل | عالية |
| فئة الخدمة والتوجيه | TTFT، حجم التذبذب | الاستجابة الأولى بطيئة أو متقلبة بين السرعة والبطء | عالية |
| بوابة API ومسار الشبكة | زمن إضافي ثابت في كل دورة | كل استدعاء يضيف ثوانٍ ثابتة | متوسطة |
| بروتوكول النقل (SSE / WebSocket) | التكلفة التراكمية عبر الدورات، واستقرار الاتصال | المهام الطويلة بطيئة، وانقطاع في منتصف الطريق | متوسطة |
| التخزين المؤقت وحلقة الأدوات | زمن معالجة الإدخال، وعدد دورات الاستدعاء | المحادثات الطويلة تصبح أبطأ بوضوح، وعدد الدورات كبير جدًا | عالية |
2.1 تأثير سرعة استدلال النموذج وقوة الاستدلال على زمن Codex
قبل مقارنة طريقتي الربط، يجب أولاً التأكد من أن معرّف النموذج الفعلي وقوة الاستدلال وإصدار النموذج وفئة الخدمة متطابقة. تتراوح قوة الاستدلال من low إلى xhigh وmax، وكلما ارتفعت الفئة، زاد محتوى التفكير الذي يولّده النموذج، وطال زمن الدورة الواحدة.
يصنّف دليل OpenAI لتحسين التأخير عدد رموز الإخراج (output tokens) كمتغيّر رئيسي يؤثر في زمن الاستدلال: في بعض الحالات، عندما ينخفض عدد رموز الإخراج بنحو 50%، قد ينخفض تأخير التوليد بنسبة تقترب من 50% أيضًا؛ بينما يكون تأثير تقليل نص الإدخال العادي أصغر بكثير عادةً. وفئة الخدمة مهمة بالقدر نفسه؛ فنمط Fast من OpenAI يمكن أن يصل إلى سرعة تصل إلى 2.5 أضعاف للموديلات والأحمال المشمولة، لكنه خيار فئة مدفوع، ولا يسري إلا على بعض النماذج.
وهذا يعني أنه حتى لو أظهر جانبي الاشتراك والطرف الثالث النموذج نفسه، فبمجرد اختلاف فئة الاستدلال أو فئة الخدمة سيظهر فرق السرعة بوضوح.
2.2 تأثير خدمة وكيل API ومسارات الشبكة وWebSocket على المهام متعددة الجولات
تكون سلسلة الطلبات في الواجهات الخارجية عادةً أطول: العميل → بوابة مزوّد الخدمة → عقدة الوكيل → مسار عابر للحدود (أحيانًا) → خدمة الاستدلال النهائية. وكل قفزة إضافية قد تضيف قدرًا من التأخير الثابت وتقلبًا في الشبكة، وهي تأخيرات تتراكم جولةً بعد جولة داخل حلقة الـ Agent.
بروتوكول النقل عامل آخر. فـ Responses API التقليدي يعمل غالبًا عبر HTTP/SSE، ما يعني إعادة إنشاء الطلب وحمل السياق في كل جولة. أما نمط WebSocket فيحافظ على اتصال قائم، ويستفيد من previous_response_id والمدخلات التراكمية لتقليل النقل والمعالجة المتكررين. وفيما يلي الأرقام التي نشرتها OpenAI رسميًا:
- أدت جولة تحسين على الـ API في أواخر 2025 إلى تحسّن زمن الوصول إلى أول token بنسبة تقترب من 45%.
- في سير عمل محدد يتضمن أكثر من 20 استدعاء أداة، حقّق نمط WebSocket提速ًا من طرف إلى طرف يصل إلى نحو 40%.
- أبلغت تكاملات Vercel عن تحسّن في زمن الوصول يصل إلى نحو 40%، وسير عمل Cline متعدد الملفات عن提速 بنحو 39%، ونماذج OpenAI داخل Cursor عن تحسّن يصل إلى نحو 30%.
هذه الأرقام مأخوذة من منتجات وسيناريوهات اختبار مختلفة، وهي تمثل قيمًا حدّية في سير عمل بعينه. بعض البوابات المتوافقة تنفّذ HTTP/SSE فقط، أو لا تدعم بشكل كامل WebSocket وإدارة الحالة التراكمية التي يستخدمها Codex، ومن ثم فإن هذا النوع من التكامل لا يحصل على هذه المكاسب.
2.3 التخزين المؤقت للسياق في Codex وعدد استدعاءات الأدوات
في المهام الطويلة، تستهلك الرسائل السابقة وتعريفات الأدوات والسياق المتكرر كمية كبيرة من رموز الإدخال. وعندما يُصيب التخزين المؤقت للمُوجّه الهدف، يمكن تقليل زمن معالجة هذا الجزء من البادئة. وتشير وثائق OpenAI إلى أن سلسلة GPT-5.6 والإصدارات اللاحقة تدعم كتابة التخزين المؤقت وقراءته والتحكم في مدة صلاحيته (TTL) بشكل جديد.
المشكلة تكمن في أن التخزين المؤقت يعتمد على ثبات بادئة الطلب. فإذا أعادت طبقة الوكيل كتابة بادئة الطلب، أو غيّرت ترتيب تعريفات الأدوات، أو عدّلت حدود التخزين المؤقت، فقد يتأثر إعادة استخدام التخزين المؤقت، ما يجعل كل جولة تعيد معالجة جزء كبير من السياق. أما عدد استدعاءات الأدوات فيحدد مباشرة عدد جولات الطلب: فكلما زادت الجولات، تضاعفت تكلفة كل جولة بمعدل أكبر.
2.4 لماذا تبدو الاستجابة الأولى من Codex طبيعية ثم يظل بطيئًا بعدها؟
هذا هو الشكل الأكثر شيوعًا لهذه المشكلة. فمقياس TTFT يقيس فقط سرعة وصول الرمز الأول، بينما الزمن الكلي لمهمة Codex هو مجموع كل الجولات. ويمكن كتابة الزمن الكلي على النحو التالي:
T_total = Σ (زمن معالجة طلب API + زمن استدلال النموذج + زمن نقل الشبكة + زمن تنفيذ الأدوات المحلية + زمن الانتظار وإعادة المحاولة)
إذا كانت الاستجابة الأولى طبيعية لكن الأداء العام بطيئًا، فالأمر يعود عادةً إلى الحالات التالية: سرعة الإخراج المستمر (TPS) منخفضة، فتؤدي الردود الطويلة إلى إبطاء كل جولة؛ إعادة استدلال النموذج بعد انتهاء تنفيذ الأدوات، حيث تتطلب كل إعادة استدلال معالجة السياق من جديد؛ انقطاع الاتصال المتدفق في منتصفه أو انتهاء المهلة، فيُشغّل العميل إعادة المحاولة، ويرى المستخدم أن «النموذج توقف». وبحسب حساب ميكانيكي، فإن مهمة تحتاج إلى 20 استدعاءً متسلسلًا للنموذج، إذا زاد الانتظار 3 ثوانٍ في كل مرة، يزداد الزمن الكلي نحو 60 ثانية، وهذا الرقم للتوضيح فقط، وليس قياسًا فعليًا.
3 ما الأدلة التي تقدّمها الحالات العامة على مشكلة بطء Codex؟
الحالتان التاليتان مأخوذتان من تقارير المستخدمين في مستودع openai/codex، وهما سجلّان لحالة فردية لمستخدم واحد، ويُستخدمان لتوضيح الآلية، ولا يمثّلان المستوى الشائع في القطاع.
3.1 Issue #60831: تقلّب زمن الاستجابة بنحو سبعة أضعاف داخل الجلسة نفسها
في Issue #60831 المقدَّم في نوفمبر 2026، رصد المُبلِّغ طلبين في الجلسة نفسها، وفي عملية العميل نفسها، وبنفس إعدادات الاستدلال: كان جسم الطلب بعد الضغط في الحالتين نحو 13.09 MB، ولم يحدث ضغط للسياق بينهما، ولم يتغيّر سجل الصور. الطلب البطيء استغرق 109.317 ثانية من اكتمال ضغط الطلب حتى استلام رأس استجابة HTTP، أما الطلب السريع فاستغرق 15.637 ثانية، أي بنسبة نحو 6.99 أضعاف.
يجدر الانتباه إلى طريقة قياس الزمن: هذان الرقمان يقيسان الزمن «حتى استلام رأس الاستجابة»، وهو يقع في مرحلة معالجة الخدمة، وليس المدة الكلية لإنجاز المهمة؛ كما أن الطلبين جاءا من المسار نفسه، فلا علاقة لهما بمقارنة الاشتراكات أو الأطراف الثالثة. ما توضّحه هذه الأرقام هو أن زمن المعالجة على الخادم قد يتقلّب بشدة حتى مع ثبات حجم السياق. ولا يستطيع التقرير نفسه تحديد أي جزء من الخدمة تسبّب في عنق الزجاجة.
3.2 Issue #44305: حلقة الأدوات تضخّم مدة مهمة قراءة فقط
في Issue #44305 المقدَّم في سبتمبر 2026، قارن المُبلِّغ مهام قراءة فقط من النوع نفسه: وكيل آخر استخدم 3 عمليات قراءة متوازية وأنجزها في نحو 10.6 ثانية؛ أما Codex فقد عمل 91.5 ثانية ثم انتهت المهلة دون تقديم إجابة كاملة. خلال ذلك نفّذ Codex نحو 11 استدعاء استدلال للنموذج و11 استدعاء أداة، وبلغ مجموع المدخلات نحو 295,042 tokens، منها نحو 260,608 tokens مدخلات مخزّنة مؤقتًا.
بحسب هذه الأرقام، تبلغ نسبة المدخلات المخزّنة نحو 88.3%، أي أن إصابة الـ cache جيدة، لكن الحلقة التسلسلية المكوّنة من 11 دورة جعلت المدة تتجاوز كثيرًا الحل المعتمد على القراءة المتوازية. استراتيجية العمل لدى الوكيلين مختلفة أصلاً، لذا لا يمكن إرجاع فرق الزمن كله إلى Codex أو إلى النموذج، لكنه يُظهر بوضوح الأثر المضاعف لعدد الدورات والتنفيذ التسلسلي على المدة الكلية.
إضافة إلى ذلك، هناك نوعان من المشكلات مرتبطان مباشرة بالتكامل مع الأطراف الثالثة: يذكر Issue #33029 أن Codex Desktop عند استخدامه واجهة متوافقة من طرف ثالث يعمل فيه نقطة نهاية النموذج بشكل طبيعي، لكن تطبيق سطح المكتب لا يزال يطلب بعض خدمات ChatGPT المساعدة، وانتهاء مهلة هذه الطلبات يُبطئ استجابة التطبيق؛ ويذكر Issue #41340 و#42471 على التوالي ظهور «stream disconnected before completion» في نقاط نهاية Responses التابعة لطرف ثالث، ووصول أحداث استدعاء الأدوات دون الدخول في مسار التنفيذ. نجاح المحادثة البسيطة، ونجاح حلقة أدوات Codex الكاملة، مستويان مختلفان من متطلبات التوافق.
4 كيف تحدد أين يكون Codex بطيئًا لديك؟
4.1 تحديد عنق الزجاجة في Codex باستخدام أربعة مقاييس أساسية
| المقياس | طريقة التسجيل | المشكلة التي يعكسها |
|---|---|---|
| TTFT | زمن انتظار أول مخرجات صالحة في كل طلب | الطابور، وبدء تشغيل النموذج، وأول حزمة عبر الشبكة |
| الزمن من طرف إلى طرف | إجمالي الوقت من تقديم المهمة حتى إتمامها | التجربة الإجمالية، وهو المعيار النهائي للحكم |
| عدد استدعاءات النموذج / الأدوات | إحصاء دورات الاستدلال، وعدد الأدوات، ووقت تنفيذ الأدوات | استراتيجية الوكيل (Agent) وتضخيم التسلسل |
| إصابات التخزين المؤقت | إجمالي المدخلات، وقراءة التخزين المؤقت، وكتابة التخزين المؤقت، ورموز المخرجات (tokens) | تكلفة إعادة معالجة السياق |
إلى جانب هذه المقاييس الأربعة، يُنصح بتسجيل TPS، وعدد رموز (tokens) الإدخال والإخراج في كل طلب، والبروتوكول المستخدم (WebSocket أو SSE)، وعدد مرات 429 و5xx وانتهاء المهلة وإعادة المحاولة. تساعدك هذه البيانات المساندة على التمييز بين «البطء» و«البطء الناتج عن إعادة المحاولة بعد خطأ».
4.2 خطوات تنفيذ اختبارات المقارنة الثلاثة لمجموعة Codex
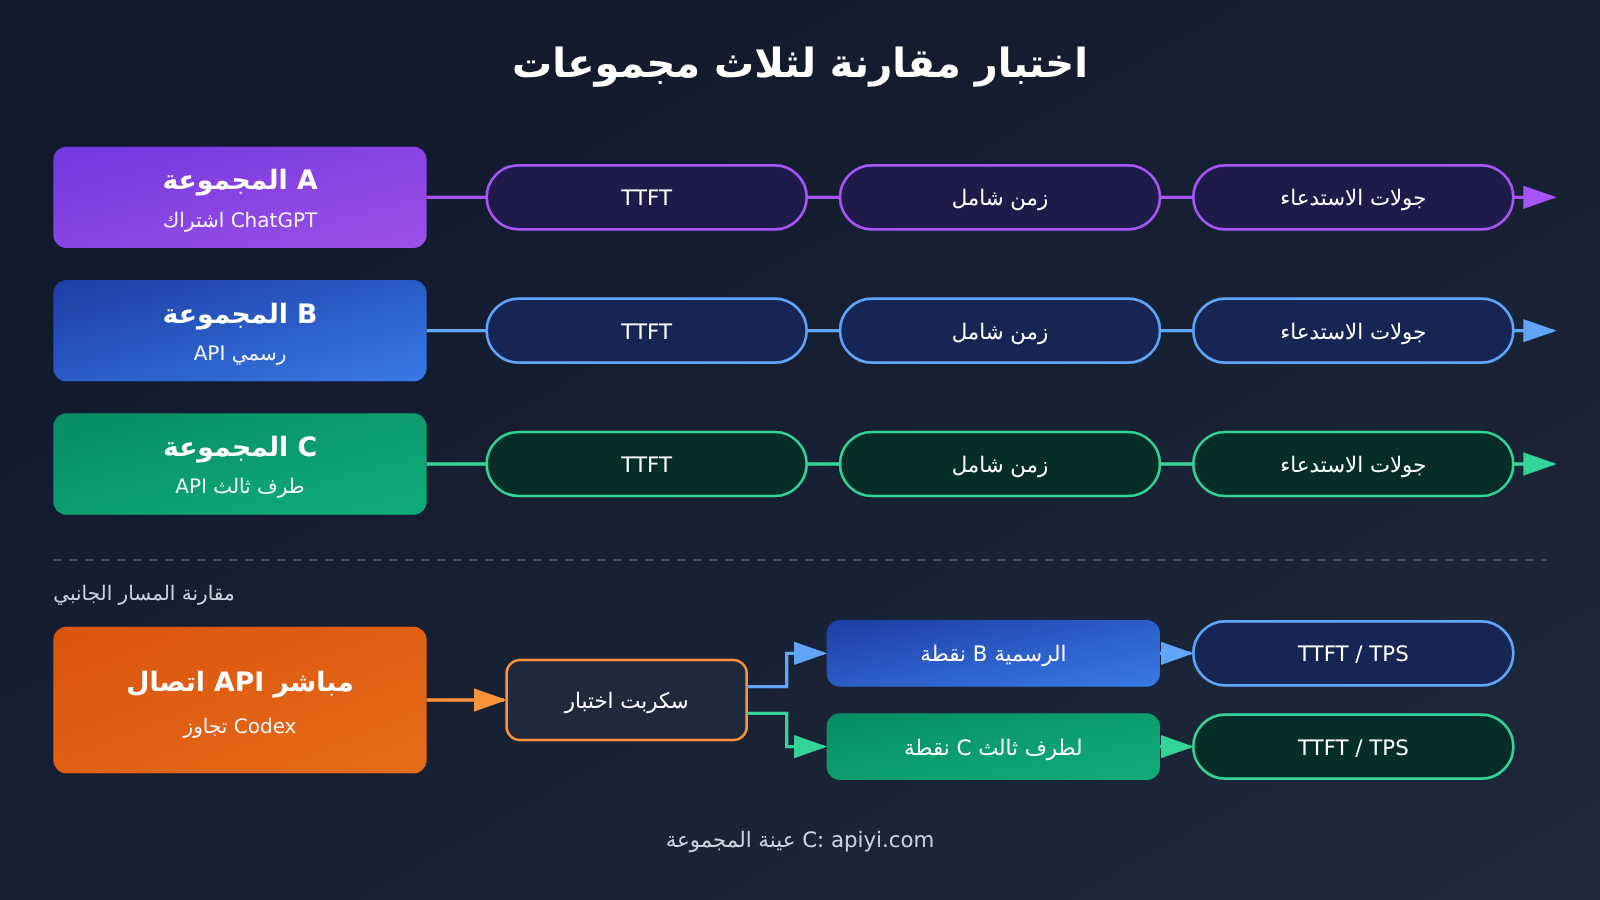
شرط اختبارات المقارنة هو ضبط المتغيرات: يجب أن يبقى معرّف النموذج وقوة الاستدلال وإصدار Codex وملفات المشروع ووصف المهمة ثابتة، مع تشغيل الاختبار مرتين في كل من الجلسة الجديدة والجلسة الطويلة لتحديد تأثير طول السياق.
- المجموعة A: تسجيل الدخول إلى Codex باستخدام اشتراك ChatGPT، وتنفيذ المهمة القياسية، وتسجيل الزمن الكلي من البداية إلى النهاية وعدد جولات الاستدعاء.
- المجموعة B: ربط Codex بمفتاح API الرسمي للنموذج نفسه، وتنفيذ المهمة نفسها.
- المجموعة C: ربط Codex عبر API متوافق من طرف ثالث، وتنفيذ المهمة نفسها.
- مجموعة الاتصال المباشر: بالنسبة لمساري B وC، تجاوز Codex وإرسال الطلب الواحد نفسه عبر سكربت، وقياس TTFT وTPS.
يعكس الفرق بين A وB بشكل أساسي اختلاف الخدمة بين مسار الاشتراك ومسار API؛ ويعكس الفرق بين B وC اختلاف البوابة والتوجيه وخدمة الاستدلال؛ أما الفجوة بين نتائج الاتصال المباشر والنتائج داخل Codex فتعكس التكلفة الإضافية الناتجة عن حلقة الوكيل (Agent loop) وتوافق البروتوكول والعميل. يُنصح بتكرار كل مجموعة عدة مرات وأخذ الوسيط، لتجنب اعتبار تقلب عابر مرة واحدة نتيجة نهائية.
السكربت التالي مخصص لاختبار “مجموعة الاتصال المباشر”، ويقيس TTFT والزمن الإجمالي ورموز الإخراج وTPS عبر طلبات Responses المتدفقة:
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، بدّل إلى العنوان الرسمي لإجراء مقارنة المجموعة B
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # حافظ على تطابق معرّف النموذج المستخدم في Codex
    reasoning={"effort": "medium"},   # حافظ على تطابق قوة الاستدلال المستخدمة في Codex
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
ملاحظة: النصوص داخل input= هي مدخلات تجريبية للمهمة ويجب إبقاؤها كما هي؛ وترجمة العبارة العربية المقابلة لها هي: “اقرأ الدالة التالية وحدد الأخطاء المحتملة: def add(a, b): return a – b”.
عرض السكربت الكامل لاختبار التكرار متعدد الجولات وإحصاءات التخزين المؤقت
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # واجهة APIYI
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# نستخدم بادئة ثابتة طويلة لمحاكاة موجه النظام وتعريفات الأدوات في Codex، لتسهيل ملاحظة إصابة الذاكرة المؤقتة
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
عند تنفيذ اختبار المجموعة C داخل Codex، تحتاج إلى ضبط نقطة نهاية تابعة لطرف ثالث لتكون مزوّد النموذج. فيما يلي الصيغة الشائعة للملف ~/.codex/config.toml، ويُرجى الرجوع إلى الوثائق الرسمية لإصدار Codex الذي تستخدمه للتأكد من أسماء الحقول الدقيقة:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 بداية سريعة: عند إعداد مقارنة المجموعة C، يمكنك التقدّم بطلب للحصول على رصيد تجريبي مجاني للمستخدمين الجدد على APIYI عبر apiyi.com، ثم استخدام المفتاح نفسه للتبديل بين عدة نماذج وتشغيل السكربت أعلاه لكل منها على حدة، لتحصل بسرعة على بيانات TTFT وإجمالي الوقت قابلة للمقارنة.
4.3 خطة تحسين Codex حسب الأعراض
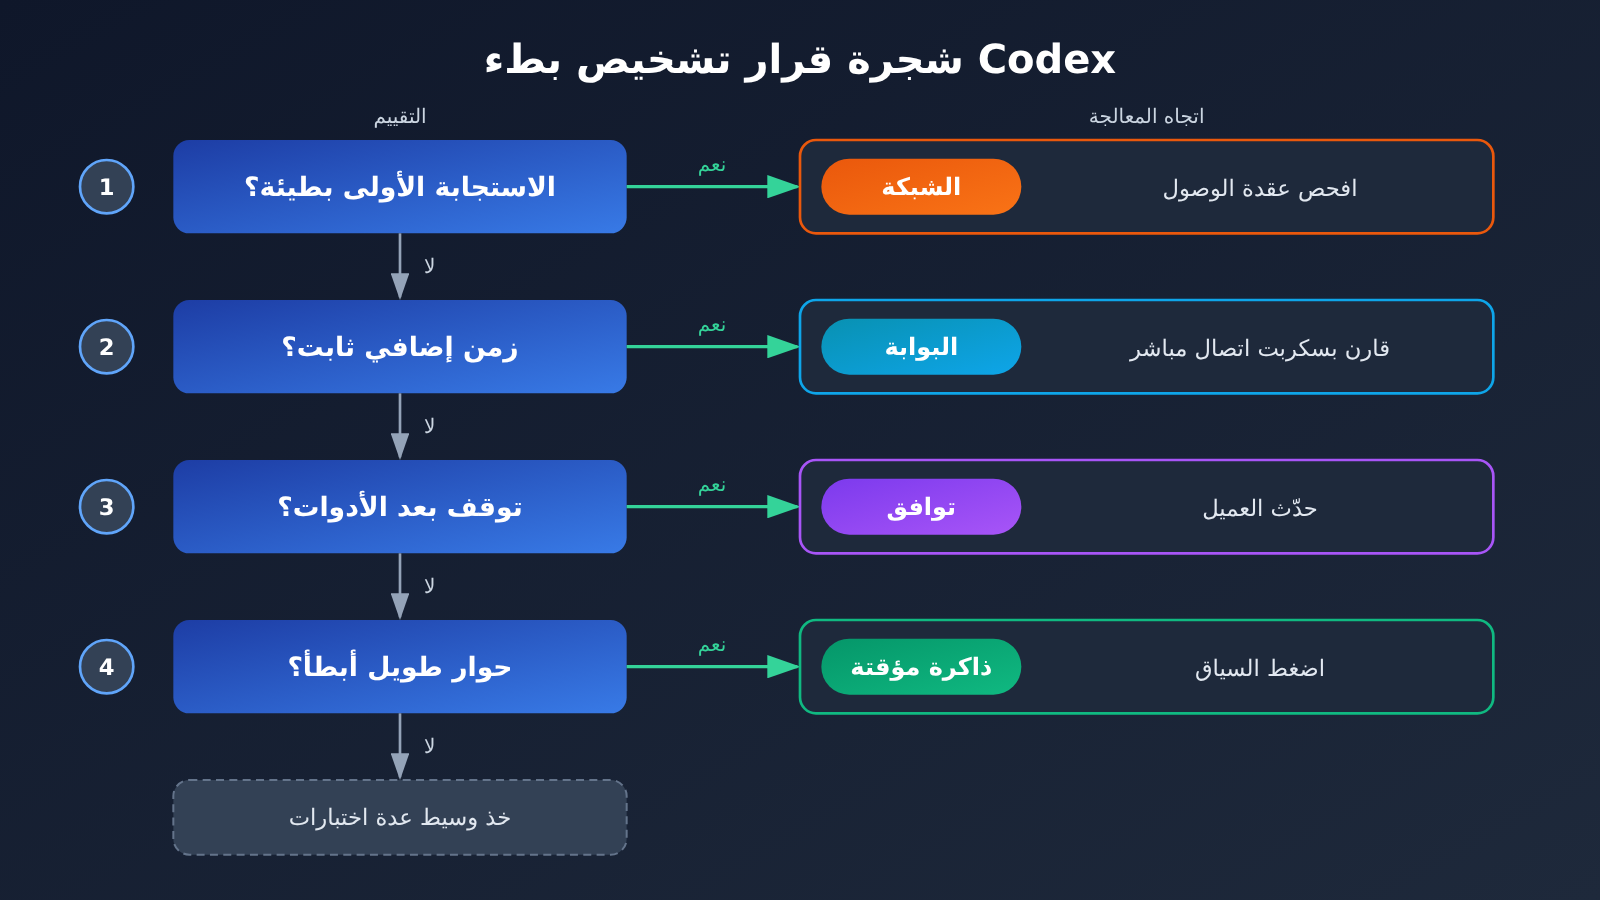
| العَرَض | أول ما يجب فحصه | طريقة المعالجة |
|---|---|---|
| بطء الاستجابة الأولى | قائمة الانتظار، بدء تشغيل النموذج، أول حزمة عبر الشبكة | التبديل إلى نقطة وصول أقرب، تأكيد فئة الخدمة، والمقارنة في أوقات خارج الذروة |
| الاستجابة الأولى سريعة ثم تتباطأ | عدد الرموز في الثانية (TPS)، جولات الأدوات، التخزين المؤقت | تقليل شدة الاستدلال، تقييد طول المخرجات، وفحص نسبة إصابة الذاكرة المؤقتة |
| زمن ثابت إضافي في كل استدعاء | مسار الوكيل، الطلبات الإضافية | استخدام سكربت اتصال مباشر لمقارنة المجموعتين B و C لتحديد التكلفة التي يضيفها البوابة |
| التعليق بعد استدعاء الأداة | أحداث Responses، إرجاع بيانات الأداة | فحص وجود انقطاع في التدفق أو فقدان لأحداث الأداة، وترقية إصدار العميل |
| المحادثات الطويلة أبطأ بكثير من الجديدة | رموز السجل، الضغط، التخزين المؤقت | افتح جلسة جديدة أو فعّل ضغط السياق في الوقت المناسب، وراقب تغيّر قراءة الذاكرة المؤقتة |
| السرعة متقلبة صعودًا وهبوطًا | حِمل الخدمة، إعادة المحاولة، تقلّبات الشبكة | إحصاء عدد 429/5xx والمهلات، وتكرار الاختبار عدة مرات وأخذ الوسيط |
| بطء عام في تطبيق سطح المكتب مع أن API سليم | طلبات الخدمات المساعدة في ChatGPT | راجع Issue #33029، وافحص إن كانت الطلبات المساعدة تنتهي بمهلة، وانتقل إلى CLI عند الحاجة |
تتبع التحسينات على مستوى النموذج منطق إرشادات OpenAI بشأن زمن الاستجابة: قلّل رموز المخرجات، وقلّل سياق الإدخال، وقلّل عدد الاستدعاءات، ونفّذ الخطوات المستقلة على التوازي، ولا تُسند إلى النموذج ما يمكن إنجازه ببرنامج عادي. وبالنسبة إلى Codex، فإن أبسط وسيلة هي تحديد نطاق أوضح لوصف المهمة، حتى يقوم الوكيل بجولات قراءة استكشافية أقل.
5 ما المؤشرات الأكثر أهمية من سعر الوحدة عند اختيار API طرف ثالث لـ Codex؟
5.1 الانتقال من سعر الـ token إلى تكلفة إنجاز المهمة
في سياق Codex، تحدد التكلفة الحقيقية بـ«إنجاز مهمة واحدة». فالواجهة ذات السعر المنخفض قد تنتهي باستهلاك أكبر من الـ tokens والوقت إذا كان التخزين المؤقت ضعيفًا، أو تعددت دورات الاستدعاء، أو تكررت إعادة المحاولة بسبب انقطاع التدفق. عند التقييم، يُنصح بالنظر إلى العناصر التالية معًا: معدل نجاح المهمة، وزمن التنفيذ من طرف إلى طرف، وإجمالي الـ tokens المستهلكة في المهمة (بما فيها قراءة التخزين المؤقت)، والتكلفة الإضافية الناتجة عن الفشل وإعادة المحاولة.
| بُعد التقييم | نقاط الاهتمام | طريقة الاختبار | المنصة المتاحة |
|---|---|---|---|
| هوية النموذج وإصداره | هل معرّف النموذج وإصداره واضحان ومستقران وقابلان للاستخدام؟ | مطابقة حقل النموذج المُعاد مع الوثائق | APIYI apiyi.com، وAPI الرسمي |
| سرعة أول token والسرعة المستمرة | الوسيط والتذبذب في TTFT وTPS | اختبار متعدد الدورات عبر سكربت اتصال مباشر | APIYI apiyi.com، وAPI الرسمي |
| زمن إنجاز Agent متعدد الجولات | إجمالي الوقت لمهمة حقيقية داخل Codex | اختبار مقارن بثلاث مجموعات | APIYI apiyi.com، وAPI الرسمي |
| توافق البروتوكول | دعم Responses وWebSocket وأحداث الأدوات | تشغيل مهمة كاملة: قراءة ملف + تعديل كود + اختبار | حسب وثائق مزود الخدمة |
| دعم التخزين المؤقت | هل يتم إرجاع رموز قراءة التخزين المؤقت بشكل طبيعي؟ | إحصاء حقول التخزين المؤقت في usage | حسب وثائق مزود الخدمة |
| الاستقرار والفوترة | نسبة الفشل، والتزامن، وشفافية الفوترة | تسجيل 429/5xx وتفاصيل الفاتورة | حسب وثائق مزود الخدمة |
5.2 تقييم واجهات طرف ثالث مثل APIYI باستخدام مهام حقيقية
APIYI apiyi.com هي منصة تجميع API لنماذج اللغة الكبيرة؛ يمكن لمفتاح API واحد استدعاء النماذج السائدة مثل OpenAI وClaude وGemini، والواجهة متوافقة مع بروتوكول OpenAI وتُحسب الفوترة حسب الاستخدام. وتظهر قيمتها في سياق Codex أساسًا في سهولة المقارنة الأفقية: يمكنك تبديل النماذج والفئات المختلفة ضمن الإعداد نفسه، والحصول على بيانات قابلة للمقارنة على مشروعك الخاص.
تختلف مسارات الاتصال ودعم البروتوكولات والاستقرار بين مزودي الخدمة من طرف ثالث، لذا يجب أن يعتمد التقييم على بيانات اختبار محددة واتفاقية الخدمة. يُنصح باختيار 2~3 مهام تمثيلية (مثل إعادة هيكلة عدة ملفات، أو إصلاح bug مصحوب باختبار)، وتنفيذها بكل طريقة اتصال وفق منهج القسم 4، ثم اتخاذ القرار بناءً على معدل النجاح وإجمالي الـ tokens.
💡 اقتراح للاختيار: استبعد أولاً باستخدام سكربت اتصال مباشر الخيارات التي تنحرف بوضوح في TTFT وTPS، ثم أدخل المرشحين المتبقيين إلى Codex لتشغيل مهام كاملة. وعبر الواجهة الموحدة لـ APIYI apiyi.com، يمكنك مقارنة عدة نماذج دون تغيير بنية الكود.
الأسئلة الشائعة FAQ
Q1: من أين تأتي فروقات السرعة الرئيسية بين اشتراك Codex وواجهة API الخارجية؟
من الفروقات الكلية في مسار الخدمة: النشر الفعلي للنموذج، شدة الاستدلال، مستوى الخدمة، مسار البوابة، بروتوكول النقل، إصابة ذاكرة التخزين المؤقت، ودرجة توافق أحداث الأدوات. حلقة الوكيل متعددة الجولات في Codex تتراكم فيها هذه الفروقات الفردية جولة بعد جولة، لذلك غالبًا ما يكون فارق الوقت الإجمالي أكبر بكثير من فارق الطلب الواحد.
Q2: TTFT طبيعي، فلماذا لا تزال مهمة Codex بطيئة جدًا؟
TTFT يقيس فقط وقت انتظار أول token. مهمة Codex الواحدة تتضمن عدة جولات استدلال واستدعاءات أدوات، وسرعة الإخراج المستمر، وإعادة الاستدلال بعد تنفيذ الأدوات، وإخفاق إصابة ذاكرة التخزين المؤقت، وإعادة المحاولات في المنتصف، وكلها تطيل الوقت الإجمالي. لتقييم التجربة يجب النظر إلى الوقت من البداية إلى النهاية وعدد جولات الاستدعاء.
Q3: كم يمكن أن يسرّع وضع WebSocket من Codex؟
البيانات التي نشرتها OpenAI هي: في سير عمل محدد بأكثر من 20 استدعاء أداة، تتحسن السرعة من البداية إلى النهاية بنحو 40% كحد أقصى. هذا سقف في سيناريو محدد، ويعتمد الربح الفعلي على عدد جولات المهمة وما إذا كانت الواجهة تدعم WebSocket وإدارة الحالة التدريجية بشكل كامل.
Q4: في المحادثات الطويلة يصبح Codex أبطأ تدريجيًا، فكيف نتعامل مع ذلك؟
سجّل أولاً إجمالي tokens الإدخال وtokens قراءة ذاكرة التخزين المؤقت في كل جولة، وتأكد من أن ذاكرة التخزين المؤقت تُصاب بشكل طبيعي. إذا كان سياق التاريخ طويلاً جدًا، يمكنك بدء جلسة جديدة أو تفعيل ضغط السياق؛ وفي الوقت نفسه قلّل نطاق المهمة وقلّل جولات قراءة الملفات الاستكشافية.
Q5: كيف نقيس بسرعة الأداء الحقيقي لواجهة API خارجية داخل Codex؟
1. سجّل في APIYI apiyi.com واحصل على مفتاح API ورصيد اختبار مجاني؛
2. استخدم سكربت الاتصال المباشر في هذه المقالة لقياس TTFT وTPS وإصابة ذاكرة التخزين المؤقت؛
3. اضبط Codex وفق القسم 4.2، ونفّذ نفس المهمة الخاصة بجهة الاشتراك، وقارن الوقت من البداية إلى النهاية وعدد جولات الاستدعاء.
بهذه الطريقة يمكنك فصل فروقات خدمة الاستدلال عن الفروقات التي تجلبها حلقة الوكيل.
Q6: هل يمكن أن تمثل البيانات في Issues العامة الأداء العام لـ Codex؟
لا يمكن أن تمثل ذلك مباشرة. Issue #60831 و#44305 كلاهما سجلات لمستخدم واحد؛ الأول يقيس الوقت حتى رؤوس استجابة HTTP، والثاني مهمة للقراءة فقط انتهت بمهلة. تكمن قيمتهما في عرض كيفية تأثير تذبذب الخادم وحلقة الأدوات التسلسلية على الوقت، ويجب التحقق من الاستنتاجات المحددة عبر اختبارك الخاص للمهمة.
نقاط أساسية حول اختلاف سرعة Codex
- المسار مختلف: تسجيل الدخول عبر الاشتراك ومفتاح API يسلكان مساري فوترة وخدمة مختلفين؛ تطابق اسم النموذج لا يعني بالضرورة تطابق النشر.
- تضاعف الحلقة: تجمّع حلقة Agent في Codex التأخيرات الصغيرة في كل دورة لتصبح فرقًا كبيرًا في الوقت الإجمالي.
- تعدد مستويات المؤشرات: يقيس TTFT الاستجابة الأولى، بينما يعكس الوقت من طرف إلى طرف وعدد دورات الاستدعاء التجربة الفعلية.
- للبروتوكول تأثير: يمكن لـ WebSocket أن يسرّع بنسبة تصل إلى نحو 40% في سيناريوهات استدعاء الأدوات متعددة الدورات، لكنه يتطلب دعمًا كاملًا من الواجهة.
- يجب التحقق من ذاكرة التخزين المؤقت: قد تؤثر طبقة وكيل API عند تغيير بادئة الطلب على ذاكرة التخزين المؤقت، لذا يجب إحصاء رموز قراءة ذاكرة التخزين المؤقت.
- اختبار مقارن: قارن بين ثلاث مجموعات — الاشتراك، وAPI الرسمي، وAPI طرف ثالث — على المهمة نفسها، وأضف اختبار اتصال مباشر لتحديد عنق الزجاجة.
- الاختيار حسب المهمة: استخدم مهامًا حقيقية لإجراء اختبارات مقارنة عبر منصات مثل APIYI apiyi.com، وانظر إلى تكلفة إتمام المهمة لا إلى سعر الوحدة.
الخلاصة
ظهور النموذج نفسه من Codex بسرعتين مختلفتين يعود في جوهره إلى تراكب مسار الخدمة وحلقة Agent:
- على مستوى الآلية: يحدد النموذج وشدة الاستدلال ومستوى الخدمة والبوابة والبروتوكول وذاكرة التخزين المؤقت وحلقة الأدوات الوقت الإجمالي معًا، وأي فرق في دورة واحدة يتضاعف مع الاستدعاءات المتعددة.
- على مستوى الأدلة: تشير البيانات الرسمية إلى أن تحسين البروتوكول ومستوى الخدمة يمكن أن يحقق تسريعًا ملحوظًا، بينما تُظهر سجلات المستخدمين أن تقلبات الخادم والحلقات التسلسلية تطيل المهام بشكل كبير.
- على مستوى المنهجية: سجّل أربعة مؤشرات أساسية، ونفّذ مقارنة ثلاثية المجموعات مع اختبار اتصال مباشر، ثم حسّن كل مشكلة بحسب أعراضها.
عند التشخيص، ثبّت النموذج وشدة الاستدلال أولاً، ثم دع البيانات تتكلم. وإذا كنت بحاجة إلى مقارنة عدة نماذج وطرق وصول، يمكنك الاستعانة بالواجهة الموحدة من APIYI لتقليل تكلفة الاختبار إلى أدنى حد.
📚 المراجع
- Codex كمنصة: البناء فوق هيكل الوكيل المفتوح:تقدّم OpenAI شرحًا لمسؤوليات Codex Agent Harness
- الرابط:
developers.openai.com/blog/codex-as-a-platform -
الوصف: المرجع الرسمي لفهم نموذج Codex متعدد الجولات وحلقة الأدوات
-
توثيق مصادقة Codex:طريقتان للوصول: تسجيل الدخول عبر ChatGPT ومفتاح API
- الرابط:
learn.chatgpt.com/docs/auth?surface=cli -
الوصف: التمييز بين مزايا الاشتراك وفوترة API وقواعد تحديد المعدل
-
تسريع سير عمل الوكلاء باستخدام WebSockets في Responses API:مقال هندسي من OpenAI
- الرابط:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
الوصف: تدفق حلقة الوكيل وبيانات تسريع WebSocket
-
توثيق وضع WebSocket:وضع WebSocket في Responses API
- الرابط:
developers.openai.com/api/docs/guides/websocket-mode -
الوصف: الاتصال الدائم والمدخلات التدريجية وحالات الاستخدام المناسبة
-
دليل تحسين زمن الاستجابة:مبادئ تحسين زمن الاستجابة لدى OpenAI
- الرابط:
developers.openai.com/api/docs/guides/latency-optimization -
الوصف: أفكار التحسين مثل رموز الإخراج وعدد الاستدعاءات والتوازي
-
توثيق الوضع السريع:مستويات الخدمة ونطاق التسريع
- الرابط:
developers.openai.com/api/docs/guides/fast-mode -
الوصف: متغير مستوى الخدمة الذي يجب ضبطه عند مقارنة السرعة
-
توثيق التخزين المؤقت للموجهات:كتابة التخزين المؤقت وقراءته ومدة البقاء TTL
- الرابط:
developers.openai.com/api/docs/guides/prompt-caching -
الوصف: إحصاءات إصابة ذاكرة التخزين المؤقت في المحادثات الطويلة وتحسينها
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471:تأخير ومشكلات توافق أبلغ عنها المستخدمون
- الرابط:
github.com/openai/codex/issues/60831、github.com/openai/codex/issues/44305、github.com/openai/codex/issues/33029 - الوصف: سجلات حالات لتقلبات الخادم وتضخيم حلقة الأدوات والطلبات المساعدة على سطح المكتب والتوافق مع بروتوكولات الطرف الثالث
المؤلف:فريق APIYI التقني
التواصل التقني:نرحب بالتواصل معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com لتبادل الخبرات حول تكامل Codex واختبار الأداء، ولمزيد من المواد يمكن زيارة مركز التوثيق docs.apiyi.com


