
ملاحظة من الكاتب: تفصيل نتيجة Claude Fable 5.2 البالغة 64.9% على RoboDojo Sim: في أي ظروف تحققت؟ وما الفارق بينها وبين Opus 5.5 وGPT-6 Astra؟ وما الأمور التي لا تثبتها؟ وما الأسعار والقيود التي ينبغي احتسابها قبل التكامل؟
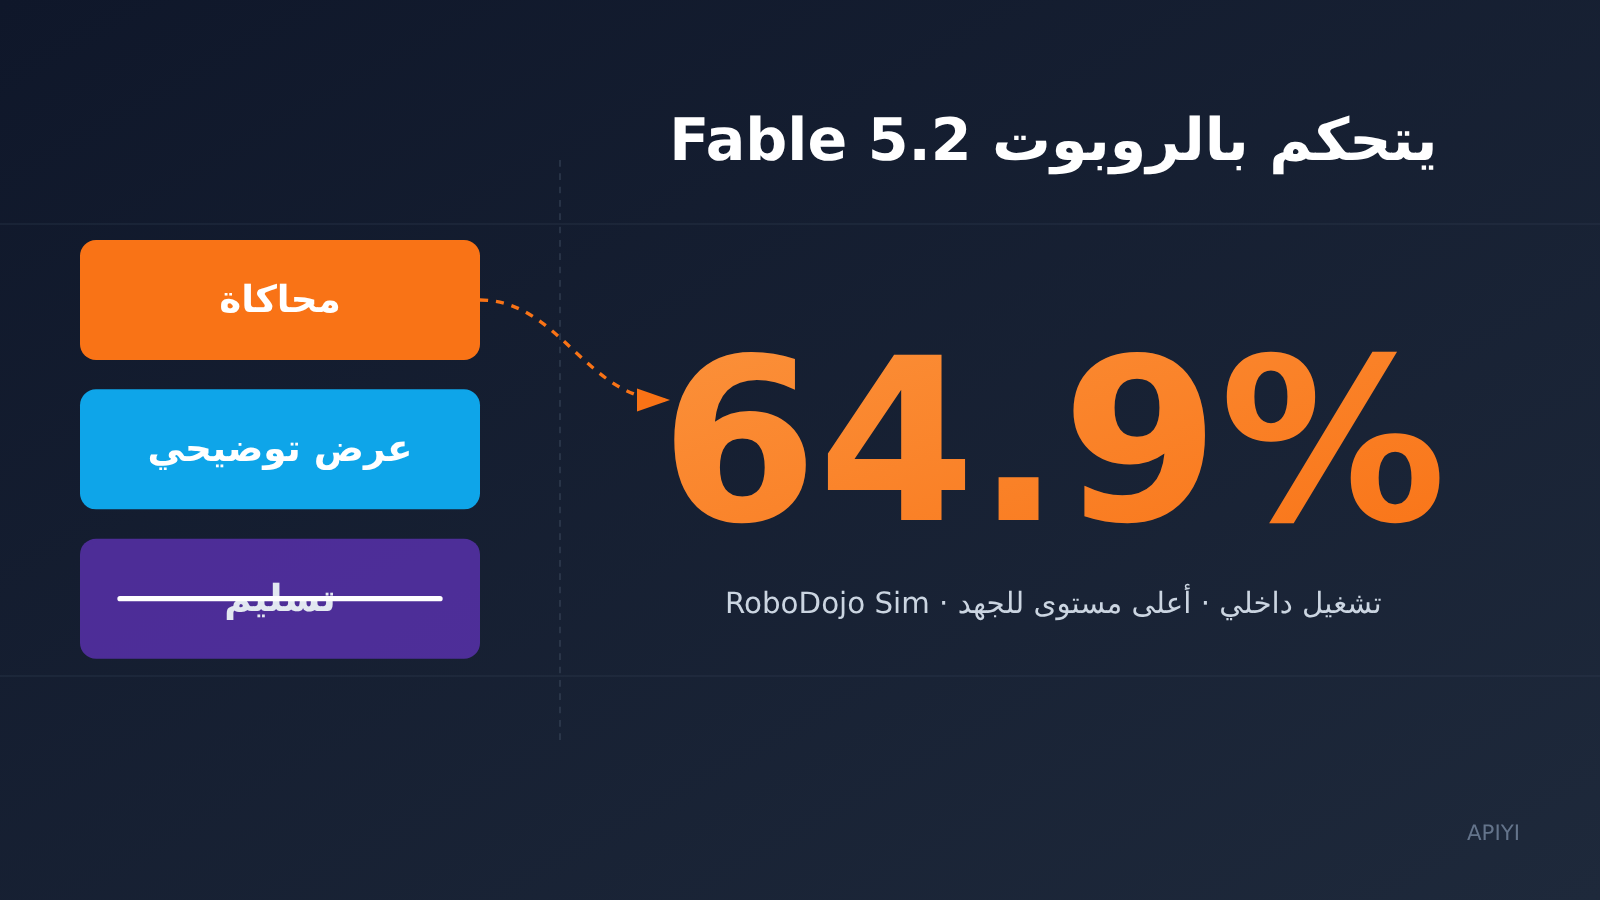
لنبدأ بالخلاصة. على RoboDojo Sim، ضمن تشغيل داخلي لدى Anthropic وبأعلى مستوى للجهد، سجّل Claude Fable 5.2 نسبة 64.9%، وOpus 5.5 نسبة 39.4%، وGPT-6 Astra نسبة 29.8%، وFable 5.1 نسبة 27.6%. هذه نتيجة لنموذج يرى صورًا من كاميرا ويتحكم بذراعين في بيئة محاكاة، وليست سجلًا لتسليمات في المصانع.
هذا ليس مقالًا ترويجيًا يقول: «لقد بدأ عصر الروبوتات». سنفصل فيما يلي بين نتائج المحاكاة ومقاطع العرض التوضيحي والنشر الفعلي. إذا كنت تستعد لاستخدام API وحساب التكاليف، فستتمكن بعد القراءة من تحديد ما إذا كان ينبغي لك تغيير مسارك التقني الآن بسبب هذه النتيجة البالغة 64.9%.
القيمة الأساسية: التمييز بين ما تثبته نتيجة Fable 5.2 البالغة 64.9% وما لا تثبته، ومعرفة النموذج المتاح الآن لإجراء التحقق الأولي.
ما حقيقة نسبة 64.9% في Claude Fable 5.2؟
يمكن توضيح هذا الرقم في ثلاث جمل. RoboDojo معيار عام يختبر قدرة النموذج على التحكم بذراعَي روبوت في بيئة محاكاة استنادًا إلى صور الكاميرا. وتذكر حاشية إعلان الإطلاق أن نسبة 64.9% هي نتيجة حصلت عليها Anthropic في اختبار داخلي، باستخدام أعلى مستوى متاح من الجهد. وحتى 2026-11-10، لم نتمكن من التحقق من الرقم نفسه في صفحة لوحة النتائج العامة لـRoboDojo؛ لذا لا يصح وصفه بأنه «الأول في التصنيف العام»، فضلًا عن القول إنه «أقوى نموذج روبوتات في العالم».
فيما يلي مقارنة RoboDojo Sim التي أوردتها Anthropic في إعلانها بتاريخ 2026-11-09:
| النموذج | RoboDojo Sim | الفارق عن Fable 5.2 | ملاحظات |
|---|---|---|---|
| Claude Fable 5.2 | 64.9% | — | اختبار داخلي، بأعلى مستوى للجهد |
| Claude Opus 5.5 | 39.4% | أقل بـ 25.5 نقطة | في الجدول نفسه |
| GPT-6 Astra | 29.8% | أقل بـ 35.1 نقطة | اختبرته Anthropic، ولم تعلن OpenAI النتيجة |
| Claude Fable 5.1 | 27.6% | أقل بـ 37.3 نقطة | الجيل السابق |
| Gemini 4 Carbon | الخانة فارغة | لا يمكن المقارنة | لا توجد نتيجة، ولا يصح اعتبارها صفرًا |
الانتقال من 27.6% إلى 64.9% يعني تحسنًا يتجاوز الضعف بين جيلين، وهو فارق لافت في جدول النتائج كله. لكن هذه النتيجة تعتمد على ثلاثة شروط: بيئة المحاكاة، والاختبار الداخلي، وأعلى مستوى للجهد. وإذا تغيّر أي شرط منها، كإجراء الاختبار على روبوت حقيقي، أو إعادة اختباره من جهة مستقلة، أو استخدام مستوى الجهد الافتراضي، فلا يمكن نقل هذه النسبة كما هي.
ما العلاقة بين Fable 5.2 وMythos 5.2؟
يوضح إعلان الإطلاق أن Claude Fable 5.2 وClaude Mythos 5.2 هما النموذج الأساسي نفسه. لكن Fable يتضمن ضوابط أقوى للأمن السيبراني والسلامة البيولوجية، ولذلك فهو متاح لجميع المستخدمين. أما Mythos، فهو متاح فقط للمؤسسات التي اجتازت برامج التحقق في علوم الحياة أو الأمن السيبراني. Mythos ليس «نموذجًا آخر أقوى»؛ لذا يكفي النظر إلى Fable 5.2 عند تقييم أداء الروبوتات.
معرّفات النماذج الرسمية:
- Claude API وGoogle Cloud وMicrosoft Foundry وClaude Platform on AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - يقابل Mythos المعرّفان
claude-mythos-5-2وanthropic.claude-mythos-5-2
الوظيفة الأساسية في Fable 5.2 للتحكم بالروبوتات: ما الذي تعرضه التجربة؟
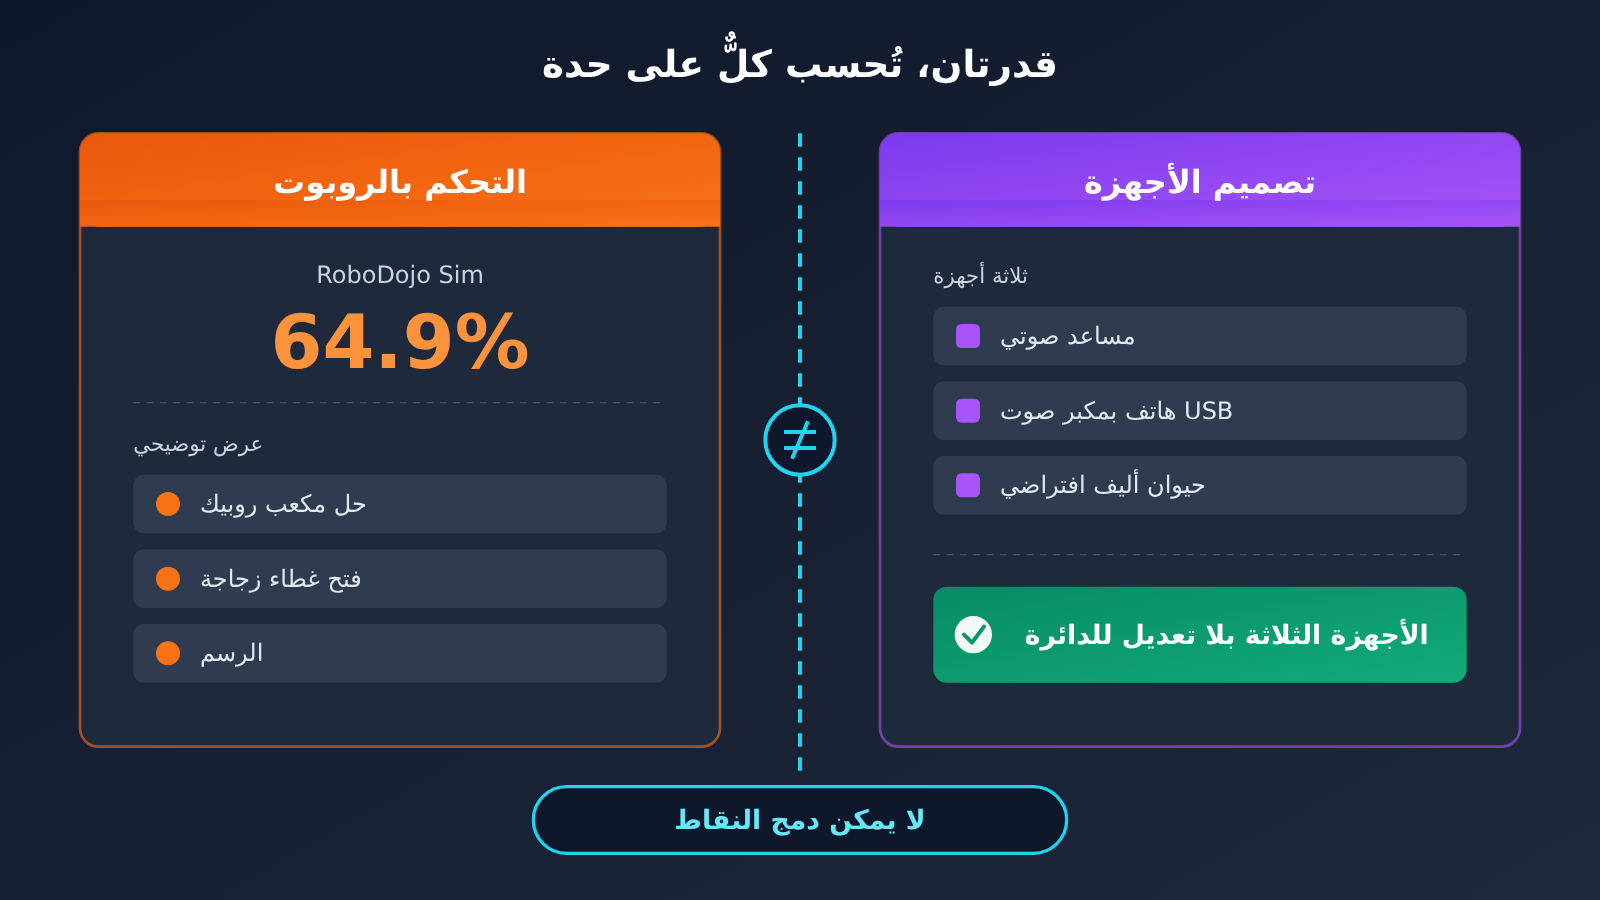
يذكر منشور الإطلاق أن قدرة Fable 5.2 على التحكم بالروبوتات المادية أفضل بوضوح من إصدارات Claude الأقدم، حتى في مهام لم يُدرَّب عليها خصيصًا. ويعرض الفيديو التوضيحي ثلاثة مشاهد: حل مكعب روبيك، وفك غطاء زجاجة، ورسم صورة لروبوت.
ينبغي التعامل مع هذه المشاهد على أنها «عروض توضيحية في منشور الإطلاق». فهي تبين أن النموذج نفّذ هذه الحركات في إعدادات محددة، لكنها لا تكشف معدل النجاح، أو عدد المحاولات، أو نسبة الإخفاقات. كما أنها لا تعني أن Anthropic أطلقت حزمة مهارات روبوتية جاهزة للتثبيت. ومن اللافت أن الشركة تقول إن بعض المهام لم تخضع لتدريب خاص، لكن هذا يظل تصريحًا رسميًا، من دون بيانات مستقلة تثبت إمكانية تكرار النتائج.
ويذكر المنشور أيضًا أن Fable 5.2 تفوق على نماذج رائدة أخرى في مجموعة الاختبارات نفسها، وعلى معظم الأنظمة المصممة خصيصًا للتحكم بالروبوتات. لكن الجزء الأخير من هذا الادعاء لا يتضمن قائمة بالأنظمة، لذا لا يمكن للقارئ معرفة الأنظمة التي جرت مقارنتها أو إصداراتها. يمكن اعتبار هذا الكلام مؤشرًا عامًا على الاتجاه، لا نتيجةً حاسمة.
مخرجات النموذج نصية، والتحكم تتولاه حزمة خارجية
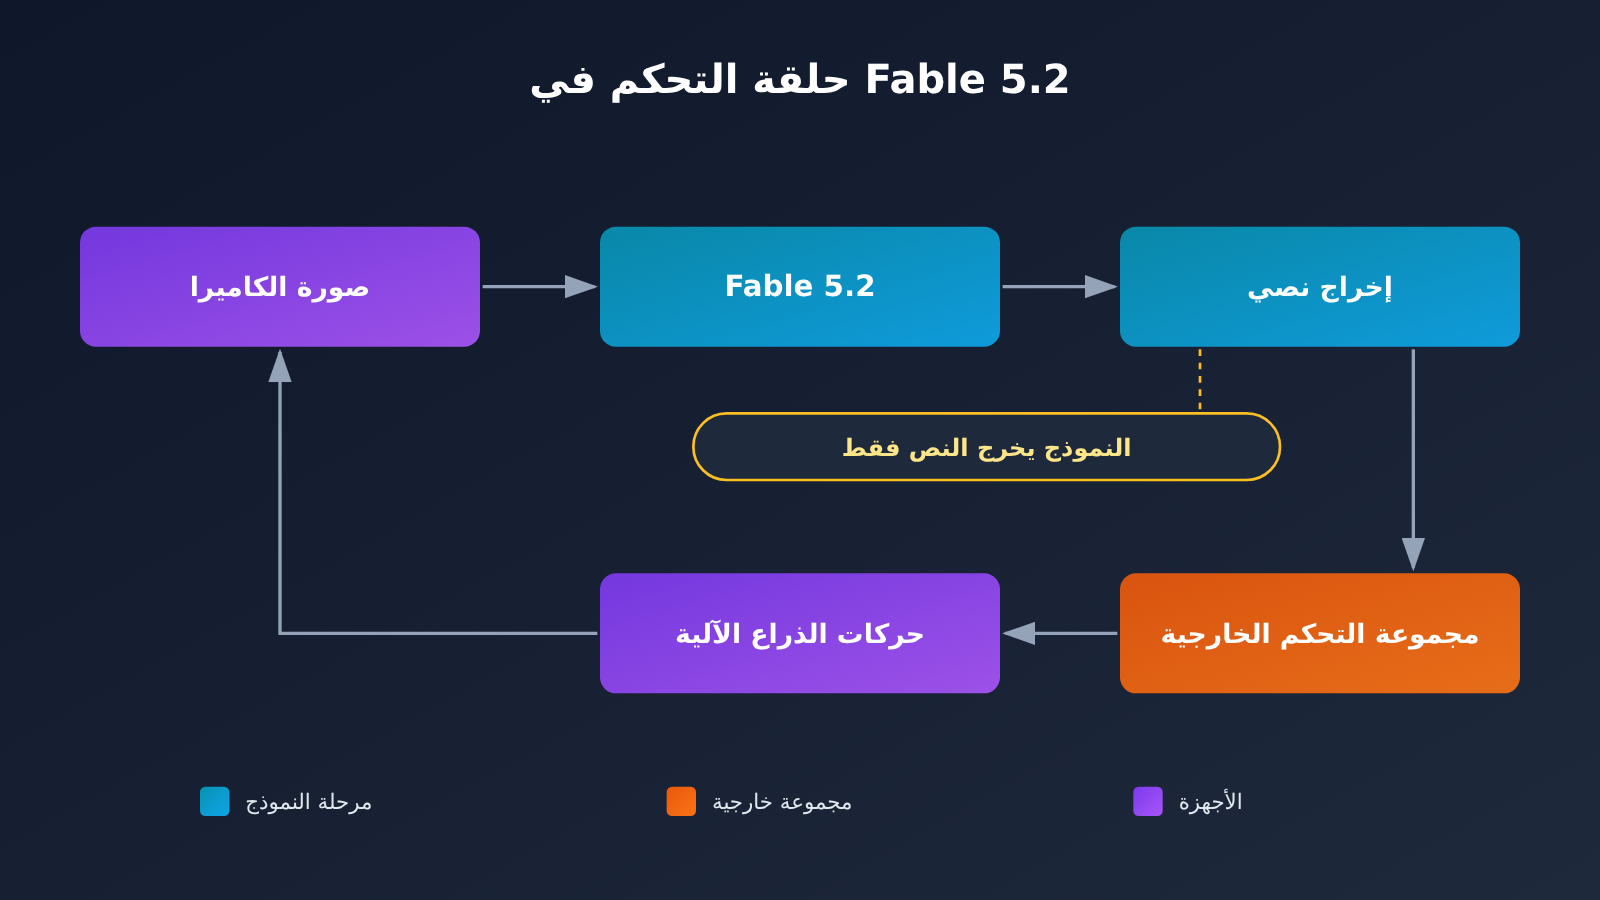
هذه هي النقطة التي يسهل أن يحجبها الفيديو التوضيحي. تذكر صفحة النموذج أن مدخلات Fable 5.2 هي النصوص والصور، وأن مخرجاته نصية فقط. فهو لا يرسل أوامر مباشرة إلى المحركات؛ إذ تتولى حزمة خارجية في كل خطوة تفسير النص وتحويله إلى حركة، ثم ترسل صورة جديدة من الكاميرا إلى النموذج.
لذلك، يعتمد أداء التحكم في الواقع على النموذج وعلى الحزمة التي تستخدمها معًا: كيف تُعرَّف فضاءات الحركة، وما آلية التعامل مع إخفاق التفسير، وهل زمن التأخير في كل خطوة مقبول. وقد حقق نظام RoboDojo نسبة 64.9% باستخدام حزمة Anthropic نفسها. أما كيفية تغير النتيجة عند استخدام حزمة مختلفة، فلا نعرفها حاليًا.
بيانات Fable 5.2 الفعلية: الفجوة في الروبوتات ليست كالفجوة في استخدام الكمبيوتر
عندما يرى كثيرون أن «Fable 5.2 قوي جدًا»، قد يخلطون تلقائيًا بين نتائج الروبوتات ونتائج المجالات الأخرى. يستند الجدول التالي بالكامل إلى إعلان Anthropic الصادر في 2026-11-09، ويقارن حجم الفجوات في عدة اختبارات مرتبطة بـ«التحكم»:
| الاختبار | Fable 5.2 | Opus 5.5 | GPT-6 Astra | تقدم Fable 5.2 على Opus 5.5 |
|---|---|---|---|---|
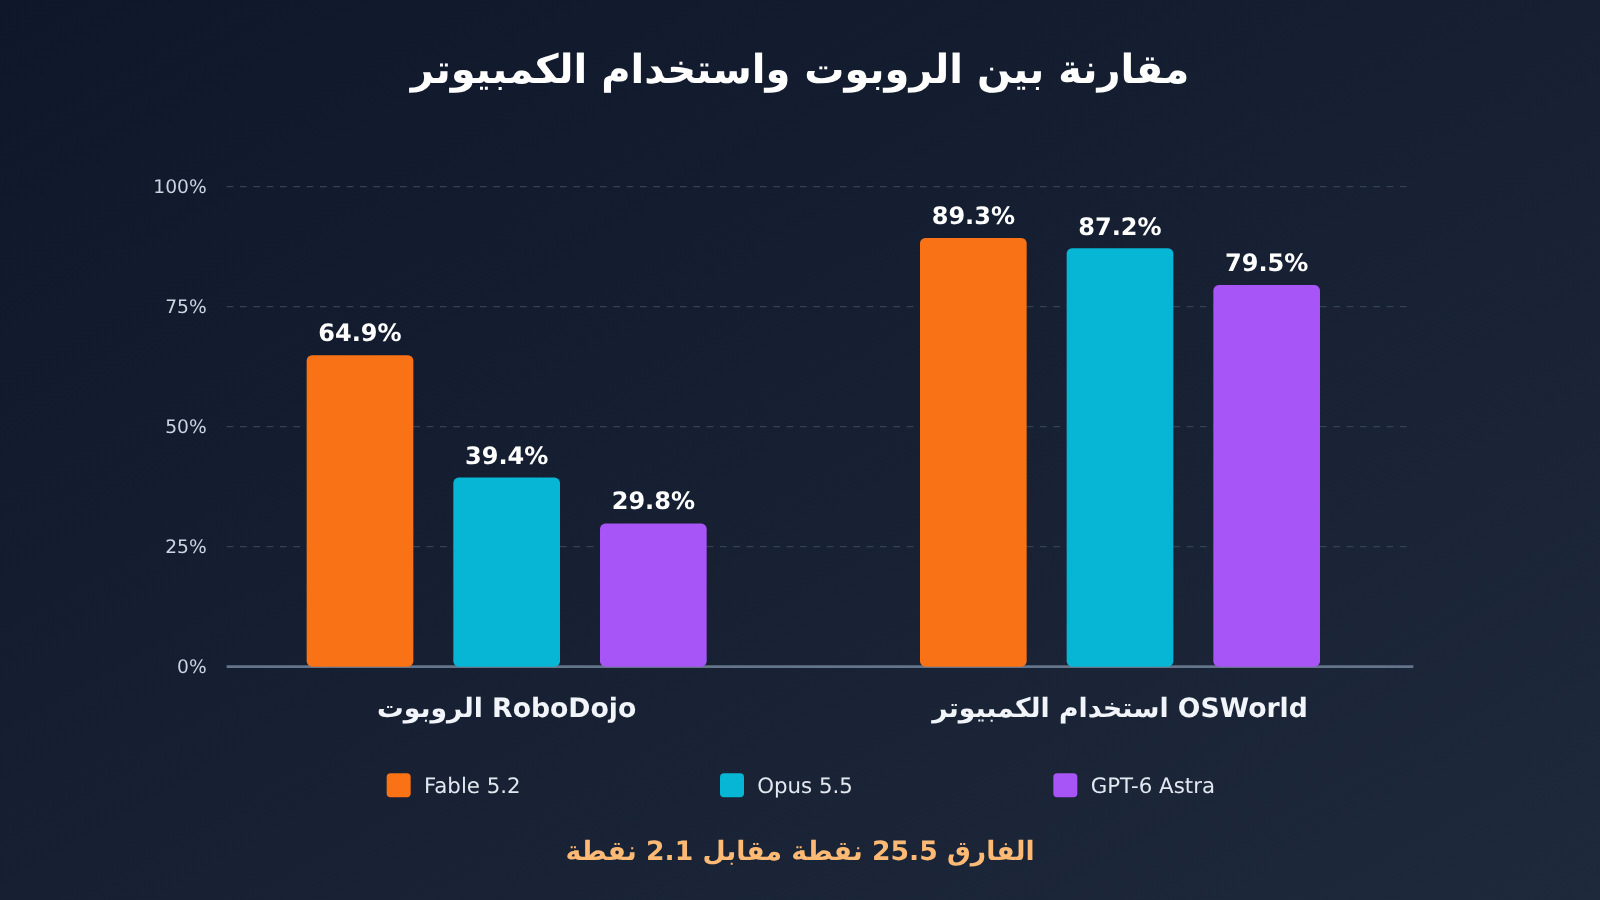
| RoboDojo Sim (محاكاة الذراعين) | 64.9% | 39.4% | 29.8% | 25.5 نقطة |
| OSWorld 2.1 (استخدام الكمبيوتر، جزء من مجموعة الاختبار غير المتصلة بالإنترنت) | 89.3% | 87.2% | 79.5% | 2.1 نقطة |
| AutomationBench | 51.4% | 42.5% | 41.4% | 8.9 نقاط (حقق Carbon نتيجة أعلى بلغت 53.9%) |
| Remote Labor Index (الفئة High) | 41.3% | 21.3% | 20.8% | 20.0 نقطة |
في اختبار OSWorld 2.1، لا يتجاوز تقدم Fable 5.2 على Opus 5.5 مقدار 2.1 نقطة. وهذا فرق لا يُقارن بالفجوة في RoboDojo، حيث ارتفعت النتيجة من 39.4% إلى 64.9%. لذا، إذا كانت مهام الوكيل التي تحتاج إليها تتعلق باستخدام الكمبيوتر، فالفرق بين Opus 5.5 وFable 5.2 أصغر بكثير مما هو عليه في اختبارات الروبوتات.
مستوى الجهد: 64.9% ليست نتيجة الإعداد الافتراضي
تعرض جداول النتائج في منشور الإطلاق أعلى مستوى جهد كان متاحًا لكل نموذج وقتها، ما لم يُذكر خلاف ذلك. مستوى الجهد الافتراضي لـ Fable 5.2 في Claude API هو high، بينما هو Medium في تطبيق Claude وClaude Code. وهذا يعني أن استدعاء النموذج بالإعدادات الافتراضية لا يضمن الحصول على الإعدادات التي حققت نتيجة 64.9%.
يتطلب المستوى الأعلى تفكيرًا أطول وعددًا أكبر من الرموز. وفي حلقات الروبوتات التي تتطلب اتخاذ قرارات متكررة، يؤدي استخدام أعلى مستوى للاستدلال في كل خطوة إلى زيادة زمن الاستجابة والتكلفة. أما مقدار تراجع نتيجة 64.9% عند استخدام high أو medium، فلم يوضحه منشور الإطلاق.
مقارنة المواصفات: Fable 5.2 وOpus 5.5 وGPT-6 Astra
| البند | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| السياق | 1M | 1M | 1,050,000 |
| الحد الأقصى للإخراج | 128K | 128K | 128,000 |
| وسائط الإدخال / الإخراج | نص + صور / نص | نص + صور / نص | نص + صور / نص |
| مستوى الجهد الافتراضي في API | high | medium | يدعم من low إلى max |
| مستويات زمن الاستجابة | Moderate | Moderate | لا تستخدم الصفحة الرسمية المعيار نفسه |
| تاريخ انتهاء المعرفة | يونيو 2026 | 2026-06 | 2026-04-30 |
مخرجات النماذج الثلاثة كلها نصية، وهذا قيد مشترك لا يمكن تجاوزه عند استخدامها للتحكم في الروبوتات.
أمور لا ينبغي احتسابها ضمن نتيجة الروبوتات في Fable 5.2
تصميم ثلاثة أجهزة إلكترونية هو تجربة في تصميم العتاد
يتضمن المنشور أيضًا فقرة عن استخدام موجه من جملة واحدة لتصميم ثلاثة أجهزة إلكترونية عاملة باستخدام Fable 5.2: مساعد صوتي منزلي، وهاتف بمكبر صوت USB، وحيوان أليف افتراضي محمول باليد. أُنجز المشروع بالتعاون مع Diode، واستغرق إنتاج كل لوحة دوائر أقل من يوم، وعملت الأجهزة الثلاثة من دون أي تعديل على الدوائر.
يعرض هذا المشروع القدرة على تصميم العتاد، ولا علاقة له بـ RoboDojo، كما أن الأجهزة نفسها ليست روبوتات. وقد يؤدي وضعه إلى جانب نتيجة 64.9% إلى انطباع بأن النظام قادر على تولي كل شيء «من التصميم إلى التحكم»، لكن المشروعين لا صلة بينهما.
حدود قدرات Fable 5.2: قيود تؤثر في حلقة التحكم
المعلومات التالية واردة في صفحة النموذج وملاحظات التحديث. تؤثر كل نقطة منها مباشرةً في حلقة التحكم التي تبنيها:
- فرض استدعاء أداة يؤدي إلى خطأ: يؤدي ضبط
tool_choiceعلىanyأوtoolإلى إرجاع الخطأ 400. إذا كان إطار العمل لديك يعتمد على «وجوب استدعاء أداة تنفيذ الإجراء»، فعليك السماح للنموذج بالاختيار بنفسه، ثم توفير آلية احتياطية لتحليل المخرجات. - لا يمكن ضبط معلمات أخذ العينات: يؤدي تمرير
temperatureأوtop_pأوtop_kإلى إرجاع الخطأ 400. - لا يمكن إيقاف التفكير: التفكير التكيفي مفعّل دائمًا، ولا يمكنك سوى ضبط مقدار التفكير عبر
effort. وتشير ملاحظات التحديث إلى أن كتابة «لا تفكر، وأجب مباشرةً» في الموجه لا توقف التفكير عند المستويات المتوسطة أو الأعلى. - قلة الكلام في سلاسل الأدوات الطويلة: أثناء استدعاء الأدوات تباعًا، قد تكون مخرجات النموذج الموجهة للمستخدم قليلة، أو قد يستدعي الأدوات مباشرةً من دون توضيح ما يفعله. لذلك لا ينبغي لواجهة المراقبة أن تعتمد على مبادرته إلى الإبلاغ عن التقدم.
- قد يتوقف مبكرًا: قد تنتهي الجولة أحيانًا، تاركةً قائمة مهام معلّقة، أو قد يتعثر النموذج عند عقبة عادية. ويحدث ذلك بوتيرة أكبر عند المستوى المنخفض.
- الرفض يستهلك الحصة أيضًا: عند رفض الطلب، تكون الاستجابة HTTP 200، وتكون قيمة
stop_reasonهيrefusal، ومع ذلك يُحتسب الطلب ضمن حصة معدل الاستخدام. - الاحتفاظ بالبيانات: تُحفَظ البيانات لمدة 30 يومًا. ولا يمكن استخدام خيار الاحتفاظ الصفري بالبيانات ما لم تحصل على موافقة صريحة من Anthropic.
تتطلب حلقة الروبوت أن يقدّم النموذج إجراءً قابلًا للتنفيذ في كل خطوة. ومجتمعةً، تعني القيود المذكورة أعلاه أنه ينبغي لك تصميم حالات قابلة للتعافي من انتهاء المهلة، وغياب الإجراء، والرفض، والتوقف في منتصف التنفيذ، قبل إدخال النموذج في حلقة التحكم.
أسعار Fable 5.2: احسب التكلفة قبل الدمج
تُحتسب الأسعار الرسمية لكل مليون رمز، وهي واردة في صفحة النموذج وملاحظات التحديث وصفحة الوضع السريع:
| بند الفوترة | Fable 5.2 | Opus 5.5 | GPT-6 Astra (سياق قصير) |
|---|---|---|---|
| الإدخال / الإخراج القياسي | $8 / $40 | $4 / $20 | $10 / $50 |
| قراءة الذاكرة المؤقتة | $0.20 | $0.20 | $1 (إدخال مخزّن مؤقتًا) |
| الكتابة إلى الذاكرة المؤقتة | 5 دقائق: $10، ساعة واحدة: $16 | متاح في الصفحة الرسمية، لكنه غير مذكور هنا | $12.5 |
| المعالجة المجمّعة | نصف السعر: $4 / $20 | نصف السعر أيضًا | غير مذكور هنا |
| الوضع السريع | $16 / $80 | $8 / $40 | — |
هناك نقاط أخرى يجدر الانتباه إليها. سعر Fable 5.2 أقل بنسبة 20% من Fable 5.1 ($10 / $50). لا تتغير قدرات الوضع السريع، وتصل سرعة الإخراج فيه إلى 2.5 ضعف سرعة الوضع القياسي، لكن السعر الرسمي لا يذكر على نحو منفصل تكلفة الذاكرة المؤقتة في الوضع السريع. وبالحساب التقديري وفقًا لمضاعف السعر، تبلغ تكلفة قراءة الذاكرة المؤقتة نحو $0.40، والكتابة إليها لمدة 5 دقائق نحو $20، ولمدة ساعة واحدة نحو $32. ولا تتشارك أوضاع السرعة المختلفة ذاكرة الموجه المؤقتة؛ لذا فإن التبديل من الوضع السريع إلى القياسي يؤدي إلى عدم إصابة الذاكرة المؤقتة. أما GPT-6 Astra، فعندما يتجاوز الإدخال 272K رمز، تُحتسب تكلفة الطلب كاملًا بمضاعف 2 للإدخال و1.5 للإخراج.
تتطلب حلقة الروبوت إرسال صورة جديدة في كل خطوة، في حين يظل موجه النظام والتعليمات الخاصة بالإجراءات السابقة ثابتة إلى حد كبير. يناسب هذا النوع من البنية خفض التكلفة باستخدام الذاكرة المؤقتة، لكن لا يمكن توفير تكلفة إدخال الصور في كل خطوة أو رموز التفكير.
هل يمكن استخدام Fable 5.2 الآن؟ حالة توفره على APIYI
حتى 2026-11-10، لا يظهر claude-fable-5-2 ولا أي طراز من Mythos في القائمة الإجمالية للنماذج أو واجهة الأسعار العامة على APIYI apiyi.com. نعمل على إتاحة هذا النموذج في أقرب وقت. يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة الطرازات والأسعار. وقبل إتاحته، لن نذكر سعر Fable 5.2 على APIYI، ولن نحسب السعر الرسمي باستخدام مضاعف مجموعة الرموز.
في ذلك اليوم، كانت الطرازات ذات الصلة التالية متاحة للاستخدام ضمن القائمة الإجمالية على APIYI (الأسعار المدرجة بالدولار لكل مليون رمز مميز):
| معرّف الطراز | الإدخال / الإخراج | قراءة الذاكرة المؤقتة | نقاط النهاية | الاستخدام الأنسب |
|---|---|---|---|---|
claude-opus-5-5، claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat، messages | بناء حلقة استدعاء الأدوات والتحكم بالكمبيوتر أولًا |
claude-fable-5-1، claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat، messages | استخدامه خط أساس للمقارنة مع الجيل السابق |
claude-fable-5، claude-fable-5-thinking |
$10 / $50 | $1 | chat، messages | المقارنة مع الإصدارات السابقة |
gpt-6-astra |
$10 / $50 | $1 | responses (أساسي)، chat | المقارنة مع مزود آخر |
الأسعار في القائمة الإجمالية هي الأسعار المدرجة، أما التكلفة الفعلية فتُحتسب بعد ضربها في معامل مجموعة الرموز، ويُعتمد فيها على الفاتورة. لا تذكر الحاشية الخاصة بـ gpt-6-astra سوى شرائح أسعار الإدخال (10 دولارات لما يصل إلى 272,000 رمز مميز، و20 دولارًا من 272,001 إلى 1,050,000 رمز مميز). أما سعر الإخراج في سياق طويل فلم يُذكر؛ لذا يُرجى الرجوع إلى الفاتورة في لوحة التحكم. للاتصال، استخدم واجهة متوافقة مع OpenAI، واجعل قيمة base_url هي https://api.apiyi.com/v1.
النهج العملي هو البدء بـ claude-opus-5-5 لإعداد إدخال الصور وتحليل الإجراءات والتعافي من الإخفاقات، ثم استبدال معرّف الطراز للمقارنة بعد إتاحة Fable 5.2 على APIYI. الفارق في مهمة الروبوتات (25.5 نقطة) أكبر بكثير من الفارق في التحكم بالكمبيوتر (2.1 نقطة)، لذا هناك ما يبرر انتظار Fable 5.2، لكن مشاهدة مقاطع العرض التوضيحي وحدها لا تكفي لاتخاذ القرار.
تحليل مزايا وعيوب قدرات الروبوتات في Fable 5.2
المزايا
- قفزة كبيرة بين الأجيال: ارتفعت نتيجة RoboDojo Sim من 27.6% إلى 64.9%، وهي من أكبر التحسينات في جدول النتائج كله.
- تفوق واضح على النماذج المشابهة: يتقدم على Opus 5.5 بفارق 25.5 نقطة، وعلى GPT-6 Astra بفارق 35.1 نقطة (وفقًا للبيانات الواردة في منشور Anthropic).
- انخفاض السعر: السعر القياسي أقل بنسبة 20% من سعر الإصدار 5.1، وتبلغ تكلفة قراءة البيانات المخزنة مؤقتًا $0.20.
- اتساق في معالجة المدخلات المرئية: يدعم إدخال الصور ونافذة سياق بسعة 1M، ما يتيح استيعاب سجل مرئي طويل متعدد الخطوات.
القيود
- الأدلة محدودة: تستند النتيجة إلى تشغيل داخلي وبأعلى مستوى من الجهد؛ ولم يُعثر على الرقم نفسه في لوحة نتائج عامة، كما لم تُجرَ إعادة اختبار مستقلة.
- البيانات تقتصر على المحاكاة: لا يذكر الفيديو التوضيحي معدل النجاح، كما أن ادعاء «التفوق على معظم أنظمة الروبوتات المتخصصة» لا يرفق قائمة بهذه الأنظمة.
- قيود متعددة على حلقة التشغيل: لا يخرج النموذج إلا نصًا، ولا يمكن فرض استدعاء الأدوات عليه، ولا يمكن إيقاف التفكير، ونادرًا ما يوضح خطواته من تلقاء نفسه في سلاسل التنفيذ الطويلة.
- تكلفة مرتفعة عند أعلى مستوى: تستند النتيجة إلى أعلى مستوى من الجهد، لذا عليك قياس زمن الاستجابة واستهلاك الرموز بنفسك عند النشر الفعلي.
متى لا ينبغي أن تعتمد على هذه النتيجة لتبديل النموذج؟
إذا لم تكن لديك بيئة محاكاة خاصة بك أو حلقة تشغيل على روبوت فعلي، فلن تكون نسبة 64.9% قابلة للتحقق بالنسبة إليك، لأنك لن تتمكن من التأكد من انطباقها على إعداداتك. وإذا كانت احتياجاتك تتعلق بالأمن السيبراني أو المجالات الحيوية أو البرمجة اليومية، فلن تثبت هذه النتيجة شيئًا عن أداء النموذج فيها؛ بل عليك الرجوع إلى الاختبارات الخاصة بهذه المجالات. وتوصية منشور الإصدار نفسه هي أن يبدأ معظم المستخدمين في مهام البرمجة والمعرفة بـ Opus 5.5، ثم ينتقلوا إلى نموذج أعلى أو أدنى بحسب مستوى الصعوبة.
الأسئلة الشائعة
س1: هل نسبة 64.9% التي حققها Fable 5.2 واردة في لوحة النتائج العامة؟
لا. توضح الحاشية في إعلان الإطلاق أن هذه نتيجة حصلت عليها Anthropic في اختبار داخلي. أما RoboDojo فهو معيار تقييم عام، لكن حتى 2026-11-10 لم نتمكن من التحقق من ظهور النسبة نفسها في لوحة النتائج العامة.
س2: هل حقق Fable 5.2 نسبة 64.9% عند مستوى الجهد الافتراضي؟
لا، بل حققها عند أعلى مستوى جهد متاح. المستوى الافتراضي في Claude API هو high، بينما المستوى الافتراضي في تطبيق Claude وClaude Code هو Medium. ولم يذكر إعلان الإطلاق النتيجة عند المستوى الافتراضي.
س3: هل تفوق Fable 5.2 على أنظمة مخصصة للروبوتات؟
ذكر إعلان الإطلاق أنه تفوق على «معظم الأنظمة المصممة خصيصًا للتحكم في الروبوتات»، لكنه لم يرفق قائمة بها. لذلك لا نعرف حاليًا الأنظمة التي تفوق عليها بالتحديد.
س4: لماذا لا تظهر نتيجة Gemini 4 Carbon على RoboDojo؟
الخانة المقابلة له في جدول إعلان الإطلاق فارغة، ولم يوضح الإعلان السبب. لا يعني ذلك أن نتيجته صفر، ولا يمكن استنتاج أدائه من هذه الخانة الفارغة.
س5: كيف يمكن الاستعداد الآن لاستخدامه عبر API؟
حتى 2026-11-10، لم تدرج APIYI apiyi.com النموذج `claude-fable-5-2` بعد، وسنطرحه في أقرب وقت. يُرجى الرجوع إلى قائمة النماذج في المنصة لمعرفة اسم النموذج وسعره. يمكنك البدء باستخدام `claude-opus-5-5` المتاح حاليًا لاختبار مسار إدخال الصور واستدعاء الأدوات، ثم التبديل إلى النموذج الجديد ومقارنة النتائج بعد طرحه.
س6: هل تثبت الأجهزة الإلكترونية الثلاثة أنه قادر على التحكم في الروبوتات؟
لا. فالمساعد الصوتي ومكبر الصوت USB المزود بهاتف والحيوان الأليف الافتراضي هي تجارب لتصميم الأجهزة بالتعاون مع Diode، وهي تتعلق بقدرات تصميم الدوائر، ولا ترتبط بنتائج التحكم بذراعي الروبوت على RoboDojo.
س7: هل ينبغي لوكلاء التحكم في الكمبيوتر انتظار Fable 5.2؟
ليس هناك داعٍ كبير لذلك. حقق Fable 5.2 نسبة 89.3% على OSWorld 2.1، مقابل 87.2% لـ Opus 5.5، أي بفارق 2.1 نقطة فقط، في حين أن السعر القياسي لـ Opus 5.5 لا يتجاوز نصف سعر Fable 5.2.
أبرز النقاط حول قدرات الروبوتات في Fable 5.2
- دلالة النتيجة: تمثل نسبة 64.9% أداءً لمحاكاة ذراعين، ضمن تشغيل داخلي وبأعلى مستوى من الجهد.
- حجم الفارق: يتقدم على Opus 5.5 بفارق 25.5 نقطة، وعلى GPT-6 Astra بفارق 35.1 نقطة.
- المقارنة المرجعية: لا يتقدم سوى بنقطتين على OSWorld؛ ولا ينبغي الخلط بين نوعَي الفارق.
- طبيعة العروض التوضيحية: حل مكعب روبيك وفتح أغطية الزجاجات والرسم أمثلة توضيحية وردت في منشور الإطلاق، وليست مهارات جاهزة للاستخدام في المنتجات.
- قيود حلقة التشغيل: يقتصر الإخراج على النص، ويؤدي فرض
tool_choiceإلى استجابة 400، ولا يمكن إيقاف التفكير. - حالة الإتاحة: حتى 2026-11-10، لم يُدرج النموذج بعد على APIYI. ويمكنك البدء باستخدام
claude-opus-5-5لبناء حلقة التشغيل.
الخلاصة
يمثل التقدم الذي أحرزه Claude Fable 5.2 في التحكم بالروبوتات إشارة ملموسة؛ إذ ارتفعت نتيجته في RoboDojo Sim من 27.6% في الجيل السابق إلى 64.9%، متقدمًا بوضوح على النماذج التي قارنت Anthropic بينها. لكن نطاق انطباق هذه النتيجة محدود جدًا: فهي تخص بيئة محاكاة وتشغيلًا داخليًا وأعلى مستوى من الجهد، ولا تشمل معدل النجاح على الروبوتات الفعلية، ولا تعكس القدرة على التسليم في المصانع.
إذا كانت لديك بالفعل حلقة تشغيل خاصة بالمحاكاة أو بالروبوتات الفعلية، فمن المفيد إجراء مقارنة باستخدام Fable 5.2 بعد إتاحته. واحرص مسبقًا على تصميم نظامك بما يراعي قيود تحليل المخرجات النصية، وتعذّر فرض استدعاء الأدوات، وعدم إمكانية إيقاف التفكير. أما إذا لم تكن لديك حلقة تشغيل، أو كانت مهمتك تتعلق بكتابة الشيفرات أو استخدام الحاسوب، فلا داعي لتغيير نهجك الحالي بسبب نتيجة 64.9%.
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com. ويُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة حالة إتاحة النموذج.


