
Примечание автора: в этой статье мы сознательно разбираем по отдельности официально заявленные результаты GPT-6.2 Astra и независимые данные Artificial Analysis, а затем по четырём типам задач — профессиональные документы, наука, код и 3D, кибербезопасность — решаем, стоит ли доверять модели ваши самые сложные задачи.
17 ноября 2026 года OpenAI официально выпустила GPT-6.2 Astra и GPT-6.2 Sol. В официальном посте модели названы «суперэффективными и созданными для задач реального мира». Одновременно вышли анонс, системная карта и страницы обеих моделей в каталоге API, а Artificial Analysis в тот же день опубликовала собственное независимое тестирование. Границы возможностей GPT-6.2 Astra теперь можно перепроверить сразу по нескольким источникам.
Это не рекламная статья в духе «первые во всём». По сводному индексу Artificial Analysis GPT-6.2 Astra занимает не первое место. Её результаты заметно меняются в зависимости от выбранного уровня Reasoning. А в кибербезопасности всё наоборот: из-за более строгих защитных механизмов модель отклоняет даже часть легитимных запросов. Официальные и сторонние цифры в этой статье поданы раздельно — мы не смешиваем их в один общий вывод.
Главная ценность: дочитав статью, вы сможете понять, какие доказательства есть у GPT-6.2 Astra по каждой из четырёх категорий — подготовка профессиональных документов, научные задачи в терминале, код и 3D, кибербезопасность — и почему один сводный балл не заменяет детальный разбор по пунктам.
Ключевые моменты GPT-6.2 Astra
Начнём со сводной таблицы для быстрого чтения. Для каждой строки указан источник данных — при чтении обращайте на него внимание.
| Пункт | Суть | Источник данных | Что это значит для вас |
|---|---|---|---|
| Профессиональные задачи | Длительные профессиональные рабочие процессы, юридические задачи и GDPval v2 — улучшения по сравнению с GPT-6 Astra, причём при меньших затратах | Официальные данные (самоотчёт) | Стоит попробовать в первую очередь для документоориентированных многошаговых задач |
| Наука в терминале | Terminal-Bench-Science 0.1 — на 9 процентных пунктов выше, чем у GPT-6 Astra | Официальные данные; AA также называет модель лидером | Для сценариев, где нужно запускать научные пайплайны в терминале, есть подтверждающие данные |
| Код и 3D | Индекс кодинг-агентов наравне с GPT-6 Astra, Elo 1318 в слепом сравнении AA-3D | Независимый тест AA / пересказ официальных данных | В коде рывка нет, зато 3D-генерация радует |
| Итоговый балл зависит от уровня рассуждений | Max и Xhigh — 62, High — 60, Medium — 57, Low — 46 | Независимый тест AA | Снижая уровень, вы экономите, но и балл падает |
| Кибербезопасность | Уровень «критический» в Preparedness Framework, часть легальных исследований уязвимостей будет отклоняться, Daybreak ещё не подключён к 6.2 | Официальная системная карта и релизный документ | Командам по исследованию безопасности стоит заранее предусмотреть запасные варианты |
Что учесть перед чтением о GPT-6.2 Astra
Большинство результатов в официальном релизе — это относительные значения: например, «на 5,2 балла выше, чем GPT-6 Astra» или «затраты — менее одной трети». Для многих бенчмарков абсолютные баллы не приводятся. В таких случаях эта статья лишь пересказывает соотношения и не додумывает цифры.
Artificial Analysis (далее — AA) — независимая третья сторона. Их сводный индекс построен на другом наборе задач, а баллы к тому же привязаны к уровню рассуждений. Когда разработчики говорят, что «затраты составляют около 5% от конкурента», а на странице AA указана стоимость одной задачи — это разные методики, и одну цифру нельзя напрямую делить на другую или пересчитывать.
Ключевые возможности GPT-6.2 Astra: разбираем четыре категории задач по отдельности
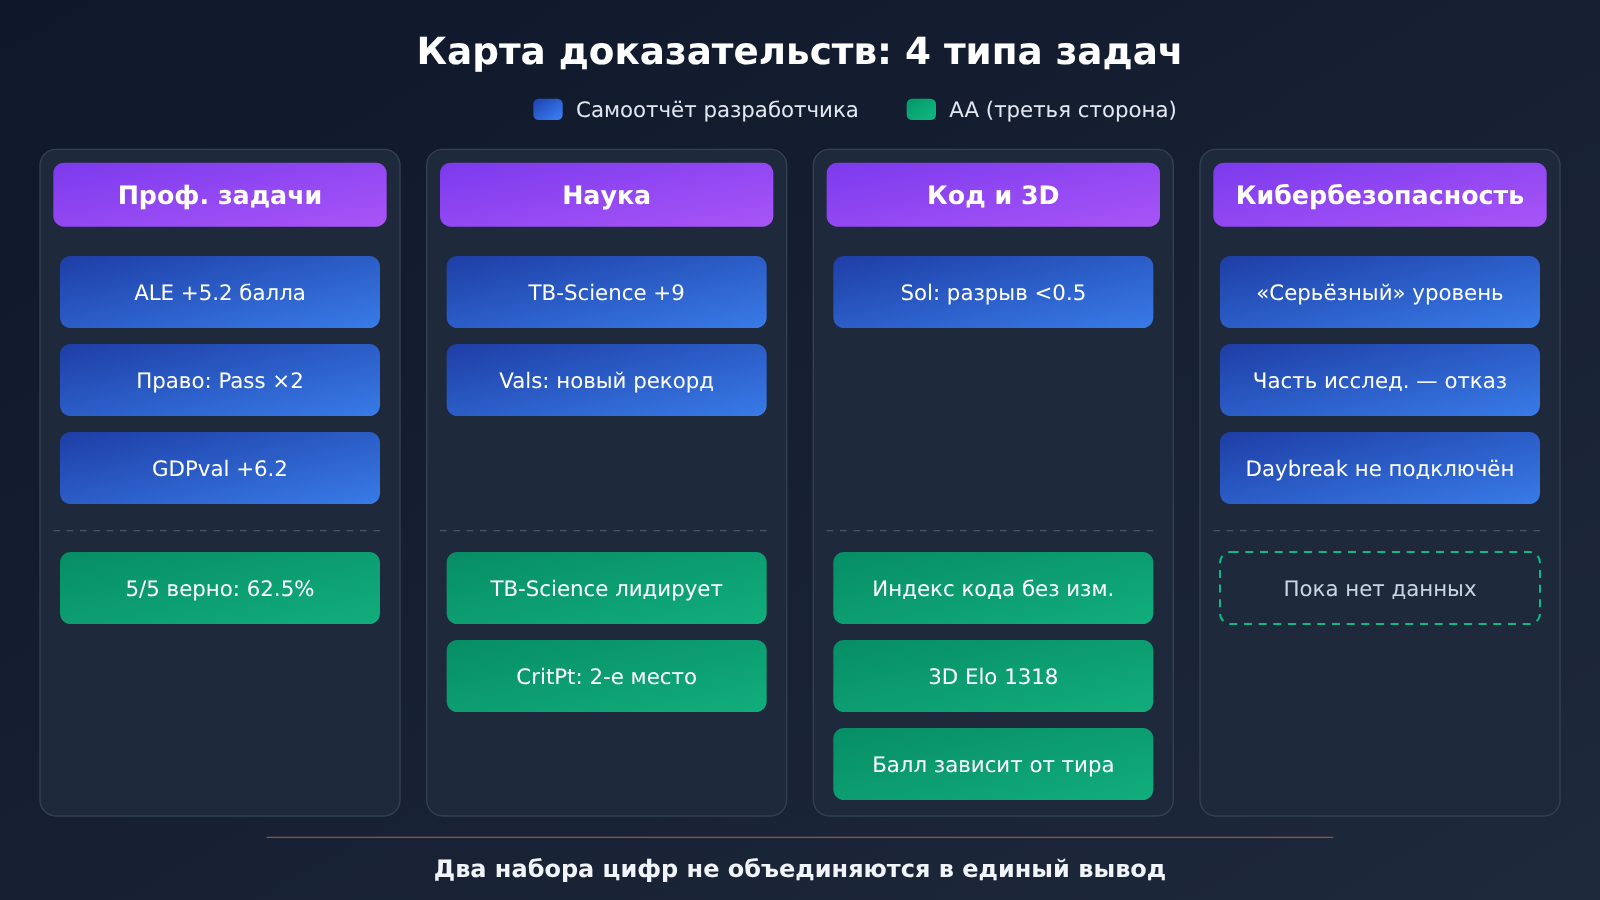
Возможности GPT-6.2 Astra в профессиональных задачах (в основном по самоотчётам разработчика)
Профессиональным задачам в этом анонсе уделено больше всего внимания. На бенчмарке Agents’ Last Exam, который проверяет длинные профессиональные рабочие процессы, GPT-6.2 Astra по данным разработчика обходит GPT-6 Astra на 5,2 балла, а её стоимость — менее трети от стоимости GPT-6 Astra. На том же бенчмарке она опережает Claude Fable 5.2 на 5,5 балла, и её затраты составляют около 5% от затрат Claude Fable 5.2. В сноске уточняется, что результат Fable 5.2 в таблице не включает девять задач, где она использовала резервную модель, — так что, цитируя это сравнение, не забудьте оговорить эту деталь.
Данные по юридическим сценариям взяты из Harvey LAB-AA v1.1. По официальным данным, показатель прохождения у GPT-6.2 Astra более чем вдвое выше, чем у Claude Fable 5.2, а стоимость — примерно шестая часть от её затрат. Ориентированная на юристов конфигурация «Astra for Law» покажет ещё более высокие цифры. В релизном посте абсолютный показатель прохождения не приводится, поэтому здесь можно подтвердить только относительное преимущество — насколько модель надёжна на юридических задачах в абсолютном выражении, судить нельзя.
На внутреннем бенчмарке GDPval v2 GPT-6.2 Astra опережает GPT-6 Astra на 6,2 процентного пункта и при этом расходует на 22% меньше выходных токенов. Разработчик также ссылается на результаты AA-AnalystAgent: во всех пяти независимых попытках GPT-6.2 Astra правильно ответила на 62,5% вопросов. Этот показатель измеряет именно стабильность, а не разовую точность, поэтому для аналитических задач, где нужны воспроизводимые результаты, он особенно информативен.
Возможности GPT-6.2 Astra в научных задачах (официальные самоотчёты + сторонние данные AA)
В научном направлении есть два источника, которые подтверждают друг друга. По официальным данным, на Terminal-Bench-Science 0.1 GPT-6.2 Astra обходит GPT-6 Astra на 9 процентных пунктов, при этом стоит меньше трети. На Vals Science Index разработчики заявляют о новом рекорде, но абсолютный балл не раскрывают.
Со стороны третьих лиц картина похожая: в статье AA также прямо сказано, что GPT-6.2 Astra лидирует на Terminal-Bench-Science 0.1. А вот на сложном подмножестве CritPt v2 она уступает лишь Claude Fable 5.2. Отсюда видно, что в науке полного доминирования нет: научные рабочие процессы в терминале — её сильная сторона, но в тяжёлых задачах с упором на теоретические выкладки всё ещё находятся соперники посильнее.
Здесь есть подводный камень, о который легко споткнуться. Согласно официальной сноске, один из результатов Fable 5.2 на Terminal-Bench-Science взят от AA и получен с помощью mini-swe-agent, тогда как Anthropic отдельно отчитывается: Fable 5.2 в Claude Code с интенсивностью рассуждений Max показывает 74,6%. Эти две цифры для Fable получены в разных тестовых конфигурациях, и считать их частью одного сравнения нельзя.
Возможности GPT-6.2 Astra в коде и 3D (независимые бенчмарки AA + официальные пересказы)
Доказательства по коду довольно сдержанные. Coding Agent Index от AA (Codex harness, режим max) показывает, что GPT-6.2 Astra идёт вровень с GPT-6 Astra — то есть заметного скачка в кодинг-агентах у этого поколения не произошло.
FrontierCode 2.0 измеряет, будут ли изменения в реальных кодовых базах смержены мейнтейнерами. Настоящий герой этого бенчмарка — Sol: по официальным данным, GPT-6.2 Sol отстаёт от GPT-6.2 Astra менее чем на 0,5 балла, а стоит при этом примерно в пять раз дешевле; обе модели работали в режиме Max. Этот вывод говорит об отличном соотношении цены и результата у Sol, но его нельзя читать как дополнительное преимущество Astra в FrontierCode.
В направлении 3D-генерации официальные источники пересказывают Elo слепой оценки людьми по AA-3D: GPT-6.2 Astra — 1318, Claude Fable 5.2 — 1271, GPT-6.2 Sol — 1259. В исследовательском превью AA-Robotics v0.1 результаты такие: Astra — 79, Sol — 78, Fable 5.2 — 75. 3D и робототехника — одни из немногих конкретных направлений, где Astra впереди, но Robotics пока находится на стадии исследовательского превью, так что преувеличивать вес этого результата не стоит.
Кроме того, уровень галлюцинаций в AA-Omniscience (режим Max) составляет 59% у GPT-6.2 Astra и 55% у Sol. Если занимаетесь код-ревью или фактчекингом, эти цифры напоминают: без внешней перепроверки всё ещё не обойтись.
Кибербезопасность и выравнивание GPT-6.2 Astra (официальная системная карта)
Согласно системной карте, и GPT-6.2 Astra, и Sol достигли уровня «критический» по кибербезопасности и «высокого» по биологии и химии в рамках Preparedness Framework (рамки готовности). GPT-6.2 Astra — к тому же первая, по официальным данным, публично выпущенная модель, преодолевшая высокий порог по категории «самоулучшение ИИ». В анонсе это отметили только для Astra — про Sol ничего подобного не написано.
С ростом уровней возможностей ужесточились и меры защиты. Разработчики честно признают: часть легитимных исследований уязвимостей будет отклоняться. Daybreak, созданный для защитников, пока предлагает Alpha-версию GPT-6 Astra, GPT-6 Sol на Daybreak Blue и GPT-6 Cyber на Daybreak Red. Официально обещают постараться добавить 6.2 в Daybreak, но на данный момент Daybreak всё ещё не поддерживает 6.2.
По части выравнивания (alignment) большинство оценок близки к показателям GPT-6 Astra, а неуместных действий в смоделированных рабочих сценариях стало меньше. Правда, в двух тестах модель чаще «не замечала» блокирующие проблемы — скажем, отсутствующий файл или недоступный поисковый инструмент. После добавления соответствующих инструкций в Codex такие пропуски заметно сократились. Если вы выстраиваете Agent-процессы, стоит прямо в системных инструкциях потребовать от модели сообщать о блокерах.
GPT-6.2 Astra: сводка доказательств по четырём типам задач
| Тип задач | Ключевые доказательства | Источник | Сила вывода |
|---|---|---|---|
| Профессиональные задачи | На ALE выше GPT-6 Astra на 5.2 балла; на Harvey процент прохождения вдвое выше, чем у Fable 5.2; на GDPval v2 выше на 6.2 п.п. | Официальный самоотчёт | Относительное преимущество ясно, абсолютных баллов у большинства нет |
| Наука | Terminal-Bench-Science 0.1 выше на 9 п.п.; по данным AA, тоже впереди; на CritPt v2 — второе место на сложном подмножестве | Официальный самоотчёт + AA | Сильна в «терминальной» науке, в сложных теоретических задачах есть соперники |
| Код | Coding Agent Index — наравне с GPT-6 Astra | Независимый тест AA | Скачка между поколениями нет |
| 3D | AA-3D: Elo 1318 — выше, чем у Fable 5.2 и Sol | Данные AA в официальном пересказе | Лидерство в отдельной дисциплине |
| Кибербезопасность | Уровень «Severe» (критический); легитимные исследования уязвимостей могут отклоняться; Daybreak не подключён к 6.2 | Официальная системная карта | Возможности мощные, но применимость ограничена |
Данные тестирования GPT-6.2 Astra: как меняется общий балл в зависимости от уровня рассуждений
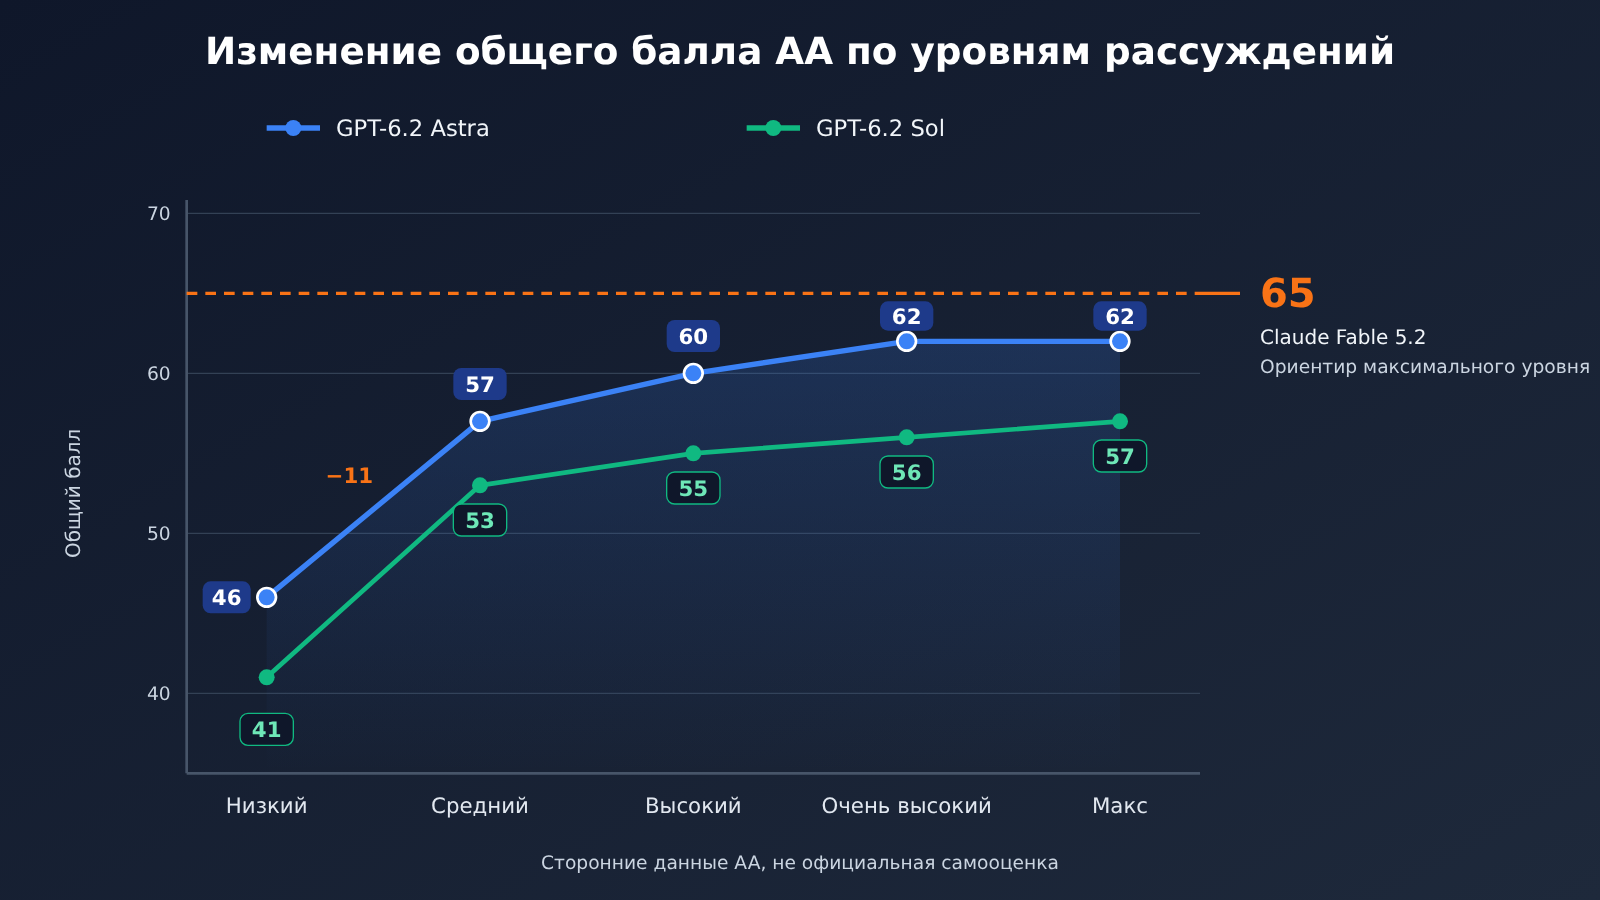
Intelligence Index v5.0.1 от AA — самая цитируемая на сегодня сторонняя комплексная оценка. На максимальном уровне рассуждений Claude Fable 5.2 занимает первое место с 65 баллами. GPT-6.2 Astra на уровнях Max и Xhigh набирает 62 балла — это больше, чем 60 у Gemini 4 Carbon и 59 у Claude Opus 5.5 на их максимальных уровнях, и на 5 баллов выше, чем у GPT-6 Astra.
По-настоящему важно другое — насколько сильно результат зависит от уровня рассуждений. Вся таблица ниже построена на сторонних данных AA:
| Уровень рассуждений | GPT-6.2 Astra | GPT-6.2 Sol | Примечание |
|---|---|---|---|
| Max | 62 | 57 | У Astra баллы Max и Xhigh совпадают |
| Xhigh | 62 | 56 | На этом уровне Astra ещё не теряет баллов |
| High | 60 | 55 | Минус 2 балла |
| Medium | 57 | 53 | Medium у Astra равен Max у Sol |
| Low | 46 | 41 | Обвальное падение |
С Max до Low GPT-6.2 Astra теряет 16 баллов, причём только при переходе с Medium на Low — сразу 11. Если ради экономии опустить уровень рассуждений до Low, вы получите уже не «Astra с 62 баллами». Выбирать модель только по максимальному баллу в рейтинге — верный способ переоценить её реальную эффективность в работе.
Данные по стоимости тоже считаются по методике AA. Стоимость одной задачи в комплексном индексе: GPT-6.2 Astra (Max) — $4.00, GPT-6.2 Sol (Max) — $1.01, а на странице Claude Fable 5.2 указано $26.54. Это стоимость именно для набора задач AA, и её нельзя напрямую пересчитывать вместе с официальным заявлением «стоимость ALE составляет около 5% от Fable 5.2».
Спецификации и официальные цены GPT-6.2 Astra
Спецификации и цены сверяйте со страницей модели OpenAI. ID модели — gpt-6.2-astra: на вход принимает текст и изображения, на выходе отдаёт текст, аудио и видео не поддерживаются. Контекстное окно — 1,050,000 токенов, максимальный ввод — 922,000, максимальный вывод — 128,000, срез знаний — 2026-05-18, reasoning-токены поддерживаются. API не принимает значение none для параметра reasoning effort.
| Параметр | Официальное значение GPT-6.2 Astra (за 1 млн токенов) |
|---|---|
| Ввод (стандартный тариф для короткого контекста) | $8 |
| Чтение из кэша | $0.40 |
| Запись в кэш (хранение 30 минут) | $10 |
| Запись в кэш (хранение 12 часов) | $20 |
| Вывод | $40 |
| Поддерживаемые эндпоинты | Chat Completions, Responses, Batch |
Выше приведены официальные цены OpenAI. Модель gpt-6.2-astra пока недоступна на APIYI — мы добавим её в ближайшее время; актуальные модели и цены смотрите в списке моделей платформы. Если коротко, из анонса релиза: ввод и вывод на 20% дешевле, чем у GPT-6 Astra, а кэшированный ввод — на 60% дешевле.
В правилах тарификации есть ещё несколько нюансов. Если ввод в рамках одного запроса превышает 272K токенов, цены на ввод и кэш удваиваются, а вывод считается по полуторному тарифу короткого контекста (×1.5) — причём расчёт идёт по всему запросу целиком. Batch стоит 50% от стандартной цены, Fast — 2× стандартной цены при том же объёме контекста. Ultrafast до 2027-02-28 (тихоокеанское время) обходится в 3× стандартной цены, а с 2027-03-01 — уже 6×.
Для сравнения: официальные цены GPT-6.2 Sol — ввод $2, чтение из кэша $0.10, вывод $10. Модель gpt-6.2-sol на APIYI тоже пока недоступна — мы добавим её в ближайшее время; актуальные модели и цены смотрите в списке моделей платформы.
Проверять наличие моделей удобно сразу в двух местах: сводная таблица моделей APIYI на apiyi.com (docs.apiyi.com/models.md) и эндпоинт с ценами https://api.apiyi.com/api/pricing. По данным сводной таблицы на 2026-11-17 15:54 (UTC+8), ни там, ни там моделей gpt-6.2-astra и gpt-6.2-sol пока нет. Уже представленная в таблице gpt-6-astra — это модель предыдущего поколения, и её цена на платформе не может служить ориентиром для цен 6.2.
Быстрый старт с GPT-6.2 Astra: сначала выбираем задачу, потом уровень рассуждений
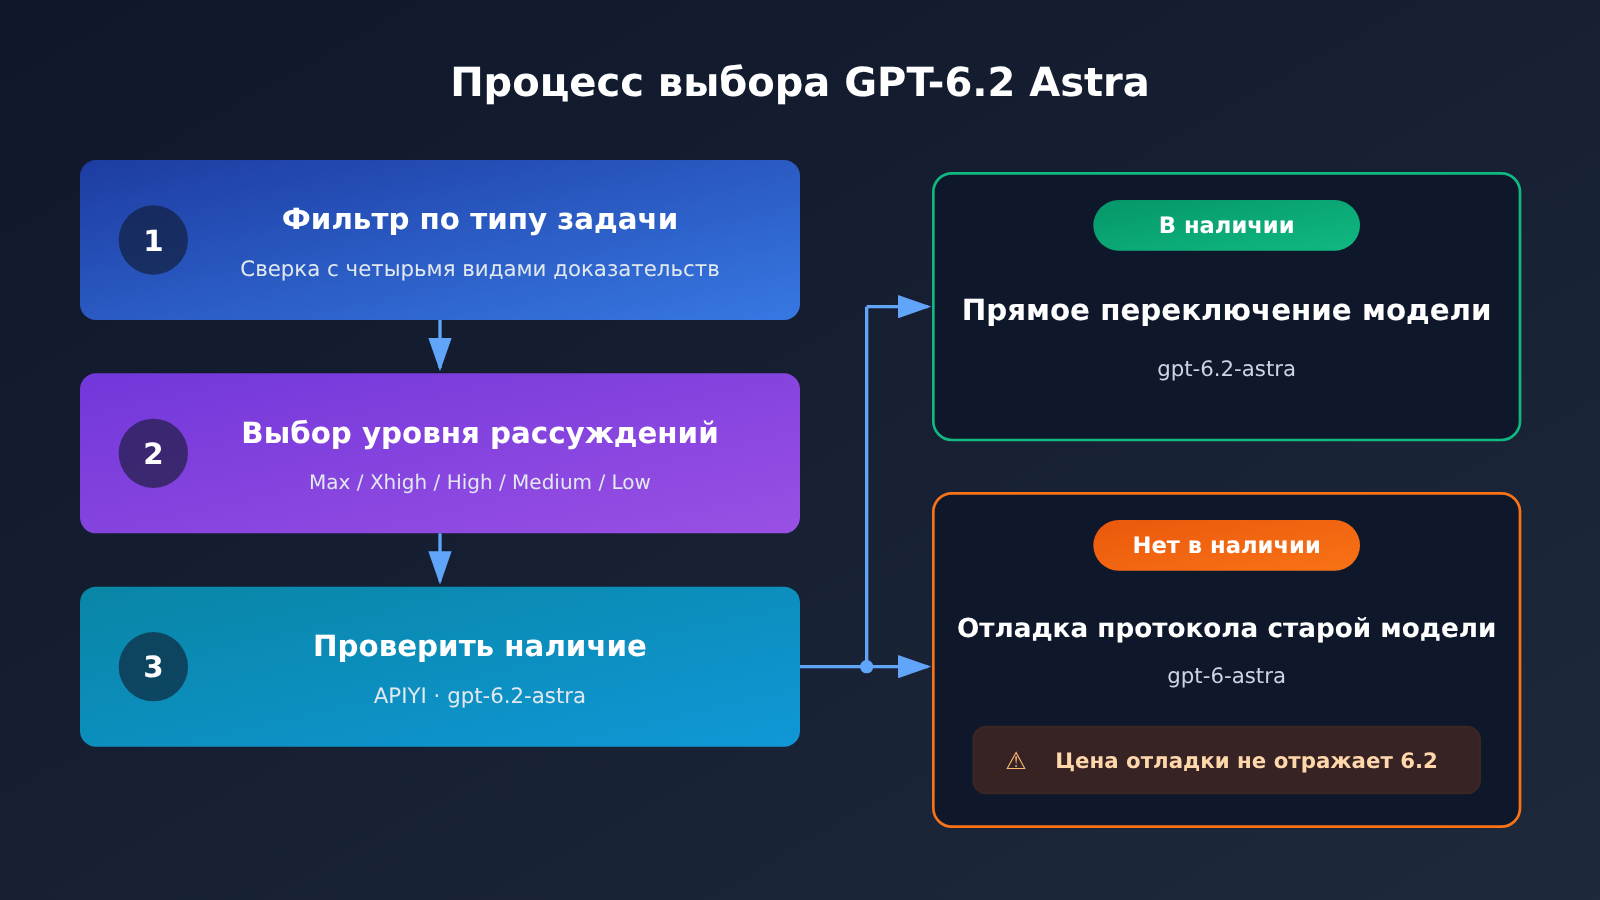
Прежде чем доверить GPT-6.2 Astra сложную задачу, рекомендуем оценивать её в таком порядке:
- Сначала — по типу задачи. Сверьтесь с четырьмя категориями доказательств, о которых шла речь выше. Для сдачи профессиональных документов или научных процессов в терминале у Astra есть довольно чёткие официальные подтверждения; если задача в основном связана со слиянием кода, сначала оцените, справится ли Sol; а для исследования уязвимостей будьте готовы к тому, что часть запросов отклонят.
- Потом — уровень рассуждений. Помните про разброс результатов в AA: Max и Xhigh — 62, High — 60, Medium — 57, Low — 46. Если важно экономить, начните с High или Medium и сравните результаты в A/B-тесте; сразу брать Low для сложных задач не советуем.
- И напоследок — список моделей платформы. Откройте список моделей на APIYI (apiyi.com) и поищите
gpt-6.2-astra. Если модель уже в наличии, просто замените поле model в запросе на это имя.
Если 6.2 в списке пока нет, можно сначала провести отладку протокола на уже доступной gpt-6-astra: укажите в OpenAI-совместимом клиенте base_url равным https://api.apiyi.com/v1, впишите в model значение gpt-6-astra и проверьте структуру запросов Chat Completions или Responses, стриминговый вывод и параметры рассуждений. Важно понимать: на этом шаге вы проверяете только протокол интерфейса — во время отладки действует цена gpt-6-astra, а не 6.2, и результаты не отражают возможности 6.2.
При отладке стоит заранее уточнить несколько параметров: reasoning effort нельзя передавать как none; для длинных входных данных учитывайте порог 272K, после которого стоимость всего заказа удваивается; если планируете пакетные офлайн-задачи, оцените половинную цену Batch. Когда 6.2 появится на платформе, всё это можно будет использовать без изменений.
🚀 Совет для старта: APIYI (apiyi.com) предоставляет OpenAI-совместимый интерфейс — одного API-ключа хватает для вызова моделей разных провайдеров, а новым пользователям доступен бесплатный тестовый лимит. Рекомендуем сначала отладить всю цепочку запросов на доступных моделях: когда появится 6.2, для переключения достаточно будет поменять только имя модели.
Рекомендации по выбору задач для GPT-6.2 Astra
| Тип задачи | Стоит ли ставить Astra в приоритет | Стартовый уровень рассуждений | На что обратить внимание |
|---|---|---|---|
| Долгосрочная подготовка профессиональных документов | Да | Начинайте с High, для ключевых результатов — Max | Официальные сравнения — в основном относительные значения |
| Научные задачи в терминале | Да | High или Xhigh | В сложных теоретических вопросах могут найтись более сильные конкуренты |
| Правки со слиянием кода | Сначала оцените Sol | Выбирайте по бюджету | Coding Agent Index рывка не показал |
| Генерация 3D | Можно | Подбирайте по качеству результата | AA-3D — это Elo слепой оценки, цифра приводится по официальным источникам |
| Исследование уязвимостей | С осторожностью | Неприменимо | Модель может отклонять запросы, Daybreak пока не поддерживает 6.2 |
Стартовые уровни рассуждений в таблице — это наши рекомендации на основе разрыва в баллах AA, а не официальные значения. Перед выводом в продакшн обязательно сравните модель на собственных примерах задач.
Анализ плюсов и минусов GPT-6.2 Astra
Преимущества
- Много подтверждений в профессиональных задачах: ALE, Harvey LAB-AA, GDPval v2, AA-AnalystAgent — несколько официально заявленных метрик указывают в одну сторону, причём почти всегда со снижением затрат.
- Научные задачи в терминале подтверждены двумя источниками: и официальные данные, и сторонний бенчмарк AA показывают лидерство на Terminal-Bench-Science 0.1.
- Снижение удельных затрат: официальные цены ниже, чем у GPT-6 Astra, — на 20% за ввод и вывод и на 60% за кэшированный ввод; на GDPval v2 выходных токенов к тому же на 22% меньше.
- Длинный контекст и большой объём вывода: 1 050 000 токенов контекста и 128 000 максимального вывода — удобно обрабатывать целые материалы за один проход.
Ограничения
- По общему баллу — не первый: на максимальном уровне AA у Claude Fable 5.2 — 65 баллов, у GPT-6.2 Astra — 62. Если в вашем сценарии нужна максимальная универсальность, сначала проведите сравнительное тестирование.
- Чувствительность к уровню рассуждений: на уровне Low — всего 46 баллов. Прежде чем понижать уровень, обязательно прогоните регрессионные тесты на своих задачах.
- В коде нет скачка между поколениями: Coding Agent Index в AA на уровне GPT-6 Astra; для правок со слиянием кода сначала оцените более дешёвый Sol.
- Ограничения в исследованиях безопасности: часть легитимных исследований уязвимостей будет отклонена, а 6.2 в Daybreak пока недоступна. Командам безопасности пока приходится оставаться на серии GPT-6 в Daybreak.
- Может умалчивать о блокерах: в двух тестах модель чаще не сообщала о проблемах вроде отсутствующих файлов или недоступных инструментов — в агентских процессах явно требуйте от неё отчёта о блокерах.
- Уровень галлюцинаций немаленький: в AA-Omniscience (Max) он достигает 59%, поэтому факты в ответах всё равно нужно проверять внешними источниками.
Часто задаваемые вопросы (FAQ)
Q1: Что такое GPT-6.2 Astra?
GPT-6.2 Astra — модель, выпущенная OpenAI 2026-11-17 одновременно с GPT-6.2 Sol; её идентификатор — `gpt-6.2-astra`. Модель принимает на вход текст и изображения и выдаёт текст, контекстное окно — 1,050,000 токенов. Она доступна в ChatGPT Work, Codex и через OpenAI API.
Q2: GPT-6.2 Astra — сейчас самая сильная модель?
Однозначно так сказать нельзя. По стороннему сводному индексу AA в высшей категории Claude Fable 5.2 набирает 65 баллов, а GPT-6.2 Astra — 62. По отдельным направлениям — профессиональные задачи, научная работа в терминале, 3D — есть данные, что модель лидирует, но индекс код-агентов остался на уровне предыдущего поколения, поэтому оценивать нужно по каждой задаче отдельно.
Q3: Почему у одной и той же GPT-6.2 Astra разные баллы?
Потому что баллы AA привязаны к уровню рассуждений: Max и Xhigh — 62, High — 60, Medium — 57, Low — 46. Чем ниже уровень рассуждений, тем меньше расход ресурсов и тем ниже балл. При цитировании балла обязательно указывайте уровень рассуждений.
Q4: Подходит ли GPT-6.2 Astra для исследования уязвимостей?
Стоит быть осторожным. По кибербезопасности модель получила уровень «критический», защита стала строже, и часть легитимных исследований уязвимостей будет отклоняться. Daybreak, ориентированная на защитников, пока не обновлена до 6.2 — официально сообщается лишь о планах её добавить.
Q5: Можно ли сейчас вызвать gpt-6.2-astra через APIYI?
По сводной таблице и интерфейсу цен на момент 2026-11-17 15:54 (UTC+8) модель gpt-6.2-astra ещё не добавлена — мы добавим её как можно скорее; актуальные модели и цены смотрите в списке моделей платформы. До этого момента можно провести отладку протокола на APIYI apiyi.com с уже доступной моделью `gpt-6-astra`. При этом тарифицироваться будет gpt-6-astra — это не цена версии 6.2.
Q6: Какова официальная цена GPT-6.2 Astra?
Официальные цены OpenAI за 1 млн токенов: вход — $8, чтение кэша — $0.40, запись в кэш на 30 минут — $10, выход — $40. Если вход в рамках одного запроса превышает 272K, цена всего запроса повышается. На APIYI модель пока не добавлена — мы добавим её как можно скорее; актуальные модели и цены смотрите в списке моделей платформы.
Q7: Какие у GPT-6.2 Astra известные недостатки?
Их четыре: заметное падение баллов на низких уровнях рассуждений; возможности код-агентов на уровне предыдущего поколения; доля галлюцинаций в AA-Omniscience (Max) — 59%; в части тестов модель склонна пропускать блокирующие проблемы вроде отсутствующих файлов или недоступных инструментов. Первые три пункта можно смягчить выбором уровня рассуждений и внешней проверкой, а последний — явно потребовать в инструкции сообщать о блокирующих проблемах.
## GPT-6.2 Astra: ключевые выводы
— **Больше всего подтверждений в профессиональных задачах**: официальные данные разработчика по ALE, Harvey и GDPval v2 показывают рост качества при более низких затратах.
— **Научный терминальный бенчмарк подтверждён двумя источниками**: и официальные данные разработчика, и независимые результаты AA показывают лидерство в Terminal-Bench-Science.
— **В коде рывка нет**: по AA Coding Agent Index модель на уровне GPT-6 Astra, а лучшее соотношение цены и качества в FrontierCode — у Sol.
— **Общий балл зависит от уровня рассуждений**: баллы AA — Max/Xhigh: 62, High: 60, Medium: 57, Low: 46.
— **Сильная безопасность, но с ограничениями**: модель доходит до уровня «severe» (критического) и может отказывать в легальных исследованиях уязвимостей; Daybreak к 6.2 не подключён.
— **С чего начать**: сначала выберите модель под задачу, затем задайте уровень рассуждений и напоследок проверьте, есть ли она в списке моделей на APIYI (apiyi.com).
—
## Итоги
Ключевые тезисы о GPT-6.2 Astra:
1. **Сильные стороны по типам задач**: самые убедительные доказательства — для профессиональной подготовки документов и передовой науки, в 3D есть лидерство по отдельным показателям, а код держится на уровне предыдущего поколения.
2. **Баллы по уровням рассуждений**: сводный балл стороннего рейтинга AA падает с 62 на уровне Max до 46 на уровне Low — выбор уровня напрямую влияет на результат.
3. **Цифры по источникам**: самоотчёт OpenAI и сторонние данные AA — это две разные методики подсчёта; ни стоимость, ни баллы нельзя пересчитывать из одной системы в другую.
4. **Сценарии безопасности оценивайте отдельно**: защита стала строже, а Daybreak ещё не подключён к 6.2.
Если у вас на руках сложная задача, советуем сначала свериться с этими четырьмя типами доказательств и понять, попадает ли она в зону сильных сторон Astra, а затем сравнить уровни рассуждений между собой на собственных примерах.
До появления 6.2 в каталоге можно заранее отладить цепочку вызовов через APIYI (apiyi.com) на уже доступных моделях; когда модель выйдет, достаточно просто сменить её название в коде. Ориентируйтесь на актуальные цены в списке моделей на платформе.
—
## 📚 Источники
1. **Пост OpenAI о релизе**: официальное представление GPT-6.2 Astra и Sol и официально заявленные результаты
— Ссылка: `openai.com/index/introducing-gpt-6-2-astra-sol`
— Описание: относительные результаты и сводка цен по профессиональной подготовке документов, науке и коду
2. **Системная карта OpenAI**: уровни безопасности и оценка выравнивания
— Ссылка: `deploymentsafety.openai.com/gpt-6-2-astra-sol`
— Описание: уровень «критический» по кибербезопасности, высокий порог самосовершенствования ИИ, текущее состояние Daybreak
3. **Страница модели OpenAI**: характеристики и официальные цены
— Ссылка: `platform.openai.com/docs/models/gpt-6.2-astra`
— Описание: контекстное окно, эндпоинты, правила тарификации 272K, коэффициенты Batch/Fast/Ultrafast
4. **Обзорная статья Artificial Analysis**: сторонний сводный индекс и его составляющие
— Ссылка: `artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol`
— Описание: сводные баллы по каждому уровню рассуждений, Coding Agent Index, частота галлюцинаций, Robotics
5. **Страница модели Artificial Analysis**: стоимость одной задачи для GPT-6.2 Astra
— Ссылка: `artificialanalysis.ai/models/gpt-6-2-astra`
— Описание: методика расчёта стоимости одной задачи в сводном индексе
—
> **Автор**: техническая команда APIYI
> **Технические вопросы**: будем рады вашему обращению на главной странице официального сайта APIYI, подробности о моделях и подключении — в центре документации docs.apiyi.com


