
Короткий ответ: при идеальных условиях стандартное 30-минутное кэширование промптов OpenAI становится дешевле, чем работа без кэша, уже со 2-го использования, а 12-часовое кэширование — только с 3-го. Идеальные условия здесь такие: один и тот же фиксированный префикс один раз полностью записывается в кэш, все последующие запросы попадают в кэш, и повторных записей за это время нет. По официальной цене gpt-6-luna для стандартного тарифа с коротким контекстом, если фиксированный префикс на 10000 токенов используется всего 10 раз, 30-минутное кэширование экономит около 78,5% по сравнению с отсутствием кэширования, а 12-часовое — около 66%. Но это расчёт только для фиксированного префикса, а не скидка на весь запрос.
Что вы узнаете из этой статьи?
- Реальные условия попадания в кэш промптов и чем они отличаются от «семантического сходства».
- Как рассчитываются два тарифа записи — 30-минутный и 12-часовой — и почему к ним нельзя дополнительно прибавлять обычную плату за ввод.
- Набор проверяемых примеров для 1, 2, 3 и 10 использований, а также формула окупаемости для префикса любой длины.
- Что эти правила означают для разработчиков при проектировании структуры промпта и планировании пакетных задач.
Навигация: Сначала концептуальная таблица и краткий обзор влияния помогут согласовать термины и понять, кого это затрагивает; в разделе «Объективные факты» собраны правила кэширования, цены и примеры расчётов из официальной документации; в разделе «Анализ и выводы» объясняется математика за порогом окупаемости, а также обсуждаются структура промпта, планирование пакетов и типичные ошибки.
Кэширование промптов OpenAI To Know: объяснение понятий
| Понятие | Краткое объяснение |
|---|---|
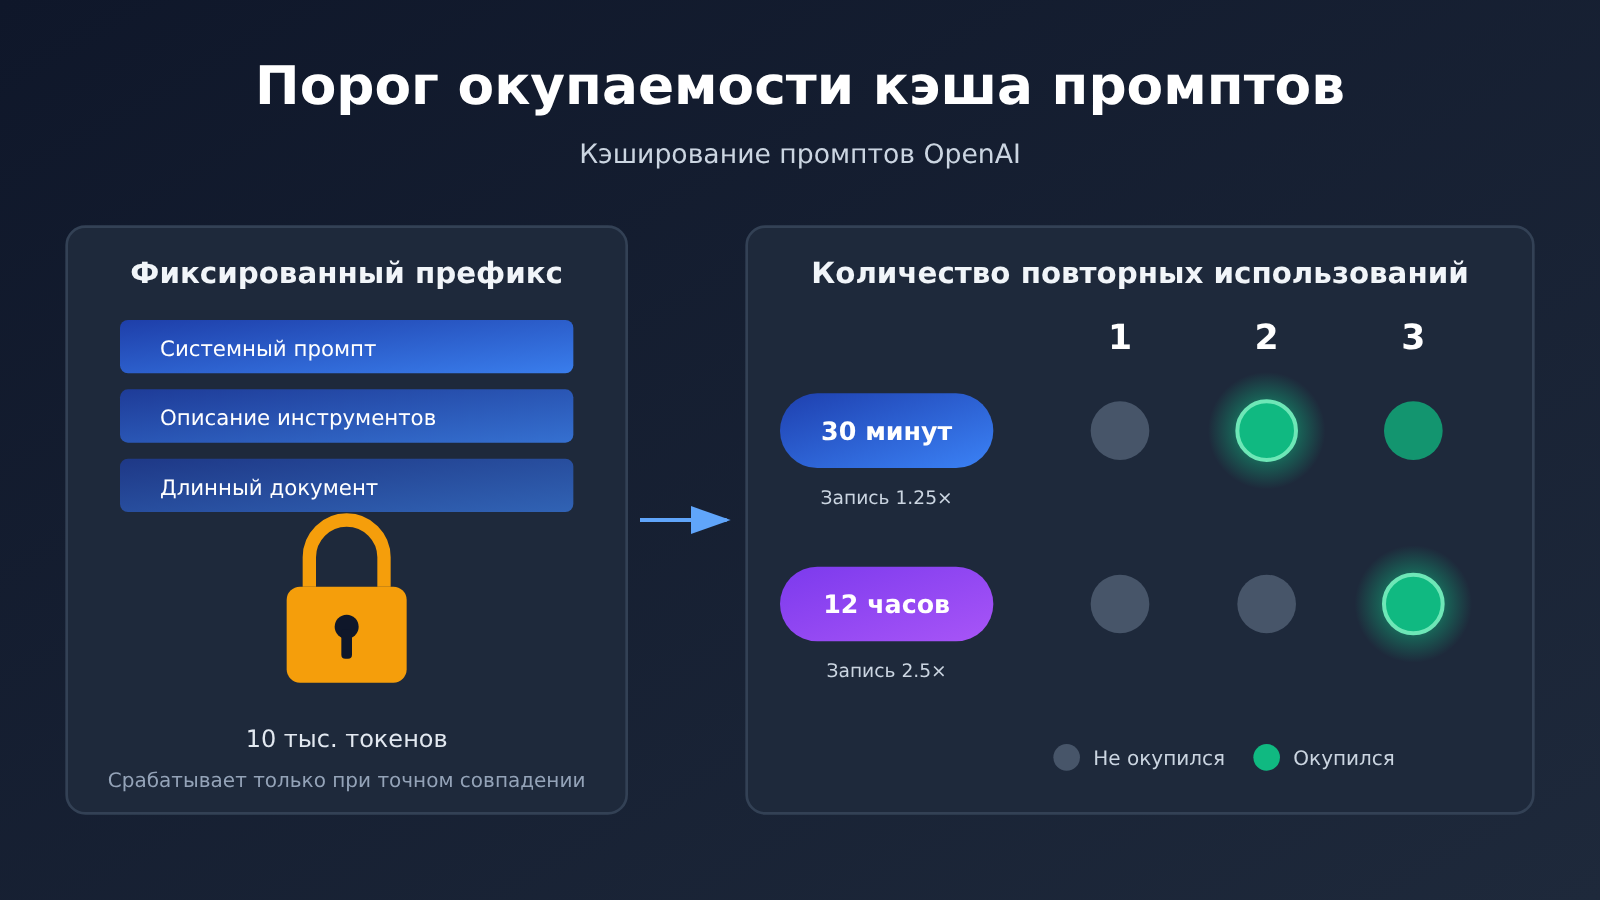
| Кэширование промптов (Prompt Caching) | OpenAI кэширует повторяющиеся префиксы промптов, а последующие запросы при попадании в кэш тарифицируются по более низкой цене «чтения кэша» |
| Префикс промпта | Непрерывное содержимое входных данных запроса с самого начала; кэш сопоставляется с точно таким же префиксом, а не с похожим по смыслу содержимым |
| Видимые входные токены | Входные токены, которые учитываются при определении порога кэширования; модели GPT-5.6 и новее требуют не менее 1024 токенов, чтобы кэш вообще заработал |
| Запись в кэш | Тарификация при первом помещении префикса в кэш: считается как множитель обычной цены ввода и представляет собой общую ставку записи |
| Чтение из кэша | Тарификация при попадании последующих запросов в кэш, цена значительно ниже обычного ввода |
| Кэш на 30 минут / 12 часов | Два варианта времени жизни кэша, по умолчанию — 30 минут; вариант на 12 часов доступен в Responses API, но запись в него дороже |
| Уровень обработки Standard | Стандартный уровень обработки в официальной таблице цен; цены на разных уровнях отличаются, смешивать их нельзя |
| Уровень Short context | Официальная таблица цен различает уровни по длине контекста; в этой статье используются только цены для короткого контекста |
Кратко о влиянии кэширования промптов OpenAI
- Разработчикам API: экономия от кэширования зависит от числа повторных использований и частоты попаданий за время действия кэша, а не от принципа «включил — и уже экономишь». В 30-минутном тарифе достаточно двух обращений (первичная запись плюс одно попадание), чтобы это стало дешевле, чем без кэширования. В 12-часовом тарифе запись стоит дороже, поэтому нужно больше повторных использований, чтобы окупить затраты.
- Командам, которые делают агентов или используют длинные системные промпты: фиксированные правила, описания инструментов и длинные документы стоит размещать в начале, а изменяемый контент — в конце. Только так префикс будет стабильно попадать в кэш. Это вопрос структуры, а не настроек.
- Командам, выполняющим пакетную обработку задач: запросы с одинаковым префиксом лучше отправлять в течение срока действия кэша — это заметно повышает частоту попаданий. Если же задачи распределены на весь день, стоит оценить, оправдан ли 12-часовой тариф.
- Тем, кто отвечает за расчёт затрат: кэширование влияет только на стоимость входных данных в фиксированном префиксе. Вывод, новые материалы, вызовы инструментов и повторные попытки в него не входят. В бюджетной таблице нельзя переносить долю экономии от кэша прямо на общий счёт.
Кэширование промптов OpenAI: объективные факты
Источники информации и актуальность
Данные для этой статьи проверены 2026-11-17 по официальным документам, которые постоянно поддерживает OpenAI: руководству по кэшированию промптов developers.openai.com/api/docs/guides/prompt-caching и странице с ценами developers.openai.com/api/docs/pricing.md. Эти документы обновляются в любой момент, а дату первого появления соответствующих правил мы не проверяли. Так что это не новость дня, а разбор и расчёт по действующим правилам.
Правила попадания в кэш промптов
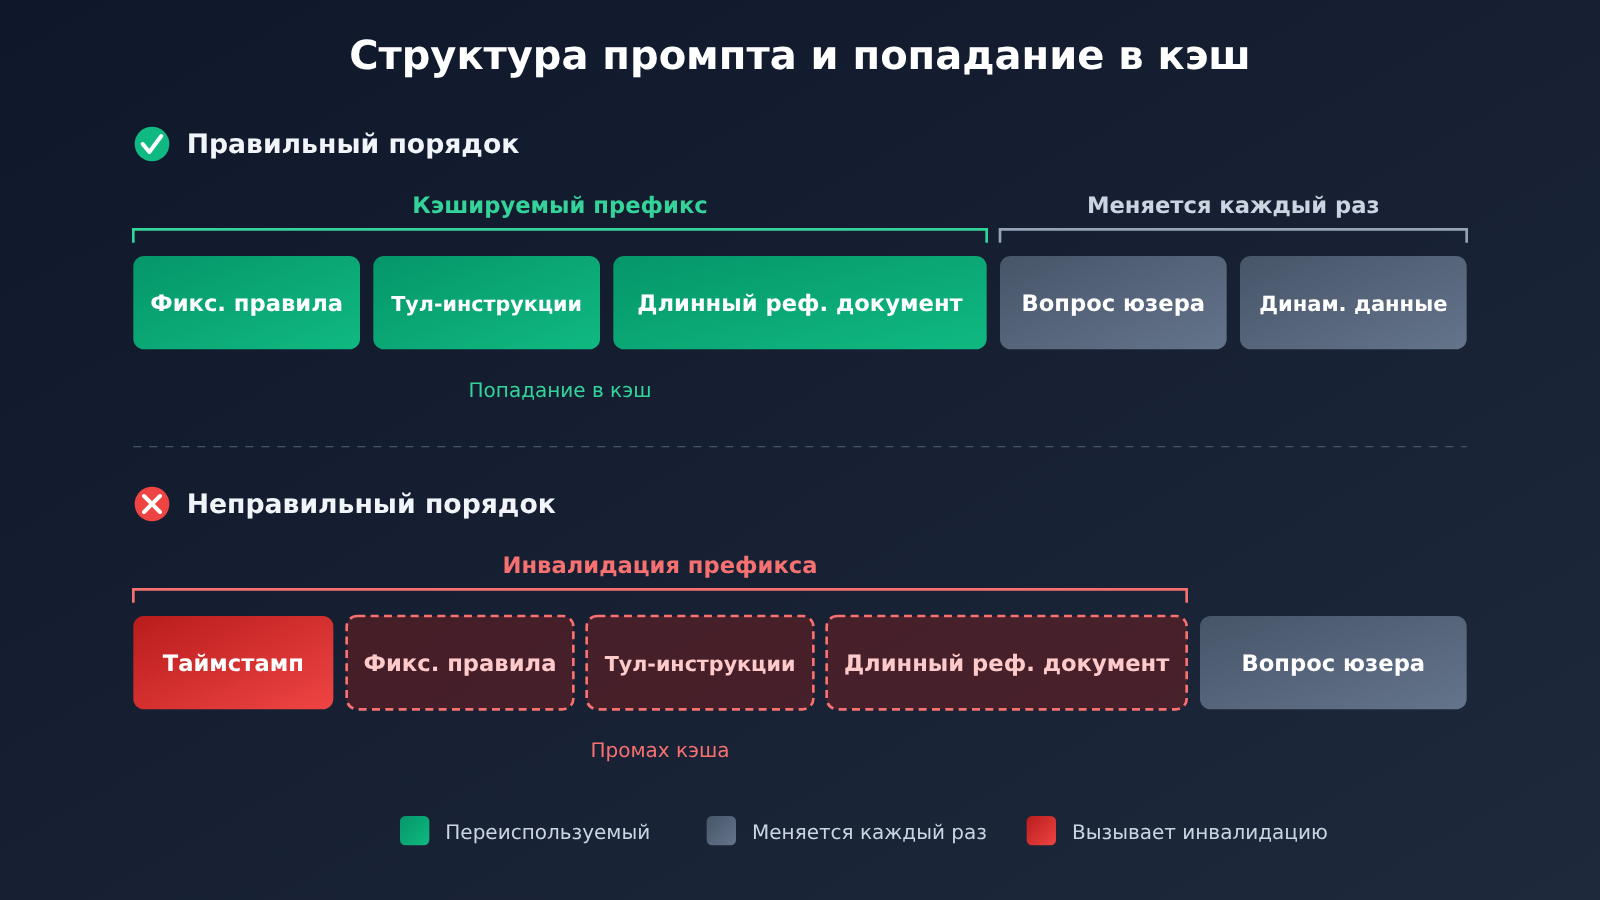
Кэширование промптов в OpenAI сопоставляет одинаковый префикс промпта. Два промпта могут быть почти одинаковыми по смыслу, но если начало у них различается, кэш не сработает: это не поиск по семантическому сходству. То есть изменение любого символа в префиксе — например, если вставить текущее время в начало системного промпта — может лишить все последующие части промпта шанса попасть в кэш.
Для GPT-5.6 и последующих моделей порог кэширования — не менее 1024 видимых входных токенов. У старых моделей правила другие: выводы о расчёте стоимости и пороге из этой статьи применимы только к новым правилам, описанным в официальной документации, и их нельзя механически переносить на старые модели.
Две ставки записи в кэш
| Уровень кэша | Ставка записи (относительно обычного ввода) | Пояснение |
|---|---|---|
| 30 минут (по умолчанию) | 1.25× | Время действия кэша по умолчанию |
| 12 часов | 2.5× | Предоставляется в Responses API |
В официальной документации прямо указано, что оба множителя — это полная ставка записи: при первой записи плата взимается именно по этой ставке, и обычная плата за ввод сверху не начисляется. Кроме того, важно понимать: 12 часов — это время действия кэша, а не срок удаления данных, эти два понятия нельзя путать.
Официальные цены gpt-6-luna
Ниже приведены цены gpt-6-luna со страницы официальных цен OpenAI для уровня обработки Standard и диапазона Short context, в долларах за миллион токенов. Эти цены нельзя применять к длинному контексту или другим уровням обработки, и это не тарифы какой-либо сторонней платформы.
| Позиция тарификации | Цена (USD / миллион токенов) |
|---|---|
| Обычный ввод | $0.10 |
| Вывод | $0.50 |
| Чтение кэша | $0.01 |
| Запись в 30-минутный кэш | $0.125 |
| Запись в 12-часовой кэш | $0.25 |
Как видно, цена записи на 30 минут — $0.125 — ровно в 1.25 раза выше обычного ввода, а запись на 12 часов за $0.25 — в 2.5 раза, что совпадает с правилом множителей из документации. Чтение кэша стоит всего одну десятую от обычного ввода.
Пример расчёта при повторном использовании
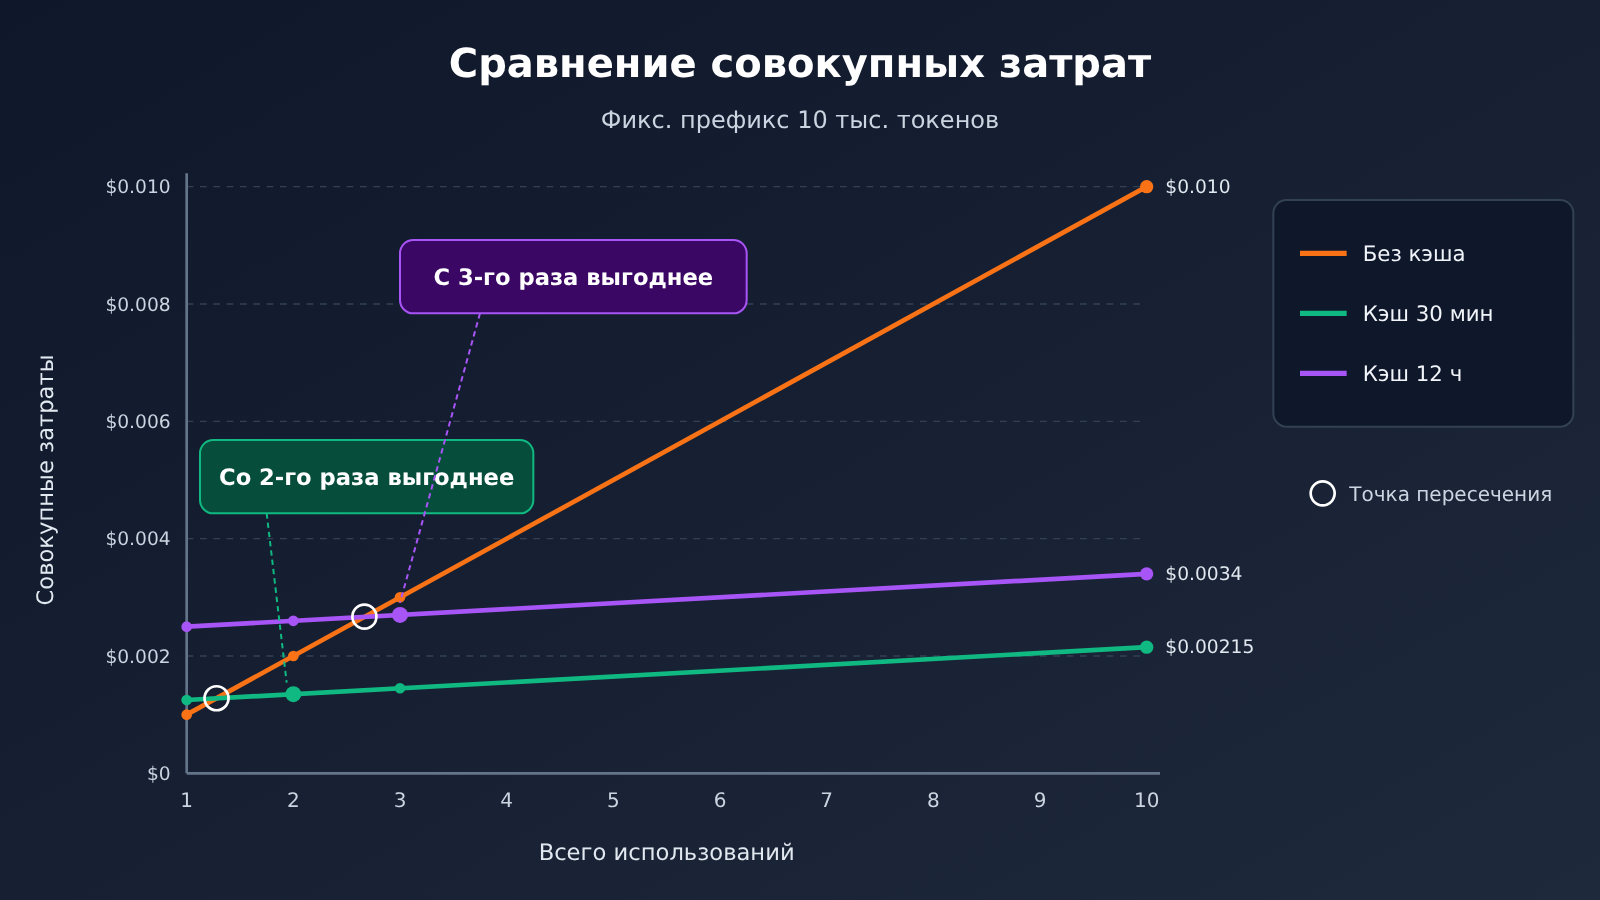
Приведённые ниже примеры — теоретические расчёты на основе официальных цен, а не результаты реальных измерений. Допущения: фиксированный префикс из 10 000 тарифицируемых токенов; при первом использовании он полностью записывается в кэш; при каждом последующем использовании происходит попадание в кэш; повторных записей за это время нет.
| Общее число использований | Без кэша | 30-минутный кэш | 12-часовой кэш |
|---|---|---|---|
| 1 раз | $0.001 | $0.00125 | $0.0025 |
| 2 раза | $0.002 | $0.00135 | $0.0026 |
| 3 раза | $0.003 | $0.00145 | $0.0027 |
| 10 раз | $0.010 | $0.00215 | $0.0034 |
При этих допущениях 30-минутный кэш становится дешевле варианта без кэша начиная со 2-го общего использования, а 12-часовой кэш — начиная с 3-го. Если использовать только 1 раз, оба варианта с кэшированием дороже, чем без кэша: вы платите надбавку за запись, но не получаете скидку за чтение.
Границы применимости примера расчёта
Эти цифры охватывают только фиксированную часть префикса. Новые материалы, добавляемые в каждый запрос, вывод модели, вызовы инструментов и повторные попытки при ошибках в расчёт не входят — так что это не скидка на весь запрос целиком. Если интервал между двумя использованиями превышает время жизни кэша, для последующих запросов уже нельзя считать, что «попали все» — придётся снова прибавить стоимость повторной записи.
Анализ и выводы по кэшированию промптов в OpenAI
Почему порог окупаемости — 2 и 3 обращения
Если обобщить расчёт на произвольное число обращений N, можно записать три линии затрат (в долларах на миллион токенов префикса):
- Без кэширования: 0.10 × N
- Кэш на 30 минут: 0.125 + 0.01 × (N − 1)
- Кэш на 12 часов: 0.25 + 0.01 × (N − 1)
Чтобы стоимость с кэшем оказалась меньше стоимости без кэша, для 30-минутного варианта нужно N больше примерно 1.28, то есть выгодно начиная со 2-го обращения; для 12-часового нужно N больше примерно 2.67, то есть выгодно с 3-го обращения. Этот вывод не зависит от длины префикса: все три линии затрат пропорциональны числу токенов, поэтому если префикс в 2000 токенов заменить на 50000 токенов, число обращений до окупаемости не изменится — изменится только абсолютная сумма экономии. Условие — префикс должен проходить порог в 1024 токена и ценовой тариф должен совпадать.
Структурно надбавка за запись — это разовая затрата, а экономия от каждого попадания в кэш — разница между обычной ценой ввода и ценой чтения из кэша, то есть $0.09 на миллион токенов. У 30-минутного варианта надбавка всего $0.025, её покрывает одно попадание; у 12-часового надбавка $0.15, для её покрытия нужно два попадания. Отсюда и разница в одно обращение между двумя порогами окупаемости.
Многоразовый скрипт для расчёта окупаемости
Скрипт ниже воспроизводит расчёты из этой статьи при тех же допущениях. Можно подставить свои цены и количество использований и быстро оценить собственный сценарий. Значения цен лучше сверять с актуальными данными на официальной странице с ценами.
# По официальным ценам gpt-6-luna Standard / Short context (доллары / миллион токенов)
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """Считаем только стоимость фиксированного префикса;
    предполагаем полную запись при первом вызове, попадания в кэш при всех
    последующих и отсутствие повторных записей"""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} 次  不缓存 ${base:.5f}  30分钟 ${c30:.5f}  12小时 ${c12:.5f}")
Результат выполнения совпадает с таблицей расчётов выше. Если в вашей ситуации часть запросов не попадает в кэш, эти промахи можно обработать как «повторную запись» — тогда точка окупаемости соответственно сдвинется вправо.
Структура промпта важнее переключателя
Поскольку кэш распознаёт только абсолютно идентичный префикс, порядок частей в промпте напрямую определяет долю попаданий в кэш. Надёжнее всего выносить в самое начало фиксированные системные правила, ролевые установки, описания инструментов и справочные документы, а вопрос пользователя, результаты поиска, временные метки и прочие материалы, которые меняются при каждом вызове, — в конец. Стоит любому изменяющемуся полю затесаться в начало префикса, и даже самый длинный фиксированный блок после него уже не удастся переиспользовать.
Есть ещё одно распространённое заблуждение, о котором стоит сказать отдельно: добивать промпт до порога в 1024 токена нерелевантным содержимым невыгодно. Заполняющие токены сначала оплачиваются по цене записи, а затем каждый раз — по цене чтения из кэша, к тому же они могут мешать модели понимать настоящие инструкции. Смысл порога в том, что коротким промптам кэш вообще не нужен, а не в том, чтобы искусственно удлинять короткие промпты.
Планирование батчей решает, попадём ли мы «во все цели»
Ещё одно ключевое допущение в расчётах — что все последующие запросы попадут в кэш. В реальности, если запросы с одним и тем же префиксом разбросаны по всему дню, 30-минутный режим скорее всего истечёт между двумя запросами, данные каждый раз будут записываться заново, и выйдет дороже, чем без кэширования. Здесь есть два подхода: первый — собрать однотипные задачи в батчи и отправлять их подряд в течение 30 минут; второй — оценить 12-часовой режим и обменять более высокую разовую плату за запись на более долгий срок жизни.
Выбор можно свести к простому эмпирическому правилу: если запросы идут плотно и с короткими интервалами — используйте режим по умолчанию на 30 минут, достаточно всего 2 использований, чтобы вышло дешевле, чем без кэша; если запросы редкие, но в течение одного дня один и тот же префикс используется многократно и общее число использований стабильно достигает 3 и больше, тогда 12-часовой режим имеет смысл. Если префикс с высокой вероятностью будет использован в течение срока жизни только один раз, самый дешёвый вариант — вообще не кэшировать.
Что в расчётах затрат легко завысить
Цифра «экономия около 78,5% при 10 использованиях» бросается в глаза, но относится она только к стоимости входных данных фиксированного префикса. В структуре цен gpt-6-luna выход стоит в 5 раз дороже обычного входа: если приложение генерирует длинные ответы или каждый запрос тянет за собой много новых материалов из поиска, доля сэкономленного на кэше префиксов в общем счёте может оказаться не такой уж большой. При составлении бюджета разумнее разбить запрос на блоки «фиксированный префикс», «динамический вход», «выход», «инструменты и повторы» и оценивать каждый отдельно, применяя формулу кэширования только к первому.
Кроме того, описанное в статье правило множителя записи относится к моделям GPT-5.6 и более поздним; конкретные цены в примере соответствуют только уровню обработки Standard и уровню Short context для gpt-6-luna. При переходе на старые модели, длинное контекстное окно или другие уровни обработки нужно заново смотреть цены и пересчитывать, а число использований для окупаемости тоже может измениться. Официальная документация постоянно обновляется: если правила позже изменятся, ориентироваться стоит на документацию того времени — это переменная, за которой нужно следить, а не уже случившееся изменение.
Сюньцзы в «Убеждении в учёбе» писал: «Собранная в гору земля — и ветры с дождями родятся там; собранная в пучину вода — и драконы родятся там». С бухгалтерией кэша промптов всё так же: одна запись — это только расход, настоящая экономия приходит от стабильного повторного использования в течение срока жизни.


