
Примечание автора: разбираем Qwen4-Max, занявшую 6-е место в рейтинге Code Arena WebDev: расстановка сил в первой шестёрке, разрыв между китайскими моделями, отставание от топовых моделей, а также как правильно читать число голосов и стоимость одной задачи.
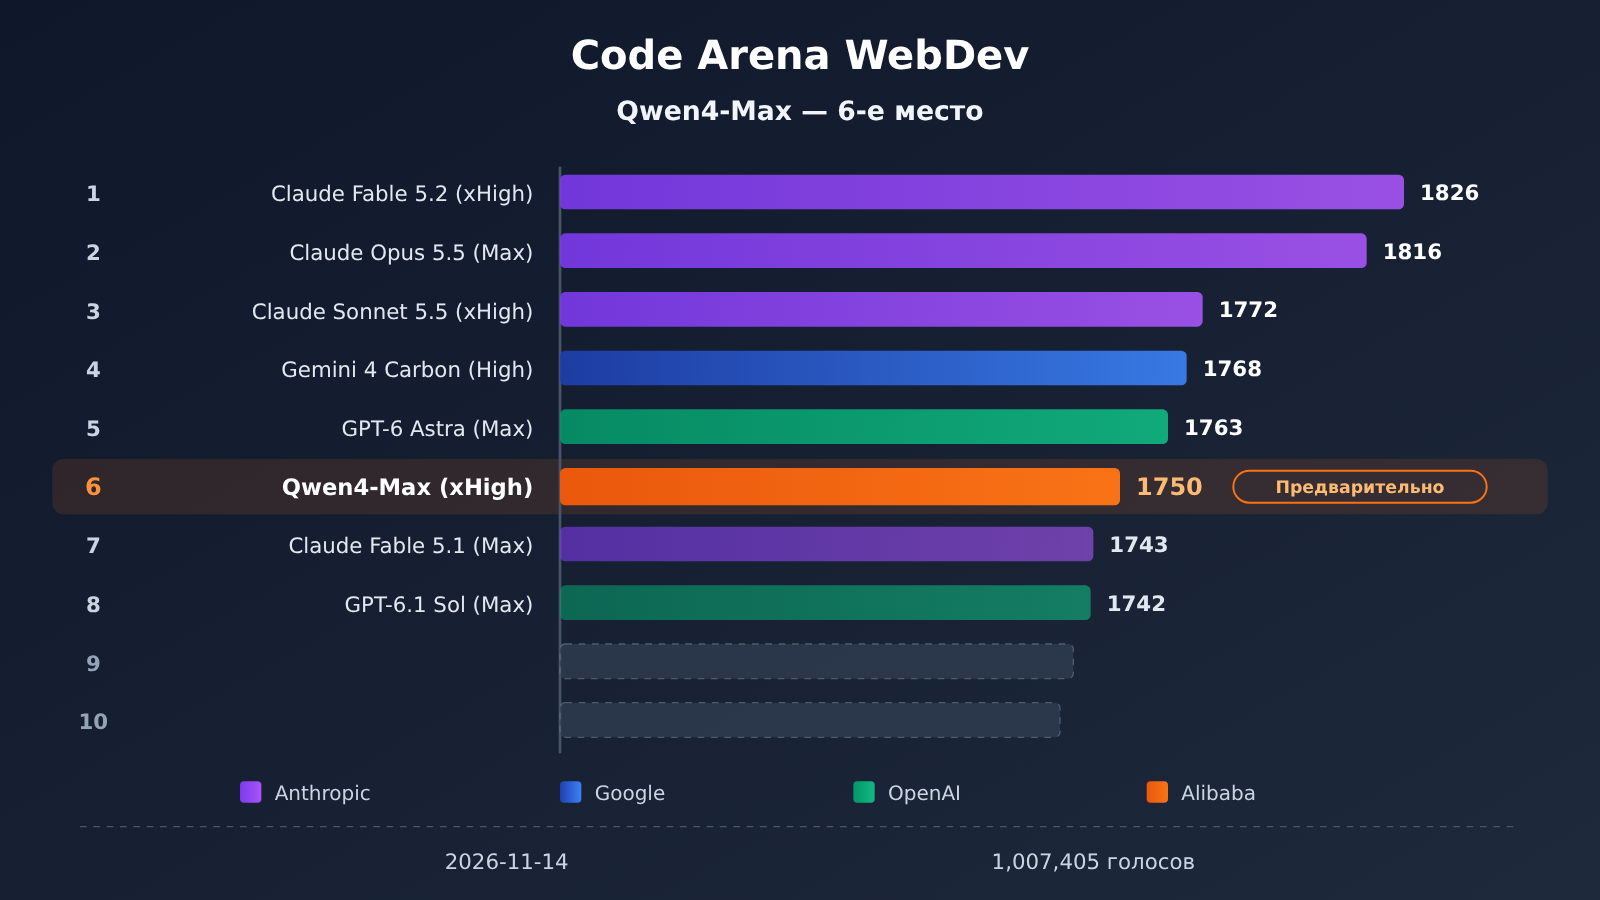
Сразу к выводу: в рейтинге Code Arena WebDev от arena.ai (категория Overall, на странице указана дата 2026-11-14) Qwen4-Max (xHigh) занимает 6-е место с 1750 баллами. Это первый случай, когда китайская модель попала в первую шестёрку этого рейтинга, и единственная модель в первой шестёрке не из американской лаборатории.
Это не рекламный материал, где 6-е место подаётся как 1-е. У Qwen4-Max в рейтинге стоит пометка Preliminary, у неё всего 1,814 голосов, так что позиция ещё может измениться. На той же официальной инфографике Alibaba она всё ещё заметно отстаёт от Opus 5.5 и GPT-6 Astra в Terminal-Bench и ProgramBench.
Главная ценность: после прочтения статьи у вас будет набор метаданных рейтинга, которые можно открыть и проверить самостоятельно, и вы поймёте, как использовать 6-е место Qwen4-Max, а как — нет.
Qwen4-Max в Code Arena WebDev: главное про 6-е место
Прежде чем спорить о местах, вынесем на стол метаданные рейтинга. Любое утверждение в духе «занял такое-то место» стоит сначала сверять с датой, числом голосов и количеством участвующих моделей — иначе непонятно, насколько это место вообще устойчиво.
| Пункт | Данные (публичные данные того же рейтинга) | Как это читать |
|---|---|---|
| Рейтинг и категория | arena.ai Code Arena WebDev, Overall | Отражает только предпочтения в слепом тестировании веб-разработки |
| Дата страницы | 2026-11-14 | Места продолжают меняться по мере поступления голосов |
| Всего голосов / моделей | 1,007,405 голосов / 159 моделей | Выборка большая, но число голосов у отдельных моделей сильно разнится |
| Место и балл Qwen4-Max | 6-е место, 1750 баллов | Единственная модель не из США в первой шестёрке |
| Голоса и пометка Qwen4-Max | 1,814 голосов, Preliminary | Всё ещё на этапе предварительной оценки |
| Стоимость одной задачи P50 | $4.18 | Медиана по статистике рейтинга, а не цена модели за единицу |
Что на самом деле означает место Qwen4-Max в рейтинге
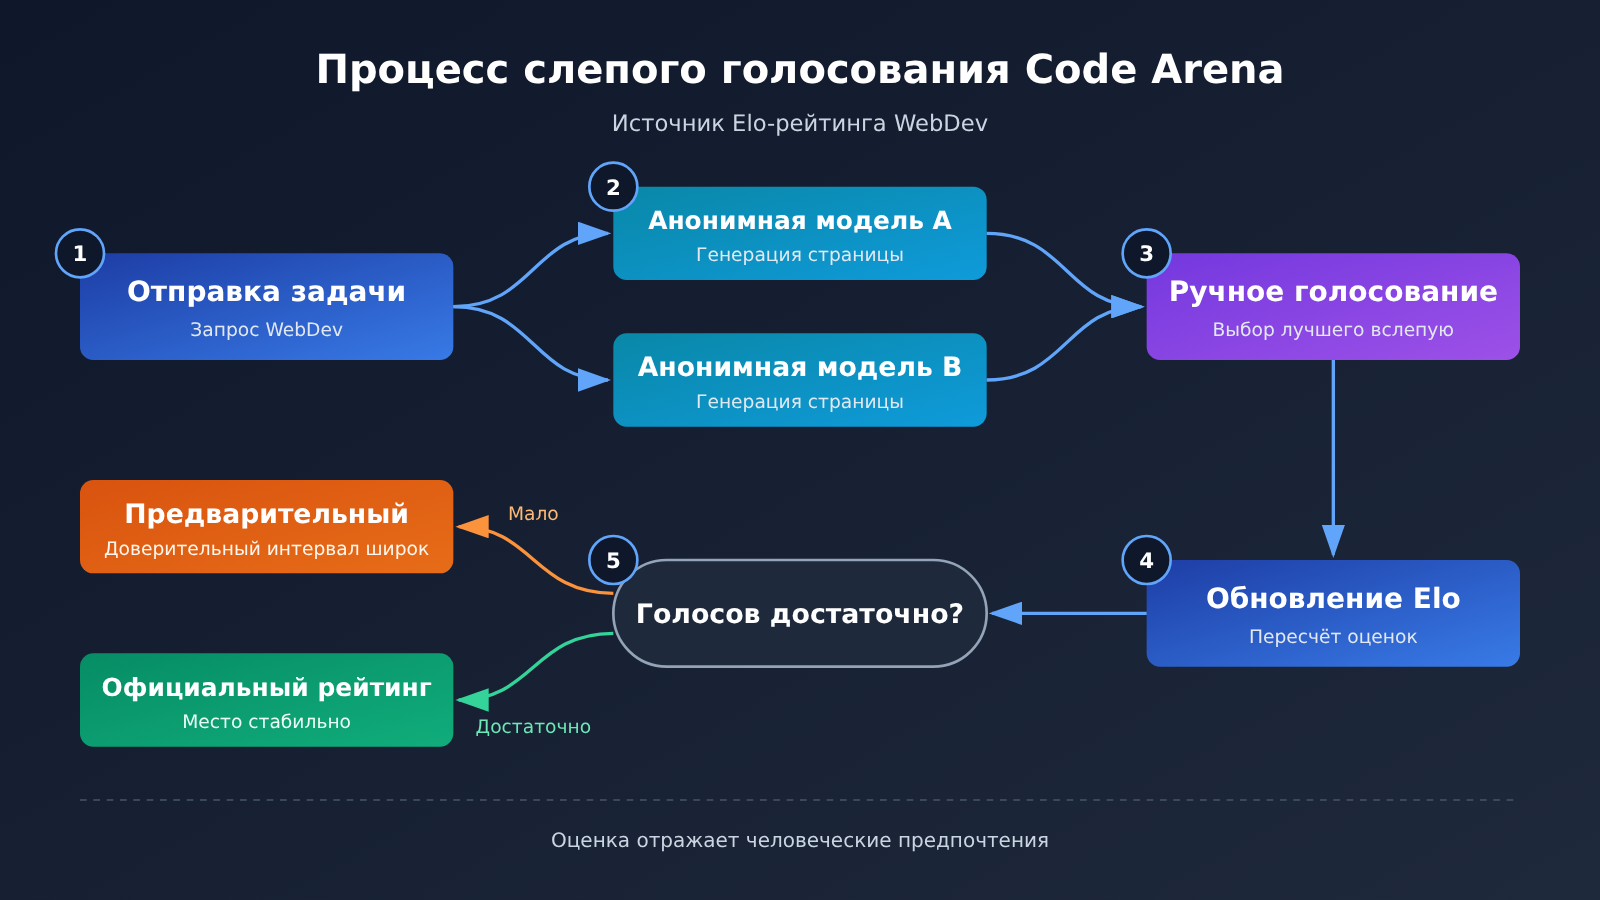
Оценка Elo в Code Arena складывается из слепого голосования людей: пользователь даёт одну и ту же задачу по веб-разработке, смотрит на результат двух анонимных моделей и голосует за тот, что лучше. Оценка показывает, «чей веб с точки зрения живых судей лучше», то есть измеряет предпочтения, а не суммарную продуктивность.
Пометку Preliminary тоже нужно читать правильно. Она говорит о том, что модель провела в поединках ещё недостаточно много боёв, поэтому доверительный интервал шире. У Gemini 4 Carbon (High), занявшей 4-е место в том же рейтинге, тоже стоит эта пометка — так что обмен позициями в диапазоне с 4-го по 6-е место в ближайшие недели вполне ожидаем.
Кто входит в топ-6 Code Arena WebDev: расстановка соперников Qwen4-Max
Если перечислить всю первую десятку, место Qwen4-Max становится виднее. Первые пять позиций заняли три американские лаборатории, причём одна только Anthropic забрала три из них.
| Место | Модель | Баллы | Лаборатория | Примечание |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | Первое место |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | P50 на одну задачу $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Preliminary | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | P50 на одну задачу $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | Alibaba | Preliminary, 1,814 голосов |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
Что расстановка в топ-5 значит для Qwen4-Max
В топ-6 у Anthropic 3 места (Fable 5.2, Opus 5.5, Sonnet 5.5), у Google и OpenAI по 1, у Alibaba 1. Иначе говоря, Qwen4-Max «протиснулась» на позицию между флагманами трёх ведущих лабораторий, а не просто подобрала место в разреженном рейтинге.
Ещё одна деталь, на которую стоит обратить внимание: места с 6-го по 8-е идут очень плотно — 1750, 1743, 1742, разница меньше 10 баллов. Отрыв Qwen4-Max от Claude Fable 5.1 и GPT-6.1 Sol меньше, чем её отставание от GPT-6 Astra на 13 баллов. Насколько стабильно место в рейтинге, станет понятно, когда число голосов вырастет.
Место Qwen4-Max среди китайских моделей
Если смотреть только на китайский сегмент, преимущество Qwen4-Max довольно заметно. Это единственная китайская модель, попавшая в топ-10; следующая появляется только на 13-м месте.
| Место среди китайских моделей | Модель | Баллы | Место в общем рейтинге | Отставание от Qwen4-Max |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | 6-е | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | 13-е | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | 16-е | −74 |
| 4 | Qwen3.8-Max | 1670 | 18-е | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | 18-е | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | 19-е | −89 |
| 7 | Kimi K3 (Max) | 1658 | 20-е | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | 26-е | −111 |
| 9 | Hy4 preview | 1632 | 27-е | −118 |
| 10 | GLM-5.3 (Max) | 1622 | 31-е | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | 33-е | −129 |
Два смысла разрыва внутри китайского сегмента
Первый уровень — скачок между поколениями. Qwen4-Max на 74 балла выше своей предыдущей версии Qwen3.8-Max (0902), а место в рейтинге выросло с 16-го до 6-го. В рамках одного и того же рейтинга и одной системы голосования это довольно серьёзный прирост.
Второй уровень — отрыв от второй китайской модели. Qwen4-Max на 64 балла выше Kimi K3.1 Pro, и это почти столько же, сколько он отстаёт от Opus 5.5 (66 баллов). Иными словами, сейчас Qwen4-Max находится посередине между китайским сегментом и мировой верхушкой: снизу он оторвался от китайских конкурентов, сверху до первого места ещё есть путь.
Стоит напомнить, что китайские модели со 2-го по 7-е место уместились между 1686 и 1658 баллами, разрыв совсем небольшой. Расставлять их по порядку с помощью этого рейтинга особого смысла нет.
Насколько Qwen4-Max отстаёт от мировых лидеров
Разрыв в баллах на Code Arena WebDev
Если выписать разницу между Qwen4-Max и моделями-лидерами и грубо прикинуть «шанс победы в прямом сравнении» по общей формуле Elo (шкала 400), становится понятнее, что эти баллы значат на практике. Конкретная методика подсчёта в arena может отличаться от стандартного Elo, так что проценты ниже — просто ориентир для интуиции:
- Против GPT-6 Astra, 5-е место: 1750 против 1763, разница 13 баллов, ориентировочный шанс победы около 48% — практически равные соперники.
- Против Opus 5.5, 2-е место: разница 66 баллов, ориентировочный шанс победы около 41%.
- Против Fable 5.2, 1-е место: разница 76 баллов, ориентировочный шанс победы около 39%.
- Против Kimi K3.1 Pro — второй китайской модели: Qwen4-Max впереди на 64 балла, ориентировочный шанс победы около 59%.
Диапазон баллов во всём рейтинге — от 1071 до 1826. В таком масштабе 76 баллов отставания от первого места не так уж много, но всё равно говорят о том, что в предпочтениях для веб-разработки топовые модели Anthropic по-прежнему чаще получают одобрение оценщиков.
Другие бенчмарки на том же графике: высокий Elo не гарантирует силу в терминальных задачах
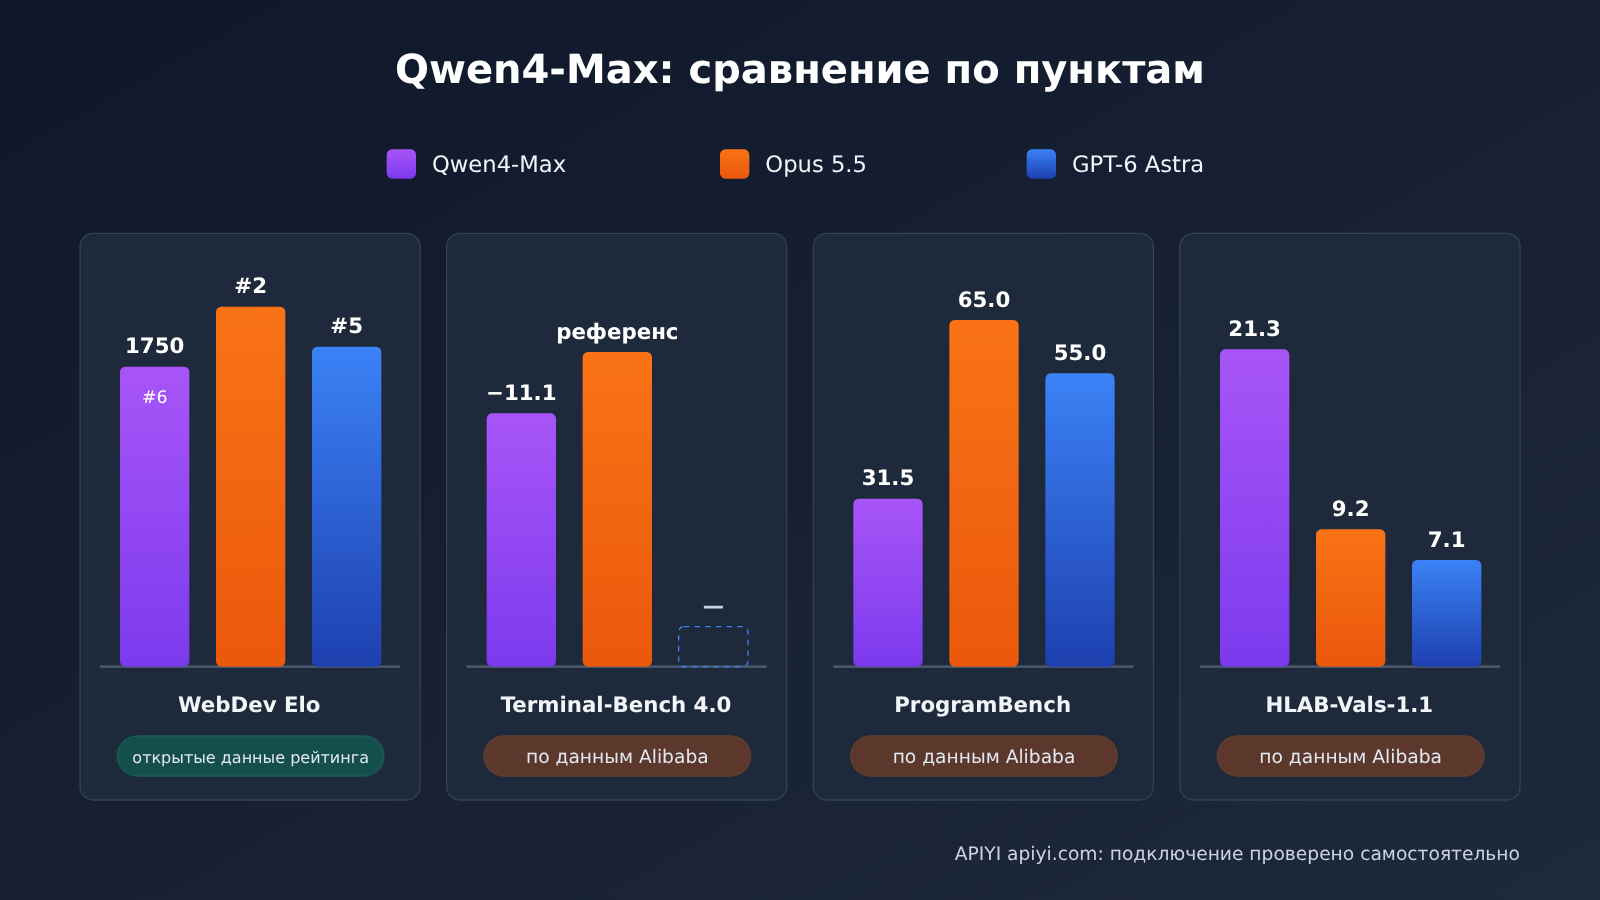
При выпуске Qwen4-Max Alibaba использовала один график с несколькими бенчмарками. Все данные ниже — по официальным заявлениям Alibaba, а не из рейтинга arena и не результаты независимого воспроизведения.
| Бенчмарк (официальные данные Alibaba) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | Другие |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
Эта таблица показывает одну ключевую вещь: Qwen4-Max очень хорошо выступает в слепых тестах по веб-разработке, но в терминальных операциях и инженерном программировании разрыв всё ещё заметен. В Terminal-Bench 4.0 она на 11.1 балла ниже Opus 5.5, а Kimi 67.2 на графике — ещё выше; в ProgramBench её 31.5 — меньше половины результата Opus 5.5.
Есть и позиции, где она явно впереди. На HLAB-Vals-1.1 Qwen4-Max получает 21.3 — заметно выше 9.2 у Opus 5.5 и 7.1 у GPT-6 Astra; на AA-Briefcase она также выше GPT-6 Astra. Поэтому точнее говорить так: распределение способностей Qwen4-Max отличается от моделей-лидеров, а не что она «во всём почти догнала» их.
Как читать голоса и стоимость Qwen4-Max
Что означают 1,814 голосов
Удержится ли модель на своей позиции, во многом зависит от числа голосов. 1,814 голосов Qwen4-Max — это меньше 0,2% от примерно 1 млн общих голосов, и по сравнению с несколькими китайскими моделями в том же рейтинге это тоже заметно меньше.
| Модель | Позиция | Голоса | Стоимость одной задачи P50 | Статус |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 6 | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | 13 | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | 16 | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | 2 | Публичные данные рейтинга | $8.99 | — |
| GPT-6 Astra (Max) | 5 | Публичные данные рейтинга | $9.43 | — |
У Qwen3.8-Max голосов примерно в 12.7 раза больше, чем у Qwen4-Max, поэтому её оценка ближе к «стабильному значению». 1750 баллов Qwen4-Max сейчас выглядят скорее как раннее измерение — позже они могут как подрасти, так и опуститься. Когда ссылаетесь на эту позицию, лучше одновременно указывать три ограничения: «Preliminary, 1,814 голосов, 2026-11-14».
Стоимость одной задачи P50: это не цена за токены модели
Показатель «стоимость одной задачи P50» в таблице означает медианную стоимость одного запуска задачи из этого рейтинга. На него сильно влияют длина ответа модели и уровень интенсивности рассуждений (например, xHigh, Max), поэтому его нельзя сравнивать с ценой модели за миллион токенов.
В таком измерении $4.18 у Qwen4-Max составляет около 46% от $8.99 у Opus 5.5 и 44% от $9.43 у GPT-6 Astra, но примерно в 4,7 раза больше, чем $0.89 у Kimi K3.1 Pro, и в 2,2 раза больше, чем $1.91 у предыдущего поколения Qwen3.8-Max. Если в вашем сценарии важна стоимость одного запуска, обратите внимание и на Kimi K3.1 Pro: он набирает 1686 баллов примерно за одну пятую стоимости.
Официальная цена Qwen4-Max и текущая цена в APIYI
Ниже указаны цены за 1M tokens, данные на 2026-11-16:
- Официальная цена Qwen4-Max:输入 $1.5, вывод $4.5, чтение из кэша $0.075.
- APIYI продаёт флагманскую модель Qwen
qwen3.8-max: ввод $1.65, вывод $4.95, чтение из кэша $0.20625.
Важно отметить: APIYI пока не добавил qwen4-max в каталог, но мы скоро это сделаем. Это разные модели, поэтому указанные цены нельзя напрямую сравнивать между собой. Актуальные доступные модели и цены смотрите в списке моделей на платформе APIYI apiyi.com.
Три шага: перепроверить рейтинг, сверить цену, сменить точку подключения
После того как разработчик просмотрел таблицу лидеров, он обычно делает три вещи: сверяет места, сверяет цены и пробует подключить модель к своему проекту. Рекомендую идти в таком порядке:
- Перепроверить рейтинг: откройте страницу Code Arena WebDev на arena.ai и проверьте, не изменились ли дата, число голосов и отметка Preliminary.
- Сверить цену: в списке моделей APIYI apiyi.com посмотрите, какие модели Qwen сейчас в продаже и по какой цене, и проверьте, появился ли в каталоге
qwen4-max. - Сменить точку подключения: в уже используемом SDK с совместимостью с OpenAI поменяйте base_url на
https://api.apiyi.com/v1, в поле ID модели сначала укажитеqwen3.8-max, а когда новая модель появится в каталоге — переключитесь наqwen4-maxдля сравнения.
🚀 Совет для быстрого старта: если хотите на своих задачах WebDev проверить, насколько серия Qwen отличается от Claude, GPT и Gemini, можно через APIYI apiyi.com вызывать несколько моделей одним API-ключом — у новых пользователей есть бесплатный тестовый лимит, так что удобно сначала прогнать небольшую выборку, а потом уже решать, что брать в основу.
Анализ сильных и слабых сторон Qwen4-Max
Сильные стороны Qwen4-Max
- Лучший балл предпочтения в веб-разработке среди китайских моделей: 1750 баллов — на 64 балла больше, чем у второй китайской модели, и на 74 балла больше, чем у предыдущего поколения.
- Разрыв с лидерами местами уже небольшой: до 5-го места, GPT-6 Astra, всего 13 баллов; с 7-м и 8-м местами — почти на равных.
- Стоимость одной задачи ниже, чем у флагманских моделей лидеров: P50 $4.18 — меньше половины от Opus 5.5 и GPT-6 Astra.
- Есть заметные преимущества в отдельных бенчмарках: официально заявленный результат HLAB-Vals-1.1 заметно выше, чем у Opus 5.5 и GPT-6 Astra.
Ограничения Qwen4-Max
- Место в рейтинге пока нестабильно: статус Preliminary и 1 814 голосов — при цитировании нужно указывать эти оговорки.
- Отставание в бенчмарках для терминала и инженерного программирования: на Terminal-Bench 4.0 и ProgramBench результат заметно ниже, чем у Opus 5.5 и GPT-6 Astra; при работе с Agent или автоматизацией командной строки это нужно оценивать отдельно.
- Стоимость одной задачи выше, чем у некоторых китайских моделей: заметно дороже Kimi K3.1 Pro и Qwen3.8-Max; в сценариях, чувствительных к стоимости, это может оказаться невыгодно.
Когда не стоит смотреть только на рейтинг Code Arena WebDev
Если ваш основной сценарий — работа в терминале, многоэтапное изменение кода или многошаговые задачи Agent, то, глядя только на WebDev Elo, вы переоцените реальные результаты Qwen4-Max. Здесь ближе к задаче будут бенчмарки вроде Terminal-Bench. Аналогично, если бюджет — жёсткое ограничение, стоит смотреть на стоимость одной задачи вместе с баллами, а не гнаться только за местом в рейтинге. Лучше всего этот рейтинг отвечает на вопрос: «Кто, по мнению людей-рецензентов, делает веб-страницы лучше».
Частые вопросы (FAQ)
Q1: Шестое место Qwen4-Max в рейтинге Code Arena WebDev — это реальная позиция?
Да, это реальная позиция, которая отображается на странице рейтинга (2026-11-14, категория Overall, 1750 баллов). Но у неё стоит пометка Preliminary, и голосов всего 1,814 — так что позиция ещё может измениться. При цитировании лучше указывать эти условия.
Q2: Насколько Qwen4-Max отстаёт от GPT-6 Astra и Opus 5.5?
В Code Arena WebDev Qwen4-Max уступает GPT-6 Astra 13 баллов, Opus 5.5 — 66 баллов, а лидеру Fable 5.2 — 76 баллов. Но на Terminal-Bench 4.0 и ProgramBench, данные по которым Alibaba публикует сама, разрыв с этими двумя моделями заметно больше.
Q3: Насколько Qwen4-Max опережает другие китайские модели?
Это единственная китайская модель в топ-10: она на 64 балла выше второй китайской модели Kimi K3.1 Pro (13-е место, 1686 баллов) и на 74 балла выше своей предыдущей версии Qwen3.8-Max (0902).
Q4: Для каких задач Qwen4-Max подходит лучше всего?
Судя по методике этого рейтинга, модель лучше всего показывает себя в WebDev-задачах: генерация фронтенда, лендинги и интерактивные прототипы. А для автоматизации в терминале, масштабной правки кода на уровне крупных проектов и похожих сценариев лучше смотреть на терминальные бенчмарки и проверять всё на собственных примерах.
Q5: Как вызывать модели серии Qwen через API для сравнительного тестирования?
Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ, затем в OpenAI-совместимом SDK укажите `base_url` как `https://api.apiyi.com/v1`, а в качестве ID модели — `qwen3.8-max`. Модель `qwen4-max` пока не добавлена в каталог, но мы добавим её в ближайшее время — после этого для переключения и сравнения достаточно будет поменять ID модели.
Q6: Стоимость $4.18 за задачу — это цена Qwen4-Max?
Нет. $4.18 — это медианная стоимость одной задачи (P50) по статистике рейтинга, она зависит от длины вывода и выбранного уровня рассуждений. Цену самой модели нужно смотреть отдельно: за 1M tokens на вход, на выход и на чтение кэша. Актуальные цены можно проверить в списке моделей на APIYI apiyi.com.
Qwen4-Max Code Arena WebDev: ключевые выводы
- Место: 6-е в рейтинге на 2026-11-14, 1750 баллов — китайская модель впервые попала в топ-6.
- Расклад: первые пять мест заняты полностью — три у Anthropic, по одному у Google и OpenAI.
- Стабильность: пометка Preliminary и 1,814 голосов — позиция ещё может измениться.
- Отрыв от своих: на 64 балла впереди Kimi K3.1 Pro и на 74 балла — впереди предыдущего поколения.
- Границы возможностей: по официально заявленным результатам Terminal-Bench и ProgramBench всё ещё отстаёт от лидеров.
- Как считать стоимость: P50 $4.18 — это медиана на одну задачу, а не цена модели.
- С чего начать: можно сначала собрать в APIYI процесс сравнения на
qwen3.8-max, а когда новая модель появится в каталоге — переключиться.
Итог
Выступление Qwen4-Max в рейтинге Code Arena WebDev можно описать тремя пунктами:
- Впервые в топ-6: 1750 баллов, единственная модель не из американской лаборатории в первой шестёрке, от 5-го места отстаёт всего на 13 баллов.
- Место — пока раннее показание: Preliminary, 1,814 голосов; при цитировании обязательно указывайте дату и число голосов.
- Elo — это не «сильнее во всём»: по официально заявленным результатам в терминальных бенчмарках и бенчмарках инженерного программирования модель всё ещё уступает Opus 5.5 и GPT-6 Astra.
Если вы выбираете модель, воспринимайте этот рейтинг как один из ориентиров — «предпочтения в веб-разработке», — а решение принимайте с учётом собственных задач и бюджета. Рекомендую через APIYI apiyi.com собрать кандидатов под одним интерфейсом, прогнать их на одном наборе задач и сделать выводы по своим данным.
📚 Справочные материалы
- Рейтинг Code Arena WebDev на arena.ai: источник данных о позиции, баллах, числе голосов и стоимости одной задачи в этой статье
- Ссылка:
arena.ai -
Примечание: на странице указана дата 2026-11-14, категория Overall; актуальную позицию и пометку Preliminary можно проверить самостоятельно
-
Официальная инфографика релиза Qwen4-Max от Alibaba: источник баллов по бенчмаркам Terminal-Bench 4.0, ProgramBench и другим
- Ссылка: официальные каналы публикации Qwen
- Примечание: все соответствующие данные в статье — официальные самодекларированные показатели, а не воспроизведение третьей стороной
Автор: техническая команда APIYI
Техническое общение: будем рады обратной связи — свяжитесь с нами на главной странице сайта APIYI; инструкции по добавлению моделей и подключению доступны в центре документации docs.apiyi.com


