
Примечание автора: оба флагмана уровня 2.4T, у Qwen4-Max каталожная цена ниже на 25%, максимальная длина вывода примерно втрое больше, а на ту же задачу уходит на 20–30% меньше токенов. В статье разбираем архитектуру, официальные самоотчётные результаты бенчмарков и каталожные цены двух поколений, а также даём чек-лист миграции с qwen3.8-max.
16.11.2026 Alibaba выпустила Qwen4-Max. Сразу к выводу: по сравнению с Qwen3.8-Max у нового поколения входная и выходная каталожные цены ниже на 25%, максимальная длина вывода выросла со 128K до 393K, примерно втрое, а в официальном тесте Work360 на ту же задачу уходит на 20–30% меньше токенов. Командам, которые уже используют qwen3.8-max в продакшене, стоит серьёзно оценить обновление, но перестраивать всё с нуля не нужно.
Это не рекламный текст в духе «новое поколение полностью сносит старое». Все приведённые ниже результаты бенчмарков помечены как официальные самоотчёты, а данные сторонних рейтингов — как снимок публичного лидерборда (14.11.2026). Два числа, которые легко преувеличить, — снижение стоимости одной задачи на 62% и 6-е место в Arena, — разберём отдельно.
Главная ценность: после прочтения вы сможете ответить на три вопроса: какая часть экономии реальна, какие бенчмарки выросли заметно, а какие почти не изменились, и что ещё придётся менять при миграции, помимо ID модели. Кроме того, если вы вызываете модели через APIYI apiyi.com: по состоянию на 16.11.2026, 11:00, платформа ещё не добавила qwen4-max в каталог; на этом этапе можно продолжать использовать qwen3.8-max, мы скоро добавим эту модель.
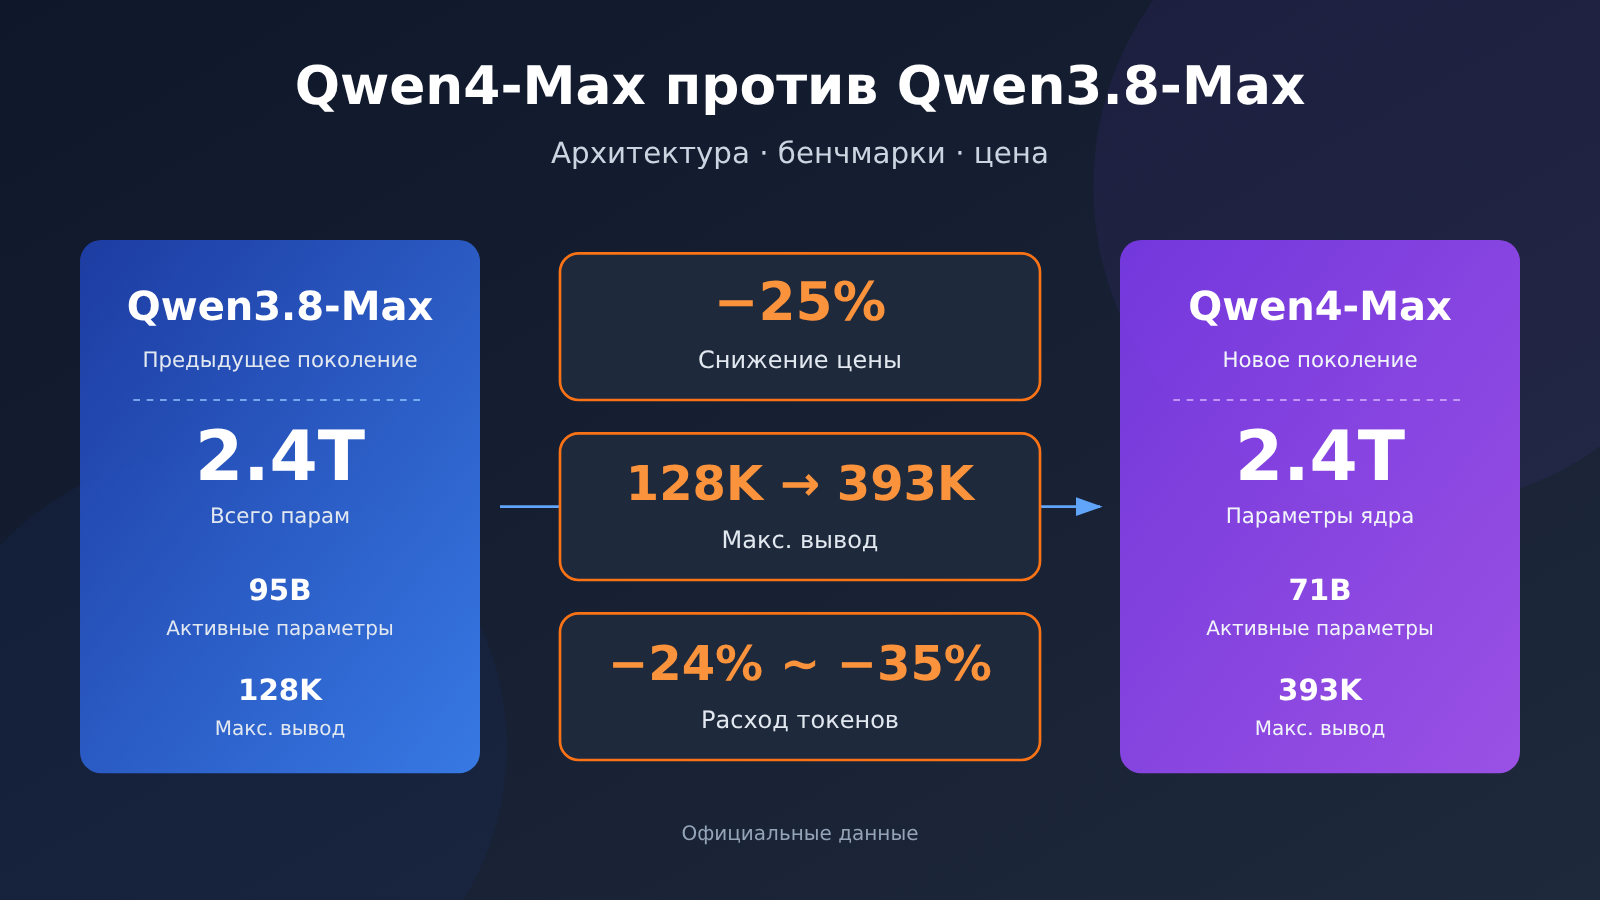
Ключевые различия Qwen4-Max и Qwen3.8-Max: краткий обзор
Общий масштаб у обоих поколений моделей сопоставим, но в Qwen4-Max изменены активные параметры, лимит вывода и уровень рассуждений по умолчанию. В таблице ниже сначала собраны различия на уровне спецификаций, а цена разобрана отдельно — в разделе о стоимости.
| Параметр сравнения | Qwen3.8-Max | Qwen4-Max | Изменение |
|---|---|---|---|
| Масштаб параметров | 2.4T общих параметров | 2.4T основной блок + 328B N-gram Embedding | Основной блок того же уровня, добавлена таблица эмбеддингов |
| Активируется за раз | 95B | 71B | Примерно на 25% меньше |
| Контекст | 1M | 1M (макс. вход 991K, в режиме рассуждений 983K) | Лимит входа немного уже |
| Максимальный вывод | 128K | 393K | Примерно в 3 раза больше |
| Максимальная цепочка рассуждений | Отдельно не указана официально | 262K | Добавлен явный лимит |
| reasoning_effort по умолчанию | xhigh | high | Уровень по умолчанию понижен на одну ступень |
| Визуальные возможности | Поддержка ввода изображений | Нативное зрение | Зрение стало нативной возможностью |
| Открытые веса | Qwen3.8-2.4T-A95B | В материалах не упоминается | — |
По этой таблице видно логику апгрейда: общий масштаб не меняется, вычислений на один проход меньше, пространство для вывода больше. Снижение активных параметров с 95B до 71B — базовая предпосылка для понижения каталожной цены; а максимальный вывод в 393K напрямую меняет выполнимость таких задач, как длинные отчёты и генерация больших фрагментов кода.
Стоит предупредить: значение reasoning_effort по умолчанию сменилось с xhigh на high. Если в вашем коде этот параметр не задан явно, то после смены ID модели реально используемый уровень рассуждений изменится — об этом ещё раз напомним в списке миграции.
Изменения архитектуры Qwen4-Max: как три новшества влияют на использование
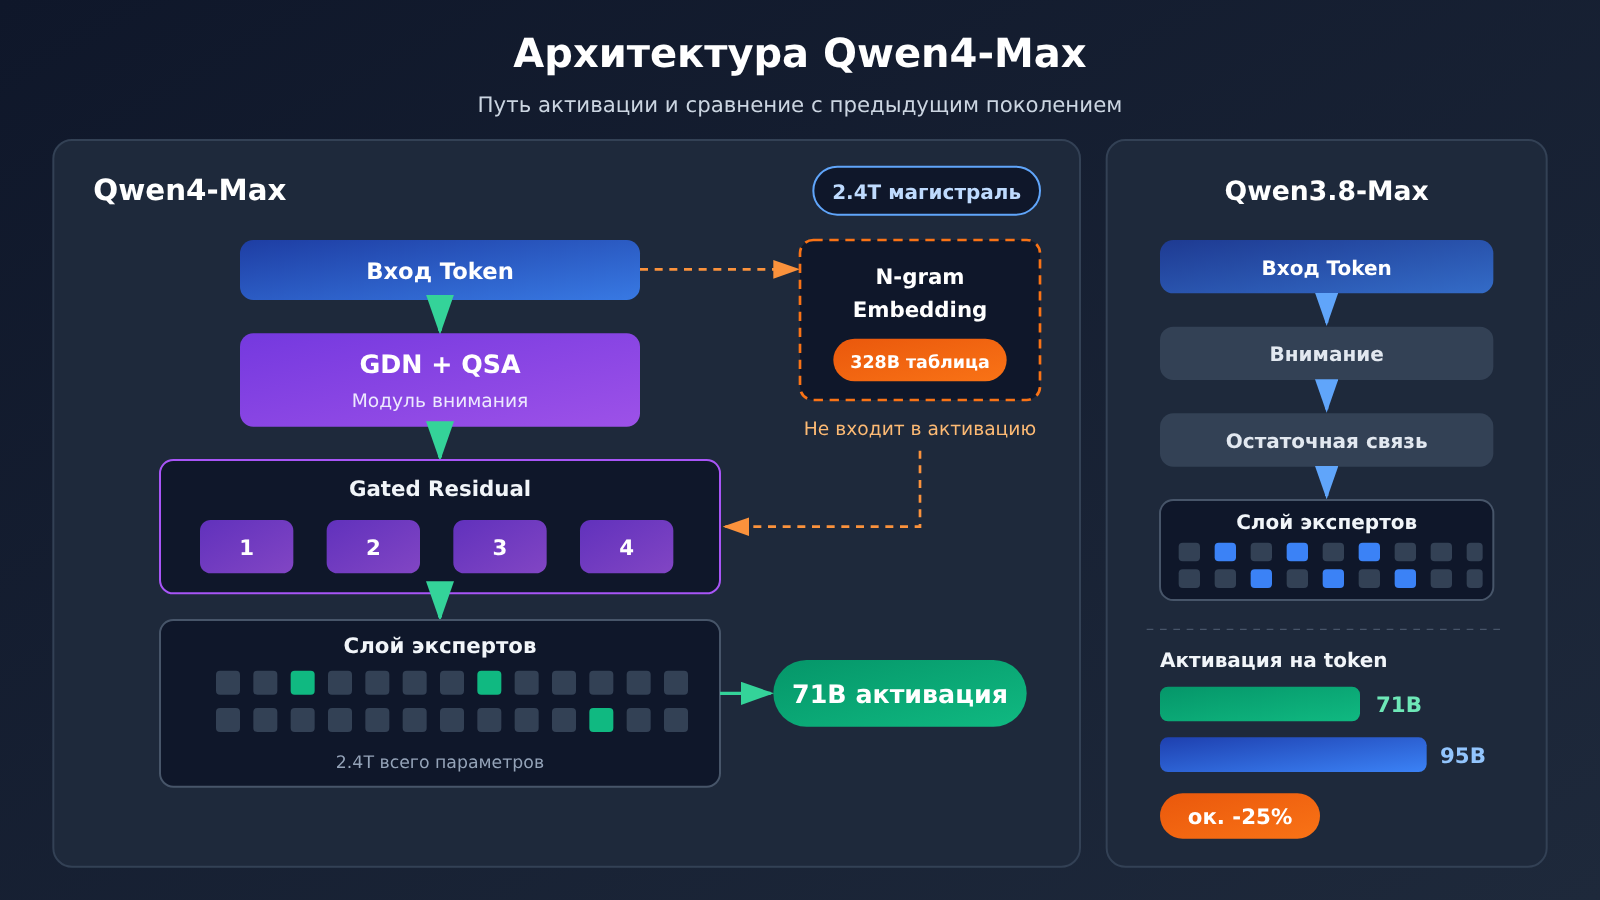
Официальный блог свёл архитектурные изменения Qwen4-Max к трём пунктам: GDN + QSA, четыре ветви Gated Residual и N-gram Embedding. Пользователям API не нужно разбираться в деталях реализации по слоям, но стоит понимать, на что влияет каждое из этих изменений.
GDN + QSA: изменения на уровне внимания
Это перестройка структуры внимания. Официально её представляют вместе с контекстом в 1M и максимальным выводом в 393K, и, как мы понимаем, она в первую очередь работает на вычислительную эффективность в сценариях с длинными последовательностями. Для вызывающей стороны ощутимый результат такой: при том же контекстном окне в 1M Qwen4-Max выдаёт более длинный вывод, да ещё и по более низкой цене за единицу.
Четыре ветви Gated Residual
Остаточные связи расширили до четырёх ветвей с гейтированием. Подобные изменения обычно влияют на стабильность обучения и на переток информации между разными способностями, а в итоге отражаются на поведении модели. Практическое следствие: даже если промпт совсем не меняется, стиль вывода Qwen4-Max и длина шагов рассуждения могут отличаться от предыдущего поколения, поэтому промпты, тонко настроенные под Qwen3.8-Max, нужно прогонять через регрессионные тесты.
N-gram Embedding: 328B параметров — это ещё не объём вычислений
Параметры Qwen4-Max записываются так: «2.4T основной ствол / 71B активация + 328B N-gram Embedding». По обычной практике такие эмбеддинги относятся к табличным параметрам (поиск по таблице) и не входят в расчёт активации основного ствола на каждый токен, поэтому нельзя просто прибавлять 328B к объёму активации и сравнивать. С реальной стоимостью инференса связано другое: 71B против 95B, то есть примерно на 25% меньше активации на каждом шаге.
На уровне предобучения официально сообщается, что Qwen4-Max-Base показывает самый низкий BPB (биты на байт, чем меньше — тем лучше) по всем четырём внутренним наборам тестов — знания, код, вопросы-ответы, STEM — примерно на 5–13% ниже, чем у Qwen3.8-Max-Base. Это внутренние оценки компании, но они хотя бы говорят о том, что сама база улучшилась, и последующий рост в бенчмарках не держится только на постобучении.
Сравнение бенчмарков Qwen4-Max: где прирост большой, а где почти ничего не изменилось
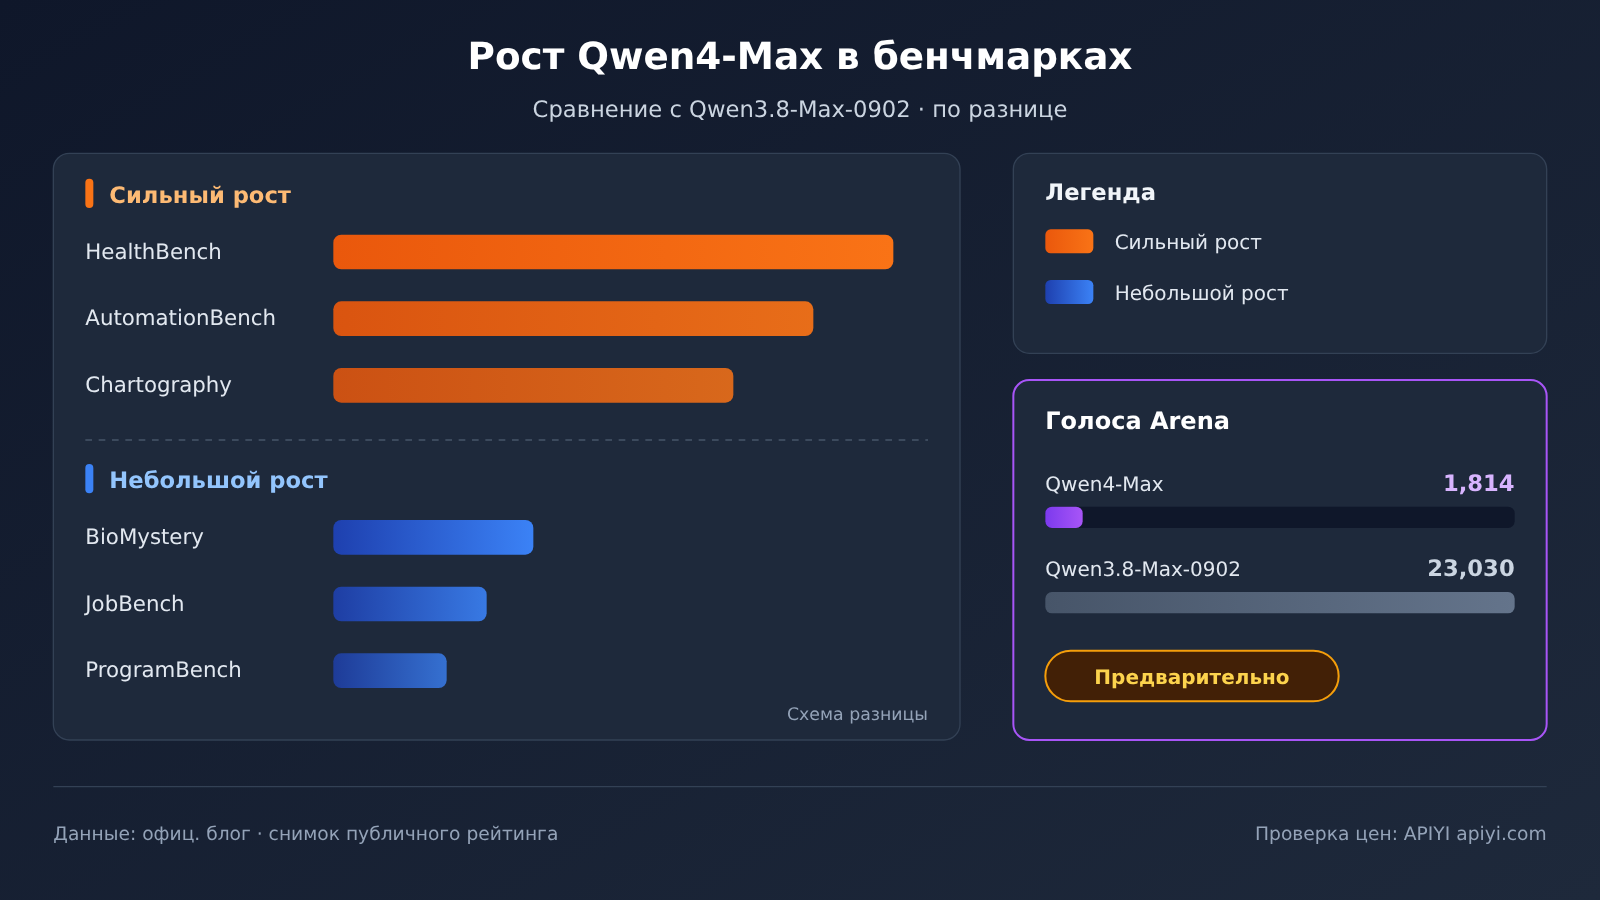
Все данные ниже взяты из одной и той же сводной таблицы Alibaba — это официальные цифры самой компании, а точка отсчёта — Qwen3.8-Max-0902 (версия с сентябрьским обновлением). Мы выстроили их по убыванию прироста, чтобы сразу было видно, на чём именно сосредоточена выгода от апгрейда.
| Бенчмарк (официальные данные) | Qwen3.8-Max-0902 | Qwen4-Max | Разница | Оценка прироста |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | заметный |
| CodeArena | 1676 | 1750 | +74 | заметный |
| HealthBench | 39.6 | 60.0 | +20.4 | очень заметный |
| AutomationBench | 56.2 | 72.5 | +16.3 | очень заметный |
| Chartography | 42.0 | 54.2 | +12.2 | заметный |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | заметный |
| APEX-Agents | 63.3 | 72.1 | +8.8 | заметный |
| HLE | 43.9 | 51.7 | +7.8 | заметный |
| DeepSWE | 69.3 | 75.7 | +6.4 | средний |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | средний |
| Video-Index | 63.2 | 68.1 | +4.9 | средний |
| ProgramBench | 28.0 | 31.5 | +3.5 | небольшой |
| JobBench | 65.3 | 68.5 | +3.2 | небольшой |
| BioMystery | 84.1 | 85.0 | +0.9 | почти без изменений |
Сильнее всего подтянулись задачи из категории агентов и вызова инструментов: AutomationBench +16.3, Terminal-Bench +9.6, APEX-Agents +8.8. Если ваш сценарий — это многошаговые вызовы инструментов, работа в терминале или автоматизированные процессы, то именно здесь апгрейд даёт максимальную отдачу. HealthBench вырос с 39.6 до 60.0, Chartography прибавил 12.2 — то есть медицинские вопросы-ответы и понимание графиков тоже относятся к сильным сторонам этого поколения.
С другой стороны, BioMystery прибавил всего 0.9, а JobBench и ProgramBench — чуть больше трёх пунктов. На таких задачах предельная польза от апгрейда невелика: если ваш основной сценарий как раз из этой области, одних бенчмарков для решения об обновлении недостаточно — смотреть нужно прежде всего на стоимость. Официально приведён ещё Work360: 52.69 против 47.74, то есть выше на 4.95, что тоже средний прирост.
По безопасности официальные данные такие: доля двойного прохождения на уровне функций в Last Secure Code Bench выросла с 22.0% до 31.8%, а одновременная безопасность по трём уровням гранулярности — с 8% до 14.7%. В абсолютных числах это по-прежнему немного, сгенерированный код всё равно нужно проверять на безопасность, но относительный прирост заметный.
Сторонний рейтинг Arena: место в Preliminary с 1 814 голосами
Официальные 1750 баллов CodeArena видны и в стороннем рейтинге arena.ai Code Arena WebDev. Ниже — снимок публичного рейтинга, 2026-11-14:
- Qwen4-Max (xHigh): 1750 баллов, 6-е место, пометка Preliminary, 1 814 голосов, $4.18 за задачу
- Qwen3.8-Max (0902): 1676 баллов, 16-е место, 23 030 голосов, $1.91 за задачу
- Qwen3.8-Max: 1670 баллов, 18-е место
Второй момент, который легко преувеличить: у Qwen4-Max всего 1 814 голосов, а у предыдущей версии 0902 — 23 030, разница примерно в 12 раз. Пометка Preliminary означает, что рейтинг ещё сходится и 6-е место может измениться, так что сейчас при упоминании лучше писать «предварительное 6-е место».
В снимке есть ещё одна примечательная деталь: Qwen4-Max выступает в режиме xHigh, и стоимость задачи у него $4.18 — выше, чем $1.91 у Qwen3.8-Max 0902. Это не противоречит официальному заявлению о «снижении стоимости одной задачи», потому что и уровни, и типы задач разные, но напоминает: на максимальном уровне рассуждений Qwen4-Max не обязательно экономнее.
Цены и затраты Qwen4-Max: насколько реальна экономия
Апгрейд, по сути, сводится к смене модели, и перед тем как решаться, нужно сверяться с ценами. В таблице ниже — официальные прайсовые цены двух поколений и текущая цена qwen3.8-max, который сейчас продаётся в APIYI; все значения указаны за 1M tokens, данные на 2026-11-16.
| Статья тарификации (за 1M tokens) | Qwen3.8-Max официально (Сингапур) | Qwen4-Max официально | Qwen4-Max официально в юанях | APIYI qwen3.8-max текущая цена |
|---|---|---|---|---|
| Ввод | $2 | $1.5 | ¥10 | $1.65 |
| Вывод | $6 | $4.5 | ¥30 | $4.95 |
| Чтение кэша | $0.25 | $0.075 | ¥0.5 | $0.20625 |
| Запись кэша (5 минут) | в официальном блоге не указано | $1.875 | ¥12.5 | в документации отдельно не указано |
| Запись кэша (1 час) | в официальном блоге не указано | $3 | ¥20 | в документации отдельно не указано |
Ввод и вывод подешевели на 25% каждый, чтение кэша — с $0.25 до $0.075, то есть примерно на 70%: это самое заметное изменение в новом прайсе. С другой стороны, у Qwen4-Max явно указаны две тарификации записи кэша — на 5 минут и на 1 час, так что приложениям, которые часто переиспользуют длинные префиксы, придётся закладывать эти затраты на запись в бюджет.
Экономия токенов: 20–30% по Work360, 40–50% по Terminal-Bench
Официально заявленная экономия токенов приводится в двух наборах данных. На Work360 в режиме Xhigh расход меньше на 24%, в режиме High — на 35%, отсюда и берётся «экономия в 20–30%». На Terminal-Bench 4.0 цифры ещё внушительнее — 48% и 49% соответственно.
Для терминальных задач экономия заметно больше, что, вероятно, связано с меньшим числом раундов работы с инструментами. При планировании бюджета для обычных офисных задач надёжнее ориентироваться на 20–30%, а 40–50% применимы только к сценариям терминальных операций, похожим на Terminal-Bench.
Те 11 процентных пунктов, из-за которых 62% и 51% не сходятся
Это первое место, где цифры легко завысить. Официально стоимость одной задачи снизилась с $4.43 до $1.67 — это около 62% в долларах; в китайской версии указано снижение с ¥26.58 до ¥11.16, то есть примерно 58%. Сами эти два набора цифр уже расходятся.
Если считать по официальным же данным: токенов на 35% меньше, цена за единицу на 25% ниже — перемножение даёт лишь около 51% снижения, то есть 0.65 × 0.75 ≈ 0.49. Оставшиеся ~11 процентных пунктов официально никак не объясняются. Мы предполагаем, что они могут складываться из выигрыша от попаданий в кэш за счёт резкого снижения цены чтения из кэша (примерно −70%), а также из сокращения числа раундов вызова инструментов. Но это лишь наше предположение, а не официальное объяснение.
Надёжный подход такой: считать 51% ориентировочным верхним пределом «при том же проценте попаданий в кэш», а 62% могут быть близки к реальности только в сценариях с высоким процентом попаданий в кэш и большим числом раундов работы с инструментами. Для вашего конкретного бизнеса самый надёжный ориентир — один раз прогнать сравнение стоимости одной задачи на реальном трафике.
Текущие цены и статус в каталоге APIYI
В APIYI сейчас продаётся qwen3.8-max: вход $1.65, выход $4.95, чтение из кэша $0.20625. Если верить документации, это на 17,5% ниже, чем $2 / $6 у Alibaba Cloud. Столько же стоит qwen3.8-max-0902, а версия с открытыми весами qwen3.8-2.4t-a95b — $1.72 / $5.16 / $0.215.
На момент повторной проверки 2026-11-16 11:00 qwen4-max ещё не было ни в документации моделей APIYI, ни в прайс-листе (всего 284 модели) — модель пока не добавлена. Мы как можно скорее её добавим; название модели и цена будут соответствовать списку моделей на платформе APIYI apiyi.com. Честно говоря, официальная цена Qwen4-Max уже ниже текущей цены qwen3.8-max на платформе, так что после добавления стоит ещё раз перепроверить расчёты.
Миграция с Qwen3.8-Max на Qwen4-Max: чек-лист
Многие думают, что апгрейд — это просто замена одного ID модели. На самом деле изменились параметры по умолчанию, границы контекста и тарификация кеша. Чек-лист ниже упорядочен по принципу «если не изменить — начнутся проблемы».
| Пункт проверки | Текущее состояние Qwen3.8-Max | После миграции на Qwen4-Max | Рекомендуемое действие |
|---|---|---|---|
| ID модели | qwen3.8-max / qwen3.8-max-0902 |
Ориентироваться на список моделей платформы | Переключаться после появления в каталоге, сначала поэтапное развёртывание |
| Значение reasoning_effort по умолчанию | xhigh | high | Явно указывать уровень, чтобы поведение не изменилось незаметно |
| Верхний предел max_tokens | 128K | 393K | Проверить настройки обрезки, хранения и таймаутов в downstream-системах |
| Максимальный вход | 1M | 991K (в режиме рассуждений — 983K) | Сверхдлинные входы около 1M нужно обрезать |
| Тарификация кеша | Чтение кеша $0.25 | Чтение кеша $0.075, плюс отдельные цены записи за 5 минут / 1 час | Пересмотреть стратегию префиксов кеша и TTL |
| Визуальный вход | Ввод изображений | Нативное зрение | Заново прогнать регрессию по сценариям с изображениями |
| Промпт и формат вывода | Уже оптимизированы под предыдущее поколение | Архитектура изменена, поведение может отличаться | Прогнать регрессию на фиксированном наборе тестов |
| Мониторинг затрат | Считается по токенам | И токены, и цена за токен снижаются | Смотреть на стоимость одной задачи, а не на цену за токен |
Самое легко упускаемое в этом списке — reasoning_effort. У Qwen3.8-Max по умолчанию xhigh, у Qwen4-Max — high. Если в коде уровень явно не задан, после переключения можно и сэкономить токены, и получить результат хуже ожидаемого на сложных задачах рассуждения. В официальных данных по экономии токенов приводятся обе ступени — Xhigh и High, — так что советую и вам измерить обе, а потом решить, какую использовать в продакшене.
Второй момент — длина вывода. Лимит 393K означает, что один ответ может быть намного длиннее, чем раньше. Если системы логирования, поля базы данных и таймауты шлюза рассчитаны на вывод в 128K, их нужно заранее расширить. Максимальный вход сократился с 1M до 991K (в режиме рассуждений — 983K). Для бизнеса, который в обычной жизни не упирается в лимит, это почти не заметно, а вот сценарии, где документы забиваются под самую границу, начнут сразу получать ошибку.
Как подключаться через APIYI на текущем этапе
Если вы уже подключены через APIYI, base_url — https://api.apiyi.com/v1, используется протокол, совместимый с OpenAI, и в поле модели достаточно указать qwen3.8-max, чтобы продолжать работать в продакшене. Тем, кому нужно зафиксировать поведение сентябрьского релиза, можно перейти на qwen3.8-max-0902 — цена та же.
Когда qwen4-max появится на платформе, протокол останется прежним, поэтому на уровне кода миграция сводится к замене поля model, а дальше по чек-листу выше нужно добить reasoning_effort и max_tokens. Рекомендую сначала перевести 5%–10% трафика на поэтапное развёртывание, сравнить стоимость одной задачи и бизнес-метрики, и только потом включать на всех.
🚀 Совет по миграции: проекты, которые сейчас работают через APIYI apiyi.com, продолжают использовать
qwen3.8-max, а параллельно готовят набор тестов и переключатель для поэтапного развёртывания; ID меняем после появленияqwen4-maxв каталоге — так не возникнет ситуации, когда бизнес простаивает в ожидании новой модели.
Рекомендации по сценариям для Qwen4-Max и Qwen3.8-Max
Где стоит в первую очередь оценить переход на Qwen4-Max
- Многошаговые вызовы инструментов и автоматизация: в AutomationBench, Terminal-Bench и APEX-Agents заметный рост, а экономия токенов максимальна как раз на терминальных задачах.
- Задачи со сверхдлинным выводом: если нужно за один раз сгенерировать отчёт, код или документ длиннее 128K, это под силу только Qwen4-Max с его 393K.
- Медицинские вопросы и понимание диаграмм: HealthBench +20.4, Chartography +12.2 — самые заметные улучшения в этом поколении.
- Когда важна безопасность кода: доля прохождения обеих проверок безопасности выросла с 22.0% до 31.8%, но процесс ревью всё равно нужен.
- Приложения с высокой долей повторного использования кэша: цена чтения из кэша упала примерно на 70%, больше всего выигрывают сценарии с длинными системными промптами и фиксированными префиксами базы знаний.
Где лучше остаться на Qwen3.8-Max
- Всё уже стабильно в продакшене, промпты глубоко настроены: Qwen3.8-Max по-прежнему надёжная рабочая модель, и апгрейд ради апгрейда не нужен.
- Основные задачи похожи на BioMystery и JobBench: там прирост скромный, и затраты на миграцию могут перекрыть выгоду.
- Нужно самостоятельное развёртывание с открытыми весами: у Qwen3.8-2.4T-A95B открытые веса есть, а про версию Qwen4-Max с открытыми весами в материалах ничего не сказано.
- Вызовы идут через APIYI и решение нужно прямо сейчас: пока
qwen4-maxне появился в каталоге,qwen3.8-max— готовый вариант.
| Ваша ситуация | Рекомендация |
|---|---|
| В центре агенты и вызовы инструментов, хочется снизить затраты | Сначала оцените Qwen4-Max, замерьте стоимость на тарифе High |
| Нужен одиночный вывод длиннее 128K | Только Qwen4-Max |
| Стабильно в продакшене, в основном общие вопросы-ответы | Оставьте Qwen3.8-Max, а в свободное время прогоняйте регрессионные тесты |
| Нужно самостоятельное развёртывание с открытыми весами | Продолжайте использовать Qwen3.8-2.4T-A95B |
| Сейчас подключение идёт через APIYI | Продолжайте работать с qwen3.8-max, а после появления в каталоге переключите постепенно (canary) |
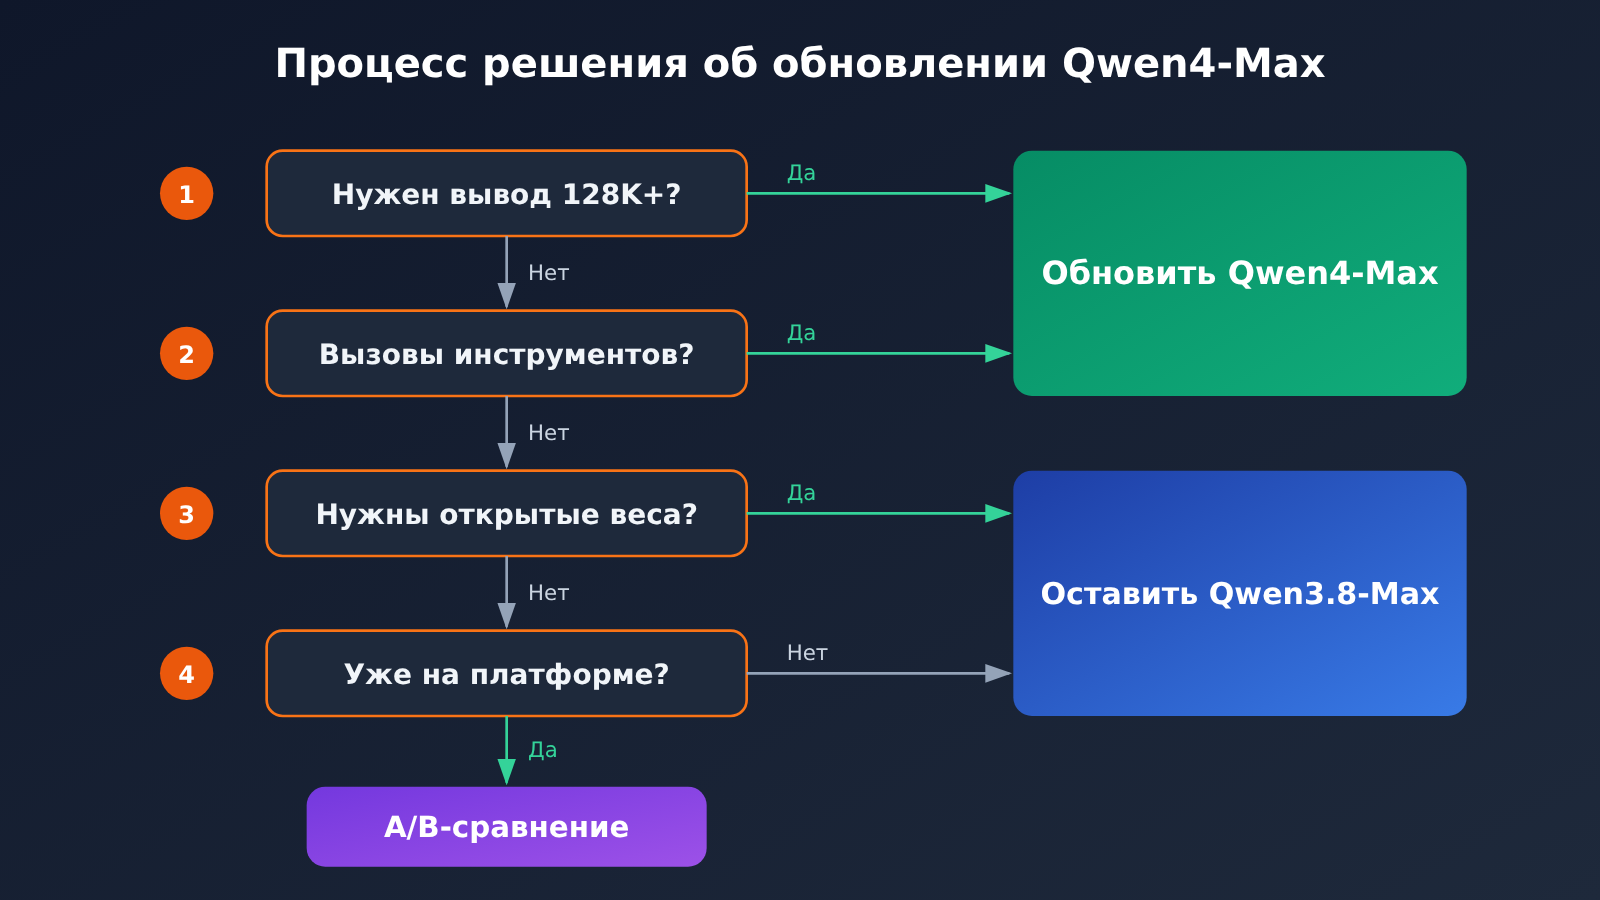
Qwen4-Max против Qwen3.8-Max: что выбрать
Если свести всё к одной фразе: сценарии с ИИ-агентами, длинные ответы и задачи с интенсивным кэшированием стоит обновлять, а с обычными стабильными задачами можно не торопиться. Из трёх плюсов обновления снижение цены на 25% — факт; экономия токенов на 20–30% — официальные данные на отдельных бенчмарках; а снижение стоимости одной задачи на 62% можно приблизить только при подходящих условиях кэширования и количестве раундов вызова инструментов в вашем сценарии.
💡 Рекомендация по выбору: прежде чем принимать решение, прогоните по одному набору своих реальных задач на каждой модели и сравните стоимость одной задачи и качество результата, а не ориентируйтесь только на таблицу бенчмарков. С помощью APIYI apiyi.com можно одним и тем же API-ключом сначала снять baseline на
qwen3.8-max, а после выходаqwen4-maxсразу сравнить его в том же коде.
Частые вопросы (FAQ)
Вопрос 1: Какая связь между Qwen4-Max и Qwen3.8-Max?
Обе модели — флагманы Tongyi Qianwen уровня 2,4T. Qwen3.8-Max вышла 2026-08-03, версия 0902 — это обновление сентября; Qwen4-Max вышла 2026-11-16, у неё другая архитектура, число активных параметров на каждый проход снизилось с 95B до 71B, лимит вывода поднят до 393K, а заявленная цена снижена на 25%.
Вопрос 2: Если экономишь 20–30% токенов, счёт уменьшится на те же 20–30%?
Не только, и не обязательно. Сама цена за единицу уже упала на 25%, а вместе с сокращением числа токенов теоретически стоимость той же задачи может снизиться примерно на 51%. Но данные об экономии токенов взяты из официального бенчмарка Work360 — сколько сэкономит именно ваш сценарий, надо проверять на практике; если использовать режим xhigh, как видно из снимка Arena, стоимость одной задачи может, наоборот, вырасти.
Вопрос 3: Qwen4-Max занимает 6-е место в Arena — можно ли доверять этому результату?
Пока это лишь предварительный результат. В снимке публичного рейтинга (2026-11-14) у Qwen4-Max всего 1 814 голосов и пометка Preliminary, а у предыдущего поколения 0902 — 23 030 голосов, разница примерно в 12 раз. Оценка 1750 совпадает с официально заявленной, но позиция ещё изменится по мере накопления голосов.
Вопрос 4: Можно ли уже сейчас вызвать qwen4-max через APIYI?
По состоянию на 2026-11-16 11:00 — нет, `qwen4-max` пока не добавлена в каталог, но мы добавим её в ближайшее время. Сейчас доступны `qwen3.8-max`, `qwen3.8-max-0902` и версия с открытыми весами `qwen3.8-2.4t-a95b`; актуальные модели и цены смотрите в списке моделей на платформе APIYI apiyi.com, а новым пользователям можно сначала прогнать базовый замер на бесплатном тестовом лимите.
Вопрос 5: При миграции достаточно поменять только ID модели?
Нет, недостаточно. Как минимум нужно явно задать `reasoning_effort` (значение по умолчанию меняется с xhigh на high), при необходимости увеличить `max_tokens` и лимиты нижележащего хранилища, проверить сверхдлинные входы около 1M и заново оценить стоимость записи в кэш. На уровне протокола, если вы работаете через OpenAI-совместимый интерфейс `https://api.apiyi.com/v1`, в коде достаточно изменить поле model.
Вопрос 6: Стоит ли продолжать пользоваться Qwen3.8-Max?
Стоит. Она по-прежнему флагман уровня 2,4T: контекст 1M, вывод 128K, режимы с рассуждением и без него — всё на месте, плюс есть версия с открытыми весами. На таких бенчмарках, как BioMystery и JobBench, Qwen4-Max улучшилась совсем немного, так что для подобных задач стабильно работающая Qwen3.8-Max вполне может и дальше нести производственную нагрузку.
Qwen4-Max против Qwen3.8-Max: главные выводы
- Тот же масштаб, меньше активаций: магистраль 2.4T не изменилась, активация на каждый вызов снизилась с 95B до 71B — примерно на 25%.
- Цена за единицу ниже на 25%: ввод $2→$1.5, вывод $6→$4.5, чтение кэша дешевле примерно на 70%, при этом появилась плата за запись в кэш.
- Объём вывода вырос примерно втрое: максимальный вывод 128K→393K, максимальный ввод сокращён до 991K.
- Рост сосредоточен в агентных задачах: AutomationBench, Terminal-Bench и HealthBench заметно подросли, а BioMystery почти не сдвинулся.
- Два места, где не стоит преувеличивать: из 62% снижения затрат обоснованно выводится только около 51%, а 6-е место в Arena — это всего 1 814 голосов и статус Preliminary.
- Миграция — не только смена ID: следите за значением по умолчанию
reasoning_effort, лимитомmax_tokensи стратегией кэширования. - Статус в APIYI:
qwen4-maxпока не появился в каталоге, продолжайте работать сqwen3.8-max, а после публикации переключитесь постепенно.
Итог
Главные выводы из сравнения Qwen4-Max и Qwen3.8-Max:
- Затраты: снижение цены за единицу на 25% — это гарантированный выигрыш. Экономию токенов в 20–30% нужно подтверждать замером именно на вашем сценарии, а в 62% снижении около 11 процентных пунктов непонятно откуда берутся.
- Возможности: агентные задачи, вызов инструментов, медицина и работа с диаграммами заметно подросли, часть бенчмарков почти не изменилась, и все цифры — из официальных заявлений вендора.
- Миграция: протокол не меняется, но уровень рассуждений по умолчанию, лимит вывода и биллинг кэша стали другими — нужно проверять по чек-листу пункт за пунктом.
Qwen3.8-Max остаётся надёжной рабочей моделью, а обновление должно быть постепенным решением, подкреплённым данными, а не мгновенным переключением всего трафика при виде новой версии. Рекомендую сначала через APIYI apiyi.com собрать базовые показатели стоимости и качества на qwen3.8-max, а после появления qwen4-max сравнить их напрямую в рамках одного и того же интерфейса.
📚 Справочные материалы
- Официальный блог Qwen3.8: примечания к выпуску Qwen3.8-Max с параметрами, контекстом и официальными ценами
- Ссылка:
qwen.ai/blog?id=qwen3.8 -
Пояснение: источник спецификаций предыдущего поколения и цен для региона Сингапур
-
Hugging Face — Qwen3.8-2.4T-A95B: версия Qwen3.8 с открытыми весами
- Ссылка:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
Пояснение: карточка модели и загрузка весов для самостоятельного развертывания
-
Официальный блог Qwen: анонс Qwen4-Max и сравнение результатов бенчмарков на одном графике
- Ссылка:
qwen.ai/blog -
Пояснение: источник данных об изменениях архитектуры, официально заявленных результатах бенчмарков, затратах на токены и стоимость одного задания
-
arena.ai Code Arena WebDev: сторонний лидерборд сравнения моделей
- Ссылка:
arena.ai - Пояснение: в статье используется снимок от 2026-11-14; позиции меняются в зависимости от количества голосов
Автор: техническая команда APIYI
Обратная связь по техническим вопросам: свяжитесь с нами на главной странице сайта APIYI; модели и цены можно посмотреть в центре документации docs.apiyi.com


