
Примечание автора: разбираемся, откуда взялись 64,9% Claude Fable 5.2 на RoboDojo Sim, насколько результат отличается от Opus 5.5 и GPT-6 Astra, чего он не доказывает и какие цены и ограничения нужно учесть перед подключением.
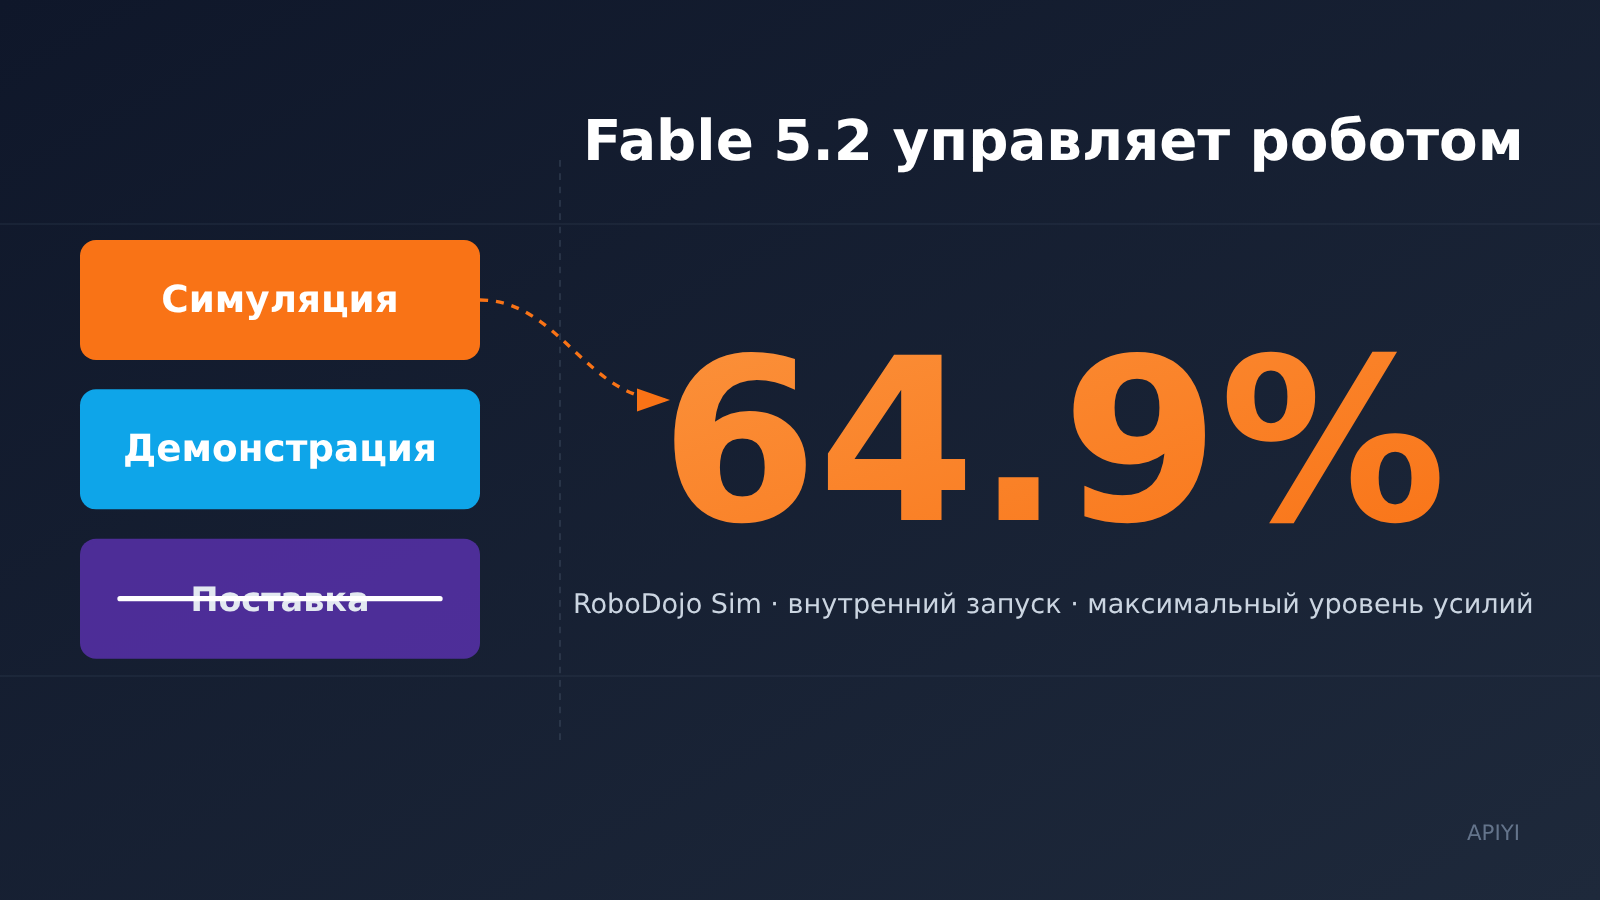
Сначала — главное. На RoboDojo Sim, в условиях внутреннего запуска Anthropic и с максимальным уровнем усилий, результаты такие: Claude Fable 5.2 набрал 64,9%, Opus 5.5 — 39,4%, GPT-6 Astra — 29,8%, а Fable 5.1 — 27,6%. Это результат работы модели с изображениями с камер и управления симулированными роботизированными руками, а не данные о внедрении на заводах.
Это не рекламная статья в духе «наступила эра роботов». Ниже разберём отдельно результаты симуляции, демонстрационные видео и реальные внедрения. Если вы собираетесь подключить API и подсчитать расходы, после прочтения сможете решить, стоит ли уже сейчас менять технический подход ради этих 64,9%.
Главное: разобраться, что именно доказывают 64,9% Fable 5.2, чего они не доказывают и какую модель уже можно использовать для предварительной проверки.
Что на самом деле означает результат 64,9% у Claude Fable 5.2
Объяснить эту цифру можно в трёх предложениях. RoboDojo — открытый бенчмарк, который проверяет, может ли модель управлять двуручным роботом в симулированной среде по изображениям с камеры. В сноске к анонсу указано, что результат 64,9% получен Anthropic при внутреннем тестировании с максимальным уровнем усилий. По состоянию на 2026-11-10 нам не удалось найти эту же цифру на открытой странице рейтинга RoboDojo, поэтому называть модель «лидером открытого рейтинга» нельзя — тем более утверждать, что это «лучшая в мире модель для робототехники».
Ниже приведено сравнение RoboDojo Sim из анонса Anthropic от 2026-11-09:
| Модель | RoboDojo Sim | Отставание от Fable 5.2 | Примечание |
|---|---|---|---|
| Claude Fable 5.2 | 64,9% | — | Внутреннее тестирование, максимальный уровень усилий |
| Claude Opus 5.5 | 39,4% | Ниже на 25,5 п. п. | Та же таблица |
| GPT-6 Astra | 29,8% | Ниже на 35,1 п. п. | Тестирование проводила Anthropic, а не OpenAI |
| Claude Fable 5.1 | 27,6% | Ниже на 37,3 п. п. | Предыдущее поколение |
| Gemini 4 Carbon | В таблице значение не указано | Сравнить нельзя | Нет данных — это не нулевой результат |
Переход с 27,6% до 64,9% — это более чем двукратный рост относительно предыдущего поколения. На фоне всей таблицы результат особенно заметен. Но у него есть три важных условия: симулированная среда, внутреннее тестирование и максимальный уровень усилий. Если изменить хотя бы одно из них — например, перейти к тестированию на реальном роботе, независимой проверке или настройке усилий по умолчанию, — эту цифру уже нельзя будет напрямую переносить на новые условия.
Как связаны Fable 5.2 и Mythos 5.2
В анонсе прямо сказано: Claude Fable 5.2 и Claude Mythos 5.2 основаны на одной и той же базовой модели. У Fable усилены механизмы защиты от угроз в области кибербезопасности и биобезопасности, поэтому он доступен всем пользователям. Mythos доступен только организациям, прошедшим проверку в рамках программ по биобезопасности или кибербезопасности. Mythos — не «другая, более мощная модель». Для оценки возможностей в робототехнике достаточно рассматривать Fable 5.2.
Официальные идентификаторы моделей:
- Claude API, Google Cloud, Microsoft Foundry, Claude Platform on AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - Для Mythos:
claude-mythos-5-2иanthropic.claude-mythos-5-2
Ключевые возможности Fable 5.2 в управлении роботами: что показано в демонстрациях
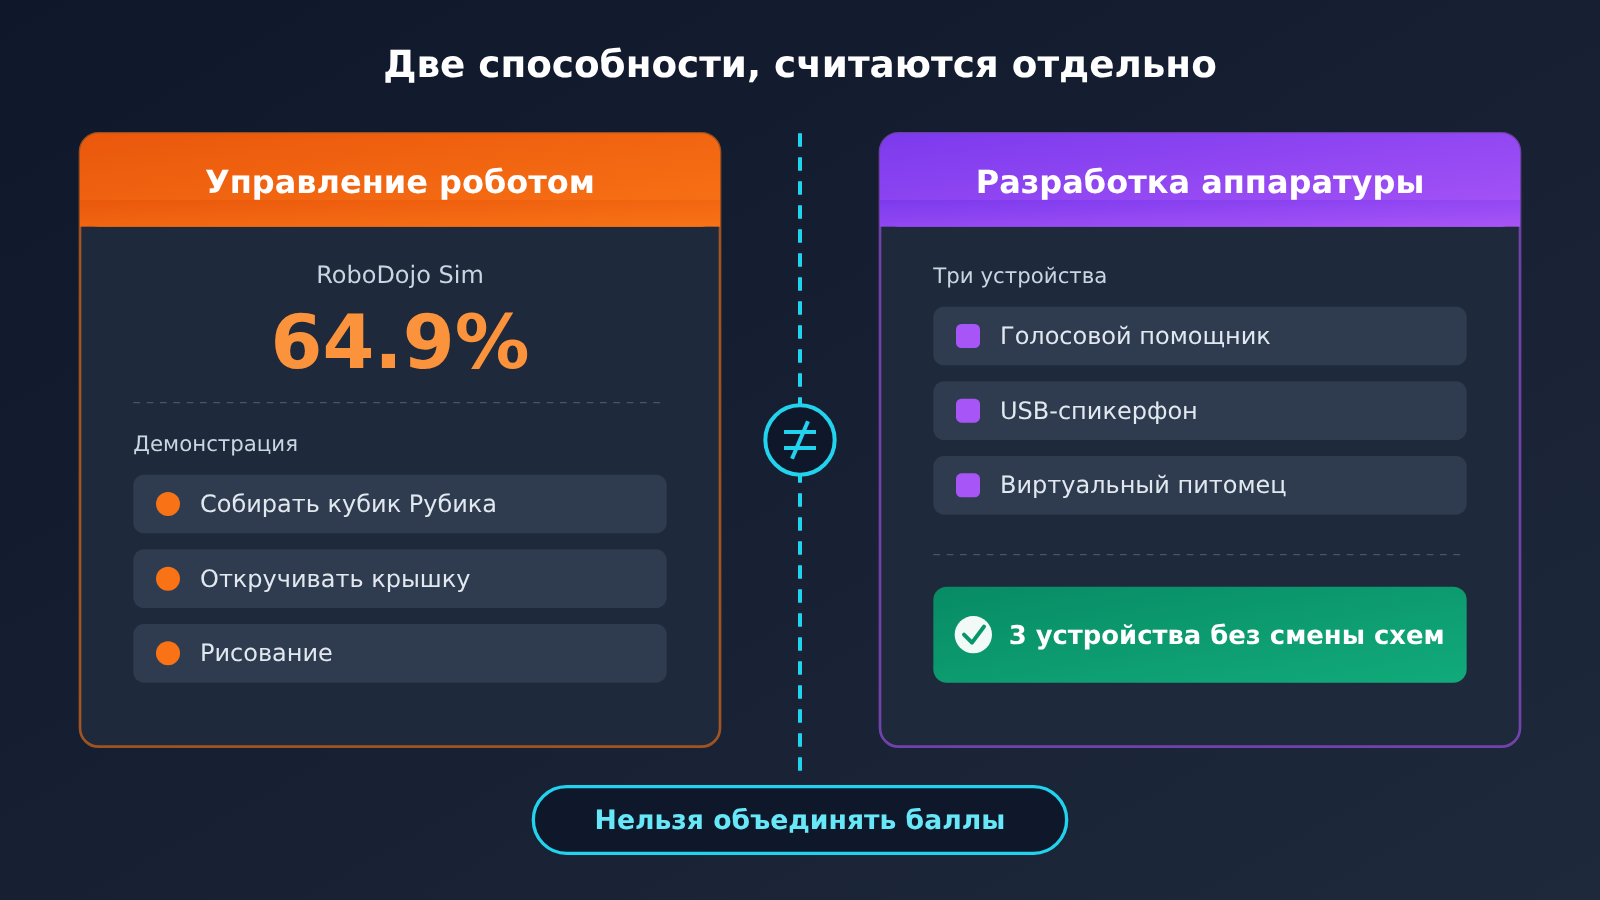
В анонсе говорится, что Fable 5.2 управляет физическими роботами заметно лучше, чем более ранние модели Claude, в том числе справляется с задачами, для которых его специально не обучали. В сопроводительном видео показаны три сценария: сборка кубика Рубика, откручивание крышки бутылки и рисование робота.
К этим материалам стоит относиться именно как к демонстрациям из анонса. Они показывают, что модель выполнила эти действия в определённых условиях, но не позволяют судить об успешности, количестве повторных попыток или доле неудач. И это не значит, что Anthropic выпустила готовый пакет навыков для установки на робота. Заявление о задачах, для которых модель не проходила специального обучения, заслуживает внимания, но пока оно основано только на словах самой компании: данных для независимого воспроизведения результатов не представлено.
В анонсе также сказано, что Fable 5.2 превзошла другие передовые модели и большинство систем, специально разработанных для управления роботами, на одном и том же наборе тестов. Однако во второй части утверждения нет списка систем, поэтому непонятно, какие именно модели и версии сравнивали. Это можно считать сигналом о направлении развития, но не доказательством.
Модель выдаёт текст, а управляет внешний комплекс
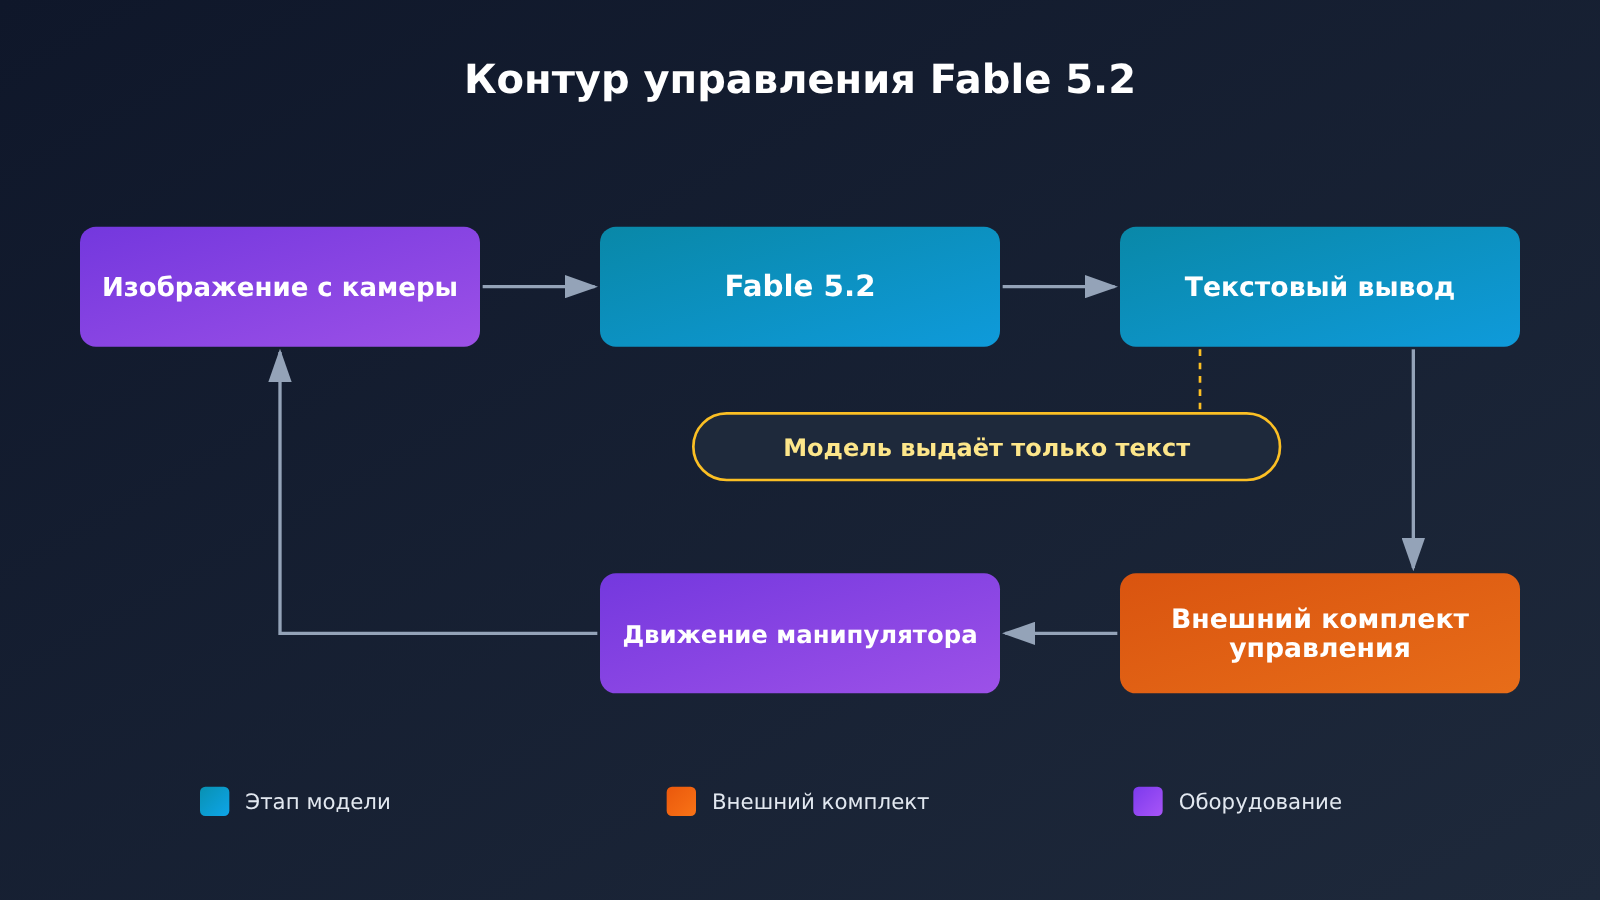
Этот нюанс проще всего упустить при просмотре демонстрационного видео. На странице модели указано, что Fable 5.2 принимает на вход текст и изображения, а выдаёт только текст. Она не посылает команды моторам напрямую: на каждом шаге внешний комплекс преобразует текст в действия, а затем передаёт модели новое изображение с камеры.
Поэтому в реальных условиях результат управления зависит и от модели, и от вашего комплекса: от того, как задано пространство действий, что происходит при ошибке разбора и приемлема ли задержка на один шаг. Результат 64,9% в RoboDojo получен на комплексе Anthropic. Неизвестно, как изменится оценка при использовании другого комплекса.
Данные тестирования Fable 5.2: результаты в робототехнике и управлении компьютером — это разные вещи
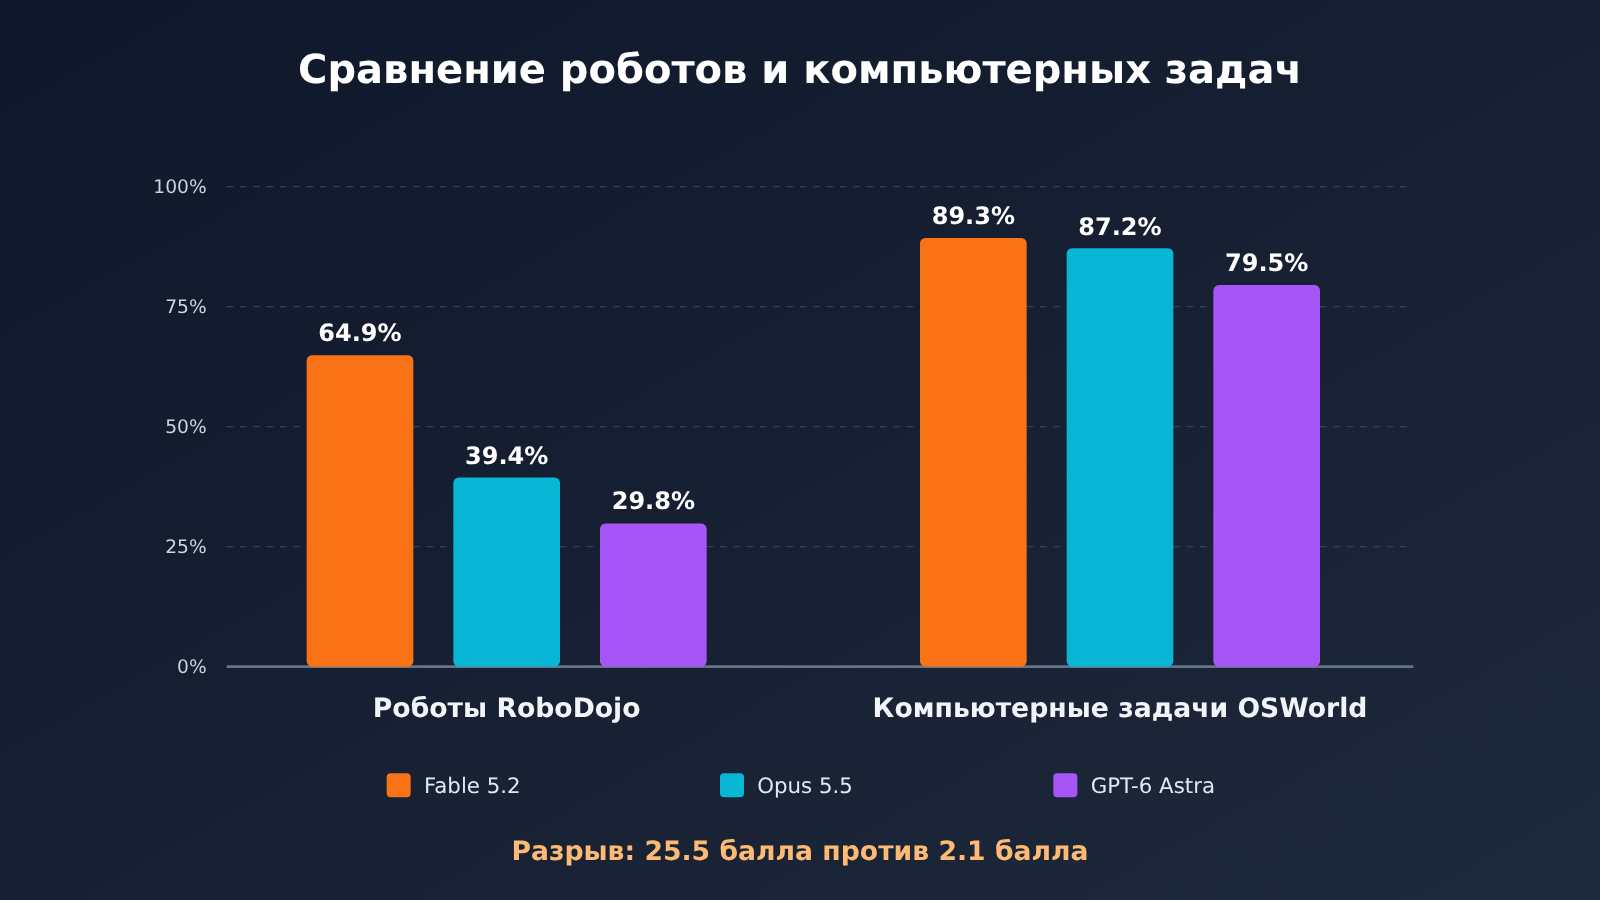
Увидев, что «Fable 5.2 очень хороша», многие сразу начинают сравнивать результаты по робототехнике с показателями в других задачах. В таблице ниже — данные из публикации Anthropic от 2026-11-09. Они показывают, насколько отличаются результаты в нескольких тестах, связанных с управлением:
| Тест | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Преимущество Fable 5.2 перед Opus 5.5 |
|---|---|---|---|---|
| RoboDojo Sim (симуляция работы двумя руками) | 64.9% | 39.4% | 29.8% | 25.5 п. п. |
| OSWorld 2.1 (управление компьютером, офлайн-часть набора) | 89.3% | 87.2% | 79.5% | 2.1 п. п. |
| AutomationBench | 51.4% | 42.5% | 41.4% | 8.9 п. п. (у Carbon результат выше — 53.9%) |
| Remote Labor Index (уровень High) | 41.3% | 21.3% | 20.8% | 20.0 п. п. |
В OSWorld 2.1 Fable 5.2 опережает Opus 5.5 всего на 2.1 п. п. Это совсем не тот масштаб, что разрыв между 39.4% и 64.9% в RoboDojo. Если вам нужен агент для задач по управлению компьютером, различие между Opus 5.5 и Fable 5.2 гораздо меньше, чем в тестах по робототехнике.
Уровень усилий: 64,9% — не результат при настройках по умолчанию
Если не указано иное, в таблице результатов из анонса приведены показатели, полученные при максимальном уровне усилий, доступном для каждой модели на тот момент. По умолчанию в Claude API для Fable 5.2 установлен уровень high, а в приложении Claude и Claude Code — Medium. То есть при вызове с настройками по умолчанию вы не обязательно получите результат 64,9%: он был достигнут с другой конфигурацией.
Максимальный уровень означает более длительное рассуждение и расход большего количества токенов. В робототехническом цикле, где нужно снова и снова принимать решения, рассуждение на максимальном уровне на каждом шаге увеличивает и задержку, и стоимость. В анонсе не указано, насколько снизится результат 64,9% на уровнях high или medium.
Сравнение характеристик: Fable 5.2, Opus 5.5 и GPT-6 Astra
| Параметр | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Контекстное окно | 1M | 1M | 1,050,000 |
| Максимальный вывод | 128K | 128K | 128,000 |
| Модальности ввода / вывода | Текст + изображения / текст | Текст + изображения / текст | Текст + изображения / текст |
| Уровень усилий по умолчанию в API | high | medium | Поддерживаются уровни от low до max |
| Уровень задержки | Moderate | Moderate | На официальной странице используется другая система оценки |
| Дата актуальности знаний | Июнь 2026 года | 2026-06 | 2026-04-30 |
Все три модели выдают текст — это общее ограничение, которое необходимо учитывать при управлении роботами.
Что не стоит засчитывать в робототехнические результаты Fable 5.2
Три электронных устройства — эксперимент по проектированию аппаратуры
В публикации есть ещё один эпизод: по короткому промпту Fable 5.2 спроектировала три работающих электронных устройства — домашнего голосового помощника, USB-спикерфон и портативного виртуального питомца. Проект выполнен совместно с Diode. Каждую плату изготовили менее чем за день, и все три устройства заработали без изменений в схемах.
Это демонстрация возможностей проектирования аппаратуры, не имеющая отношения к RoboDojo. Да и сами устройства не являются роботами. Если поставить этот результат рядом с показателем 64,9%, может сложиться впечатление, что модель умеет всё — от проектирования до управления. Но эти две истории никак не связаны.
Ограничения Fable 5.2: что может повлиять на контур управления
Ниже перечислены особенности, описанные на странице модели и в примечаниях к обновлению. Каждая из них напрямую влияет на построение контура управления:
- Принудительный вызов инструмента приводит к ошибке: если установить
tool_choiceвanyилиtool, API вернёт ошибку 400. Если ваш набор инструментов требует, чтобы модель обязательно вызывала инструмент для выполнения действия, разрешите ей выбирать самостоятельно и предусмотрите запасной вариант с разбором ответа. - Нельзя задать параметры сэмплирования: передача
temperature,top_pилиtop_kприведёт к ошибке 400. - Нельзя отключить рассуждения: адаптивный режим рассуждений всегда включён, а объём рассуждений можно регулировать только с помощью
effort. В примечаниях к обновлению указано, что при уровне medium и выше даже инструкция в промпте «не рассуждай, просто ответь» не остановит модель. - При длинных цепочках вызовов инструментов модель редко говорит: при последовательных вызовах инструментов ответ для пользователя может быть очень кратким, а иногда модель сразу вызывает инструмент, ничего не объяснив. Поэтому интерфейс мониторинга не должен рассчитывать на то, что модель сама будет сообщать о ходе работы.
- Модель может остановиться раньше времени: иногда она завершает ход, оставив список невыполненных задач, или застревает на обычном препятствии. При уровне low такое случается чаще.
- Отказ тоже расходует лимит: при отказе API возвращает HTTP 200, а
stop_reasonпринимает значениеrefusal. Такой ответ также расходует лимит запросов. - Хранение данных: данные хранятся 30 дней. Использовать режим нулевого хранения данных можно только с явного разрешения Anthropic.
Контур управления роботом должен обеспечивать выполнение действий на каждом шаге. В совокупности перечисленные особенности означают, что перед подключением модели нужно предусмотреть восстановление после тайм-аутов, пустых действий, отказов и преждевременной остановки.
Цены Fable 5.2: посчитайте расходы до подключения
Официальные цены указаны за миллион токенов. Данные взяты со страниц моделей, из примечаний к обновлениям и со страницы быстрого режима:
| Статья расходов | Fable 5.2 | Opus 5.5 | GPT-6 Astra (короткий контекст) |
|---|---|---|---|
| Стандартный ввод / вывод | $8 / $40 | $4 / $20 | $10 / $50 |
| Чтение кэша | $0.20 | $0.20 | $1 (кэшированный ввод) |
| Запись в кэш | 5 минут — $10, 1 час — $16 | Есть на официальной странице, здесь не указана | $12.5 |
| Пакетная обработка | С учётом скидки 50% — $4 / $20 | Та же скидка 50% | Здесь не указана |
| Быстрый режим | $16 / $80 | $8 / $40 | — |
Есть ещё несколько моментов, на которые стоит обратить внимание. Fable 5.2 на 20% дешевле Fable 5.1 ($10 / $50). Возможности быстрого режима не изменились, а скорость вывода может быть до 2.5 раза выше, чем в стандартном режиме. Однако официальные цены не указывают отдельно стоимость кэширования в быстром режиме. Если исходить из коэффициента, чтение кэша будет стоить примерно $0.40, запись в кэш на 5 минут — около $20, а на 1 час — около $32. Кэш промптов между режимами с разной скоростью не общий: при переключении с быстрого режима на стандартный произойдёт промах кэша. Если объём ввода GPT-6 Astra превышает 272K токенов, вся заявка тарифицируется с коэффициентом 2 для ввода и 1.5 для вывода.
В цикле работы бота на каждом шаге передаётся новое изображение, а системный промпт и описание действий почти не меняются. Такая схема позволяет снизить расходы за счёт кэширования, но ввод изображения и токены на рассуждения на каждом шаге сэкономить не получится.
Можно ли сейчас вызывать Fable 5.2: доступность на APIYI
По состоянию на 2026-11-10 модели claude-fable-5-2 и моделей линейки Mythos пока нет ни в общем списке моделей APIYI apiyi.com, ни в публичном интерфейсе цен. Мы постараемся добавить эту модель как можно скорее. Актуальные идентификаторы и цены смотрите в списке моделей платформы. Пока Fable 5.2 не появилась на платформе, в этой статье мы не указываем её цену на APIYI и не пересчитываем официальную цену с помощью группового коэффициента.
На тот же день в общем списке APIYI доступны следующие связанные модели. Указаны цены из списка в долларах за миллион токенов:
| ID модели | Ввод / вывод | Чтение из кэша | Эндпоинты | Для чего подходит |
|---|---|---|---|---|
claude-opus-5-5, claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat, messages | Сначала настроить цикл вызова инструментов и управления компьютером |
claude-fable-5-1, claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat, messages | Использовать для сравнения с предыдущим поколением |
claude-fable-5, claude-fable-5-thinking |
$10 / $50 | $1 | chat, messages | Сравнить с историческими версиями |
gpt-6-astra |
$10 / $50 | $1 | responses (основной), chat | Сравнить модели разных поставщиков |
Цены в общем списке — указанные в каталоге. Фактическое списание зависит от группового коэффициента токенов — ориентируйтесь на счёт. В примечании к gpt-6-astra указана только ступенчатая цена на ввод: $10 за объём до 272 000 токенов и $20 за объём от 272 001 до 1 050 000 токенов. Цена на вывод при длинном контексте не указана — проверяйте её в счетах консоли. Для подключения используйте совместимый с OpenAI интерфейс и укажите https://api.apiyi.com/v1 в base_url.
Практичный вариант — сначала проверить ввод изображений, разбор действий и восстановление после ошибок на claude-opus-5-5, а после появления Fable 5.2 на APIYI заменить ID модели и сравнить результаты. Разрыв в робототехнике — 25,5 пункта — намного больше, чем в управлении компьютером (2,1 пункта), поэтому ждать Fable 5.2 есть смысл. Но принимать решение, опираясь только на демонстрационные видео, не стоит.
Анализ преимуществ и недостатков робототехнических возможностей Fable 5.2
Преимущества
- Заметный скачок между поколениями: результат RoboDojo Sim вырос с 27,6% до 64,9% — это один из самых значительных приростов во всей таблице результатов.
- Заметное преимущество перед аналогами: результат на 25,5 процентного пункта выше, чем у Opus 5.5, и на 35,1 пункта выше, чем у GPT-6 Astra (данные из публикации Anthropic).
- Снижение цены: стандартная цена на 20% ниже, чем у версии 5.1; чтение из кэша стоит $0.20.
- Единые параметры для работы с изображениями: модель принимает изображения и поддерживает контекстное окно на 1 млн токенов, поэтому может обрабатывать длинную историю многошаговых визуальных задач.
Ограничения
- Недостаточно надёжные подтверждения: результат получен во внутренних тестах с максимальным уровнем усилий. В открытых рейтингах не удалось найти подтверждение того же результата, независимого повторного тестирования тоже нет.
- Только данные симуляции: в демонстрационных видео не приводятся показатели успешности, а утверждение, что модель «превосходит большинство специализированных робототехнических систем», не сопровождается их списком.
- Много ограничений в цикле управления: модель выдаёт только текст, нельзя принудительно вызывать инструменты, отключить режим рассуждений нельзя, а при длинных цепочках она редко сообщает о ходе работы.
- Высокая стоимость на максимальном уровне: результат получен при максимальном уровне усилий. Задержку и расход токенов при реальном развёртывании нужно измерить самостоятельно.
Когда не стоит менять модель на основании этих данных
Если у вас нет собственной среды симуляции или контура управления реальным роботом, показатель 64,9% не имеет для вас проверяемой ценности: вы не сможете установить, сохраняется ли он в ваших условиях. Этот результат также ничего не доказывает для задач кибербезопасности, биологии или повседневного программирования — для них нужно смотреть на соответствующие тесты. В публикации самой компании рекомендуется начинать с Opus 5.5 для большинства задач программирования и работы со знаниями, а затем переходить на более мощную или лёгкую модель в зависимости от сложности.
Часто задаваемые вопросы
Вопрос 1. Результат Fable 5.2 — 64,9% — взят из публичного рейтинга?
Нет. В сноске к публикации указано, что это результат внутренних тестов Anthropic. RoboDojo — открытый бенчмарк, но по состоянию на 2026-11-10 нам не удалось найти такое же значение на странице публичного рейтинга.
Вопрос 2. 64,9% — это результат при стандартном уровне усилий?
Нет, это результат на самом высоком доступном уровне усилий. По умолчанию в Claude API установлен уровень High, а в приложении Claude и Claude Code — Medium. Результат на стандартном уровне усилий в публикации не приводится.
Вопрос 3. Fable 5.2 превзошла специализированные робототехнические системы?
В публикации говорится, что модель обошла «большинство систем, специально разработанных для управления роботами», но список таких систем не приводится. Какие именно системы она превзошла, пока неизвестно.
Вопрос 4. Почему для Gemini 4 Carbon нет результата на RoboDojo?
В таблице публикации эта ячейка оставлена пустой, и причина не указана. Пустая ячейка не означает нулевой результат и не позволяет судить о качестве модели.
Вопрос 5. Как уже сейчас подготовиться к работе через API?
По состоянию на 2026-11-10 модель `claude-fable-5-2` ещё не появилась на APIYI apiyi.com. Мы постараемся добавить её как можно скорее; актуальные названия моделей и цены смотрите в списке моделей на платформе. Пока можно проверить работу с изображениями и инструментами на уже доступной модели `claude-opus-5-5`, а после выхода Fable 5.2 — переключиться на неё и сравнить результаты.
Вопрос 6. Доказывают ли три электронных устройства, что модель умеет управлять роботами?
Нет. Голосовой помощник, USB-колонка-телефон и виртуальный питомец — это эксперимент по разработке аппаратных устройств в сотрудничестве с Diode. Он демонстрирует навыки проектирования схем и не связан с результатами управления двуруким роботом на RoboDojo.
Вопрос 7. Нужно ли агентам для работы с компьютером ждать Fable 5.2?
Скорее нет. На OSWorld 2.1 результат Fable 5.2 — 89,3%, а Opus 5.5 — 87,2%. Разница составляет всего 2,1 процентного пункта, при этом стандартная цена Opus 5.5 вдвое ниже, чем у Fable 5.2.
Ключевые выводы о возможностях Fable 5.2 в робототехнике
- Что означает результат: 64,9% — результат симуляции двурукого робота при внутреннем запуске и максимальном уровне усилий.
- Разрыв: результат на 25,5 процентного пункта выше, чем у Opus 5.5, и на 35,1 пункта выше, чем у GPT-6 Astra.
- Сравнение с другими задачами: в OSWorld преимущество составляет всего 2,1 пункта — эти результаты нельзя ставить в один ряд.
- Демонстрации: сборка кубика Рубика, откручивание крышки бутылки и рисование — это демонстрационные примеры из анонса, а не готовые продуктовые навыки.
- Ограничения цикла управления: модель выдаёт только текст; принудительно заданный
tool_choiceприводит к ошибке 400, а отключить рассуждения нельзя. - Доступность: по состоянию на 10 ноября 2026 года APIYI ещё не добавила модель в каталог. Пока можно построить цикл управления на
claude-opus-5-5.
Итог
Прогресс Claude Fable 5.2 в управлении роботами — вполне реальный и заметный сигнал: результат RoboDojo Sim вырос с 27,6% у предыдущего поколения до 64,9%. В сравнении, представленном Anthropic, модель значительно опережает конкурентов. Но область применения этой цифры очень узкая: она учитывает только симуляцию, внутренний запуск и максимальный уровень усилий. Это не показатель успешности работы на реальных роботах и не гарантия готовности к внедрению на производстве.
Если у вас уже есть собственный цикл управления для симуляции или реального робота, после добавления Fable 5.2 в каталог стоит сравнить её с другими моделями. Заранее предусмотрите разбор текстового вывода и учтите, что принудительно вызывать инструменты и отключать рассуждения нельзя. Если такого цикла у вас нет или вам нужно решать задачи по программированию и управлению компьютером, менять текущий подход только из-за результата 64,9% не нужно.
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами на главной странице APIYI — apiyi.com. Актуальный статус добавления моделей смотрите в каталоге платформы.


