
Примечание автора: разбираем три задачи из статьи DeepSeek Harness «Exploring Super-agent Design» — полнодуплексное взаимодействие, память и работу с учётными данными. Посмотрим, какие решения можно взять на вооружение уже сейчас, какие остаются открытыми вопросами, и составим контракты интерфейсов и чек-лист внедрения.
Долго работающий агент часто сталкивается сразу с тремя проблемами. Пока шесть минут выполняются тесты, новый вопрос пользователя вынужден ждать в очереди. Вчерашний контекст вытесняется из окна сегодняшними событиями. А во время отладки агент открывает .env — и ключи попадают в историю диалога. 2026-11-01 команда DeepSeek Harness опубликовала подробную статью «Exploring Super-agent Design», в которой свела эти проблемы к трём темам: полнодуплексное взаимодействие (full-duplex), память (Chain of Recall) и «использование учётных данных без доступа к их содержимому».
Это не обзор запуска продукта. В оригинале описана архитектура, а не функция, которую можно просто включить: полнодуплексное взаимодействие уже реализовано в DeepSeek Harness, но по умолчанию отключено. Часть решений находится в прототипе плагина dsh-superagent-prototype, причём автор прямо указывает, что это «не официальный продукт DeepSeek». Долгосрочная память и работа с учётными данными также названы в оригинале открытыми вопросами.
Главное: из этой статьи вы узнаете, какие решения для этих трёх задач можно взять на вооружение, каким контрактам должны соответствовать связанные с ними API и с чего начать в собственном проекте агента.
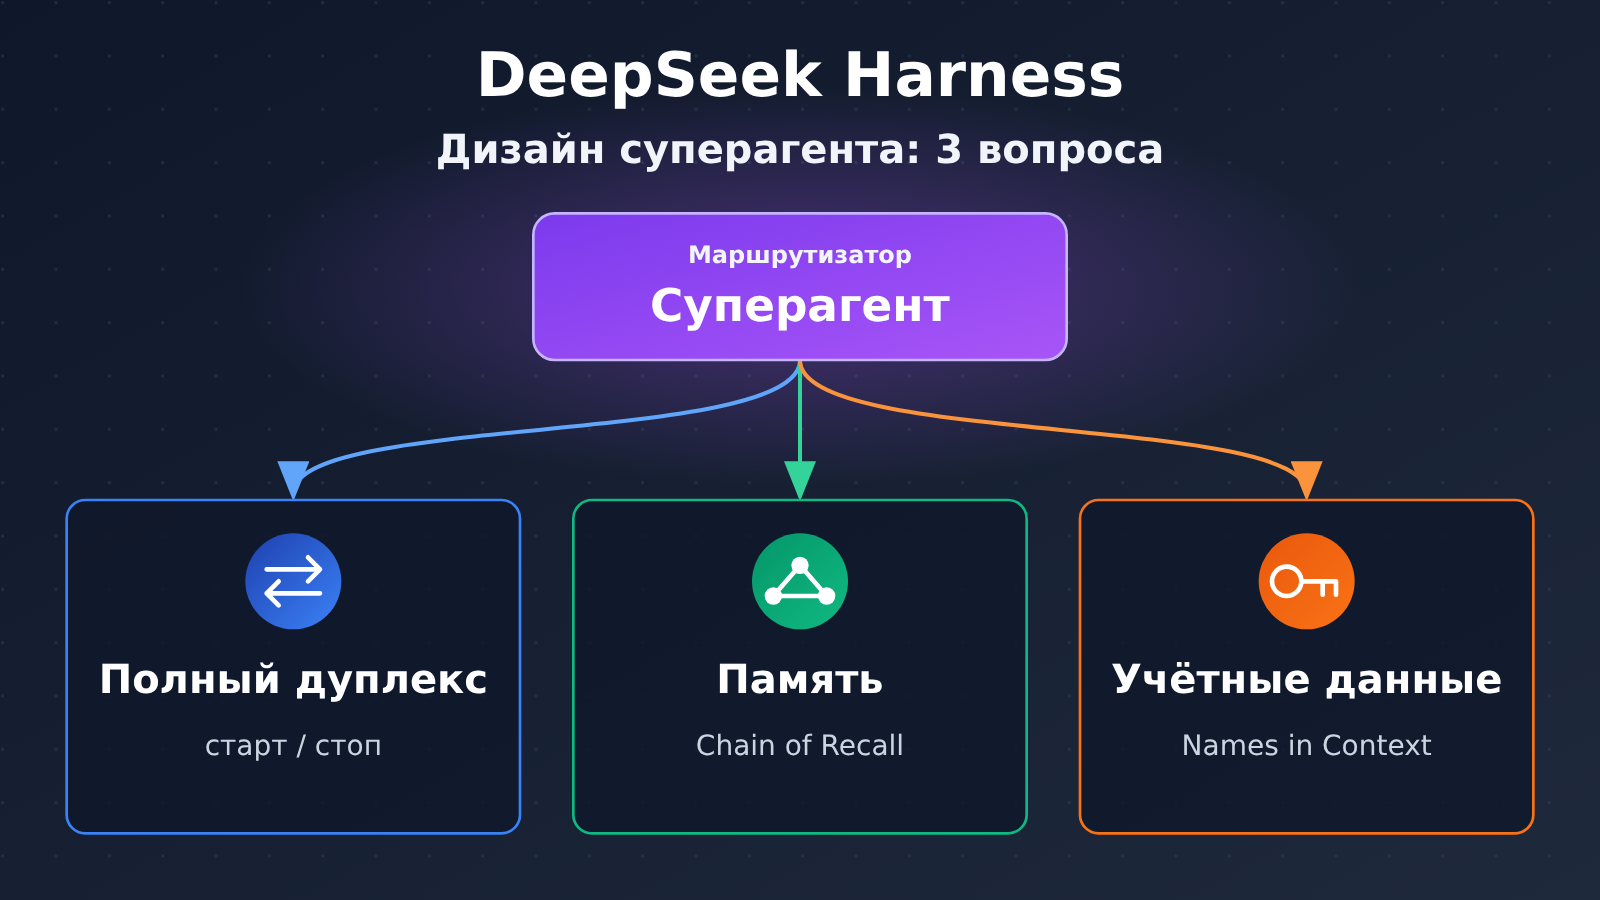
Ключевые принципы супер-агента DeepSeek Harness
Для начала разберёмся, какое место в оригинале занимают три вопроса проектирования и что из предложенного можно применить уже сейчас.
| Вопрос | Основная идея оригинала | Статус в оригинале | Что можно применить |
|---|---|---|---|
| Полный дуплекс | Разделить блокирующий run() на start() и stop(), чтобы агент мог получать инструкции во время работы |
Реализовано, но по умолчанию отключено | Асинхронный контракт инструментов, возврат событий, пакетная обработка |
| Память | Оставлять в контексте только стабильные ID, краткие сводки и соседние сообщения; остальное выносить вовне, сохраняя указатели, и использовать связи по ID для многошагового поиска | Долговременная память остаётся открытым вопросом | Стабильные ID, inline/spill, точное извлечение по ID |
| Учётные данные | Агент должен использовать учётные данные, но они не должны попадать в его контекст | Открытый вопрос | Инженерные подходы, при которых имена попадают в контекст, а значения остаются за его пределами |
Общая архитектура супер-агента DeepSeek Harness
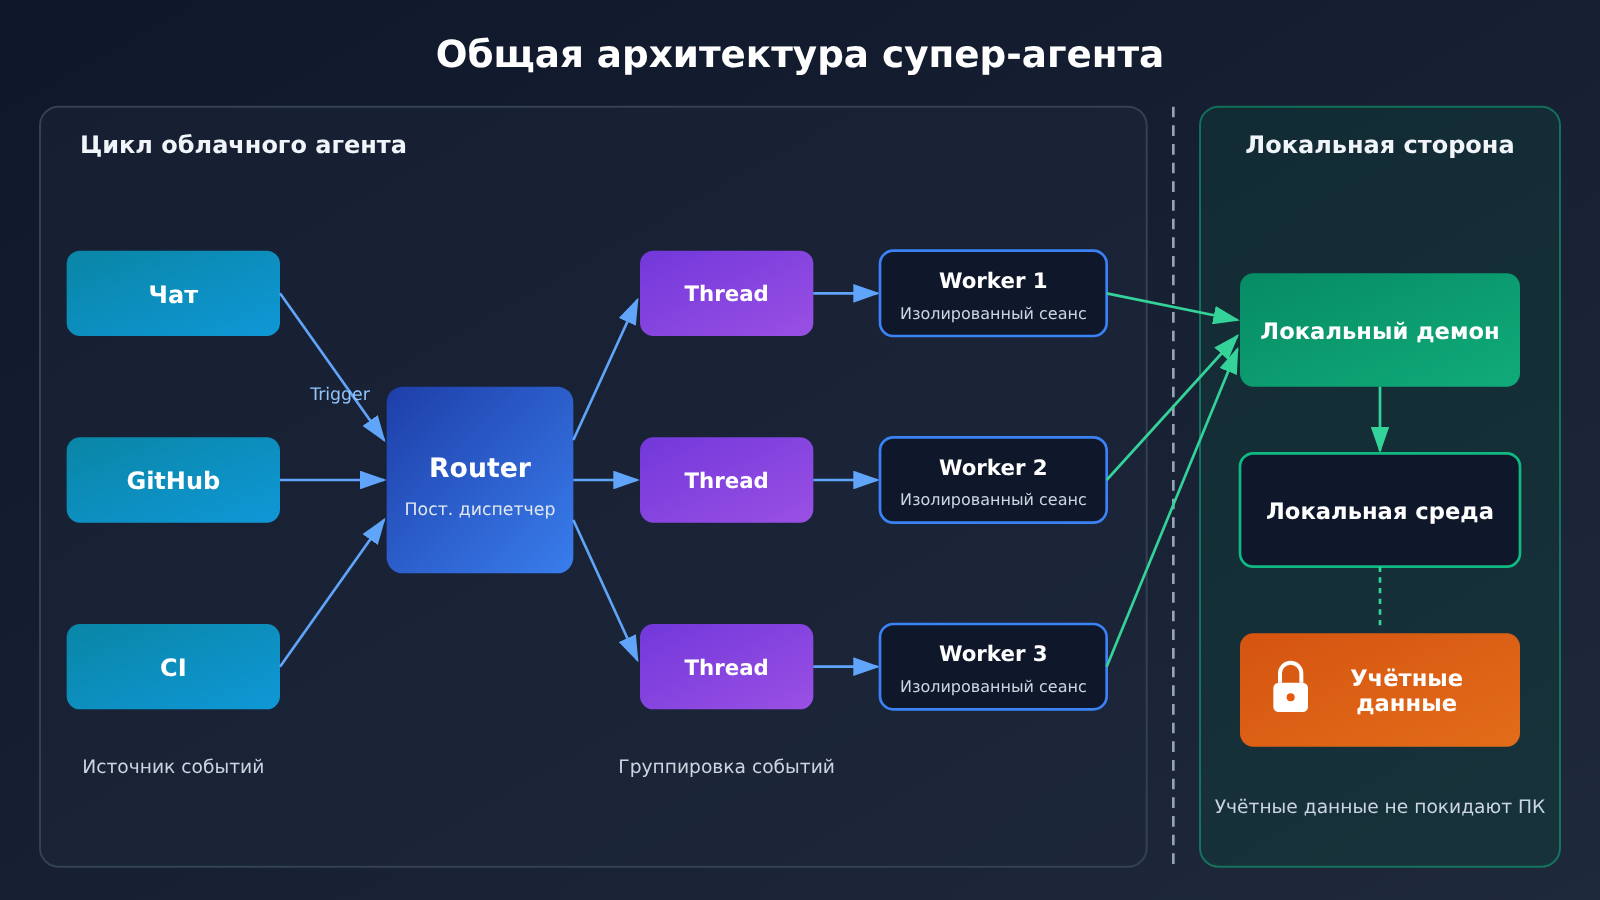
В оригинале супер-агент состоит из Router и Worker. Router — постоянно работающая точка входа для распределения задач, которая одновременно отслеживает события из чата, GitHub, CI и других источников. Worker — изолированная сессия агента, которая обрабатывает только одну задачу. Каждое входящее в систему событие называется Trigger. Связанные события, относящиеся к одному PR, одной теме в мессенджере или одной цепочке писем, объединяются в Thread.
У этой архитектуры есть и особенность развёртывания: цикл агента работает в облаке, а пользовательское окружение для выполнения задач остаётся на локальной машине. За связь между ними отвечает небольшой фоновый процесс, а учётные данные также хранятся локально. Все три вопроса проектирования рассматриваются с учётом этого устройства. Разобравшись с понятиями Router, Worker, Trigger и Thread, проще понять и последующие решения для полного дуплекса и памяти.
Как применить полнодуплексный подход DeepSeek Harness
Полнодуплексный режим решает проблему, когда один медленный инструмент «замораживает» всего агента. При традиционном подходе агент синхронно ждёт ответа инструмента. Если запрос занимает 200 мс, это не страшно, но шестиминутный запуск тестов создаёт сразу три проблемы: задержки последующих запросов накапливаются; агент не слышит пользователя, если тот посреди работы говорит «пропусти e2e-тесты»; шлюз разрывает соединение, которое слишком долго остаётся открытым, — работа успешно завершена, но вызов выдаёт ошибку тайм-аута.
В оригинале идеальное состояние называется «productive»: агент уже может принять следующую инструкцию, пока предыдущая ещё выполняется. Для этого один блокирующий вызов run() разбивают на несколько небольших контрактов: start() сразу возвращает идентификатор задачи, status() сообщает о ходе выполнения, stop() инициирует отмену, а результат позднее возвращается в диалог в виде события. Разница в том, кто ждёт: при использовании run() ждёт модель, а при использовании start() — среда выполнения.
Контракт асинхронных инструментов в полнодуплексной архитектуре DeepSeek Harness
На уровне определения инструментов для каждой длительной операции вместо одного инструмента предоставляются три. Например, для тестов start_test_run возвращает только job_id и статус queued, без каких-либо данных о результатах; get_job_status возвращает один из статусов queued, running, done, failed и краткое описание прогресса; stop_job инициирует отмену и возвращает фактический статус задачи.
Два правила помогут избежать нежелательного поведения модели. Во-первых, в описании инструмента нужно явно указать «не ждать результата», иначе модель будет часто опрашивать get_job_status. Во-вторых, start никогда не должен возвращать данные, иначе модели придётся угадывать, какую структуру она получила на этот раз. API задач, стоящий за инструментами, можно спроектировать по таблице ниже. Определение 202 Accepted в RFC 9110 как раз означает, что запрос принят к обработке, но обработка ещё не завершена.
| Вызов | Ответ | Соответствующий инструмент |
|---|---|---|
POST /jobs (с заголовком запроса Idempotency-Key) |
202, возвращает job_id и статус queued, Location указывает на /jobs/{id} |
start |
GET /jobs/{id} |
200, возвращает queued / running / done / failed | status, слушатель задач |
GET /jobs/{id}/result |
200 с результатом, если задача завершена; 409, если ещё нет | Инструмент получения результата |
DELETE /jobs/{id} |
202 означает, что запрос на отмену принят; последующий вызов возвращает 404 или 409 | stop |
| Необязательный URL обратного вызова | POST вызывающей стороне при завершении задачи | Слушатель задач |
Возврат результатов и пакетная обработка в полнодуплексном DeepSeek Harness
Опрос — лишь запасной вариант. Лучше, чтобы среда выполнения отслеживала задачи и после завершения отправляла в диалог короткое событие с job_id, статусом и краткой сводкой, например: «412 прошли, 3 завершились с ошибкой». Полный лог можно оставить за инструментом получения результатов — тогда десятки тысяч строк не попадут напрямую в контекст.
В оригинале также описана пакетная обработка в Router: триггеры, поступившие во время генерации, ставятся в очередь и объединяются при следующем вызове модели. У таких вызовов длинный ввод и короткий вывод, поэтому большая часть затрат приходится на этап prefill. В эксперименте, описанном в оригинале, при увеличении частоты триггеров с 1 до 40 в минуту средний размер пакета вырос с 1.0 до 2.8, а время принятия одного решения снизилось с 6.4 s до 1.6 s. Это данные конкретного эксперимента, а не универсальный бенчмарк, но сам подход можно применять напрямую: пока модель генерирует ответ, события и сообщения пользователя ставятся в очередь, а после завершения текущего раунда передаются модели вместе в порядке поступления.
Порядок выполнения, отмена и идемпотентность
Эти детали легко упустить на этапе прототипа, а после запуска они могут привести к проблемам:
- Порядок выполнения: задачи завершаются в непредсказуемом порядке. Если B зависит от A, зависимость нужно указать явно: либо запускать B только после события о завершении A, либо добавить в API поддержку
depends_on. - Отмена:
stop— это только запрос, он не гарантирует отмену. Нужно возвращать фактический конечный статус: если задача успела завершиться до отмены, вернитеdone, чтобы модель могла сообщить пользователю, как всё было. - Ключ идемпотентности: модель может повторить вызов, а потеря ответа — привести к повторному
start. Требуйтеidempotency_keyпри каждом вызовеstartи возвращайте существующую задачу при повторном использовании ключа. Иначе одна просьба «выполнить миграцию» может привести к её двойному запуску. - Частичные результаты и тайм-ауты: предоставляйте промежуточный вывод через интерфейс результатов с курсором; для каждой задачи задавайте предельное время выполнения и отправляйте событие
job_timed_outпри его превышении.
Если ваши инструменты работают через MCP, обратите внимание на необязательное расширение Tasks в версии спецификации MCP от 2026-07-28. Сервер может отвечать на вызов инструмента результатом с taskId, а клиент — опрашивать состояние через tasks/get или слушать notifications/tasks и отправлять запрос на отмену через tasks/cancel. Это расширение необходимо явно включить и на клиенте, и на сервере. Кроме того, его поддержка зависит от хост-приложения, поэтому перед использованием всё нужно проверить.
Когда асинхронность не нужна: если вызов возвращает результат за одну-две секунды, следующий шаг в любом случае не может начаться без результата или за инструментом нет настоящего API задач. Если инструмент внутри блокирующий, асинхронная обёртка лишь добавит сложности. Практичный подход: оставить операции чтения блокирующими, а длительные операции записи и вычисления сделать асинхронными.
Как использовать подход к памяти из DeepSeek Harness: Chain of Recall
Рано или поздно долго работающий агент упирается в предел контекстного окна: новые задачи постоянно поступают. У трёх распространённых способов справиться с этим есть свои недостатки. Если сохранять всё, окно заполнится, а расходы будут расти с каждым шагом. Если использовать обновляемое резюме, можно потерять конкретную ошибку или номер PR, которые понадобятся позже. А поиск по сходству не найдёт нужный факт, если его формулировка слишком отличается от поискового запроса.
В оригинальной статье предлагается считать контекст кешем и использовать только две операции. Inline помещает в контекст то, что агенту с наибольшей вероятностью понадобится прямо сейчас: ID, краткие резюме и соседние сообщения. Spill обрабатывает всё остальное: содержимое сокращается, а на его месте остаётся указатель, по которому позже можно получить полную версию. Вытесненное содержимое не удаляется — просто в промпте от него остаётся только указатель. Например, для события о сбое CI в контексте сохраняется лишь одна строка: «CI для PR #412 не прошёл: 3 из 118 тестов в директории payments завершились с ошибкой». Вместо полного лога размером 41 KB остаётся только путь для его извлечения. Если резюме достаточно, агенту не придётся платить за обработку этих 41 KB.
Стабильные ID и граф ссылок в системе памяти DeepSeek Harness
Chain of Recall работает при условии, что ID никогда не меняются. В исходном описании ID присваиваются трём типам объектов:
| Объект | Значение | Пример ID | Связи |
|---|---|---|---|
| Trigger | Событие, поступившее в систему: сообщение в чате, Webhook, callback от CI | trg_8f21 |
Принадлежит определённому Thread |
| Thread | Цепочка связанных событий в рамках одного PR, обсуждения в мессенджере или переписки по электронной почте | thr_pr_412 |
Закреплён за одним или несколькими Worker |
| Worker | Изолированная сессия агента, выполняющего одну задачу | wkr_77a0 |
В отчёте ссылается на обработанные Trigger |
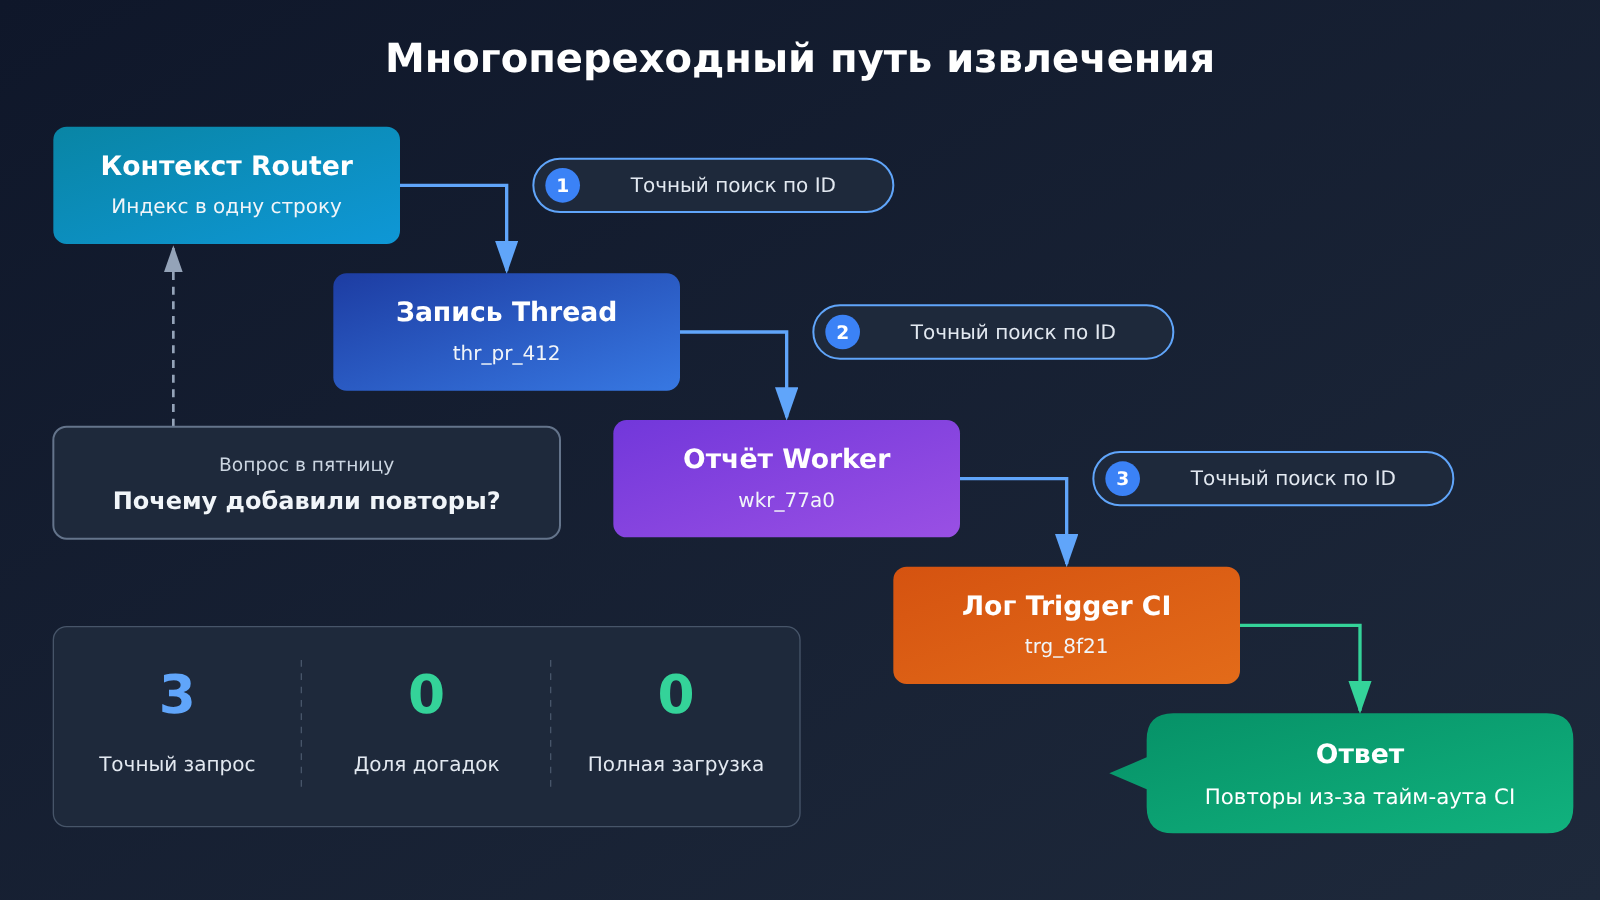
Эти связи образуют граф ссылок — память агента. При извлечении данных агент переходит по ссылкам шаг за шагом: он не загружает всю историю и не ищет похожие тексты. Например, в пятницу кто-то спрашивает Router: «Почему в платёжный клиент добавили повторные попытки?» Обсуждение этого решения было во вторник и давно вышло за пределы контекста. Первый шаг: Router использует сохранившуюся в контексте строку индекса и извлекает thr_pr_412. Второй шаг: из записи Thread он узнаёт, за каким Worker тот закреплён, и извлекает итоговый отчёт этого Worker. Третий шаг: в отчёте есть ссылка на Trigger со сбоем CI; Router извлекает его лог и видит ошибку тайм-аута. Три небольших точных запроса — и ответ получен без догадок.
Четыре требования к API памяти DeepSeek Harness
Каждый шаг в цепочке извлечения памяти — это вызов API. Если на каком-то шаге вернётся другая запись или не вернётся ничего, цепочка оборвётся: агент либо застрянет, либо начнёт строить догадки. Поэтому базовый API должен выполнять четыре требования:
- ID никогда не меняется: ID, возвращённый сегодня, и через месяц должен указывать на тот же объект. После удаления ID не используется повторно, а при миграции не переназначается.
- Получение по ID должно быть дешёвым и точным:
GET /threads/{id}возвращает только указанную запись, без поиска и без «ближайшего совпадения». - Неизвестный ID должен явно вызывать ошибку: API возвращает 404 и понятное тело ошибки. Если вернуть 200 с пустым объектом, агент решит, что такая запись в памяти существует.
- Пагинация по курсору не должна пропускать записи: длинный Thread возвращается постранично, в правильном порядке, и каждое событие появляется ровно один раз. При добавлении новых событий курсор остаётся действительным.
При рефакторинге эти требования легко нарушить, даже не заметив этого. Поэтому стоит закрепить их в автоматических тестах и запускать тесты при каждом слиянии изменений.
Важно учитывать два ограничения. Во-первых, Chain of Recall не заменяет векторный поиск: векторный поиск отвечает на вопрос «что похоже на это», а Chain of Recall — «что с этим связано». На практике часто сочетают оба подхода: сначала находят начальный Thread ID через векторный индекс, а затем переходят по ссылкам к точным фактам. Во-вторых, цифра «37%» в оригинале относится к сквозной передаче Thread: без неё количество токенов, считываемых из кеша за один запуск, выросло с 23.2M до 31.8M. Это цена отсутствия конкретной функции, а не экономия от самого Chain of Recall — при цитировании их не стоит путать.
Чему можно научиться у DeepSeek Harness: использовать учётные данные, не раскрывая их агенту
В оригинальной статье этот вопрос остаётся открытым: если учётные данные попадут в контекст агента, они могут утечь. Поэтому агент должен уметь использовать их, но не видеть. Есть четыре распространённых сценария утечки: агент читает .env при поиске причины ошибки; записывает заголовки запроса с секретами в открытом виде в команды для отладки или выполняет echo, чтобы «убедиться, что переменная задана»; вставляет реальные значения в описание PR, комментарий к Issue или тестовые данные; под воздействием инъекции промпта на веб-странице или в ответе API выводит переменные окружения. OWASP считает инъекции промптов главным риском для приложений на базе больших языковых моделей, а раскрытие учётных данных относит к утечкам конфиденциальной информации.
Все меры защиты подчиняются одному правилу: в контексте остаются только имена, а значения — за пределами модели. В контексте могут встречаться имя переменной STRIPE_KEY, ссылка на секрет в менеджере секретов, плейсхолдеры вроде {{token}} или замаскированные значения. Но там не должно быть реальных ключей, значений, полученных после разрешения ссылок, и строк логов без маскировки. Если реальное значение всё же попало в диалог, ключ нужно сменить в тот же день: записи диалогов сохраняются, кэшируются и экспортируются, а отправленный токен уже нельзя отозвать.
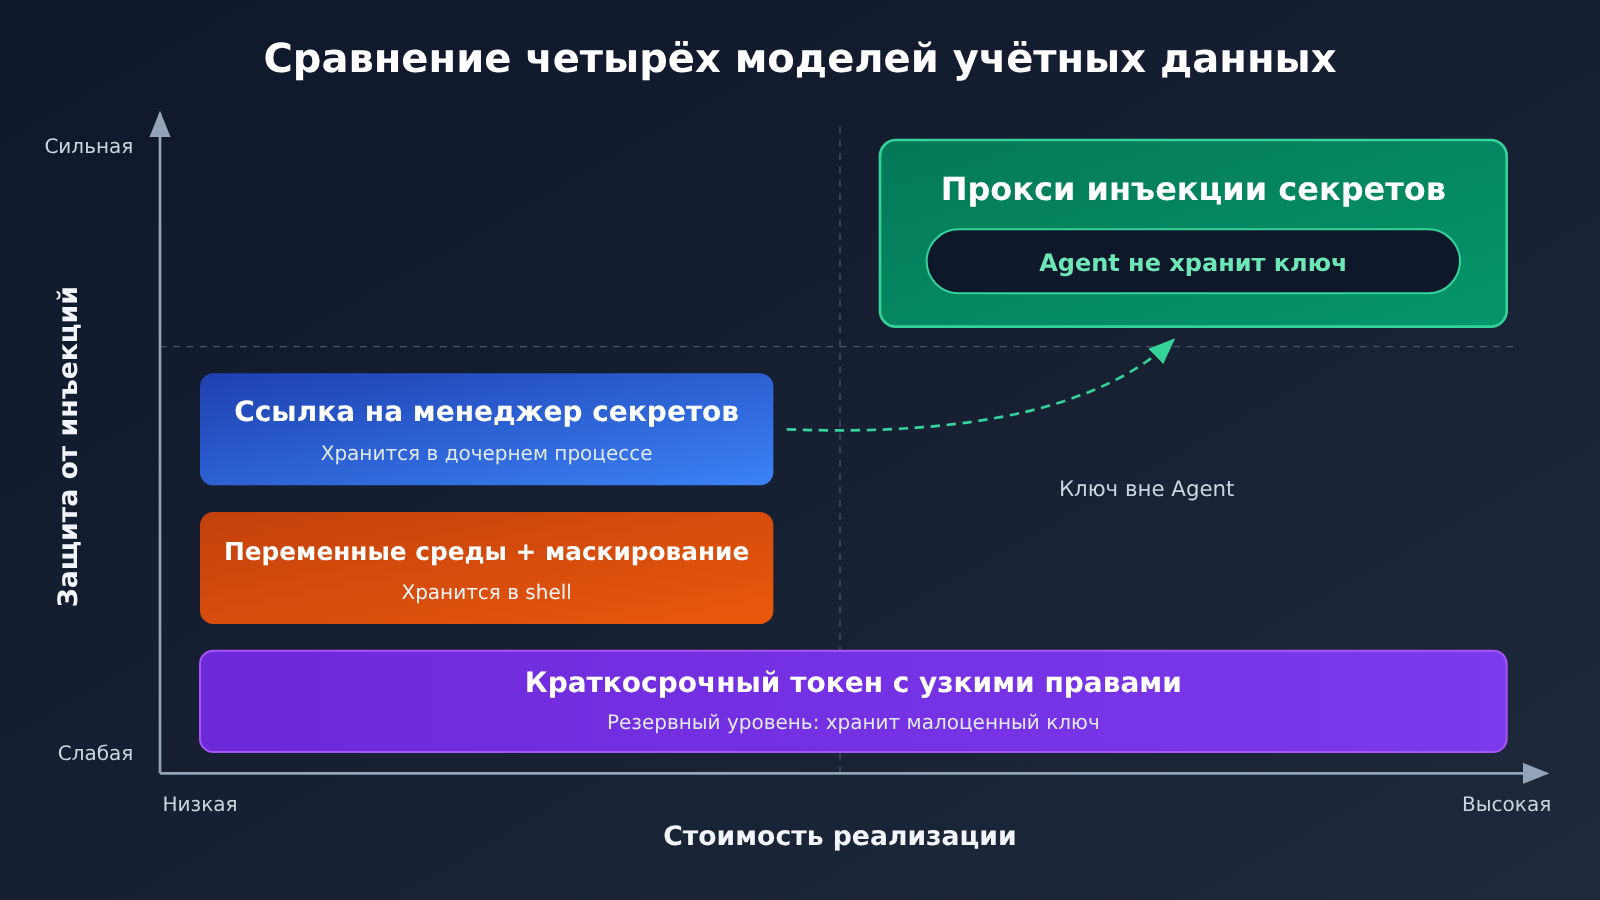
Четыре способа защитить учётные данные в DeepSeek Harness
| Подход | Как работает | Есть ли значение у Agent | Главное ограничение |
|---|---|---|---|
| Переменные окружения + маскирование | В команде указывается $NAME, shell подставляет значение; чтение .env запрещено; перед передачей вывода значения маскируются |
Есть в shell | Защищает от случайных ошибок, но не от намеренного вывода после инъекции |
| Ссылка на менеджер секретов | В конфигурации хранится только ссылка вроде op://vault/item/field, а во время выполнения CLI передаёт значение дочернему процессу |
Есть в дочернем процессе | Те же ограничения, что и у переменных окружения |
| Прокси с подстановкой учётных данных | Agent обращается к локальному прокси без ключа; прокси добавляет заголовок авторизации и пересылает запрос, если он есть в списке разрешённых | Нет | Прокси нужно отдельно разворачивать и поддерживать |
| Краткосрочный токен с узкими правами | Для каждой сессии выпускается токен, который действует несколько минут и разрешает только одну операцию | Есть, но ценность его невелика | Это лишь запасная мера: пока токен действует, им всё ещё могут злоупотребить |
Из этих четырёх подходов только прокси с подстановкой учётных данных позволяет сделать так, чтобы у Agent вообще не было ключа. Список разрешённых запросов на прокси не менее важен, чем подстановка ключа: например, можно разрешить GET /v1/charges и запретить DELETE /v1/customers. Даже если Agent подвергнется инъекции, он сможет выполнять только одобренные вами вызовы и не сможет забрать ключ. Прокси должен работать от отдельного пользователя или в отдельном контейнере, чтобы Agent не мог прочитать его конфигурацию. Это соответствует подходу к развёртыванию из оригинала: учётные данные остаются локально вместе с окружением.
Если ваш Agent вызывает модель через APIYI, тот же подход можно применить к ключу модели: прокси подставляет ключ при пересылке запроса в APIYI, а Agent знает только то, что нужно обращаться к локальному прокси. Тогда даже при экспорте истории диалога в ней не окажется действующего ключа APIYI. Точный адрес подключения и способ авторизации смотрите в документации APIYI на docs.apiyi.com.
Последний уровень защиты — маскирование. В выводе инструментов, логах CI и сохранённых сессиях нужно маскировать значения с известными префиксами, включая sk_live_, ghp_, github_pat_, AKIA и xoxb-, а также значения всех заголовков запросов Authorization и X-API-Key и конкретные значения, подставленные во время текущей сессии. Достаточно одной незамаскированной строки, чтобы все предыдущие меры защиты пошли насмарку.
Быстрый старт с DeepSeek Harness: план внедрения и выбор моделей
Необязательно решать все три вопроса проектирования сразу. Если расставить задачи по соотношению затрат и пользы, получится такой порядок:
- Начните с защиты учётных данных: запретите агенту читать
.env, укажите вCLAUDE.mdилиAGENTS.md«не выводить переменные, имена которых заканчиваются на_KEY,_TOKENили_SECRET», и добавьте фильтр для маскирования данных в выводе. Это можно сделать за полдня, а результат будет заметен сразу. - Переведите медленные инструменты на асинхронную работу: начните с тестирования, сборки и развёртывания — операций, которые часто занимают больше нескольких секунд. Разделите их на start / status / stop, добавьте ключи идемпотентности и сроки выполнения.
- Внедрите стабильные ID: назначайте событиям, тредам сессий и подзадачам неизменяемые ID. В контексте оставляйте только ID и краткое резюме в одну строку, а большие объёмы данных выносите за его пределы, сохраняя указатель на них.
- Добавьте прокси для подстановки учётных данных и краткосрочные токены: разверните прокси для сторонних API и настройте список разрешённых адресов. Для каждой сессии агента выпускайте отдельный токен.
При выборе моделей учитывайте, что Router получает длинный ввод, выдаёт короткий ответ и часто принимает пакетные решения. Для него подойдёт быстрая недорогая модель с низкой ценой чтения из кэша. Worker пишет код и решает сложные задачи, поэтому ему нужна более мощная модель. Цены в таблице взяты со страницы APIYI docs.apiyi.com/models. Актуальные единицы тарификации и цены уточняйте на этой странице; другие ценовые условия здесь не гарантируются.
| Модель (название в APIYI) | Цена ввода | Цена вывода | Цена кэша | Рекомендуемая роль | Доступная платформа |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Пакетные решения и сводки событий для Router | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Worker для повседневного написания кода | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Worker для задач с длинным контекстом и работы с документами | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Worker для сложного рефакторинга и критически важных решений | APIYI apiyi.com |
В оригинальных экспериментах с пакетной обработкой и сквозной передачей Thread особое внимание уделяется объёму токенов, считываемых из кэша. Большая часть расходов на стороне Router приходится на prefill и чтение из кэша, поэтому при выборе модели цена кэша зачастую важнее цены вывода.
🚀 Быстрый старт: APIYI предоставляет доступ к моделям из таблицы через API и поддерживает оба формата интерфейса — OpenAI и Anthropic. Для Router можно подключить deepseek-v4.1-flash в формате OpenAI, а для Worker — claude-sonnet-5-5 в формате Anthropic. Обоими подключениями можно управлять из одного аккаунта. Инструкции по подключению доступны в документации APIYI на docs.apiyi.com, актуальные цены — на docs.apiyi.com/models.
Частые вопросы FAQ
Q1: Что такое «Дизайн супер-агента» от DeepSeek Harness?
Это большая статья о проектировании «Exploring Super-agent Design», опубликованная командой DeepSeek Harness 2026-11-01. В ней обсуждается архитектура постоянно работающего супер-агента, который одновременно отслеживает несколько источников событий. Речь идёт именно об архитектуре, а не об официально выпущенной функции. Часть описанного реализована в прототипе плагина `dsh-superagent-prototype`, который, как уточняет автор, не является официальным продуктом DeepSeek.
Q2: Чем полный дуплекс отличается от параллельного вызова инструментов?
При параллельном вызове несколько инструментов выполняются одновременно в рамках одного раунда, но модель всё равно ждёт, пока вернутся все результаты. В полнодуплексном режиме асинхронный вызов инструмента сразу возвращает дескриптор, а результат приходит в следующих раундах в виде события. Пока модель ждёт, она может продолжать диалог, получать новые инструкции и запускать новые задачи.
Q3: Можно ли просто включить Chain of Recall? Заменит ли он RAG?
Ни то ни другое невозможно. Chain of Recall — это шаблон проектирования, описанный в исходной статье, а не функция, которую можно включить переключателем. Для него нужно самостоятельно реализовать стабильные ID и интерфейс извлечения по ID. Он решает другую задачу, чем RAG: RAG ищет похожий контент, а Chain of Recall извлекает данные по точным ссылкам. На практике обычно сначала находят отправную точку с помощью векторного поиска, а затем переходят по ссылкам ID к конкретным фактам. В исходной статье долгосрочная память также названа открытой проблемой; утверждения о том, что Chain of Recall её уже решил, там нет.
Q4: Для каких сценариев лучше всего подходят решения этих трёх задач?
— **Полный дуплекс**: тестирование, сборка, краулинг, рендеринг, развёртывание и другие задачи, которые часто занимают больше нескольких секунд, когда пользователь продолжает общаться с агентом во время их выполнения.
— **Память**: история из отдельных событий, которые можно связать между собой, например PR, тикеты, записи запусков CI, сессии службы поддержки и записи о релизах.
— **Учётные данные**: агенты для написания кода и эксплуатации, которым нужен доступ к платным или требующим особой защиты сторонним API.
Q5: Как быстро подключить разные модели для Router и Worker?
Проще всего использовать для единого подключения платформу, совместимую с форматами API OpenAI и Anthropic. Зарегистрируйтесь на APIYI apiyi.com, получите API-ключ и укажите нужные имена моделей отдельно для Router и Worker. Адрес подключения уточняйте в документации APIYI на docs.apiyi.com. Перед запуском рекомендуется проверить качество решений deepseek-v4.1-flash и claude-sonnet-5-5 на одной и той же выборке реальных событий, а затем распределить между ними роли.
Q6: Где проверить модели и цены, упомянутые в исходной статье?
Актуальные цены на все упомянутые в этой статье модели указаны на странице APIYI docs.apiyi.com/models. Числа из исходной статьи и сторонних материалов приведены только для сравнения. Если модели нет на этой странице, значит, она пока недоступна в APIYI. Мы постараемся добавить её как можно скорее; после этого актуальную цену можно будет проверить на странице цен.
Q7: Какие известные ограничения есть у этих подходов?
Для полнодуплексной работы нужен полноценный API задач: «псевдоасинхронность», построенная как обёртка над блокирующим выполнением, лишь добавит сложности. Chain of Recall не найдёт содержимое, для которого не созданы ссылки, а контракт ID легко нарушить при миграции и рефакторинге. Что касается учётных данных, ни переменные окружения, ни ссылки на секреты не защитят от ситуации, когда агент после инъекции намеренно выводит значения. Только прокси инъекции позволяет агенту вообще не иметь доступа к этим значениям; краткоживущие токены могут служить лишь запасной мерой. В оригинале память и учётные данные также названы открытыми вопросами.
Ключевые выводы по проектированию супер-агента DeepSeek Harness
- Позиция оригинала: это статья об архитектуре; полнодуплексный режим по умолчанию выключен, а прототип плагина не является официальным продуктом.
- Полнодуплексный режим: вместо блокирующего run используются start / status / stop, результаты возвращаются в виде событий и объединяются в пакеты.
- Контракт API задач: 202 означает принятие запроса, ключ идемпотентности служит для дедупликации, отмена возвращает фактический статус, для каждой задачи задаётся крайний срок.
- Устройство памяти: в контексте хранятся только стабильные ID и краткие сводки; на остальное содержимое оставляются указатели, а при извлечении данные последовательно запрашиваются по цепочке ссылок ID.
- Контракт API памяти: ID не меняются, данные извлекаются точно, для неизвестного ID возвращается 404, пагинация с курсором не пропускает записи.
- Принцип работы с учётными данными: имена попадают в контекст, значения остаются за его пределами; предпочтителен прокси инъекции, краткоживущие токены служат запасной мерой, конфиденциальные данные в логах полностью маскируются.
- Распределение ролей между моделями: для Router выбирается недорогая модель с низкой стоимостью кэширования, для Worker — более мощная; в APIYI их можно сравнить с одной учётной записью.
Итоги
Из проекта DeepSeek Harness «Дизайн супер-агента» можно позаимствовать больше практических решений, чем можно подумать, учитывая его статус прототипа:
- Полный дуплекс: асинхронные контракты инструментов и возврат событий агенту — проверенные инженерные подходы. API задач можно сначала покрыть тестами, а затем подключить к агенту.
- Память: стабильные ID в сочетании с inline/spill — самый недорогой способ реализовать точную память для событийного агента, но они не заменяют векторный поиск.
- Учётные данные: правило «имена — в контекст, значения — за его пределами» можно применять уже сегодня. Прокси для внедрения учётных данных — единственный способ сделать так, чтобы ключи вообще не попадали к агенту.
Начните с защиты учётных данных и асинхронного выполнения медленных инструментов. Стабильные ID и прокси для внедрения учётных данных можно оставить на второй этап. Если для Router и Worker нужны разные модели, их можно протестировать через APIYI apiyi.com, используя единый интерфейс, совместимый с форматами OpenAI и Anthropic. Актуальные цены указаны на docs.apiyi.com/models.
📚 Источники
- What Is Chain of Recall? How Stable IDs Give AI Agents Memory: разбор системы памяти Chain of Recall
- Ссылка:
apidog.com/blog/chain-of-recall-ai-agent-memory -
Описание: стабильные ID, inline/spill, примеры многошагового извлечения и четыре контракта API
-
Async Tool Calls for AI Agents: Why start() Beats a Blocking run(): разбор полнодуплексных асинхронных инструментов
- Ссылка:
apidog.com/blog/async-tool-calls-ai-agents -
Описание: контракты start/status/stop, результаты экспериментов с пакетной обработкой и расширение MCP Tasks
-
How to Let AI Agents Use API Keys Without Seeing Them: практики защиты учётных данных агента
- Ссылка:
apidog.com/blog/ai-agents-use-api-keys-without-seeing-them -
Описание: четыре схемы работы с учётными данными, пути утечки и чек-лист по маскированию данных
-
Документация и цены APIYI: инструкции по подключению моделей и тарифы, упомянутые в статье
- Ссылки:
docs.apiyi.comиdocs.apiyi.com/models - Описание: актуальные названия моделей, форматы интерфейсов и цены
Автор: техническая команда APIYI
Обсуждение технических вопросов: если у вас есть вопросы о выборе архитектуры агента или подключении нескольких моделей, свяжитесь с нами через главную страницу APIYI apiyi.com. Больше материалов — в документации на docs.apiyi.com.


