
Em 2026-11-11, o blog de desenvolvedores do Google apresentou um caso de uso bem concreto: o Gemini Notebook usa a Decisions API como roteador em tempo real. Quando uma requisição chega, ela direciona as perguntas do dia a dia para o nível de modelo e o nível de raciocínio mais adequados. O Google informa, por conta própria, uma redução de até 40% na latência das consultas cotidianas. Vale lembrar que esse número é do próprio Google: não vem de um teste de carga independente nem de uma medição feita por alguma plataforma.
Isso não é mais uma evolução de capacidade do modelo. A mudança é tirar a escolha do modelo de dentro do código do desenvolvedor e colocá-la no caminho da requisição.
Valor central: em 3 minutos, entender o que é o gemini-decision-1, como ele é cobrado e o que ele significa para a sua cadeia de chamadas.
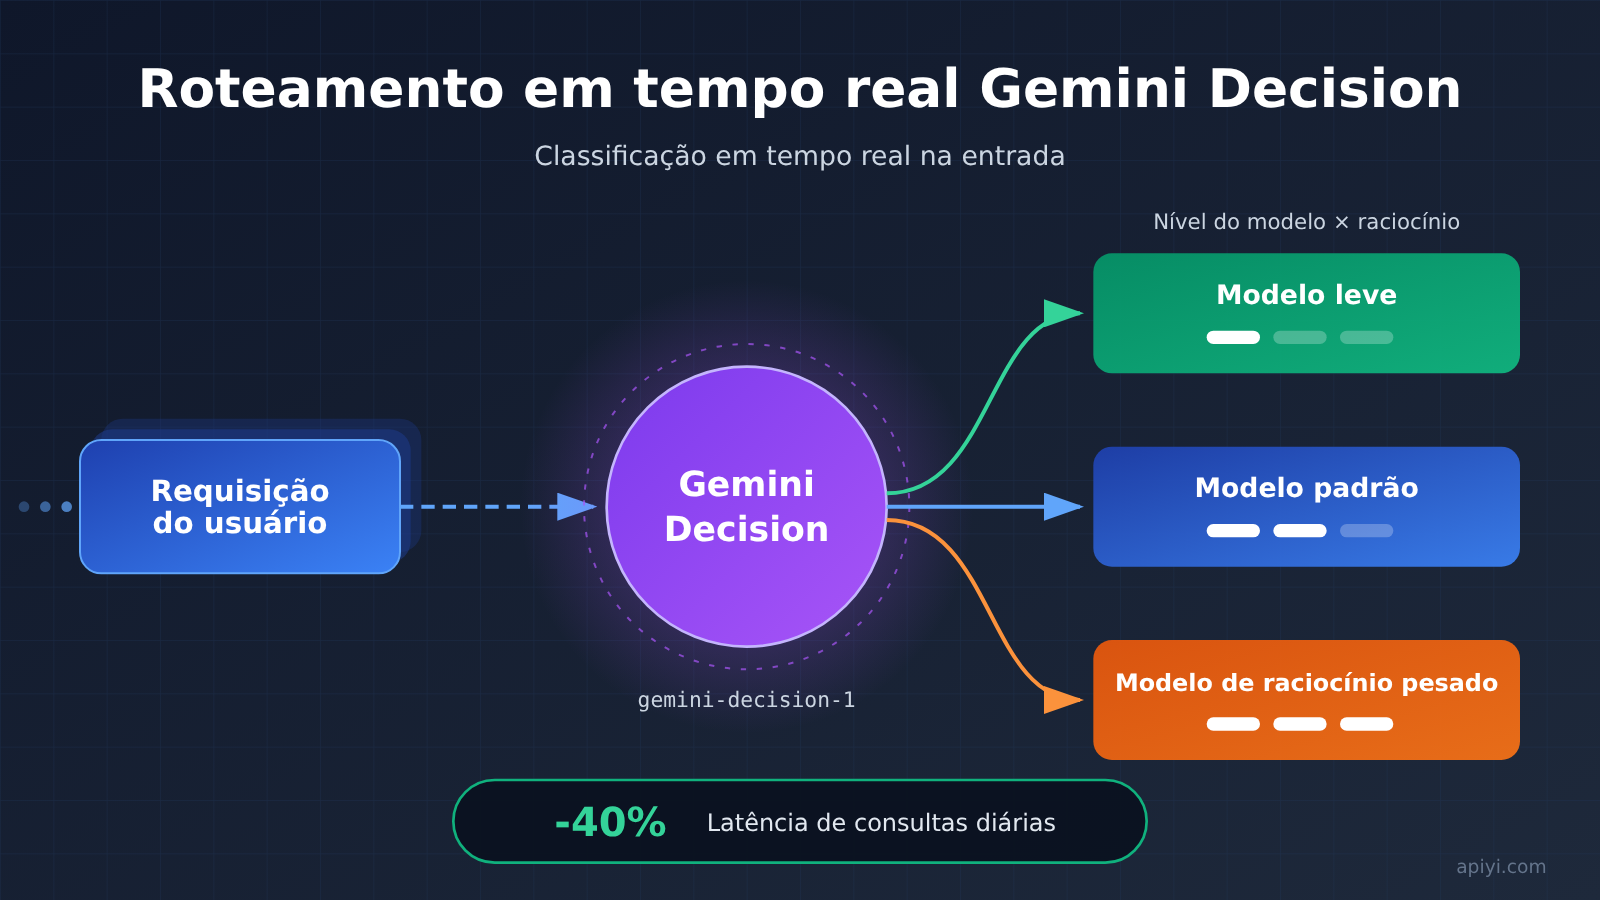
Gemini Decision: resumo das informações principais
| Item | Detalhes |
|---|---|
| Data do anúncio | 2026-11-11, blog de desenvolvedores do Google |
| ID do modelo | gemini-decision-1 |
| Posicionamento | Roteamento e decisão em tempo real, não geração de conteúdo |
| Primeiro caso de uso público | Classificação interna de perguntas do dia a dia no Gemini Notebook |
| Preço de entrada | $0.10 / 1M tokens |
| Preço de saída | $0 |
| Ganho de latência | Redução de até 40% nas consultas cotidianas, segundo o próprio Google |
| Disponibilidade em plataformas agregadoras | Até 2026-11-12, esse ID ainda não consta na tabela de preços da APIYI (apiyi.com) |
A linha mais fácil de passar batido na tabela é a do preço de saída: $0. Ela mostra que o resultado do gemini-decision-1 não é um texto, e sim um veredito curtíssimo: para qual nível encaminhar e quanto orçamento de raciocínio usar. Se você comparar o preço unitário dele com o de modelos de conversa na mesma tabela, vai chegar a uma conclusão totalmente errada.
Outro detalhe é que ele já tem um caso de produção real, e não só exemplos na documentação. O Gemini Notebook é um produto do próprio Google. Ou seja, o Google colocou esse roteamento para rodar primeiro no seu produto e só depois falou dele publicamente. Isso dá mais credibilidade do que um benchmark isolado, mas continua sendo uma descrição feita unilateralmente pela empresa.
Como o Gemini Decision funciona: os casos de roteamento divulgados pelo Google
Segundo o blog do Google, as perguntas do dia a dia no Gemini Notebook passam primeiro pela Decisions API, que decide qual faixa de modelo e qual nível de raciocínio usar. Ou seja, a decisão de roteamento virou uma chamada de modelo, e não um monte de if-else fixo no código ou um limiar ajustado na mão.
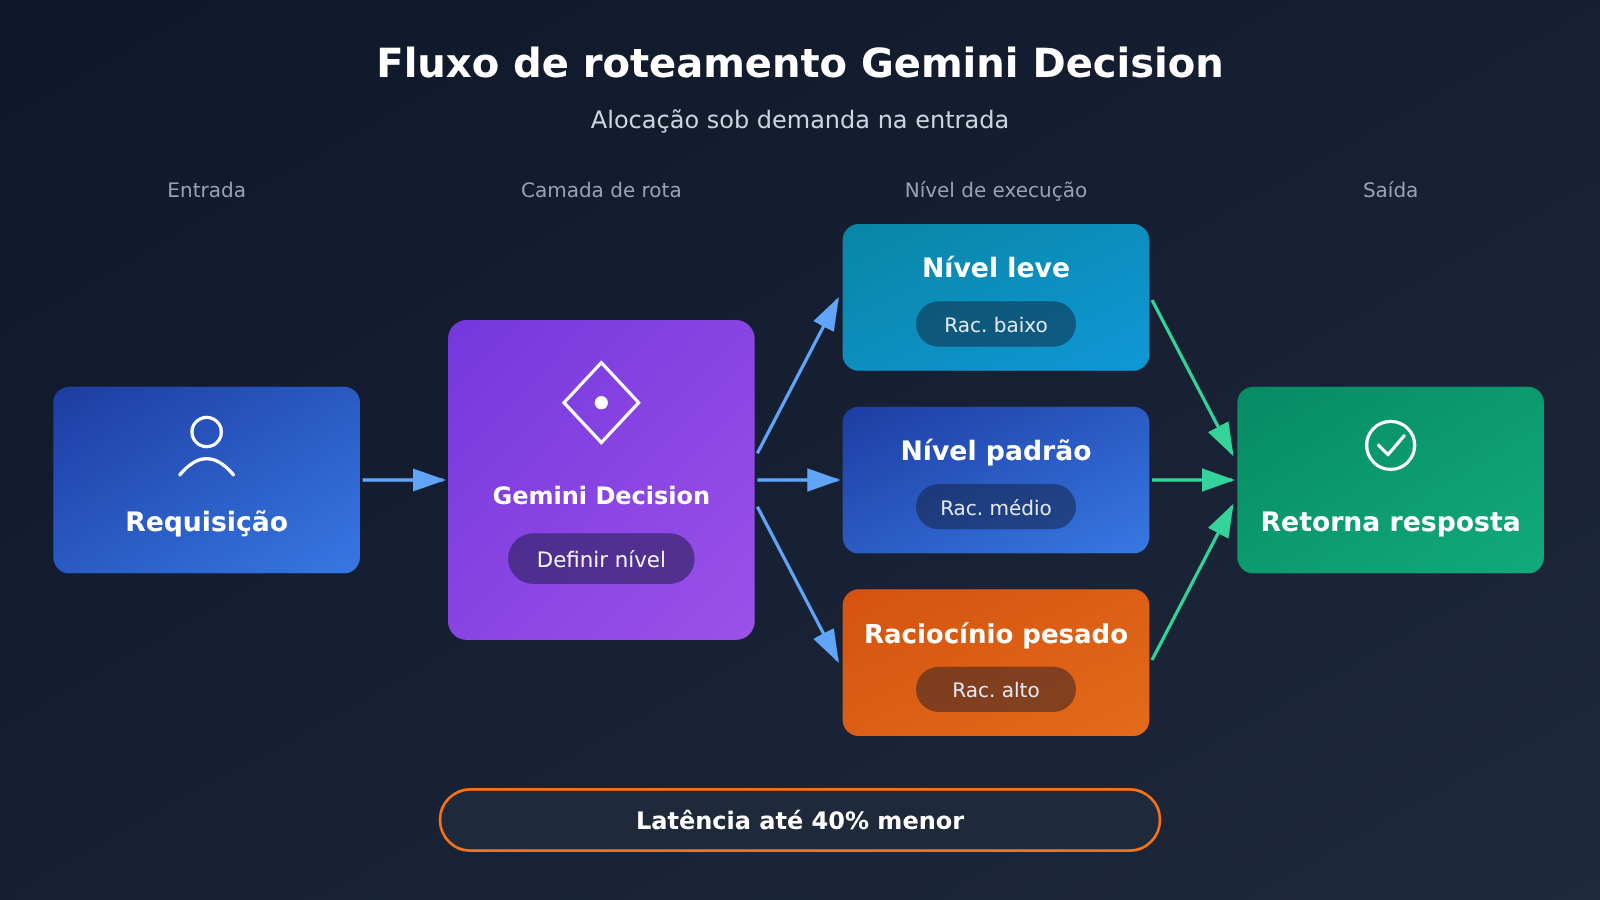
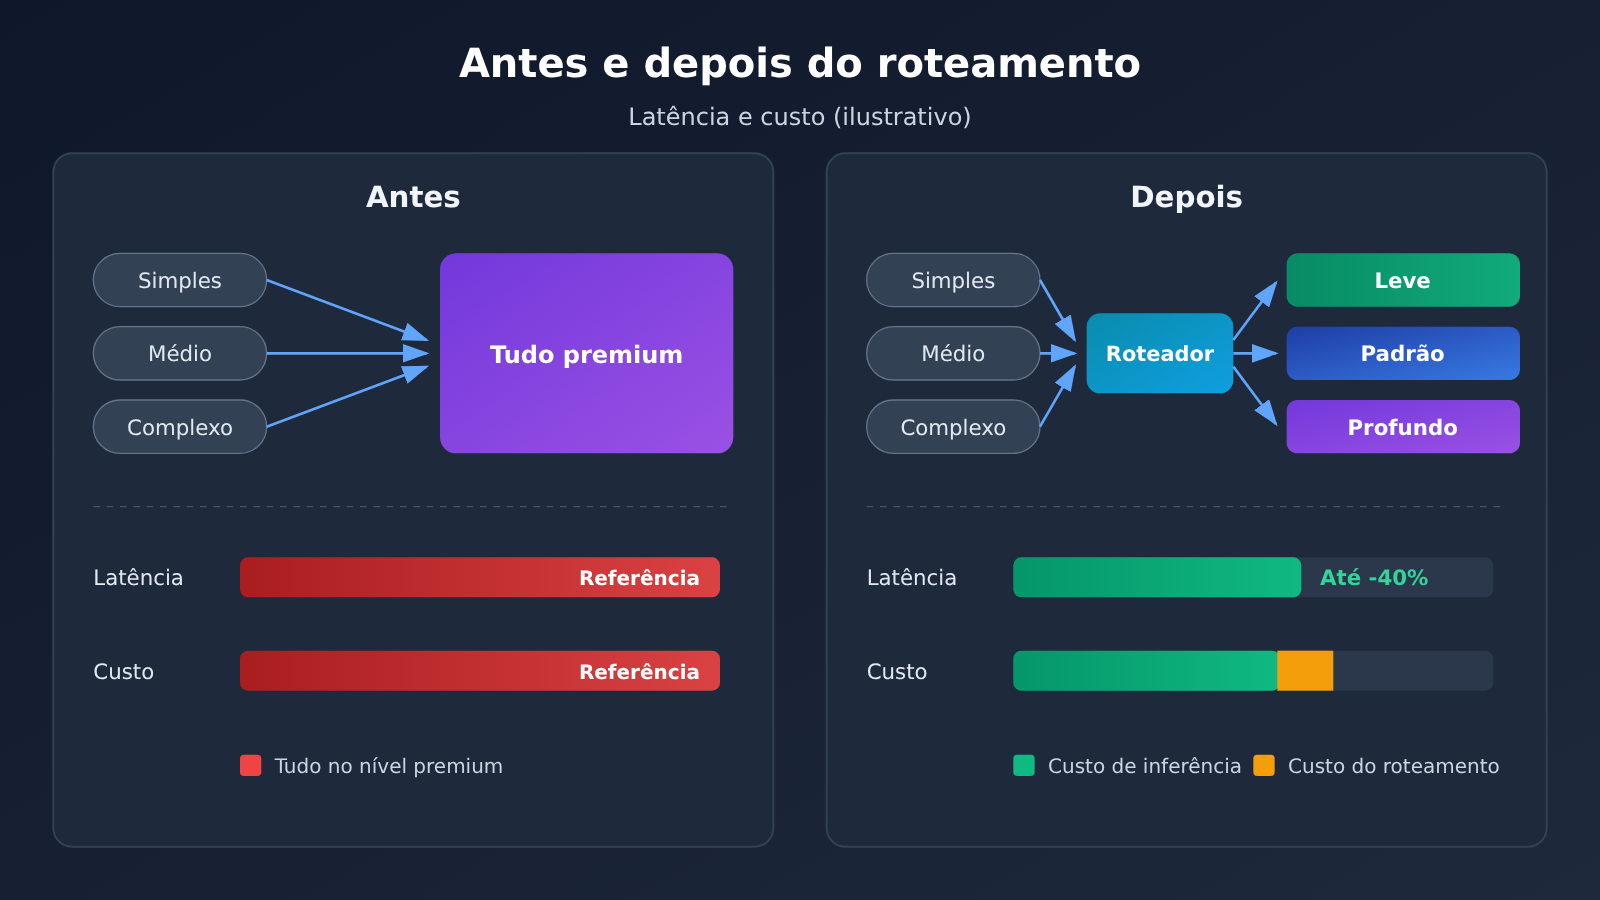
O problema que esse design resolve é bem real: num mesmo produto, a maioria das requisições é de perguntas leves do cotidiano, e só uma minoria exige raciocínio pesado. Se tudo vai para a mesma faixa, as requisições leves ficam presas a um modelo pesado, e latência e custo sobem juntos. Se tudo vai para a faixa leve, as perguntas complexas não são bem respondidas. Colocar um modelo de decisão dedicado na entrada para fazer essa triagem transforma a “alocação sob demanda” em infraestrutura.
| Etapa | Prática comum antes do roteamento | Depois de introduzir o Decision |
|---|---|---|
| Definição da faixa | Regras no código ou correspondência por palavra-chave | O modelo decide com base no conteúdo da requisição |
| Manutenção | Os limiares precisam de ajuste manual conforme o negócio muda | A lógica de decisão evolui junto com o modelo |
| Impacto na latência | Com muitas requisições pesadas, tudo fica mais lento | O Google diz que as consultas do dia a dia chegam a ter até 40% menos latência |
| Impacto no custo | Todas as requisições são cobradas na mesma faixa | Requisições leves caem na faixa leve, e a estrutura da fatura muda |
Vale deixar claro que os 40% se referem ao cenário de “consultas do dia a dia”, e não a todas as requisições. O Google usa o valor como teto, e o ganho real no seu negócio depende de quantas das suas requisições são do tipo que pode ser rebaixado de faixa. Se o seu produto é só análise de documentos longos ou tarefas complexas de código, o espaço para rebaixar naturalmente é menor.
🎯 Dica técnica: para validar o ganho dessa abordagem de roteamento no seu próprio negócio, comece usando a interface unificada do APIYI (apiyi.com) para rodar modelos de diferentes faixas com o mesmo lote de requisições. Compare latência e qualidade de saída e só então decida se vale a pena adicionar uma camada de roteamento.
Estrutura de cobrança do Gemini Decision e o que ela significa para o custo
Entrada a US$ 0,10 / 1M tokens e saída a US$ 0: na prática, a cobrança é feita pela quantidade de contexto que o modelo “lê”. Para decidir a rota, o roteador precisa ver o conteúdo da requisição, então faz sentido cobrar pela entrada. Já a saída é só um veredito com o nível escolhido, que quase não gera custo, e por isso o preço oficial é simplesmente zero.
Isso quer dizer que quem vai integrar precisa fazer uma conta a mais: a própria camada de roteamento também consome tokens. A economia de raciocínio obtida quando uma requisição é rebaixada de nível precisa cobrir esse custo extra de decisão, senão não há ganho líquido. Quanto mais longa a requisição e maior a diferença entre os níveis, mais fácil a conta fechar no positivo. Em cenários com requisições curtas, que já iriam para o nível mais leve, adicionar uma camada de roteamento pode até sair mais caro.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# O gemini-decision-1 ainda não está disponível na tabela de preços da plataforma
# Por enquanto, troque o model por um modelo de chat já existente para validar o fluxo do seu negócio
response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "这个问题需要多深的推理?"}]
)
print(response.choices[0].message.content)
🚀 Primeiros passos: até 12/11/2026, o gemini-decision-1 ainda não aparece na lista de preços da APIYI (apiyi.com), e a plataforma vai incluí-lo assim que possível. Enquanto isso, você pode validar o fluxo chamando outros modelos pela mesma interface compatível com a OpenAI, com custo de troca praticamente zero. Para modelos e preços específicos, consulte sempre a lista em apiyi.com.
Quem será afetado: o que muda, na prática, em três tipos de cadeia de chamadas
Lado da aplicação: o roteamento deixa de ser algo que você escreve e vira uma chamada de interface
Antes, quem fazia distribuição entre vários modelos geralmente tinha de manter uma tabela de regras e reajustar os parâmetros a cada troca de versão dos modelos. Se a decisão de roteamento puder ser terceirizada para um modelo de decisão dedicado, a lógica do lado da aplicação fica bem mais enxuta, e o trabalho que sobra é definir “quais faixas existem” e “qual modelo vai em cada faixa”. O preço disso é uma chamada serial a mais, então a qualidade da rede na camada de entrada passa a afetar diretamente a latência total.
Lado do custo: menos latência não significa fatura menor
Latência e custo são duas curvas diferentes. Rebaixar a faixa de uma requisição reduz as duas ao mesmo tempo, mas o próprio roteamento é cobrado por token de entrada, e em cenários de requisições curtas o custo marginal acaba ficando maior. O caminho mais seguro é agrupar primeiro as requisições por tipo e ativar o roteamento só para a parcela do tráfego em que a diferença de complexidade é grande, deixando o restante em faixas fixas.
| Tipo de equipe | Principal benefício | Custo a observar |
|---|---|---|
| Produtos de perguntas e respostas voltados ao consumidor final | A latência das perguntas do dia a dia cai e a melhora na experiência é nítida | Gasto extra de tokens com a chamada de roteamento |
| Ferramentas internas de empresas | Requisições complexas e simples rodam misturadas, com grande diferença entre faixas | Será preciso redesenhar a divisão das faixas |
| Serviços de requisições curtas em alta frequência | Ganho limitado, pouco espaço para rebaixar de faixa | Um salto serial a mais pode não compensar |
Lado da plataforma: a velocidade em acompanhar novos IDs de modelo vira critério de escolha
O ritmo de atualização dos modelos está cada vez mais acelerado, e entre o anúncio de um ID e o momento em que ele fica estável para uso costuma haver uma janela de espera. Para equipes que usam plataformas de agregação, a rapidez em conseguir uma interface chamável nesse período influencia diretamente o cronograma de validação. É aí que está o valor de plataformas como a APIYI (apiyi.com): uma única chave API, interface compatível com a OpenAI e a possibilidade de trocar de modelo assim que ele for disponibilizado, sem mexer na estrutura do código. O andamento da disponibilização e os detalhes de cobrança valem conforme o que for exibido na página do apiyi.com.
Perguntas frequentes (FAQ)
Q1: O que é o Gemini Decision?
O gemini-decision-1, divulgado pelo Google, é um modelo voltado para roteamento e tomada de decisão em tempo real. Ele não gera o texto da resposta: sua função é decidir para qual faixa de modelo e para qual nível de raciocínio uma requisição deve ir. O Gemini Notebook é o primeiro caso de uso em produção que o Google divulgou publicamente.
Q2: Qual é a diferença para os modelos Gemini comuns?
Um modelo de conversa comum devolve conteúdo. Já o Gemini Decision devolve apenas um resultado de decisão bem curto, e por isso a estrutura de cobrança é bem diferente: entrada a US$ 0,10 / 1M tokens e saída a US$ 0. Se você o encara como um “modelo generativo mais barato”, já está olhando na direção errada.
Q3: De onde vem a redução de até 40% na latência?
O número vem do blog oficial do Google, ou seja, é um dado autodeclarado. Ele representa o teto de melhoria de latência do Gemini Notebook em consultas do dia a dia, e não o resultado de um teste de carga independente. O ganho real depende de quantas das suas requisições são leves o suficiente para serem direcionadas a uma faixa menor.
Q4: Quanto ele pode economizar no meu negócio?
Não existe uma resposta universal. A economia de custo de inferência vem de as requisições serem encaminhadas para faixas mais leves, enquanto o próprio roteamento é cobrado por token de entrada. Quanto mais longas as requisições e maior a diferença entre as faixas, mais claro é o ganho líquido. Em cenários com muitas requisições curtas e frequentes, vale avaliar com cuidado.
Q5: Já dá para chamar o Gemini Decision?
Até 12/11/2026, o gemini-decision-1 ainda não consta na tabela de preços da APIYI (apiyi.com), mas a plataforma vai disponibilizá-lo o quanto antes. Até lá, você pode usar a interface unificada da apiyi.com para já validar o fluxo do seu negócio e, quando o ID entrar no ar, basta trocar o nome do modelo. Os modelos disponíveis e os preços valem conforme a lista da apiyi.com.
Q6: Quais são os custos conhecidos de adicionar uma camada de roteamento?
Há três pontos principais: o caminho da requisição ganha uma chamada serial a mais, então a qualidade da rede na entrada passa a pesar mais; a própria decisão de roteamento consome tokens de entrada, o que aumenta o custo marginal das requisições curtas; e a divisão em faixas precisa ser redesenhada de acordo com o seu negócio, sem simplesmente copiar o esquema de outra pessoa.
Gemini Decision: pontos principais (Key Takeaways)
- Posicionamento: o gemini-decision-1 é um modelo de roteamento em tempo real. Ele devolve uma decisão de faixa (tier) e não gera texto de resposta.
- Caso de uso: o Gemini Notebook usa o modelo para encaminhar as perguntas do dia a dia para a faixa de modelo e a faixa de raciocínio mais adequadas.
- Ganho: segundo o próprio Google, a latência das consultas cotidianas cai em até 40%. É um número autodeclarado.
- Cobrança: entrada a US$ 0,10 / 1M de tokens e saída a US$ 0. O valor é cobrado sobre o contexto lido.
- Custo embutido: o roteamento consome tokens por conta própria, então em requisições curtas o ganho líquido precisa ser calculado à parte.
- Disponibilidade: até 12/11/2026, o APIYI (apiyi.com) ainda não tem esse ID, mas vamos incluí-lo o quanto antes. Os preços valem conforme a lista do apiyi.com.
- Como validar: primeiro faça o fluxo funcionar com uma interface unificada e só depois decida se vale a pena colocar uma camada de roteamento em produção.
Resumo
O que importa neste anúncio não é o quanto o modelo é poderoso, e sim o fato de o Google ter transformado a “escolha do modelo” em uma interface que pode ser oferecida externamente, depois de testá-la primeiro nos próprios produtos. Para quem desenvolve, vale guardar três pontos: a decisão de roteamento está deixando de ser lógica de código e virando uma invocação do modelo; o ganho de latência é um teto autodeclarado e precisa ser reestimado com o perfil do seu próprio tráfego; e a nova dimensão de cobrança muda a estrutura de custos, então não dá para olhar só a economia obtida ao descer de faixa.
Se quiser validar essa abordagem antes, dá para começar rodando a lógica de classificação por faixas com os modelos que você já tem. Quando o gemini-decision-1 estiver disponível no APIYI (apiyi.com), basta trocar o nome do modelo para fazer a migração. Modelos e preços valem conforme a lista do apiyi.com.
Referências
- Blog oficial do Google: Gemini Decisions API
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ -
Descrição: única fonte original deste artigo para o ID do modelo, casos de uso de roteamento, números de latência e preços
-
Lista de preços do APIYI (apiyi.com)
- Link:
apiyi.com - Descrição: usada para conferir o status de disponibilização do gemini-decision-1 e o critério final de cobrança
Autor: Equipe técnica do APIYI
Fale com a gente: entre em contato pela página inicial do APIYI (apiyi.com). As novidades sobre modelos disponibilizados e as explicações sobre novas interfaces estão na central de documentação do site.


