
Nota do autor: o tempo de execução das tarefas do Codex é determinado em conjunto pelo modelo, pela intensidade de raciocínio, pelo caminho de serviço, pelo ciclo de ferramentas, pelo cache e pela rede. Usar comparações com a mesma tarefa e medição por etapas permite localizar o gargalo.
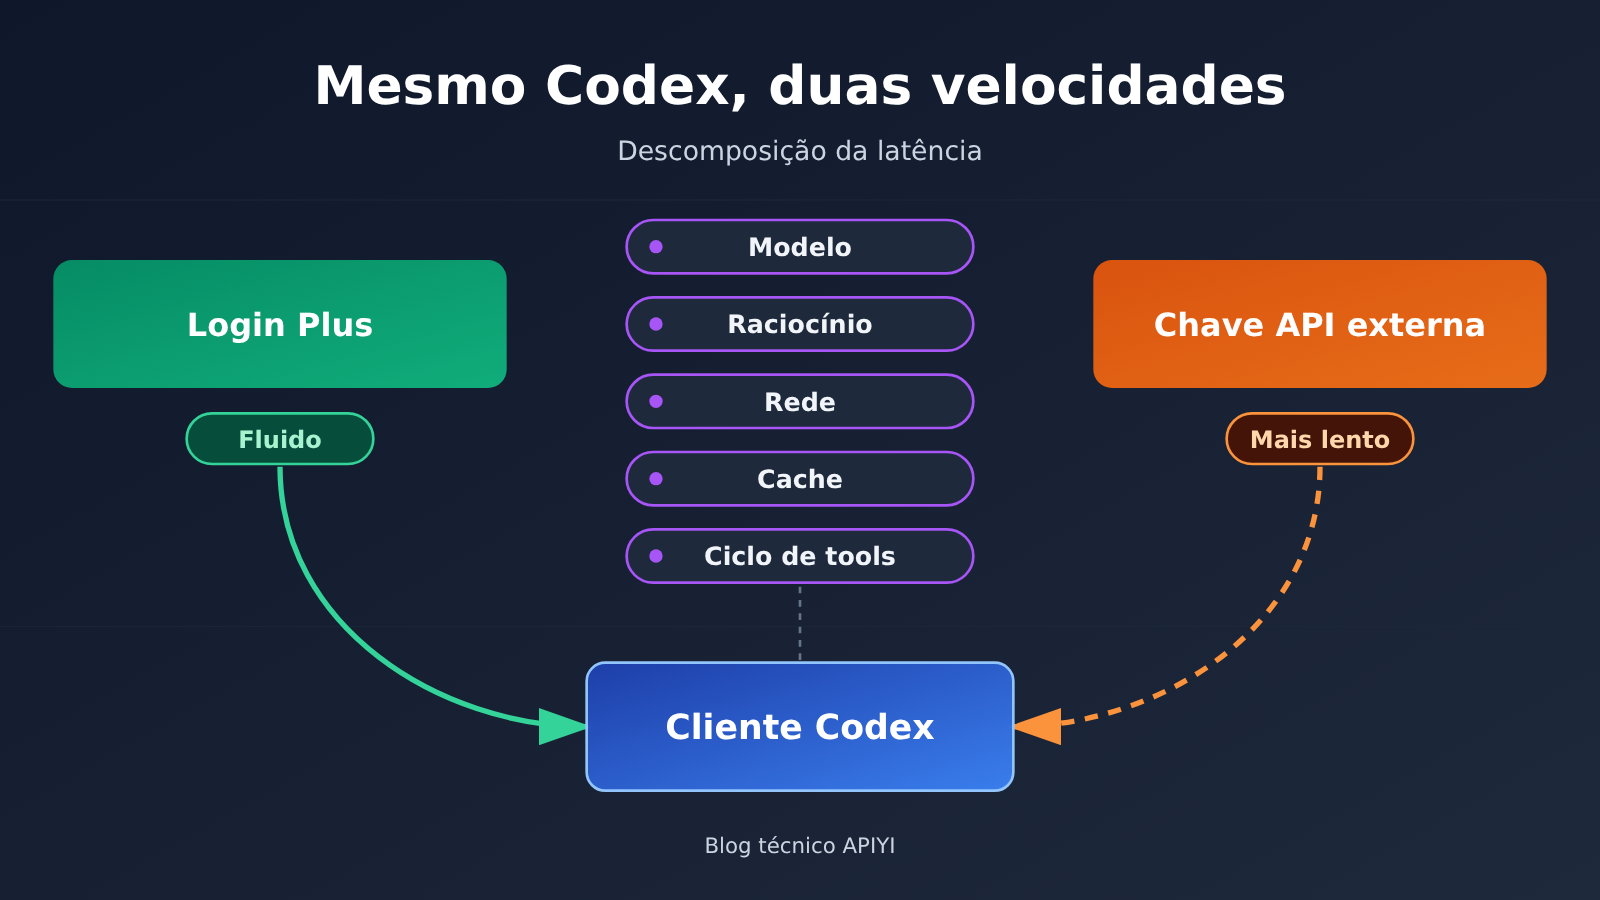
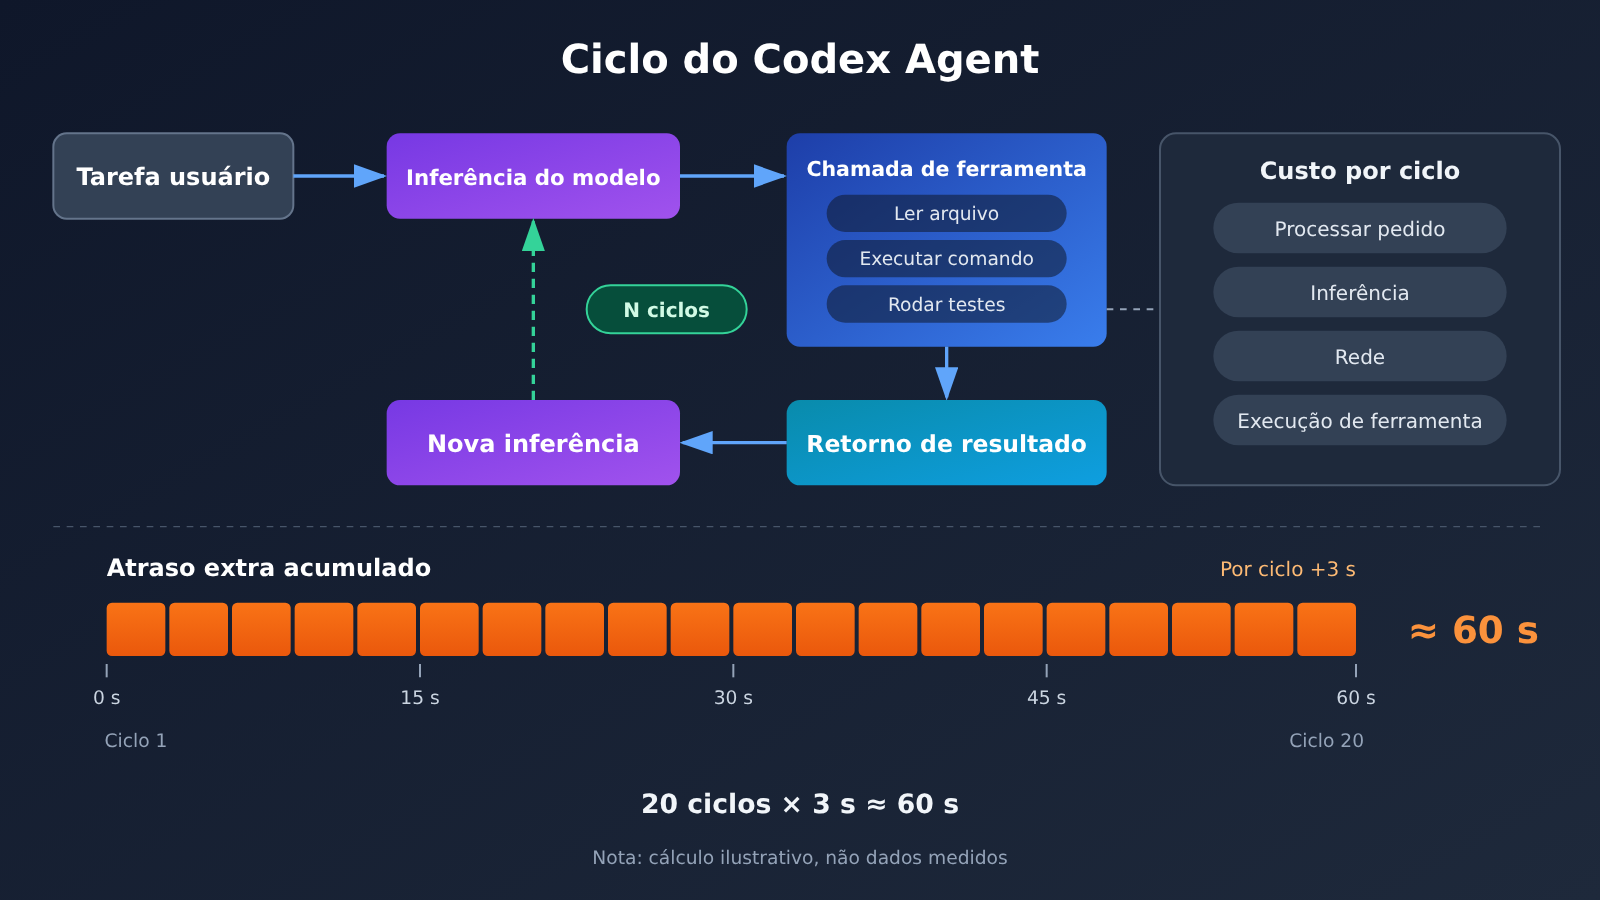
O mesmo Codex, ao fazer login com ChatGPT Plus, flui bem; ao trocar para uma chave API de terceiros, fica lento. A razão normalmente está no fato de os dois seguirem caminhos de serviço diferentes, e o ciclo do agente do Codex multiplica o atraso extra de cada rodada de requisição. A interface do cliente é a mesma, mas a implantação do modelo, o nível de inferência, o protocolo de transporte, o acerto de cache e o grau de compatibilidade dos eventos de ferramentas podem diferir. Se uma requisição demora apenas 3 segundos a mais, uma tarefa de programação que exige 20 chamadas seriais pode levar cerca de 1 minuto a mais.
A seguir, vou primeiro detalhar como o Codex funciona e os dois caminhos de acesso, depois explicar item a item as fontes de latência das APIs de terceiros, usando duas issues públicas do GitHub como evidências de caso. Em seguida, apresento quatro métricas centrais, três grupos de testes comparativos e um plano de otimização classificado por sintomas, para ajudar você a identificar se seu Codex está lento por causa do modelo, da rede, do cache ou do ciclo de ferramentas. Por fim, discuto quais métricas, ao escolher uma API de terceiros, refletem melhor o custo real do que o preço unitário.
Para saber: termos para entender as diferenças de velocidade do Codex
| Termo | Explicação |
|---|---|
| Codex Harness | Estrutura de execução do Codex, responsável por organizar o modelo, as ferramentas, o contexto e o ciclo de tarefas em múltiplas rodadas. |
| Responses API | Interface fornecida pela OpenAI que oferece suporte à saída do modelo, à chamada de ferramentas e ao gerenciamento de estado em múltiplas rodadas; o Codex depende dela para funcionar. |
| TTFT | Time To First Token: tempo de espera desde o envio da solicitação até o recebimento do primeiro token de saída. |
| TPS | Tokens Per Second: quantidade de tokens gerados por segundo, refletindo a velocidade de saída contínua. |
| Tempo de ponta a ponta | Tempo total desde o envio da tarefa até sua conclusão final, incluindo todas as chamadas ao modelo e a execução de ferramentas. |
| Intensidade de raciocínio | Nível de profundidade do raciocínio do modelo, como low, medium e high; quanto mais alto, normalmente maior a quantidade de saída e o tempo necessário. |
| Chamada de ferramentas (Tool Calling) | Processo em que o modelo solicita a um programa externo que leia arquivos, execute comandos etc., e então usa o resultado para continuar o raciocínio. |
| Cache de comandos (Prompt Caching) | Quando o prefixo de entrada é repetido e atende aos critérios, os resultados de cálculo já existentes são reutilizados para reduzir o tempo de processamento. |
| SSE | Server-Sent Events: o servidor envia eventos continuamente por uma conexão HTTP unidirecional. |
| WebSocket | Um tipo de conexão persistente e bidirecional em que solicitações de múltiplas rodadas podem reutilizar a mesma conexão. |
| previous_response_id | Parâmetro da Responses API que referencia a resposta da rodada anterior; combinado com entrada incremental, pode reduzir transmissões repetidas. |
| Nível de serviço | Diferentes opções de processamento para o mesmo modelo, como Standard e Fast, com velocidade e preço distintos. |
1 Por que o mesmo Codex apresenta duas velocidades?
1.1 Login por assinatura do Codex e chave API seguem caminhos de serviço diferentes
De acordo com a documentação de autenticação da OpenAI, a CLI do Codex, as extensões para IDE e os aplicativos de desktop suportam duas formas de login: entrar com uma conta ChatGPT ou informar uma chave API. O login com ChatGPT consome os direitos de uso do Codex incluídos na assinatura e os limites correspondentes; a chave API segue as regras de cobrança por uso e de limitação de taxa da conta de API. A própria assinatura Plus também não inclui o direito de chamar gratuitamente qualquer API da OpenAI.
Ao conectar uma chave API de terceiros, o cliente Codex apenas organiza a tarefa; a inferência real acontece no serviço por trás dessa interface. O modelo efetivamente chamado, a forma de cobrança, o protocolo de streaming e a qualidade do serviço são determinados pela interface de terceiros e pela implementação do seu backend. Portanto, o fato de o nome do modelo exibido no cliente ser o mesmo só indica que você escolheu o mesmo nome; não dá para confirmar que as duas requisições passaram pela mesma implantação de modelo, pela mesma fila de serviço e pelo mesmo caminho de transmissão.
1.2 O loop do agente do Codex faz com que ele precise requisitar o modelo repetidamente
Em 《Codex as a platform》, publicado pela OpenAI em 19 de agosto de 2026, o Agent Harness de código aberto do Codex é responsável por entender a tarefa, manter o contexto, pesquisar a base de código, chamar o Shell, editar arquivos, executar testes e lidar com recuperação de falhas, aprovação do usuário e limites de execução. Em essência, é um sistema em loop de “inferência do modelo → execução de ferramentas → nova inferência”.
Em um artigo de engenharia da OpenAI de 22 de abril de 2026, foi descrito o fluxo típico: o usuário propõe uma tarefa de modificação, o modelo decide o que fazer, o Codex lê arquivos ou executa comandos, a ferramenta retorna o resultado, o modelo analisa novamente e segue chamando ferramentas, modificando código, executando testes e verificando resultados. Tarefas complexas podem envolver dezenas de rodadas de ida e volta entre o modelo e as ferramentas, e cada rodada é uma requisição completa à API.
2 De onde vem a diferença de velocidade do Codex ao conectar-se a APIs de terceiros?
Primeiro, vamos resumir em uma tabela as cinco categorias de fontes de latência e depois detalhar cada uma.
| Fonte de latência | Métrica principalmente afetada | Comportamento típico | Prioridade de investigação |
|---|---|---|---|
| Modelo e intensidade de raciocínio | TPS, tempo de raciocínio por turno | Saída consistentemente mais lenta, tempo de pensamento longo | Alta |
| Nível de serviço e roteamento | TTFT, amplitude de variação | Primeira resposta lenta ou alternando entre rápido e lento | Alta |
| Gateway e caminho de rede | Tempo adicional fixo por turno | Cada chamada tem alguns segundos extras consistentes | Média |
| Protocolo de transporte (SSE / WebSocket) | Custo acumulado em múltiplos turnos, estabilidade da conexão | Tarefas longas lentas, interrupção no meio | Média |
| Cache e loop de ferramentas | Tempo de processamento de entrada, número de rodadas de chamada | Conversas longas ficam visivelmente mais lentas, rodadas em excesso | Alta |
2.1 Impacto da velocidade de inferência do modelo e da intensidade de raciocínio no tempo do Codex
Antes de comparar as duas formas de acesso, é preciso confirmar se o ID real do modelo, a intensidade de raciocínio, a versão do modelo e o nível de serviço são os mesmos. A intensidade de raciocínio vai de low a xhigh, max; quanto maior o nível, mais conteúdo de pensamento o modelo gera e mais longo fica o tempo por turno.
O guia de otimização de latência da OpenAI lista o número de tokens de saída como variável-chave que afeta o tempo de inferência: em alguns cenários, reduzir os tokens de saída em cerca de 50% pode fazer a latência de geração cair quase 50%; já o impacto de reduzir texto de entrada comum costuma ser bem menor. O nível de serviço também importa: o modo Fast da OpenAI pode chegar a até 2,5x de velocidade para modelos e cargas aplicáveis, mas é uma opção de nível pago e só funciona para parte dos modelos.
Isso significa que, mesmo que o lado da assinatura e o lado de terceiros exibam o mesmo modelo, se o nível de raciocínio ou o nível de serviço forem diferentes, a diferença de velocidade será evidente.
2.2 Impacto do serviço proxy de API, caminhos de rede e WebSocket em tarefas de múltiplos turnos
A cadeia de requisições de interfaces de terceiros costuma ser mais longa: cliente → gateway do provedor → nó proxy → possível link transfronteiriço → serviço de inferência final. Cada salto adicional pode acrescentar um pouco de latência fixa e flutuações de rede — e essas latências vão se acumulando turno após turno dentro do loop do Agent.
O protocolo de transporte é outra variável. A Responses API tradicional normalmente usa HTTP/SSE, o que obriga a reestabelecer a requisição e carregar o contexto a cada turno. O modo WebSocket mantém uma conexão persistente e, com o auxílio do previous_response_id e de entradas incrementais, reduz transmissão e processamento duplicados. Os dados oficiais divulgados pela OpenAI são estes:
- Uma rodada de otimização da API no final de 2025 reduziu a latência do primeiro token em quase 45%.
- Em fluxos de trabalho específicos com mais de 20 chamadas de ferramentas, o modo WebSocket proporcionou uma aceleração ponta a ponta de até cerca de 40%.
- Integrações relacionadas à Vercel relataram melhorias de latência de até cerca de 40%; fluxos de múltiplos arquivos no Cline relataram aceleração de cerca de 39%; e modelos OpenAI no Cursor relataram melhorias de até cerca de 30%.
Esses números vêm de diferentes produtos e cenários de teste, e representam valores de teto em fluxos de trabalho específicos. Alguns gateways compatíveis implementam apenas HTTP/SSE, ou não oferecem suporte completo ao WebSocket e ao gerenciamento de estado incremental usados pelo Codex — esse tipo de conexão não consegue capturar esses ganhos.
2.3 Cache de contexto do Codex e número de chamadas de ferramentas
Em tarefas longas, mensagens do histórico, definições de ferramentas e contexto repetido ocupam muitos tokens de entrada. Quando há um acerto no cache de comandos, o tempo de processamento desse prefixo pode diminuir. A documentação da OpenAI mostra que o GPT-5.6 e as séries seguintes oferecem suporte a novos controles de gravação, leitura e TTL do cache.
O problema é que o cache depende da estabilidade do prefixo da requisição. Se a camada de proxy reescrever o prefixo da requisição, alterar a ordem das definições de ferramentas ou mudar o limite do cache, isso pode afetar a reutilização do cache e fazer com que cada rodada processe novamente um grande bloco de contexto. Já o número de chamadas de ferramentas determina diretamente o número de rodadas da requisição: quanto mais rodadas, mais vezes todo o custo de cada rodada é multiplicado.
2.4 Por que a primeira resposta do Codex é normal, mas as seguintes continuam lentas?
Esta é a forma mais comum da pergunta do título. O TTFT mede apenas se o primeiro token chega rápido; o tempo total de uma tarefa do Codex é a soma de todas as rodadas. O tempo total pode ser escrito assim:
T_total = Σ (tempo de processamento da requisição à API + tempo de inferência do modelo + tempo de transmissão pela rede + tempo de execução de ferramentas locais + tempo de espera e novas tentativas)
Uma primeira resposta normal com um tempo total lento normalmente vem dos seguintes casos: a velocidade de saída contínua (TPS) é baixa, e respostas longas deixam cada rodada mais lenta; depois que a execução da ferramenta termina, o modelo faz uma nova inferência, e cada nova inferência precisa processar o contexto novamente; a conexão de streaming é interrompida no meio ou sofre timeout, o cliente aciona uma nova tentativa, e o usuário vê “o modelo travou”. Pelo funcionamento do mecanismo, uma tarefa que exige 20 chamadas sequenciais ao modelo, em que cada uma espera 3 segundos a mais, terá um aumento de cerca de 60 segundos no tempo total; esse número serve para ilustrar o efeito cumulativo, não é um resultado medido.
3 Quais evidências os casos públicos oferecem sobre o problema de lentidão do Codex?
Os dois casos abaixo vêm de relatos de usuários no repositório openai/codex. São logs isolados de um único usuário, usados para ilustrar o mecanismo — não representam o comportamento típico do setor.
3.1 Issue #60831: variação de cerca de sete vezes no tempo de resposta na mesma sessão
No Issue #60831, aberto em novembro de 2026, o relator observou duas requisições na mesma sessão, no mesmo processo cliente e com as mesmas configurações de inferência: em ambos os casos, o corpo da requisição após compressão era de cerca de 13,09 MB, não houve compressão de contexto no intervalo e o histórico de imagens também não mudou. Na requisição lenta, o tempo entre o fim da compressão da requisição e o recebimento do cabeçalho de resposta HTTP foi de 109,317 segundos; na rápida, 15,637 segundos — uma razão de aproximadamente 6,99 vezes.
Vale prestar atenção à forma de medição: esses dois números medem o tempo “até receber o cabeçalho de resposta”, ou seja, a fase de processamento no servidor, e não a duração total da tarefa. Além disso, as duas requisições vieram do mesmo caminho, então não têm relação com comparações entre assinatura e terceiros. O que isso mostra é que, quando o tamanho do contexto não muda, o próprio tempo de processamento do servidor pode oscilar bastante. O relato, por si só, não permite identificar qual etapa específica do serviço criou o gargalo.
3.2 Issue #44305: o loop de ferramentas faz o tempo de uma tarefa somente leitura disparar
No Issue #44305, de setembro de 2026, o relator comparou tarefas somente leitura do mesmo tipo: outro agente usou 3 leituras em paralelo e terminou em cerca de 10,6 segundos; o Codex rodou por 91,5 segundos e atingiu o timeout sem entregar uma resposta completa. Nesse período, o Codex realizou cerca de 11 inferências do modelo e 11 chamadas de ferramentas, acumulando aproximadamente 295.042 tokens de entrada, dos quais cerca de 260.608 tokens eram de entrada em cache.
Calculando com esses números, a entrada em cache responde por cerca de 88,3% do total — ou seja, o cache estava acertando bem —, mas as 11 rodadas seriais do loop ainda deixaram o tempo muito acima da abordagem de leitura paralela. As estratégias de trabalho dos dois agentes são diferentes por natureza, então a diferença de tempo não pode ser atribuída inteiramente ao Codex ou ao modelo; ainda assim, o caso mostra com clareza o efeito multiplicador que o número de rodadas de chamada e a execução serial têm sobre o tempo total.
Além disso, há dois outros tipos de problema diretamente ligados à integração com terceiros: o Issue #33029 relata que, ao usar uma interface compatível de terceiros no Codex Desktop, o endpoint do modelo funcionava normalmente, mas o aplicativo desktop continuava requisitando alguns serviços auxiliares do ChatGPT, e o timeout dessas requisições deixava a resposta do app mais lenta; já os Issues #41340 e #42471 relatam, respectivamente, o erro “stream disconnected before completion” em endpoints Responses de terceiros e eventos de chamada de ferramenta que são recebidos mas não entram no fluxo de execução. Um chat simples funcionar e um ciclo completo de ferramentas do Codex funcionar são dois níveis diferentes de exigência de compatibilidade.
4 Como descobrir onde o seu Codex está lento?
4.1 Identifique o gargalo do Codex com quatro métricas principais
| Indicador | Como registrar | Problema que revela |
|---|---|---|
| TTFT | Tempo de espera até a primeira saída válida em cada solicitação | Fila, inicialização do modelo, primeiro pacote da rede |
| Tempo ponta a ponta | Tempo total da tarefa, do envio à conclusão | Experiência geral; é a referência final de avaliação |
| Número de chamadas ao modelo / ferramentas | Contar rodadas de inferência, chamadas de ferramentas e tempo de execução das ferramentas | Estratégia do agente e amplificação por chamadas seriais |
| Acerto de cache | Entrada total, leitura de cache, gravação em cache, tokens de saída | Custo de reprocessamento de contexto repetido |
Além dessas quatro métricas, vale a pena registrar também o TPS, os tokens de entrada e saída de cada solicitação, o protocolo utilizado (WebSocket ou SSE) e o número de ocorrências de 429, 5xx, timeouts e retentativas. Esses dados auxiliares ajudam a distinguir “lentidão” de “lentidão causada por retentativas após erros”.
4.2 Etapas de execução dos três grupos de testes comparativos com Codex
O pressuposto do teste comparativo é controlar as variáveis: ID do modelo, intensidade de raciocínio, versão do Codex, arquivos do projeto e descrição da tarefa permanecem iguais, e cada cenário é executado tanto em sessão nova quanto em sessão longa, para identificar o impacto do tamanho do contexto.
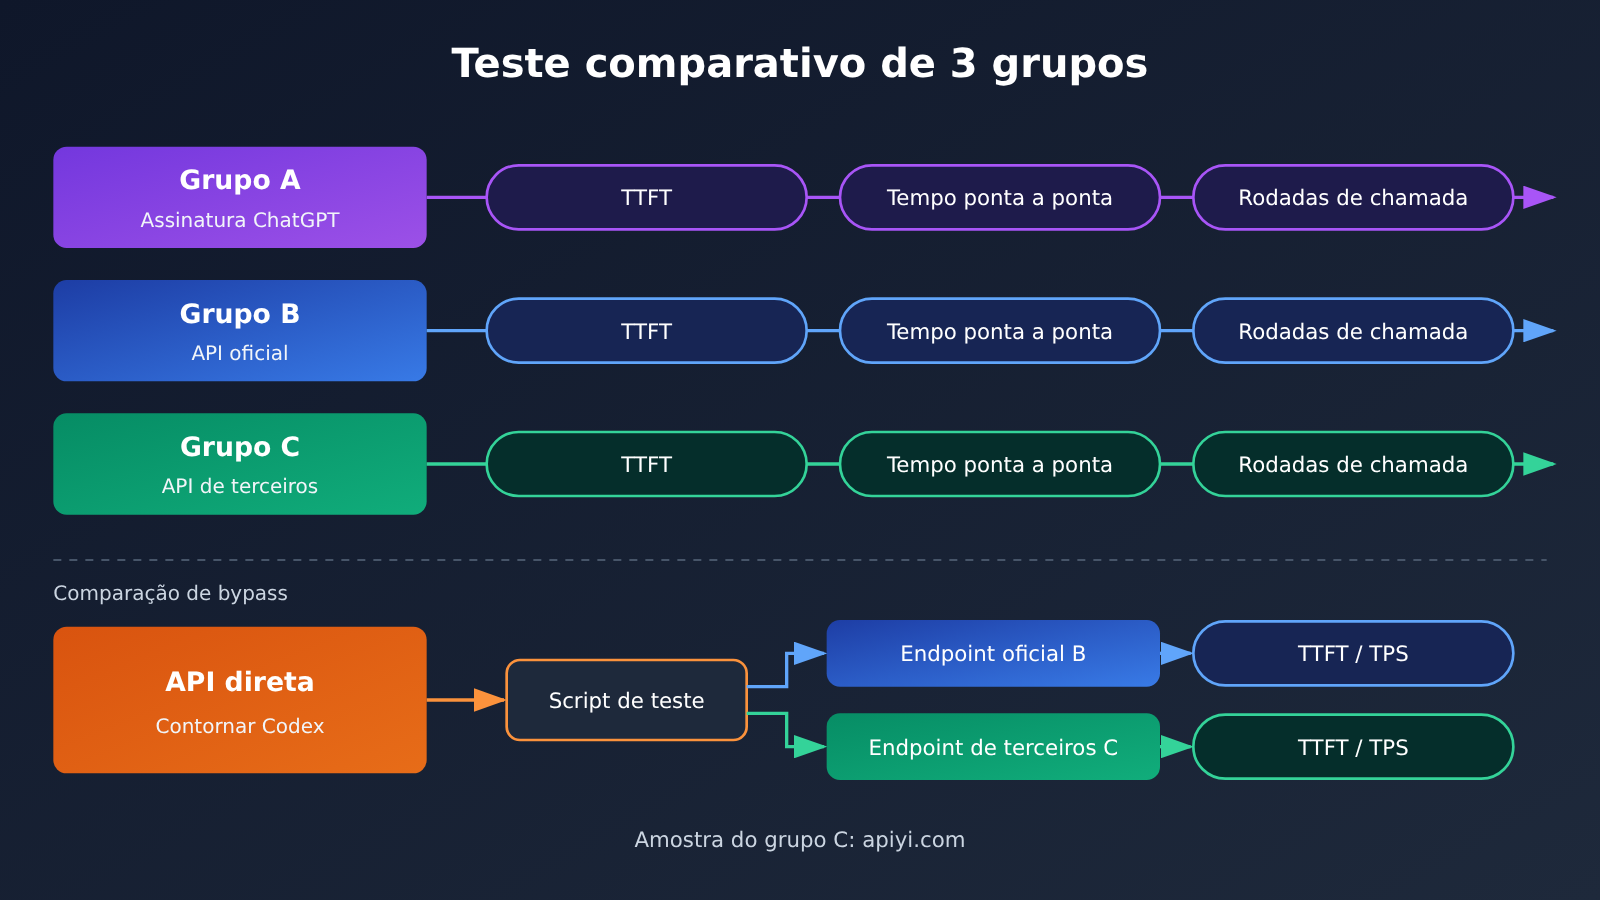
- Grupo A: entrar no Codex com a assinatura do ChatGPT, executar a tarefa padrão e registrar o tempo total e o número de rodadas de chamada.
- Grupo B: conectar o Codex usando a chave API oficial do mesmo modelo e executar a mesma tarefa.
- Grupo C: conectar o Codex usando uma API compatível de terceiros e executar a mesma tarefa.
- Grupo de conexão direta: para os caminhos B e C, ignorar o Codex e enviar a mesma requisição única via script, medindo TTFT e TPS.
A diferença entre A e B reflete principalmente a diferença de serviço entre o caminho de assinatura e o caminho de API; a diferença entre B e C reflete diferenças de gateway, roteamento e serviço de inferência; já a distância entre o resultado da conexão direta e o resultado dentro do Codex reflete o custo extra trazido pelo ciclo do Agent, pela compatibilidade de protocolo e pelo cliente. Recomenda-se repetir cada grupo várias vezes e usar a mediana, para não tomar uma oscilação pontual como conclusão.
O script abaixo serve para o teste do “grupo de conexão direta”: envia uma requisição Responses em streaming para medir TTFT, duração total, tokens de saída e TPS:
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada do APIYI; troque para o endereço oficial para fazer o comparativo do grupo B
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # Manter o mesmo ID de modelo usado no Codex
    reasoning={"effort": "medium"},   # Manter a mesma intensidade de raciocínio usada no Codex
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
Ver o script completo de testes repetidos em várias rodadas e estatísticas de cache
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # interface APIYI
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# Usar um prefixo fixo mais longo para simular o prompt de sistema e as definições de ferramentas do Codex, para observar melhor o acerto de cache
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
Ao rodar o teste do grupo C dentro do Codex, é preciso configurar o endpoint de terceiros como provedor de modelo. A forma mais comum de escrever o ~/.codex/config.toml está logo abaixo — para os nomes exatos dos campos, vale consultar a documentação oficial da versão do Codex que você está usando:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 Início rápido: para montar a comparação do grupo C, você pode solicitar a cota de teste gratuita para novos usuários em APIYI apiyi.com, usar a mesma chave para alternar entre vários modelos e executar o script acima com cada um deles — assim você obtém rapidamente dados comparáveis de TTFT e de tempo total.
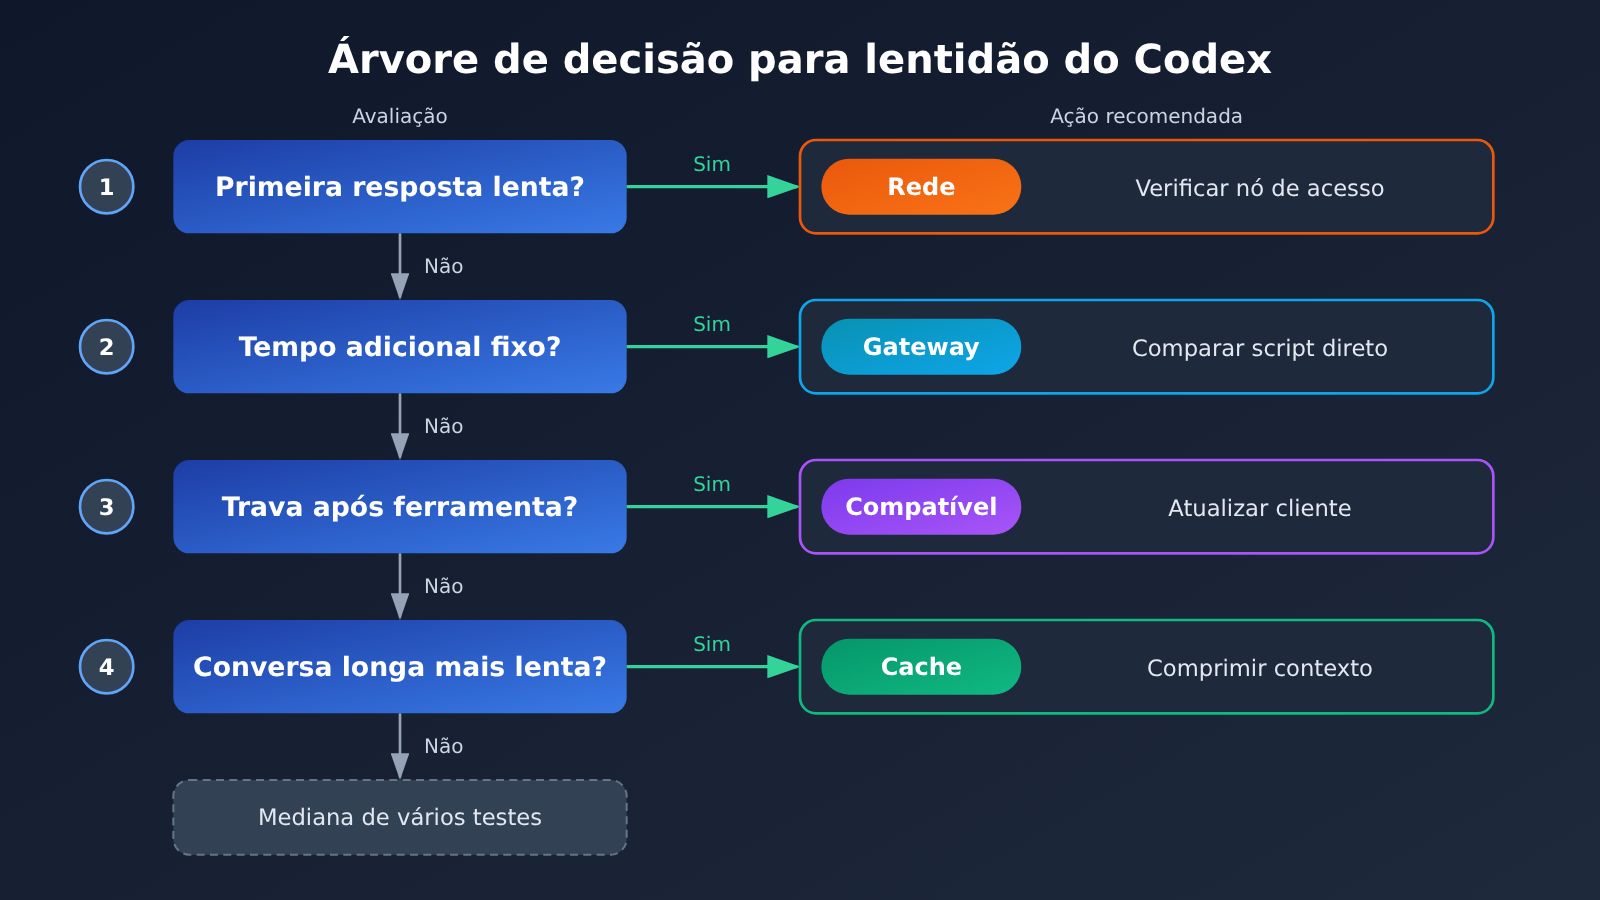
4.3 Plano de otimização do Codex por sintoma
| Sintoma | O que verificar primeiro | Como tratar |
|---|---|---|
| Primeira resposta lenta | Fila, inicialização do modelo, primeiro pacote da rede | Trocar para um nó de acesso mais próximo, confirmar o nível do plano, fazer comparações fora dos horários de pico |
| Primeira resposta rápida, seguintes lentas | TPS, rodadas de ferramentas, cache | Reduzir a intensidade de raciocínio, limitar o comprimento da saída, checar a taxa de acerto do cache |
| Tempo fixo extra em cada chamada | Link do serviço proxy de API, requisições adicionais | Comparar os grupos B e C com um script de conexão direta e localizar a sobrecarga do gateway |
| Travamento após chamada de ferramenta | Eventos do Responses, retorno da ferramenta | Verificar se houve interrupção do stream ou perda de eventos da ferramenta e atualizar a versão do cliente |
| Conversa longa bem mais lenta que uma nova | Tokens do histórico, compressão, cache | Abrir uma nova sessão na hora certa ou disparar a compressão de contexto, observando a mudança na leitura do cache |
| Velocidade oscilando entre rápida e lenta | Carga do serviço, novas tentativas, flutuação da rede | Contar ocorrências de 429/5xx e timeouts, repetir os testes várias vezes e usar a mediana |
| Aplicativo desktop travando no geral, API normal | Requisições dos serviços auxiliares do ChatGPT | Consultar a Issue #33029, verificar se as requisições auxiliares estão estourando o tempo limite e, se preciso, passar para a CLI |
A otimização no nível do modelo segue a mesma lógica do guia de latência da OpenAI: reduzir os tokens de saída, diminuir o contexto de entrada, reduzir o número de chamadas, processar etapas independentes em paralelo e não entregar ao modelo aquilo que um programa comum já resolve. No caso do Codex, o caminho mais direto é dar à descrição da tarefa um escopo mais claro, para que o Agent gaste menos rodadas exploratórias de leitura.
5 Ao escolher uma API de terceiros para o Codex, quais métricas importam mais do que o preço unitário?
5.1 Do preço por token ao custo de conclusão da tarefa
No cenário do Codex, o custo real é determinado por “concluir uma tarefa”. Uma interface com preço unitário baixo, se tiver cache com baixa taxa de acerto, muitos turnos de chamada e quedas de conexão frequentes com novas tentativas, vai acabar consumindo mais tokens e mais tempo. Na avaliação, recomenda-se olhar estas métricas em conjunto: taxa de sucesso das tarefas, tempo ponta a ponta, total de tokens consumidos por tarefa (incluindo leitura de cache) e o custo extra gerado por falhas e novas tentativas.
| Dimensão de avaliação | Pontos de atenção | Método de teste | Plataformas disponíveis |
|---|---|---|---|
| Identidade e versão do modelo | Se o ID e a versão do modelo são claros, estáveis e disponíveis | Conferir o campo de modelo retornado e a documentação | APIYI apiyi.com, API oficial |
| Primeiro token e velocidade sustentada | Mediana e variação de TTFT e TPS | Vários ciclos de teste com script de conexão direta | APIYI apiyi.com, API oficial |
| Tempo de conclusão do Agent em múltiplos turnos | Tempo total de tarefas reais dentro do Codex | Testes comparativos em três grupos | APIYI apiyi.com, API oficial |
| Compatibilidade de protocolo | Suporte a Responses, WebSocket e eventos de ferramentas | Rodar uma tarefa completa de ler arquivo + alterar código + testar | Depende da documentação do provedor |
| Suporte a cache | Se os tokens de leitura de cache são retornados normalmente | Contabilizar os campos de cache no usage | Depende da documentação do provedor |
| Estabilidade e cobrança | Taxa de falha, concorrência, transparência da cobrança | Registrar 429/5xx e os detalhes da fatura | Depende da documentação do provedor |
5.2 Avaliar interfaces de terceiros como a APIYI usando tarefas reais
APIYI apiyi.com é uma plataforma de agregação de APIs de Modelos de Linguagem Grande: uma única chave API permite chamar os principais modelos como OpenAI, Claude e Gemini, a interface é compatível com o protocolo da OpenAI e a cobrança é por uso. Seu valor no cenário do Codex está principalmente na facilidade de comparação lado a lado: com a mesma configuração, basta trocar de modelo e de nível para gerar dados comparáveis no seu próprio projeto.
Cada provedor terceirizado tem cadeia de conexão, suporte de protocolo e estabilidade diferentes, então a avaliação deve se basear em dados de teste concretos e no contrato de serviço. Recomenda-se selecionar 2 a 3 tarefas representativas (por exemplo, uma refatoração envolvendo vários arquivos e uma correção de bug com testes), executá-las em cada forma de acesso conforme o método da seção 4, e então decidir combinando taxa de sucesso e total de tokens.
💡 Sugestão de escolha: primeiro use o script de conexão direta para eliminar as opções com TTFT e TPS claramente fora da faixa, depois coloque os candidatos restantes no Codex para rodar tarefas completas. Com a interface unificada do APIYI apiyi.com, é possível comparar vários modelos sem alterar a estrutura do código.
Perguntas frequentes
Q1: De onde vem principalmente a diferença de velocidade entre a assinatura do Codex e uma API de terceiros?
A diferença vem do caminho de serviço como um todo: implantação real do modelo, intensidade de raciocínio, nível de serviço,链路 do gateway, protocolo de transporte, acerto de cache e grau de compatibilidade com eventos de ferramentas. O ciclo de agente em múltiplas rodadas do Codex acumula essas diferenças de cada rodada, por isso a diferença no tempo total costuma ser muito maior do que a diferença em uma única requisição.
Q2: Se o TTFT está normal, por que a tarefa do Codex continua lenta?
O TTFT mede apenas o tempo de espera pelo primeiro token. Uma tarefa do Codex envolve múltiplas rodadas de raciocínio e chamadas de ferramentas; a velocidade de saída contínua, o novo raciocínio após a execução de ferramentas, os erros de acerto de cache e as novas tentativas no meio do caminho também aumentam o tempo total. Para avaliar a experiência, é preciso olhar o tempo ponta a ponta e o número de rodadas de chamada.
Q3: Quanto o modo WebSocket pode acelerar o Codex?
Os dados divulgados pela OpenAI são: em fluxos de trabalho específicos com mais de 20 chamadas de ferramentas, a velocidade ponta a ponta pode aumentar em até cerca de 40%. Esse é o limite em um cenário específico; o ganho real depende do número de rodadas da tarefa e de a interface oferecer suporte completo a WebSocket e gerenciamento de estado incremental.
Q4: O Codex fica cada vez mais lento em conversas longas. Como lidar com isso?
Primeiro, registre o total de tokens de entrada e os tokens lidos do cache em cada rodada, para confirmar se o cache está tendo acertos normais. Se o contexto histórico estiver muito longo, você pode abrir uma nova sessão ou acionar a compactação de contexto; ao mesmo tempo, reduza o escopo da tarefa e diminua as rodadas exploratórias de leitura de arquivos.
Q5: Como testar rapidamente o desempenho real de uma API de terceiros no Codex?
1. Registre-se na APIYI apiyi.com e obtenha a chave API e a cota gratuita de teste;
2. Use o script de conexão direta deste artigo para medir TTFT, TPS e acerto de cache;
3. Configure o Codex conforme a seção 4.2, execute a mesma tarefa do lado da assinatura e compare o tempo ponta a ponta e o número de rodadas de chamada.
Assim, você consegue separar a diferença do serviço de raciocínio da diferença trazida pelo ciclo de agente.
Q6: Os dados em Issues públicas representam o desempenho geral do Codex?
Não representam diretamente. As Issues #60831 e #44305 são logs de um único usuário: a primeira mede o tempo até os cabeçalhos da resposta HTTP, e a segunda é uma tarefa somente leitura que terminou em timeout. O valor delas está em mostrar como a oscilação do servidor e o ciclo serial de ferramentas afetam o tempo; as conclusões específicas precisam ser verificadas com os seus próprios testes de tarefas.
Pontos-chave sobre a diferença de velocidade do Codex
- Caminhos diferentes: login por assinatura e chave API seguem caminhos de cobrança e serviço distintos; um nome de modelo igual não significa a mesma implantação.
- Amplificação pelo loop: o loop de agente do Codex acumula as pequenas latências de cada rodada numa diferença de tempo total significativa.
- Métricas em camadas: o TTFT mede a primeira resposta; é o tempo ponta a ponta e o número de rodadas de chamada que refletem a experiência real.
- O protocolo importa: o WebSocket traz até cerca de 40% de ganho em cenários de múltiplas rodadas de chamada de ferramentas, mas exige suporte completo da interface.
- Cache precisa ser conferida: a camada de proxy pode alterar o prefixo da requisição e afetar o cache; é preciso contabilizar os tokens de leitura de cache.
- Teste comparativo: compare três grupos (assinatura, API oficial e API de terceiros) na mesma tarefa, além de um teste de conexão direta para localizar o gargalo.
- Escolha por tarefa: faça testes horizontais com tarefas reais em plataformas como APIYI apiyi.com e observe o custo de conclusão da tarefa, não o preço unitário.
Resumo
O mesmo Codex apresentando duas velocidades tem raiz no efeito combinado do caminho de serviço com o loop do agente:
- No plano do mecanismo: modelo, intensidade de raciocínio, nível de serviço, gateway, protocolo, cache e loop de ferramentas determinam juntos o tempo total; qualquer diferença de uma única rodada é amplificada por múltiplas chamadas.
- No plano das evidências: dados oficiais mostram que a otimização de protocolo e de nível de serviço traz ganhos consideráveis; logs de usuários mostram que oscilações do servidor e loops serializados alongam significativamente a tarefa.
- No plano do método: registre as quatro métricas centrais, faça três grupos de comparação mais um teste de conexão direta e então otimize item por item conforme o sintoma.
Ao investigar, primeiro fixe o modelo e a intensidade de raciocínio, e depois deixe os dados falarem. Se precisar comparar vários modelos e formas de acesso, use a interface unificada do APIYI para reduzir ao mínimo o custo de teste.
📚 Referências
- Codex as a platform: build on the open agent harness: a OpenAI apresenta as responsabilidades do Codex Agent Harness
- Link:
developers.openai.com/blog/codex-as-a-platform -
Descrição: base oficial para entender o modelo multi-turno e o ciclo de ferramentas do Codex
-
Documentação de autenticação do Codex: duas formas de acesso, login via ChatGPT e API Key
- Link:
learn.chatgpt.com/docs/auth?surface=cli -
Descrição: diferencia os benefícios da assinatura, a cobrança da API e as regras de limite de taxa
-
Speeding up agentic workflows with WebSockets in the Responses API: artigo de engenharia da OpenAI
- Link:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
Descrição: fluxo do ciclo do agente e dados de aceleração com WebSocket
-
Documentação do modo WebSocket: modo WebSocket da Responses API
- Link:
developers.openai.com/api/docs/guides/websocket-mode -
Descrição: conexões persistentes, entrada incremental e cenários aplicáveis
-
Guia de otimização de latência: princípios de otimização de latência da OpenAI
- Link:
developers.openai.com/api/docs/guides/latency-optimization -
Descrição: ideias de otimização como tokens de saída, número de chamadas e paralelização
-
Documentação do Fast mode: níveis de serviço e escopo de aceleração
- Link:
developers.openai.com/api/docs/guides/fast-mode -
Descrição: variável de nível de serviço que precisa ser controlada ao comparar velocidades
-
Documentação de Prompt caching: gravação, leitura e TTL do cache
- Link:
developers.openai.com/api/docs/guides/prompt-caching -
Descrição: estatísticas e otimização de acertos de cache em conversas longas
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471: problemas de latência e compatibilidade relatados por usuários
- Link:
github.com/openai/codex/issues/60831,github.com/openai/codex/issues/44305,github.com/openai/codex/issues/33029 - Descrição: logs de casos individuais sobre oscilações do servidor, amplificação do ciclo de ferramentas, solicitações auxiliares no desktop e compatibilidade com protocolos de terceiros
Autor: equipe técnica da APIYI
Contato técnico: fique à vontade para entrar em contato conosco pela página inicial do site APIYI apiyi.com para trocar experiências sobre integração do Codex e testes de desempenho. Para mais materiais, acesse a central de documentação em docs.apiyi.com


