
Nota do autor: uma análise dos 64,9% de Claude Fable 5.2 no RoboDojo Sim: em que condições esse resultado foi alcançado, quanto ele fica à frente de Opus 5.5 e GPT-6 Astra, o que não dá para concluir a partir dele e quais custos e limitações você precisa considerar antes da integração.
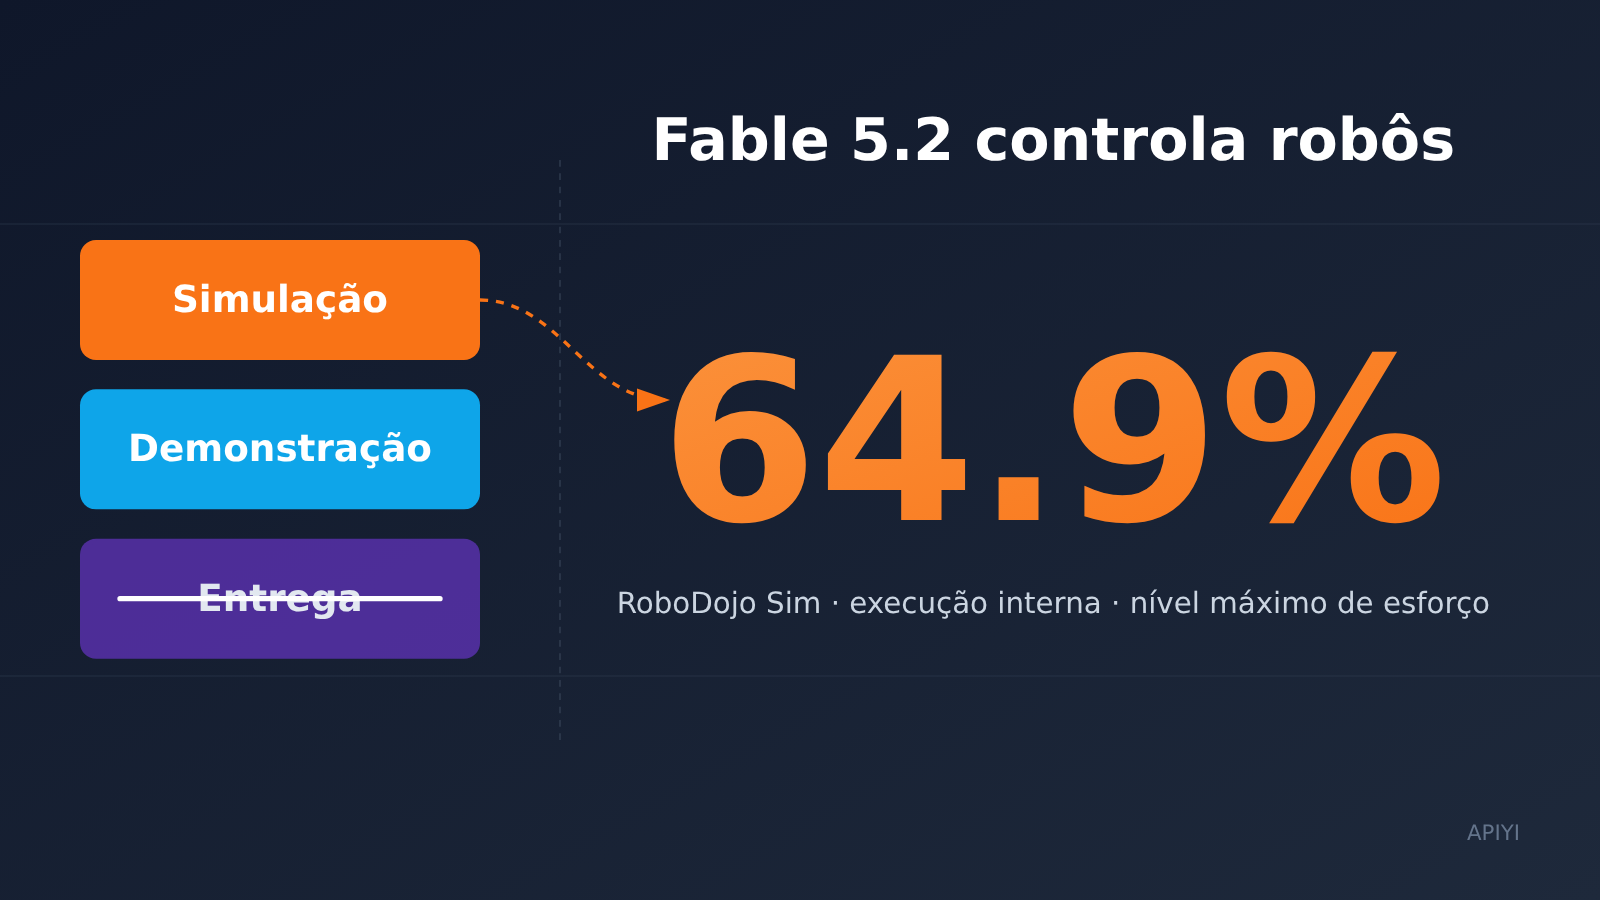
Vamos direto ao ponto. No RoboDojo Sim, em uma execução interna da Anthropic e com o nível máximo de esforço, Claude Fable 5.2 alcançou 64,9%, Opus 5.5 ficou com 39,4%, GPT-6 Astra com 29,8% e Fable 5.1 com 27,6%. Esses resultados medem o desempenho dos modelos ao analisar imagens de câmeras e controlar dois braços robóticos simulados — não são registros de entregas em fábricas.
Isto não é um artigo promocional dizendo que “a era dos robôs chegou”. A seguir, vamos separar os resultados de simulação, os vídeos de demonstração e as implantações no mundo real. Se você está se preparando para integrar uma API e calcular os custos, ao terminar a leitura poderá avaliar se já vale a pena mudar sua estratégia técnica por causa desses 64,9%.
O principal: entenda o que os 64,9% de Fable 5.2 comprovam e o que não comprovam — e descubra qual modelo você pode chamar hoje para fazer validações preliminares.
O que significa exatamente o 64,9% do Claude Fable 5.2?
Dá para explicar esse número em três frases. RoboDojo é um benchmark público que mede se um modelo consegue controlar um robô de dois braços em um ambiente simulado com base em imagens de câmeras. A nota de rodapé do anúncio informa que os 64,9% foram obtidos em uma execução interna da Anthropic, usando o nível de esforço mais alto disponível. Até 10/11/2026, não conseguimos confirmar esse mesmo número na página pública de classificação do RoboDojo. Por isso, não dá para dizer que o resultado ficou em “primeiro lugar no ranking público”, muito menos que o modelo é “o melhor modelo de robótica do mundo”.
Veja a comparação do RoboDojo Sim apresentada pela Anthropic no anúncio de 09/11/2026:
| Modelo | RoboDojo Sim | Diferença em relação ao Fable 5.2 | Observação |
|---|---|---|---|
| Claude Fable 5.2 | 64.9% | — | Execução interna, nível de esforço mais alto |
| Claude Opus 5.5 | 39.4% | 25.5 pontos a menos | Na mesma tabela |
| GPT-6 Astra | 29.8% | 35.1 pontos a menos | Resultado obtido pela Anthropic, não divulgado pela OpenAI |
| Claude Fable 5.1 | 27.6% | 37.3 pontos a menos | Geração anterior |
| Gemini 4 Carbon | Em branco na tabela | Não é possível comparar | Sem resultado informado; não dá para considerar como 0 |
A pontuação passou de 27.6% para 64.9%, mais que dobrando de uma geração para outra. É uma diferença bem marcante na tabela inteira. Mas esse resultado depende de três condições: ambiente simulado, execução interna e nível de esforço mais alto. Se qualquer uma delas mudar — por exemplo, para testes com robôs reais, uma avaliação independente ou o nível de esforço padrão —, não dá para aplicar o mesmo número diretamente.
Qual é a relação entre Fable 5.2 e Mythos 5.2?
O anúncio explica claramente: Claude Fable 5.2 e Claude Mythos 5.2 são o mesmo modelo de base. O Fable tem proteções mais rigorosas contra riscos de segurança cibernética e biológica e, por isso, está disponível para todos os usuários. O Mythos só é disponibilizado para organizações aprovadas em programas de verificação de ciências da vida ou segurança cibernética. O Mythos não é “outro modelo mais poderoso”. Para avaliar o desempenho em robótica, basta olhar para o Fable 5.2.
Os IDs oficiais dos modelos são:
- Claude API, Google Cloud, Microsoft Foundry e Claude Platform on AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - Os IDs correspondentes do Mythos são
claude-mythos-5-2eanthropic.claude-mythos-5-2
Funcionalidades principais do Fable 5.2 no controle de robôs: o que aparece na demonstração
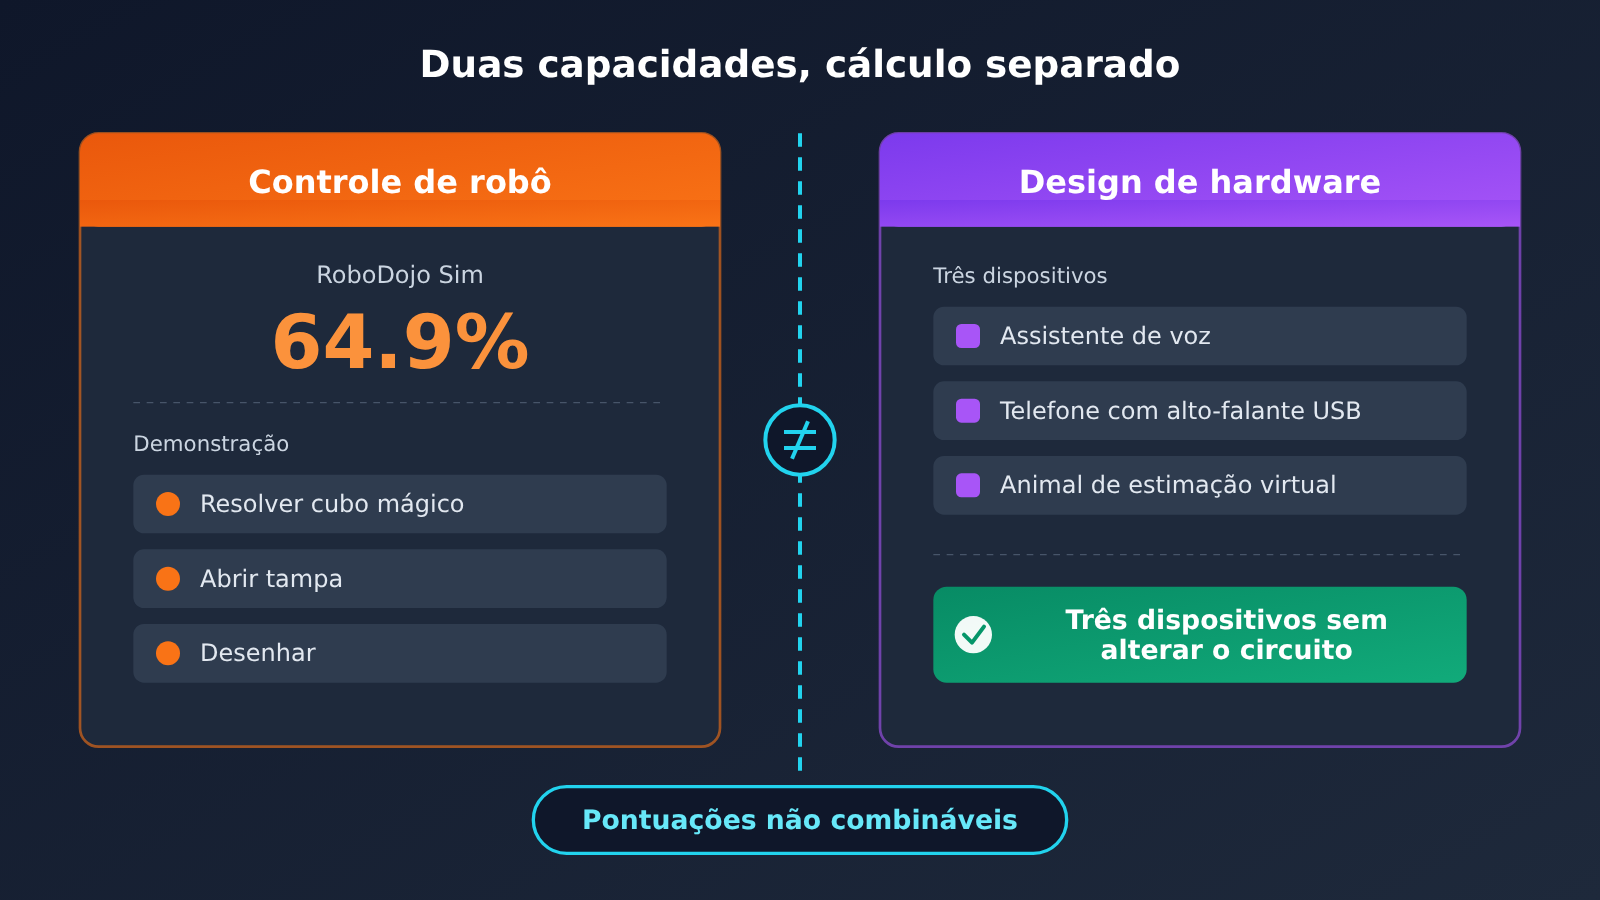
Segundo a publicação de lançamento, o Fable 5.2 controla robôs físicos muito melhor do que os modelos Claude anteriores, inclusive em tarefas para as quais não foi treinado especificamente. O vídeo de demonstração mostra três cenários: resolver um cubo mágico, abrir uma garrafa e desenhar um robô.
Esses exemplos devem ser entendidos como “demonstrações da publicação de lançamento”. Eles mostram que o modelo executou essas ações em configurações específicas, mas não informam a taxa de sucesso, o número de tentativas nem a proporção de falhas. Também não significam que a Anthropic lançou um pacote de habilidades para robôs que possa ser instalado diretamente. A empresa afirma que algumas das tarefas não foram treinadas especificamente, o que é interessante, mas ainda se trata de uma declaração oficial, sem dados que permitam uma reprodução independente.
A publicação também afirma que o Fable 5.2 superou outros modelos de ponta e a maioria dos sistemas desenvolvidos especificamente para controlar robôs no mesmo conjunto de testes. A segunda afirmação não vem acompanhada de uma lista, então não dá para saber quais sistemas foram comparados nem quais versões foram usadas. É um sinal de tendência, não uma conclusão.
O modelo gera texto; o controle fica por conta de um kit externo
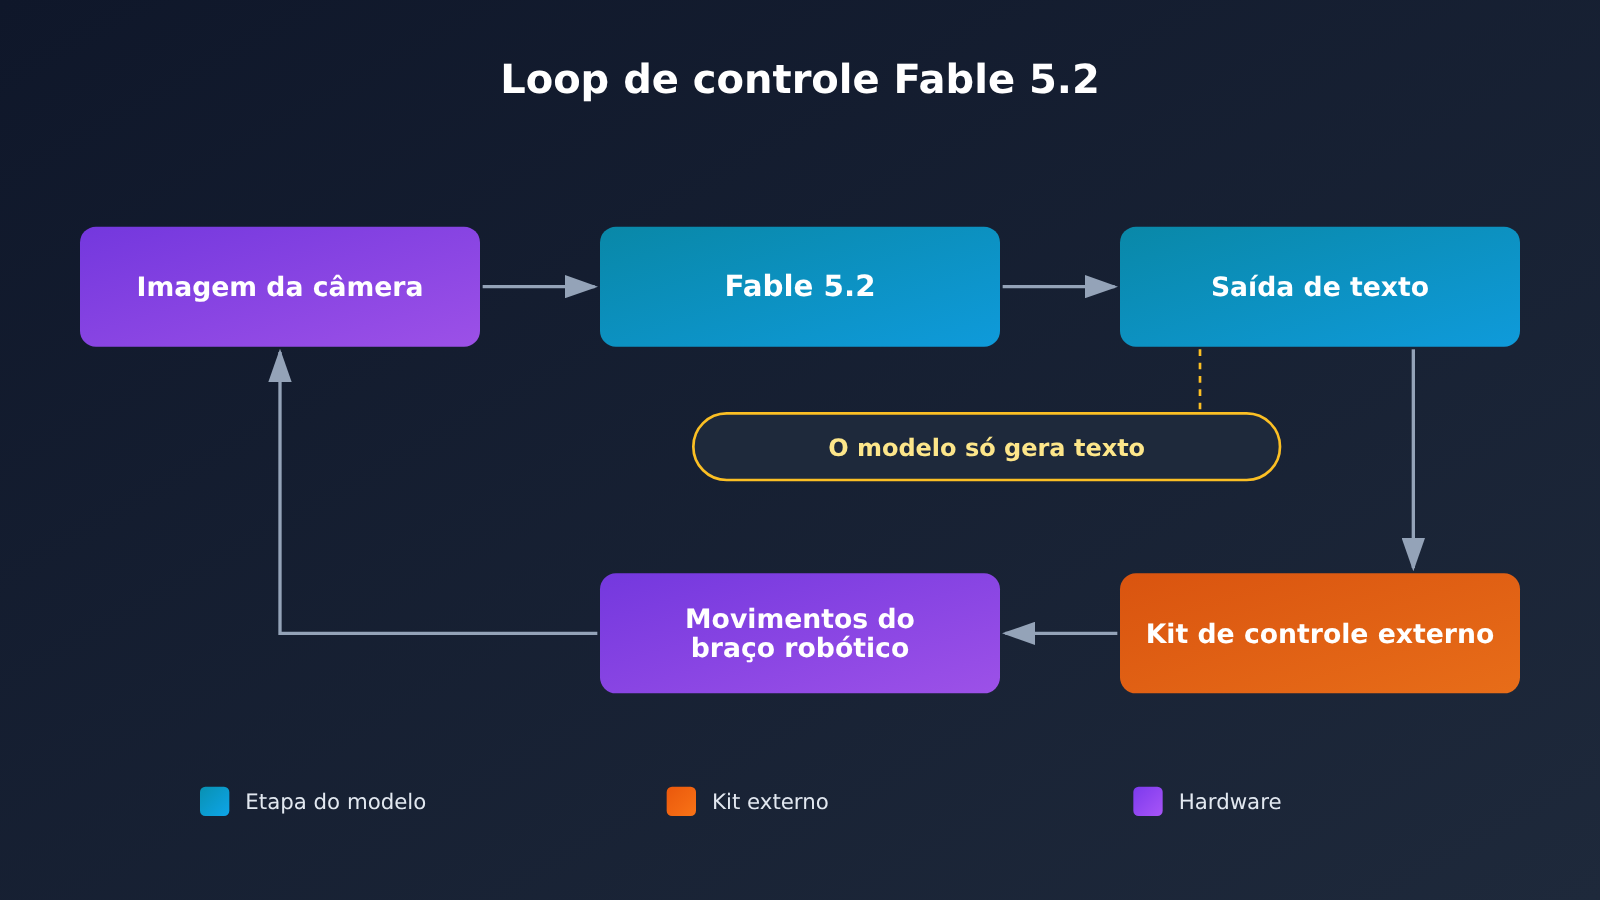
Esse é o ponto que mais facilmente passa despercebido nos vídeos de demonstração. A página do modelo informa que o Fable 5.2 recebe texto e imagens, mas sua única saída é texto. Ele não envia instruções diretamente aos motores: a cada etapa, um kit externo precisa interpretar o texto e convertê-lo em ações, depois enviar ao modelo uma nova imagem da câmera.
Por isso, em situações reais, o controle depende tanto do modelo quanto do seu kit: de como o espaço de ações é definido, do que acontece quando a interpretação falha e de a latência por etapa ser aceitável. Os 64,9% do RoboDojo foram obtidos com o kit da própria Anthropic. Ainda não se sabe como a pontuação mudaria com outro kit.
Dados de testes do Fable 5.2: a diferença em robótica não é a mesma que em tarefas no computador
Muita gente vê que “o Fable 5.2 é muito bom” e acaba misturando as pontuações de robótica com as de outras tarefas. A tabela abaixo reúne dados do anúncio da Anthropic, publicado em 2026-11-09, e compara a diferença entre alguns testes relacionados a “controle”:
| Teste | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Vantagem do Fable 5.2 sobre o Opus 5.5 |
|---|---|---|---|---|
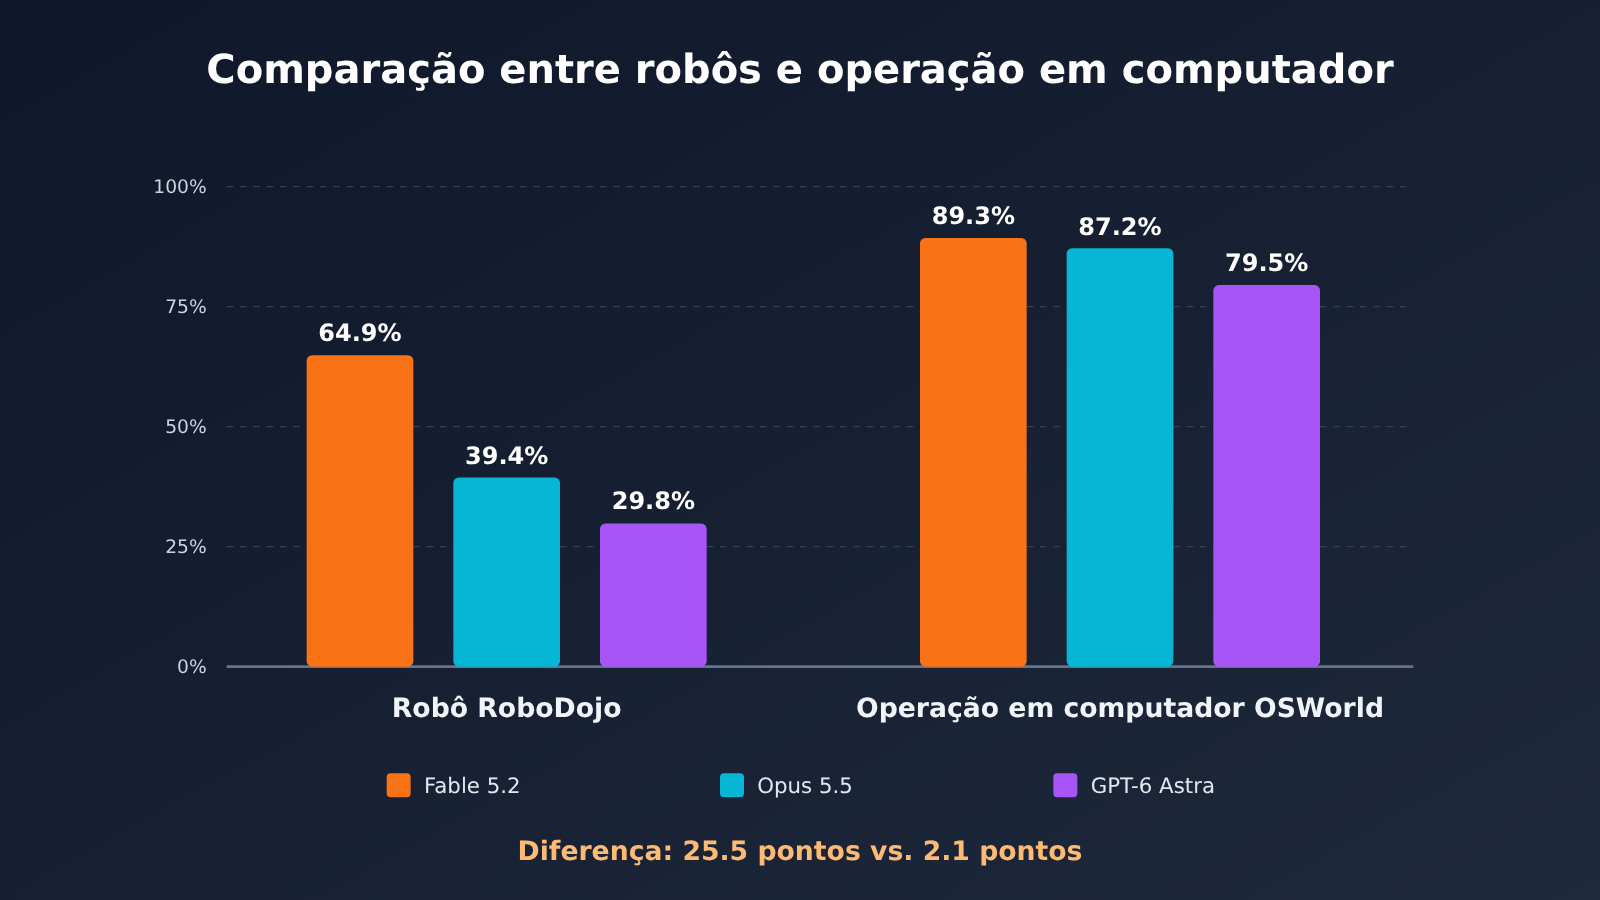
| RoboDojo Sim (simulação bimanual) | 64.9% | 39.4% | 29.8% | 25.5 pontos |
| OSWorld 2.1 (operações no computador, parte offline do conjunto) | 89.3% | 87.2% | 79.5% | 2.1 pontos |
| AutomationBench | 51.4% | 42.5% | 41.4% | 8.9 pontos (o Carbon ficou acima, com 53.9%) |
| Remote Labor Index (faixa High) | 41.3% | 21.3% | 20.8% | 20.0 pontos |
No OSWorld 2.1, o Fable 5.2 supera o Opus 5.5 por apenas 2.1 pontos. Essa diferença está longe de ser da mesma magnitude que o salto de 39.4% para 64.9% no RoboDojo. Se o seu caso de uso envolve agentes que operam computadores, a diferença entre o Opus 5.5 e o Fable 5.2 é bem menor do que nos testes de robótica.
Nível de esforço: 64.9% não é o resultado do nível padrão
Salvo indicação em contrário, a tabela de resultados do anúncio usa o nível de esforço mais alto disponível para cada modelo naquele momento. O esforço padrão do Fable 5.2 é high na Claude API e Medium no aplicativo Claude e no Claude Code. Ou seja, se você fizer uma chamada com os parâmetros padrão, talvez não obtenha a configuração que alcançou os 64.9%.
O nível mais alto exige mais tempo de raciocínio e mais tokens. Em um ciclo de robótica, que exige decisões repetidas, usar o nível máximo de raciocínio em cada etapa aumenta tanto a latência quanto o custo. O anúncio não informa quanto os 64.9% cairiam nos níveis high ou medium.
Comparativo de especificações: Fable 5.2, Opus 5.5 e GPT-6 Astra
| Item | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Contexto | 1M | 1M | 1,050,000 |
| Saída máxima | 128K | 128K | 128,000 |
| Modalidades de entrada / saída | Texto + imagem / texto | Texto + imagem / texto | Texto + imagem / texto |
| Nível de esforço padrão da API | high | medium | Compatível com low até max |
| Faixa de latência | Moderate | Moderate | A página oficial não usa a mesma métrica |
| Corte de conhecimento | junho de 2026 | 2026-06 | 2026-04-30 |
Nos três modelos, a saída é texto — uma limitação comum que não dá para ignorar ao controlar robôs.
O que Fable 5.2 não deve contabilizar como pontuação em robótica
Três dispositivos eletrônicos são um experimento de design de hardware
O texto de lançamento também menciona outro projeto: com um comando de apenas um parágrafo, Fable 5.2 projetou três dispositivos eletrônicos funcionais: um assistente de voz doméstico, um telefone com alto-falante USB e um bichinho virtual portátil. O projeto foi realizado em parceria com a Diode. Cada placa de circuito levou menos de um dia para ser produzida, e os três dispositivos funcionaram sem precisar de nenhuma alteração no circuito.
Isso demonstra capacidade de design de hardware, mas não tem relação com o RoboDojo — e os dispositivos também não são robôs. Apresentar esse resultado junto dos 64,9% pode dar a impressão de que o modelo cuida de tudo, do projeto ao controle, mas não há relação entre as duas coisas.
Limites das capacidades do Fable 5.2: restrições que afetam o loop de controle
As informações a seguir vêm da página do modelo e das notas de atualização. Cada item afeta diretamente o loop de controle que você está montando:
- A chamada obrigatória de ferramentas gera erro: definir
tool_choicecomoanyoutoolretorna 400. Se seu conjunto de ferramentas depende da chamada obrigatória de uma ferramenta de ação, será preciso deixar o modelo escolher por conta própria e incluir uma alternativa de segurança para analisar a resposta. - Não é possível definir parâmetros de amostragem: enviar
temperature,top_poutop_kretorna 400. - Não é possível desativar o raciocínio: o raciocínio adaptativo fica sempre ativado; só dá para ajustar sua intensidade por meio de
effort. As notas de atualização mencionam que, nos níveis medium ou superiores, escrever “não pense, responda diretamente” no comando não faz o modelo parar de raciocinar. - O modelo fala pouco em cadeias longas de ferramentas: durante chamadas consecutivas de ferramentas, as respostas voltadas ao usuário podem ser escassas, ou o modelo pode chamar ferramentas sem dar explicações. A interface de monitoramento não deve depender de relatos espontâneos de progresso.
- O modelo pode parar antes da hora: às vezes, uma rodada termina e o modelo para, deixando uma lista de tarefas pendentes, ou fica bloqueado por um obstáculo comum. Isso acontece com mais frequência no nível low.
- Recusas também consomem a cota: quando o modelo recusa uma solicitação, retorna HTTP 200 com
stop_reasonigual arefusal; mesmo assim, isso consome a cota de requisições. - Retenção de dados: os dados são retidos por 30 dias. Não é possível usar retenção zero de dados sem autorização explícita da Anthropic.
Os loops de controle de robôs exigem que cada etapa produza uma ação executável. Em conjunto, esses pontos significam que, antes de integrar o modelo ao loop de controle, você precisa preparar o sistema para se recuperar de timeouts, ações vazias, recusas e interrupções no meio do processo.
Preços do Fable 5.2: faça as contas antes de integrar
Os preços oficiais são por milhão de tokens e foram consultados na página do modelo, nas notas de atualização e na página do modo rápido:
| Item de cobrança | Fable 5.2 | Opus 5.5 | GPT-6 Astra (contexto curto) |
|---|---|---|---|
| Entrada / saída padrão | $8 / $40 | $4 / $20 | $10 / $50 |
| Leitura do cache | $0.20 | $0.20 | $1 (entrada em cache) |
| Gravação no cache | 5 minutos: $10; 1 hora: $16 | Disponível na página oficial, mas não listado aqui | $12.5 |
| Em lote | Com 50% de desconto: $4 / $20 | Também com 50% de desconto | Não listado aqui |
| Modo rápido | $16 / $80 | $8 / $40 | — |
Há mais alguns pontos importantes. O Fable 5.2 é 20% mais barato que o Fable 5.1 ($10 / $50). O modo rápido mantém os mesmos recursos, mas pode gerar respostas até 2,5 vezes mais rápido que o modo padrão. No entanto, o preço do cache no modo rápido não é informado separadamente pela documentação oficial. Fazendo uma estimativa proporcional, a leitura do cache fica em cerca de $0.40, a gravação com cache de 5 minutos, em cerca de $20, e a gravação com cache de 1 hora, em cerca de $32. Os modos de velocidade não compartilham o cache de comandos; mudar do modo rápido para o padrão causa um cache miss. No GPT-6 Astra, quando a entrada ultrapassa 272K tokens, a solicitação inteira é cobrada com multiplicadores de 2x para a entrada e 1,5x para a saída.
Em um loop de robô, uma nova imagem é enviada a cada etapa, enquanto o comando de sistema e as instruções de ação anteriores praticamente não mudam. Esse tipo de estrutura pode reduzir custos com o cache, mas não elimina os tokens de entrada das imagens nem os tokens de raciocínio de cada etapa.
Já dá para usar o Fable 5.2? Status de disponibilidade no APIYI
Até 10/11/2026, claude-fable-5-2 ainda não aparece no catálogo de modelos nem na API pública de preços do APIYI apiyi.com. Também não há nenhum modelo Mythos disponível. Vamos disponibilizar esse modelo o quanto antes. Consulte a lista de modelos da plataforma para conferir os IDs e os preços. Antes disso, este artigo não informa o preço do Fable 5.2 no APIYI nem calcula o preço oficial com base nos multiplicadores de grupo.
Naquele dia, estes modelos relacionados já estavam disponíveis no catálogo do APIYI. Os preços listados estão em dólares por milhão de tokens:
| ID do modelo | Entrada / saída | Leitura do cache | Endpoint | Indicação |
|---|---|---|---|---|
claude-opus-5-5, claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat, messages | Começar a montar o fluxo de chamada de ferramentas e controle do computador |
claude-fable-5-1, claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat, messages | Usar como referência para comparar com a geração anterior |
claude-fable-5, claude-fable-5-thinking |
$10 / $50 | $1 | chat, messages | Comparar com versões anteriores |
gpt-6-astra |
$10 / $50 | $1 | responses (principal), chat | Comparar com modelos de outros fornecedores |
Os preços do catálogo são os valores listados. A cobrança real também depende do multiplicador do grupo de tokens; confira a fatura. A nota de rodapé de gpt-6-astra informa apenas as faixas de preço de entrada ($10 para até 272.000 tokens e $20 de 272.001 a 1.050.000 tokens). O preço de saída para contextos longos não está especificado; consulte a fatura no console. Para integrar, use a interface compatível com OpenAI e defina base_url como https://api.apiyi.com/v1.
Uma abordagem prática é começar com claude-opus-5-5 para validar a entrada de imagens, a interpretação de ações e a recuperação de falhas. Quando o Fable 5.2 estiver disponível no APIYI, basta trocar o ID do modelo para fazer a comparação. A diferença em tarefas com robôs (25,5 pontos) é bem maior do que em operações no computador (2,1 pontos), então faz sentido esperar pelo Fable 5.2. Ainda assim, vídeos de demonstração não bastam para tomar uma decisão.
Análise dos pontos fortes e limitações do Fable 5.2 em robótica
Pontos fortes
- Grande salto entre gerações: o RoboDojo Sim subiu de 27,6% para 64,9%, uma das maiores melhorias em toda a tabela de resultados.
- Vantagem expressiva em relação a modelos semelhantes: 25,5 pontos acima do Opus 5.5 e 35,1 pontos acima do GPT-6 Astra (dados do anúncio publicado pela Anthropic).
- Preço mais baixo: o preço padrão é 20% menor que o do 5.1, e a leitura em cache custa US$ 0,20.
- Entrada visual consistente: aceita imagens e tem uma janela de contexto de 1 milhão de tokens, capaz de acomodar históricos visuais mais longos com várias etapas.
Limitações
- Evidências limitadas: os resultados vêm de testes internos, na configuração de maior esforço. Não foi possível confirmar o mesmo número em rankings públicos, e não há uma reprodução independente.
- Dados apenas de simulação: os vídeos de demonstração não informam taxas de sucesso, e a afirmação de que o modelo “supera a maioria dos sistemas robóticos especializados” não vem acompanhada de uma lista.
- Muitas restrições no ciclo de controle: só gera texto, não é possível forçar o uso de ferramentas, não dá para desativar o raciocínio e, em sequências longas, o modelo raramente explica o que está fazendo por iniciativa própria.
- Custo alto na configuração máxima: a pontuação foi obtida na configuração de maior esforço. Na prática, você precisa medir a latência e o consumo de tokens no seu próprio ambiente.
Quando não usar isso como motivo para trocar de modelo
Se você não tem um ambiente de simulação ou um ciclo de controle com robô real, os 64,9% não têm um significado verificável para você: não dá para confirmar se o resultado se mantém na sua configuração. Se sua necessidade envolve segurança cibernética, biologia ou programação do dia a dia, essa pontuação também não comprova nada — para esses casos, vale consultar os testes específicos. A recomendação do próprio anúncio é começar pelo Opus 5.5 na maioria das tarefas de programação e de conhecimento, e depois subir ou descer de modelo conforme a dificuldade.
Perguntas frequentes (FAQ)
Q1: Os 64,9% do Fable 5.2 são um resultado do ranking público?
Não. A nota de rodapé do anúncio informa que esse resultado foi obtido em uma execução interna da Anthropic. O RoboDojo é um benchmark público, mas, até 10/11/2026, não conseguimos confirmar o mesmo número na página do ranking público.
Q2: Os 64,9% foram obtidos no nível de esforço padrão?
Não. O resultado foi obtido no nível de esforço máximo disponível. O nível padrão da Claude API é `high`, enquanto o padrão nos aplicativos Claude e no Claude Code é `Medium`. O anúncio não informa a pontuação no nível padrão.
Q3: O Fable 5.2 superou sistemas especializados em robótica?
Segundo o anúncio, ele superou “a maioria dos sistemas desenvolvidos especificamente para controlar robôs”, mas não foi fornecida uma lista. Ainda não sabemos exatamente quais sistemas foram superados.
Q4: Por que o Gemini 4 Carbon não tem pontuação no RoboDojo?
Essa célula está em branco na tabela do anúncio, que não explica o motivo. Um espaço em branco não significa uma pontuação de 0, nem permite tirar conclusões sobre o desempenho do modelo.
Q5: Como posso me preparar desde já usando a API?
Até 10/11/2026, o APIYI (apiyi.com) ainda não disponibiliza o `claude-fable-5-2`. Vamos oferecer esse modelo em breve; consulte a lista de modelos da plataforma para ver o identificador e o preço. Enquanto isso, você pode testar o fluxo de entrada de imagens e chamadas de ferramentas com o `claude-opus-5-5`, que já está disponível, e depois comparar os resultados quando o novo modelo for lançado.
Q6: Os três dispositivos eletrônicos provam que o modelo sabe controlar robôs?
Não. O assistente de voz, o telefone com alto-falante USB e o bichinho virtual são experimentos de design de hardware feitos em parceria com a Diode. Eles demonstram capacidade de projetar circuitos e não têm relação com a pontuação de controle bimanual do RoboDojo.
Q7: Agentes que operam computadores precisam esperar pelo Fable 5.2?
Provavelmente não. No OSWorld 2.1, o Fable 5.2 marcou 89,3%, enquanto o Opus 5.5 fez 87,2%: uma diferença de apenas 2,1 pontos. Além disso, o preço padrão do Opus 5.5 é metade do preço do Fable 5.2.
Principais conclusões sobre as capacidades robóticas do Fable 5.2
- O que a pontuação significa: 64,9% é o resultado de uma simulação com dois braços, executada internamente e no nível máximo de esforço.
- Tamanho da diferença: 25,5 pontos acima do Opus 5.5 e 35,1 pontos acima do GPT-6 Astra.
- Ponto de comparação: no OSWorld, a vantagem é de apenas 2,1 pontos. Esses dois tipos de diferença não devem ser confundidos.
- Contexto das demonstrações: resolver um cubo mágico, abrir uma garrafa e desenhar são demonstrações da publicação, não habilidades prontas para uso em produtos.
- Limitações do fluxo: o modelo só gera texto; forçar
tool_choiceretorna um erro 400, e não é possível desativar o raciocínio. - Disponibilidade: em 10/11/2026, o modelo ainda não estava disponível na APIYI. Enquanto isso, você pode usar
claude-opus-5-5para montar o fluxo.
Resumo
O avanço do Claude Fable 5.2 no controle robótico é um sinal concreto: o resultado no RoboDojo Sim subiu de 27,6% na geração anterior para 64,9%, ficando bem à frente dos modelos usados como comparação pela Anthropic. Mas esse número se aplica a um cenário bem específico: ambiente simulado, execução interna e nível máximo de esforço. Ele não inclui a taxa de sucesso em robôs reais nem representa a capacidade de entregar soluções para fábricas.
Se você já tem um fluxo de simulação ou um robô real, vale a pena fazer uma rodada de comparação quando o Fable 5.2 estiver disponível. Também é bom planejar desde já como lidar com as limitações: analisar as respostas em texto, não poder forçar chamadas de ferramentas e não conseguir desativar o raciocínio. Se você ainda não tem esse fluxo, ou se seu objetivo é resolver tarefas de programação ou de uso do computador, não precisa mudar sua solução atual por causa dos 64,9%.
Autor: equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial da APIYI, em apiyi.com. A disponibilidade dos modelos pode ser conferida na lista de modelos da plataforma.


