
글쓴이의 말: README, 릴리스 노트, 프로바이더 문서를 기준으로 OpenMotion의 다섯 가지 제작 단계를 나눠서, OpenAI 호환 키 하나로 어느 단계까지 연결할 수 있는지, 그리고 연결되지 않는 샷은 어떻게 외부에서 생성한 뒤 가져오는지 설명해요.
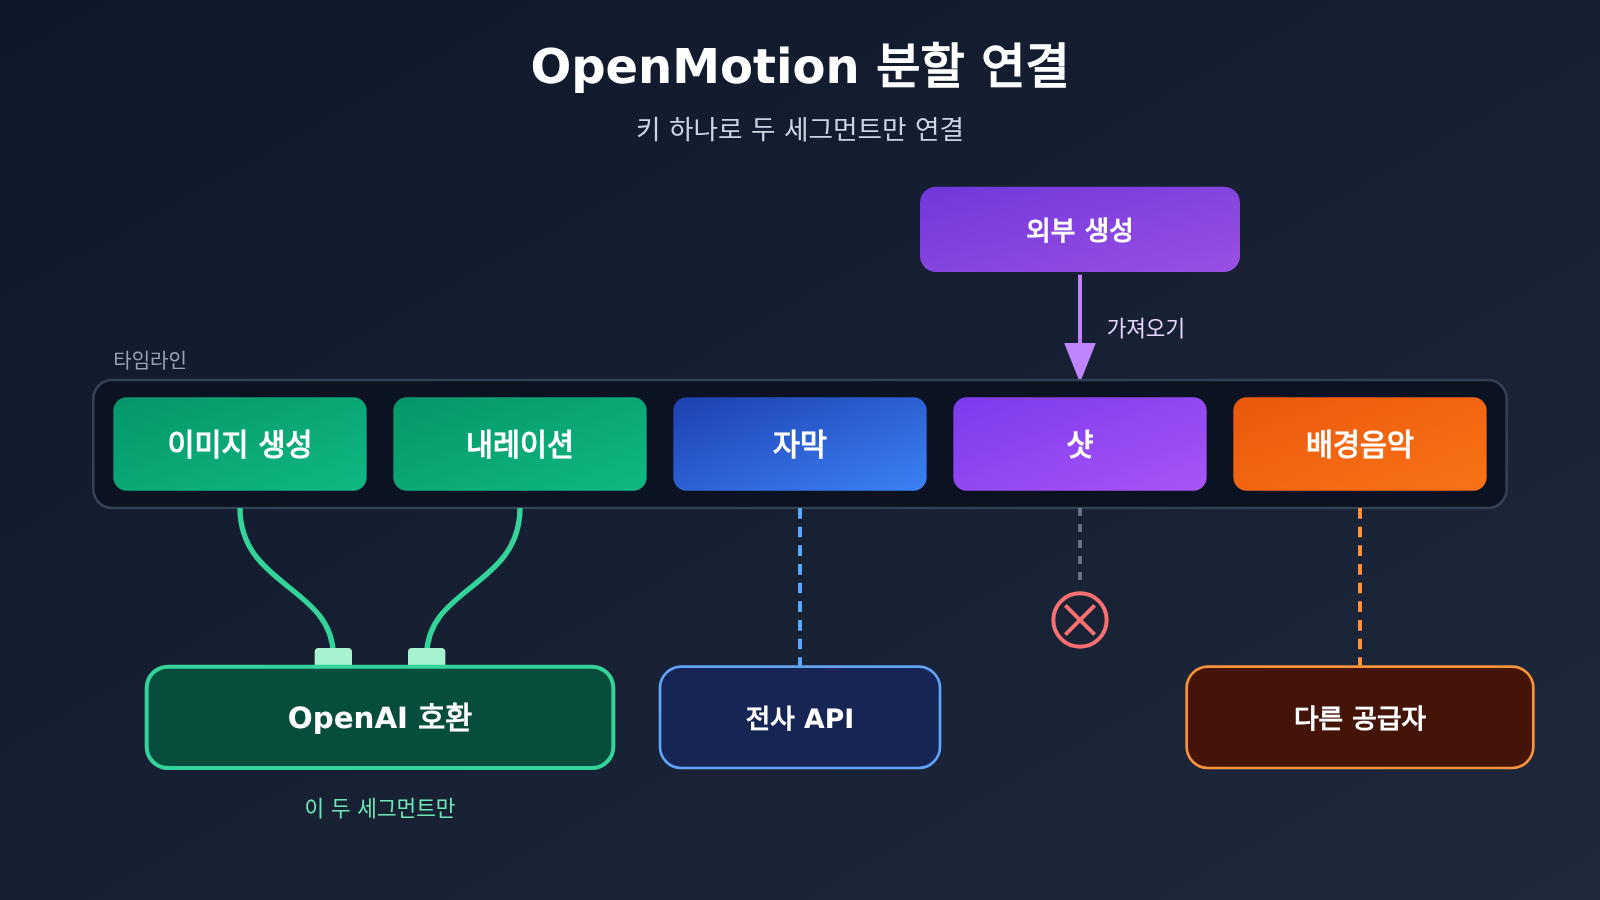
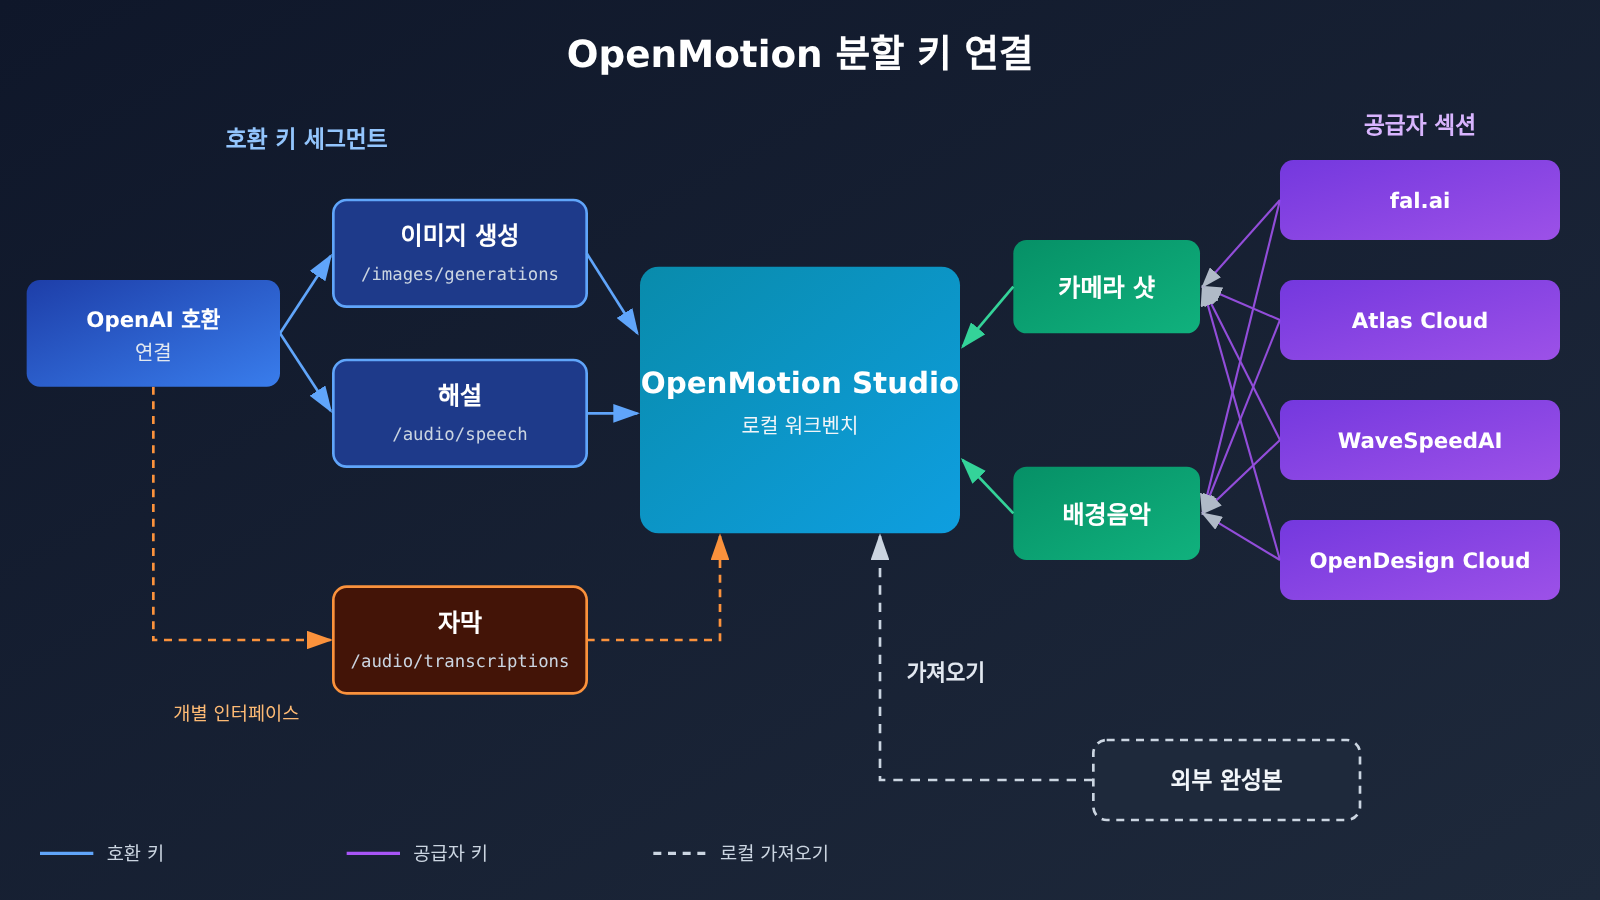
OpenMotion으로 나만의 영상 한 편을 만들려는데 마침 API 키가 하나 있다면, 많은 사람이 가장 먼저 Model Settings의 OpenAI 호환 연결에 키를 넣고 이미지 생성, 내레이션, 샷, 배경 음악까지 전부 돌아가기를 기대해요. 저장소 문서에 적힌 대로, OpenMotion에서 호환 키 하나는 이미지 생성과 내레이션, 두 가지 프로토콜에만 대응해요. 자막 전사는 세 번째의 별도 인터페이스이고, 영상 샷과 배경 음악은 호환 슬롯에 속하지 않아요.
이 글은 또 하나의 저장소 인기 소개 글이 아니에요. 이 글은 스타 수로 결론을 내리지 않고, README, v0.1.1 릴리스 노트, 프로바이더 문서만 대조하면서 키가 어디까지 연결되는지 단계별로 확인해요. 모든 기능 설명에는 출처를 밝혔고, 실제 테스트에서 나온 내용은 하나도 없어요.
핵심 가치: 이 글을 읽고 나면, 어느 단계는 호환 인터페이스에 맡길지, 어느 단계는 프로바이더를 바꿀지, 어느 단계는 외부에서 먼저 생성한 뒤 OpenMotion으로 가져올지 스스로 판단할 수 있어요.
OpenMotion 동영상 제작 키 연결 핵심 요점
먼저 결론을 표 하나로 정리해 볼게요. 표의 “기대 프로토콜”은 저장소의 docs/provider-settings.md와 compatible.md에서 가져온 것으로, OpenMotion 쪽에서 무엇을 구현했는지를 나타내요. 어느 한 플랫폼이든 해당 엔드포인트를 제공한다는 뜻은 아니에요.
| 제작 단계 | OpenMotion이 기대하는 프로토콜 | 호환 키를 바로 연결할 수 있는지 | 연결이 안 될 때 다음 단계 |
|---|---|---|---|
| 이미지 생성 | POST base에 /images/generations 추가, b64_json 또는 url 읽기 |
가능. 단, 플랫폼이 해당 엔드포인트를 제공해야 함 | 이미지 생성 엔드포인트가 있는 플랫폼 선택 |
| 내레이션 | POST base에 /audio/speech 추가, 본문에 input 넣기, voice 필수, 바이너리 오디오 반환 |
프로토콜은 구현됐지만 플랫폼에 실제로 그 엔드포인트가 있어야 함 | 해당 엔드포인트가 있는 공급자로 변경하거나, 직접 녹음한 오디오 가져오기 |
| 자막 | POST base에 /audio/transcriptions 추가, 실제 타임스탬프 필요 |
별도 인터페이스라 내레이션과 공유하지 않음 | Studio에서 직접 작성하거나 자막 파일 가져오기 |
| 샷 | fal.ai, Atlas Cloud, WaveSpeedAI 또는 OpenDesign Cloud 사용 | 불가 | 외부에서 완성본을 만든 뒤 가져오기 |
| 배경음악/효과음 | 샷과 동일. 호환 프로토콜에는 음악과 효과음이 구현되지 않음 | 불가 | 공급자 변경 또는 본인 오디오 가져오기 |
OpenMotion 호환 인터페이스는 이미지 생성과 내레이션만 알아봐요
리포지토리의 docs/provider-settings.md에 아주 분명히 적혀 있어요. OpenAI 호환 연결로 실행할 수 있는 건 /images/generations와 바이너리 /audio/speech이고, 음성에는 반드시 voice가 있어야 해요. Anthropic과 Google Gemini는 여기서 카탈로그 설정만 담당해요. 범용 미디어 어댑터가 없거든요. 그래서 Claude나 Gemini 키를 넣어도 이미지 생성이나 음성 기능이 갑자기 생기지는 않아요. 동영상과 음악은 분명히 fal.ai, Atlas Cloud, WaveSpeedAI, 또는 OpenDesign Cloud에 맡기고 있어요.
compatible.md는 호환 어댑터의 경계도 그어 놨어요. 이미지 생성은 텍스트-이미지 변환만 하고, 이미지 편집 업로드도 비동기 동영상도 하지 않아요. 내레이션은 바이너리 오디오를 반환하지만, 음악과 음향 효과 프로토콜은 구현되어 있지 않아요. docs/model-gateway.md(2026-11-15 업데이트 표시)에는 한마디가 더 붙어요. 범용 호환 연결이 구현하는 건 표준 음성 프로토콜일 뿐, 이 연결들에 이식 가능한 음악이나 음향 효과 인터페이스가 있다는 뜻은 아니에요. 다시 말해 ‘호환’은 음성까지만 호환된다는 거죠.
OpenMotion README의 세 모델 목록은 섞어 보면 안 돼요
README는 서로 다른 위치에서 세 가지 목록을 보여 주는데, 용도가 달라서 하나의 “OpenMotion 지원 모델 표”로 합칠 수 없어요.
- 맨 앞의 예시: 이미지 생성, 샷 추가, 사운드트랙, 내레이션의 예시로 GPT Image 2.6, Seedance 2.5, Suno, Eleven v4를 들어 워크플로가 어떤 모습인지 보여 줘요.
- fal.ai 카탈로그 부분: Model Settings에서 fal.ai를 연결하고 카탈로그를 새로 고치면 GPT Image 2.6, Nano Banana 2.1, FLUX.3, Seedance 2.5, Kling 4.0, Wan 3.0, Eleven v4를 찾을 수 있어요. 이건 fal.ai를 거치는 카탈로그예요.
- 기능 표: 이미지는 Codex Image, Atlas Cloud 경유 Nano Banana 2, fal.ai 경유 FLUX Schnell이고, 동영상은 Atlas Cloud 경유 Seedance 2.0, fal.ai 경유 Wan 2.2, 음악은 Atlas Cloud 경유 Suno v4, 음성은 fal.ai 경유 Kokoro예요.
이 세 목록은 각각 “워크플로 예시”, “특정 공급자 카탈로그에 무엇이 있는지”, “문서에 나열된 연결 방식”이라는 세 가지 질문에 답해요. 맨 앞에 Seedance 2.5라고 적혀 있다고 해서, 여러분의 호환 키로 OpenMotion에서 곧바로 Seedance 샷을 만들 수 있다는 뜻은 아니에요.
OpenMotion 영상 빠르게 시작하기: 단계별로 키 연결하기
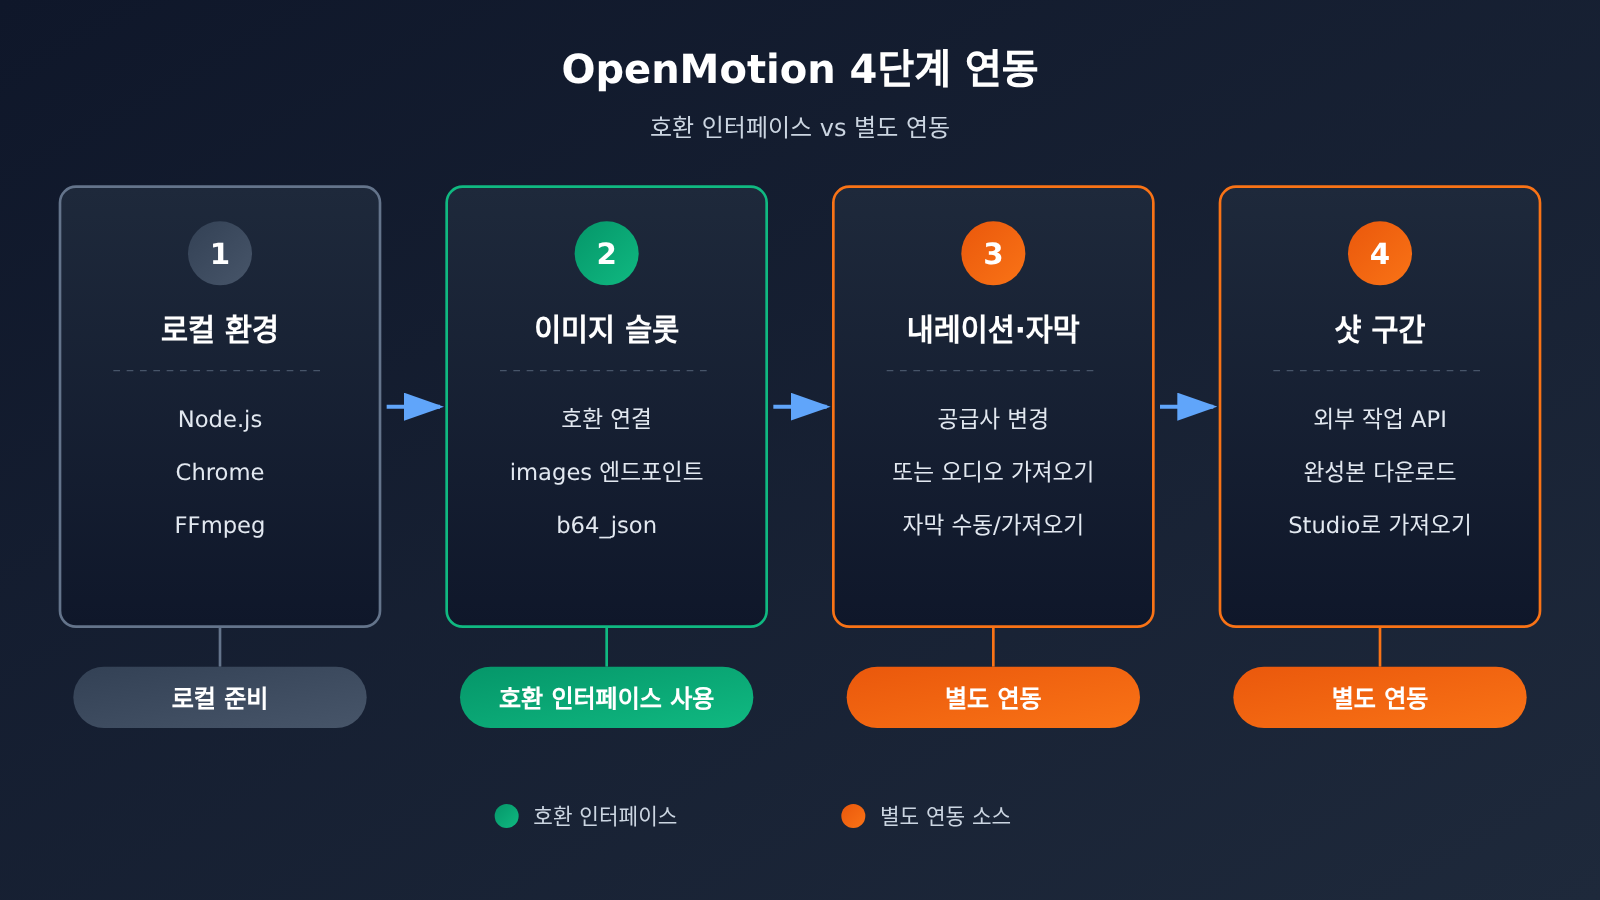
아래에서는 영상 제작 순서대로 한 번 살펴볼게요. 각 단계마다 먼저 OpenMotion이 무엇을 기대하는지 설명하고, 그다음 여러분이 가진 키가 여기에 맞는지 확인할게요.
첫 번째 단계: OpenMotion 로컬 환경 준비
README 설치 섹션에 나열된 요구 사항은 다음과 같아요. 키를 연결하기 전에 환경이 모두 갖춰졌는지 먼저 확인하시길 권장해요:
- Node.js 26.11.1: README에 명시된 버전이에요.
- 소스 설치가 기본 방식: 게시된 npm 애플리케이션은 선택 사항이고, README 원문에서는 published versions can lag라고 안내하며, 새 기능이 늦게 도착할 수 있다고 해요.
- Chrome 또는 Chromium, 그리고 FFmpeg: 로컬 미리보기와 내보내기 모두 이들에 의존해요.
- Docker Compose (선택 사항): v0.1.1 릴리스 노트에 따르면, Docker Compose로 소스에서 로컬로 Studio를 열 수 있어요.
README는 또한 소프트웨어 자체는 구독료를 받지 않고 렌더링 비용을 회차별로 청구하지 않으며, 각 공급자가 여러분 자신의 계정으로 과금한다고 명시하고 있어요. 또 생성 인터페이스를 전혀 호출하지 않고 자신의 화면, 이미지, 오디오를 직접 가져올 수도 있는데, 이 점은 뒤에서 연결이 안 되는 단계에서 반복적으로 활용하게 될 거예요.
두 번째 단계: OpenMotion 이미지 생성 슬롯에 호환 연결 구성하기
이미지 생성은 호환 키에서 가장 안정적인 구간이에요. APIYI를 예로 들면, OpenAI 호환 모델 집계 플랫폼으로 하나의 Key로 여러 주류 모델을 호출할 수 있어요. 이미지 생성 엔드포인트 /v1/images/generations가 OpenMotion 이미지 생성 어댑터가 요구하는 경로와 정확히 맞아요. Model Settings에서 대략 이렇게 입력해요:
| 필드 | 입력 내용 | 설명 |
|---|---|---|
| 연결 유형 | OpenAI 호환 | 이 유형만 /images/generations를 사용해요 |
| Base URL | https://api.apiyi.com/v1 |
어댑터가 뒤에 /images/generations를 붙여요 |
| API Key | 플랫폼 콘솔에서 만든 토큰 | 토큰 그룹에 선택한 모델의 그룹이 포함되어야 해요 |
| 이미지 모델 | gpt-image-2.6-all, gpt-image-2.6-flare 또는 gpt-image-2.6-sunburst |
README 예시의 GPT Image 2.6에 해당해요 |
| 반환 형식 | b64_json 또는 url |
어댑터가 두 형식 모두 읽을 수 있어요 |
설정한 뒤 먼저 스틸 프레임 한 장을 생성해 연결 경로가 원활한지 확인하세요. OpenMotion의 호환 이미지 생성 어댑터는 이미지 편집 업로드를 지원하지 않는다는 점에 주의하세요. “이미 존재하는 이미지를 수정”하는 작업은 이 경로에서 할 수 없고, 다시 생성하거나 외부에서 편집한 이미지를 가져와야 해요.
🚀 빠른 시작: 이미지 생성 단계는 먼저 APIYI apiyi.com에서 신규 사용자 무료 테스트 크레딧으로 이미지 한 장을 생성해 Base URL, 토큰 그룹, 모델 ID가 모두 맞는지 확인한 뒤, 스토리보드 스틸 프레임을 대량 생성하는 것을 권장해요.
제3단계: OpenMotion 내레이션과 자막, 엔드포인트부터 확인하기
내레이션 슬롯이 요구하는 건 /v1/audio/speech, 자막 슬롯이 요구하는 건 /v1/audio/transcriptions예요. 서로 다른 두 개의 인터페이스죠. 2026-11-20에 확인한 APIYI 가격 책정 인터페이스를 보면, 공개된 엔드포인트는 /v1/messages, /v1/embeddings, Gemini generateContent, /v1/images/generations, /v1/chat/completions, /v1/responses뿐이에요. /v1/audio/speech도 없고, /v1/audio/transcriptions도 없어요.
전체 표에서 tts-1과 tts-1-hd 엔드포인트에는 chat만 적혀 있는데, OpenMotion의 내레이션 어댑터는 /audio/speech 요청을 보내요. 그래서 이 두 모델 ID를 내레이션 슬롯에 채워 넣는다고 해서 소리가 나오길 기대할 수는 없어요. 내레이션 쪽에는 두 가지 길이 있어요. 실제로 /audio/speech를 제공하면서 voice 파라미터를 지원하는 다른 공급자를 찾거나, 아니면 직접 오디오를 녹음해서 그대로 가져오는 거예요.
자막은 v0.1.1에서 오히려 다루기 쉬워요. 릴리스 노트에 따르면 Studio에서 자막을 생성하거나, 가져오거나, 직접 작성할 수 있고, 그런 다음 SRT나 VTT로 내보낼 수 있어요. compatible.md의 자막 섹션(확인 날짜 2026-11-17)은 실제 타임스탬프를 확보해야만 SRT나 VTT로 내보낼 수 있다고 알려줘요. 텍스트만 있어서는 타임라인을 만들 수 없어요. 전사 엔드포인트가 없을 때는 자막 파일을 직접 작성하거나 타임라인이 포함된 자막 파일을 가져오는 게 가장 직접적인 방법이에요.
4단계: OpenMotion 샷은 외부에서 생성한 뒤 가져오기
샷 구간은 호환 슬롯에 채워 넣을 수 없어요. OpenMotion에서 샷을 직접 생성하더라도 여전히 fal.ai, Atlas Cloud 또는 WaveSpeedAI를 거쳐야 해요. 영상 크레딧이 다른 플랫폼에 있다면, 그쪽에서 완성 영상을 생성한 뒤 파일을 Studio로 가져오면 돼요. v0.1.1에 새로 추가된 단일 구간 MP4 내보내기 기능을 쓰면 샷을 교체한 클립을 따로 확인하기도 편해요. Seedance 2.5를 외부에서 어떻게 생성하는지는 다음 섹션에서 따로 설명할게요.
OpenMotion 이미지 생성 모델과 가격, 어떻게 확인할까요
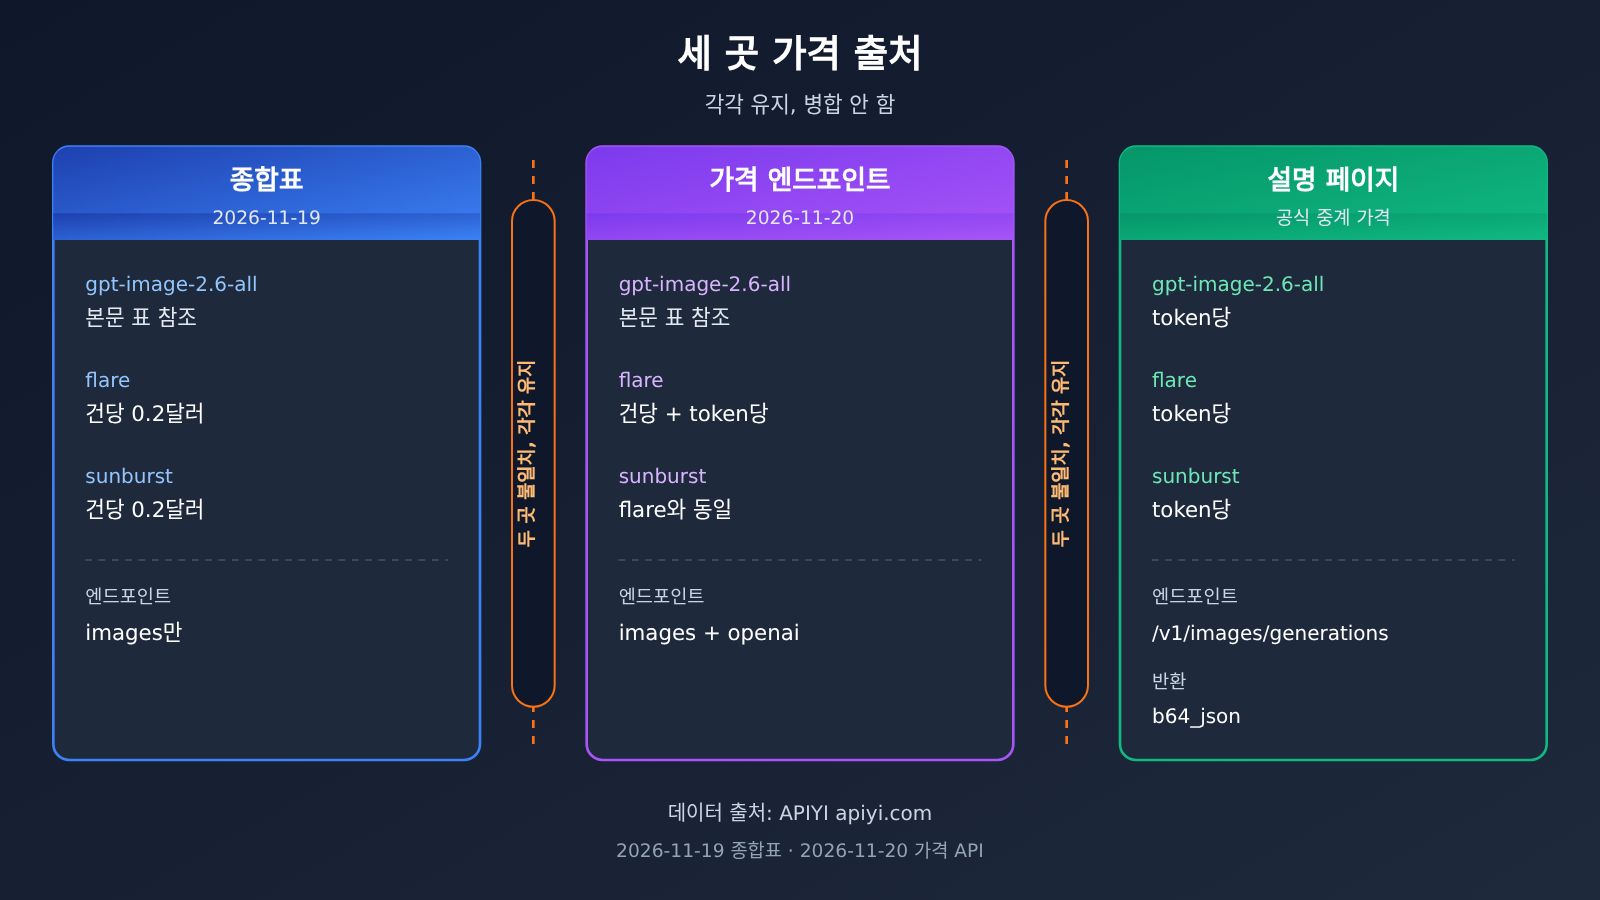
모델을 확인하고 가격을 맞춰 볼 때 가장 실수하기 쉬운 건, 서로 다른 페이지의 숫자를 하나의 가격으로 뭉뚱그리는 일이에요. 아래에서는 APIYI의 세 출처를 각각 나눠 정리했고, 조회 날짜는 표 머리말에 표시했어요. 두 곳이 일치하지 않으면 양쪽 모두 남겨 뒀어요.
| 모델 ID | 전체 표(데이터 시각 2026-11-19 10:59) | 가격 API(2026-11-20 조회) | 설명 페이지 |
|---|---|---|---|
gpt-image-2.6-all |
호출당 0.025 USD/회; 엔드포인트 chat, images; 그룹 Default, image2_OSS, SVIP | model_price 0.025; 엔드포인트 image-generation, openai |
설명 페이지에는 gpt-image-2-all 0.025 USD/장으로 적혀 있고, 2.6 버전이 아니에요 |
gpt-image-2.6-flare |
호출당 0.2 USD/회; 엔드포인트에는 images만 기재; 그룹 Default, image2Enterprise, image2_OSS, SVIP | model_price 0.2, 동시에 billing_expr(p * 5 + cr * 1.25 + img * 8 + img_cr * 2 + c * 30) 포함; 엔드포인트 image-generation, openai |
공식 중계는 token 기준: 텍스트 입력 5, 이미지 입력 8, 이미지 출력 30 USD/백만 token; 캐시 읽기 텍스트 1.25, 이미지 2 USD |
gpt-image-2.6-sunburst |
flare와 동일: 호출당 0.2 USD/회, 엔드포인트에는 images만 기재 | flare와 동일 | 위와 동일, token 기준 |
보시면, 전체 표는 flare와 sunburst를 호출당 0.2 USD, 엔드포인트는 images만으로 적었지만, 가격 API는 0.2 외에도 token 기준 과금 공식을 하나 더 달고 있고 엔드포인트에도 openai가 추가돼 있어요. 설명 페이지는 공식 중계 가격을 token 기준으로 나열하고, 공식 중계 텍스트-이미지 변환이 /v1/images/generations를 사용하며 b64_json을 반환한다고 명시해요. 이 몇 곳의 설명이 완전히 일치하지는 않아서, 이 글에서는 이들을 합쳐 하나의 가격으로 만들지 않아요. 실제 청구 금액은 주문할 때 apiyi.com 콘솔의 모델 목록을 기준으로 하세요.
OpenMotion 이미지 생성 슬롯의 경우, 중요한 정보는 사실 엔드포인트예요. 세 모델의 이미지 엔드포인트가 모두 /images/generations와 맞고, 반환 형식도 어댑터가 읽을 수 있는 b64_json이에요.
배경 음악과 내레이션 쪽을 보면, README 예시에 나온 Suno와 Eleven v4는 2026-11-19 전체 표와 2026-11-20 가격 API 어디에도 나오지 않아요. 전체 표에는 whisper도 없어요. Suno와 Eleven v4는 아직 출시되지 않았고, 해당 모델은 최대한 빨리 출시할 예정이에요. 모델과 가격은 플랫폼 모델 목록을 기준으로 하세요.
OpenMotion 샷 단계: Seedance 2.5가 호환 슬롯에 들어가지 않는 이유
Seedance 2.5의 APIYI 모델 ID는 doubao-seedance-2-5-260628예요. 이 모델이 OpenMotion 호환 슬롯에 들어가지 않는 데는 두 가지 이유가 있어요. OpenMotion 호환 어댑터는 애초에 비동기 영상 처리를 하지 않고, doubao-seedance-2-5-260628 역시 APIYI에서 자체 작업 인터페이스를 사용하기 때문이에요. 호환 영상 인터페이스가 아니랍니다.
| 항목 | 통합 표(2026-11-19) | 가격 인터페이스(2026-11-20) | Seedance2 설명 페이지 |
|---|---|---|---|
| 엔드포인트 | chat만 기재 | openai(즉 chat)만 존재 | POST /seedance/api/v3/contents/generations/tasks |
| 그룹 | SeeDance2 | SeeDance2만 존재; SeeDance2, SD2Fast, SD2Mini 그룹 배율은 모두 0.18 | 토큰에서 SeeDance2를 선택해야 하며, 배율 0.18x |
| 가격 표기 | 종량제, 입력 70, 출력 70달러/백만 토큰, 캐시 읽기 데이터 없음 | 동일 모델, 그룹 배율로 환산 | 720p, 5초, 입력 영상 없는 예시 기준 1.3721달러 |
| 과금 방식 | 종량제 | 종량제 | 종량제 우선 또는 종량제 |
여기서 두 숫자를 혼동하면 안 돼요. 통합 표의 70달러/백만 토큰은 정가이고, 설명 페이지의 1.3721달러는 SeeDance2 그룹의 0.18 배율을 이미 적용한 구체적인 예시예요. 통합 표 정가에 0.18을 곱하면 12.60달러/백만 토큰이 되고, 여기에 설명 페이지 예시에서 사용한 108900토큰을 곱하면 약 1.37달러가 나와요. 바로 그 예시와 맞아떨어지죠. 즉 두 숫자는 같은 과금 체계의 서로 다른 층위를 설명하는 것이지, 골라 쓸 수 있는 두 개의 가격이 아니에요.
그룹 이름에도 차이가 있어요. 통합 표에서는 fast와 mini를 SD2-Fast-Cheap, SD2-Mini-Cheap으로 적었지만, 가격 인터페이스에서는 SD2Fast, SD2Mini라고 불러요. 토큰을 만들 때는 콘솔에 실제로 표시되는 그룹 이름을 기준으로 하세요. 특정 페이지의 이름을 그대로 억지로 넣으면 안 돼요.
실제 영상 제작 흐름에 적용해 보면 이래요. 먼저 APIYI의 Seedance 작업 인터페이스에 샷 작업을 제출하고, 작업이 끝나면 완성 영상을 내려받은 뒤, 영상 파일을 OpenMotion 타임라인으로 가져와요. 그리고 호환 인터페이스로 생성한 정지 이미지, 외부에서 녹음한 내레이션과 함께 편집하는 거예요.
💡 선택 가이드: 샷 한도와 이미지 생성 한도를 같은 키 하나로 관리하고 싶다면, APIYI apiyi.com에서 토큰에 이미지 생성 그룹과 SeeDance2 그룹을 함께 선택하면 돼요. 이미지 생성은 OpenMotion에 입력하고, 샷은 작업 인터페이스로 생성한 뒤 가져오면 청구서를 한 백오피스에서 깔끔하게 확인할 수 있어요.
자주 묻는 질문 FAQ
Q1: OpenMotion은 무엇인가요?
OpenMotion은 nexu-io가 공개한 오픈소스 영상 제작 Studio예요. 라이선스는 Apache-2.0이고 저장소는 2026-05-11에 생성됐어요. 저장소 소개에는 22개의 agent를 지원한다고 쓰여 있으며, Claude Code, Codex, DSH, WorkBuddy를 명시하고 있어요. README에 따르면 소프트웨어 자체에는 구독료나 렌더링 비용을 받지 않고, 생성 인터페이스 비용은 각자의 공급자 계정으로 청구돼요.
Q2: OpenMotion의 호환 인터페이스는 fal.ai, Atlas Cloud와 무엇이 다른가요?
호환 인터페이스는 OpenMotion에서 `/images/generations`와 `/audio/speech` 두 프로토콜만 실행하고, 자막은 별도로 `/audio/transcriptions`를 사용해요. 문서에서 지정한 비디오·음악 채널은 fal.ai, Atlas Cloud, WaveSpeedAI, OpenDesign Cloud예요. Studio 안에서 바로 장면을 생성하려면 뒤에 나온 이 업체들을 거쳐야 해요.
Q3: OpenMotion v0.1.1은 언제 출시됐고 무엇이 바뀌었나요?
v0.1.1은 2026-11-18 19:32(베이징 시간)에 릴리스됐어요. 릴리스 노트에 따르면 자막을 생성하거나 가져오거나 직접 작성할 수 있고 SRT 또는 VTT로 내보낼 수 있어요. 특정 구간을 MP4로 따로 내보낼 수 있고, 96개의 Skill이 새로 추가됐으며, Docker Compose로 소스에서 Studio를 로컬로 실행할 수 있어요. 선택형 DeepSeek Harness 플러그인은 Studio를 대화창 옆에 배치해요. 이 내용은 모두 릴리스 노트에서 온 것이며, 실제 테스트로 확인한 결론은 아니에요.
Q4: tts-1을 OpenMotion의 내레이션 슬롯에 넣을 수 있나요?
바로 그렇게 할 수는 없어요. 내레이션 슬롯은 `/v1/audio/speech` 요청을 보내고, `voice`를 포함해야 하며, 바이너리 오디오를 반환해요. 그런데 APIYI 전체 표에서 `tts-1`과 `tts-1-hd`의 엔드포인트에는 chat만 적혀 있고, 가격 책정 API의 공개 엔드포인트에도 `/v1/audio/speech`가 없어요. 내레이션에는 해당 엔드포인트를 제공하는 다른 공급자를 쓰거나, 오디오를 미리 녹음해서 가져오는 걸 권해요.
Q5: API를 통해 OpenMotion에 이미지 생성을 빠르게 연결하려면 어떻게 하나요?
절차는 간단해요:
1. APIYI apiyi.com에서 가입하고 무료 테스트 크레딧을 받아요.
2. 토큰을 만들 때, 사용할 이미지 모델이 속한 그룹(예: Default)을 포함시켜요.
3. OpenMotion Model Settings에서 OpenAI 호환 연결을 새로 만들고, Base URL에는 `https://api.apiyi.com/v1`, 모델에는 `gpt-image-2.6-all`처럼 현재 제공 중인 ID를 입력해요.
4. 정지 이미지를 하나 생성해 검증하면, 어댑터가 응답으로 받은 `b64_json` 또는 `url`을 읽어요.
Q6: Seedance 2.5로 생성한 장면을 OpenMotion에 어떻게 넣나요?
`doubao-seedance-2-5-260628`을 사용해 작업 API `POST /seedance/api/v3/contents/generations/tasks`에 작업을 제출하고, 토큰에서 SeeDance2 그룹을 선택해요. 작업이 완료되면 비디오 파일을 다운로드한 뒤, OpenMotion에서 소재로 가져와 타임라인에 올려요. 가격은 두 곳에서 따로 봐야 해요. 전체 표의 표시 가격은 입력·출력 각각 100만 token당 70달러이고, 설명 페이지의 720p·5초 예시는 환산 후 1.3721달러예요.
Q7: 이 연결 방식에는 어떤 알려진 제한이 있나요?
– **이미지 생성**: 호환 어댑터는 이미지 편집 업로드를 지원하지 않고, 텍스트-이미지 변환만 할 수 있어요.
– **내레이션과 자막**: OpenMotion 프로토콜은 구현됐지만, 플랫폼이 `/audio/speech`와 `/audio/transcriptions`를 실제로 제공해야 해요. 자막에 실제 타임스탬프가 없으면 SRT나 VTT로 내보낼 수 없어요.
– **배경 음악과 효과음**: 호환 프로토콜은 구현되지 않아서 fal.ai, Atlas Cloud, WaveSpeedAI, OpenDesign Cloud를 사용하거나 직접 오디오를 가져와야 해요.
– **가격 기준**: 전체 표, 가격 책정 API, 설명 페이지가 같은 모델을 표기하는 방식이 완전히 같지는 않으니, 주문하기 전에 플랫폼의 모델 목록을 기준으로 확인해요.
OpenMotion으로 영상 만들 때 키 연결 핵심 포인트
- 호환 슬롯이 받는 건 두 가지 프로토콜뿐: 이미지 생성
/images/generations와 내레이션/audio/speech이고, 자막은 세 번째 인터페이스예요. - 숏과 배경 음악은 호환 슬롯에 들어가지 않아요: Studio 안에서 생성하려면 fal.ai, Atlas Cloud, WaveSpeedAI 또는 OpenDesign Cloud를 거쳐야 해요.
- README의 세 목록은 합치지 마세요: 도입부 예시, fal.ai 목록, 기능 표는 각각 용도가 달라요.
- 이미지 생성에는 이미 올라와 있는 모델이 있어요:
gpt-image-2.6-all,gpt-image-2.6-flare,gpt-image-2.6-sunburst모두 이미지 엔드포인트와 맞아요. - 가격은 출처별로 따로 봐야 해요: 전체 표는 회당 기준, 가격 책정 API는 공식이 붙어 있고, 설명 페이지는 토큰 기준이라 하나의 가격으로 합치면 안 돼요.
- 연결이 안 되면 외부에서 생성해 가져오세요: Seedance 2.5는 태스크 API로 영상을 만들고, 다운로드한 뒤 타임라인에 가져오면 돼요.
- 먼저 이미지 한 장부터 돌려 보세요: APIYI의 무료 크레딧으로 Base URL과 토큰 그룹을 검증한 다음, 다른 단계로 넓혀 보세요.
요약
OpenMotion으로 나만의 영상 한 편을 만들 때 키 연결 방식은 세 가지로 정리할 수 있어요.
- 이미지 생성은 호환 인터페이스로: Base URL이
/images/generations를 제공하는 플랫폼을 가리키게 하고, 올라와 있는 GPT Image 2.6 모델 ID를 넣으면 돼요. - 내레이션과 자막은 엔드포인트부터 확인: OpenMotion은 프로토콜을 지원하지만, 플랫폼에
/audio/speech,/audio/transcriptions가 없으면 공급자를 바꾸거나 직접 작성해서 가져와야 해요. - 숏과 배경 음악은 따로 연결: 외부에서 완성본을 만든 뒤 가져오거나, Studio 안에서 fal.ai, Atlas Cloud, WaveSpeedAI를 연결하면 돼요.
작업을 시작하기 전에 이 글의 구간별 표를 보면서 각 단계에 맞는 인터페이스를 먼저 정리해 두면, 키를 한꺼번에 넣고 오류를 하나씩 찾는 것보다 훨씬 수월해요. 이미지 생성과 Seedance 숏, 이 두 구간은 APIYI(apiyi.com)에서 토큰 하나로 함께 관리할 수 있어요. 먼저 무료 크레딧으로 연결 경로를 검증하고, 그다음 본편 영상에서의 역할 분담을 정하세요.
📚 참고 자료
-
OpenMotion 저장소와 README: 설치 요구 사항, 세 가지 모델 목록, 과금 안내
- 링크:
github.com/nexu-io/openmotion - 설명: 2026-11-20에 main 브랜치를 확인했으며, Node.js 버전과 Chrome 및 FFmpeg 의존성을 포함합니다
- 링크:
-
OpenMotion v0.1.1 릴리스 노트: 자막, 단일 구간 내보내기, Docker Compose 등의 업데이트
- 링크:
github.com/nexu-io/openmotion/releases/tag/v0.1.1 - 설명: 2026-11-18에 릴리스되었으며, 이 글에서 버전 기능에 대한 설명은 모두 이 페이지에서 가져왔습니다
- 링크:
-
OpenMotion provider 문서: 호환 인터페이스로 실행 가능한 프로토콜 범위
- 링크:
github.com/nexu-io/openmotion/blob/main/docs/provider-settings.md - 설명: 같은 디렉터리의
docs/model-gateway.md와skills/openmotion-media/references/providers/compatible.md에서 이미지 생성, 음성, 자막 세 가지 인터페이스의 세부 사항을 보충했습니다
- 링크:
-
APIYI 모델 총표, 기능 설명 페이지 및 가격 책정 인터페이스: 모델 ID, 엔드포인트, 그룹 및 가격
- 링크:
docs.apiyi.com/models.md - 설명: 같은 사이트의
/api-capabilities/gpt-image-2/overview.md와/api-capabilities/seedance2/overview.md는 설명 페이지이며, 가격 책정 인터페이스 경로는 api 하위 도메인의/api/pricing이고, pricing_version은 shell-api-modelmak-v1입니다
- 링크:
작성자: APIYI 기술 팀
기술 문의: 연동 과정에서 모델, 그룹 또는 엔드포인트가 맞지 않는 문제를 겪으셨다면 APIYI 공식 홈페이지를 통해 문의해 주세요


