
작성자 주: 이 글은 GPT-6.2 Sol Ultrafast의 공식 속도 상한, 프로모션 가격, 정가(리스트 가격)를 각각 따로 제시하고, 여러분의 작업에 그대로 적용해 볼 수 있는 속도 프리미엄 계산법을 제공합니다.
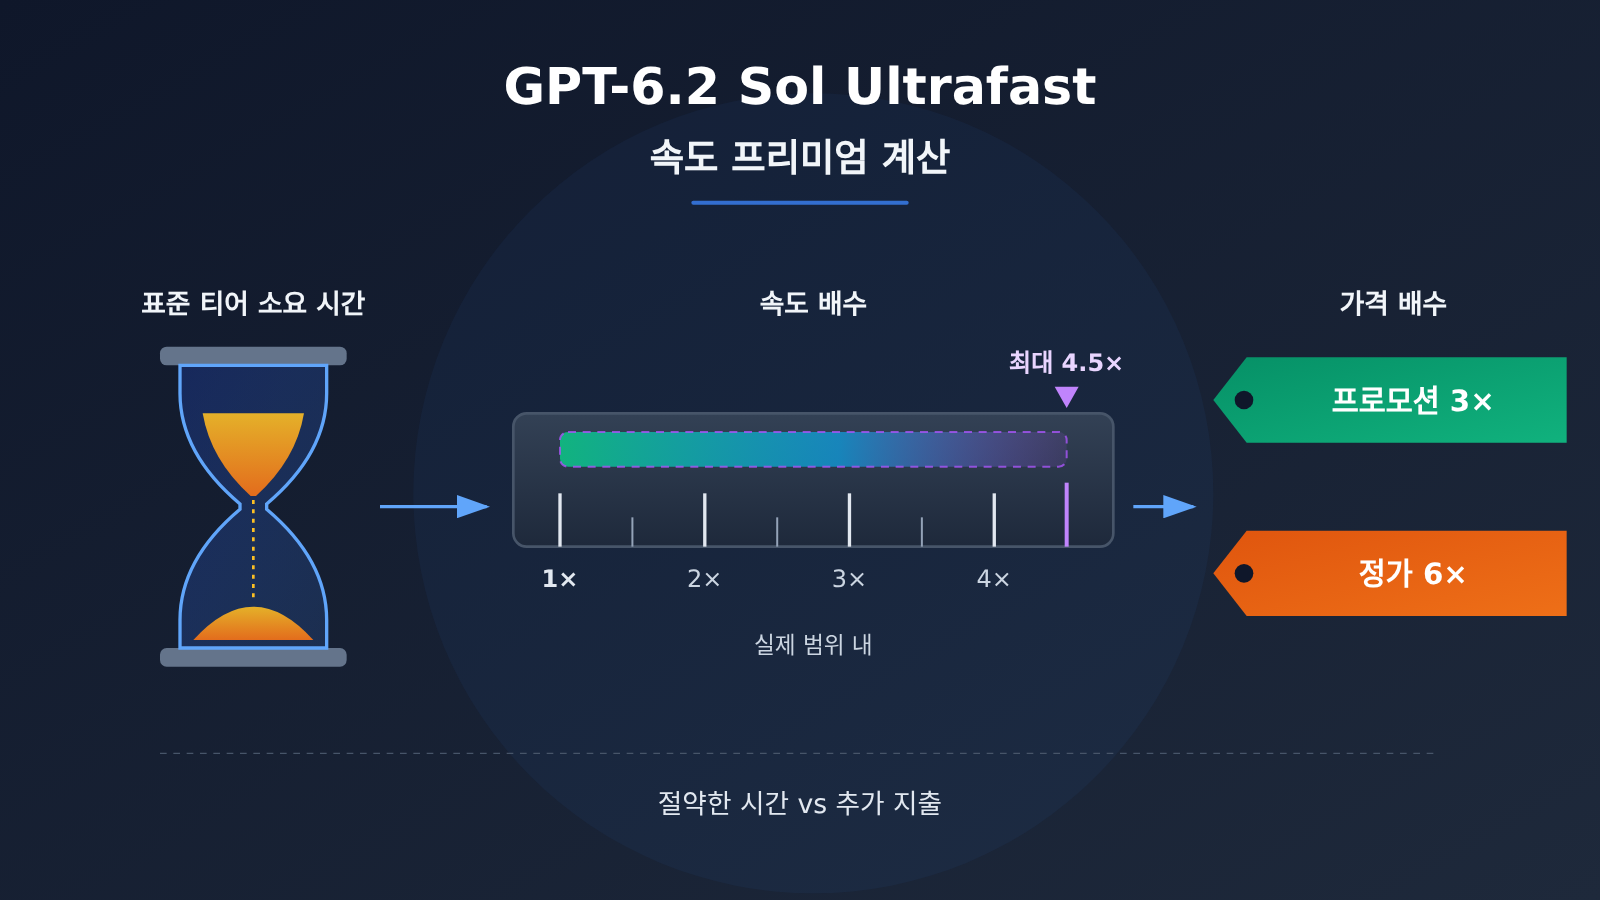
GPT-6.2 Sol에 Ultrafast를 켤지 말지는 이번 작업에서 얼마만큼의 기다림을 줄일 수 있는지에 달려 있어요. 공식이 제시한 속도는 같은 모델 표준 모드 대비 최대 4.5배이고, 프로모션 기간 가격은 표준가의 3배, 2027년 3월부터 적용되는 정가는 6배예요. 속도는 상한값이고 가격은 확정된 숫자라서, 두 값은 확실성의 정도가 다르며 단순히 나눌 수 없어요.
이 글은 “살 만한가”를 대신 답해 주지 않아요. 자체 속도 측정 결론을 내리지 않고, 대조군이 없는 민간 기록 하나를 최종 결과로 삼지도 않아요. 이 글은 하나의 계산법만 제공해요. 먼저 여러분 작업이 표준 모드에서 걸리는 시간을 측정하고, 공식의 “최고” 배수로 절약 가능한 시간의 상한을 계산한 다음, 마지막에 가격 차이와 비교하는 방식이에요.
핵심 가치: 이 글을 다 읽으면 어떤 작업이든 “1분을 아낄 때마다 얼마를 더 내야 하는지”를 계산할 수 있고, 작업에 따라 속도 모드를 켤지 결정할 수 있어요.
GPT-6.2 Sol Ultrafast 속도 프리미엄의 핵심 차이
먼저 개념 하나를 정리해야 해요. Ultrafast는 또 다른 모델이 아니라 서비스 등급이에요. 공식 API 문서 기준으로 요청의 model은 여전히 gpt-6.2-sol이고, service_tier를 추가해 ultrafast로 설정하기만 하면 돼요. 현재 이 서비스 등급을 지원하는 모델은 GPT-6.2 Astra, GPT-6.2 Sol, GPT-6 Astra, GPT-6.1 Sol이에요.
그래서 여러분이 비교하는 건 서로 다른 두 모델의 성능 차이가 아니라, 같은 모델의 두 가지 전달 속도예요. 출력 품질 문제는 잠시 옆으로 치워두고, 남은 변수는 시간과 가격 두 가지뿐이에요.
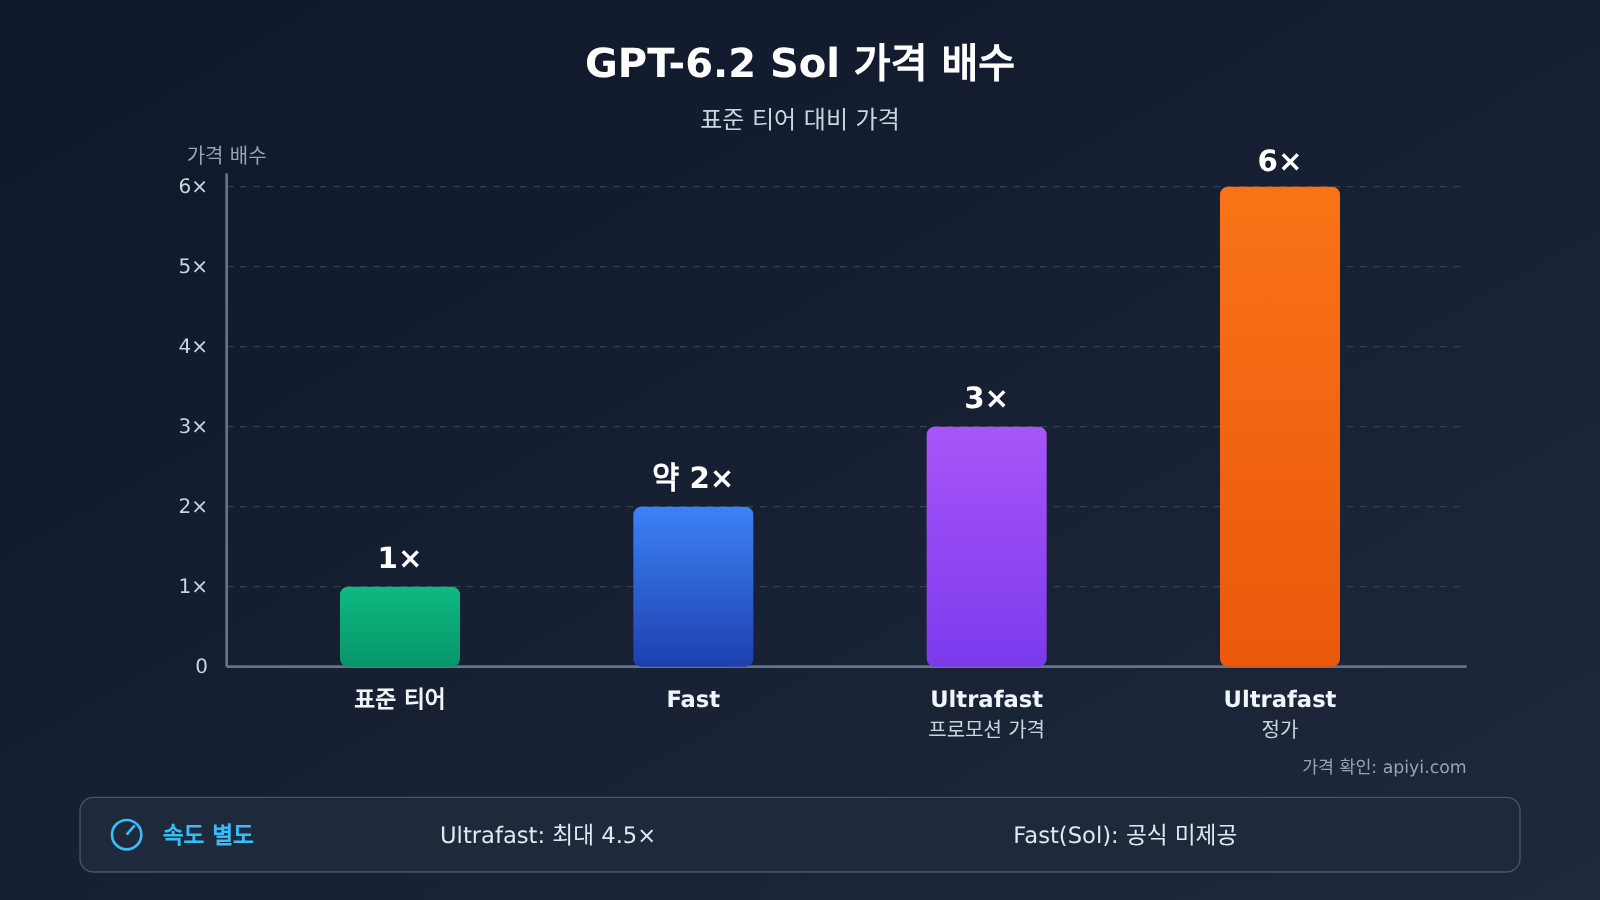
| 등급 (gpt-6.2-sol, 짧은 컨텍스트) | 입력 | 캐시 읽기 | 출력 | 표준가 대비 | 공식 속도 설명 |
|---|---|---|---|---|---|
| 표준 등급 | 2 | 0.10 | 10 | 1× | 기준 |
| Fast | 4 | 0.20 | 20 | 약 2× | 문서에 Sol 속도 배수 미기재 |
| Ultrafast 프로모션 (2027-02-28 태평양 시간까지) | 6 | 0.30 | 30 | 3× | 최대 4.5배 |
| Ultrafast 정가 (2027-03-01부터) | 12 | 0.60 | 60 | 6× | 최대 4.5배 |
표의 가격 단위는 달러/백만 tokens이고, 짧은 컨텍스트는 입력이 27.2만 tokens를 넘지 않는 경우를 말해요. Fast 등급은 따로 짚고 넘어가야 해요. 공식 문서에 적힌 “약 1.5배 속도”는 GPT-6.2 Astra와 GPT-5.6을 대상으로 한 것이고 GPT-6.2 Sol에는 적혀 있지 않으니, 이 배수를 Sol의 Fast 등급에 그대로 적용하면 안 돼요.
GPT-6.2 Sol Ultrafast 긴 컨텍스트 가격
입력이 27.2만 tokens를 넘으면 긴 컨텍스트 요금이 적용돼요. 공식 표준 등급의 긴 컨텍스트 가격은 입력 4, 캐시 읽기 0.20, 출력 15예요. Ultrafast 프로모션 가격은 12 / 0.60 / 45, 정가는 24 / 1.20 / 90으로 여전히 표준가의 3배와 6배예요.
| 요금 항목 (긴 컨텍스트, 달러/백만 tokens) | 입력 | 캐시 읽기 | 출력 |
|---|---|---|---|
| 공식 표준 등급 | 4 | 0.20 | 15 |
| Ultrafast 프로모션 | 12 | 0.60 | 45 |
| Ultrafast 정가 | 24 | 1.20 | 90 |
APIYI 모델 총괄표 gpt-6.2-sol (27.2만 입력 초과) |
3 | 플랫폼 목록 기준 | 플랫폼 목록 기준 |
여기 숫자가 하나 어긋나는 부분이 있어 따로 설명할게요. APIYI apiyi.com의 모델 총괄표는 구간을 0~27.2만 tokens 입력 2달러, 27.2만 초과 시 입력 3달러로 적었지만, 공식 표준 등급의 긴 컨텍스트 입력가는 4달러예요. 이 두 숫자를 합쳐서 보면 안 돼요. APIYI를 통해 호출하면 총괄표 기준 3달러로 계산되고, 공식에 직접 연결하면 4달러로 계산돼요.
GPT-6.2 Sol Ultrafast의 속도는 어디서 오나: 공식 상한과 비공식 기록
속도 쪽에는 지금 두 종류의 정보가 있는데, 신뢰도 차이가 커서 따로 봐야 해요.
| 출처 | 내용 | 성격 | 내 배수로 쓸 수 있나 |
|---|---|---|---|
| 공식 Codex / API 문서 | Ultrafast 생성 속도는 동일 모델 표준 등급의 최대 4.5배(up to 4.5 times) | 공식 상한 표현 | 상한으로만 볼 수 있어요 |
| Artificial Analysis | 동일 모델 표준 등급 약 85 출력 token/초 | 제3자 공개 벤치마크 | 참고로만 볼 수 있어요 |
| OrcaRouter 2026-11-18 전언 | 작업 한 건 평균 약 126 token/초, 피크 약 252 | 단일 실행, 표준 등급 대조 없는 전언 | 쓸 수 없어요 |
공식 원문은 “up to”를 써요. 최대 이 정도까지 나올 수 있다는 뜻이고, 요청할 때마다 4.5배가 나온다고 약속하는 건 아니에요. 계산에 넣을 때는 “가장 좋은 경우” 칸에 두는 게 맞아요.
OrcaRouter는 2026-11-18에 X에서 한 편집자의 단일 작업을 전했어요. Ultrafast는 평균 초당 약 126 token, 피크 약 252였고, 작업 전체 소요 시간(wall clock)은 약 27분이었는데 그중 모델 응답이 약 14분이었어요. 전언 작성자는 이 숫자를 Artificial Analysis가 공개한 표준 등급 85 token/초와 비교해 약 1.5배라고 계산했어요. 하지만 이 기록은 실행이 한 번뿐이고, 반복도 없고, 같은 작업의 표준 등급 대조도 없어요. 그래서 데이터 포인트 하나일 뿐, 이 속도 등급의 최종 성능을 대표한다고 볼 수는 없어요.
이 기록은 놓치기 쉬운 사실 하나도 보여줘요. 27분의 전체 소요 시간 가운데 모델 응답은 약 14분뿐이에요. 속도 등급은 모델 생성 구간만 빠르게 할 뿐, 도구 호출, 파일 읽기·쓰기, 사람의 확인 같은 단계는 그만큼 빨라지지 않아요.
GPT-6.2 Sol Ultrafast 속도 프리미엄 계산법: 그대로 적용할 수 있는 알고리즘
아래 알고리즘은 의도적으로 다른 사람이 측정한 배수는 전혀 사용하지 않아요. 직접 준비해야 할 데이터는 오직 하나, 이번 작업을 표준 티어에서 실행했을 때의 소요 시간이에요.
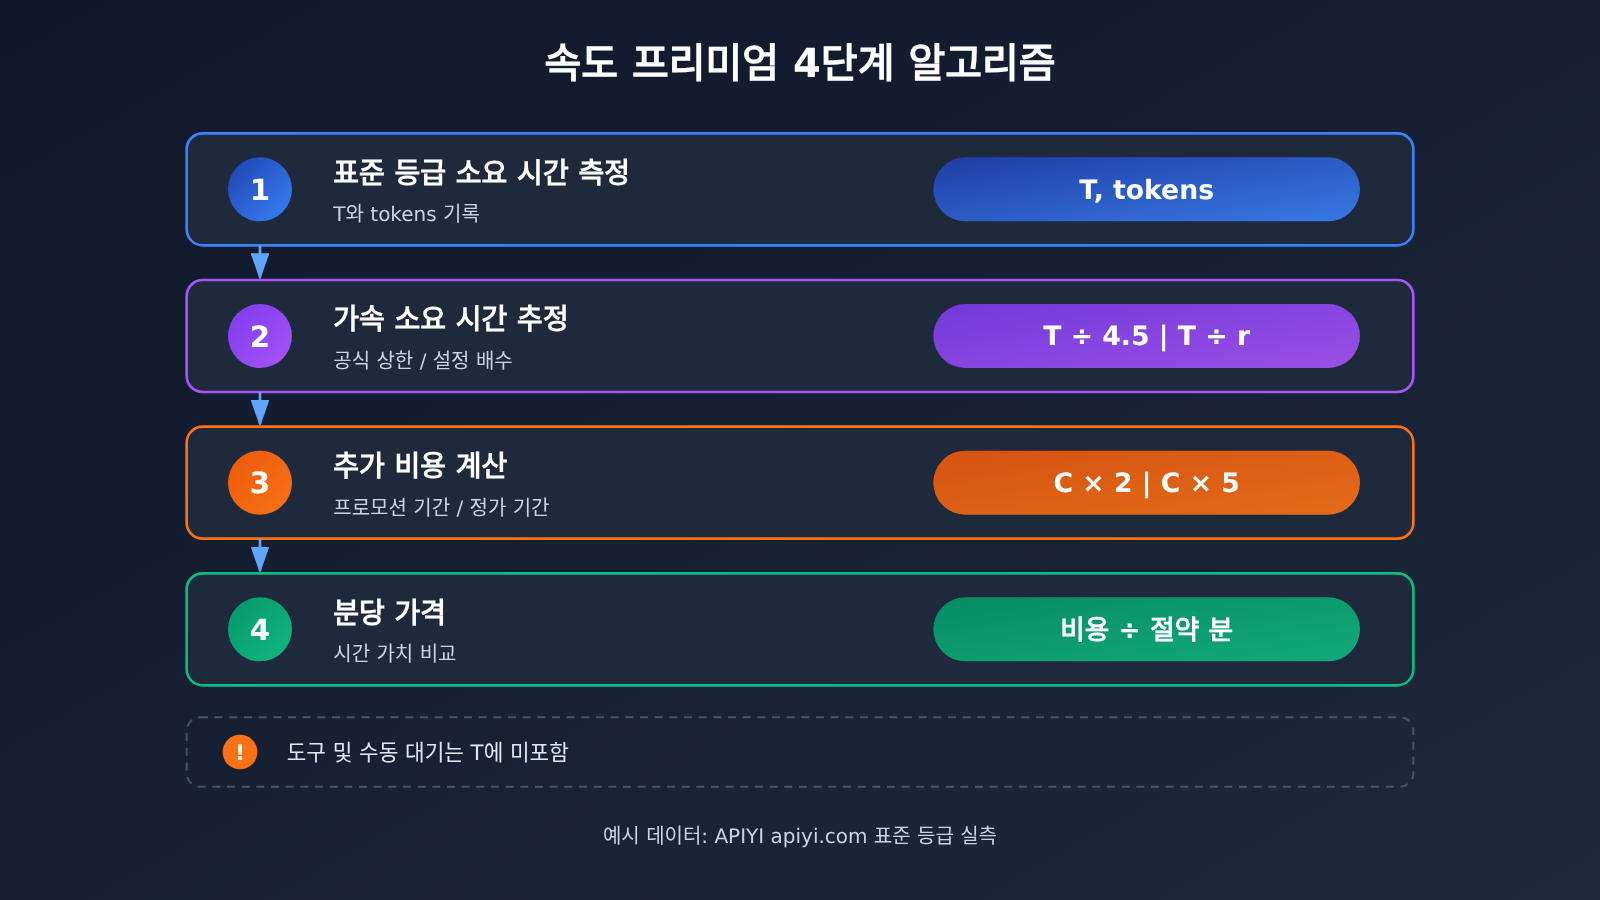
| 단계 | 계산 항목 | 공식 | 설명 |
|---|---|---|---|
| ① | 표준 티어 생성 소요 시간 T | 직접 측정 | 모델 생성만 계산하고 도구 시간은 제외 |
| ② | 최선의 경우 절약 가능 시간 | T × (1 − 1/4.5) ≈ 0.78T | 공식 상한 적용 |
| ②′ | 보수적 경우 절약 가능 시간 | T × (1 − 1/r) | r은 직접 정한 배수이며 r ≤ 4.5 |
| ③ | 표준 티어 비용 C | 입력×단가 + 캐시 읽기×단가 + 출력×단가 | 컨텍스트 길이에 따라 가격 티어 선택 |
| ④ | 프로모션 기간 추가 비용 | C × 2 | Ultrafast 프로모션 가격은 3C |
| ④′ | 정가 기간 추가 비용 | C × 5 | Ultrafast 정가 가격은 6C |
| ⑤ | 1분 절약당 가격 | 추가 비용 ÷ 절약한 분 수 | 자신의 시간 가치와 비교 |
GPT-6.2 Sol Ultrafast 예시 계산
아래에서는 가상의 숫자로 알고리즘을 보여드릴게요. 이 숫자들은 속도 측정 결과가 아니에요. 한 번의 작업에 입력 20만 tokens(짧은 컨텍스트), 출력 5만 tokens, 캐시 히트 없음이라고 가정해 볼게요. 여러분이 표준 티어에서 직접 측정한 출력 속도는 80 token/초라고 해요.
- 표준 티어 비용 C = 0.2 × 2 + 0.05 × 10 = 0.9달러.
- 표준 티어 생성 소요 시간 T = 50000 ÷ 80 ≈ 625초, 약 10.4분.
- Ultrafast 프로모션 가격은 2.7달러라 추가 지출이 1.8달러이고, 정가는 5.4달러라 추가 지출이 4.5달러예요.
| 가정 배수 r | 생성 소요 시간 | 절약된 시간 | 프로모션 기간 분당 가격 | 정가 기간 분당 가격 |
|---|---|---|---|---|
| 4.5(공식 상한) | 약 2.3분 | 약 8.1분 | 약 0.22달러 | 약 0.56달러 |
| 3 | 약 3.5분 | 약 6.9분 | 약 0.26달러 | 약 0.65달러 |
| 2 | 약 5.2분 | 약 5.2분 | 약 0.35달러 | 약 0.87달러 |
| 1.5 | 약 6.9분 | 약 3.5분 | 약 0.51달러 | 약 1.29달러 |
이 표에서 두 가지를 알 수 있어요. 첫째, 배수가 4.5에서 1.5로 떨어지면 분당 가격이 대략 두 배가 되니까, 가격 자체보다 배수 가정이 더 중요해요. 둘째, 2027년 3월 정가가 적용된 뒤에는 똑같이 1분을 절약하는 데 약 2.5배 더 많은 돈을 내야 하므로, 프로모션 기간의 결론을 내년에 그대로 적용할 수는 없어요.
💰 비용 확인 제안: 예시에 나온 표준 티어 단가는 APIYI apiyi.com 종합 표에서
gpt-6.2-sol의 표기 가격(입력 2, 캐시 읽기 0.1, 출력 10)과 바로 대조해 볼 수 있어요. 이 가격대는 공식 표준 티어의 짧은 컨텍스트와 일치하므로, 알고리즘의 C값 출처로 삼기에 적합해요.
코드로 직접 측정해 보는 GPT-6.2 Sol 표준 티어 소요 시간
알고리즘의 첫 단계에서는 실제 T 값이 필요해요. 아래 코드는 스트리밍 출력으로 첫 토큰까지 걸린 시간과 전체 생성 시간을 기록하고, usage에서 토큰 수를 읽어 와서 여러분의 작업이 표준 티어에서 어느 정도 속도를 내는지 계산해 줍니다.
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 엔드포인트
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "把你的真实任务提示词放在这里"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"首 token {first - start:.1f}s,生成 {gen:.1f}s,"
      f"输出 {usage.completion_tokens} tokens,约 {usage.completion_tokens / gen:.0f} tok/s")
service_tier까지 포함한 전체 비교 스크립트 보기
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # 달러/백만 토큰, 단문맥 기준
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # 공식 사용법: 같은 모델 ID에 service_tier 추가
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "把你的真实任务提示词放在这里"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"标准档:生成 {t_std:.1f}s,费用约 ${c_std:.3f},返回档位 {s_std}")

for name, r in [("官方上限", 4.5), ("保守假设", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:省 {saved_min:.1f} 分钟,"
          f"促销每分钟 ${c_std * 2 / saved_min:.3f},刊例每分钟 ${c_std * 5 / saved_min:.3f}")

# 속도 티어를 직접 측정하려면 아래 주석을 해제하고, 반환된 service_tier 필드가 ultrafast인지 확인하세요
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度档:生成 {t_uf:.1f}s,实际倍数约 {t_std / t_uf:.2f},返回档位 {s_uf}")
service_tier에 대해 한 가지 짚고 넘어갈 게 있어요. APIYI apiyi.com의 모델 총목록에는 gpt-6.2-sol만 올라 있고, 별도의 ultrafast 모델명도, service_tier 필드 표기도 없어요. 목록에 적힌 가격은 표준 등급 기준이에요. 이 글은 문서와 가격표만 확인했을 뿐 실제 요청은 보내지 않았기 때문에, 이 파라미터가 https://api.apiyi.com/v1로 호출될 때 어떻게 동작하는지는 말씀드릴 수 없어요. 속도 등급이 필요하다면 응답에 반환되는 등급 필드와 청구서를 기준으로 보고, 모델명과 가격은 플랫폼 모델 목록을 기준으로 확인하세요.
🚀 시작 전 팁: 먼저 APIYI apiyi.com의 표준 등급
gpt-6.2-sol로 내 실제 작업을 두세 번 돌려 보고, 생성에 걸린 시간의 중앙값을 T로 잡으세요. 이 단계는 표준 가격만 쓰지만, 이후 모든 계산의 정확도를 결정해요.
GPT-6.2 Sol Ultrafast 시나리오 추천
결론은 작업별로 내려야 해요. 같은 사람이라도 작업에 따라 정반대의 답이 나올 수 있어요.
Ultrafast를 켜는 게 좋은 시나리오
- 화면 앞에서 결과를 기다리는 대화형 작업: 실시간 페어 프로그래밍이나 현장 데모 같은 경우요. 기다리는 시간이 곧 인건비라서, 위 공식대로 계산하면 통상 단가로 충분히 메울 수 있어요.
- 생성이 전체 벽시계 시간에서 차지하는 비중이 큰 작업: T가 작업 전체 시간의 대부분이라면, 절약한 시간이 곧바로 전달 시간에 반영돼요.
- 프로모션 기간의 짧은 컨텍스트 작업: 3배 가격에 짧은 컨텍스트의 낮은 단가가 더해지면, 추가로 나가는 절대 금액이 크지 않아요.
표준 등급에 남기는 게 나은 시나리오
- 백그라운드 배치 처리, 야간 작업: 기다리는 사람이 없으니, 절약한 분에 대응하는 시간 가치가 없어요.
- 도구 호출이 많은 Agent 작업: 앞서 옮겨 적은 기록처럼, 벽시계 27분 중 모델 응답은 약 14분만 차지해서 속도 등급은 그 일부만 줄일 수 있어요.
- 긴 컨텍스트, 대량 출력 작업: 정가 기간에는 긴 컨텍스트 출력 단가가 90에 이르러 추가 비용이 빠르게 불어나요.
| 작업 특성 | 생성 시간 비중 | 기다리는 사람 | 권장 |
|---|---|---|---|
| 대화형 코딩, 현장 데모 | 높음 | 있음 | 먼저 공식대로 계산, 통상 단가로 메울 수 있음 |
| 도구 집약형 Agent | 중간~낮음 | 상황에 따라 | 생성 부분만 계산해야 해서 이득이 희석됨 |
| 야간 배치 처리 | 높음 | 없음 | 표준 등급 유지 |
| 긴 컨텍스트 대량 출력 | 높음 | 상황에 따라 | 정가 기간에는 신중히 계산 필요 |
💡 선택 가이드: 한 프로젝트에 두 종류 작업이 모두 있다면, 코드에서 작업 유형에 따라
service_tier를 붙일지 결정하면 되고 전역으로 켤 필요는 없어요. APIYI apiyi.com에서 같은 Key로 표준 등급 기준선을 먼저 돌려 보고, 어떤 작업이 속도 등급 추가 테스트에 값어치가 있는지 판단하세요.
GPT-6.2 Sol Ultrafast 의사결정 가이드
앞선 내용을 하나의 고정된 절차로 정리해 볼게요.
- 표준 티어로 실제 작업을 돌려 보고, 생성에 걸린 시간 T와 토큰 사용량을 기록해요. 다른 사람이 말한 속도 수치는 쓰지 않아요.
- 공식 상한인 4.5배로 최선의 경우를 계산하고, 스스로 합리적이라고 판단하는 보수적 배수 r을 하나 골라서 두 경우를 모두 계산해요.
- 프로모션 3배와 정가 6배로 각각 추가 지출을 계산해서 두 개의 “분당 가격”을 구해요.
- 자신의 시간 가치와 비교해요. 보수적 배수에서도 여전히 이득인 작업이라야 켤 만한 작업이에요.
- 2027-03-01에 정가가 시행되기 전에, 새 가격으로 한 번 더 계산해요.
이 절차의 핵심은 2단계예요. 공식 “최대 4.5배”는 상한으로 삼을 수 있고, 2026-11-18의 약 126 token/초라는 언급은 단일 데이터 포인트일 뿐이에요. 둘 다 이번 작업의 실제 배수는 아니에요. 실제 배수는 오직 자신의 작업에서 대조 테스트를 해 봐야만 알 수 있어요.
자주 묻는 질문 FAQ
Q1: GPT-6.2 Sol Ultrafast는 새로운 모델인가요?
아니요. 공식 API 문서를 보면 Ultrafast는 서비스 티어이고, 요청의 `model`은 여전히 `gpt-6.2-sol`이에요. 여기에 `service_tier`를 추가해서 `ultrafast`로 설정하면 되고, 모델 자체는 바뀌지 않아요.
Q2: Ultrafast를 켜면 반드시 4.5배가 나오나요?
아니요. 공식 원문은 “up to 4.5 times”로, 상한을 뜻하는 표현이에요. 계산할 때는 더 낮은 보수적 배수도 함께 준비하고, 자신의 대조 테스트 결과를 기준으로 삼아야 해요.
Q3: GPT-6.2 Sol Ultrafast의 프로모션 가격은 언제 끝나나요?
공식 프로모션 가격은 2027-02-28(태평양 시간)까지 이어지고, 가격은 표준가의 3배예요. 2027-03-01부터는 정가가 적용되어 표준가의 6배가 돼요. 짧은 컨텍스트든 긴 컨텍스트든 모두 이 배수 관계를 따라요.
Q4: 그 약 126 token/초 기록은 참고할 수 있나요?
하나의 데이터 포인트로 참고할 수는 있지만, 결론으로 삼을 수는 없어요. 2026-11-18에 OrcaRouter가 전한 한 번의 작업이고, 반복 실행도 없었고, 같은 작업의 표준 티어 대조도 없었어요. 본문의 약 1.5배라는 주장은 Artificial Analysis가 공개한 표준 티어 85 token/초와 비교해서 나온 것이에요.
Q5: APIYI에서 보이는 gpt-6.2-sol 가격은 어느 티어인가요?
표준 티어예요. APIYI apiyi.com 전체 표에서 `gpt-6.2-sol`의 표시 가격은 입력 2, 캐시 읽기 0.1, 출력 10이고, 공식 표준 티어의 짧은 컨텍스트와 일치해요. responses와 chat 엔드포인트를 지원해요. 전체 표에는 별도의 ultrafast 모델이 없고, `service_tier`도 적혀 있지 않아요.
Q6: 입력 토큰이 27.2만을 넘으면 표준 티어는 얼마로 계산되나요?
두 출처의 숫자가 달라서 따로 계산해야 해요. APIYI 전체 표에는 입력 27.2만 초과 시 3달러로 적혀 있고, 공식 표준 티어의 긴 컨텍스트 입력은 4달러예요. https://api.apiyi.com/v1 로 호출할 때는 플랫폼 모델 목록을 기준으로 계산하고, 공식에 직접 연결하면 4달러로 계산해요.
GPT-6.2 Sol Ultrafast 속도 프리미엄 핵심 요점
- Ultrafast는 서비스 등급이에요: 동일한 모델 ID
gpt-6.2-sol에service_tier만 붙이면 되고, 모델 성능은 그대로예요. - 4.5배는 공식 상한이에요: 원문이 up to이므로, 계산할 때 매번 달성할 수 있는 배수로 취급하면 안 돼요.
- 가격은 두 구간으로 나뉘어요: 프로모션 기간에는 표준가의 3배, 2027-03-01부터는 정가(리스트가)의 6배예요.
- 생성 시간만 빨라져요: 도구 호출 같은 비생성 시간은 절감 가능한 부분에 포함되지 않아요.
- 한 번의 측정 기록으로 결과를 대표할 수 없어요: 2026-11-18의 약 126 token/초 기록에는 표준 등급 대조군이 없었어요.
- 먼저 내 표준 등급을 측정하세요: APIYI apiyi.com의 표준 등급
gpt-6.2-sol로 T를 측정한 뒤 알고리즘에 대입하면 돼요.
정리
GPT-6.2 Sol Ultrafast 속도 프리미엄 계산은 세 가지로 정리할 수 있어요:
- 속도는 상한과 보수, 두 값을 써요: 공식 최고 4.5배는 최상의 경우에 넣고, 직접 정한 보수 배수는 다른 칸에 넣어요.
- 가격은 따로 계산해요: 프로모션 기간의 추가 지출은 표준 비용의 2배, 정가 기간에는 5배이므로 두 결론을 섞으면 안 돼요.
- 결론은 작업에 따라 달라져요: 1분을 절약하는 데 드는 가격이 당신의 시간 가치보다 낮아야, 이 작업에 속도 등급을 켜는 게 적합해요.
제목에 던진 질문의 답은 당신의 작업 데이터에 달려 있어요. 먼저 APIYI apiyi.com에서 표준 등급으로 베이스라인을 측정한 다음, 그 숫자를 이 글의 계산표에 대입해 보세요.
📚 참고 자료
-
OpenAI Codex 속도 등급 설명: Ultrafast 최고 4.5배라는 공식 표기
- 링크:
developers.openai.com/codex/agent-configuration/speed - 설명: “up to 4.5 times” 원문과 적용 모델 확인
- 링크:
-
OpenAI Ultrafast 모드 API 가이드:
service_tier사용법과 지원 모델- 링크:
developers.openai.com/api/docs/guides/ultrafast-mode - 설명: Ultrafast는 서비스 등급이며
model은 바뀌지 않음을 확인
- 링크:
-
OpenAI API 가격 페이지: 표준 등급, Fast, Ultrafast 프로모션 가격과 정가
- 링크:
developers.openai.com/api/docs/pricing - 설명: 짧은 컨텍스트와 긴 컨텍스트의 전체 가격
- 링크:
-
OrcaRouter 전달 기록: 2026-11-18의 단일 Ultrafast 작업 데이터
- 링크:
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - 설명: 단일 사례이고 대조군이 없는 전달 기록이라 하나의 데이터 포인트로만 볼 수 있어요
- 링크:
-
APIYI 모델 총표:
gpt-6.2-sol표준 등급 표시 가격과 단계- 링크:
docs.apiyi.com/models.md - 설명: 표준 등급 단가와 27.2만 입력 초과 구간의 가격 확인
- 링크:
작성자: APIYI 기술 팀
기술 문의: 계산이나 연동 관련 문제가 있으시면 APIYI 공식 웹사이트 홈페이지를 통해 저희에게 연락해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있습니다.


