
Anmerkung des Autors: Dieser Artikel listet die offizielle Geschwindigkeitsobergrenze, den Aktionspreis und den Listenpreis von GPT-6.2 Sol Ultrafast getrennt auf und liefert einen Rechenweg für den Geschwindigkeitsaufschlag, den du auf deine eigenen Aufgaben übertragen kannst.
Ob du Ultrafast für GPT-6.2 Sol aktivierst, hängt davon ab, wie viel Wartezeit diese Aufgabe einsparen kann. Die offizielle Geschwindigkeit ist höchstens 4.5-mal so hoch wie der Standardtarif desselben Modells, der Preis während der Aktionsphase beträgt das 3-Fache des Standardpreises, und der Listenpreis ab März 2027 liegt beim 6-Fachen. Die Geschwindigkeit ist ein Höchstwert, der Preis eine feste Zahl. Beide sind unterschiedlich verlässlich bestimmt und lassen sich nicht einfach durcheinander dividieren.
Dieser Artikel beantwortet die Frage „Lohnt sich der Kauf?“ nicht für dich. Wir ziehen keine eigenen Schlussfolgerungen aus Geschwindigkeitstests und behandeln auch keinen inoffiziellen Erfahrungsbericht ohne Kontrollgruppe als Endergebnis. Dieser Artikel liefert nur einen Rechenweg: Miss zuerst die Laufzeit deiner eigenen Aufgabe im Standardtarif, berechne dann mit dem offiziellen „höchstens“-Faktor die Obergrenze der möglichen Zeitersparnis und vergleiche sie schließlich mit dem Preisunterschied.
Der Kernnutzen: Nach dem Lesen dieses Artikels kannst du für jede beliebige Aufgabe ausrechnen, „wie viel mehr du pro eingesparter Minute bezahlst“, und dann je nach Aufgabe entscheiden, ob du den Geschwindigkeitstarif aktivierst.
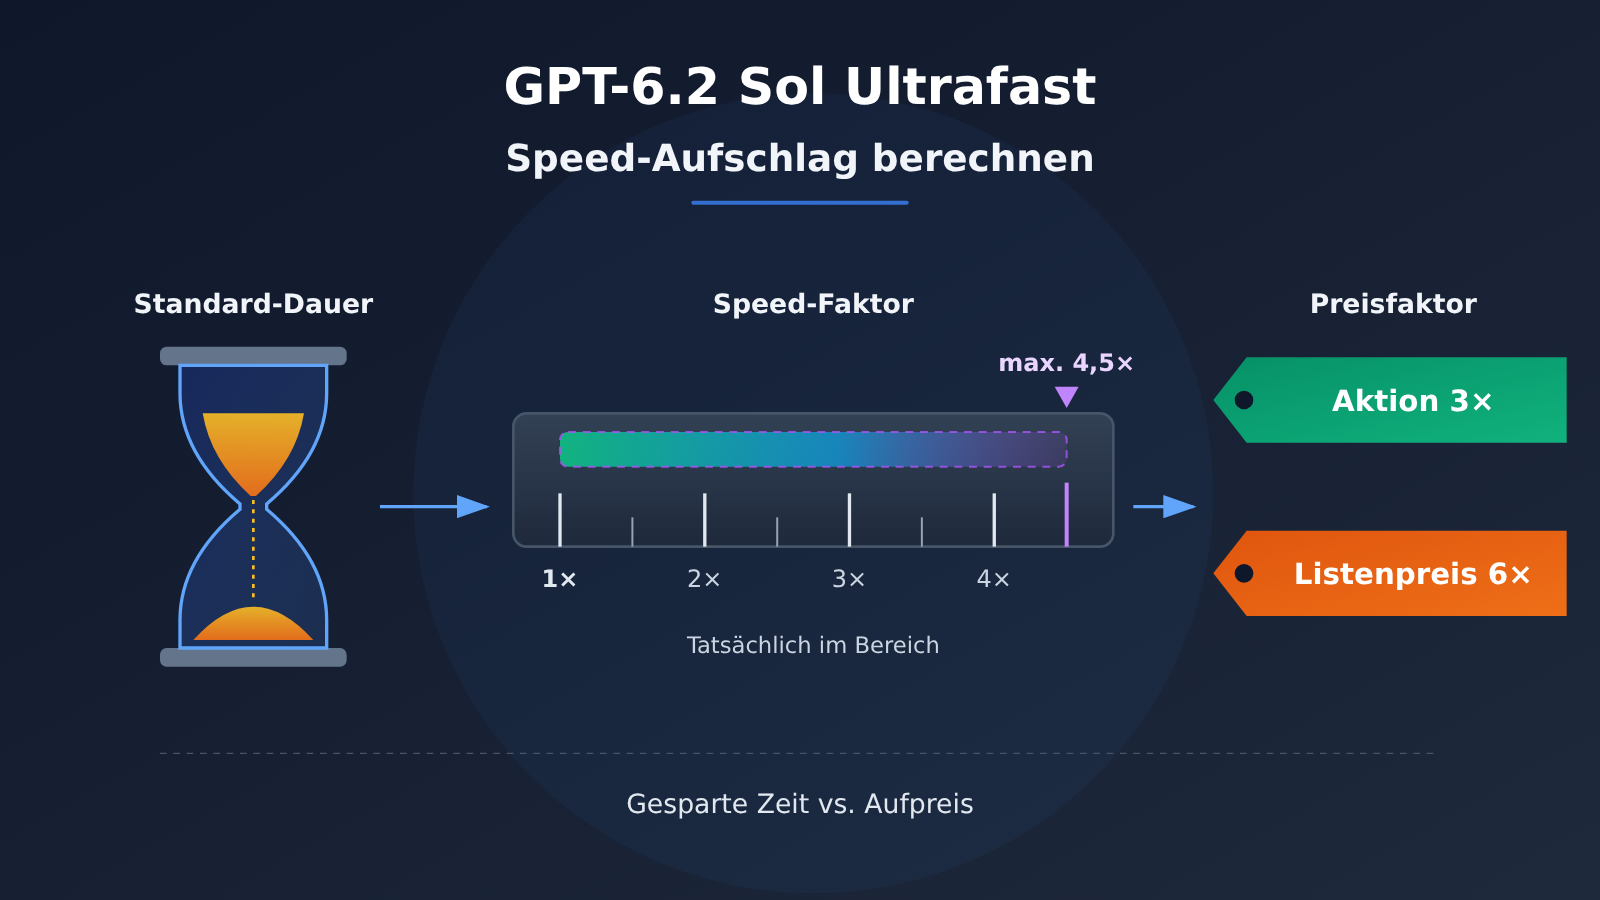
Die zentralen Unterschiede beim Geschwindigkeitsaufpreis von GPT-6.2 Sol Ultrafast
Zuerst muss ein Begriff geklärt werden: Ultrafast ist eine Service-Stufe und kein eigenes Modell. Laut offizieller API-Dokumentation bleibt model in der Anfrage weiterhin gpt-6.2-sol; du musst lediglich zusätzlich service_tier angeben und auf ultrafast setzen. Derzeit unterstützen GPT-6.2 Astra, GPT-6.2 Sol, GPT-6 Astra und GPT-6.1 Sol diese Service-Stufe.
Du vergleichst also zwei Auslieferungsgeschwindigkeiten desselben Modells – nicht die Fähigkeiten zweier Modelle. Die Frage der Ausgabequalität können wir beiseitelassen, denn es bleiben nur zwei Variablen: Zeit und Preis.
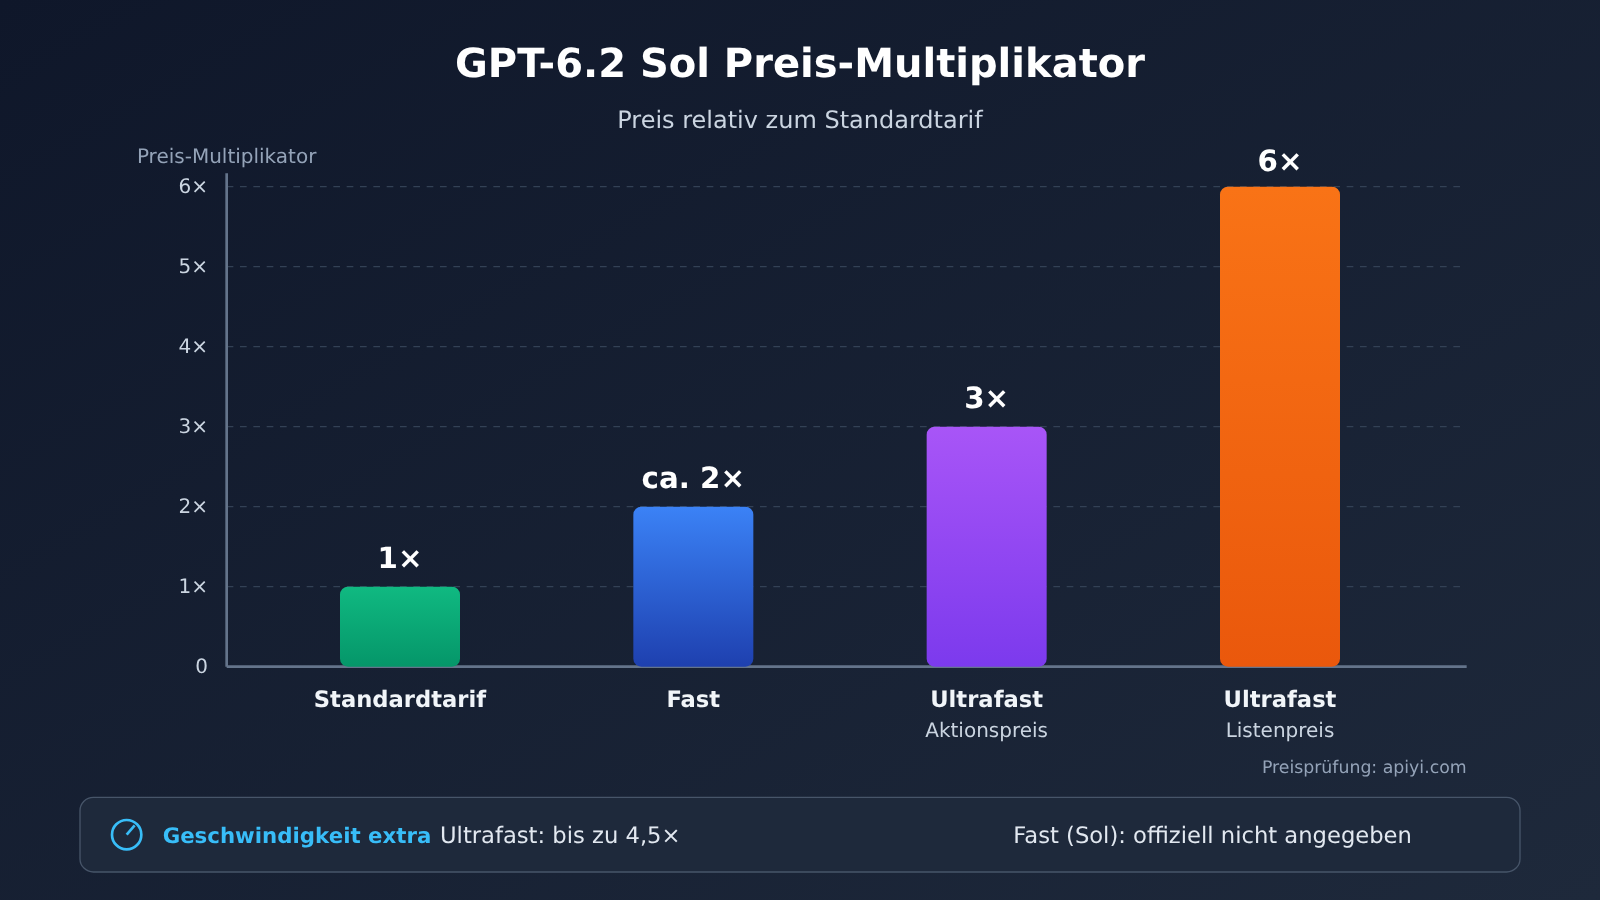
| Stufe (gpt-6.2-sol, kurzer Kontext) | Eingabe | Cache-Lesen | Ausgabe | Relativ zum Standardpreis | Offizielle Angabe zur Geschwindigkeit |
|---|---|---|---|---|---|
| Standard-Stufe | 2 | 0.10 | 10 | 1× | Referenz |
| Fast | 4 | 0.20 | 20 | ca. 2× | In der Doku ist für Sol kein Geschwindigkeitsfaktor angegeben |
| Ultrafast Aktionspreis (bis 28.02.2027, pazifische Zeit) | 6 | 0.30 | 30 | 3× | bis zu 4,5-fach |
| Ultrafast Listenpreis (ab 01.03.2027) | 12 | 0.60 | 60 | 6× | bis zu 4,5-fach |
Die Preise in der Tabelle sind in US-Dollar pro Million Tokens angegeben; „kurzer Kontext“ bedeutet, dass die Eingabe höchstens 272.000 Tokens umfasst. Zur Fast-Stufe noch ein separater Hinweis: Die in der offiziellen Dokumentation genannte „etwa 1,5-fache Geschwindigkeit“ bezieht sich auf GPT-6.2 Astra und GPT-5.6 und steht nicht bei GPT-6.2 Sol – dieser Faktor lässt sich daher nicht auf die Fast-Stufe von Sol übertragen.
GPT-6.2 Sol Ultrafast – Preise für langen Kontext
Sobald die Eingabe 272.000 Tokens überschreitet, greift die Preisstaffel für langen Kontext. Im offiziellen Standardtarif liegen die Preise für langen Kontext bei 4 für die Eingabe, 0,20 für Cache-Lesevorgänge und 15 für die Ausgabe. Der Ultrafast-Aktionspreis beträgt 12 / 0,60 / 45, der Listenpreis 24 / 1,20 / 90 – also weiterhin das 3-Fache bzw. 6-Fache des Standardpreises.
| Abrechnungsposten (langer Kontext, USD pro Million Tokens) | Eingabe | Cache-Lesevorgang | Ausgabe |
|---|---|---|---|
| Offizieller Standardtarif | 4 | 0,20 | 15 |
| Ultrafast-Aktion | 12 | 0,60 | 45 |
| Ultrafast-Listenpreis | 24 | 1,20 | 90 |
APIYI-Übersichtstabelle gpt-6.2-sol (über 272.000 Eingabe-Tokens) |
3 | gemäß Plattformliste | gemäß Plattformliste |
An dieser Stelle gibt es eine zahlenmäßige Abweichung, die gesondert erläutert werden muss: Die Modellübersichtstabelle von APIYI (apiyi.com) gibt die Staffelung mit 2 USD für Eingaben von 0 bis 272.000 Tokens an und mit 3 USD für Eingaben über 272.000 Tokens, während der Eingabepreis im offiziellen Standardtarif für langen Kontext 4 USD beträgt. Diese beiden Zahlen sollten nicht zusammengeführt werden: Bei Aufrufen über APIYI gilt der Wert von 3 USD aus der Übersichtstabelle, bei direkter Anbindung an den offiziellen Anbieter werden 4 USD berechnet.
Woher die Geschwindigkeit von GPT-6.2 Sol Ultrafast kommt: offizielle Obergrenze und Messungen aus der Community
Zur Geschwindigkeit gibt es derzeit zwei Arten von Informationen, deren Verlässlichkeit stark voneinander abweicht – sie sollten getrennt behandelt werden.
| Quelle | Inhalt | Charakter | Kann als dein Multiplikator gelten |
|---|---|---|---|
| Offizielle Codex-/API-Dokumentation | Ultrafast-Generierungsgeschwindigkeit bis zu 4,5-mal so hoch wie die Standardstufe desselben Modells (up to 4.5 times) | offizielle Angabe zur Obergrenze | nur als Obergrenze |
| Artificial Analysis | Standardstufe desselben Modells etwa 85 Output-Token/Sekunde | öffentlicher Benchmark eines Drittanbieters | nur als Referenz |
| OrcaRouter, Weiterverbreitung vom 2026-11-18 | eine Aufgabe im Durchschnitt etwa 126 Token/Sekunde, Spitzenwert etwa 252 | Einzelmessung ohne Vergleich mit der Standardstufe | nein |
Der offizielle Text verwendet „up to“, also „bis zu“ – das heißt: maximal erreichbar, ohne zu versprechen, dass jede Anfrage das 4,5-Fache erreicht. In der Rechnung gehört dieser Wert in die Spalte „Best Case“.
Am 2026-11-18 hat OrcaRouter eine einzelne Aufgabe eines Cutters von X weiterverbreitet: Ultrafast im Durchschnitt etwa 126 Token pro Sekunde, Spitzenwert etwa 252; die Wall-Clock-Zeit der Aufgabe betrug etwa 27 Minuten, davon etwa 14 Minuten Modellantwort. Der Autor des Beitrags verglich diese Zahl mit den von Artificial Analysis veröffentlichten 85 Token/Sekunde der Standardstufe und kam auf etwa das 1,5-Fache. Dieser Datensatz beruht auf einem einzigen Lauf, ohne Wiederholung und ohne Vergleich derselben Aufgabe in der Standardstufe – er taugt daher nur als einzelner Datenpunkt und kann nicht die endgültige Leistung dieser Geschwindigkeitsstufe repräsentieren.
Dieser Datensatz offenbart noch einen leicht zu übersehenden Fakt: In den 27 Minuten Wall-Clock-Zeit macht die Modellantwort nur etwa 14 Minuten aus. Die Geschwindigkeitsstufe beschleunigt nur den Abschnitt der Modellgenerierung – Tool-Aufrufe, Datei-Lese- und Schreibvorgänge, manuelle Freigaben und ähnliche Schritte werden dadurch nicht schneller.
So berechnen Sie den Geschwindigkeitsaufpreis von GPT-6.2 Sol Ultrafast: eine direkt anwendbare Rechenmethode
Die folgende Rechenmethode verzichtet bewusst auf jegliche „von anderen gemessenen Faktoren“. Die einzige Angabe, die Sie selbst liefern müssen, ist die Dauer dieser Aufgabe im Standardmodus.
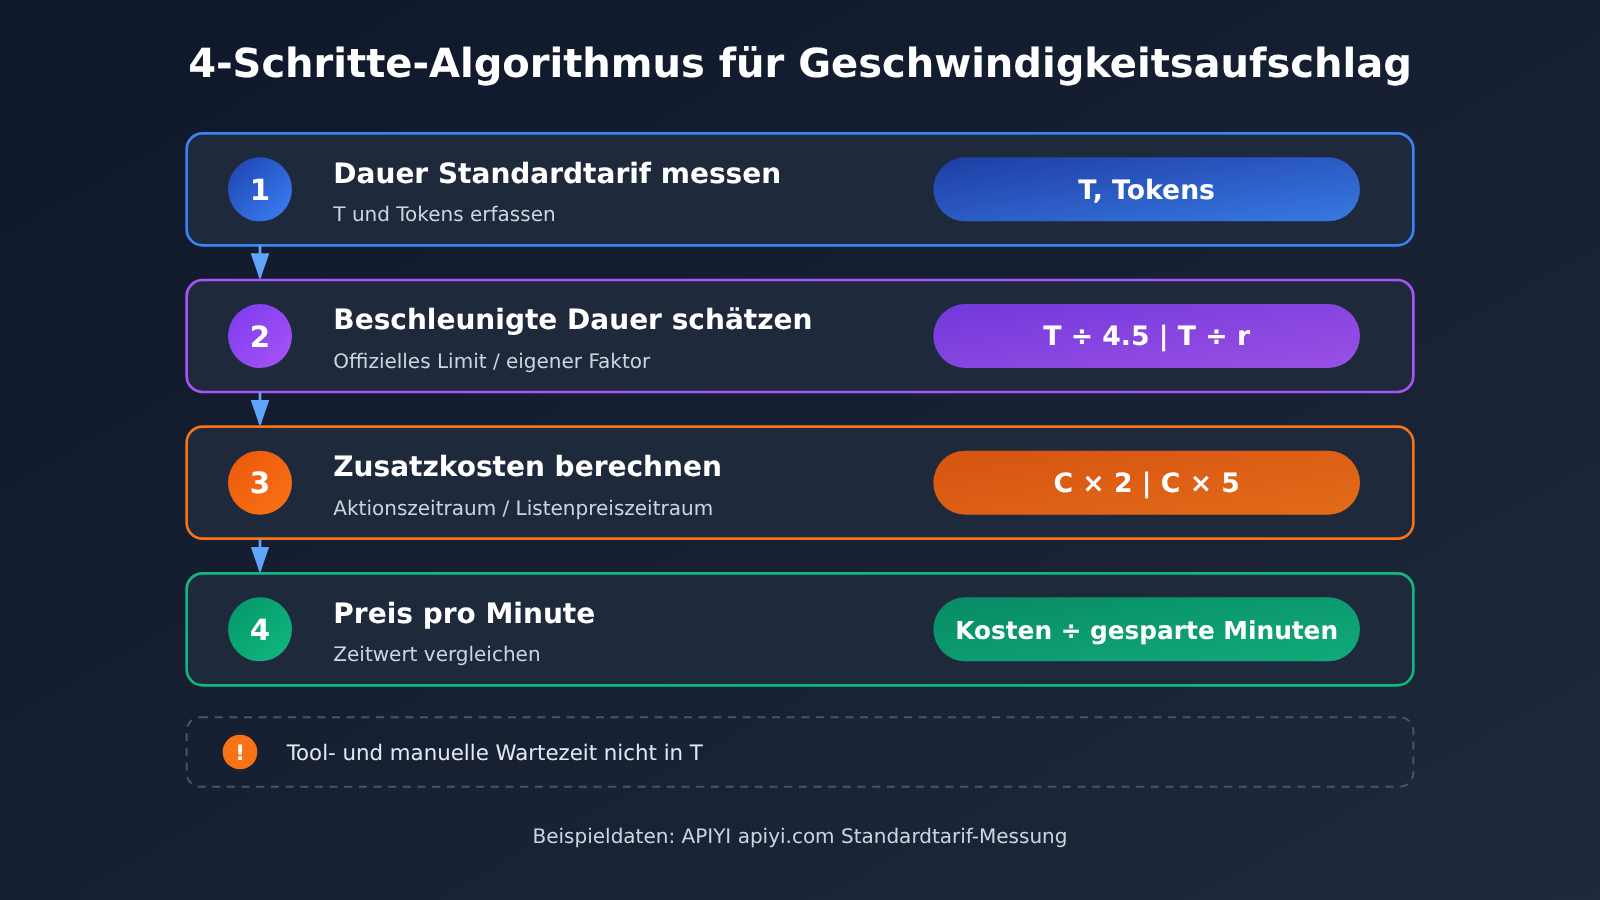
| Schritt | Berechnung | Formel | Erläuterung |
|---|---|---|---|
| ① | Generierungszeit T im Standardmodus | Selbst messen | Nur Modellgenerierung, keine Tool-Zeit |
| ② | Einsparbare Zeit im Bestfall | T × (1 − 1/4.5) ≈ 0.78T | Offizielle Obergrenze verwenden |
| ②′ | Einsparbare Zeit im konservativen Fall | T × (1 − 1/r) | r ist der selbst festgelegte Faktor, mit r ≤ 4.5 |
| ③ | Kosten C im Standardmodus | Eingabe × Stückpreis + Cache-Lesen × Stückpreis + Ausgabe × Stückpreis | Preistufe nach Kontextlänge wählen |
| ④ | Zusatzkosten in der Aktionsphase | C × 2 | Ultrafast-Aktionspreis beträgt 3C |
| ④′ | Zusatzkosten in der Listenpreisphase | C × 5 | Ultrafast-Listenpreis beträgt 6C |
| ⑤ | Preis pro eingesparter Minute | Zusatzkosten ÷ eingesparte Minuten | Mit dem eigenen Zeitwert vergleichen |
GPT-6.2 Sol Ultrafast – Beispielrechnung
Im Folgenden wird die Berechnung mit einer Reihe angenommener Zahlen veranschaulicht. Diese Zahlen sind keine Ergebnisse einer Geschwindigkeitsmessung. Angenommen, eine Aufgabe hat 200.000 Tokens Eingabe (kurzer Kontext) und 50.000 Tokens Ausgabe, ohne Cache-Treffer; Ihre eigene Ausgabegeschwindigkeit im Standardmodus liegt bei 80 Tokens/Sekunde.
- Kosten im Standardmodus: C = 0,2 × 2 + 0,05 × 10 = 0,9 US-Dollar.
- Generierungsdauer im Standardmodus: T = 50000 ÷ 80 ≈ 625 Sekunden, also etwa 10,4 Minuten.
- Der Aktionspreis für Ultrafast beträgt 2,7 US-Dollar, die Mehrkosten betragen 1,8 US-Dollar; der Listenpreis beträgt 5,4 US-Dollar, die Mehrkosten 4,5 US-Dollar.
| Angenommener Faktor r | Generierungsdauer | Zeitersparnis | Preis pro Minute während der Aktion | Preis pro Minute zum Listenpreis |
|---|---|---|---|---|
| 4,5 (offizielles Maximum) | etwa 2,3 Minuten | etwa 8,1 Minuten | etwa 0,22 US-Dollar | etwa 0,56 US-Dollar |
| 3 | etwa 3,5 Minuten | etwa 6,9 Minuten | etwa 0,26 US-Dollar | etwa 0,65 US-Dollar |
| 2 | etwa 5,2 Minuten | etwa 5,2 Minuten | etwa 0,35 US-Dollar | etwa 0,87 US-Dollar |
| 1,5 | etwa 6,9 Minuten | etwa 3,5 Minuten | etwa 0,51 US-Dollar | etwa 1,29 US-Dollar |
Aus dieser Tabelle lassen sich zwei Dinge ablesen. Erstens: Sinkt der Faktor von 4,5 auf 1,5, verdoppelt sich der Preis pro Minute ungefähr. Die Annahme zum Faktor ist daher entscheidender als der Preis selbst. Zweitens: Wenn im März 2027 der Listenpreis gilt, kostet dieselbe eingesparte Minute etwa 2,5-mal so viel. Die Schlussfolgerungen aus der Aktionsphase lassen sich daher nicht ohne Weiteres auf das nächste Jahr übertragen.
💰 Empfehlung zur Kostenprüfung: Die Einheitspreise im Standardmodus aus dem Beispiel können direkt mit den Listenpreisen für
gpt-6.2-solin der Übersichtstabelle von APIYI apiyi.com abgeglichen werden (Eingabe 2, Cache-Lesen 0,1, Ausgabe 10). Diese Preise stimmen mit dem offiziellen Standardmodus für kurzen Kontext überein und eignen sich als Quelle für den C-Wert in der Berechnung.
Mit Code die eigene Laufzeit von GPT-6.2 Sol im Standardtarif messen
Der erste Schritt des Algorithmus braucht ein echtes T. Der folgende Code protokolliert per Streaming-Ausgabe die Zeit bis zum ersten Token und die gesamte Generierungszeit und liest zusätzlich die Token-Anzahl aus usage aus – damit lässt sich die Geschwindigkeit für genau deine Art von Aufgabe im Standardtarif berechnen.
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatibler Endpunkt von APIYI
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "把你的真实任务提示词放在这里"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"首 token {first - start:.1f}s,生成 {gen:.1f}s,"
      f"输出 {usage.completion_tokens} tokens,约 {usage.completion_tokens / gen:.0f} tok/s")
Vollständiges Vergleichsskript inklusive service_tier ansehen
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # USD pro Million Tokens, kurzer Kontext
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # Offizielle Schreibweise: gleiche Modell-ID plus service_tier
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "把你的真实任务提示词放在这里"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"标准档:生成 {t_std:.1f}s,费用约 ${c_std:.3f},返回档位 {s_std}")

for name, r in [("官方上限", 4.5), ("保守假设", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:省 {saved_min:.1f} 分钟,"
          f"促销每分钟 ${c_std * 2 / saved_min:.3f},刊例每分钟 ${c_std * 5 / saved_min:.3f}")

# Für einen echten Test des Speed-Tiers die folgenden Zeilen auskommentieren
# und prüfen, ob das zurückgegebene Feld service_tier "ultrafast" ist
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度档:生成 {t_uf:.1f}s,实际倍数约 {t_std / t_uf:.2f},返回档位 {s_uf}")
Zu service_tier sei gesagt: Die Modellübersicht von APIYI apiyi.com führt nur gpt-6.2-sol auf, kein separates Ultrafast-Modell, und auch das Feld service_tier ist dort nicht aufgeführt. Die dort gelisteten Preise entsprechen der Standardstufe. Dieser Artikel hat nur die Dokumentation und die Preisliste geprüft, keine echten Anfragen gesendet – daher lässt sich nicht sagen, wie sich dieser Parameter bei einem Aufruf über https://api.apiyi.com/v1 verhält. Wenn Sie eine Geschwindigkeitsstufe benötigen, orientieren Sie sich bitte an dem in der Antwort zurückgegebenen Stufenfeld und der Abrechnung; Modell und Preis richten sich nach der Modellliste der Plattform.
🚀 Einstiegstipp: Lassen Sie zunächst zwei- bis dreimal Ihre eigenen echten Aufgaben auf der Standardstufe
gpt-6.2-solvon APIYI apiyi.com laufen und nehmen Sie den Median der Generierungszeit als T. Dieser Schritt kostet nur den Standardpreis, entscheidet aber über die Genauigkeit aller folgenden Berechnungen.
Szenarioempfehlungen für GPT-6.2 Sol Ultrafast
Die Schlussfolgerung muss je nach Aufgabe gezogen werden. Dieselbe Person kann bei unterschiedlichen Aufgaben zu gegensätzlichen Antworten kommen.
Szenarien, die sich für Ultrafast eignen
- Interaktive Aufgaben, bei denen jemand vor dem Bildschirm auf das Ergebnis wartet: zum Beispiel Echtzeit-Pair-Programming oder Live-Demos. Die Wartezeit ist direkt Personalaufwand – nach der obigen Formel lässt sich der Stückpreis in der Regel decken.
- Aufgaben, bei denen die Generierung einen hohen Anteil an der Wall-Clock-Zeit hat: Wenn T den Großteil der Gesamtdauer einer Aufgabe ausmacht, schlägt sich die eingesparte Zeit direkt in der Lieferzeit nieder.
- Kurzkontext-Aufgaben während einer Aktionsphase: Der dreifache Preis trifft auf einen niedrigen Stückpreis für kurzen Kontext – der absolute zusätzliche Aufwand bleibt gering.
Szenarien, die besser auf der Standardstufe bleiben
- Hintergrund-Batchverarbeitung, Nachtaufgaben: Niemand wartet, die eingesparten Minuten haben keinen entsprechenden Zeitwert.
- Werkzeugaufruf-intensive Agent-Aufgaben: Ähnlich wie bei der weiter oben wiedergegebenen Aufzeichnung – von 27 Minuten Wall-Clock-Zeit entfallen nur etwa 14 Minuten auf die Modellantwort, die Geschwindigkeitsstufe kann also nur einen Teil davon komprimieren.
- Langkontext-Aufgaben mit großer Ausgabe: In der Listenpreisphase erreicht der Stückpreis für Langkontext-Ausgaben 90 – die zusätzlichen Kosten wachsen schnell.
| Aufgabenmerkmal | Anteil der Generierungszeit | Jemand wartet | Tendenz |
|---|---|---|---|
| Interaktives Coding, Live-Demos | Hoch | Ja | Erst nach der Formel rechnen, Stückpreis lässt sich in der Regel decken |
| Werkzeugintensive Agenten | Mittel bis niedrig | Je nach Situation | Nur den Generierungsteil rechnen, der Nutzen wird verwässert |
| Nächtliche Batchverarbeitung | Hoch | Nein | Auf der Standardstufe bleiben |
| Langkontext mit großer Ausgabe | Hoch | Je nach Situation | In der Listenpreisphase sorgfältig rechnen |
💡 Auswahltipp: Wenn in demselben Projekt beide Arten von Aufgaben vorkommen, können Sie im Code je nach Aufgabentyp entscheiden, ob
service_tiermitgegeben wird – es muss nicht global aktiviert werden. Legen Sie über APIYI apiyi.com mit demselben Key eine Standardstufen-Baseline an und entscheiden Sie dann, welche Aufgabenart es wert ist, die Geschwindigkeitsstufe weiter zu testen.
Entscheidungsempfehlung für GPT-6.2 Sol Ultrafast
So lässt sich das Vorherige zu einem festen Ablauf zusammenfassen:
- Führen Sie echte Aufgaben im Standardmodus aus und notieren Sie die Generierungszeit T sowie den Token-Verbrauch. Übernehmen Sie dabei keine Geschwindigkeitswerte von anderen.
- Berechnen Sie mit der offiziellen Obergrenze von 4,5 den Bestfall und wählen Sie zusätzlich einen konservativen Multiplikator r, den Sie für angemessen halten. Rechnen Sie beide Szenarien durch.
- Berechnen Sie die zusätzlichen Kosten getrennt mit dem Aktionsfaktor 3 und dem Listenpreis-Faktor 6. So erhalten Sie zwei „Preise pro Minute“.
- Vergleichen Sie das mit dem Wert Ihrer Zeit: Nur Aufgaben, die auch beim konservativen Multiplikator noch lohnend sind, sollten Sie aktivieren.
- Rechnen Sie vor dem Inkrafttreten des Listenpreises am 1. März 2027 noch einmal mit dem neuen Preis nach.
Der entscheidende Punkt in diesem Ablauf ist Schritt 2. Das offizielle „bis zu 4,5-fach“ kann als Obergrenze dienen. Die Angabe vom 18. November 2026 mit rund 126 Token/Sekunde ist dagegen nur ein einzelner Datenpunkt. Beides ist nicht der tatsächliche Multiplikator für Ihre aktuelle Aufgabe. Den realen Multiplikator erhalten Sie nur, indem Sie einen Vergleichstest mit Ihrer eigenen Aufgabe durchführen.
Häufige Fragen (FAQ)
F1: Ist GPT-6.2 Sol Ultrafast ein neues Modell?
Nein. Laut offizieller API-Dokumentation ist Ultrafast eine Service-Stufe: Im Request bleibt `model` weiterhin `gpt-6.2-sol`, zusätzlich setzt man `service_tier` auf `ultrafast`. Das Modell selbst ändert sich nicht.
F2: Erreicht man mit aktiviertem Ultrafast garantiert die 4,5-fache Geschwindigkeit?
Nicht unbedingt. Im offiziellen Wortlaut heißt es „up to 4.5 times“, also eine Obergrenze. Für Kalkulationen sollte man parallel einen niedrigeren, konservativen Faktor ansetzen und sich auf die eigenen Vergleichstests verlassen.
F3: Wann endet der Aktionspreis für GPT-6.2 Sol Ultrafast?
Der offizielle Aktionspreis gilt bis zum 2027-02-28 (Pazifische Zeit) und beträgt das 3-Fache des Standardpreises; ab dem 2027-03-01 gilt der Listenpreis, also das 6-Fache des Standardpreises. Sowohl kurzer als auch langer Kontext folgen diesem Multiplikator.
F4: Taucht der Wert von etwa 126 Token/Sekunde als Referenz?
Er kann als Datenpunkt dienen, aber nicht als Schlussfolgerung. Es handelt sich um eine Aufgabe, die OrcaRouter am 2026-11-18 wiedergegeben hat – ohne Wiederholungsläufe und ohne Vergleich mit der Standardstufe bei derselben Aufgabe. Die im Text genannte Angabe von etwa 1,5-fach ergibt sich aus dem Vergleich mit den von Artificial Analysis veröffentlichten 85 Token/Sekunde der Standardstufe.
F5: Welche Stufe hat der auf APIYI angezeigte Preis für gpt-6.2-sol?
Die Standardstufe. In der Übersichtstabelle von APIYI apiyi.com ist `gpt-6.2-sol` mit Eingabe 2, Cache-Lesen 0,1 und Ausgabe 10 bepreist, was der offiziellen Standardstufe für kurzen Kontext entspricht; unterstützt werden die Endpunkte responses und chat. In der Übersichtstabelle gibt es kein separates ultrafast-Modell, und `service_tier` wird dort nicht aufgeführt.
F6: Wie wird bei der Standardstufe gerechnet, wenn mehr als 272.000 Eingabe-Token anfallen?
Die Zahlen der beiden Quellen unterscheiden sich und müssen getrennt berechnet werden: Die APIYI-Übersichtstabelle nennt für über 272.000 Eingabe-Token 3 US-Dollar, die offizielle Standardstufe für langen Kontext nennt 4 US-Dollar für die Eingabe. Bei Aufrufen über https://api.apiyi.com/v1 wird nach der Modellliste der Plattform gerechnet, bei direkter Anbindung an das offizielle Angebot nach 4 US-Dollar.
GPT-6.2 Sol Ultrafast Geschwindigkeitsaufschlag – Kernthemen (Key Takeaways)
- Ultrafast ist eine Service-Stufe: Es genügt, dieselbe Modell-ID
gpt-6.2-solumservice_tierzu ergänzen – die Modellfähigkeiten bleiben unverändert. - 4,5-fach ist die offizielle Obergrenze: Im Original steht „up to“ – bei der Berechnung darf man diesen Faktor nicht so behandeln, als würde er jedes Mal erreicht.
- Der Preis teilt sich in zwei Phasen: In der Aktionsphase das 3-Fache des Standardpreises, ab dem 2027-03-01 das 6-Fache des Listenpreises.
- Nur die Generierungszeit wird schneller: Tool-Aufrufe und andere Zeiten außerhalb der Generierung zählen nicht zu dem, was sich einsparen lässt.
- Ein einzelner weitergegebener Messwert sagt nichts über das Ergebnis aus: Der am 2026-11-18 gemessene Wert von etwa 126 Token/Sekunde hat keine Vergleichsmessung in der Standardstufe.
- Zuerst die eigene Standardstufe messen: Mit der Standardstufe
gpt-6.2-solbei APIYI apiyi.com lässt sich T ermitteln, das dann in den Algorithmus eingesetzt wird.
Zusammenfassung
Die Berechnung des Geschwindigkeitsaufschlags bei GPT-6.2 Sol Ultrafast lässt sich in drei Punkten zusammenfassen:
- Geschwindigkeit mit Obergrenze und konservativem Wert ansetzen: Die offizielle Höchstgrenze von 4,5-fach kommt in die Best-Case-Spalte, der selbst gewählte konservative Faktor in die andere Spalte.
- Preise getrennt berechnen: In der Aktionsphase beträgt der Zusatzaufwand das 2-Fache der Standardkosten, in der Listenpreisphase das 5-Fache – die beiden Ergebnisse dürfen nicht vermischt werden.
- Die Entscheidung hängt von der Aufgabe ab: Nur wenn der Preis pro eingesparter Minute unter deinem eigenen Zeitwert liegt, lohnt es sich, für diese Aufgabe die Geschwindigkeitsstufe zu aktivieren.
Die Antwort auf die Frage im Titel hängt von deinen eigenen Aufgabendaten ab. Am besten misst du zuerst bei APIYI apiyi.com mit der Standardstufe eine Baseline und setzt die Zahlen dann in die Algorithmus-Tabelle aus diesem Artikel ein.
📚 Referenzen
-
Erläuterung der Geschwindigkeitsstufen von OpenAI Codex: offizielle Angabe „bis zu 4,5-mal“ für Ultrafast
- Link:
developers.openai.com/codex/agent-configuration/speed - Beschreibung: Bestätigt den Originaltext „up to 4.5 times“ und die Modelle, für die er gilt
- Link:
-
API-Leitfaden für den OpenAI-Ultrafast-Modus: Verwendung von
service_tierund unterstützte Modelle- Link:
developers.openai.com/api/docs/guides/ultrafast-mode - Beschreibung: Bestätigt, dass Ultrafast eine Service-Stufe ist und
modelunverändert bleibt
- Link:
-
OpenAI API-Preisseite: Aktionspreise und Listenpreise für Standard, Fast und Ultrafast
- Link:
developers.openai.com/api/docs/pricing - Beschreibung: Vollständige Preise für kurze und lange Kontexte
- Link:
-
OrcaRouter-Wiedergabeprotokoll: Daten einer einzelnen Ultrafast-Aufgabe vom 2026-11-18
- Link:
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - Beschreibung: Eine einmalige Wiedergabe ohne Vergleichsgruppe; sie kann lediglich als einzelner Datenpunkt dienen
- Link:
-
APIYI-Modellübersicht: Listenpreis und Staffelung des Standardtarifs für
gpt-6.2-sol- Link:
docs.apiyi.com/models.md - Beschreibung: Abgleich des Stückpreises im Standardtarif und des Preises für mehr als 272.000 Eingabetokens
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Bei Fragen zu Berechnungen oder zur Anbindung kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.


