
Nota do autor: este artigo lista separadamente o limite máximo oficial de velocidade, o preço promocional e o preço de tabela do GPT-6.2 Sol Ultrafast, e apresenta uma fórmula de prêmio de velocidade que você pode aplicar às suas próprias tarefas.
Ativar o Ultrafast para o GPT-6.2 Sol depende de quanta espera esta tarefa consegue economizar. A velocidade informada oficialmente é de até 4,5 vezes o nível padrão do mesmo modelo, o preço durante a promoção é 3 vezes o preço padrão, e o preço de tabela a partir de março de 2027 é 6 vezes. A velocidade é um limite superior; o preço é um número definido. Como o grau de certeza dos dois é diferente, não dá para simplesmente dividir um pelo outro.
Este artigo não responde por você se “vale a pena comprar”. Não fazemos nossas próprias conclusões de teste de velocidade, nem tratamos um registro informal sem grupo de controle como resultado final. Oferecemos apenas um método: primeiro meça o tempo da sua própria tarefa no nível padrão, depois use o multiplicador “máximo” oficial para calcular o limite de tempo que pode ser economizado e, por fim, compare com a diferença de preço.
Valor central: depois de ler este artigo, você consegue calcular, para qualquer tarefa, “quanto a mais você paga por cada minuto economizado” e então decidir, com base na tarefa, se vale ativar o modo de velocidade.
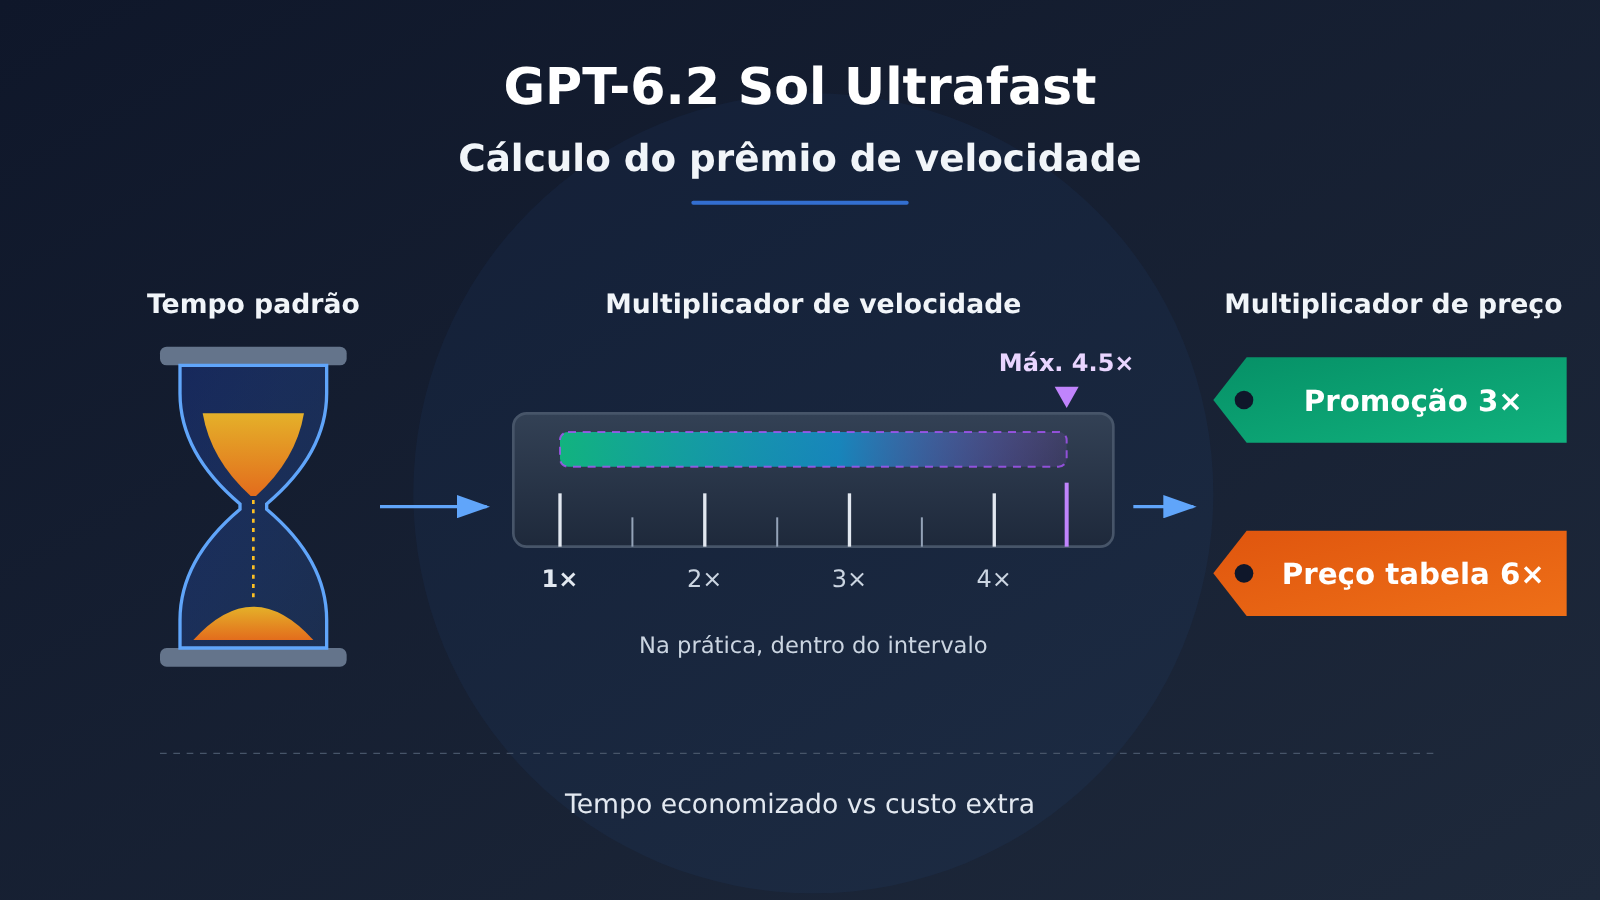
A diferença central do prêmio de velocidade do GPT-6.2 Sol Ultrafast
Antes de tudo, vale esclarecer um conceito: Ultrafast é um nível de serviço, não outro modelo. Conforme a documentação oficial da API, o model na requisição continua sendo gpt-6.2-sol; basta adicionar service_tier e defini-lo como ultrafast. Hoje, os modelos que suportam esse nível de serviço são GPT-6.2 Astra, GPT-6.2 Sol, GPT-6 Astra e GPT-6.1 Sol.
Portanto, o que você está comparando são duas velocidades de entrega do mesmo modelo, e não diferenças de capacidade entre dois modelos. A questão da qualidade da saída pode ficar de lado: aqui sobram apenas duas variáveis, tempo e preço.
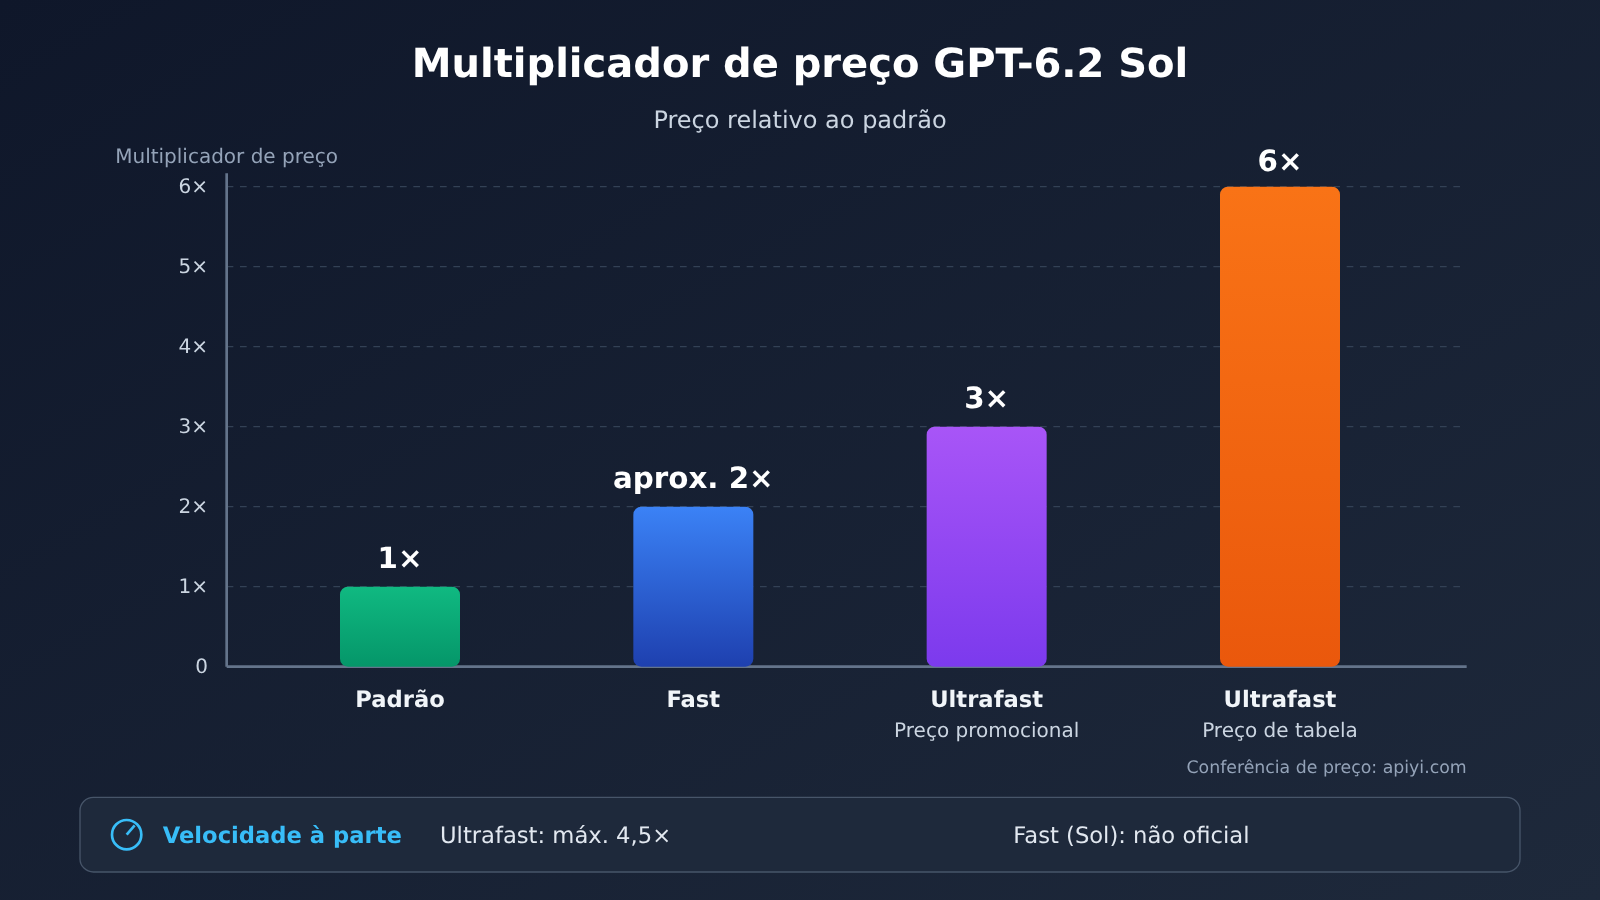
| Nível (gpt-6.2-sol, contexto curto) | Entrada | Leitura de cache | Saída | Relativo ao preço padrão | O que a documentação oficial diz sobre velocidade |
|---|---|---|---|---|---|
| Nível padrão | 2 | 0.10 | 10 | 1× | Referência |
| Fast | 4 | 0.20 | 20 | cerca de 2× | A documentação não informa múltiplo de velocidade para o Sol |
| Ultrafast promocional (até 2027-02-28, horário do Pacífico) | 6 | 0.30 | 30 | 3× | até 4,5 vezes |
| Ultrafast tabela (a partir de 2027-03-01) | 12 | 0.60 | 60 | 6× | até 4,5 vezes |
Na tabela, os preços estão em dólares por milhão de tokens, e “contexto curto” significa entrada de até 272 mil tokens. Vale um alerta separado sobre o nível Fast: o “cerca de 1,5 vez mais rápido” que aparece na documentação oficial se refere ao GPT-6.2 Astra e ao GPT-5.6, e não está escrito para o GPT-6.2 Sol — então não dá para aplicar esse múltiplo ao nível Fast do Sol.
Preços de contexto longo do GPT-6.2 Sol Ultrafast
Se a entrada passar de 272 mil tokens, entra na precificação de contexto longo. No nível oficial padrão, o preço de contexto longo é 4 para entrada, 0.20 para leitura de cache e 15 para saída. O Ultrafast promocional fica em 12 / 0.60 / 45, e o preço de tabela (list price) em 24 / 1.20 / 90 — ou seja, ainda 3 vezes e 6 vezes o preço padrão.
| Item de precificação (contexto longo, USD/milhão de tokens) | Entrada | Leitura de cache | Saída |
|---|---|---|---|
| Nível oficial padrão | 4 | 0.20 | 15 |
| Ultrafast promocional | 12 | 0.60 | 45 |
| Ultrafast preço de tabela | 24 | 1.20 | 90 |
Tabela geral da APIYI gpt-6.2-sol (entrada acima de 272 mil) |
3 | Conforme a lista da plataforma | Conforme a lista da plataforma |
Há uma inconsistência numérica aqui que merece uma explicação à parte: a tabela geral de modelos da APIYI apiyi.com define a faixa de 0 a 272 mil tokens de entrada em 2 dólares e, acima de 272 mil, entrada em 3 dólares, enquanto o preço de entrada do contexto longo no nível oficial padrão é 4 dólares. Não junte esses dois números: chamando via APIYI, a conta é feita com os 3 dólares da tabela geral; conectando direto no oficial, a conta é feita com os 4 dólares.
De onde vem a velocidade do GPT-6.2 Sol Ultrafast: limite oficial e registros da comunidade
A questão da velocidade tem hoje dois tipos de informação, com níveis de confiança bem diferentes. Vale a pena tratá-los separadamente.
| Origem | Conteúdo | Natureza | Serve como o seu multiplicador? |
|---|---|---|---|
| Documentação oficial do Codex / API | A velocidade de geração do Ultrafast chega a até 4,5 vezes a velocidade do mesmo modelo no nível padrão (up to 4.5 times) | Declaração de limite máximo oficial | Só como limite superior |
| Artificial Analysis | Cerca de 85 tokens de saída por segundo no mesmo modelo no nível padrão | Benchmark público independente | Só como referência |
| Relato do OrcaRouter em 18/11/2026 | Em uma tarefa, média de cerca de 126 tokens por segundo, com pico de cerca de 252 tokens por segundo | Relato de uma única execução, sem comparação com o nível padrão | Não |
O texto oficial usa “up to”, que significa “até”, sem prometer que toda requisição vai alcançar 4,5 vezes. Na hora de fazer contas, o melhor é colocá-lo na coluna “melhor caso”.
Em 18/11/2026, o OrcaRouter reproduziu o relato de um editor no X sobre uma única tarefa: o Ultrafast teve média de cerca de 126 tokens por segundo, com pico de cerca de 252; o tempo total de execução da tarefa foi de cerca de 27 minutos, dos quais cerca de 14 minutos foram de resposta do modelo. O autor do relato comparou esse número com os 85 tokens por segundo do nível padrão divulgados pelo Artificial Analysis e chegou a cerca de 1,5 vezes. Esse registro representa apenas uma execução, sem repetições e sem uma comparação do mesmo nível padrão na mesma tarefa. Portanto, é só um ponto de dados e não representa o desempenho final desse nível de velocidade.
Esse registro também revela um fato fácil de passar despercebido: dos 27 minutos de tempo total decorrido, a resposta do modelo ocupou apenas cerca de 14 minutos. O nível de velocidade só acelera a etapa de geração do modelo; chamadas de ferramentas, leitura e gravação de arquivos, confirmação humana e outras etapas não ficam mais rápidas por causa disso.
Como calcular o prêmio de velocidade do GPT-6.2 Sol Ultrafast: um algoritmo pronto para aplicar
O algoritmo abaixo evita de propósito qualquer “multiplicador medido por outra pessoa”. O único dado que você precisa fornecer é o tempo que esta tarefa leva no nível padrão.
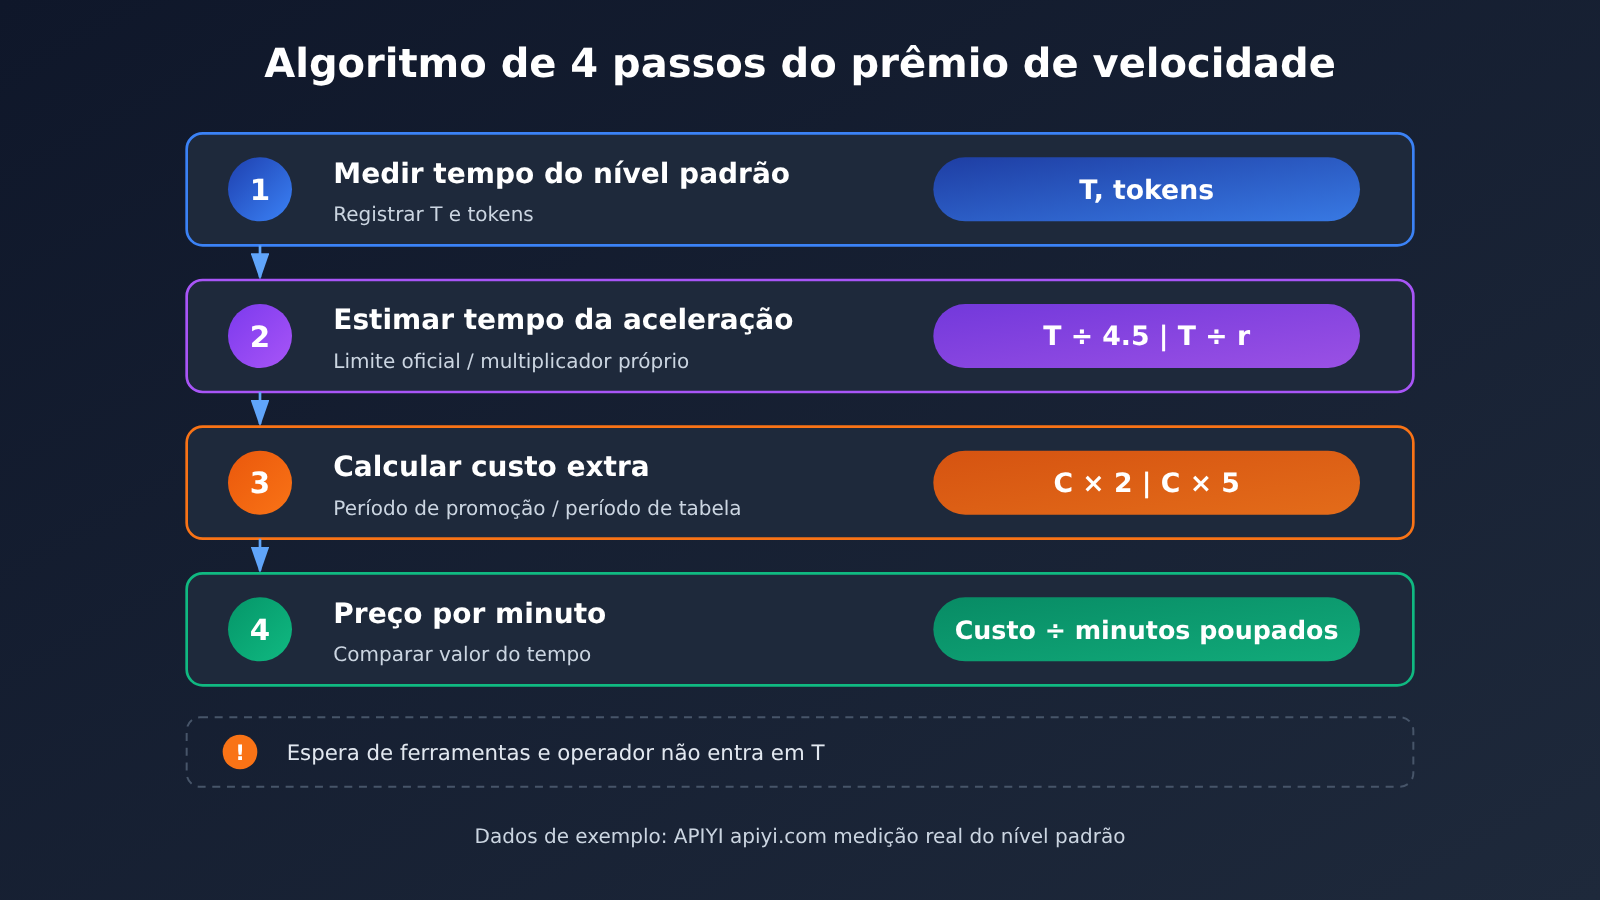
| Etapa | Item de cálculo | Fórmula | Descrição |
|---|---|---|---|
| ① | Tempo de geração no nível padrão T | Meça você mesmo | Conta apenas a geração do modelo, sem o tempo de ferramentas |
| ② | Tempo economizado no melhor cenário | T × (1 − 1/4.5) ≈ 0.78T | Usando o limite oficial |
| ②′ | Tempo economizado no cenário conservador | T × (1 − 1/r) | r é o multiplicador que você definiu, com r ≤ 4.5 |
| ③ | Custo no nível padrão C | entrada × preço unitário + leitura de cache × preço unitário + saída × preço unitário | Escolha a faixa de preço conforme o comprimento do contexto |
| ④ | Custo extra no período promocional | C × 2 | O preço promocional do Ultrafast é 3C |
| ④′ | Custo extra no período de tabela | C × 5 | O preço de tabela do Ultrafast é 6C |
| ⑤ | Preço por minuto economizado | custo extra ÷ minutos economizados | Compare com o valor do seu tempo |
Exemplo de cálculo do GPT-6.2 Sol Ultrafast
A seguir, usamos um conjunto de números hipotéticos para demonstrar o algoritmo — esses números não são resultados de medição de velocidade. Suponha uma tarefa com 200 mil tokens de entrada (contexto curto) e 50 mil tokens de saída, sem acerto de cache; e que a velocidade de saída que você mesmo obteve no nível padrão seja de 80 tokens/segundo.
- Custo do nível padrão C = 0.2 × 2 + 0.05 × 10 = 0.9 dólar.
- Tempo de geração do nível padrão T = 50000 ÷ 80 ≈ 625 segundos, cerca de 10.4 minutos.
- O Ultrafast custa 2.7 dólares no período promocional, um gasto extra de 1.8 dólares; no preço de tabela, custa 5.4 dólares, um gasto extra de 4.5 dólares.
| Múltiplo hipotético r | Tempo de geração | Tempo economizado | Preço por minuto na promoção | Preço por minuto no preço de tabela |
|---|---|---|---|---|
| 4.5 (limite oficial) | cerca de 2.3 minutos | cerca de 8.1 minutos | cerca de 0.22 dólar | cerca de 0.56 dólar |
| 3 | cerca de 3.5 minutos | cerca de 6.9 minutos | cerca de 0.26 dólar | cerca de 0.65 dólar |
| 2 | cerca de 5.2 minutos | cerca de 5.2 minutos | cerca de 0.35 dólar | cerca de 0.87 dólar |
| 1.5 | cerca de 6.9 minutos | cerca de 3.5 minutos | cerca de 0.51 dólar | cerca de 1.29 dólar |
Esta tabela revela dois pontos. Primeiro, quando o múltiplo cai de 4.5 para 1.5, o preço por minuto praticamente dobra — ou seja, a hipótese de múltiplo é mais decisiva do que o próprio preço. Segundo, depois que o preço de tabela entrar em vigor em março de 2027, economizar o mesmo 1 minuto custará cerca de 2.5 vezes mais; as conclusões do período promocional não podem ser simplesmente transportadas para o ano que vem.
💰 Sugestão de conferência de custo: o preço unitário do nível padrão usado no exemplo pode ser comparado diretamente com o preço listado de
gpt-6.2-solna tabela geral do APIYI apiyi.com (entrada 2, leitura de cache 0.1, saída 10). Essa faixa de preços é consistente com o nível padrão oficial de contexto curto e serve como fonte do valor C no algoritmo.
Meça com código o tempo do seu GPT-6.2 Sol no nível padrão
O primeiro passo do algoritmo precisa de um T real. O código abaixo usa saída em streaming para registrar o tempo até o primeiro token e o tempo total de geração, além de ler a contagem de tokens do usage — assim você calcula a velocidade da sua tarefa no nível padrão.
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # endpoint compatível com OpenAI da APIYI
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "把你的真实任务提示词放在这里"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"首 token {first - start:.1f}s,生成 {gen:.1f}s,"
      f"输出 {usage.completion_tokens} tokens,约 {usage.completion_tokens / gen:.0f} tok/s")
Ver o script completo de comparação com service_tier
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # dólares por milhão de tokens, contexto curto
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # forma oficial: o mesmo ID de modelo mais service_tier
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "把你的真实任务提示词放在这里"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"标准档:生成 {t_std:.1f}s,费用约 ${c_std:.3f},返回档位 {s_std}")

for name, r in [("官方上限", 4.5), ("保守假设", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:省 {saved_min:.1f} 分钟,"
          f"促销每分钟 ${c_std * 2 / saved_min:.3f},刊例每分钟 ${c_std * 5 / saved_min:.3f}")

# se quiser medir o nível de velocidade na prática, descomente as linhas abaixo
# e verifique se o campo service_tier retornado é ultrafast
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度档:生成 {t_uf:.1f}s,实际倍数约 {t_std / t_uf:.2f},返回档位 {s_uf}")
Sobre service_tier, vale esclarecer: a tabela geral de modelos do APIYI apiyi.com lista apenas gpt-6.2-sol, não há um modelo ultrafast separado nem o campo service_tier aparece nela; os preços da lista correspondem ao nível padrão. Este artigo apenas verificou a documentação e a tabela de preços, sem enviar solicitações reais, portanto não é possível afirmar como esse parâmetro se comporta ao chamar via https://api.apiyi.com/v1. Se você precisar do nível de velocidade, use como referência o campo de nível retornado na resposta e a fatura; modelo e preço seguem a lista de modelos da plataforma.
🚀 Sugestão para começar: primeiro execute duas ou três vezes suas próprias tarefas reais com o
gpt-6.2-solno nível padrão do APIYI apiyi.com e use a mediana do tempo de geração como T. Essa etapa custa apenas o preço padrão, mas determina a precisão de todos os cálculos seguintes.
Cenários recomendados para GPT-6.2 Sol Ultrafast
A conclusão deve ser tomada por tarefa. A mesma pessoa pode chegar a respostas opostas em tarefas diferentes.
Cenários em que vale a pena ativar o Ultrafast
- Tarefas interativas em que alguém está na frente da tela esperando o resultado: por exemplo, programação em par em tempo real e demonstrações ao vivo. O tempo de espera é diretamente custo de mão de obra; pela fórmula acima, o preço unitário normalmente consegue cobrir esse custo.
- Tarefas em que a geração representa uma proporção alta do tempo total decorrido: se T ocupa a maior parte do tempo total da tarefa, o tempo economizado pode aparecer diretamente no prazo de entrega.
- Tarefas de contexto curto durante promoções: o preço 3x combinado com o preço unitário baixo de contexto curto faz com que o valor absoluto do gasto extra seja pequeno.
Cenários em que é melhor permanecer no nível padrão
- Processamento em lote em segundo plano e tarefas noturnas: ninguém está esperando, então os minutos economizados não têm valor de tempo correspondente.
- Tarefas de Agent com muitas chamadas de ferramentas: como no registro parafraseado acima, de 27 minutos de tempo total decorrido, a resposta do modelo ocupa apenas cerca de 14 minutos; o nível de velocidade só consegue comprimir parte disso.
- Tarefas de contexto longo e saída grande: no período de tabela de preços, o preço unitário de saída para contexto longo chega a 90, e o gasto extra cresce muito rápido.
| Característica da tarefa | Proporção do tempo de geração | Há alguém esperando | Tendência |
|---|---|---|---|
| Codificação interativa e demonstrações ao vivo | Alta | Sim | Calcular primeiro pelo algoritmo; o preço unitário geralmente cobre |
| Agent intensivo em ferramentas | Médio-baixo | Depende | Calcular apenas pela parte de geração; o benefício é diluído |
| Processamento em lote noturno | Alta | Não | Permanecer no nível padrão |
| Contexto longo e saída grande | Alta | Depende | Requer cálculo cuidadoso no período de tabela de preços |
💡 Sugestão de escolha: se um mesmo projeto tiver os dois tipos de tarefa, você pode decidir no código, por tipo de tarefa, se inclui
service_tier, sem precisar habilitar globalmente. Use a mesma chave no APIYI apiyi.com para executar a linha de base no nível padrão e depois decidir qual tipo de tarefa vale a pena continuar testando no nível de velocidade.
Recomendações de decisão para o GPT-6.2 Sol Ultrafast
Vamos organizar o conteúdo anterior em um processo fixo:
- Execute tarefas reais com o nível padrão, anote o tempo de geração T e o consumo de tokens, sem usar os números de velocidade de outras pessoas.
- Calcule o melhor cenário usando o limite oficial de 4,5, depois escolha um multiplicador conservador r que você considere razoável e calcule os dois casos.
- Calcule o custo adicional separadamente com base no multiplicador promocional de 3 e no multiplicador de tabela de 6, obtendo dois “preços por minuto”.
- Compare com o valor do seu tempo: só as tarefas que continuam valendo a pena sob o multiplicador conservador é que merecem ser ativadas.
- Antes de o preço de tabela entrar em vigor em 2027-03-01, recalcule tudo com os novos preços.
O ponto-chave deste processo é a etapa 2. O “até 4,5 vezes” oficial pode servir como limite superior, enquanto aquele relato de aproximadamente 126 tokens/segundo em 2026-11-18 é apenas um único ponto de dados — nenhum dos dois é o multiplicador real da sua tarefa. O multiplicador real só pode ser obtido por meio de testes comparativos nas suas próprias tarefas.
Perguntas frequentes (FAQ)
Q1: O GPT-6.2 Sol Ultrafast é um modelo novo?
Não. De acordo com a documentação oficial da API, o Ultrafast é um nível de serviço; o `model` na requisição continua sendo `gpt-6.2-sol`, com o acréscimo de `service_tier` definido como `ultrafast` — o modelo em si não muda.
Q2: Ativar o Ultrafast garante alcançar 4,5 vezes?
Não necessariamente. O texto oficial diz “up to 4.5 times”, o que é uma afirmação de limite superior. No cálculo, você deve preparar ao mesmo tempo um multiplicador conservador mais baixo e usar seu próprio teste comparativo como referência.
Q3: Quando termina o preço promocional do GPT-6.2 Sol Ultrafast?
O preço promocional oficial vai até 2027-02-28 (horário do Pacífico), com valor de 3 vezes o preço padrão; a partir de 2027-03-01 entra em vigor o preço de tabela, de 6 vezes o preço padrão. Tanto o contexto curto quanto o contexto longo seguem essa relação de multiplicador.
Q4: Aquele registro de cerca de 126 tokens/segundo pode ser usado como referência?
Pode servir como um ponto de dados, mas não como conclusão. É um relato do OrcaRouter em 2026-11-18 sobre uma tarefa, sem execuções repetidas e sem comparação com o nível padrão na mesma tarefa; a afirmação de cerca de 1,5 vez no texto foi obtida comparando com os 85 tokens/segundo do nível padrão divulgados pela Artificial Analysis.
Q5: A qual nível corresponde o preço do gpt-6.2-sol visto na APIYI?
É o nível padrão. Na tabela geral do APIYI apiyi.com, o preço de `gpt-6.2-sol` é entrada 2, leitura de cache 0,1 e saída 10, igual ao nível padrão oficial de contexto curto, com suporte aos endpoints responses e chat. A tabela geral não tem um modelo ultrafast separado nem menciona `service_tier`.
Q6: Quando se ultrapassa 272 mil tokens de entrada, quanto o nível padrão cobra?
Os números das duas fontes são diferentes e precisam ser calculados separadamente: a tabela geral do APIYI informa que acima de 272 mil tokens de entrada o valor é 3 dólares, enquanto o nível padrão oficial de contexto longo tem entrada de 4 dólares. Ao chamar via https://api.apiyi.com/v1, o cálculo segue a lista de modelos da plataforma; na conexão direta com o oficial, o cálculo é de 4 dólares.
GPT-6.2 Sol Ultrafast — Principais pontos sobre o prêmio de velocidade (Key Takeaways)
- Ultrafast é um nível de serviço: basta usar o mesmo ID de modelo
gpt-6.2-solcomservice_tier, e a capacidade do modelo não muda. - 4,5x é o teto oficial: o texto original diz “up to”, então na hora de calcular não dá para tratar esse número como um multiplicador que sempre se atinge.
- O preço tem duas fases: no período promocional é 3x o preço padrão; a partir de 2027-03-01 o preço de tabela passa a 6x.
- Só o tempo de geração fica mais rápido: tempos que não são de geração, como chamadas de ferramentas, não entram na parte que pode ser economizada.
- Um único relato não representa o resultado: o registro de cerca de 126 tokens/s em 2026-11-18 não tem comparação com o nível padrão.
- Meça primeiro o seu próprio nível padrão: dá para usar o nível padrão
gpt-6.2-solna APIYI apiyi.com para medir o T e depois aplicar na fórmula.
Resumo
O cálculo do prêmio de velocidade do GPT-6.2 Sol Ultrafast pode ser resumido em três pontos:
- Use dois valores para a velocidade: o teto e um valor conservador: o máximo oficial de 4,5x fica no cenário mais otimista, e o multiplicador conservador que você definir fica na outra coluna.
- Calcule o preço separadamente: no período promocional o gasto extra é 2x o custo padrão, e no preço de tabela é 5x — as duas conclusões não podem ser misturadas.
- A conclusão depende da tarefa: só vale a pena ativar o nível de velocidade se o preço por minuto economizado ficar abaixo do valor do seu tempo.
A resposta para a pergunta do título depende dos dados da sua própria tarefa. A sugestão é medir primeiro a linha de base com o nível padrão na APIYI apiyi.com e depois colocar os números na tabela de cálculo deste artigo.
📚 Referências
-
Explicação dos níveis de velocidade do OpenAI Codex: a afirmação oficial de até 4,5 vezes no Ultrafast
- Link:
developers.openai.com/codex/agent-configuration/speed - Descrição: confirma o texto original “up to 4.5 times” e os modelos aplicáveis
- Link:
-
Guia de API do modo Ultrafast da OpenAI: uso de
service_tiere modelos suportados- Link:
developers.openai.com/api/docs/guides/ultrafast-mode - Descrição: confirma que o Ultrafast é um nível de serviço e que o
modelnão muda
- Link:
-
Página de preços da API OpenAI: preços promocionais e de tabela dos níveis padrão, Fast e Ultrafast
- Link:
developers.openai.com/api/docs/pricing - Descrição: preços completos para contexto curto e contexto longo
- Link:
-
Registro de paráfrase do OrcaRouter: dados de uma única tarefa Ultrafast em 2026-11-18
- Link:
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - Descrição: uma paráfrase de caso único, sem grupo de controle, que serve apenas como um ponto de dados
- Link:
-
Tabela geral de modelos do APIYI: preço de tabela e faixas do
gpt-6.2-solno nível padrão- Link:
docs.apiyi.com/models.md - Descrição: verificação do preço unitário do nível padrão e do preço acima de 272 mil tokens de entrada
- Link:
Autor: equipe técnica do APIYI
Contato técnico: se você tiver dúvidas sobre cálculos ou integração, fale conosco pela página inicial do site oficial do APIYI. Para mais materiais, acesse o centro de documentação em docs.apiyi.com


