
요약: 이 글은 동일한 워크로드를 사용해 Prompt Caching의 캐시 쓰기, 캐시 읽기, 동적 입력, 출력 네 부분 비용을 계산하고, 적중률과 TTL, 호출 주기가 실제 절감액에 어떤 영향을 미치는지 설명해요.
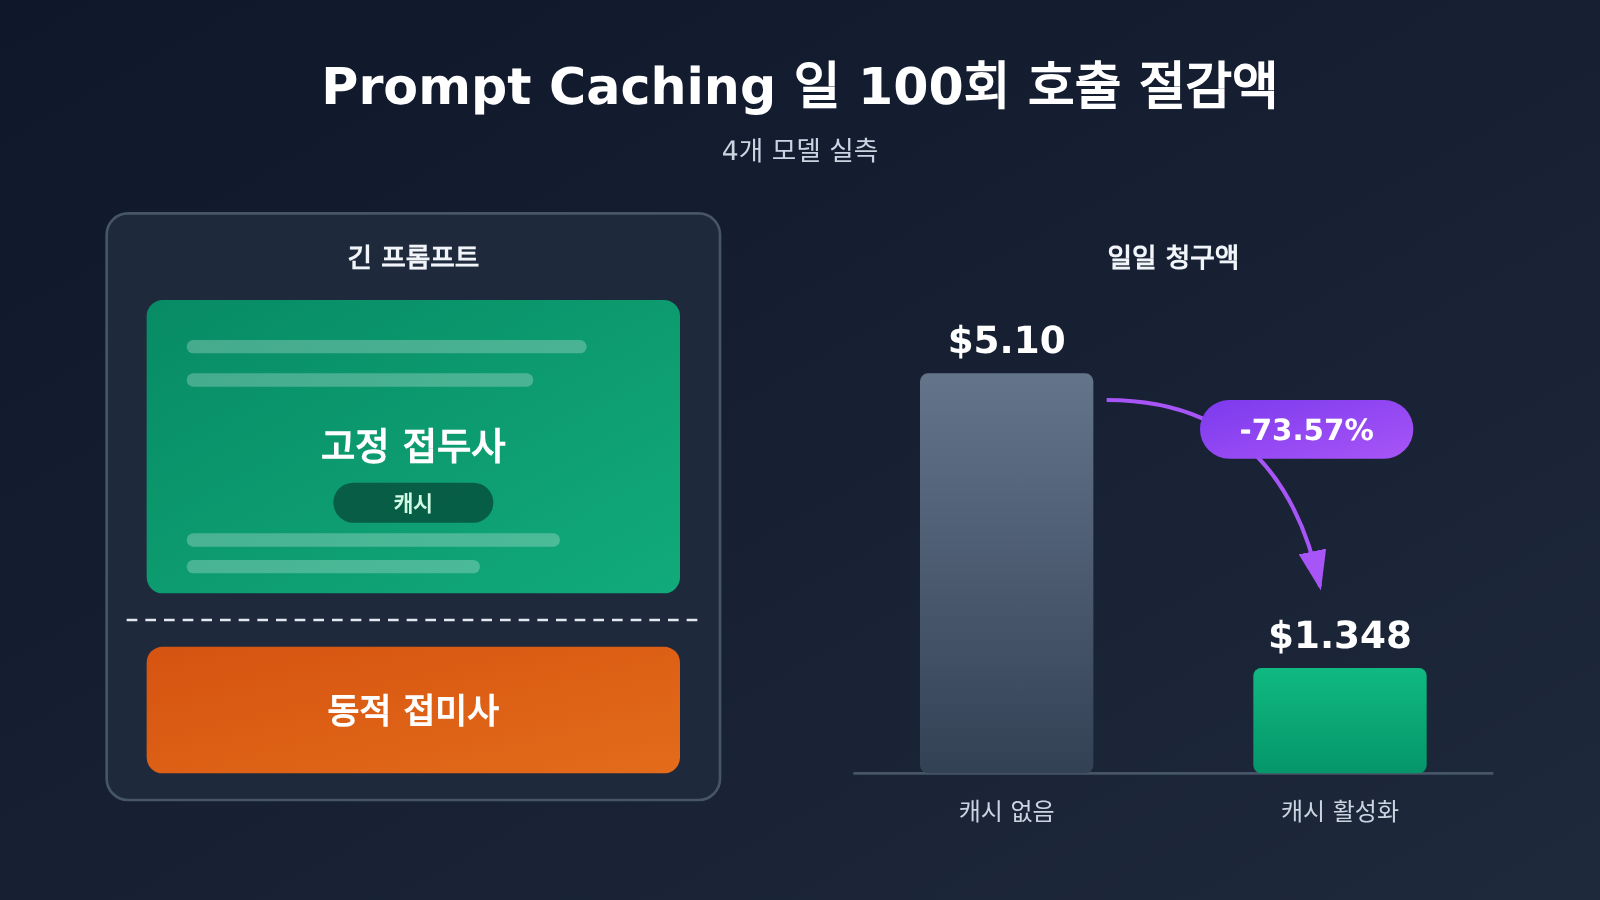
결론: 이 글에서 설정한 워크로드는 매 호출마다 고정 프리픽스 20K Token, 동적 입력 500 Token, 출력 1K Token이며, 하루 100회 호출해요. “첫 호출에서 쓰기, 이후 99회 전부 적중”이라는 이상적인 조건에서 GPT-6.1 Sol의 하루 전체 청구 금액은 $5.10에서 $1.348로 떨어져 약 73.57% 절감돼요. Claude Sonnet 5.5도 결과가 같고, GPT-6 Astra는 $25.50에서 $7.73으로(약 69.69% 절감), Gemini 3.8 Flash는 $1.9125에서 $0.576으로(약 69.88% 절감) 내려가요. 고정 프리픽스 항목만 보면 절감 비율은 88%에서 94% 사이예요. 전체 청구 금액의 절감 폭이 더 낮은 이유는 출력 Token과 동적 입력이 캐시 할인을 받지 못하기 때문이에요. 위 숫자는 공식 단가로 계산한 예산 시뮬레이션이며 실제 청구서가 아니에요. 가격은 모두 표준 숏 컨텍스트 요율을 적용했고, 확인 날짜는 2026-11-13이에요.
내용 미리보기: 1부에서는 캐시가 요청 중 어느 구간을 재사용하는지, 그리고 그것이 청구서의 어느 부분에 영향을 주는지 설명해요. 2부에서는 OpenAI, Claude, Gemini 세 곳의 캐시 규칙을 비교해요. 3부에서는 네 모델의 계산 공식을 항목별로 나열해 독자가 직접 다시 계산할 수 있게 해요. 4부에서는 TTL과 호출 주기를 계산해 적중률이 왜 떨어지는지 보여줘요. 5부에서는 프롬프트 구성 방식, TTL 선택, 코드 예시, 적중률 모니터링 방법을 제시해요. 6부에서는 대량 AI 생산 시나리오에서 Token 비용을 통제하는 판단 기준을 논의해요.
먼저 알아두기: Prompt Caching 용어 정리
| 용어 | 설명 |
|---|---|
| Token | 모델이 텍스트를 측정하는 단위예요. API는 Token 수량으로 과금하며, 단가는 보통 ‘달러 / 백만 Token(MTok)’으로 표시해요 |
| Prompt Caching | 이미 처리한 프롬프트 접두사를 캐시해 두고, 이후 요청에서 같은 접두사를 만나면 그대로 재사용해 중복 처리 비용을 줄이는 방식이에요 |
| 안정 접두사 | 여러 요청에서 글자 그대로 동일한 프롬프트 시작 부분이에요. 예를 들어 역할 설명, 작성 규칙, 예시 문장, 지식 베이스 등이 해당해요 |
| 동적 입력 | 요청마다 달라지는 내용이에요. 예를 들어 그날의 뉴스 자료, 글 제목, 사용자 요구 사항 등이 있어요 |
| 캐시 쓰기 | 안정 접두사를 처음 처리해 캐시에 저장하는 것으로, 단가가 보통 일반 입력보다 높아요 |
| 캐시 읽기 | 이후 요청이 기존 캐시를 적중하면 일반 입력보다 훨씬 낮은 단가로 과금돼요 |
| 캐시 적중 | 새 요청의 접두사가 사용 가능한 캐시와 Token 단위로 일치해 재사용에 성공한 상태예요 |
| TTL | 캐시가 유지되는 시간이에요. OpenAI는 이를 최소 유지 시간으로 정의하며, 정확한 삭제 시점을 보장하지 않아요 |
| 캐시 중단점 | 프롬프트에서 ‘캐시 가능한 접두사는 여기까지’라는 위치를 표시하는 지점이에요 |
| 암시적 / 명시적 캐시 | 암시적 캐시는 시스템이 자동으로 판단해 재사용하고, 명시적 캐시는 개발자가 직접 중단점을 선언하거나 캐시 객체를 생성하는 방식이에요 |
| 전체 작업 비용 | 한 번 호출의 입력, 출력 및 해당되는 도구 비용을 모두 합친 것으로, 절감 비율을 측정하는 실제 분모예요 |
1. Prompt Caching으로 비용 절약, 구체적으로 어디서 절약될까요?
1.1 Prompt Caching이 재사용하는 것
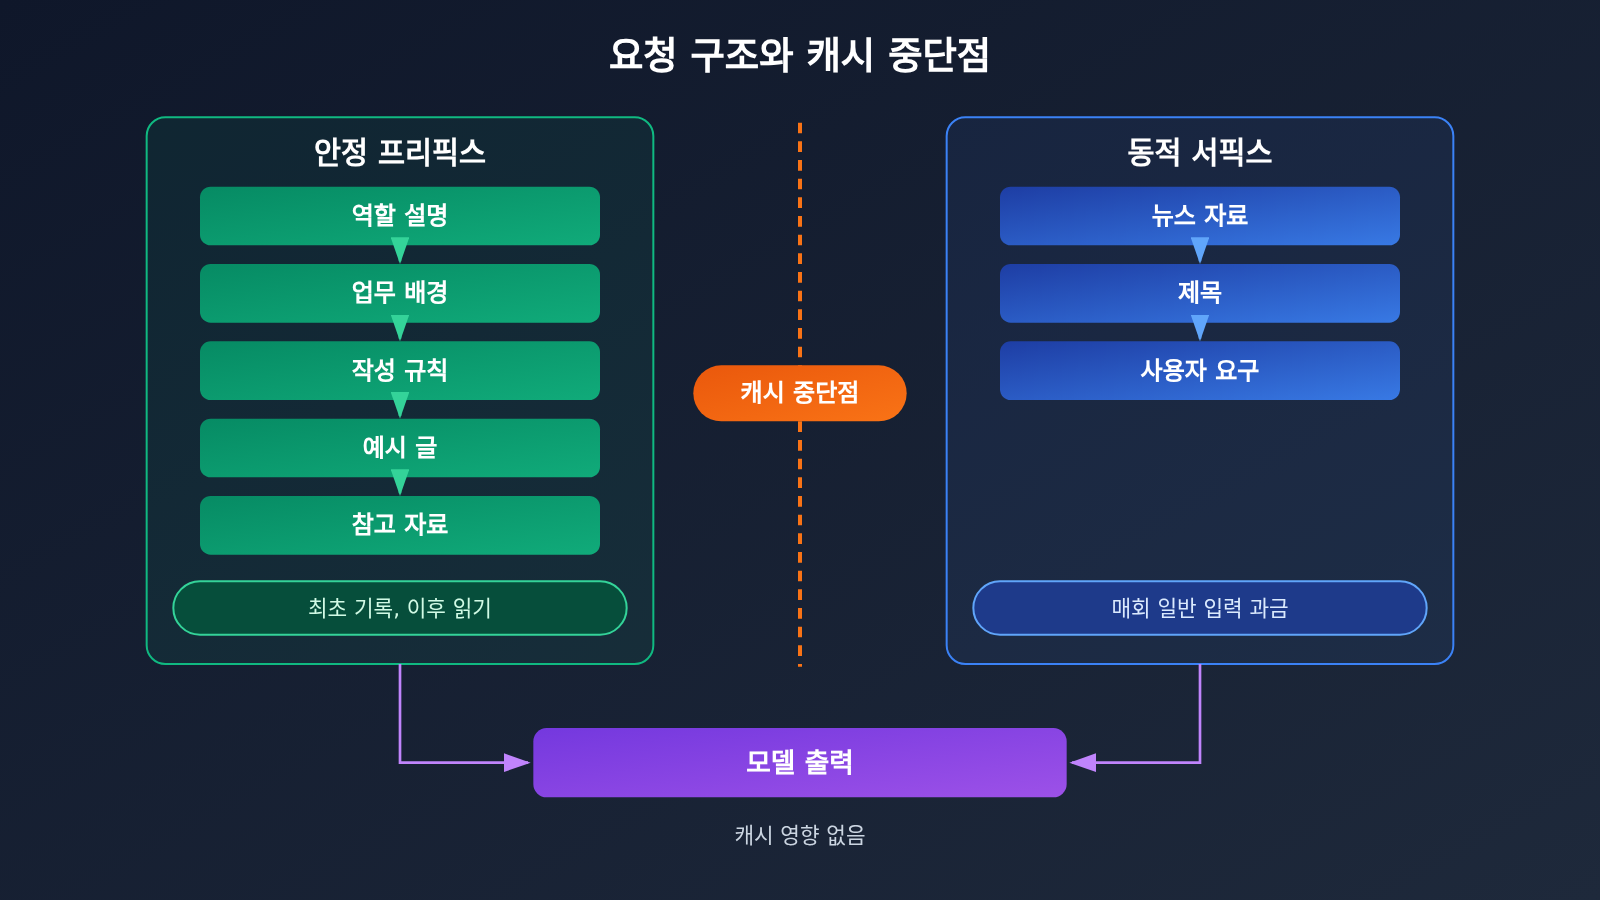
AI 글쓰기 플랫폼을 예로 들어볼게요. 글 한 편을 생성할 때마다 요청은 두 부분으로 구성돼요. 첫 번째는 고정 콘텐츠로, 역할 설명, 업무 배경, 작성 규칙, 예시 글, 용어와 참고 자료가 여기에 해당해요. 두 번째는 동적 콘텐츠로, 당일 뉴스 자료, 글 제목, 사용자의 구체적인 요구사항이 들어가요.
Prompt Caching이 재사용하는 것은 첫 번째 부분, 즉 토큰 단위로 완전히 동일한 접두사예요. 캐시 매칭은 토큰 시퀀스가 완전히 일치해야 하며, 의미가 비슷하다고 해서 적중되는 건 아니에요. 표현 하나를 바꾸거나, 문단 순서를 조정하거나, 도구 정의를 다시 배열하면 접두사가 새로운 콘텐츠가 되어 캐시가 무효화될 수 있어요.
그래서 캐시 최적화에는 한 가지 기본 원칙이 있어요. 안정적인 콘텐츠는 맨 앞에, 변화하는 콘텐츠는 뒤에 배치하는 것.
1.2 Prompt Caching이 절약하는 것은 어느 부분의 비용일까요?
한 번 호출의 청구서는 다섯 항목으로 나눌 수 있는데, 이 중 고정 접두사 비용만 캐시에 의해 달라져요:
| 비용 항목 | 캐시 없을 때 | 캐시 활성화 후 |
|---|---|---|
| 고정 접두사 | 매번 일반 입력 가격으로 과금 | 최초에는 쓰기 가격, 적중 후에는 읽기 가격 |
| 동적 입력 | 일반 입력 가격 | 일반 입력 가격, 변동 없음 |
| 모델 출력 | 출력 가격 | 출력 가격, 변동 없음 |
| 도구 비용 | 도구 규칙에 따름 | 도구 규칙에 따름, 변동 없음 |
| 명시적 캐시 저장(Gemini) | 없음 | 저장 시간에 따라 별도 계산 |
이 표가 보여주는 핵심 차이는 고정 접두사 절감률과 전체 청구서 절감률이 서로 다른 지표라는 점이에요. 전자는 캐시된 부분의 감소폭만 측정하고, 후자는 전체 청구서의 감소폭을 측정해요. 출력이 길수록 후자는 낮아져요.
2 GPT, Claude, Gemini의 프롬프트 캐싱 규칙은 어떤 차이가 있나요?
2.1 OpenAI 프롬프트 캐싱: 30분과 12시간
OpenAI 문서는 GPT-5.6 및 이후 모델에 대해 이렇게 규정하고 있어요. 캐시 접두사의 최소 길이는 일반적으로 1,024개의 가시 입력 토큰이며, 암시적(implicit) 모드와 명시적(explicit) 모드 두 가지를 지원해요. 명시적 모드에서는 개발자가 적절한 메시지 콘텐츠 블록에 prompt_cache_breakpoint를 표시해 캐시 접두사의 경계를 분명히 지정해요.
TTL은 기본 30분이고, Responses API에서는 prompt_cache_options.ttl = "12h"로 최소 12시간의 유지 시간을 선택할 수 있어요. 과금은 쓰기와 읽기로 나뉘어요.
- 30분 쓰기: 일반 입력의 1.25배
- 12시간 쓰기: 일반 입력의 2.5배
- 캐시 읽기: 대부분의 새 모델은 일반 입력의 0.1배, GPT-6.1 Sol과 GPT-6.1 Terra는 0.05배
prompt_cache_key는 서로 다른 사용자나 워크스페이스의 캐시 청구를 구분하는 데 사용할 수 있어요. GPT-5.6 및 이후 모델에서는 캐시 라우팅이 이미 공식적으로 자동 관리되고 있어요.
2.2 Claude 프롬프트 캐싱: 5분과 1시간
Claude는 cache_control을 통해 자동 또는 명시적 캐싱을 지원해요. 기본 유효 시간은 5분이고, 캐시가 적중할 때마다 유효 시간이 갱신돼요. 5분은 캐시 쓰기 또는 읽기 요청이 시작되는 시점부터 계산하며, 응답을 생성하는 데 걸리는 시간도 여기에 포함돼요. 그래서 출력이 긴 작업에서는 실제로 사용할 수 있는 간격이 5분보다 짧아져요.
과금 배수는 5분 쓰기 1.25배, 1시간 쓰기 2배, 일반 읽기 0.1배예요. Claude Sonnet 5.5와 Claude Opus 5.5는 읽기 요율이 0.05배로 낮아졌어요. Sonnet 5.5의 표준 단가는 입력 $2, 5분 쓰기 $2.50, 1시간 쓰기 $4, 읽기 $0.10, 출력 $10이에요(모두 미국 달러 / 백만 Token 기준).
2.3 Gemini 컨텍스트 캐싱: 암시적과 명시적
Gemini 2.5 및 최신 모델은 기본적으로 암시적 캐싱이 활성화되어 있고, 별도 설정이 필요 없어요. 최소 입력 요구량은 모델마다 달라요. Gemini 3.8 Flash는 4,096 Token, Gemini 2.5 Flash와 2.5 Pro는 2,048 Token이에요. Google은 함께 쓰는 콘텐츠를 프롬프트 앞부분에 배치하고, 비교적 짧은 시간 안에 동일한 접두사를 재사용할 것을 권장해요.
명시적 캐싱은 개발자가 직접 캐시 객체를 생성하고 유지 시간을 설정해야 해요. 비용은 캐시 콘텐츠, 이후 읽기, 저장 기간의 세 부분으로 구성돼요. Gemini Interactions API는 현재 암시적 캐싱만 지원하며, 명시적 캐시 객체가 필요할 때는 generateContent API를 사용해야 해요.
Gemini 3.8 Flash의 2026년 12월 31일까지 가격은 입력 $0.75, 출력 $3.75, 캐시 읽기 $0.075, 명시적 캐시 저장 $0.50 / 백만 Token / 시간이에요. 공식적으로는 2027년 1월 1일부터 $1.50, $7.50, $0.15, $1.00으로 조정할 계획이에요. 네 항목의 가격이 같은 비율로 두 배가 되기 때문에, 아래에서 계산하는 절감 비율은 그대로이고 절대 금액만 두 배가 돼요.
2.4 세 공급자의 프롬프트 캐싱 규칙 비교
| 구분 | OpenAI | Claude | Gemini |
|---|---|---|---|
| 캐싱 방식 | 암시적 / 명시적 브레이크포인트 | cache_control 자동 / 명시적 |
암시적(기본값) / 명시적 캐시 객체 |
| 기본 TTL | 30분(최소 유지 시간) | 5분, 적중 시 갱신 | 암시적은 시스템이 관리, 명시적은 기간 직접 설정 |
| 긴 TTL 옵션 | 12시간(Responses API) | 1시간 | 명시적 캐시 직접 설정 |
| 쓰기 요율 | 30분: 1.25배, 12시간: 2.5배 | 5분: 1.25배, 1시간: 2배 | 암시적 첫 입력은 일반 입력으로 계산 |
| 읽기 요율 | 0.1배(Sol / Terra는 0.05배) | 0.1배(Sonnet / Opus 5.5는 0.05배) | 3.8 Flash: $0.075 / MTok |
| 추가 비용 | 저장 비용 없음 | 저장 비용 없음 | 명시적 캐시는 시간당 저장 비용 부과 |
| 최소 프리픽스 | 일반적으로 1,024 토큰 | 공식 문서 기준 | 3.8 Flash: 4,096 토큰 |
3. 하루 100번 호출하면 프롬프트 캐싱으로 과연 얼마나 아낄 수 있을까?
3.1 계산 조건 통일
아래 내용은 공식 단가를 기준으로 한 이론적 계산일 뿐, 실제 사용자 청구서는 아니에요. 공통 가정은 다음과 같아요.
- 매 호출마다 고정 프리픽스 20,000 Token, 동적 입력 500 Token, 출력 1,000 Token
- 하루 100회 호출, 항상 같은 모델만 사용
- 동적 콘텐츠는 전부 안정적인 프리픽스 뒤에 위치
- 캐시 시나리오: 첫 호출에서 쓰기, 이후 99회는 완전 히트. 모든 호출이 TTL 안에서 끝나거나, 히트 때마다 유효기간이 계속 갱신됨
- 서드파티 할증, 일괄 할인, 도구 비용은 고려하지 않음
- 20K 프리픽스는 GPT-6 Astra가 272K Token을 넘길 때 적용되는 롱 컨텍스트 추가 과금을 유발하지 않음
계산식은 다음과 같이 통일했어요.
항목별 비용 = Token 수 × 호출 횟수 ÷ 1,000,000 × 단가(달러 / MTok)
캐시 적용 후 프리픽스 비용 = 20,000 × 1 ÷ 1,000,000 × 쓰기 단가 + 20,000 × 99 ÷ 1,000,000 × 읽기 단가
3.2 GPT-6 Astra의 전체 계산식
GPT-6 Astra 단가: 일반 입력 $10, 출력 $50, 30분 쓰기 $12.50, 캐시 읽기 $1.
캐시 미사용:
- 고정 프리픽스: 20,000 × 100 ÷ 1,000,000 × $10 = $20
- 동적 입력: 500 × 100 ÷ 1,000,000 × $10 = $0.50
- 출력: 1,000 × 100 ÷ 1,000,000 × $50 = $5
- 하루 합계: $25.50
30분 캐시:
- 최초 쓰기: 20,000 ÷ 1,000,000 × $12.50 = $0.25
- 99회 읽기: 20,000 × 99 ÷ 1,000,000 × $1 = $1.98
- 동적 입력: $0.50, 출력: $5
- 하루 합계: $7.73
전체 청구서에서 $17.77, 약 69.69%를 아끼는 셈이에요. 고정 프리픽스 비용은 $20에서 $2.23으로 떨어져 약 88.85% 절감됩니다.
3.3 GPT-6.1 Sol, Claude Sonnet 5.5, Gemini 3.8 Flash
GPT-6.1 Sol(입력 $2, 출력 $10, 30분 쓰기 $2.50, 읽기 $0.10):
- 캐시 없음: 프리픽스 $4 + 동적 입력 $0.10 + 출력 $1 = $5.10
- 캐시 적용 후: 쓰기 $0.05 + 읽기 $0.198 + 동적 입력 $0.10 + 출력 $1 = $1.348
- $3.752 절감, 약 73.57%; 프리픽스가 $4에서 $0.248로 떨어져 약 93.8% 절감
Claude Sonnet 5.5(5분 캐시)의 단가는 GPT-6.1 Sol과 같고, 계산 과정과 결과도 동일해요. $5.10에서 $1.348로 줄어들죠. 단, 호출 간격이 5분 유효기간을 지속적으로 유지할 수 있어야 한다는 조건이 있어요.
Gemini 3.8 Flash(암시적 캐시, 첫 번째는 일반 입력 $0.75로 계산):
- 캐시 없음: 프리픽스 $1.50 + 동적 입력 $0.0375 + 출력 $0.375 = $1.9125
- 캐시 적용 후: 첫 프리픽스 $0.015 + 99회 읽기 $0.1485 + 동적 입력 $0.0375 + 출력 $0.375 = $0.576
- $1.3365 절감, 약 69.88%; 프리픽스가 $1.50에서 $0.1635로 떨어져 약 89.1% 절감
- 이 결과는 암시적 캐시가 전부 적중했다고 가정한 값이며, 명시적 캐시 저장 비용은 포함하지 않았어요.
3.4 프롬프트 캐싱의 절감 비율과 절감 금액의 차이
| 모델 | 캐시 없음 / 일 | 캐시 후 / 일 | 일일 절감 | 30일 절감(외삽) | 프리픽스 절감률 | 전체 청구서 절감률 |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
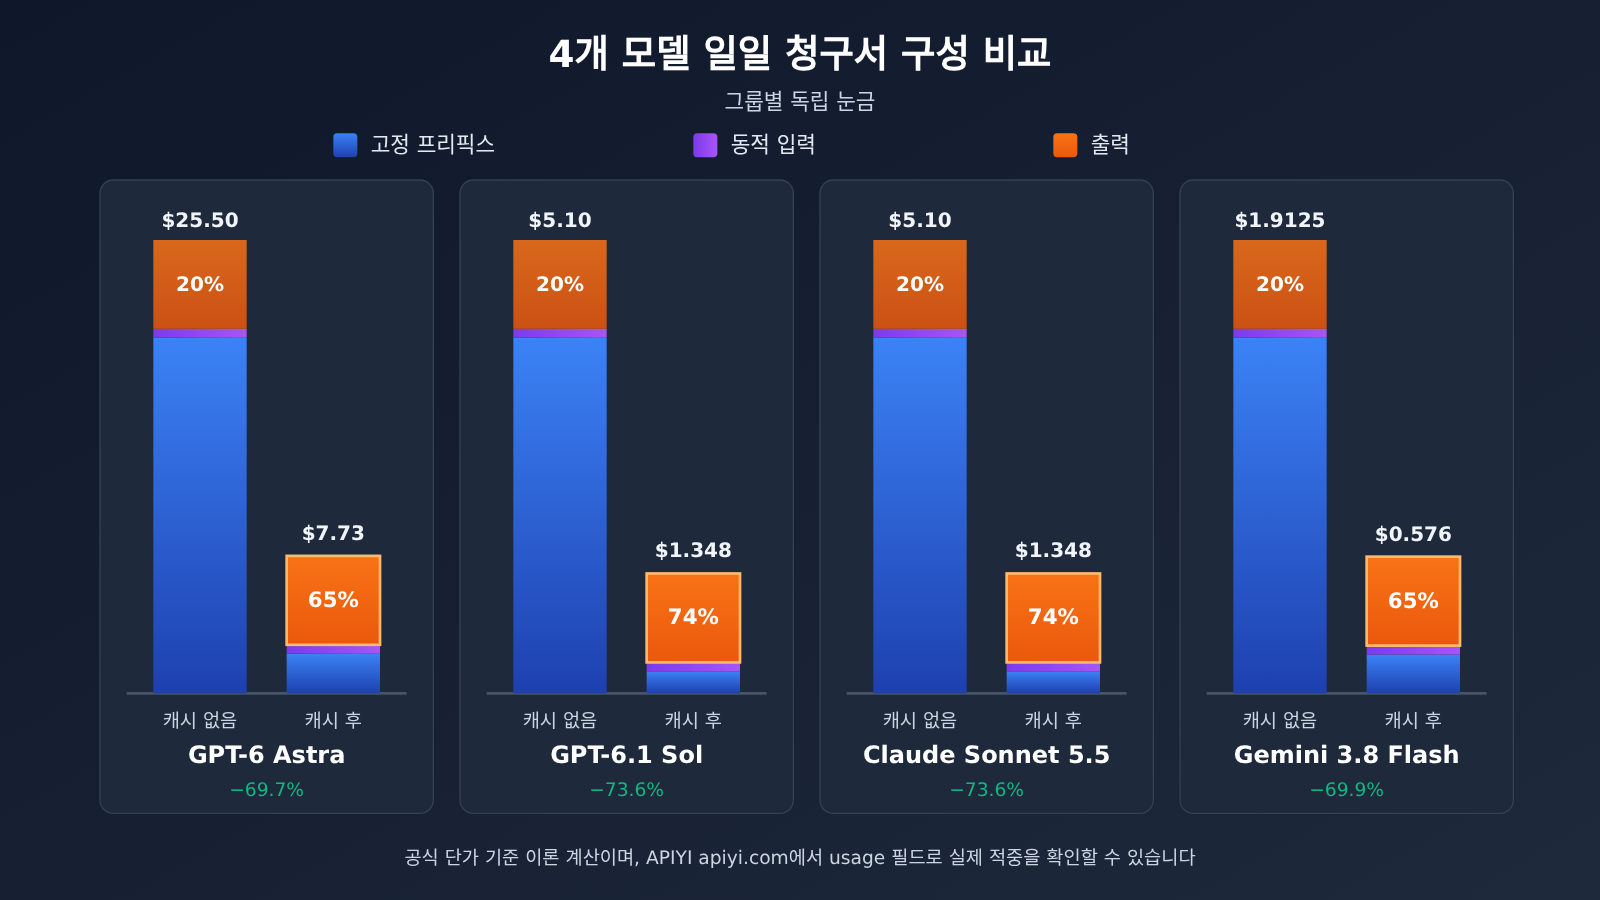
표에서 두 가지를 읽어낼 수 있어요:
- 비율은 읽기 할인에서 결정돼요. GPT-6.1 Sol과 Claude Sonnet 5.5의 읽기 가격은 일반 입력의 0.05배로, 프리픽스 절감률이 93.8%에 달해 0.1배 읽기인 Astra와 Gemini보다 높아요.
- 금액은 단가 기저에서 결정돼요. Astra는 절감 비율이 가장 낮지만 하루 $17.77을 절감해서 Gemini 3.8 Flash의 13배가 넘어요. 단가가 높은 모델일수록 캐싱을 켰을 때 절대적 이득이 커져요.
캐시를 켜면 GPT-6 Astra 청구서에서 출력이 차지하는 비중이 약 20%에서 약 65%로 올라가요($5 ÷ $7.73). 이때는 추가로 원가를 낮추는 초점이 출력 길이를 제어하는 쪽으로 옮겨가요. 네 모델이 같은 Token 수를 사용한 것은 비교를 편하게 하기 위한 것일 뿐이라는 점은 짚어둘게요. 같은 작업을 완료할 때 각 모델의 실제 출력 길이와 정확도는 서로 달라요.
💡 선택 가이드: 비율이 비슷하다면 일일 절대 절감 금액과 작업 품질의 균형을 먼저 보세요. APIYI apiyi.com에서 같은 템플릿으로 몇 개 후보 모델을 각각 호출해 실제 출력 길이와 캐시 Token을 기록한 뒤, 위 공식에 대입해 월 예산을 추정해보는 걸 권해요.
4 매일 같은 프롬프트를 반복하는데도 Prompt Caching 청구서가 여전히 비쌀 수 있는 이유
4.1 TTL과 호출 빈도가 적중률을 결정해요
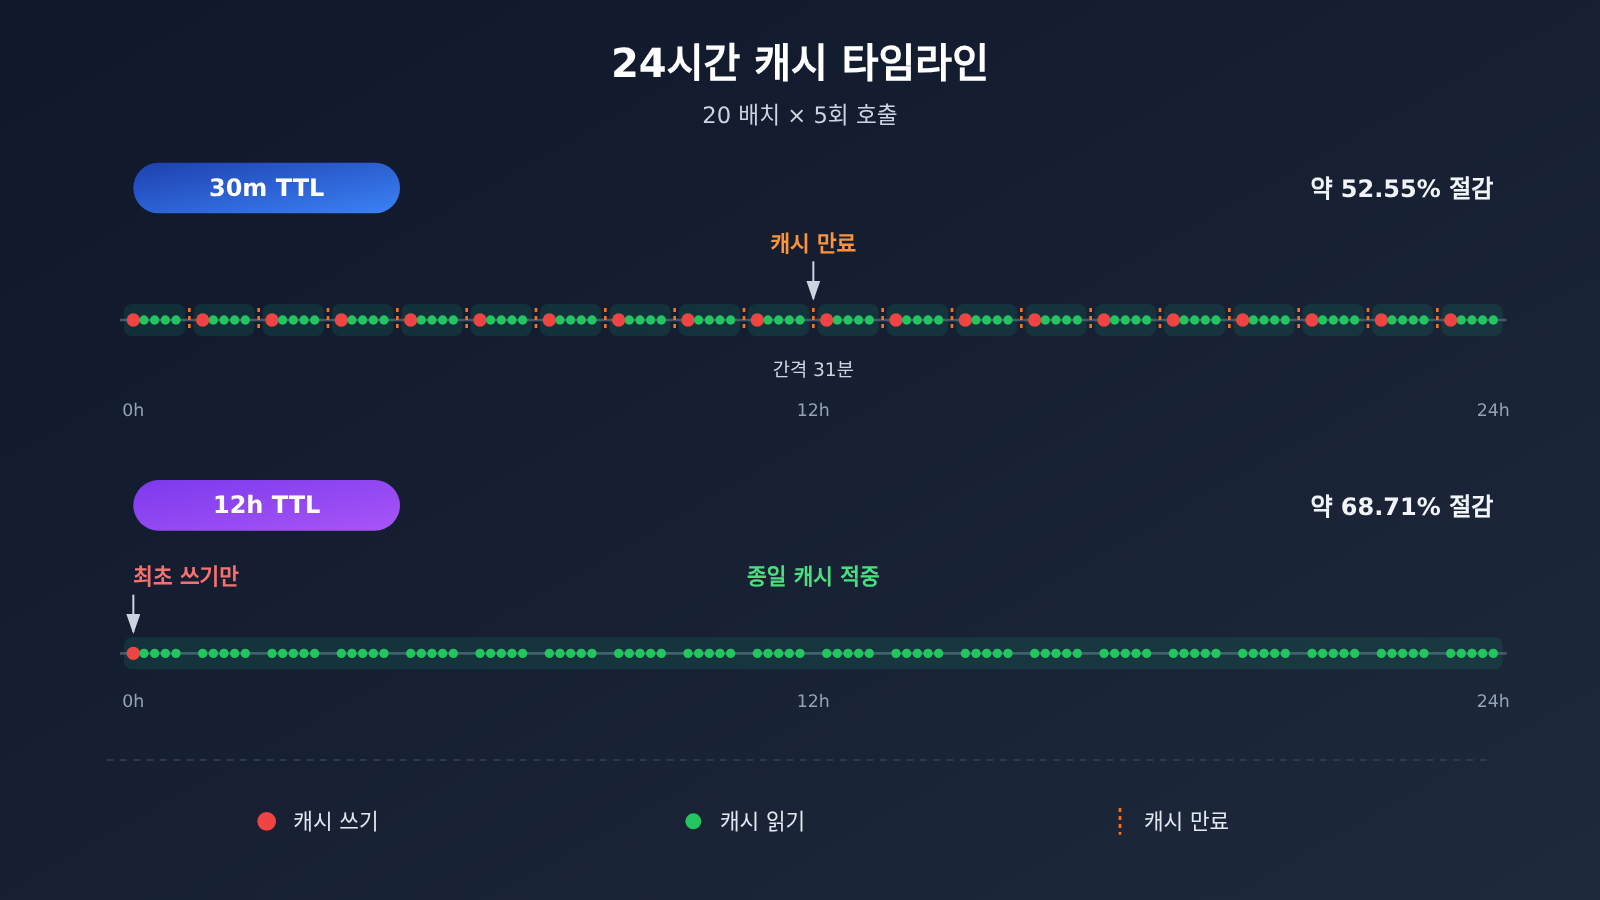
매일 100번 호출한다고 해서 한 번 써두면 하루 종일 커버되는 건 아니에요. 아래에서는 GPT-6 Astra를 예로 들어볼게요. 하루를 20개 배치로 나누고, 각 배치는 5회 연속 호출하며, 두 배치 사이 간격은 31분이에요.
| 시나리오 | 쓰기 횟수와 비용 | 읽기 횟수와 비용 | 프리픽스 비용 | 동적 입력과 출력 추가 | 일일 합계 | 절감률 |
|---|---|---|---|---|---|---|
| 캐시 없음 | — | — | $20 | $5.50 | $25.50 | — |
| A: 30분 캐시 | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | 약 52.55% |
| B: 12시간 캐시(동일 윈도우 내) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | 약 68.71% |
시나리오 A에서는 배치 간격이 30분을 넘어서 매 배치마다 다시 써야 하고, 절감률은 이상적인 69.69%에서 52.55%로 떨어져요. 시나리오 B는 한 번 쓰는 가격이 30분 캐시의 두 배지만 하루에 한 번만 쓰기 때문에 분산 호출에는 더 유리해요. 12시간方案은 같은 윈도우만 커버하고, 다음 날 같은 캐시를 재사용할 수 있다는 보장은 없어요. 하루에 한두 번만 호출하는 작업이라면 동일한 프롬프트만으로는 날짜를 넘기는 캐시를 만들 수 없어요.
각 TTL의 손익분기점은 안정 프리픽스만 따져서, 일반 입력을 1배로 계산하면 이렇게 돼요:
| 方案 | 쓰기 배수 | 읽기 배수 | 쓰기 1 + 읽기 1 vs 캐시 없음 2회 | 쓰기 1 + 읽기 2 vs 캐시 없음 3회 | 손익분기점 도달에 필요한 유효 읽기 |
|---|---|---|---|---|---|
| OpenAI 30분 | 1.25 | 0.1 | 1.35 < 2 | — | 1회 |
| OpenAI 12시간 | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | 2회 |
| Claude Sonnet 5.5 · 5분 | 1.25 | 0.05 | 1.30 < 2 | — | 1회 |
| Claude Sonnet 5.5 · 1시간 | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | 2회 |
결론은 아주 명확해요. 짧은 TTL은 한 번만 적중해도 본전을 뽑고, 긴 TTL은 유효 기간 안에 최소 두 번 적중해야 본전을 뽑아요.
4.2 캐시 중단점과 프롬프트 순서
가장 흔한 실패 원인은 안정적인 프리픽스가 바뀌는 것이에요. 타임스탬프, 사용자 ID, 작업 제목, 실시간 자료를 프롬프트 맨 앞에 두면 요청마다 프리픽스가 새로운 내용으로 바뀌어서 캐시가 절대 적중할 수 없어요.
OpenAI의 암시적 모드에서는 첫 요청이 동적 콘텐츠까지 캐시 범위에 포함시킨 경우, 이후 동적 콘텐츠가 바뀌면 기대했던 안정 프리픽스에 적중하지 못할 수 있어요. 해결책은 안정적인 콘텐츠가 끝나는 지점에 명시적 캐시 중단점을 설정하는 거예요.
다른 흔한 원인들도 있어요:
- 모델, 공급사, 서비스 조직을 전환했거나 일부 파라미터를 수정한 경우
- Agent가 대화 압축, 도구 정의 재정렬, 히스토리 메시지 수정을 하면서 재사용 가능한 프리픽스가 다시 쓰인 경우
- 서드파티 게이트웨이가 캐시 파라미터를 전달하지 않거나, 캐시 할인을 청구서에 반영하지 않은 경우
4.3 출력 토큰과 도구 비용의 영향
캐시는 입력 프리픽스에만 적용돼요. 3.2의 Astra 계산 예시에서 프리픽스 비용이 0으로 떨어져도 청구서는 $5.50(동적 입력 + 출력) 아래로 내려가지 않아요. 출력이 길고 도구 호출이 많은 작업은 전체 청구서의 감소 폭이 프리픽스 절감률보다 확실히 낮아요. 그래서 캐시를 켠 뒤에도 출력 길이를 제어하고 도구 호출을 간소화하는 작업을 함께 해야 해요.
5 AI 애플리케이션에서 Prompt Caching을 어떻게 구성하고 모니터링할까요?
5.1 안정적인 프리픽스와 동적 서픽스 구성 방법
변화 빈도가 낮은 것부터 높은 순서로 내용을 배치하세요.
- 도구 정의: 순서와 설명을 고정하고, 요청에 따라 동적으로 추가하거나 제거하지 마세요.
- 시스템 규칙과 작성 가이드: 역할 설명, 브랜드 규칙, 문체 요구 사항
- 예시 문서와 지식 베이스: 긴 참고 문서를 넣고, 버전이 바뀔 때 전체를 교체하세요.
- (캐시 브레이크포인트)
- 동적 자료: 당일 뉴스, 검색 결과, 사용자 입력
- 현재 작업 지시: 제목, 글자 수, 구체적인 요구 사항
다음 예시는 OpenAI 호환 인터페이스로 호출하고, 응답에 포함된 캐시 토큰을 읽습니다.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

STABLE_PREFIX = """你是一名技术博客作者……(写作规范、范文、术语表,约 20K Token,内容逐字固定)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # 플랫폼 모델 목록에 있는 실제 이름을 기준으로 합니다
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # 안정적인 프리픽스를 맨 앞에 배치
        {"role": "user", "content": "今日材料:……\n标题:……"},  # 동적 내용은 뒤에 배치
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"输入 {resp.usage.prompt_tokens},命中缓存 {cached}")
전체 코드 보기: 비용 계산기 + 캐시 적중률 통계
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """공식 단가로 일일 비용(달러)을 계산하고 (프리픽스, 동적 입력, 출력, 합계)를 반환합니다"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # 이름: (입력, 출력, 쓰기, 읽기)  달러 / 백만 Token, 확인 날짜 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # 암시적 캐시는 첫 호출 시 일반 입력으로 계산
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},节省 {(base - cached) / base:.2%}")

# 시나리오 A: Astra 30m, 20개 배치 각각 재작성 필요
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- 온라인 적중률 통계 ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"实际缓存命中率:{hit:.2%}")
    return hit
🚀 빠른 시작 가이드: 먼저 위 계산기로 예산을 추정한 다음, 실제 템플릿으로 10~20회 호출을 실행해
cached_tokens가 두 번째 호출부터 안정적으로 나타나는지 확인하세요. 신규 사용자는 APIYI apiyi.com에서 무료 테스트 크레딧을 받아 이 단계를 검증하고, 적중이 확인되면 사용량을 늘리면 됩니다.
5.2 Prompt Caching TTL과 캐시 모드 선택하기
- 고빈도 연속 호출(호출 간격이 몇 분 이내로 안정적): 기본 짧은 TTL을 사용하세요. 즉, OpenAI는 30분, Claude는 5분이에요. 한 번만 적중해도 본전을 뽑고, 쓰기 프리미엄도 가장 낮아요. Claude는 응답 생성 시간도 5분 윈도우에 포함시켜 계산해야 해요.
- 하루 종일 분산 호출(배치 간격이 30분을 넘음): OpenAI 12시간 또는 Claude 1시간을 검토하세요. 윈도우 안에서 두 번 이상 적중할 수 있다면, 긴 TTL이 반복 쓰기보다 저렴해요. 4.1의 시나리오 B가 바로 그 예시예요.
- 프리픽스가 매우 길고, 긴 시간대에 걸쳐 재사용해야 하는 Gemini 작업: 명시적 캐싱을 검토하되 스토리지 비용도 함께 계산하세요. Gemini 3.8 Flash를 예로 들면, 20K Token을 12시간 저장하는 비용은 0.02 × $0.50 × 12 = $0.12예요. 이 글의 워크로드에서는 이 비용이 $0.576의 일일 청구서에 비해 이미 상당한 수준이에요. 암시적 캐시가 잘 적중한다면 그대로 기본값을 유지하세요.
- 프리픽스가 자주 바뀌는 경우: 먼저 프리픽스를 고정한 다음 TTL을 고려하세요. 프리픽스가 불안정하면 어떤 TTL을 써도 적중을 얻을 수 없어요.
5.3 Prompt Caching의 실제 적중률과 청구서 확인하기
세 업체의 usage 필드는 각각 다음과 같아요.
- OpenAI(Responses API):
usage.input_tokens,usage.input_tokens_details.cached_tokens,usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens,usage.cache_creation_input_tokens,usage.cache_read_input_tokens - Gemini: 해당 API의 usage 필드, 예를 들어
total_cached_tokens이고, 명시적 캐시는 객체 스토리지 비용이 별도로 부과돼요
두 가지 지표를 계속 추적하시길 권장해요.
실제 캐시 적중률 = 캐시 읽기 Token ÷ 총 입력 Token
실제 절감액       = 미캐시 기준 비용 − 실제 API 청구 비용
미캐시 기준 비용은 동일한 모델, 동일한 워크로드, 동일한 출력 규모로 계산해야 해요. 그렇지 않으면 절감액을 비교할 수 없어요. APIYI apiyi.com 콘솔에서 청구서를 확인할 때는, 같은 시간대의 usage 집계와 청구 상세를 항목별로 대조해서 캐시 Token이 캐시 가격으로 청구됐는지 확인하세요.
6 APIYI 시나리오: 고정 템플릿과 대량 AI 생산에서 Prompt Caching으로 비용을 어떻게 관리할까요?
Prompt Caching에 적합한 대표적인 업무로는 매일 고정된 글 템플릿을 실행하는 AI 글쓰기 플랫폼, 동일한 도구 정의를 반복 로딩하는 에이전트, 같은 대형 참고 문서를 여러 번 인용하는 자료 분석 시스템, 그리고 브랜드 규칙과 문체 설명을 공유하는 대량 콘텐츠 생성 등이 있어요. 이런 작업에는 공통점이 하나 있는데요. 프리픽스가 길고 반복률이 높으며 호출량이 많다는 점이에요. 이는 캐시 효과가 가장 큰 구간에 정확히 해당해요.
이런 시나리오에서 비용 결정을 내릴 때는 세 가지 기준으로 판단할 수 있어요:
- 모델이 필요한 캐시 기능을 지원하는지. 최소 프리픽스 길이, 선택 가능한 TTL, 읽기 할인 배수를 포함해요. 읽기 0.05배인 모델은 긴 프리픽스 작업에서 프리픽스 절감률이 더 높아요.
- 프롬프트와 TTL이 워크로드에 맞는지. 연속 배치 처리에는 짧은 TTL을 사용하고, 스케줄에 따라 분산 실행되는 작업은 긴 TTL을 검토하면서 4.1절의 공식으로 회수 횟수를 계산해요.
- API 공급자가 캐시를 완전히 지원하고 실제 캐시 비용으로 과금하는지. 업스트림이 캐시를 지원하는 것은 비용 절감을 위한 필요 조건 중 하나일 뿐이에요. 게이트웨이는 캐시 파라미터를 올바르게 전달하고, usage에 캐시 토큰을 보고하며, 캐시 가격을 실제 과금에 반영해야 해요.
APIYI apiyi.com을 통해 호출할 때는 3번 항목을 고정된 검수 절차로 만드는 걸 권장해요. 동일한 20K 템플릿으로 여러 번 연속 호출하고, usage의 캐시 필드를 확인한 다음 청구서 과금과 대조하는 거예요. 기술적 캐시 적중과 과금 반영 두 가지를 모두 확인한 뒤에 위 계산 결과를 월간 예산 근거로 삼으세요.
자주 묻는 질문 FAQ
Q1: Prompt Caching이 뭔가요?
프롬프트에서 이미 처리된 동일한 접두사를 캐시해 두었다가, 이후 요청이 적중하면 일반 입력보다 훨씬 저렴한 가격으로 과금하는 기능이에요. 매칭은 토큰이 글자 단위로 완전히 일치해야 하므로, 고정 템플릿이나 고정 지식 베이스, 고정 도구 정의 같은 시나리오에 적합해요.
Q2: 접두사에서 90% 이상 아꼈다는데, 왜 전체 청구서는 70% 정도만 줄어드나요?
캐시는 고정 접두사에만 적용되고, 동적 입력과 출력은 여전히 원래 가격으로 과금돼요. GPT-6.1 Sol을 예로 들면, 캐싱 후 $1.348의 일일 청구서에서 출력이 $1, 동적 입력이 $0.10을 차지해요. 출력이 길수록 전체 청구서의 절감률은 낮아져요.
Q3: 하루에 한두 번만 호출하는데, 캐시를 켜는 게 의미 있을까요?
수익은 거의 없어요. OpenAI 12h와 Claude 1h 모두 유효 기간 내에 최소 두 번 적중해야 본전을 뽑을 수 있고, 날짜를 넘긴 재사용은 보장되지 않아요. 더 효과적인 방법은 같은 종류의 작업을 같은 시간대에 모아서 배치로 실행해, 윈도우 안에서의 적중 횟수를 늘리는 거예요.
Q4: 30m와 12h 중에 뭘 선택해야 하나요?
호출 간격을 보세요. 간격이 30분 이내로 안정적이라면 30m을 쓰면 되고, 한 번 적중하는 것만으로 본전을 뽑아요. 배치 간격이 길고 하루 종일 분산된다면 12h를 쓰세요. GPT-6 Astra를 20개 배치로 호출하는 예에서 12h의 일일 비용은 $7.98, 30m은 $12.10이에요.
Q5: API 집계 플랫폼을 통해 호출해도 캐시가 여전히 작동하나요?
플랫폼이 캐시 파라미터를 어떻게 전달하고 과금을 어떻게 구현하는지에 달려 있어요. APIYI apiyi.com에서 무료 테스트 크레딧으로 같은 템플릿을 연속 호출해 보면서, usage의 `cached_tokens` 같은 필드를 확인하고 차감 내역과 대조해 보시길 권해요. 캐시가 실제로 적중되고, 또 캐시 가격으로 과금되는 것을 확인한 뒤에 배치로 사용하세요.
Q6: 캐시 적중률이 갑자기 떨어지면, 어디부터 확인해야 하나요?
다음 순서로 점검해 보세요: 접두사에 타임스탬프나 ID 같은 동적 내용이 섞여 들어갔는지, 도구 정의의 순서가 바뀌었는지, Agent가 히스토리 메시지를 압축하거나 다시 썼는지, 모델이나 파라미터가 바뀌었는지, 호출 간격이 TTL을 넘겼는지. 5.3절의 적중률 공식으로 시간 단위 통계를 내면 변화가 시작된 시점을 비교적 빠르게 찾아낼 수 있어요.
Q7: Gemini의 암시적 캐시와 명시적 캐시는 어떻게 선택하나요?
암시적 캐시는 기본으로 켜져 있고 저장 비용이 없어요. 접두사가 모델의 최소 길이(3.8 Flash의 경우 4,096 토큰)를 넘으면 우선적으로 사용돼요. 명시적 캐시는 확정적인 재사용이 필요한 초장문 콘텐츠에 적합하지만, 시간 단위로 저장 비용을 지불해야 하고 generateContent API를 사용해야 해요. Interactions API는 현재 암시적 캐시만 지원해요.
정리
Prompt Caching의 핵심 포인트:
- 어디서 절약되나요: 고정 프리픽스 비용만 낮춰줘요. 이 글의 워크로드 기준으로 프리픽스 절감률은 88.85%~93.8%, 전체 청구서 절감률은 69.69%~73.57%예요.
- 얼마나 절약되나요: GPT-6.1 Sol과 Claude Sonnet 5.5는 하루 $5.10에서 $1.348로, GPT-6 Astra는 $25.50에서 $7.73으로 내려가요. 단가가 높을수록 절대 절감액도 커져요.
- 어떤 빈도가 가장 유리한가요: 고빈도, 연속, 프리픽스가 긴 호출이에요. 짧은 TTL은 1회 적중하면 본전을 뽑고, 긴 TTL은 2회 적중해야 본전이 나와요.
- 어떻게 적용하나요: 안정적인 내용을 앞에, 동적인 내용을 뒤에 배치하고 안정적인 내용 끝에 브레이크포인트를 설정해요. 호출 리듬에 맞춰 TTL을 고르고, usage 필드로 적중률을 계속 모니터링해요.
- 성립 전제: 캐시는 기술적으로 적중해야 하고, 청구 단계에서도 캐시 가격으로 과금되어야 해요.
먼저 글에 나온 계산기로 예산을 산출한 뒤, APIYI apiyi.com에서 실제 템플릿으로 적중률과 과금을 검증해 보세요. 두 가지를 모두 확인한 다음에 물량을 늘리는 게 좋아요.
📚 참고 자료
- OpenAI Prompt Caching 가이드: 캐시 모드, 브레이크포인트, TTL과 과금 배수
- 링크:
developers.openai.com/api/docs/guides/prompt-caching -
설명:
prompt_cache_options,prompt_cache_breakpoint파라미터 설명 -
OpenAI 모델 및 가격: GPT-6 Astra, GPT-6.1 Sol 단가
- 링크:
developers.openai.com/api/docs/pricing - 링크:
developers.openai.com/api/docs/models/gpt-6-astra - 링크:
developers.openai.com/api/docs/models/gpt-6.1-sol -
설명: 표준 단문맥 요율, 확인 날짜 2026-11-13
-
Claude Prompt Caching 문서:
cache_control, 5m / 1h 쓰기 및 읽기 배수 - 링크:
platform.claude.com/docs/en/build-with-claude/prompt-caching - 링크:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
설명: Sonnet 5.5 캐시 읽기 0.05배 요율
-
Gemini Context Caching 및 가격: 암시적 / 명시적 캐시, 저장 비용과 2027년 가격 조정
- 링크:
ai.google.dev/gemini-api/docs/caching - 링크:
ai.google.dev/gemini-api/docs/pricing - 설명: 모델별 최소 캐시 길이와 API 지원 범위
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지 첫 화면에서 연락 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.


