
작성자 노트: 이 글은 Anthropic 엔지니어링 블로그에서 공개한 Claude Dreaming 메커니즘을 해설해요. 4계층 메모리 구조, CL-Bench와 Wiki 실험 데이터, 오류 수정 사례, 엔지니어링 리스크를 다루고, 개발자가 “세션 사이에 메모리를 정리하는” 아이디어를 참고해 자신만의 Agent 메모리 시스템을 만드는 방법도 설명해요.
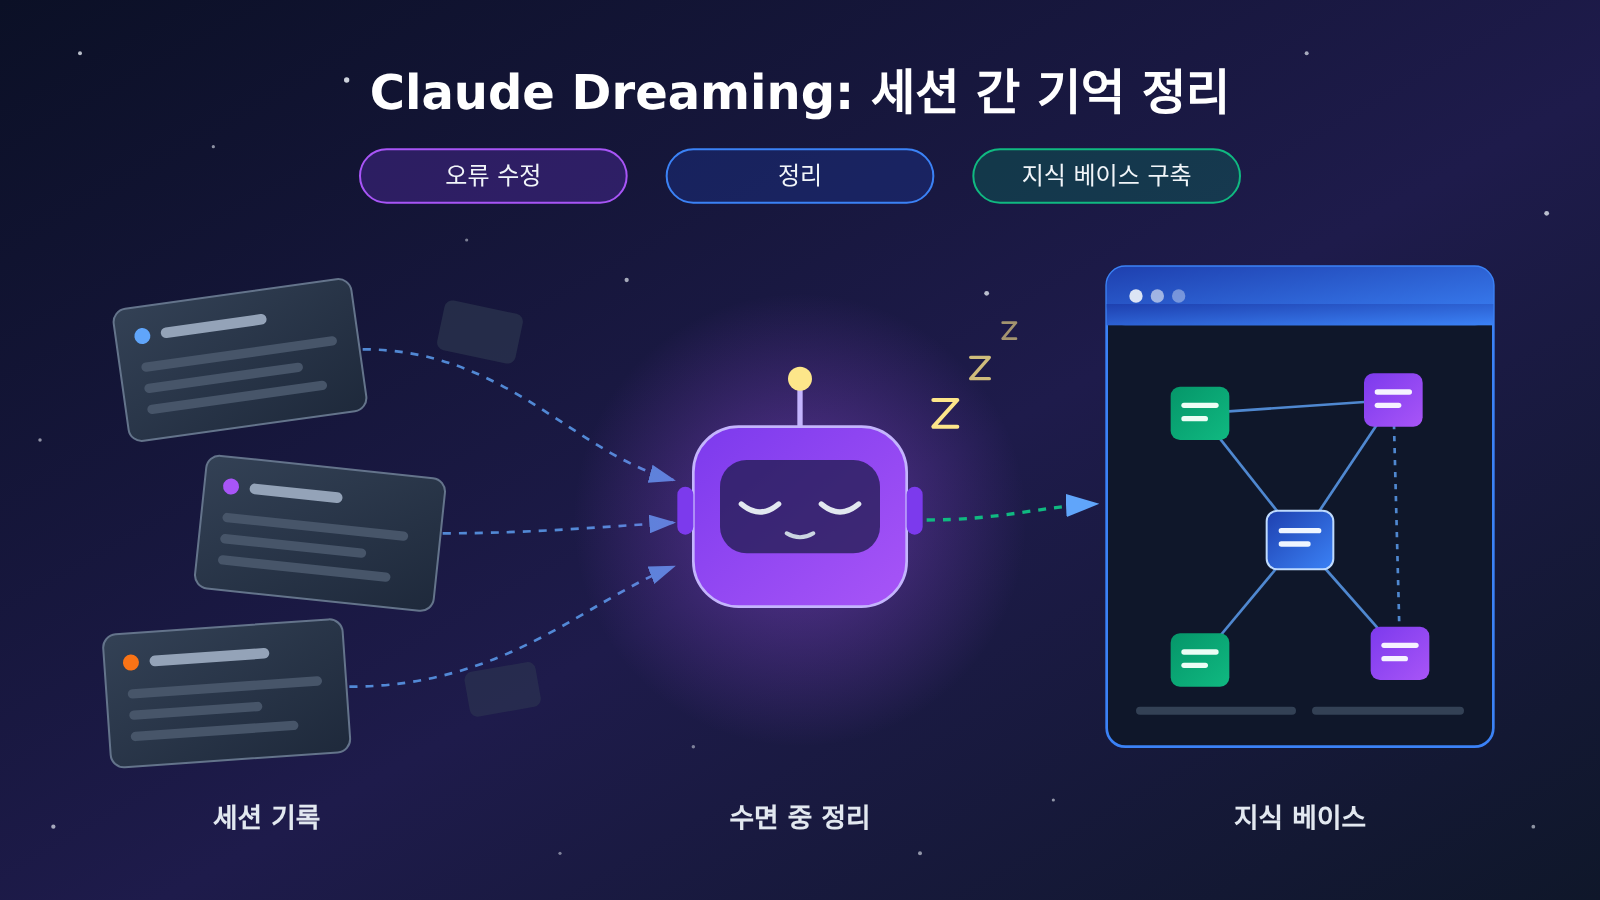
2026년 11월 6일, Anthropic이 엔지니어링 블로그에 The components of agent memory를 공개했어요. 이 글은 Claude Dreaming이 세션 사이에 오류를 바로잡고, 메모리를 정리하고, 지식 베이스를 구축하는 방식을 처음으로 체계적으로 설명해요. 공식 X 계정에도 같은 글이 올라왔고, Claude Managed Agents 문서에는 Dreams의 리서치 프리뷰 API도 이미 등장했어요.
“Agent에 벡터 DB 하나 붙이면 끝”이라는 흔한 이야기가 아니에요. Anthropic은 여러 실험으로, 장기 실행 Agent는 기록을 저장하는 것만으로는 부족하다는 점을 보여줘요. 기억을 계속 검증하고, 오류를 수정하고, 통합하고, 조직해야 오래된 정보가 다음 작업에 실제로 도움이 된다는 거예요.
핵심 가치: 이 글을 읽으면 Claude Dreaming의 4계층 메모리 구조와 주요 실험 데이터를 알 수 있어요. 어떤 상황에서 효과가 있고 어떤 상황에서 오히려 해가 되는지, 그리고 내 Agent에 어떻게 응용할 수 있는지도 함께 살펴봐요.
Claude Dreaming 핵심 정보 한눈에 보기
| 항목 | 내용 |
|---|---|
| 발표 시기 | 2026-11-06, Anthropic Engineering 블로그 |
| 핵심 개념 | Dreaming: 세션 사이에 과거 기록을 활용해 메모리를 다시 정리하고 관리하는 백그라운드 프로세스 |
| 메모리 계층 | Transcripts, Memory notes, Memory representations, Injected context의 4개 계층 |
| 제품 형태 | Claude Managed Agents의 Dreams. 현재 Research Preview 단계이며 접근 신청이 필요해요 |
| 관련 자료 | 공식 Cookbook 《Dreaming with a dynamic workflow》, 2026-11-02 공개 |
| 영향 범위 | 장기 실행 Agent, 세션을 넘나드는 작업, 기업 내부 지식 베이스 구축 |
Dreaming을 이해하려면 먼저 몇 가지 용어를 짚고 넘어가는 게 좋아요. Transcript는 사용자 입력, Agent 출력, 도구 호출과 그 결과까지 포함한 전체 세션 기록이에요. Memory Note는 과거 경험에서 추려낸 영속적인 사실, 규칙, 노하우를 말해요. Memory Store는 세션이 바뀌어도 메모리 파일을 보관해 두는 영속 저장 공간이고요. Dreaming은 Sleep-time Compute와 비슷한 발상이에요. 주된 상호작용 바깥의 유휴 연산 자원으로 이미 쌓인 컨텍스트를 처리하는 방식이죠.
Agent 메모리를 대화 기록 저장만으로 해결할 수 없는 이유
Agent 메모리를 만들 때 많은 팀이 가장 먼저 떠올리는 방법은 모든 대화를 저장해 두고 필요할 때 검색하는 거예요. 하지만 이력 로그, 세션 요약, 검색 가능한 지식은 서로 다른 것이에요. 로그는 원시 이벤트가 쌓인 더미일 뿐이고, 요약은 핵심 세부 정보를 놓칠 수 있어요. 검증과 정리를 거친 지식만이 다음 작업을 안정적으로 도와줘요.
전체 대화를 그대로 저장하면 세 가지 문제가 생겨요. 정보가 중복되고, 오래된 상태가 낡은 채로 남고, 오류가 계속 쌓여요. 잘못 적힌 기록 하나가 이후 세션에서 반복해서 읽히면, 그 오류는 사실로 취급되어 계속 실행돼요. Anthropic의 결론은 명확해요. 메모리는 많다고 좋은 게 아니라, 선별하고 검증하고 정리해야 해요.
Pokémon Red 실험이 이 차이를 잘 보여줘요. 약 10,000 스텝 시점에 Sonnet 3.7은 파일 413개와 폴더 225개를 만들었지만 배지는 1개밖에 얻지 못했어요. 반면 Fable 5는 일반 메모리 파일 9개, 폴더 2개, global.md 하나만 만들었는데도 배지를 4개 얻었어요.
차이는 “무엇을 기록하느냐”에서 나왔어요. Sonnet 3.7은 계속 바뀌는 게임 상태를 대량으로 저장했고, 이런 기록은 금방 낡아 버렸어요. Fable 5는 전략, 검증된 규칙, 행동 계획에 더 집중했어요. 여기서 하나의 설계 원칙이 나와요. 장기 메모리에는 현재 환경에서 다시 얻기 어려운 지식을 우선 남기고, 매번 바로 읽을 수 있는 실시간 상태는 굳이 기록하지 않아도 돼요.
Claude 메모리 체계의 4가지 계층
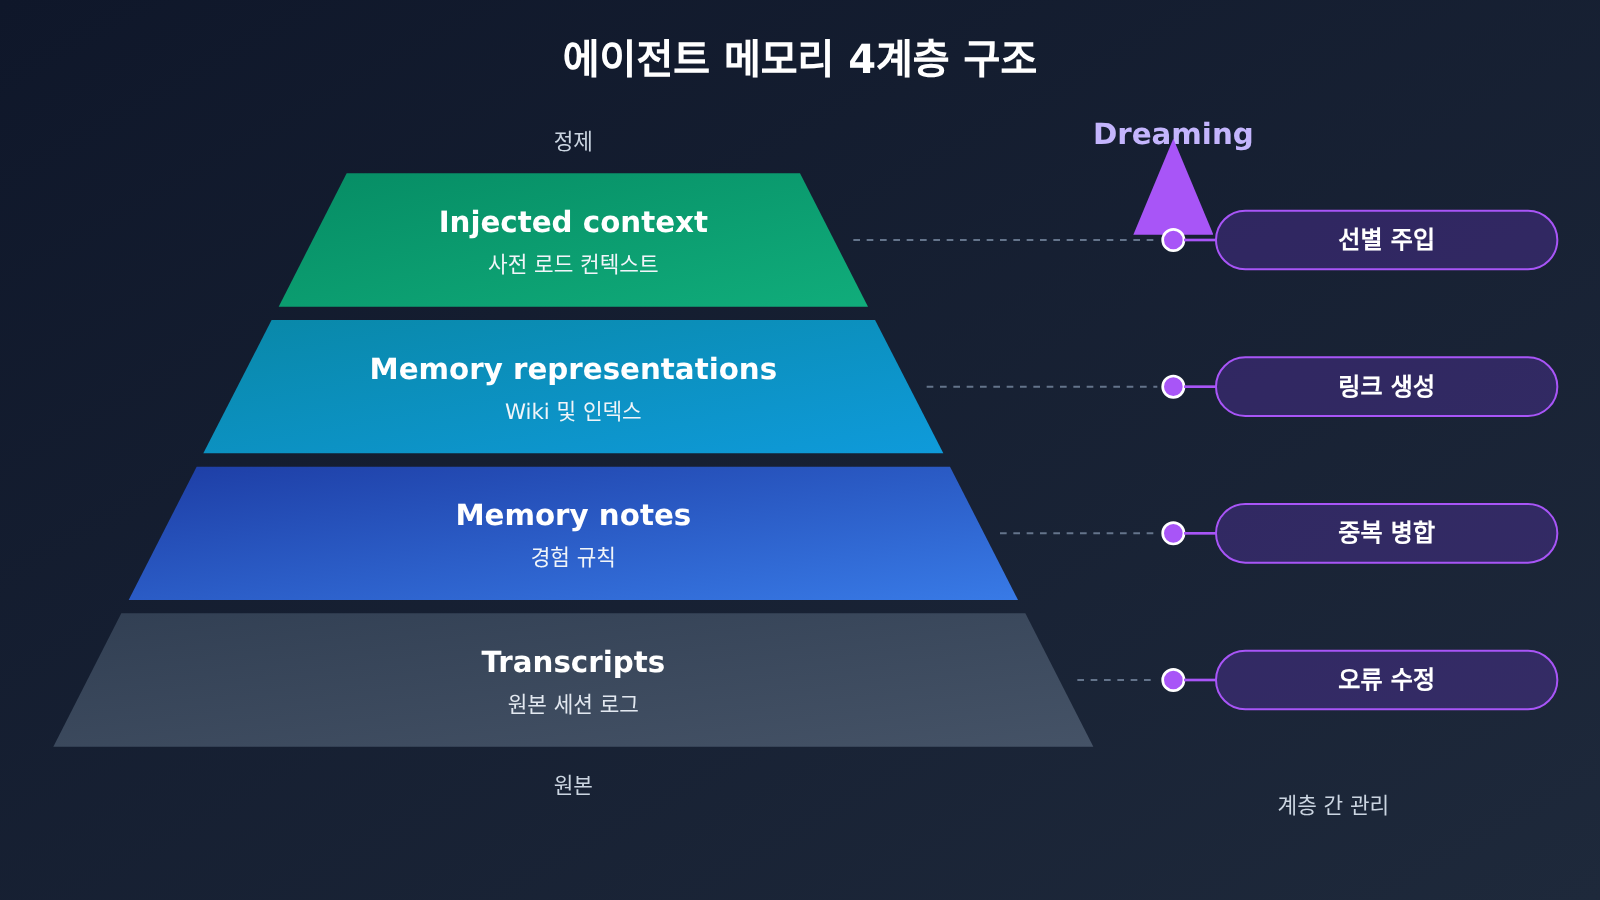
Anthropic은 Agent 메모리를 4개 계층으로 나눴어요. 계층마다 역할, 기록 빈도, 읽기 비용이 모두 달라요.
| 계층 | 내용 | 역할 | 읽기 방식 |
|---|---|---|---|
| Transcripts | 전체 세션 기록 | 검색 가능한 이벤트 로그로, 사실을 추적할 때 쓰는 원본 증거 | 필요할 때 검색 |
| Memory notes | 작업 중에 기록한 중요한 사실, 경험, 규칙 | 재사용할 수 있는 경험을 축적 | 필요할 때 읽기 |
| Memory representations | Wiki, 인덱스, 링크 등 구조화된 표현 | 지식 간의 관계를 정리하고 문서 간 검색을 지원 | 탐색 및 검색 |
| Injected context | 소수의 고가치 메모리 | 새 세션이 시작될 때 미리 로드 | 자동 주입 |
이 4개 계층은 ‘원본’에서 ‘정제’로 점차 나아가는 과정이에요. Transcript는 정보가 가장 완전하지만 분량이 크고 노이즈가 많아요. Injected context는 가장 정제되어 있지만, 항목 하나하나가 새 세션의 컨텍스트 윈도우를 차지해요. 그래서 중요도(Salience)가 가장 높은 정보만 담아야 해요.
Dreaming은 계층 전반을 오가며 유지·관리하는 역할을 해요. Transcript로 돌아가 오래된 기록을 바로잡고, Memory notes에 중복된 정보를 병합해요. 또 Wiki와 인덱스를 구축하고, 새 세션이 시작될 때 미리 주입할(Context Injection) 만한 내용을 가려내요.
Claude Dreaming이 오류를 바로잡고, 정리하고, 지식 베이스를 구축하는 방법
Dreaming의 오류 수정: Mt. Moon 길 찾기 사례
Anthropic이 기록한 길 찾기 오류 사례가 있어요. Agent가 Mt. Moon 근처 Pokémon Center의 방위를 잘못 기억했고, 이후 세션에서도 계속 잘못된 경로로 같은 시도를 반복했어요.
Dreaming이 과거 Transcript를 다시 검토해서 맨 처음 잘못 기록된 내용을 찾아냈고, 메모리 파일을 수정했어요. 수정된 메모리를 사용한 Agent는 1,935번째 동작에서 Cerulean City에 도착했어요. 오류를 바로잡지 않은 버전은 실패를 여러 번 반복하다가 끝내 목표를 달성하지 못했어요.
이 사례는 Dreaming이 단순한 요약 이상의 일을 한다는 걸 보여줘요. 원래의 경험으로 돌아가 메모리가 여전히 유효한지 검증할 수 있는 거죠. 그래서 저장해 둔 Transcript도 새로운 쓰임새를 얻게 돼요. 반복해서 대조할 수 있는 증거 저장소가 되는 셈이에요.
Claude 메모리 효과: CL-Bench 실험 데이터
Anthropic은 CL-Bench 1.0의 데이터베이스 과제로 메모리의 효과를 테스트했어요. 아래 표는 공식 보고서에 나온 mean reward예요.
| 모델 | 메모리 없음 | 메모리 사용 | 향상 폭 |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
이 데이터는 해당 과제에만 적용되는 것이며, Agent 메모리 능력을 범용적으로 평가한 점수는 아니라는 점에 유의하세요. 더 눈여겨볼 부분은 따로 있어요. 모델이 강력할수록 과거 대화를 그대로 베끼기보다는, 검증을 거친 규칙, 오류의 원인, 앞으로 마주칠 수 있는 함정을 기록하는 경향이 강해진다는 점이에요. Sonnet 4.6은 향상 폭이 매우 제한적이었는데, 이는 메모리 시스템의 효과가 모델 자체의 ‘기록 품질’과 밀접하게 연결되어 있다는 뜻이에요.
Dreaming으로 Wiki 지식 베이스를 구축한 결과
가장 큰 규모의 실험에서는 내부 문서 약 350,000건, 총 약 420M Token 분량을 사용했어요. Anthropic은 128번의 Dreaming 세션을 거치며 지식 Wiki를 단계적으로 구축했고, 이후 질의응답 과제로 효과를 평가했어요.
| 검색 방식 | 점수 | 비고 |
|---|---|---|
| Wiki 단독 사용 (구축 전 → 구축 후) | 13% → 48% | Wiki가 점차 갖춰지면서 효과가 뚜렷해짐 |
| Search 단독 사용 | 53% | 기준선 |
| Search + Wiki (구축 전 → 구축 후) | 54% → 61% | 질문당 평균 약 20,000 Token 절감 |
| 인수합병 관련 문서 간 종합 과제 | Wiki 87% vs Search 단독 73% | 문서 간 종합에서 우위가 가장 뚜렷함 |
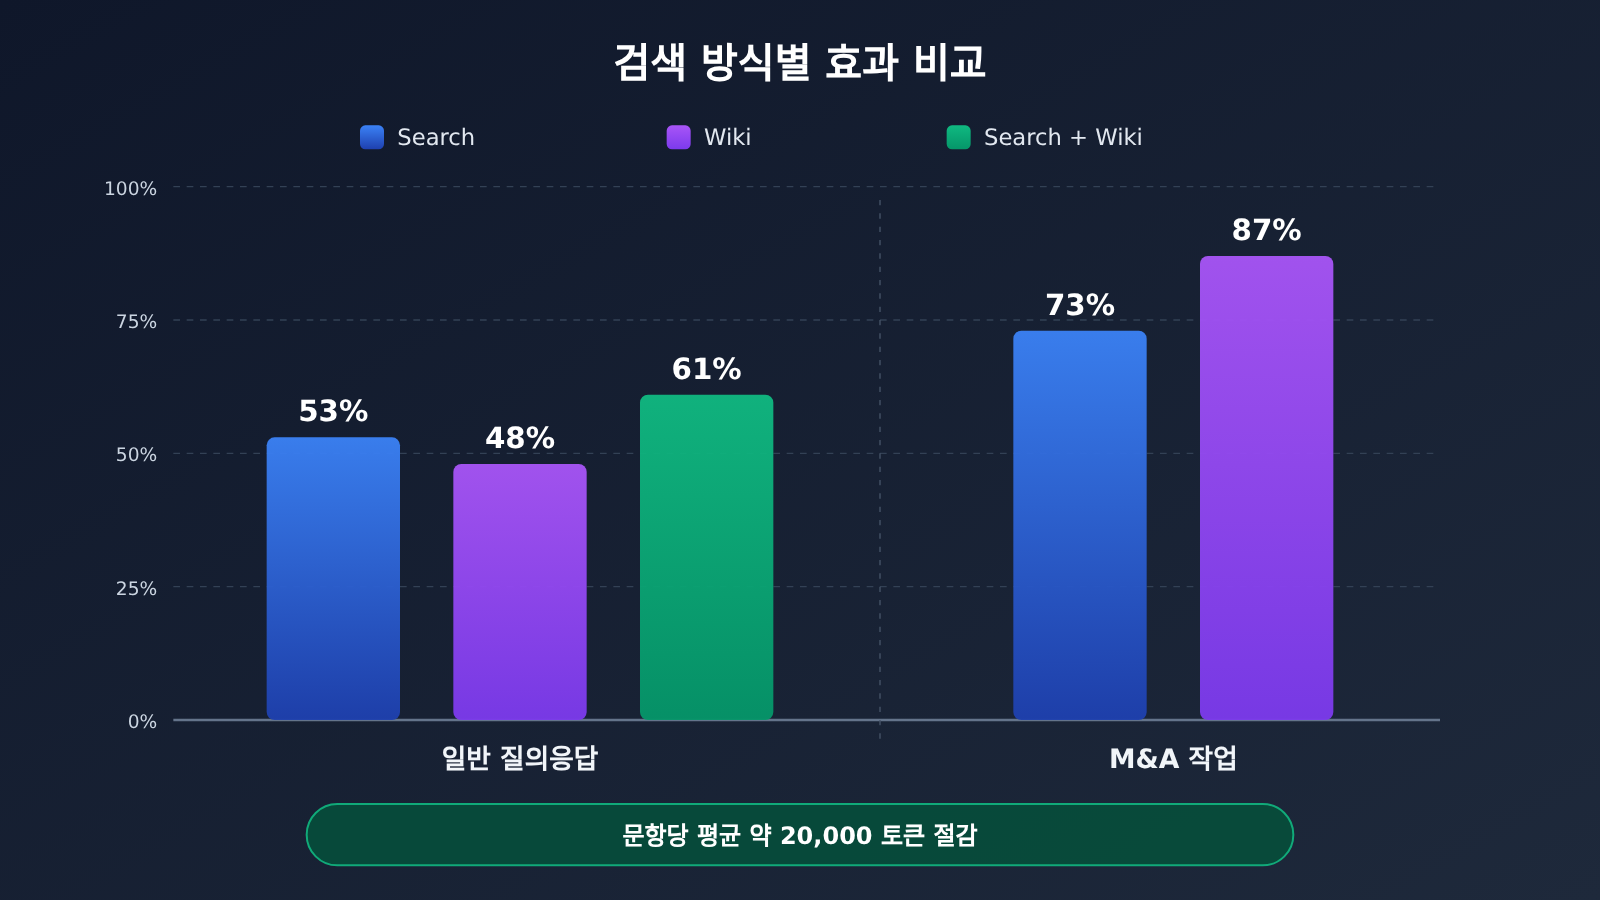
📊 차트 설명: 위 데이터는 모두 Anthropic 엔지니어링 블로그에 공개된 실험에서 나온 것이에요. 직접 가지고 있는 말뭉치로 비슷한 소규모 검증을 해보고 싶다면, APIYI(apiyi.com)를 통해 Claude 모델을 호출해서 ‘검색만 사용’하는 방식과 ‘검색 + 정리된 Wiki’를 사용하는 방식의 효과와 Token 소모량을 비교해 볼 수 있어요.
구조화된 메모리의 가치는 크게 두 가지예요. 하나는 링크와 인덱스를 만들어서 여러 문서에 흩어진 정보를 종합할 수 있게 해준다는 점이고, 다른 하나는 검색할 때마다 새로 읽어야 하는 원문의 양을 줄여서 Token 비용을 낮춰준다는 점이에요.
영향 분석: Claude Dreaming 메모리 정리가 때로는 효과적이고 때로는 해로운 이유
Anthropic은 Dreaming을 만능 해결책처럼 소개하지 않았어요. 문서에는 반례도 여러 개 나와 있는데, 이 부분이 긍정적인 수치보다 엔지니어링 실무에 더 도움이 될 수도 있어요.
메모리 정리의 5가지 엔지니어링 리스크
- 과도한 기록: Sonnet 3.7처럼 변하기 쉬운 상태를 대량으로 저장하면 메모리가 빠르게 불어나고, 그만큼 빨리 낡아요.
- 정보 노후화: 환경은 바뀌었는데 메모리는 옛 버전에 머물러 있으면, 출처를 대조하지 않는 한 에이전트를 계속 잘못된 방향으로 이끌어요.
- 공유 쓰기 덮어쓰기: 계약서 정리 실험에서 여러 에이전트가 같은 요약표에 동시에 기록하자, 핵심 사실 57개 중 41개만 남았어요. 약 72%예요. 계약서마다 독립된 페이지를 만들고, 단일 에이전트가 원본 조항을 보존하며 기록하도록 바꾸자 57개 사실이 모두 보존됐어요.
- Wiki 용량 팽창: 한 테스트에서 원본 파일은 115 KB뿐이었는데, 생성된 Wiki는 203 KB까지 늘어났어요. 정리했더니 오히려 정보량이 늘어난 셈이에요.
- 단순한 작업에서는 이점 없음: 파일 하나만 검색해도 답이 나오는 질문에서는 Wiki가 뚜렷한 개선을 가져오지 못했고, 유지 관리 비용만 늘렸어요.
개발자에게 미치는 영향
- 메모리는 계층화해야 해요: 원본 로그, 경험 규칙, 구조화된 지식, 사전 주입 컨텍스트를 따로 보관하고, 각각 다른 쓰기·읽기 전략을 적용하세요.
- 출처를 추적할 수 있어야 해요: 모든 메모리는 해당 Transcript까지 거슬러 올라갈 수 있어야 해요. 오류를 바로잡으려면 이것이 전제 조건이에요.
- 쓰기는 직렬화하거나 분할해야 해요: 여러 에이전트가 같은 파일에 동시에 쓰는 일은 피하고, “엔티티 하나당 페이지 하나” 구조를 우선 고려하세요.
- 주기적으로 정리해야 해요: Wiki와 Memory notes도 중복 제거, 병합, 폐기가 필요해요. 그렇지 않으면 용량은 계속 늘어날 뿐이에요.
업계에 미치는 영향
- 에이전트 메모리 연구의 무게중심이 “검색을 정확하게 하는 것”에서 “메모리 자체가 올바른지, 제대로 관리되고 있는지”로 옮겨가고 있어요.
- Sleep-time Compute가 일반적인 아키텍처로 자리 잡을 가능성이 있어요. 정리 비용을 유휴 시간대로 옮겨서, 주요 상호작용 중의 컨텍스트 부담을 줄일 수 있어요.
- 구조화된 메모리는 여러 파일, 여러 턴에 걸쳐 장기간 쌓이는 작업에 더 잘 맞아요. 일회성 단순 질의응답이라면 순수 검색이 여전히 더 경제적인 선택이에요.
개발자가 Claude Dreaming 아이디어를 자신의 에이전트에 적용하는 방법
공식 Dreams 리서치 프리뷰 사용 조건
Anthropic의 현재 문서에 따르면 Dreams는 Claude Managed Agents의 기능이고, 상태는 Research Preview예요. 사용하려면 접근 권한을 따로 신청해야 해요. 호출할 때는 managed-agents-2026-04-01과 dreaming-2026-04-21, 이렇게 두 개의 Beta Header를 함께 보내야 해요.
입력은 기존 Memory Store 하나와 과거 Session 1~100개이고, 출력은 새로운 Memory Store예요. 원본 Store는 수정되지 않아요. 작업은 비동기로 실행되며 보통 몇 분에서 몇 시간까지 걸려요. 비용은 선택한 모델의 표준 토큰 가격 기준으로 청구돼요. 지원 모델은 주로 Opus 5.5와 Sonnet 5.5예요. 또 현재는 Zero Data Retention이나 HIPAA 자격을 갖추지 못했어요. 그래서 민감한 데이터를 처리하기 전에 먼저 검토해 보셔야 해요.
Cookbook의 동적 워크플로 설계
공식 Cookbook에는 직접 구축할 수 있는 멀티 Agent 워크플로가 나와 있어요. 기본 구성에서는 Lead Agent가 전체 흐름을 조율하고, Analyzer Agent는 Transcript를 하나씩 맡아 분석해요. Organizer Agent는 중복 제거, 링크 복구, 인덱스 관리를 담당해요. 정리를 마친 Memory Store는 다음 Session에 마운트해서 쓰는데, 보통은 읽기 전용으로 연결해요. Cron으로 정기 실행하도록 설정할 수도 있어요. 예를 들어 매일 밤 지난 하루 동안의 Session을 정리하는 식이에요.
Cookbook에는 비용 예시도 있어요. 예시 Transcript 11개(총 283 KB)를 처리하는 데 약 2.5분이 걸렸고 비용은 약 $0.36이었어요. 긴 Transcript 50개(약 12 MB)는 비용 최적화 설정에서 약 $8, 소요 시간은 약 10분이었어요. 다만 이 수치는 특정 실험의 결과일 뿐, 고정된 가격은 아니에요.
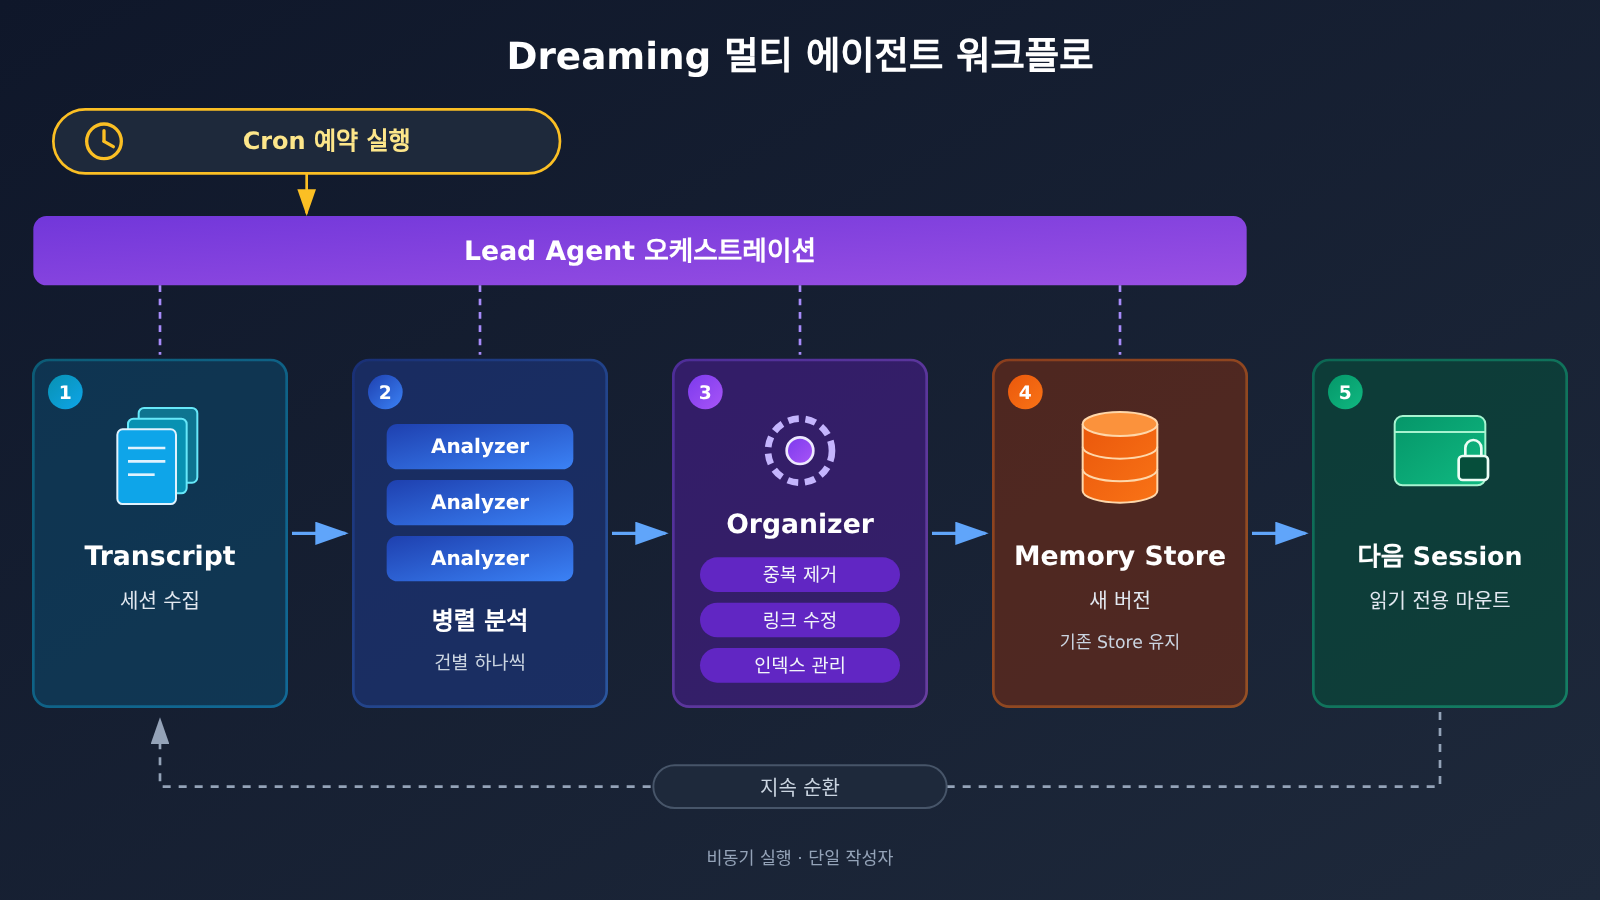
Claude 모델로 세션 간 메모리 정리 파이프라인 직접 만들기
먼저 짚고 넘어갈 점이 있어요. APIYI가 제공하는 것은 Claude 시리즈 모델의 호출 인터페이스예요. Managed Agents, Memory Stores, Dreams API를 제공한다는 뜻은 아니에요. 다만 Dreaming의 핵심 아이디어, 즉 “백그라운드에서 Transcript를 읽고, 검증된 규칙을 추려낸 뒤, 단일 작성자에게 정리를 맡긴다”는 방식은 일반 모델 호출만으로도 충분히 직접 구현할 수 있어요. 아래는 Claude가 세션 기록 하나를 분석해서 후보 메모리를 출력하게 하는 최소 예제예요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # 모델 목록에서 사용 가능한 Claude 모델로 교체하세요
    messages=[
        {"role": "system", "content": "只提炼经过验证的规则、错误原因和未来陷阱,忽略易变状态,每条注明来源行号。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
전체 구현 코드 보기 (Analyzer + 단일 작성 Organizer)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # 주제당 페이지 하나, 단일 프로세스가 순차적으로 기록해서 동시 덮어쓰기를 방지해요
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# Cron으로 매일 밤 실행할 수 있어요. 다음 세션은 memory_store의 인덱스 페이지를 읽기 전용으로 불러와요
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 빠른 시작 팁: 프로토타입을 만들 때는 APIYI(apiyi.com)에서 같은 API 키 하나로 여러 Claude 모델을 Analyzer와 Organizer로 바꿔 가며 테스트해 보세요. 어떤 조합이 더 정확하게 규칙을 추려내는지, 토큰 소모는 어느 쪽이 적은지 비교한 뒤에 운영 환경 구성을 정하면 돼요.
두 가지 방식의 차이는 아래 표로 정리할 수 있어요:
| 비교 항목 | Anthropic Managed Agents Dreams | 모델 API 기반 자체 메모리 정리 |
|---|---|---|
| 이용 방법 | 리서치 프리뷰라서 접근 권한 신청과 Beta Header가 필요해요 | Claude 모델 인터페이스를 바로 호출해요 |
| 메모리 저장 | 공식 Memory Store를 쓰고, 새 Store를 출력해요 | 파일, 데이터베이스, Wiki를 직접 구현해요 |
| 스케줄링 및 동시성 | 공식 비동기 작업 | Cron, 큐, 단일 쓰기 제어를 직접 구현해요 |
| 오류 수정 및 권한 | 공식 프로세스에 내장 | 출처 검증과 권한을 직접 설계해야 해요 |
| 이용 가능 플랫폼 | Anthropic 공식 | APIYI apiyi.com(모델 호출), 공식 API |
Claude Dreaming 자주 묻는 질문 FAQ
Q1: Claude Dreaming이 뭔가요?
Dreaming은 Anthropic이 제시한 세션 간 백그라운드 메모리 관리 과정이에요. 과거 Transcript를 활용해 오래된 기록을 바로잡고, 중복된 정보를 합치고, Wiki와 인덱스를 만들어요. 그리고 새 세션에 미리 넣어 둘 만한 가치 높은 컨텍스트를 골라내요.
Q2: Dreaming은 일반적인 세션 요약이나 벡터 검색과 뭐가 다른가요?
요약은 정보를 압축할 뿐이고, 검색은 정보를 찾아 주는 역할만 해요. Dreaming은 원본 Transcript로 돌아가 메모리가 여전히 유효한지 검증해요. 예를 들어 Mt. Moon 사례에서는 잘못된 방위를 바로잡았어요. 문서 간 링크도 만들어 주는데, 여러 파일을 종합해야 하는 작업에서 Wiki는 87%를 기록했고 검색만 쓴 경우는 73%였어요.
Q3: Claude Dreaming을 지금 바로 쓸 수 있나요?
관련 엔지니어링 블로그는 2026년 11월 6일에 공개됐어요. Dreams는 현재 Claude Managed Agents에서 Research Preview 형태로 제공돼요. 접근 권한을 신청해야 하고, 호출할 때 Beta Header 두 개를 함께 보내야 해요.
Q4: Managed Agents 접근 권한이 없어도 Dreaming 아이디어를 활용할 수 있나요?
네, 가능해요. “Transcript 수집, 백그라운드 분석, 단일 쓰기 정리, 읽기 전용 마운트, 정기 유지보수”라는 흐름을 따르면 일반 모델 호출만으로도 간소화된 버전을 만들 수 있어요. APIYI apiyi.com에서는 OpenAI 호환 인터페이스로 Claude 모델을 호출해 분석과 정리 작업을 할 수 있어요. 다만 저장소, 스케줄링, 권한은 직접 구현해야 해요.
Q5: APIYI에서 Claude Dreaming 기능을 직접 제공하나요?
아니요, 제공하지 않아요. APIYI apiyi.com은 Claude 같은 모델의 호출 인터페이스를 제공하고, Anthropic의 Managed Agents, Memory Stores, Dreams API는 포함하지 않아요. 모델을 호출해 메모리 정리 프로세스를 직접 만들 때 쓰기 좋아요. 신규 사용자는 무료 테스트 크레딧으로 먼저 방안을 검증해 볼 수 있어요.
Q6: Dreaming에는 어떤 한계가 있나요?
파일 하나만 봐도 답할 수 있는 간단한 질문에서는 Wiki의 이점이 뚜렷하지 않아요. 정리를 거치면 용량이 부풀어 오를 수도 있어요. 예를 들어 115 KB짜리 원문이 203 KB의 Wiki가 됐어요. 여러 Agent가 동시에 공유 쓰기를 하면 사실 정보가 유실되기도 해요. 또 공식 Dreams는 아직 ZDR과 HIPAA 자격을 갖추지 못했고, 작업 시간도 몇 분에서 몇 시간까지 제각각이에요.
Claude Dreaming 핵심 요약 Key Takeaways
- 메모리는 단순 저장이 아니에요: 모든 대화를 그대로 저장하면 중복, 오래된 정보, 오류가 쌓이기 때문에 검증하고 정리하는 과정이 필요해요.
- 4계층 메모리 구조: Transcripts, Memory notes, Memory representations, Injected context가 각자 역할을 나눠 맡아요.
- 오류 수정은 원본 기록에 의존해요: Dreaming은 Transcript로 돌아가 내용을 대조하고, 반복 실패의 원인이던 잘못된 방위 정보를 바로잡았어요.
- Wiki는 여러 문서에 걸친 작업에 강해요: 인수합병 과제에서 Wiki는 87%, 순수 검색은 73%의 점수를 기록했고, 문항당 평균 약 2만 토큰을 아꼈어요.
- 정리 작업에도 부작용이 있어요: 동시에 쓰기 작업을 하면 사실이 유실될 수 있고, Wiki가 계속 커지며, 단순한 작업에는 굳이 필요하지 않아요.
- 직접 구축할 수 있어요: APIYI(apiyi.com)를 통해 Claude 모델을 호출하면, 세션 사이에 메모리를 정리하는 간소화 버전을 만들 수 있어요.
마무리
Claude Dreaming에서 얻을 수 있는 시사점은 크게 세 가지예요.
- 장기 메모리의 핵심은 관리예요: 검증하고, 중복을 제거하고, 체계적으로 정리한 메모리만이 다음 작업을 안정적으로 도와줘요.
- 얼마나 많이 기억하느냐보다 무엇을 기억하느냐가 중요해요: 환경에서 다시 얻기 어려운 규칙, 오류의 원인, 함정을 우선 기록하고, 자주 바뀌는 상태는 기록하지 않는 게 좋아요.
- 구조화된 메모리는 상황에 맞게 써야 해요: 여러 파일에 걸쳐 있거나, 여러 라운드에 걸쳐 있거나, 오랫동안 쌓이는 작업이라면 Wiki를 도입할 만하지만, 단순한 검색 작업이라면 유지 보수 비용을 늘릴 필요가 없어요.
이미 Agent가 여러 세션에 걸쳐 동작하고 있다면, “Transcript를 보존하고, 매일 밤 한 번씩 순차적으로 정리하고, 인덱스 페이지는 읽기 전용으로 마운트한다”는 최소한의 사이클부터 시작해 보세요. APIYI(apiyi.com)를 통해 Claude 모델을 호출하면 이 흐름을 빠르게 검증해 볼 수 있어요. 이 플랫폼은 OpenAI 호환 인터페이스를 제공하고, 신규 사용자에게는 무료 테스트 크레딧도 드려요.
📚 참고 자료
- 에이전트 메모리의 구성 요소: Anthropic 엔지니어링 블로그 원문으로, 4계층 메모리 구조와 Dreaming 실험을 다룹니다
- 링크:
anthropic.com/research/components-of-agent-memory -
설명: CL-Bench, Pokémon, Wiki, 계약서 정리 등 실험 데이터가 처음 공개된 자료
-
동적 워크플로로 구현하는 Dreaming: Claude 공식 Cookbook
- 링크:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
설명: Lead, Analyzer, Organizer로 구성된 멀티 에이전트 워크플로 예시와 비용 참고 자료
-
Anthropic 공식 X 게시물: Dreaming 엔지니어링 블로그 공개 안내
- 링크:
x.com/AnthropicAI/status/2118814753154064501 - 설명: 공개 시점과 공식 포지셔닝을 확인할 수 있습니다
작성자: APIYI 기술팀
기술 관련 문의: APIYI 공식 홈페이지 첫 화면에서 연락 주시면 됩니다. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.


