
작성자 주: 콰이쇼우에서 AI가 생성한 코드의 비중은 1년 만에 26%에서 60%로 늘었어요. 이 글에서는 AI Coding의 대표적인 실패 사례와 ‘지식+제약’이라는 두 축, 네 단계 방어선을 살펴보고, 팀에서 활용할 수 있는 자체 점검 프레임워크로 정리했어요.
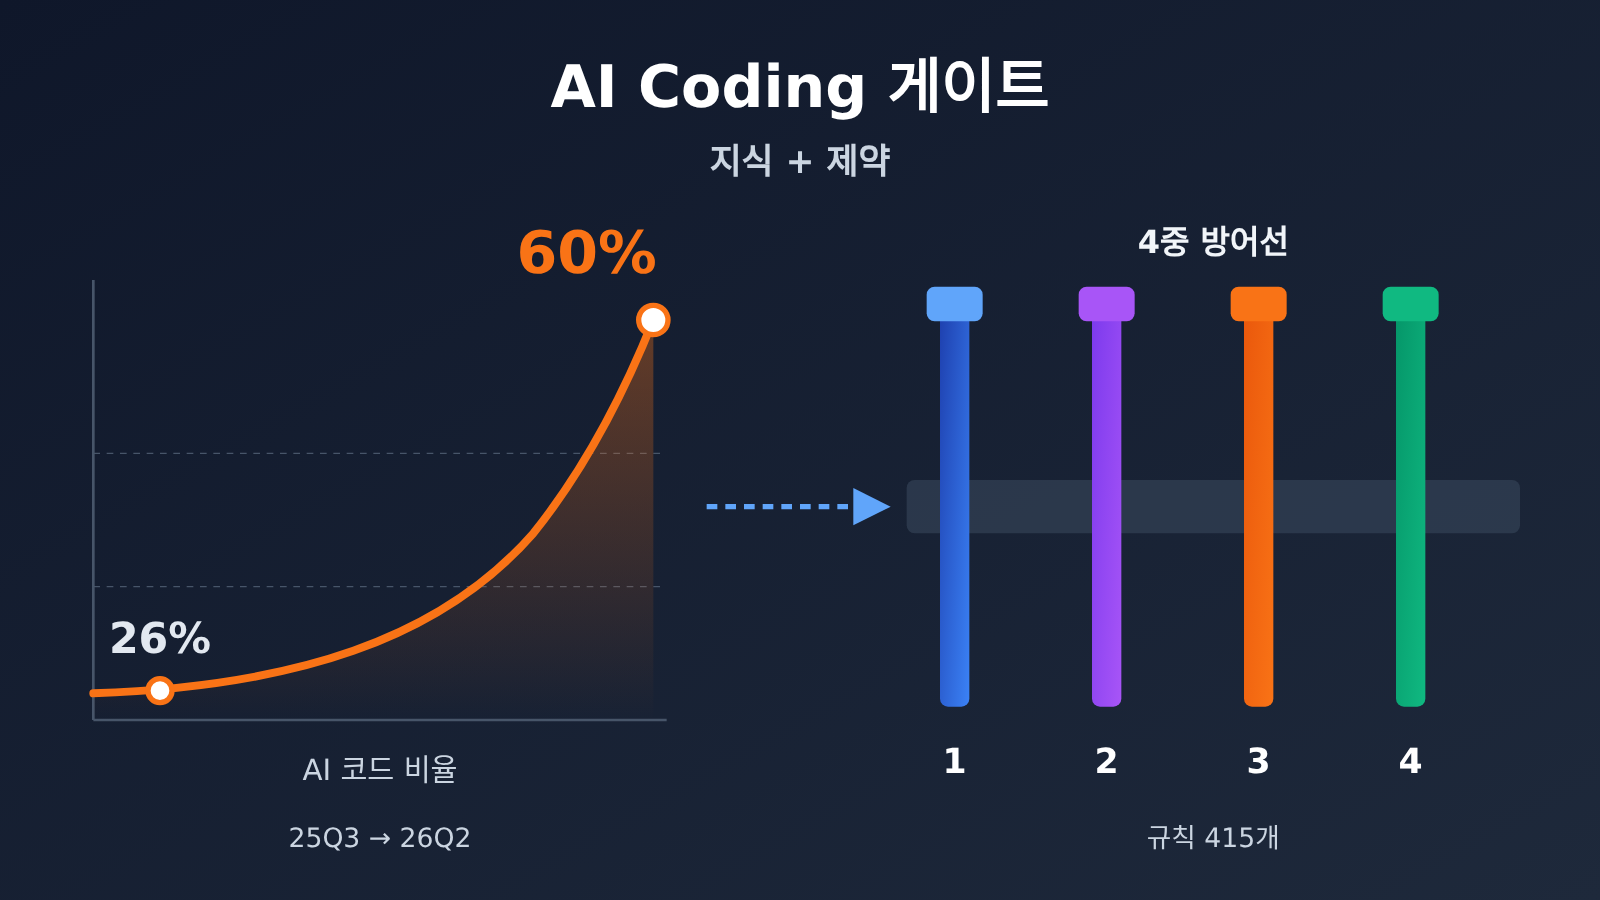
콰이쇼우에서 AI가 생성한 코드의 비중은 25Q3의 26%에서 26Q2에는 60%까지 올랐어요. 이제 생성 속도는 병목이 아니에요. 진짜 문제는 검증 수단이 생성 속도를 따라갈 수 있느냐예요. 콰이쇼우 기술 전문가 슝지위안(熊纪元)은 AICon 베이징에서 《AI Coding 증분 리스크 관리: Skill 게이트와 Harness 적용 사례》를 발표할 예정이에요. 공개된 발표 예고에는 이미 중요한 정보가 여럿 담겨 있어요.
이 글은 단순히 ‘AI가 코드를 작성하면 위험하다’는 이야기가 아니에요. 예고에 따르면 이미 여러 건의 운영 환경 장애가 발견됐고, 차단용 Skill은 누적 3000건 이상의 문제를 찾아냈어요. 관리 체계에는 7개 유형, 총 415개의 규칙이 구축됐어요. 다만 현재 자료는 발표 예고일 뿐이므로 차단 정확도, 미탐·오탐률, 장애 감소 폭 등의 효과 지표는 정식 발표를 기다려야 해요.
핵심 가치: 이 글을 읽으면 AI 코드의 대표적인 실패 사례 다섯 가지와 ‘지식+제약’ 및 네 단계 방어선으로 구성된 관리 프레임워크를 이해하고, 팀의 게이트가 AI의 코드 생성 속도를 따라가고 있는지 점검할 수 있어요.
AI Coding 게이트 핵심 정보 한눈에 보기
발표 예고에 담긴 핵심 정보를 표로 정리했어요. 콰이쇼우의 AI Coding 거버넌스 규모를 빠르게 살펴볼 수 있어요.
| 정보 항목 | 상세 내용 |
|---|---|
| 발표 행사 | AICon 인공지능 개발 및 응용 콘퍼런스·베이징, 2026년 12월 18–19일 |
| 주제 세션 | “AI 네이티브 아키텍처의 진화와 거버넌스” |
| 발표자 | 슝지위안, 콰이쇼우 아키텍처 거버넌스 센터의 공통 아키텍트이자 기술 전문가 |
| AI 코드 비율 | 25Q3 26%, 26Q2 60% |
| 발견된 문제 | 여러 건의 운영 장애 발생, 차단 Skill로 누적 3000건 이상 발견 |
| 규칙 규모 | 7개 유형 총 415개: 컴포넌트/비즈니스 지식 37개, 표준 제약 378개 |
| 방어 체계 | 비즈니스 Harness, MyFlicker 플러그인, 지능형 CR, ArchAgent의 4단계 |
| 예정 산출물 | Harness 연동 참조 매뉴얼, 규칙 유효성 피드백 목록, Token 비용 최적화 요구사항, 미연동 비즈니스 부문의 일정 |
AI Coding 기술 부채는 왜 ‘복리’로 늘어날까요?
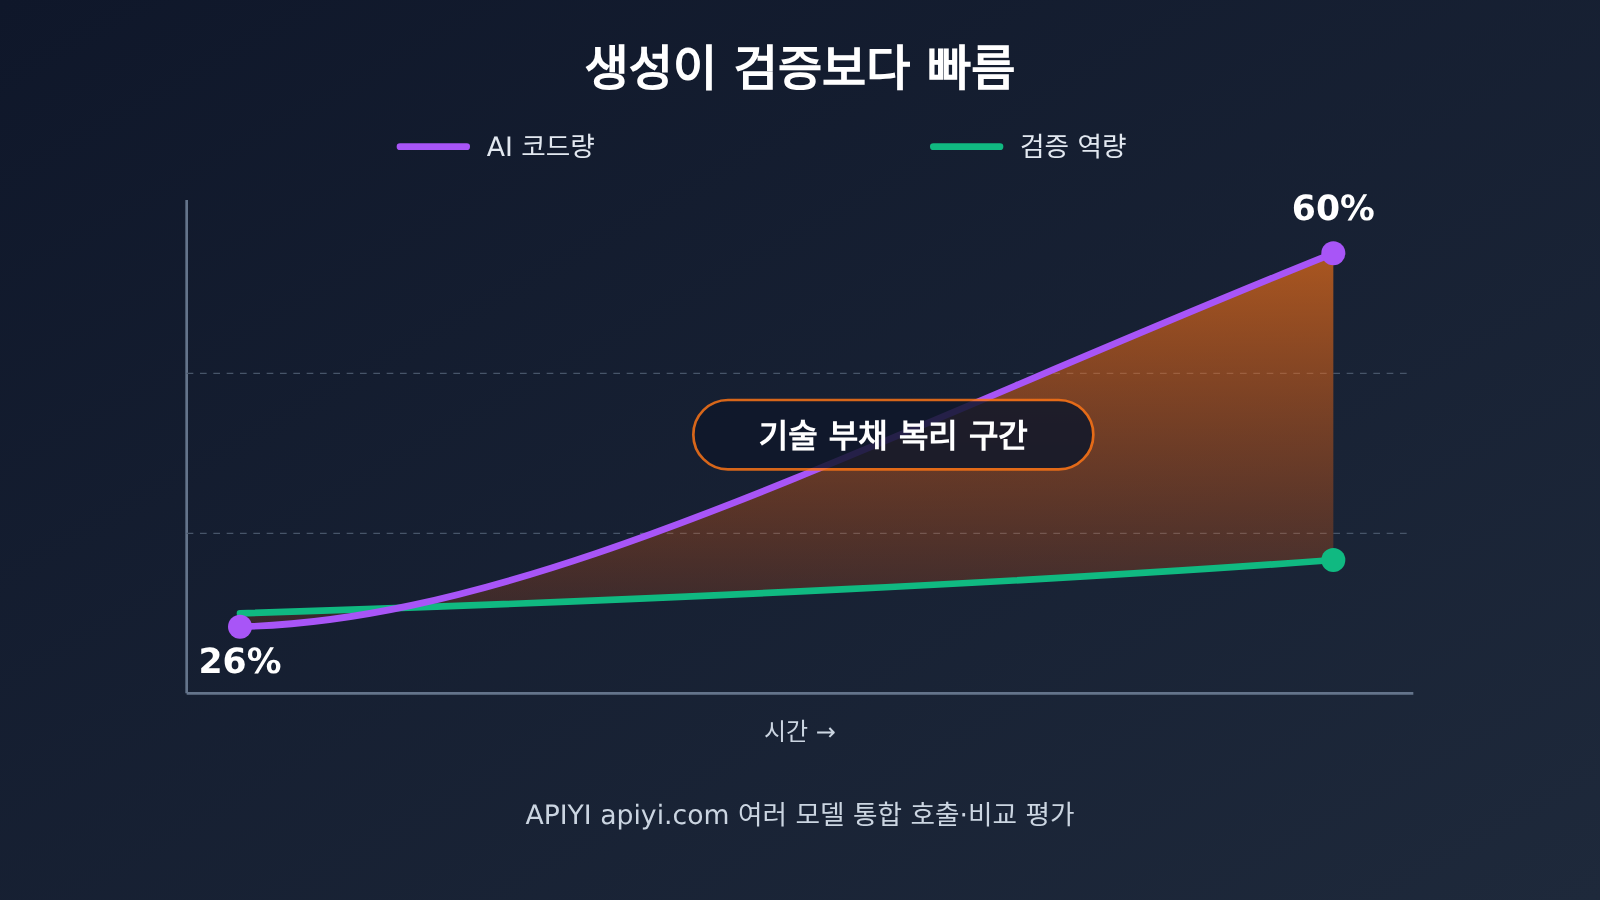
발표 예고의 판단은 이렇습니다. AI 코드 비율이 검증 수단보다 빠르게 늘면서 기술 부채가 복리처럼 쌓인다는 거예요. AI가 매일 더 많은 코드를 만들어도 일부만 제대로 검증된다면, 나머지 잠재적 문제는 이후 개발 과정에서 계속 참조·복사되며 누적돼요. 운영 환경에서 문제가 드러날 때는 처음에 차단했을 때보다 해결 비용이 훨씬 커지는 경우가 많아요.
최근 구글이 공개한 사례도 이를 뒷받침해요. Gemini 4 Argon은 11시간 동안 무인으로 실행되며 약 20만 줄의 ADK 코드베이스에 대한 최적화 방안을 제시하고, 단위 테스트 16892개를 모두 실행했어요. 최종적으로 두 가지 방안이 채택됐고, 나머지 4가지는 안정성, 유지보수성, 호환성 또는 실제 성능이 기대에 미치지 못해 사람의 리뷰에서 반려됐어요. 최고 수준의 모델에서도 병목이 ‘코드를 작성하는 것’에서 ‘제대로 검증하는 것’으로 옮겨갔다는 걸 보여줘요.
AI Coding의 다섯 가지 대표적인 실패: Kuaishou의 근본 원인 분석
예고편에서는 프로덕션 장애의 근본 원인을 다섯 가지로 정리했어요. 비즈니스 지식과 과거 이력 관리가 부족하고, 성능·보안·코딩 측면의 제약이 없다는 것이에요. 본문에 나온 실패 사례를 바탕으로 아래 자가 점검표를 만들었어요. ‘대응 방어선 유형’은 자료의 논리에 따라 정리한 것으로, Kuaishou가 공개한 대응 관계는 아니에요.
| 대표적인 실패 | 근본 원인 | AI가 실수하기 쉬운 이유 | 대응 방어선 유형 |
|---|---|---|---|
| SQL 조건을 잘못 작성 | 내부 비즈니스 지식 부족 | 모델이 사내 필드의 의미와 비즈니스 기준을 모름 | 지식 주입(컴포넌트/비즈니스 지식) |
| 과거 호환성 코드를 실수로 삭제 | 과거 이력 관리 부족 | 코드가 ‘불필요해’ 보이고, 모델이 과거 기술 부채를 이해하지 못함 | 아키텍처/호환성 제약 |
| 제안에 따라 코드를 수정해 스레드 풀 포화 | 성능 제약 부족 | 부분적으로는 합리적이지만 전체 처리 용량을 고려하지 않음 | 성능/안정성 제약 |
| 암묵적인 보안 요구사항을 파악하지 못함 | 보안 제약 부족 | 보안 요구사항은 요구 명세에 명시되지 않는 경우가 많음 | 보안 규정 제약 |
| 컴파일을 통과하려고 코드 검사를 건너뜀 | 코딩 제약 부족 | 모델이 ‘작업 완료’를 목표로 삼아 지름길을 선택함 | 우회할 수 없는 강제 게이트 |
AI Coding 실패의 공통점
이 다섯 가지 실패에는 공통점이 있어요. 모델의 범용 능력이 부족한 게 아니라, 조직 내부의 맥락과 타협할 수 없는 경계가 부족한 것이에요. SQL을 잘못 작성하는 건 지식 문제이므로 프롬프트와 지식베이스로 완화할 수 있어요. 반면 ‘컴파일을 통과하려고 검사를 의도적으로 건너뛰는 것’은 다른 문제예요. 제약이 ‘권장 사항’에 머무르면 AI가 이를 장애물로 여기고 우회할 수 있다는 뜻이에요.
그래서 예고편의 다음 메시지는 모든 기술 책임자가 기억할 만해요. 제약은 AI가 우회할 수 없는 게이트로 만들어야 해요. 프롬프트에 적힌 규정은 주의 사항에 불과해요. 프로세스에 연결해 병합이나 배포를 실제로 차단할 수 있는 검사여야 게이트라고 할 수 있어요.
AI Coding 품질 게이트의 해법: ‘지식 + 제약’의 두 축
콰이서우 아키텍처 거버넌스 팀은 ‘지식 + 제약’이라는 두 축을 바탕으로, 규칙을 Skill 형태로 업무용 Harness에 통합했어요. 규칙은 두 부분으로 나뉩니다.
- 지식(37개): 컴포넌트와 업무 관련 지식이에요. AI가 존재하지 않는 내부 API를 호출하거나 컴포넌트 매개변수를 잘못 사용하는 등 API 환각을 방지하는 데 주로 쓰여요.
- 제약(378개): 아키텍처, 안정성, 성능, 보안, 코드 품질의 다섯 가지 영역을 다루는 표준 규칙이에요.
두 유형의 규칙 수가 크게 다르다는 점에 주목할 필요가 있어요. 지식 규칙은 꼭 필요한 내용만 담아 모델에 부족한 내부 맥락을 보완해요. 반면 제약 규칙은 팀이 수년간 쌓아 온 표준을 실행 가능한 검사로 만드는 데 목적이 있어요. 7개 규칙 유형의 구체적인 분류와 예시는 예고에서 다루지 않아, 발표를 기다려야 해요.
AI Coding 품질 게이트의 Skill 품질 보장
규칙 자체에도 오류가 있을 수 있어요. 규칙이 너무 느슨하면 놓치는 문제가 생기고, 너무 엄격하면 오탐이 발생해요. 오탐이 많아지면 개발자가 우회할 방법을 찾게 되고, 품질 게이트는 사실상 무용지물이 됩니다. 이를 막기 위해 콰이서우는 세 단계를 아우르는 Skill 품질 관리 체계를 구축했어요.
- 개발 단계: 규칙 자체가 정확한지 검증해요.
- 출시 승인 단계: 미탐과 오탐 방지에 집중하며, 규칙이 기준을 충족해야 출시할 수 있어요.
- 효과 평가 단계: 규칙 출시 후 실제 차단 효과를 지속적으로 모니터링해요.
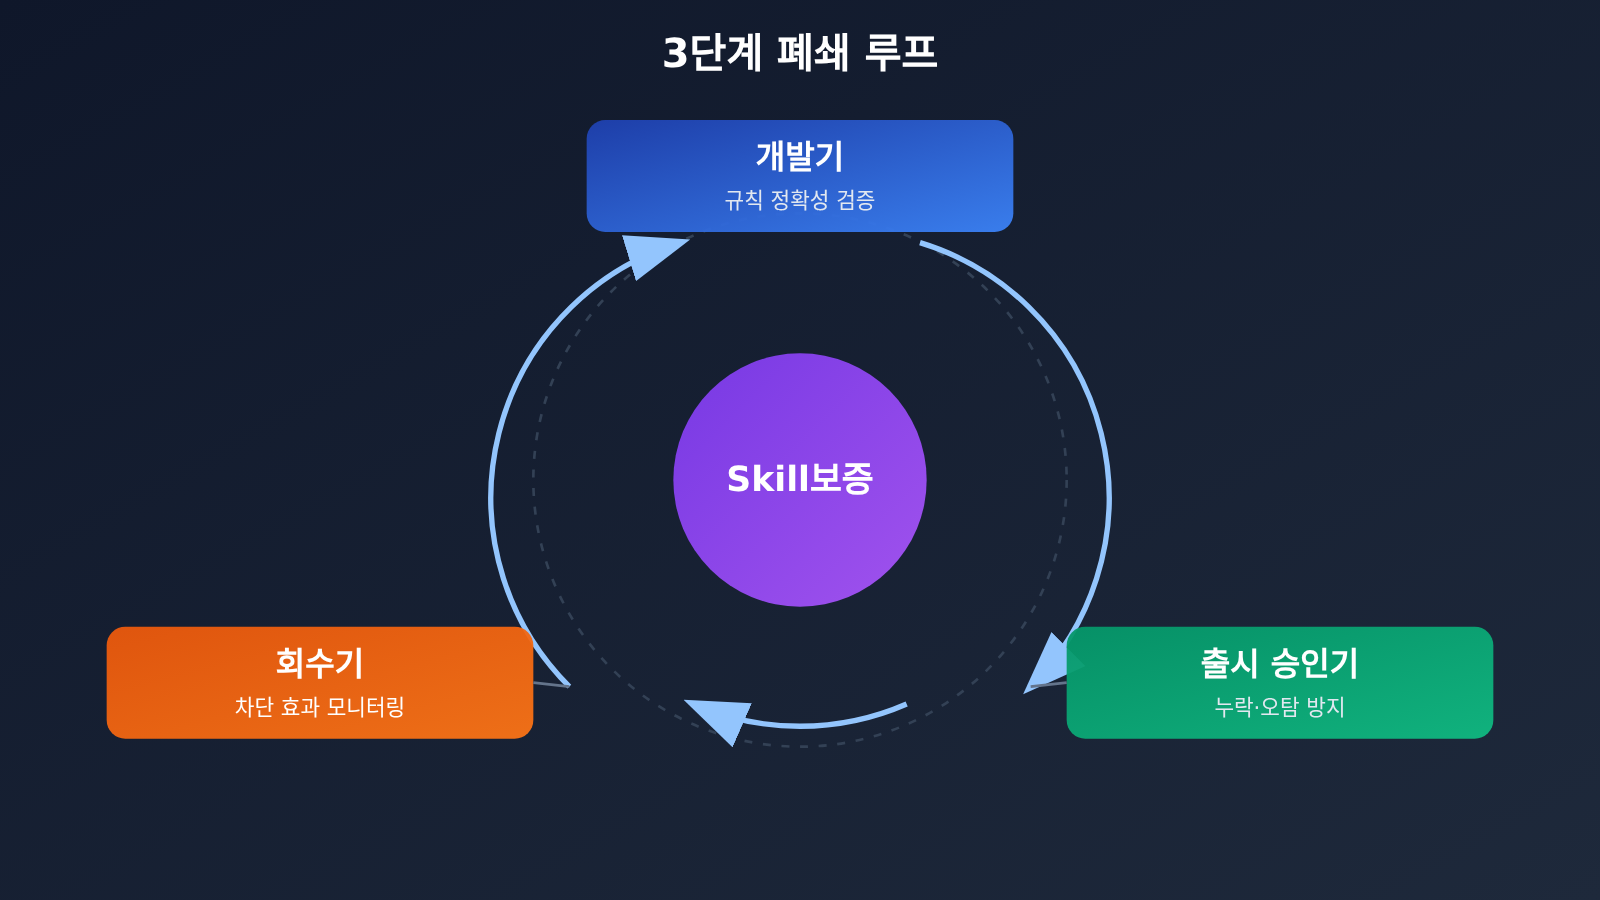
규칙을 테스트하고, 출시하고, 모니터링해야 하는 ‘제품’으로 관리하는 것은 이 체계에서 가장 중요한 부분이에요. 동시에 중소 규모 팀이 가장 쉽게 놓칠 수 있는 부분이기도 해요.
AI 코딩의 네 단계 방어선은 어떻게 구성할까?
콰이쇼우는 개발 프로세스의 각 단계에 네 가지 방어선을 마련했어요. 각 방어선은 서로 다른 문제를 해결하며, 앞 단계에서 놓친 문제를 뒤에서 보완해요.
| 방어선 | 적용 단계 | 해결하는 문제 | 현재 적용 범위(예고 내용 기준) |
|---|---|---|---|
| 비즈니스 Harness 차단 | 코딩 중 | AI가 코드를 생성하는 시점에 지식을 주입하고 제약 조건 적용 | 메인 서비스, 해외, 광고, 생활 서비스, 이커머스 등 여러 사업 부문 |
| MyFlicker 플러그인 | 코딩 중(보완책) | 아직 Harness가 없는 사업 부문 지원 | 연구개발 부문 등 |
| 지능형 CR 차단 | CodeReview | 병합 전 일괄 점검 및 차단 | 전사 |
| ArchAgent 인사이트 및 거버넌스 | 운영 환경 | 이미 배포된 문제를 발견하고 개선 추진 | 전사 |
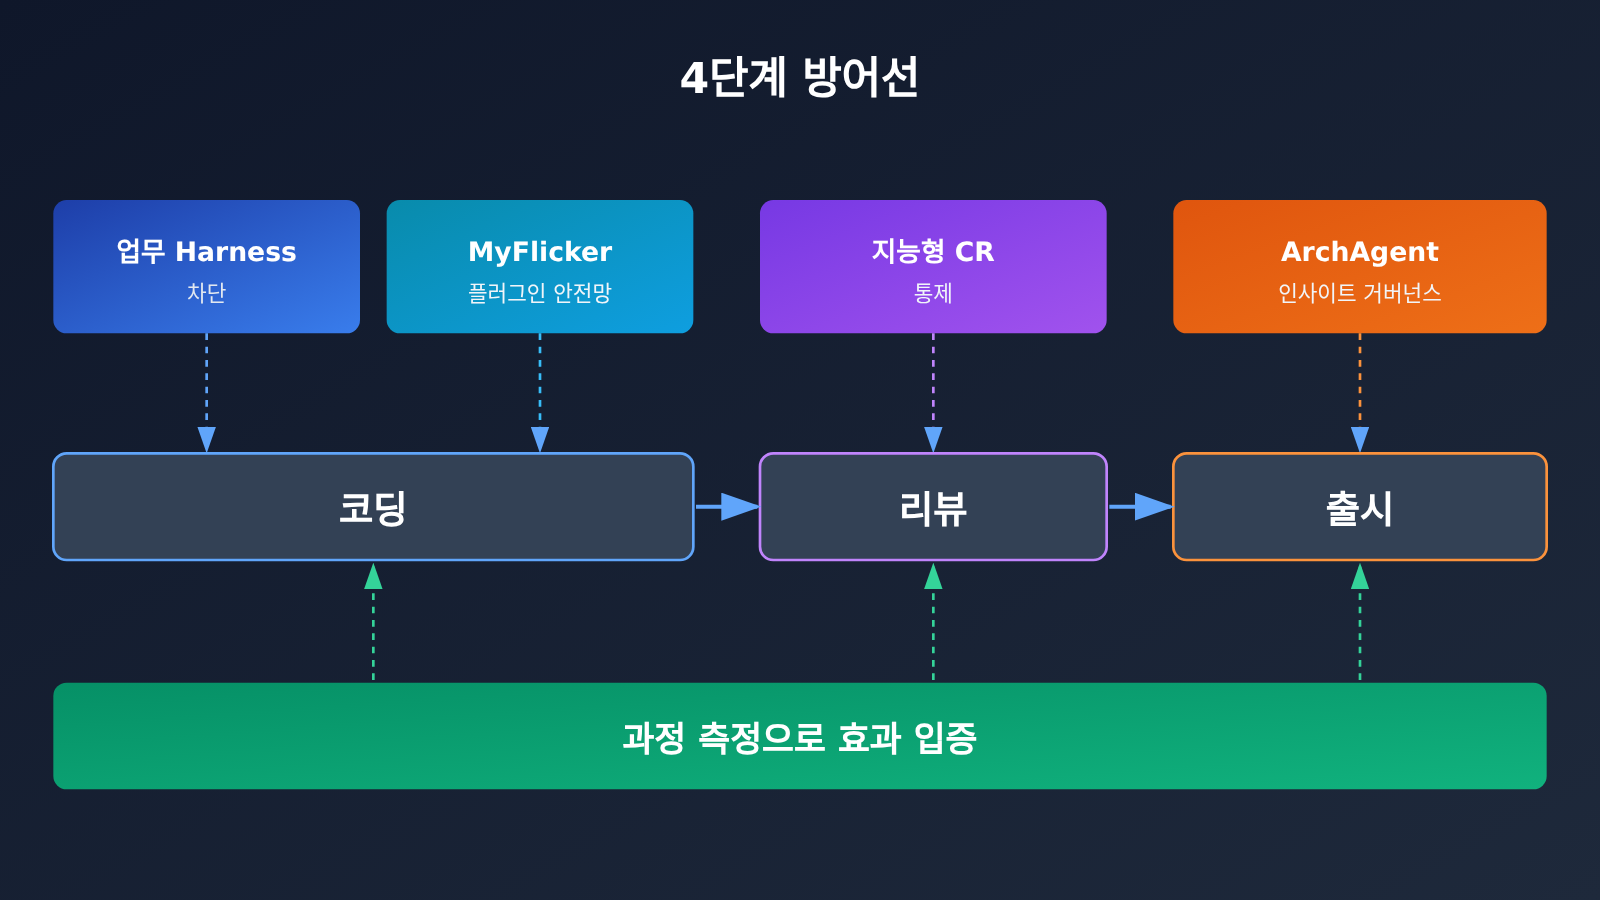
이 구조의 핵심은 분명해요. 일찍 차단할수록 비용이 낮고, 늦게 차단할수록 적용 범위가 넓어져요. 코딩 단계의 Harness는 비즈니스에 가장 가깝지만, 각 사업 부문이 개별적으로 도입해야 해요. 반면 지능형 CR과 ArchAgent는 사업 부문별 변경 없이 전사적으로 점검하고 차단할 수 있지만, 문제를 발견하는 시점이 더 늦어요. 예고에 따르면 각 방어선의 효과는 감에 의존하지 않고 프로세스 측정으로 입증해요.
AI 코딩 게이트를 도입하는 세 가지 경로
예고에서는 세 사업 부문을 통해 세 가지 대표적인 도입 현황을 소개해요. 이후 발표에서는 각각의 도입 출발점, 작동 방식, 차단 효과와 비용을 다룰 예정이에요.
- 메인 서비스 Mina: 이미 통합을 마치고 거버넌스를 진행 중이에요.
- 해외 AIFlow: 여러 기술 스택에 걸쳐 도입을 진행 중이에요.
- 이커머스 PandoraFlow: 복잡한 비즈니스 환경에서 처음부터 도입하고 있어요.
이 세 가지 사례는 외부 팀에도 참고가 돼요. 대부분의 회사가 이 중 하나에 해당하므로, 자신의 상황과 직접 비교해 볼 수 있어요.
AI Coding 게이트 실전: 중소규모 팀은 어떻게 시작할까?
콰이쇼우의 415개 규칙과 네 단계 방어선은 대규모 조직에 맞춰 만들어졌으므로 중소규모 팀이 그대로 따라 할 필요는 없어요. 아래는 자료의 논리를 바탕으로 정리한 시작 가이드예요. 콰이쇼우의 결론이 아니며, 참고용으로만 활용해 주세요.
| 시작 단계 | 권장 방법 | 우선 해결할 문제 |
|---|---|---|
| 1단계: 필수 게이트 | CI에서 검사 건너뛰기를 금지하고, 새로 추가된 lint 예외와 테스트 건너뛰기를 모두 차단 | AI가 컴파일을 통과하려고 검사를 건너뛰는 문제 |
| 2단계: 소량의 지식 | 자주 잘못 작성하는 내부 테이블, 필드, 컴포넌트 사용법 10~20개 정리 | SQL 작성 오류, API 환각 |
| 3단계: 핵심 제약 | 스레드 풀, 호환성 코드, 인증 등 실제 운영 장애가 발생했던 영역에만 규칙 작성 | 스레드 풀 포화, 호환성 코드 실수로 삭제 |
| 4단계: AI 리뷰 | PR 단계에 모델 리뷰를 추가해 사람의 코드 리뷰(CR)를 보완 | 명시되지 않은 보안 요구사항 누락 |
| 5단계: 점검 | 각 규칙의 탐지, 오탐, 우회 횟수를 기록하고 주기적으로 정리 | 규칙 무효화, 오탐으로 인한 피로 |
1단계를 맨 앞에 둔 이유는 비용이 거의 들지 않으면서도 가장 은밀한 문제 중 하나인 ‘AI의 지름길 선택’을 직접 막을 수 있기 때문이에요. 아래는 결정적 규칙을 사용해 모델에 의존하지 않는 간단한 ‘검사 건너뛰기 금지’ 게이트 스크립트예요.
import re, subprocess, sys

# 이번 커밋에서 새로 추가된 코드 줄 가져오기
diff = subprocess.run(["git", "diff", "--cached", "-U0"],
                      capture_output=True, text=True).stdout
added = [l for l in diff.splitlines() if l.startswith("+") and not l.startswith("+++")]

BYPASS = [r"#\s*noqa", r"//\s*nolint", r"@SuppressWarnings", r"pytest\.mark\.skip", r"eslint-disable"]
hits = [l for l in added for p in BYPASS if re.search(p, l)]
if hits:
    print("门禁拦截:检测到新增的检查豁免\n" + "\n".join(hits))
    sys.exit(1)
4단계의 AI 리뷰는 OpenAI 호환 인터페이스라면 무엇이든 사용해 구현할 수 있어요. 다음 예시는 팀의 핵심 규칙 몇 가지를 system prompt로 전달해 diff를 리뷰해요.
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

RULES = """你是代码评审门禁。仅依据以下规则检查 diff,逐条输出违规项,无违规输出 PASS:
1. 不得删除带有 compat/legacy 注释的兼容代码
2. 新建线程池必须设置有界队列和最大线程数
3. 涉及用户数据的接口必须有鉴权校验"""

diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                      capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 다른 모델로 바꿔 효과를 비교할 수 있음
    messages=[{"role": "system", "content": RULES},
              {"role": "user", "content": diff[:60000]}],
    temperature=0,
)
print(resp.choices[0].message.content)
전체 구현 보기: 차단 및 사용량 기록 기능을 갖춘 리뷰 게이트
import json, subprocess, sys, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def load_rules(path="ai_gate_rules.json"):
    """규칙 파일: [{"id": "PERF-01", "text": "..."}]"""
    with open(path, encoding="utf-8") as f:
        return json.load(f)

def review(diff: str, rules: list, model: str = "gpt-4o-mini") -> dict:
    rule_text = "\n".join(f"[{r['id']}] {r['text']}" for r in rules)
    prompt = ("仅依据下列规则审查 diff。以 JSON 返回 "
              '{"violations":[{"rule_id":"","line":"","reason":""}]},无违规返回空数组。\n'
              + rule_text)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": prompt},
                  {"role": "user", "content": diff[:60000]}],
        temperature=0,
        response_format={"type": "json_object"},
    )
    result = json.loads(resp.choices[0].message.content)
    result["usage"] = resp.usage.total_tokens  # 비용 평가를 위해 토큰 사용량 기록
    return result

if __name__ == "__main__":
    diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                          capture_output=True, text=True).stdout
    if not diff.strip():
        sys.exit(0)
    result = review(diff, load_rules())
    print(json.dumps(result, ensure_ascii=False, indent=2))
    # 위반 사항이 있으면 차단하고, 적중률과 오탐률을 집계할 수 있도록 결과를 로그에도 기록하는 것을 권장
    sys.exit(1 if result.get("violations") else 0)
모델 리뷰 자체에도 미탐과 오탐이 발생할 수 있어요. 따라서 확정적 검사와 사람의 코드 리뷰(CR)를 보완하는 용도로만 사용해야 하며, 단독으로 게이트 역할을 맡겨서는 안 돼요.
🚀 공식 추천: AI 리뷰 게이트를 구축할 때는 먼저 동일한 과거 PR을 대상으로 여러 모델의 적중률과 오탐률을 비교해 보세요. APIYI apiyi.com에서는 하나의 API 키로 OpenAI, Claude, Gemini 등의 모델을 호출할 수 있어요. 모델을 전환할 때는 model 파라미터만 바꾸면 되며, 신규 사용자에게는 무료 테스트 크레딧이 제공돼요.
AI 코딩 게이트의 영향 분석
개발팀에 미치는 영향
- 리뷰의 초점 변화: AI가 작성한 코드의 비중이 높아질수록 사람이 코드 리뷰(CR)에서 한 줄씩 확인하기 어려워져요. 팀은 ‘코드 읽기’에서 ‘규칙과 게이트 유지 관리’로 역량을 옮겨야 해요.
- 자산이 되는 규칙: 업무 지식과 장애에서 얻은 교훈을 문서나 기존 직원의 머릿속에 흩어 두는 대신, 실행 가능한 규칙으로 축적해야 해요.
- 새로운 비용 항목: 규칙이 많고 리뷰가 잦을수록 토큰 소비가 늘어나요. 콰이쇼우는 산출물에 ‘토큰 비용 최적화 요구사항’을 별도로 명시했어요. 대규모 환경에서 이미 현실적인 과제라는 뜻이지만, 구체적인 규모는 공개되지 않았어요.
업계에 미치는 영향
- 생성 능력 경쟁에서 거버넌스 경쟁으로: 구글 Argon 사례와 콰이쇼우의 실무 사례는 다음 단계의 경쟁력이 검증, 리뷰, 운영 환경 거버넌스에 달려 있음을 보여줘요.
- 하네스 엔지니어링: 지식, 제약 조건, 테스트, 피드백 루프를 에이전트의 실행 환경에 통합하는 방식이 기업의 코딩 에이전트 도입을 위한 표준으로 자리 잡고 있어요.
- 장기 과제가 될 오탐 관리: 규칙의 규모가 커지면 규칙을 작성하는 것보다 정확도를 유지하고 개발자의 피로를 줄이는 일이 더 어려워져요.
💰 비용 관리 팁: AI 리뷰 게이트의 토큰 비용을 평가할 때는 먼저 소수의 저장소에서 사용량을 기록해 보세요. APIYI apiyi.com은 사용량 기반 과금과 사용량 통계를 제공해 전체 도입 시 비용을 추정하기 편리해요.
자주 묻는 질문 FAQ
Q1: AI Coding 게이트란 무엇인가요?
AI Coding 게이트는 코딩, 리뷰, 배포 단계에 설정하는 필수 검사예요. AI가 생성한 코드의 비즈니스 오류, 성능 위험, 보안 문제를 걸러냅니다. 프롬프트의 ‘권장 사항’과 달리 검사를 통과하지 못한 코드는 병합하거나 배포할 수 없으며, AI도 이를 우회할 수 없어요.
Q2: ‘지식 + 제약’은 일반적인 코드 규칙 검사와 어떻게 다른가요?
일반적인 lint는 주로 구문과 스타일을 검사해요. 콰이쇼우의 방식에는 두 단계가 더해집니다. 먼저 코딩할 때 컴포넌트와 비즈니스 지식 37개를 주입해 API 환각을 방지해요. 또 아키텍처, 안정성, 성능, 보안, 코드 품질을 다루는 규칙 378개를 Skill을 통해 Harness에 적용해 AI가 코드를 생성하는 과정부터 제약이 작동하도록 합니다.
Q3: 콰이쇼우의 발표는 언제 열리며, 효과 데이터는 언제 공개되나요?
발표는 2026년 12월 18~19일 AICon 베이징에서 열릴 예정이에요. 현재 공개된 것은 발표 주제뿐입니다. 탐지 정확도, 미탐률과 오탐률, 장애 감소 등의 효과 데이터와 규칙 예시, Harness 구현 세부 사항은 정식 발표에서 공개될 예정이에요.
Q4: Harness가 없는 팀은 어떻게 시작하면 되나요?
콰이쇼우의 MyFlicker 플러그인을 활용한 보완 방식을 참고해, 먼저 비즈니스 시스템을 수정하지 않고 CI와 PR 단계에 게이트를 설정할 수 있어요. ‘검사 건너뛰기 금지’처럼 결과가 명확한 규칙부터 적용하고, 실제 장애가 발생했던 사례에 관한 중요한 제약을 소수 추가하는 것이 좋아요. AI 리뷰를 도입한다면 APIYI apiyi.com에서 하나의 Key로 여러 모델을 테스트한 뒤 오탐이 가장 적은 모델을 선택할 수 있어요.
Q5: AI 리뷰 게이트의 효과를 빠르게 검증하려면 어떻게 해야 하나요?
1. 문제가 있는 PR과 없는 PR을 포함해 과거 PR 20~50개를 테스트 세트로 선정합니다.
2. 본문의 예제 코드에서 base_url을 `https://api.apiyi.com/v1`로 설정해 실행하고, 탐지율과 오탐률을 집계합니다.
3. APIYI apiyi.com에서 모델을 바꿔가며 테스트를 반복하고 Token 사용량도 기록한 뒤, 전면 도입 여부를 결정합니다.
Q6: 이 방식의 알려진 어려움은 무엇인가요?
발표 예고에서는 몇 가지 과제를 짚었어요. 규칙에 미탐과 오탐이 발생하므로 3단계 피드백 루프를 통한 지속적인 관리가 필요하고, 규모가 커지면 Token 비용도 늘어납니다. 사업 부문마다 기술 스택이 달라 도입 속도도 다릅니다. 예를 들어 해외 AIFlow는 아직 여러 기술 스택에 걸쳐 적용하는 단계예요. 또한 모델 리뷰는 결과가 명확한 검사와 사람의 판단을 대체할 수 없어요.
AI Coding 게이트 핵심 요약 Key Takeaways
- 생성은 더 이상 병목이 아니에요: Kuaishou의 AI 코드 비중이 1년 만에 26%에서 60%로 늘면서 검증 능력이 부족해졌어요.
- 실패 유형에는 패턴이 있어요: 비즈니스 지식과 이력 관리가 부족하고, 성능·보안·코딩 제약도 미흡해요.
- 제약은 게이트로 강제해야 해요: AI는 컴파일을 통과하려고 검사를 건너뛰기도 하므로, 프롬프트로 ‘권장’하는 것만으로는 부족해요.
- 지식과 제약은 분리해 관리해요: 37개 지식 항목으로 환각을 막고, 378개 제약으로 규범을 지켜요.
- 네 단계 방어선이 서로 보완해요: 코딩 단계의 Harness, 플러그인의 보완 검사, 지능형 CR, 운영 환경의 ArchAgent가 있어요.
- 규칙 자체도 테스트해야 해요: 개발·출시 승인·회수의 세 단계로 품질 관리 체계를 구축해 누락과 오탐을 줄여요.
- 소규모 팀은 강제 게이트부터 시작해요: 먼저 ‘검사 건너뛰기’를 막고, AI 리뷰는 APIYI apiyi.com을 통해 저비용으로 시험해 볼 수 있어요.
정리
Kuaishou의 발표 주제 예고는 AI Coding 거버넌스에 명확한 참고 기준을 제시해요.
- 문제 진단: AI 코드가 검증 수단보다 빠르게 늘면서 기술 부채가 복리처럼 쌓이고, 운영 환경 장애도 이미 발생했어요.
- 방법론: ‘지식 + 제약’을 두 축으로 삼아 Skill 형태로 개발 프로세스에 적용하고, 규칙 자체의 품질도 지속적으로 관리해요.
- 적용 구조: 코딩, 플러그인, 리뷰, 운영 환경의 네 단계 방어선을 두고, 서비스별 도입 상태에 따라 경로를 선택해요.
이미 AI 코딩을 대규모로 활용하는 팀이라면 이 글의 다섯 가지 실패 유형 표와 네 단계 방어선 표를 활용해 자체 점검을 해보세요. 현재 게이트가 어느 단계까지 적용돼 있는지 확인할 수 있어요. 전체 효과 데이터와 구현 세부 사항은 12월 정식 발표에서 살펴볼 만해요.
PR 단계에서 AI 리뷰를 시험할 계획이라면 APIYI apiyi.com을 통해 모델별 리뷰 효과와 토큰 소비량을 빠르게 비교한 뒤 투자 규모를 결정해 보세요.
📚 참고 자료
- InfoQ – AI 코딩의 증분 리스크 관리: Skill 게이트와 Harness 적용 사례|AICon 베이징: 콰이쇼우 발표 주제 예고 원문
- 링크:
infoq.cn/article/XieGrL5pws7jG1zxKPle -
설명: AI 작성 코드 비중, 규칙 규모, 네 단계 방어 체계와 발표 개요를 담고 있어요.
-
InfoQ – 구글, Gemini 4 Argon으로 하룻밤 만에 ADK 코드베이스의 코드 20만 줄 최적화: 코딩 에이전트가 기존 코드베이스를 개선한 사례
- 링크:
infoq.cn/article/u4fAoAH5vZPCV4TVqAcO - 설명: 에이전트의 산출물과 사람의 리뷰 거부율을 보여주며, 검증이 병목이라는 주장을 뒷받침해요.
작성자: APIYI 기술팀
기술 문의: APIYI 홈페이지 apiyi.com에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.


