
작성자 주: 텐센트 글로벌 디지털 생태계 콘퍼런스에서 나온 “개인의 생산성 향상이 곧 조직의 역량 강화는 아니다”라는 말을 바탕으로, 팀이 AI를 사용할 때 모델 호출 계층에 먼저 마련해야 할 5가지 관리 체계를 살펴봐요.
2026년 11월 초 열린 텐센트 글로벌 디지털 생태계 콘퍼런스에는 AI 제품 전용 발표 무대가 마련됐어요. 이틀 동안 40여 차례의 제품 발표가 이어졌는데요. 그중 주목할 만한 이야기가 있었어요. 개인의 생산성이 높아진다고 조직이 강해지는 것은 아니며, 그 사이에는 조직 차원의 역량이 필요하다는 말이에요. 텐센트 클라우드 부총경리이자 WorkBuddy 기업용 제품 책임자인 장시야오가 한 이야기예요.
이번 글은 또 하나의 에이전트 제품 발표를 정리한 글이 아니에요. 그보다 근본적인 문제를 다뤄보려 해요. 개인의 AI 활용이 팀 단위로 확대되면 구성원들은 같은 모델을 공유해요. 누가 모델을 호출할 수 있는지, 각자 얼마나 사용했는지, 어느 프로젝트에 비용이 들었는지부터 모델 호출 계층에서 관리해야 해요.
핵심 내용: 이 글은 팀에 AI를 도입하기 전에 무엇을 확인해야 하는지 알려드려요. 모델 연동, 키와 권한, 비용 집계, 호출 추적, 경험 재사용을 살펴보고, 통합 게이트웨이로 해결할 수 있는 문제와 없는 문제도 구분해요.
팀의 AI 활용 핵심 정보 요약
먼저 이번 논의의 배경을 정리해 볼게요. 아래 표의 정보는 모두 GeekPark의 행사 보도에서 가져왔어요.
| 항목 | 내용 |
|---|---|
| 행사 | 텐센트 글로벌 디지털 생태계 대회 AI 제품 발표 세션: 이틀간 7개 주제, 40건 이상의 제품 발표 |
| 핵심 판단 | 개인의 생산성 향상이 곧 조직의 역량 강화로 이어지는 것은 아니며, 그 사이에는 조직 차원의 역량이 필요함 |
| 엔터프라이즈 버전 주요 업그레이드 | 오픈 플랫폼으로 업무 시스템 연결, 권한·실행 과정·사용 비용을 관리하는 엔터프라이즈 보안 솔루션과 관측 센터, 연중무휴 24시간 운영을 지원하는 호스팅 에이전트 |
| 함께 제공되는 제품군 | Buddy One은 통합 계정, 공유 Credit 풀, 중앙 집중식 관리를 제공해 기업의 AI 설정과 확산에 따르는 복잡성을 낮추는 것을 목표로 함 |
| 도입 사례 | 쑤닝은 14개 부서, 48개 협업 시나리오를 아우르는 조직 차원의 에이전트 플랫폼을 구축하고 재사용 가능한 에이전트 36개를 확보함 |
| 규모 확장의 과제 | Agent마다 독립적인 실행 환경이 필요하다면 디지털 직원 10만 개를 운영하는 데 샌드박스 10만 개가 필요할 수 있음 |
팀이 AI를 활용할 때 마주하는 세 가지 현실적인 문제
보도에 따르면 기업이 Agent를 확산하려면 세 가지 질문에 답해야 해요. Agent가 기존 시스템에 연결하고 필요한 데이터에 접근할 수 있을까요? 직원과 Agent별 권한은 어떻게 관리할까요? 한 사람이 찾아낸 좋은 방법을 다른 사람들도 바로 사용하려면 어떻게 해야 할까요? 이 세 가지는 어떤 회사의 제품을 쓰든 AI 확산을 준비하는 모든 팀에 해당해요.
주목할 점은 엔터프라이즈 버전 업그레이드에서 ‘권한, 실행 과정, 사용 비용’을 같은 모듈에서 다뤘다는 거예요. 공유 Credit 풀도 AI 확산의 복잡성을 낮추는 수단으로 여겼고요. 이는 AI가 개인 도구에서 팀 자원으로 바뀌면 접근 제어와 비용 집계가 사후 보완 사항이 아니라 인프라 문제가 된다는 뜻이에요.
모델 호출 계층이 팀의 AI 활용에서 첫 관문인 이유
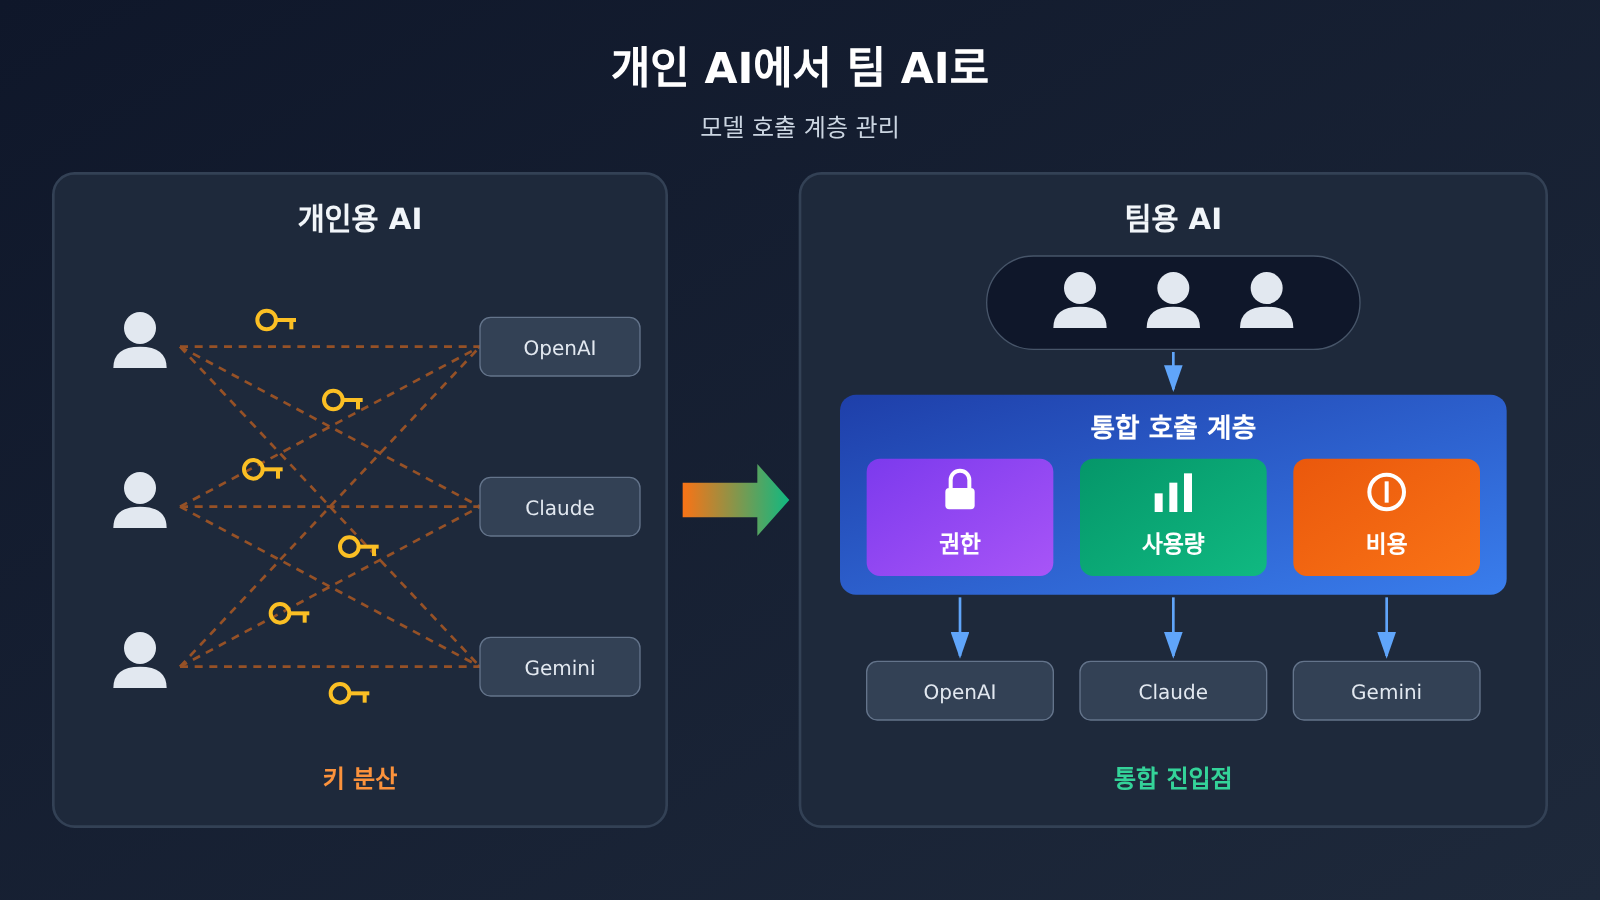
개인이 AI를 사용할 때는 보통 각자 몇 개의 모델 서비스에 가입하고, 카드를 등록하고, API 키를 관리해요. 호출 주소도 자신의 스크립트나 도구에 직접 적어두죠. 탐색 단계에서는 효율적인 방식이지만, 팀원이 늘어나면 문제가 한꺼번에 드러나요.
흔히 이런 혼란이 생겨요. API 키가 개인 컴퓨터와 채팅 기록에 흩어져 있어 퇴사자가 업무를 인계할 때 사용 중인 키가 몇 개인지 파악하기 어렵고, 월말 청구서에서는 총액만 보여 어느 프로젝트나 사용자가 얼마나 썼는지 알 수 없어요. 특정 모델에 갑자기 오류가 발생하거나 가격이 오르면 호출 주소를 직접 적어둔 곳을 일일이 수정해야 하죠. 이런 문제는 Agent의 성능과 관계없이, 모델 호출 계층을 통합 관리하지 못해서 생겨요.
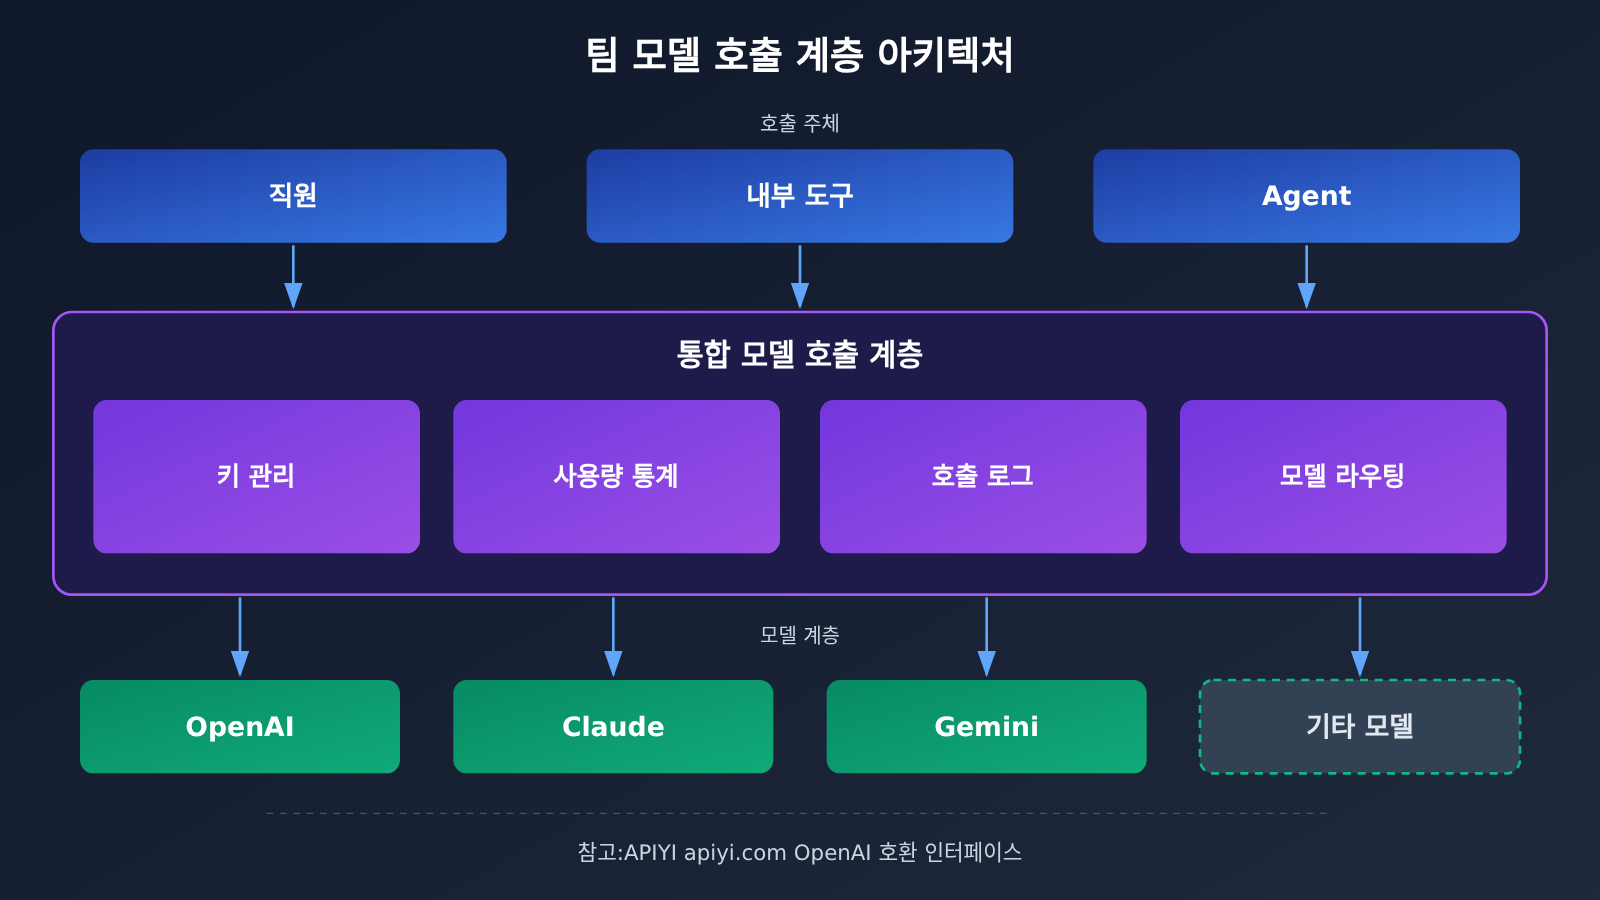
호출을 하나의 계층으로 모으면 팀 전체에 규칙을 일관되게 적용할 수 있어요. ‘먼저 관리한다’는 것은 처음부터 복잡한 승인 절차를 만든다는 뜻이 아니에요. 우선 모든 호출이 같은 진입점을 거치도록 해야 이후 권한, 사용량, 비용 관리도 할 수 있어요.
팀에서 AI를 도입하기 전 확인할 모델 호출 계층 체크리스트 5가지
이 체크리스트는 특정 업체에 종속되지 않아요. 자체 구축 게이트웨이, 클라우드 업체의 솔루션, 서드파티 통합 플랫폼을 평가할 때 두루 활용할 수 있어요.
| 확인 항목 | 답해야 할 질문 | 최소한의 실행 방안 |
|---|---|---|
| 1. 모델 연동 | 팀에 어떤 모델이 필요한가요? 모델을 바꾸려면 코드를 얼마나 수정해야 하나요? | OpenAI 호환 인터페이스로 통일하고, 모델 이름을 설정 항목으로 관리해요 |
| 2. 키와 권한 | 누가 키를 보유하고 있나요? 퇴사나 유출 시 빠르게 폐기할 수 있나요? | 프로젝트나 서비스별로 키를 발급하고, 개인 키는 프로덕션 코드에 사용하지 않아요 |
| 3. 비용 집계 | 프로젝트와 팀별로 비용이 얼마나 들었나요? | 최소한 키나 프로젝트별로 사용량을 구분하고, 매월 청구 내역을 확인해요 |
| 4. 호출 추적 | 문제가 생겼을 때 어떤 모델의 어떤 호출에서 발생했는지 찾을 수 있나요? | 요청 시간, 모델, 토큰 수, 호출자 식별자를 기록해요 |
| 5. 경험 재활용 | 좋은 프롬프트와 작업 절차를 다른 사람도 바로 사용할 수 있나요? | 검증된 프롬프트와 파라미터를 공유 템플릿이나 내부 서비스로 만들어 관리해요 |
확인 항목 1~2: 모델 연동과 키 권한
모델 연동의 핵심은 ‘교체 가능성’이에요. 모델마다 잘하는 작업이 다르고, 가격과 안정성도 달라질 수 있어요. 비즈니스 코드가 하나의 호환 인터페이스에만 의존하고 모델 이름을 설정에서 관리한다면, 모델을 바꿀 때 다시 개발할 필요 없이 설정만 변경하면 돼요.
키 권한의 핵심은 ‘회수 가능성’이에요. 팀 전체가 하나의 슈퍼 키를 공유하기보다 서비스마다 키를 하나씩 발급하고, 프로젝트마다 사용 한도를 따로 설정하는 것이 좋아요. 이렇게 하면 키가 유출돼도 영향 범위가 해당 서비스로 제한되고, 키를 폐기해도 다른 서비스에는 영향을 주지 않아요.
확인 항목 3~5: 비용 집계, 호출 추적과 경험 재활용
비용 집계는 AI 투자의 가치를 현업에서 인정받을 수 있는지 좌우해요. 전체 청구액만 볼 수 있다면 어떤 활용 사례가 실제로 가치를 창출했는지 판단할 수 없고, 경영진에게 예산을 요청하기도 어려워요. 호출 추적은 문제 해결의 기본이에요. 사용자가 “AI 답변이 틀렸다”고 알려주면, 해당 호출에 어떤 모델을 사용했고 무엇을 입력했는지 찾을 수 있어야 해요.
경험 재활용은 쑤닝 사례의 접근 방식과 같아요. 신제품 출시 절차를 템플릿으로 정리하고 진행 과정에서 만든 파일을 지식 베이스에 포함한 결과, 준비 시간이 영업일 기준 3일에서 4시간으로 줄었어요. 업무 방식도 보존해 다음에 바로 활용할 수 있게 됐죠. 모델 호출 계층에서는 검증된 프롬프트, 모델 선택과 파라미터 조합을 개인의 노하우로만 남겨두지 않고 함께 사용할 수 있도록 묶어 관리하는 것을 뜻해요.
팀을 위한 AI 통합 호출 예제
다음은 OpenAI 호환 인터페이스로 모델을 호출하는 최소 예제예요. 모델 이름을 환경 변수에서 읽어 팀 전체가 쉽게 모델을 전환할 수 있어요.
import os
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),      # 프로젝트별로 발급한 키
    base_url="https://api.apiyi.com/v1"          # APIYI 통합 인터페이스
)

resp = client.chat.completions.create(
    model=os.getenv("DEFAULT_MODEL", "gpt-4o-mini"),
    messages=[{"role": "user", "content": "总结本周项目进展"}]
)
print(resp.choices[0].message.content)
호출 기록을 남기는 팀용 래퍼 버전 보기
import os
import time
import json
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),
    base_url="https://api.apiyi.com/v1"  # 하나의 키로 여러 제공업체의 모델 호출
)

def team_chat(prompt: str, project: str, caller: str,
              model: str = None, max_tokens: int = 1000) -> str:
    """팀 통합 호출 진입점: 프로젝트, 호출자, 모델, 토큰 사용량 기록"""
    model = model or os.getenv("DEFAULT_MODEL", "gpt-4o-mini")
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    usage = resp.usage
    record = {
        "ts": int(start),
        "project": project,
        "caller": caller,
        "model": model,
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "latency_ms": int((time.time() - start) * 1000),
    }
    # 로컬 로그에 기록하고, 나중에 보고서로 가져와 프로젝트별 비용 집계
    with open("ai_usage.log", "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.choices[0].message.content

print(team_chat("生成一份周报大纲", project="marketing", caller="alice"))
이 래퍼는 애플리케이션 측에서 ‘프로젝트’와 ‘호출자’ 정보를 추가해요. 플랫폼에서 사용량 통계를 제공하더라도 자체 호출 기록을 남기는 것이 유용해요. 각 호출이 어떤 업무에 속하는지는 자체 시스템만 알 수 있기 때문이에요.
🚀 빠른 시작: 팀원마다 각자 키를 쓰고 있다면, APIYI apiyi.com에서 API 키 하나로 OpenAI, Claude, Gemini 등 주요 모델에 통합 접속할 수 있어요. OpenAI 호환 인터페이스와 사용량 기반 과금을 제공하며, 신규 사용자에게 무료 테스트 할당량도 있어 통합 호출 진입점을 먼저 구축해 보기에 좋아요.
통합 모델 호출 계층으로 해결할 수 있는 것과 없는 것
많은 팀이 통합 게이트웨이를 ‘AI 거버넌스의 완전한 해답’으로 생각하기 쉬워요. 하지만 실제로는 모델 호출 계층만 담당해요. 아래 표에서 그 범위를 살펴볼게요.
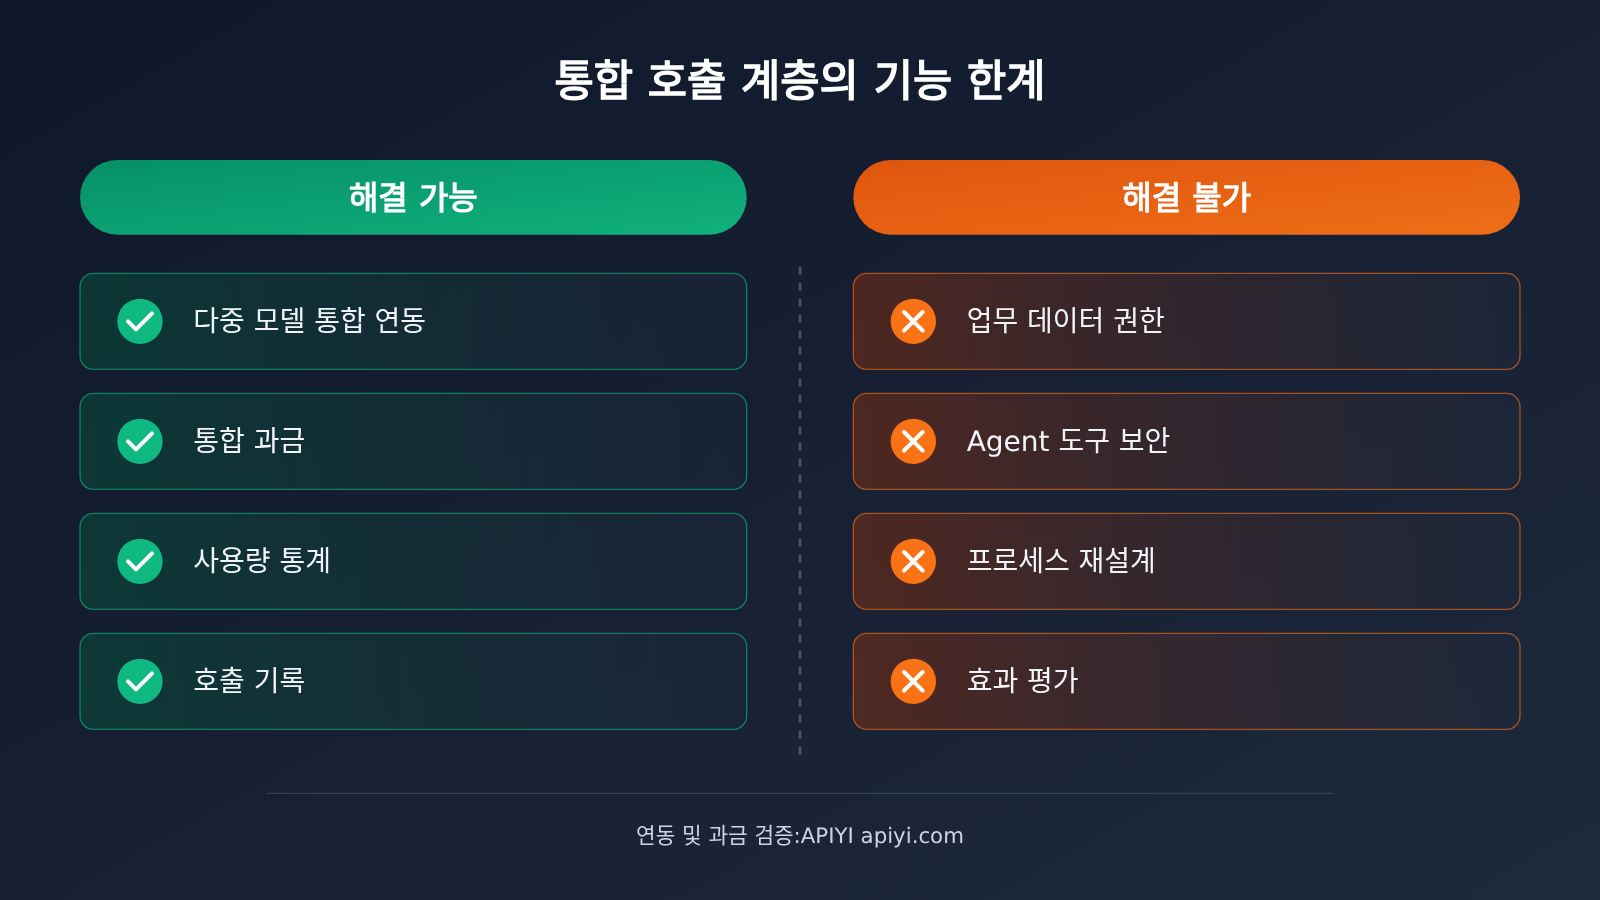
| 항목 | 통합 호출 계층으로 할 수 있는 것 | 다른 영역에서 담당해야 할 것 |
|---|---|---|
| 모델 연동 | 하나의 인터페이스로 여러 업체의 모델을 호출하고 적은 비용으로 전환 | 어떤 모델이 어떤 업무에 적합한지 판단 |
| 비용 | 잔액 통합 관리와 사용량 기반 과금으로 비용 집계 | 비용을 비즈니스 성과와 연결하고 ROI 평가 |
| 권한 | ‘누가 모델을 호출할 수 있는지’ 관리 | ‘Agent가 어떤 데이터를 읽고 어떤 작업을 수행할 수 있는지’ 관리 |
| 추적 | 호출에 사용된 모델, 토큰, 시간 기록 | Agent의 전체 실행 흐름과 결과 품질 추적 |
| 재사용 | 안정적인 호출 인터페이스 제공 | 프롬프트, 프로세스 템플릿, 지식 베이스 축적 |
텐센트가 콘퍼런스에서 보안 솔루션, 관측성 센터, Agent Runtime, 지식 제품을 함께 발표한 이유도 여기에 있어요. 보도에 따르면 Agent는 도구를 자율적으로 호출하고, 데이터에 접근하며, 코드까지 실행할 수 있어요. 따라서 작업 범위를 제한하고 민감한 정보를 보호하며, 문제가 발생했을 때 원인을 추적하는 일이 모두 중요해요. 이런 문제는 Agent 실행 계층과 데이터 계층에 속하기 때문에 모델 게이트웨이로는 관리할 수 없어요.
따라서 합리적인 순서는 먼저 모델 호출 계층을 통합해 접근과 지출 현황을 파악하고, 그 위에 데이터 접근 권한, Agent 보안, 프로세스 개선을 더하는 것이에요. 기반 계층이 보이지 않으면 상위 계층의 거버넌스도 제대로 시작하기 어려워요.
팀의 AI 활용이 미치는 영향 분석
기술 책임자에게 미치는 영향
- 아키텍처에 통합 접점을 마련해야 해요: 새 프로젝트에 대규모 언어 모델을 연동할 때 특정 업체의 공식 주소를 하드코딩하지 말고, 팀이 정한 호환 인터페이스를 통일해서 사용하세요.
- API 키 관리를 운영 업무에 포함해야 해요: API 키는 데이터베이스 비밀번호처럼 관리하고, 발급·교체·폐기 이력을 남겨야 해요.
- 로그 필드를 미리 설계해야 해요: 최소한 프로젝트, 호출 주체, 모델, Token 사용량을 서로 연결할 수 있어야 해요. 그렇지 않으면 월말에 비용을 정산할 때 수습하기 어려워요.
비즈니스 의사결정자와 구매 담당자에게 미치는 영향
팀에서 AI 기능을 도입할 때 평가 기준은 ‘어떤 모델이 가장 뛰어난가’에서 ‘제대로 관리할 수 있는가’로 바뀌어요. 아래 표는 팀의 단계별로 중점을 둘 사항을 정리한 것으로, 도입 계획을 세울 때 참고할 수 있어요.
| 팀 단계 | 일반적인 상황 | 모델 호출 계층의 우선 과제 |
|---|---|---|
| 개인 탐색 | 소수의 인원이 자비로 사용해 보고 각자 키를 보유 | 통합 인터페이스를 정하고 분산된 계정 정리 |
| 소규모 팀 시범 도입 | 한두 개 프로젝트가 AI에 의존하기 시작 | 프로젝트별 키 발급 및 기본 사용량 통계 마련 |
| 부서 도입 확대 | 여러 사업 부문에서 동시에 호출 | 프로젝트별 비용 집계 및 호출 기록 검색 |
| 조직 전체 적용 | Agent가 핵심 업무 프로세스에 도입 | 데이터 접근 권한, Agent 보안 및 효과 평가 추가 |
구매 담당자는 결제와 증빙 서류 처리 절차가 회사의 재무 요건에 맞는지도 확인해야 해요. 플랫폼의 권한 설정 단위, 로그 필드, 보관 기간, 내보내기 방식도 살펴봐야 해요. 이런 세부 사항은 플랫폼마다 차이가 크므로 계약 전에 서비스 제공업체에 하나씩 확인하고, 공식 문서를 기준으로 판단하는 것이 좋아요.
업계에 미치는 영향
행사에서 Buddy One이 공유 Credit 풀과 중앙 집중식 관리를 제안한 것은 ‘모델 사용 한도를 팀의 공유 자원으로 통합 배분한다’는 발상이 기업용 AI 제품의 표준이 되어 가고 있음을 보여줘요. 대형 업체의 제품군이든 독립 모델 통합 플랫폼이든, 사용량 확인과 비용 집계는 기업 고객에게 선택이 아닌 기본 요건이 될 것으로 보여요.
💡 선택 가이드: 본격적으로 도입하기 전에 실제 업무 데이터로 소규모 시범 운영을 해보세요. APIYI apiyi.com을 통해 여러 업체의 모델을 호출하고, 같은 작업에서 모델별 성능과 Token 사용량을 비교한 뒤 팀의 기본 모델을 결정할 수 있어요.
자주 묻는 질문 FAQ
Q1: 팀에서 AI를 사용할 때 ‘모델 호출 계층 거버넌스’란 무엇인가요?
팀의 대규모 언어 모델 접근 방식을 통합 관리하는 것을 말해요. 어떤 모델을 쓰는지, 누가 API 키를 보유하는지, 프로젝트별 사용량은 얼마인지, 각 호출을 추적할 수 있는지 등을 관리합니다. Agent의 비즈니스 로직을 담당하는 대신, 모든 호출이 관리 가능한 단일 진입점을 거치도록 해요.
Q2: 통합 모델 호출 계층과 기업용 Agent 플랫폼은 어떻게 다른가요?
기업용 Agent 플랫폼은 Agent가 업무 시스템과 연결되고, 데이터에 접근하고, 협업하며 장시간 실행되는 방식에 초점을 맞춰요. 모델 호출 계층은 그중 ‘모델 호출’ 단계만 다룹니다. 전자가 더 넓은 범위를 다루지만, 하위 모델 접근의 안정성과 제어 가능성에도 의존해요. 두 계층은 서로 대체하는 관계가 아니라 상하 관계입니다.
Q3: 소규모 팀도 지금부터 이런 관리 체계를 갖춰야 하나요?
네, 다만 가볍게 시작해도 돼요. 소규모 팀이 먼저 할 만한 일은 호출 인터페이스를 통일하고 개인 API 키가 프로덕션 코드에 들어가지 않도록 하는 거예요. 두 가지 모두 비용이 적게 들지만, 팀이 커진 뒤에 바로잡으려면 훨씬 번거로워요.
Q4: 팀이 함께 쓸 통합 모델 호출 진입점을 빠르게 구축하려면 어떻게 하나요?
OpenAI 호환 통합 플랫폼을 이용하는 것이 간단한 방법이에요. 예를 들어 APIYI apiyi.com에 가입해 API 키를 발급받고 코드의 base_url을 `https://api.apiyi.com/v1`로 바꾸면, 같은 코드로 OpenAI, Claude, Gemini 등의 모델을 호출할 수 있어요. 여기에 본문의 래퍼 함수를 활용하면 프로젝트별 사용량도 기록할 수 있습니다.
Q5: 통합 플랫폼이 팀의 권한 시스템을 직접 대체할 수 있나요?
완전히 대체할 수는 없어요. 플랫폼은 모델 접근과 과금을 관리할 수 있지만, 구성원별·프로젝트별 권한 세분화, 사용 한도, 로그 보존 정책은 플랫폼마다 다르므로 문서를 확인해야 해요. 업무 데이터와 Agent 작업에 대한 권한은 기업 자체 시스템에서 관리해야 합니다. 구체적인 기능은 APIYI apiyi.com 문서 센터에서 확인한 뒤 계획하세요.
팀의 AI 모델 호출 계층 핵심 요점 Key Takeaways
- 개인의 생산성 향상이 곧 조직의 역량 강화는 아니에요: 팀이 모델 기능을 함께 사용하면 모델의 성능보다 관리 문제가 먼저 드러나요.
- 거버넌스보다 먼저 호출 경로를 통일하세요: 모든 호출이 같은 계층을 거쳐야 권한과 비용 규칙을 적용할 수 있어요.
- 키는 프로젝트별로 발급하세요: 서비스마다 키를 하나씩 발급하면 유출이나 퇴사 시 빠르게 폐기할 수 있어요.
- 비용을 프로젝트별로 집계할 수 있어야 해요: 애플리케이션에 프로젝트와 호출 주체 필드를 추가해야 월말에 비용을 대조할 수 있어요.
- 게이트웨이에도 한계가 있어요: 데이터 권한, Agent 보안, 업무 프로세스 개선은 다른 영역에서 담당해야 해요.
- 적은 비용으로 시작하세요: APIYI apiyi.com을 통해 하나의 키로 여러 모델에 통합 접속하고, 먼저 시범 운영을 진행할 수 있어요.
정리
텐센트 컨퍼런스에서 논의된 기업용 Agent의 핵심은 특정 Agent의 성능이 아니라 조직이 그 기능을 어떻게 활용할 수 있느냐에 있었어요. 팀에 AI를 도입하려는 책임자에게 모델 호출 계층은 가장 먼저 구축할 수 있으면서도 쉽게 놓치기 쉬운 영역이에요.
- 모델을 교체할 수 있어야 해요: 호환 인터페이스를 통일하고 모델 이름은 설정값으로 관리하세요.
- 권한과 비용이 보여야 해요: 프로젝트별로 키를 발급하고 사용량을 집계해 비용 내역이 불분명해지는 일을 막으세요.
- 경험을 재사용할 수 있어야 해요: 검증된 프롬프트와 프로세스를 팀의 자산으로 축적하세요.
관심은 시간이 지나면 식겠지만, 이 체크리스트는 어떤 규모의 팀에 AI를 도입할 때도 유용해요. 먼저 한두 가지 업무 시나리오를 골라 시범 운영하면서 호출 경로와 사용량 기록을 정착시킨 뒤, 점차 범위를 넓혀 보세요. APIYI apiyi.com을 통해 여러 모델에 통합 접속하는 효과를 빠르게 검증해 보는 것도 추천해요. 플랫폼은 무료 테스트 크레딧과 사용량 기반 요금제를 제공해요.
📚 참고 자료
- 极客公园 – 한 사람은 AI를 잘 쓰는데, 왜 기업은 잘 쓰지 못할까요?: 텐센트 글로벌 디지털 생태계 컨퍼런스의 기업용 Agent 관련 발표를 다룬 기사
- 링크:
geekpark.net/news/373541 -
설명: WorkBuddy 기업용 버전 업그레이드, Buddy One, 쑤닝 사례, Agent Runtime 등의 정보를 담고 있어요.
-
OpenAI API 문서: Chat Completions 인터페이스와 usage 필드에 대한 설명
- 링크:
platform.openai.com/docs - 설명: 호환 인터페이스의 요청 구조와 토큰 집계 방식을 이해할 수 있어요.
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지 apiyi.com에서 문의해 주세요. 연동 관련 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.


