
작성자 주: 텐센트 Hy4 정식 버전이 출시되면서 이미지 이해와 컴퓨터 조작을 처음 지원해요. 이 글에서는 제조사 발표, 협력사 자체 테스트, 제3자 독립 평가를 비교해 Hy4의 능력과 한계, 적합한 활용 사례를 살펴봐요.
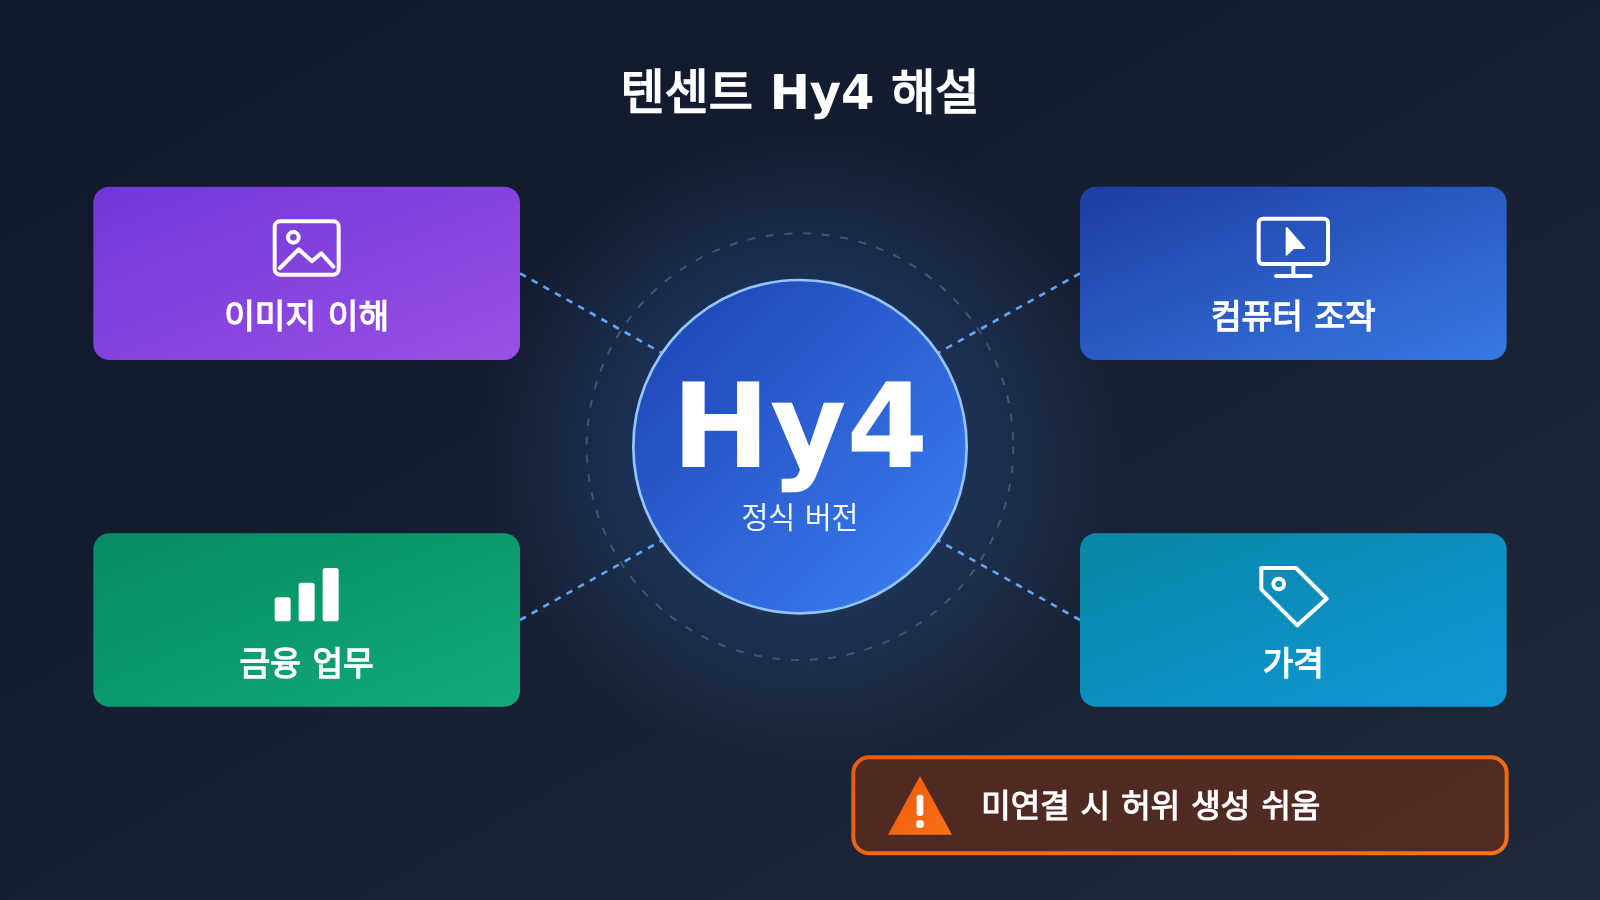
텐센트가 프리뷰 버전 출시 약 두 달 만에 Hy4 정식 버전을 선보였어요. 이미지 이해와 컴퓨터 소프트웨어의 자율 조작을 처음 지원하며, 가격은 프리뷰 버전과 같아요. 텐센트는 Hy4가 처음으로 최상위 오픈 가중치 모델 대열에 합류했다고 밝혔지만, 가중치 공개 시점은 아직 발표되지 않았어요.
이 글은 출시 발표를 그대로 옮긴 보도자료가 아니에요. 텐센트의 자체 테스트, 협력사의 피드백, Artificial Analysis의 독립 평가 결과는 완전히 일치하지 않으며, 일부는 차이도 커요. 세 가지 결과를 하나씩 비교해 제조사의 주장과 독립적인 평가 결론을 구분해 볼게요.
핵심 내용: Hy4에 새로 추가된 기능과 가격, 성능이 뚜렷하게 뒤처지는 작업, 그리고 프로그래밍·금융·업무 환경에서 안전하게 활용하는 방법을 알아봐요.
텐센트 Hy4 핵심 정보 한눈에 보기
먼저 확인된 사실을 표로 정리했어요. 능력에 관한 설명은 대부분 텐센트 공식 발표를 바탕으로 했으며, 제3자 데이터는 뒤에서 별도로 표시해요.
| 항목 | 상세 내용 |
|---|---|
| 출시 기업 | 텐센트 |
| 출시 일정 | 프리뷰 버전 출시 약 2개월 후 정식 버전 출시 |
| 현재 이용 방법 | 텐센트 클라우드, OpenRouter, 위안바오 등 텐센트 자체 앱 |
| 모델 가중치 | 공개 예정이나 구체적인 날짜는 미발표. 안전성 보고서도 가중치와 함께 공개 예정 |
| 핵심 신규 기능 | 이미지 이해와 컴퓨터 소프트웨어 자율 조작을 처음으로 지원 |
| 중점 개선 분야 | 프로그래밍, 금융, 사무 |
| 가격 | 입력 토큰 100만 개당 약 0.83달러, 출력 토큰 100만 개당 약 2.50달러로 프리뷰 버전과 동일 |
| 향후 계획 | 더 빠르고 저렴한 Hy4 flash 버전 출시 예정. 일정과 가격은 미정 |
텐센트 Hy4의 출시 배경
텐센트의 이전 세대 모델인 Hy3는 2,950억 개의 매개변수를 갖췄으며 Apache 2.0 라이선스로 공개됐어요. 이후 몇 달 사이 즈푸는 GLM-5.3을, DeepSeek는 V4.1-Flash-1017을, 문샷 AI는 Kimi K3.1 Pro를 출시하면서 중국 모델 간 경쟁이 치열해졌어요. Hy4는 이런 경쟁 속에서 텐센트를 다시 선두 그룹으로 끌어올리기 위한 모델이에요.
평가 기준이 바뀐 점도 주목할 만해요. Artificial Analysis는 10월 하순 종합 지수를 개편했으며, 현재 점수의 60%는 공개되지 않은 비공개 테스트 세트를 기반으로 해요. 새로운 기준으로 계산하면 공개 모델과 최상위 모델의 격차가 3점에서 12점으로 벌어졌어요. 따라서 Hy4의 점수를 개편 전 순위표와 직접 비교하는 것은 적절하지 않아요.
텐센트 Hy4의 멀티모달 및 컴퓨터 조작 능력 살펴보기
이미지 이해와 컴퓨터 조작은 이번 세대 Hy4의 가장 큰 변화 두 가지예요. 이미지 이해로 그림을 보고, 컴퓨터 조작으로 직접 작업할 수 있게 된 거죠. 두 능력이 결합되어야 실제 업무와 개발 과정을 수행할 가능성이 생겨요.
Hy4 이미지 이해: 코드로 이미지를 잘라 세부 사항 찾기
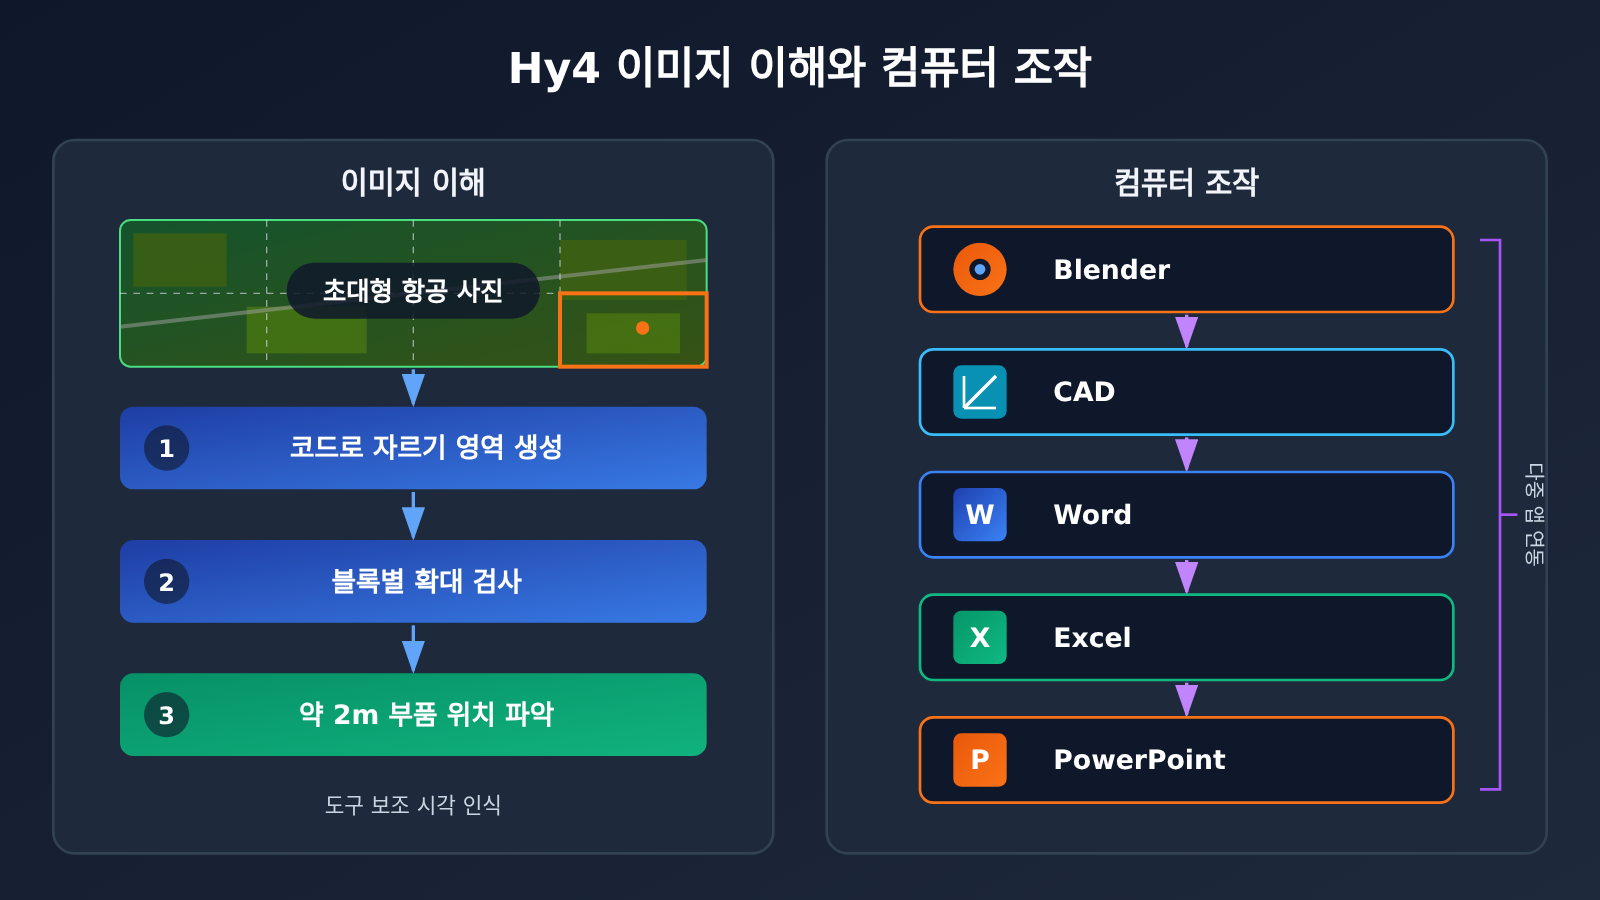
텐센트의 시연에서 Hy4는 28억 픽셀 항공 사진 속 창고 지붕에 있는 약 2미터 크기의 부품을 찾아야 했어요. 이미지 전체를 한 번에 “보는” 대신, 코드로 잘라낼 영역을 정하고 한 부분씩 확대해 살펴봤어요. 이렇게 도구의 도움을 받아 이미지를 분석하는 방식은 초대형 도면, 위성·항공 이미지, 복잡한 차트를 처리할 때 참고할 만해요.
텐센트는 이미지 이해가 디자인 시안을 바탕으로 웹사이트나 게임을 만드는 등 프로그래밍에도 도움이 된다고 설명해요. 게임 개발을 위해서는 자사 게임 스튜디오와 협력해 Unreal, Unity, Godot 등 주요 엔진에 맞게 조정했어요. 《왕자영요》 개발팀에 따르면 Hy4는 설정 관련 작업을 거의 오류 없이 처리했고, 버그의 근본 원인을 찾아내는 성공률도 이전보다 훨씬 높아졌어요. 다만 이는 텐센트 내부 팀의 평가이며, 테스트 방법은 공개되지 않았어요.
Hy4 컴퓨터 조작: 전문 소프트웨어와 여러 앱을 연계한 작업
Hy4는 처음으로 컴퓨터를 자율적으로 조작하는 능력을 갖춰, 소프트웨어를 직접 제어해 작업을 완료할 수 있어요. 텐센트는 Blender, CAD 등 전문 도구를 사용하도록 별도로 학습시켰고, 여러 앱을 차례로 사용해야 하는 작업도 학습에 포함했어요. 사무 환경에서는 사람과 실시간으로 협업해 Word, Excel, PowerPoint 파일을 다룰 수 있어요.
여기서 참고할 만한 결과가 있어요. 같은 날 분석 기관 SemiAnalysis는 실제 업무를 모사한 환경에서 AI 에이전트가 Siemens NX 등 전문 소프트웨어를 조작하는 GDPx 벤치마크를 공개했어요. 개별 작업은 최대 8시간 동안 진행됐어요. 그 결과 어떤 모델도 12%를 넘지 못했고, 1위인 Claude Opus 5.5도 12%에 그쳤어요. Hy4는 이 순위에 포함되지 않았지만, 이 결과는 업계 전반의 컴퓨터 조작 능력이 아직 초기 단계이며 “소프트웨어를 조작할 수 있다”는 것과 “전문 업무를 독립적으로 완수할 수 있다”는 것 사이에 큰 차이가 있음을 보여줘요.
Hy4가 자신의 “후속 모델” 학습에 참여하다
텐센트는 Hy4를 활용해 AI 개발 자체를 개선하는 독특한 방향도 선보였어요. 7개 분야의 내부 연구 과제 테스트에서 Hy4가 공개 모델 중 1위를 차지했다고 밝혔어요. Hy4는 에이전트 시스템 Hyra 2.0과 함께 6단계를 거쳐 텐센트 내부 학습 인프라의 처리량을 약 20% 높였어요.
이후 Hy4는 미국 스타트업 TypeSafe AI의 의사결정 모델 Jev의 한 버전을 자율적으로 학습시켰어요. 이 Hyra-Jev 변형 모델은 8개 벤치마크 중 6개에서 원본 Jev를 앞섰어요. 텐센트는 같은 방식으로 만든 생물학 및 물리학 전용 모델 두 개도 공개 모델로 배포할 예정이에요. 모두 텐센트의 자체 테스트 결과지만, Hy4를 내부 AI 연구개발의 가속기로 활용하려는 장기적인 의도를 엿볼 수 있어요.
텐센트 Hy4 3자 평가 비교: 제조사, 파트너사, 독립 기관
이 부분은 글의 핵심이에요. 같은 모델을 두고도 세 평가 주체의 결과가 뚜렷하게 다르므로, 모델을 선택할 때는 누가 평가했는지부터 확인해야 해요.
| 정보 출처 | 핵심 결론 | 평가 성격 | 신뢰도 참고 사항 |
|---|---|---|---|
| 텐센트 공식 | 금융업 종사자 200여 명이 실제 업무 600여 개를 평가한 결과, Hy4가 DeepSeek V4.1 Flash, Kimi K3.1 Pro, GLM-5.3 Flash보다 높은 순위를 기록 | 제조사 자체 평가 | 테스트 방법의 세부 사항은 공개되지 않음 |
| 텐센트 공식 | 검색 기능을 개편한 뒤, 인터넷 검색 시 환각률이 약 16%에서 약 5%로 감소 | 제조사 내부 테스트 | 인터넷 검색 상황에만 해당 |
| 텐센트 공식 | 자체 벤치마크 12개 항목 모두에서 Claude Opus 5.5가 Hy4보다 앞섰고, GPT 6.1 Sol은 8개 항목에서 앞섬 | 제조사 자체 평가 | 텐센트가 직접 격차를 인정한 결과라 참고 가치가 높음 |
| 파트너사 Comein | Hy4는 Claude Opus 5.5와 공동 2위를 차지한 유일한 중국산 모델이며, 데이터 조회에서 GPT-6.1 Sol보다 확실히 앞섬 | 파트너사 자체 평가 | 해당 파트너사의 금융 데이터 조회 시나리오에만 해당 |
| 파트너사 Manus | Hy4가 문서 관련 작업을 거의 모두 성공적으로 완료 | 파트너사 자체 평가 | 작업의 난이도와 범위는 공개되지 않음 |
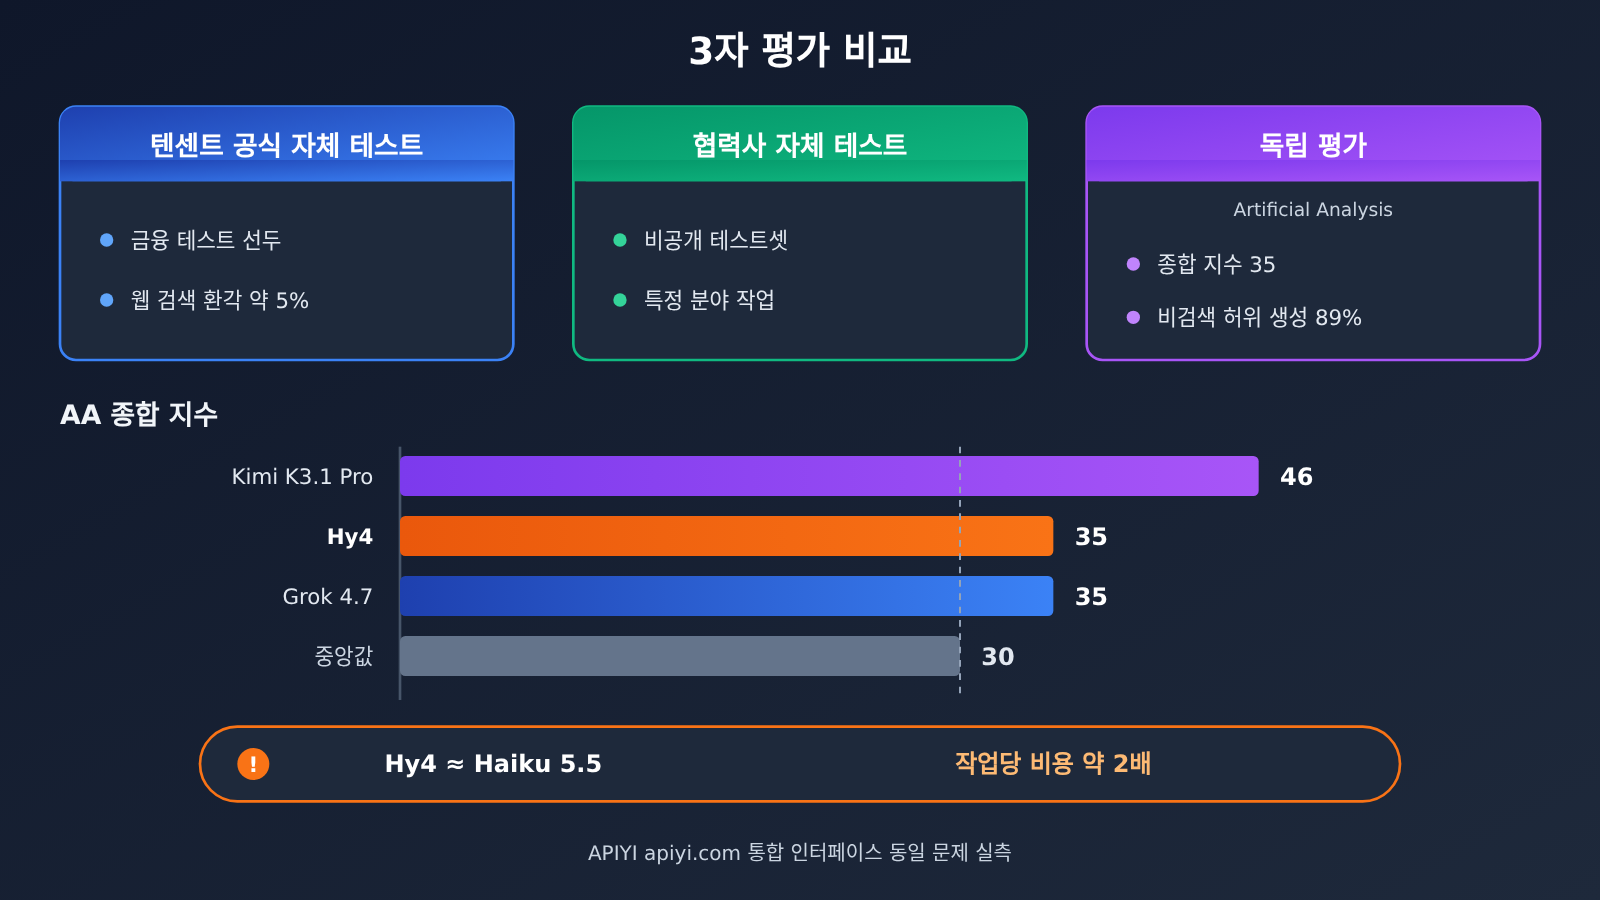
| Artificial Analysis | 종합 지수 35점으로 중앙값 30점을 웃돌고 Grok 4.7과 동점. 중국산 모델 중 2위이며, Kimi K3.1 Pro의 46점에는 못 미침 | 제3자 독립 평가 | 테스트 세트의 60%가 비공개라 평가에 맞춰 최적화하기가 비교적 어려움 |
| Artificial Analysis | 인터넷에 연결하지 않았을 때 사실 관련 질문의 약 절반에 정답을 맞혔으며, 답을 모를 때는 89%의 경우 답변을 지어냄 | 제3자 독립 평가 | 외부 자료를 참조하지 않는 지식 정확성 테스트 |
텐센트 Hy4 자체 테스트와 독립 평가의 주요 차이
가장 뚜렷한 차이는 Hy4와 Kimi K3.1 Pro의 비교에서 나타나요. 텐센트의 금융 테스트에서는 Hy4가 Kimi보다 앞섰지만, Artificial Analysis의 종합 지수에서는 Hy4가 Kimi보다 11점 뒤처졌어요. 두 결과가 반드시 모순되는 건 아니에요. 금융 테스트는 좁은 영역을 다루지만, 종합 지수는 지식 업무, 프로그래밍, 과학, 상식 등 여러 영역을 평가하거든요. Hy4는 텐센트가 집중적으로 다듬은 금융 분야에서는 강점이 있지만, 전반적인 성능에서는 앞서지 않는다고 볼 수 있어요.
가성비에서도 주목할 점이 있어요. Artificial Analysis 데이터에 따르면 Hy4의 종합 점수는 Anthropic의 가장 작은 모델인 Haiku 5.5와 비슷하지만, 해당 벤치마크에서 Haiku 5.5의 작업당 비용은 Hy4의 절반에 가까워요. 즉, 토큰 단가만 보고 “Hy4가 더 저렴하다”고 결론 내릴 수는 없어요. 작업을 완료하는 데 실제로 소비한 토큰 양도 계산해야 해요.
Tencent Hy4의 고난도 작업에서 드러나는 한계
Tencent도 Hy4가 고등 수학, 긴 프로그래밍 프로젝트, 복잡한 이미지 분석에서 최고 수준의 상용 모델에 여전히 크게 뒤처진다고 인정해요. 가장 큰 차이가 나타난 Hy-FrontierMath T5를 비롯한 수치는 다음과 같아요.
| 벤치마크 / 항목 | Hy4 | GPT 6.1 Sol | Claude Opus 5.5 | 출처 |
|---|---|---|---|---|
| Hy-FrontierMath T5 | 13.0 | 97.5 | 91.3 | Tencent 공식 자료 |
| Tencent 자체 벤치마크 12개 | 모두 Opus 5.5에 뒤처짐 | 8개 항목에서 Hy4보다 우세 | 12개 항목 모두에서 우세 | Tencent 공식 자료 |
| AA 종합 지수 | 35 | 자료에 명시되지 않음 | 자료에 명시되지 않음 | Artificial Analysis |
| 인터넷 연결 없이 답변한 사실의 정확성 | 약 절반을 맞혔으며, 모를 때 89%는 답변을 지어냄 | 자료에 명시되지 않음 | 자료에 명시되지 않음 | Artificial Analysis |
13.0점과 90점 이상은 ‘조금 뒤처지는’ 수준이 아니라 차원이 다른 격차예요. 업무에 경시대회 수준의 수학 추론, 장기간 진행되는 엔지니어링 코드 작업, 고정밀 이미지 분석이 필요하다면 Hy4는 현재 주력 모델로 적합하지 않아요.
텐센트 Hy4의 영향 분석: 개발자와 제품 팀에는 어떤 의미일까요?
개발자에게 미치는 영향: 인터넷 연결 여부에 따라 다른 모델
‘인터넷 연결 시 환각률 약 5%’와 ‘연결하지 않으면 89%가 답을 지어냄’이라는 두 수치를 함께 보면 결론은 분명해요. Hy4의 사실 신뢰성은 외부 검색에 크게 의존합니다. 텐센트의 5%는 인터넷 검색 환경에서 진행한 내부 테스트 결과이고, 89%는 Artificial Analysis가 외부 자료를 이용할 수 없는 조건에서 측정한 답변 조작 경향이에요. 제품에 Hy4를 도입할 때는 검색이 필수인 모델로 보고 설계하는 편이 좋습니다.
실제 구현할 때는 다음 방법을 참고해 보세요.
- 사실 확인 질문은 모두 검색을 거치기: 먼저 검색이나 RAG로 자료를 찾아온 뒤, 모델이 해당 자료를 바탕으로 답하게 하세요. 기억에 의존해 답하게 해서는 안 됩니다.
- 프롬프트에 ‘모른다고 답해도 된다’고 명시하기: 자료에 없는 내용은 ‘자료에 언급되지 않음’이라고 답하도록 해 답을 지어낼 가능성을 낮추세요.
- 출처 표시 요구하기: 각 결론이 어느 자료에서 나왔는지 밝히게 하면 사람이 일부를 골라 검토하기 편해요.
- 핵심 수치 재검증하기: 금융이나 보고서 관련 결과물의 숫자는 프로그램이나 규칙을 이용해 다시 확인하세요. GDPx 평가에서 지적했듯 표의 숫자 하나만 틀려도 결과물 전체의 가치가 떨어질 수 있어요.
아래는 ‘검색 증강 + 답변 거부 허용’을 적용한 간단한 호출 예시예요. 모델명은 실제 사용할 수 있는 모델로 바꾸세요. Hy4의 구체적인 모델 ID는 각 플랫폼의 콘솔에서 확인하면 됩니다.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "(这里放检索召回的资料片段)"
resp = client.chat.completions.create(
    model="your-model-name",
    messages=[
        {"role": "system", "content": "只依据给定资料回答;资料没有的内容回答“资料未提及”,并标注出处段落。"},
        {"role": "user", "content": f"资料:{context}\n\n问题:该公司三季度营收是多少?"}
    ],
    temperature=0
)
print(resp.choices[0].message.content)
전체 구현 보기: 여러 모델의 동일 질문 비교 + 답변 거부율 통계
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "只依据给定资料回答问题。"
    "如果资料中没有答案,必须只回答:资料未提及。"
    "回答时注明依据的资料段落编号。"
)

def ask(model: str, context: str, question: str) -> str:
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": f"资料:\n{context}\n\n问题:{question}"}
            ],
            temperature=0,
            max_tokens=500
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

def evaluate(models: List[str], cases: List[Dict]) -> None:
    """cases에서 answerable=False인 질문은 자료에 의도적으로 답을 넣지 않아 답변 조작 경향을 테스트합니다."""
    for m in models:
        refused, fabricated = 0, 0
        for c in cases:
            out = ask(m, c["context"], c["question"])
            if not c["answerable"]:
                if "资料未提及" in out:
                    refused += 1
                else:
                    fabricated += 1
        print(f"{m}: 正确拒答 {refused},疑似编造 {fabricated}")

cases = [
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "三季度营收是多少?", "answerable": False},
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "二季度营收是多少?", "answerable": True},
]

# 목록을 비교할 모델 ID로 바꾸세요.
evaluate(["model-a", "model-b"], cases)
🎯 모델 선택 팁: Hy4 같은 신모델을 평가할 때는 순위표만 보기보다 실제 업무 데이터를 활용해 같은 과제로 비교하는 것이 가장 믿을 만해요. APIYI apiyi.com은 OpenAI 호환 통합 인터페이스를 제공해 API 키 하나로 Claude, GPT, Gemini와 여러 중국 모델을 호출할 수 있어요. 후보 모델을 동일한 테스트 세트로 평가하기에도 편리해요. Hy4의 플랫폼 제공 여부는 콘솔의 모델 목록에서 확인하세요.
제품 책임자를 위한 시사점: Hy4에 적합한 작업과 부적합한 작업
세 곳의 정보를 종합하면 Hy4의 작업별 적합도를 다음과 같이 정리할 수 있어요.
| 작업 유형 | 적합도 | 근거 | 사용 권장 사항 |
|---|---|---|---|
| 금융 데이터 조회, 리서치 보고서 정리 | 비교적 적합 | Tencent의 금융 테스트와 Comein의 피드백 모두 자체 테스트 결과 | 반드시 검색 기능을 연동하고, 핵심 수치는 프로그램으로 검증 |
| Word, Excel, PPT 문서 처리 | 비교적 적합 | Tencent의 실시간 협업 기능, 문서 작업 완료율이 높다는 Manus의 피드백 | 위험도가 낮은 문서 작업부터 시범 적용 |
| 게임 엔진 설정, 버그 위치 파악 | 시도해 볼 만함 | Tencent 내부 게임팀의 피드백 | 설정과 오류 해결에 적합하며, 장기 프로젝트에는 부적합 |
| 웹페이지, 미니 게임 프로토타입 제작 | 시도해 볼 만함 | 이미지 이해를 활용한 프로그래밍 지원 | 프로토타입 도구로 사용하고, 프로덕션 코드는 사람이 검토 |
| 웹 검색 기반 질의응답 | 시도해 볼 만함 | 내부 테스트에서 웹 검색 시 환각률 약 5% | 검색 기능을 켜고 출처를 표시하도록 요청 |
| 웹 검색 없는 지식 질의응답 | 비권장 | 모르는 경우 89%를 지어냄 | 모델이 기억에 의존해 사실 관련 질문에 답하지 않도록 주의 |
| 고등 수학, 경시대회 수준 추론 | 비권장 | Hy-FrontierMath T5에서 13.0점에 그침 | 최상위 상용 모델 선택 |
| 장기 프로그래밍 프로젝트, 복잡한 이미지 분석 | 비권장 | Tencent가 공식적으로 뚜렷한 성능 격차를 인정 | 더 강력한 모델을 선택하거나 작업 분할 |
업계에 미치는 영향: 가중치 공개와 규제 강화의 병행
Hy4는 가중치를 공개할 계획이에요. 기업이 향후 자체 환경에 배포할 수 있는 선택지를 얻게 된다는 뜻이에요. 다만 공개 날짜와 라이선스는 아직 발표되지 않았으므로, 납기 확정이 필요한 계획에 포함하기는 일러요.
정책 측면에서도 변화가 있어요. 중국 상무부와 과학기술부는 10월에 수출 통제 체계 초안을 발표했어요. 전 세계 상위 10위 이내이거나 파라미터가 2조 개를 넘는 모델의 가중치가 대상이지만, 오픈소스 공개에는 자동 승인 신속 절차를 마련했어요. 안전과 관련해 텐센트는 학습 과정에서 해킹 관련 자료를 의도적으로 걸러냈다고 밝혔어요. 자체 보안 연구소에서는 악용 위험이 높아진 징후를 발견하지 못했으며, 생물학적 위해 위험도 자체 위험 임계값보다 훨씬 낮았다고 해요. 상세 안전 보고서는 가중치와 함께 공개될 예정이에요.
텐센트 Hy4 자주 묻는 질문 FAQ
Q1: 텐센트 Hy4는 무엇인가요?
Hy4는 텐센트가 프리뷰 버전에 이어 출시한 정식 버전 대규모 언어 모델이에요. 처음으로 이미지 이해와 컴퓨터 소프트웨어의 자율 조작을 지원하며, 프로그래밍·금융·사무 업무에 중점을 두고 최적화됐어요. 현재 Tencent Cloud, OpenRouter, Yuanbao 등의 서비스를 통해 사용할 수 있으며, 가중치는 추후 공개될 예정이에요.
Q2: Hy4는 Kimi K3.1 Pro, Claude Opus 5.5와 비교하면 어떤가요?
텐센트의 금융 자체 평가에서는 Hy4가 Kimi K3.1 Pro보다 앞섰지만, Artificial Analysis의 독립 평가에서는 Hy4가 35점으로 Kimi의 46점에 못 미쳤어요. Claude Opus 5.5와 비교하면 텐센트 자체 벤치마크 12개 항목 모두에서 뒤졌어요. 실제 업무 환경에서 직접 비교하고 싶다면 APIYI apiyi.com의 통합 인터페이스로 여러 모델을 호출해 같은 문제를 테스트할 수 있어요.
Q3: Hy4의 가중치와 Hy4 flash는 언제 공개되나요?
2026년 11월 6일 기준, 텐센트는 가중치 공개 날짜와 라이선스를 아직 발표하지 않았어요. 안전 보고서를 가중치와 함께 공개한다는 점만 밝혔어요. 더 빠르고 저렴한 Hy4 flash 역시 계획 중이라는 사실만 확인됐고, 출시 시기와 가격은 공개되지 않아 공식 발표를 계속 확인해야 해요.
Q4: Hy4의 가격은 비싼가요?
Hy4의 가격은 입력 토큰 100만 개당 약 0.83달러, 출력 토큰 100만 개당 약 2.50달러로 프리뷰 버전과 같아요. 하지만 Artificial Analysis 데이터에 따르면 비슷한 점수를 받은 Haiku 5.5의 작업당 비용은 Hy4의 절반에 가까워요. 따라서 실제 작업에서 소비하는 토큰을 기준으로 총비용을 계산해야 해요.
Q5: Hy4가 사실을 지어낼 위험을 어떻게 줄일 수 있나요?
핵심은 사실에 관한 질문에 모델이 기억만으로 답하지 않도록 하는 거예요. 웹 검색을 활성화하거나 RAG를 연결하고, 프롬프트에서 “자료에 언급되지 않음”이라고 답할 수 있도록 허용하며 출처를 표시하도록 요청하세요. 앞서 소개한 비교 스크립트로 모델별 답변 거부와 사실 조작 현황을 집계할 수 있어요. APIYI apiyi.com의 신규 사용자 무료 테스트 크레딧을 활용하면 적은 비용으로 먼저 검증해 볼 수 있어요.
Q6: Hy4에는 어떤 알려진 한계가 있나요?
주요 한계는 세 가지예요. 첫째, 고난도 작업에서 격차가 커서 Hy-FrontierMath T5 점수가 13.0점에 그쳤어요. 둘째, 웹 검색 없이 답할 때 지식의 신뢰도가 낮아 답을 모르는 경우 89%가 내용을 지어냈어요. 셋째, 긍정적인 평가 중 상당수가 텐센트나 협력사의 자체 테스트에서 나왔고 평가 방법의 세부 사항이 공개되지 않아, 직접 보유한 데이터로 재검증해야 해요.
텐센트 Hy4 핵심 요약 Key Takeaways
- 두 가지 첫 지원: Hy4는 처음으로 이미지 이해와 자율적인 컴퓨터 조작을 지원해 Blender, CAD, Office 문서 작업까지 다뤄요.
- 가격 동결: 입력 100만 토큰당 약 0.83달러, 출력 100만 토큰당 약 2.50달러로 프리뷰 버전과 같아요.
- 독립 평가에서 중상위권: AA 종합 지수 35점으로 중국 모델 중 2위지만, Kimi K3.1 Pro에는 크게 뒤처져요.
- 검색 연동 필수: 인터넷에 연결하면 환각률이 약 5%지만, 연결하지 않으면 답을 모르는 질문의 89%에서 답을 지어내요.
- 고난도 작업은 열세: 고급 수학, 대규모 코딩 프로젝트, 복잡한 이미지 분석에서 최고 수준의 상용 모델과 격차가 커요.
- 자체 평가는 재확인 필요: 금융 분야 순위와 협력사 결론은 대부분 자체 평가 결과이므로, 도입 전에 자체 샘플로 검증해야 해요.
- 비교 테스트 권장: APIYI apiyi.com의 통합 인터페이스를 활용하면 Hy4와 대안 모델을 같은 테스트셋으로 비교할 수 있어요.
정리
텐센트 Hy4의 핵심은 다음과 같아요.
- 기능이 크게 개선됐어요: 이미지 이해와 컴퓨터 조작이 이번 세대의 가장 큰 신규 기능이며, 금융과 사무 분야에 중점을 두고 개선했어요.
- 세 곳의 평가는 구분해서 봐야 해요: 제조사와 협력사의 자체 평가는 다소 낙관적인 반면, Artificial Analysis의 독립 평가에서는 중국 모델 중 2위이자 Haiku 5.5와 비슷한 수준으로 평가했어요.
- 약점이 구체적이에요: 인터넷에 연결하지 않으면 답을 지어내기 쉽고, 고난도 수학과 대규모 코딩 프로젝트에서도 크게 뒤처져요. 이는 모델 선택에 직접 영향을 줘요.
금융 데이터 조회, 문서 처리, 게임 설정 같은 작업을 한다면 Hy4에 검색 기능을 연동해 시범 테스트를 해볼 만해요. 반면 외부 검색 없이 지식에 의존하거나 고난도 추론이 필요한 경우에는 현재 더 강력한 모델이 적합해요. 먼저 APIYI apiyi.com의 통합 인터페이스로 후보 모델에 같은 문제를 적용해 테스트한 뒤, 비용과 정확도를 함께 고려해 결정해 보세요.
📚 참고 자료
- THE DECODER – Tencent releases Hy4 with vision and computer use: Hy4 출시 보도
- 링크:
the-decoder.com/tencent-releases-hy4-with-vision-and-computer-use-claims-second-place-among-chinese-ai-models -
설명: 텐센트 공식 데이터, 협력사 피드백, Artificial Analysis의 독립 평가 결과를 담고 있어요.
-
THE DECODER – SemiAnalysis GDPx 벤치마크 보도: AI 에이전트의 실제 업무 환경 평가
- 링크:
the-decoder.com/no-ai-agent-scores-above-12-percent-on-semianalysis-new-real-world-work-benchmark -
설명: 컴퓨터 조작 에이전트가 전문 소프트웨어를 다루는 전반적인 수준을 확인할 수 있어요.
-
Artificial Analysis: 독립 모델 평가 기관
- 링크:
artificialanalysis.ai - 설명: Intelligence Index와 AA-Omniscience 등 평가의 최신 데이터를 확인할 수 있어요.
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 홈페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.


