
Anmerkung der Redaktion: Tencent hat Hy4 offiziell veröffentlicht. Das Modell unterstützt erstmals Bildverständnis und die Bedienung von Computersoftware. Dieser Artikel stellt Herstellerangaben, Tests von Partnern und unabhängige Bewertungen gegenüber, um die Grenzen und Einsatzmöglichkeiten des Modells einzuordnen.
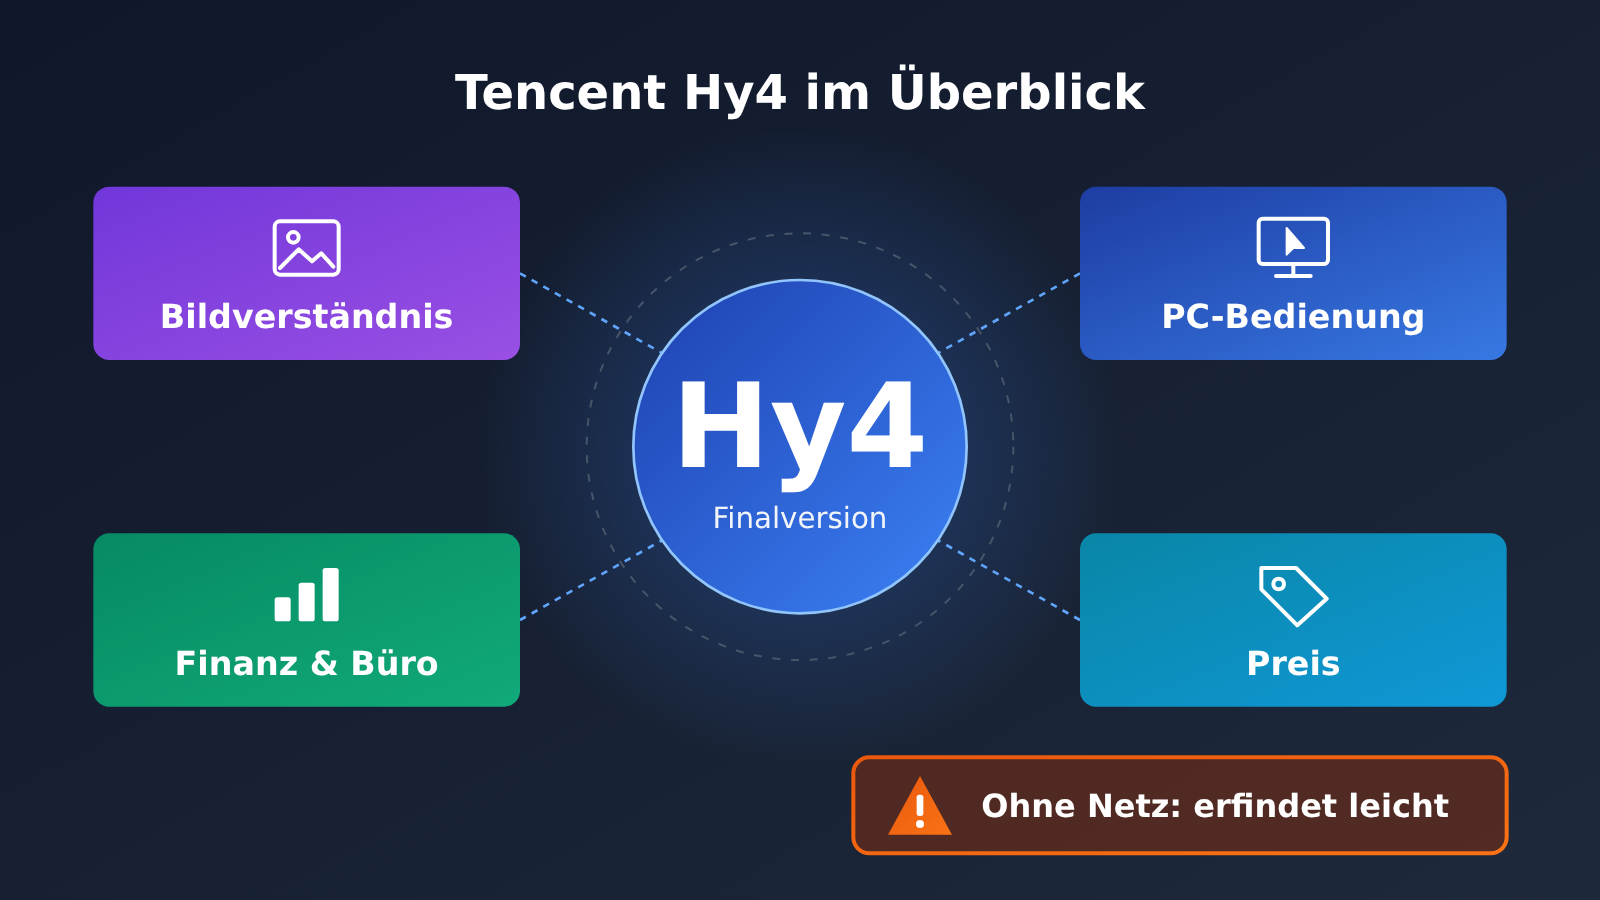
Rund zwei Monate nach der Vorschauversion hat Tencent die finale Version von Hy4 veröffentlicht. Sie unterstützt erstmals Bildverständnis und die selbstständige Bedienung von Computersoftware; die Preise bleiben gegenüber der Vorschauversion unverändert. Tencent zufolge gehört Hy4 damit erstmals zu den leistungsstärksten Modellen mit offenen Gewichten. Die Gewichte sollen allerdings erst zu einem noch nicht bekannt gegebenen Zeitpunkt freigegeben werden.
Dies ist keine bloße Nacherzählung der Produktvorstellung. Tencents eigene Tests, Rückmeldungen von Partnern und die unabhängige Bewertung von Artificial Analysis stimmen nicht vollständig überein – teils gibt es deutliche Unterschiede. Dieser Artikel stellt die Aussagen aller drei Seiten Punkt für Punkt gegenüber und trennt Herstellerangaben von unabhängigen Ergebnissen.
Das Wichtigste auf einen Blick: Nach der Lektüre wissen Sie, welche Fähigkeiten Hy4 neu mitbringt, was es kostet, bei welchen Aufgaben es deutlich zurückliegt und wie Sie es beim Programmieren sowie in Finanz- und Büroanwendungen zuverlässig einsetzen.
Tencent Hy4: Die wichtigsten Fakten im Überblick
Hier zunächst die bestätigten Fakten in einer Tabelle. Die meisten Angaben zu den Fähigkeiten stammen von Tencent selbst; Daten von Drittanbietern werden im weiteren Verlauf gesondert gekennzeichnet.
| Information | Details |
|---|---|
| Anbieter | Tencent |
| Veröffentlichungszeitplan | Die finale Version erschien rund zwei Monate nach der Vorschauversion |
| Aktuelle Verfügbarkeit | Tencent Cloud, OpenRouter sowie Tencent-eigene Anwendungen wie Yuanbao |
| Modellgewichte | Die Veröffentlichung ist geplant, ein konkretes Datum steht noch nicht fest. Der Sicherheitsbericht soll zusammen mit den Gewichten erscheinen |
| Wichtigste neue Fähigkeiten | Erstmals Unterstützung für Bildverständnis und die eigenständige Bedienung von Computersoftware |
| Optimierungsschwerpunkte | Programmierung, Finanzen und Büroarbeit |
| Preis | Rund 0,83 US-Dollar pro Million Eingabe-Token und rund 2,50 US-Dollar pro Million Ausgabe-Token, unverändert gegenüber der Vorschauversion |
| Weitere Pläne | Eine schnellere und günstigere Version namens Hy4 flash ist geplant; Zeitpunkt und Preis stehen noch nicht fest |
Hintergrund zur Veröffentlichung von Tencent Hy4
Der Vorgänger Hy3 von Tencent hat 295 Milliarden Parameter und wurde unter der Apache-2.0-Lizenz veröffentlicht. In den darauffolgenden Monaten brachte Zhipu GLM-5.3 heraus, DeepSeek veröffentlichte V4.1-Flash-1017 und Moonshot AI stellte Kimi K3.1 Pro vor. Der Wettbewerb zwischen chinesischen Modellen ist also intensiv. Hy4 soll Tencent in dieser Runde wieder in die Spitzengruppe zurückbringen.
Ein weiterer wichtiger Punkt ist die veränderte Bewertungsmethode: Artificial Analysis hat seinen Gesamtindex Ende Oktober überarbeitet. Er basiert nun zu 60 % auf nicht öffentlich zugänglichen privaten Testdatensätzen. Nach der neuen Berechnung ist der Abstand zwischen offenen Modellen und Spitzenmodellen von 3 auf 12 Punkte gewachsen. Die Bewertung von Hy4 lässt sich daher nicht direkt mit älteren Ranglisten vor der Überarbeitung vergleichen.
Tencent Hy4: multimodale Fähigkeiten und Computersteuerung
Bildverständnis und Computersteuerung sind die beiden größten Neuerungen dieser Hy4-Generation. Das eine ermöglicht dem Modell, Bilder zu verstehen, das andere, selbst Aktionen auszuführen. Erst zusammen können diese Fähigkeiten echte Büro- und Entwicklungsabläufe unterstützen.
Hy4-Bildverständnis: Details durch codegesteuertes Zuschneiden finden
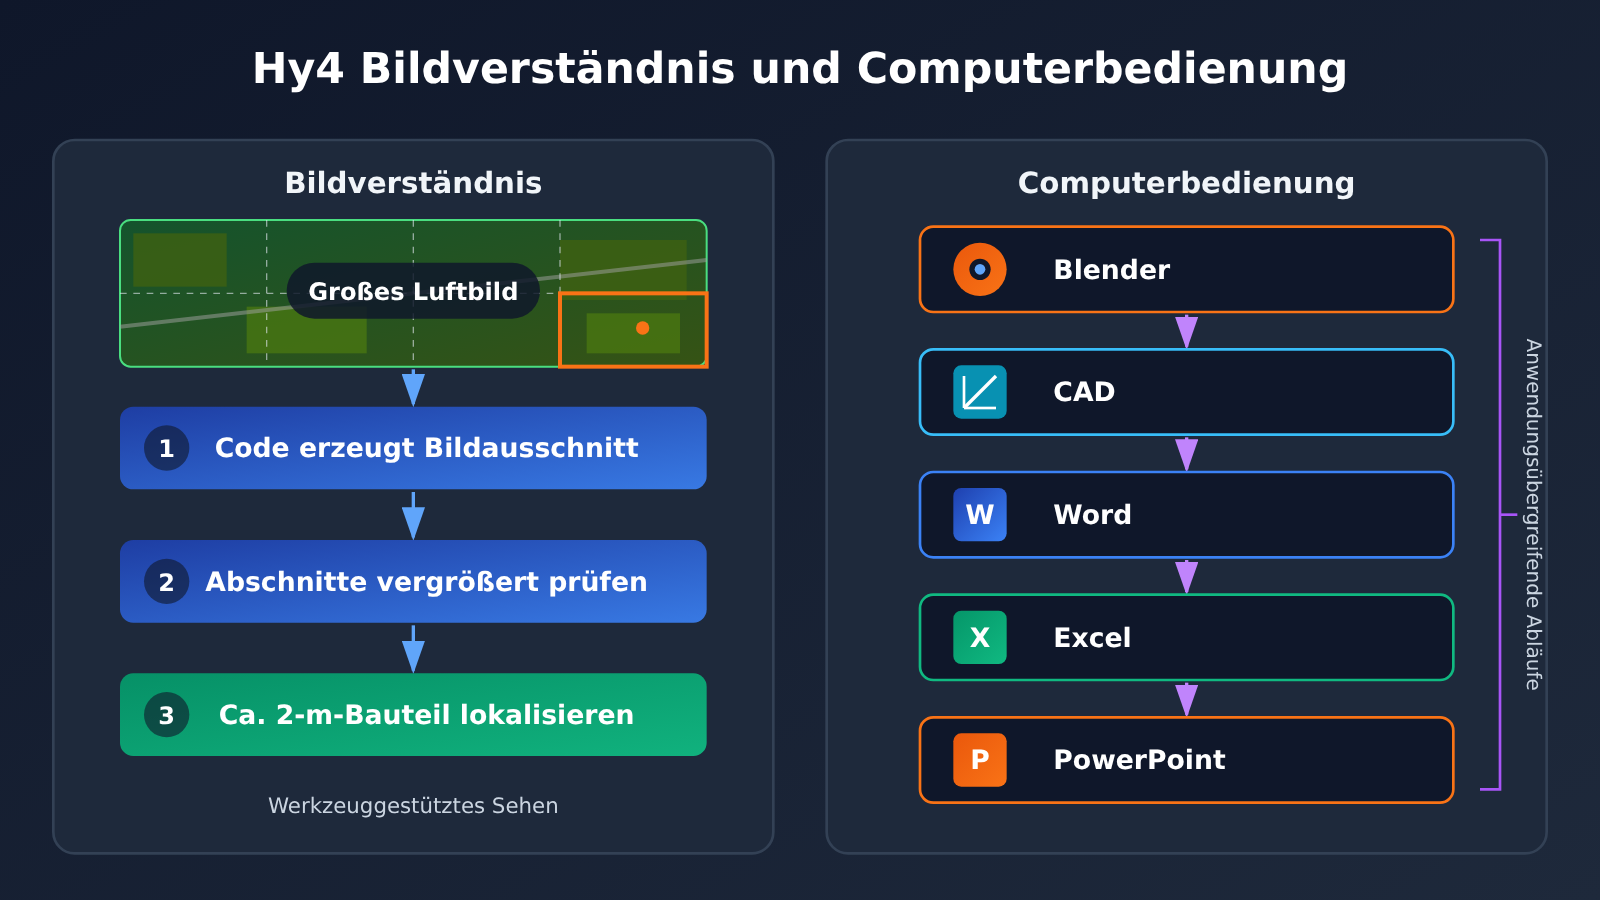
In einer Demonstration von Tencent sollte Hy4 auf einer Luftaufnahme mit 2,8 Milliarden Pixeln ein etwa zwei Meter großes Bauteil auf dem Dach eines bestimmten Lagergebäudes finden. Statt das gesamte Bild auf einmal zu „betrachten“, erzeugte das Modell per Code einzelne Bildausschnitte und untersuchte sie nacheinander vergrößert. Dieser werkzeuggestützte Ansatz ist auch für die Verarbeitung sehr großer Pläne, Fernerkundungsbilder und komplexer Diagramme interessant.
Laut Tencent kann das Bildverständnis auch beim Programmieren helfen, etwa beim Erstellen von Websites und Spielen anhand von Designvorlagen. Für die Spieleentwicklung hat Tencent mit eigenen Spielestudios zusammengearbeitet und Hy4 an gängige Engines wie Unreal, Unity und Godot angepasst. Nach Angaben des Entwicklerteams von Honor of Kings erledigt Hy4 Konfigurationsaufgaben nahezu fehlerfrei und findet die Grundursachen von Bugs deutlich häufiger als zuvor. Diese Rückmeldungen stammen allerdings von einem internen Tencent-Team; eine Testmethode wurde nicht veröffentlicht.
Hy4 am Computer: Fachsoftware und anwendungsübergreifende Aufgaben
Hy4 kann erstmals eigenständig einen Computer bedienen und Software direkt steuern, um Aufgaben zu erledigen. Tencent hat das Modell gezielt mit professionellen Werkzeugen wie Blender und CAD trainiert. Zum Training gehörten auch Aufgaben, bei denen mehrere Anwendungen nacheinander zum Einsatz kommen. Im Büro kann Hy4 in Echtzeit mit Menschen an Word-, Excel- und PowerPoint-Dateien arbeiten.
Ein wichtiger Vergleich: Am selben Tag veröffentlichte das Analyseunternehmen SemiAnalysis den GDPx-Benchmark. Darin bedienen KI-Agenten in einer simulierten realen Arbeitsumgebung Fachsoftware wie Siemens NX; einzelne Aufgaben dauern bis zu acht Stunden. Kein Modell erreichte mehr als 12 %, selbst der Erstplatzierte Claude Opus 5.5 kam nur auf 12 %. Hy4 steht nicht auf dieser Bestenliste. Das Ergebnis zeigt aber: Die Fähigkeit, Computer zu bedienen, steckt in der gesamten Branche noch in den Anfängen. Zwischen „Software bedienen können“ und „professionelle Aufgaben eigenständig erledigen können“ liegt weiterhin ein großer Unterschied.
Hy4 trainiert seine eigenen „Nachkommen“ mit
Tencent stellte auch einen besonderen Anwendungsbereich vor: Hy4 soll die KI-Entwicklung selbst verbessern. In internen Tests zu Forschungsaufgaben aus sieben Bereichen belegte Hy4 laut Tencent unter den offenen Modellen den ersten Platz. Zusammen mit dem Agentensystem Hyra 2.0 steigerte Hy4 den Durchsatz der internen Trainingsinfrastruktur von Tencent in sechs Schritten um etwa 20 %.
Anschließend trainierte Hy4 eigenständig eine Version von Jev, dem Entscheidungsmodell des US-Start-ups TypeSafe AI. Diese Hyra-Jev-Variante übertraf das ursprüngliche Jev bei sechs von acht Benchmarks. Zwei auf diese Weise entwickelte Spezialmodelle für Biologie und Physik will Tencent ebenfalls als offene Modelle veröffentlichen. All das sind Tests von Tencent selbst. Dennoch zeigen sie die langfristige Absicht: Hy4 soll die interne KI-Forschung und -Entwicklung beschleunigen.
Tencent Hy4 im Testvergleich: Hersteller, Partner und unabhängige Institutionen
Dieser Abschnitt ist der Schwerpunkt des Artikels. Die drei Seiten zeichnen vom selben Modell deutlich unterschiedliche Bilder. Bei der Auswahl sollte man daher genau darauf achten, wer die jeweilige Aussage macht.
| Informationsquelle | Kernaussage | Art der Bewertung | Hinweis zur Glaubwürdigkeit |
|---|---|---|---|
| Tencent offiziell | Über 200 Finanzfachleute bewerteten knapp 600 reale Aufgaben. Hy4 lag vor DeepSeek V4.1 Flash, Kimi K3.1 Pro und GLM-5.3 Flash | Herstellertest | Details zur Testmethodik wurden nicht veröffentlicht |
| Tencent offiziell | Nach einer Überarbeitung der Suchfunktion sank die Halluzinationsrate bei der Onlinerecherche von knapp 16 % auf etwa 5 % | Interner Herstellertest | Gilt nur für die Onlinerecherche |
| Tencent offiziell | In Tencents zwölf eigenen Benchmarks lag Claude Opus 5.5 durchgehend vor Hy4, GPT 6.1 Sol bei acht davon | Herstellertest | Tencent räumt den Abstand selbst ein, daher vergleichsweise aussagekräftig |
| Partner Comein | Hy4 ist das einzige chinesische Modell, das sich mit Claude Opus 5.5 den zweiten Platz teilt; bei Finanzdatenabfragen liegt es deutlich vor GPT-6.1 Sol | Partnertest | Bezieht sich nur auf dessen Finanzdatenabfragen |
| Partner Manus | Hy4 kann nahezu alle dokumentbezogenen Aufgaben erfolgreich abschließen | Partnertest | Schwierigkeit und Umfang der Aufgaben wurden nicht veröffentlicht |
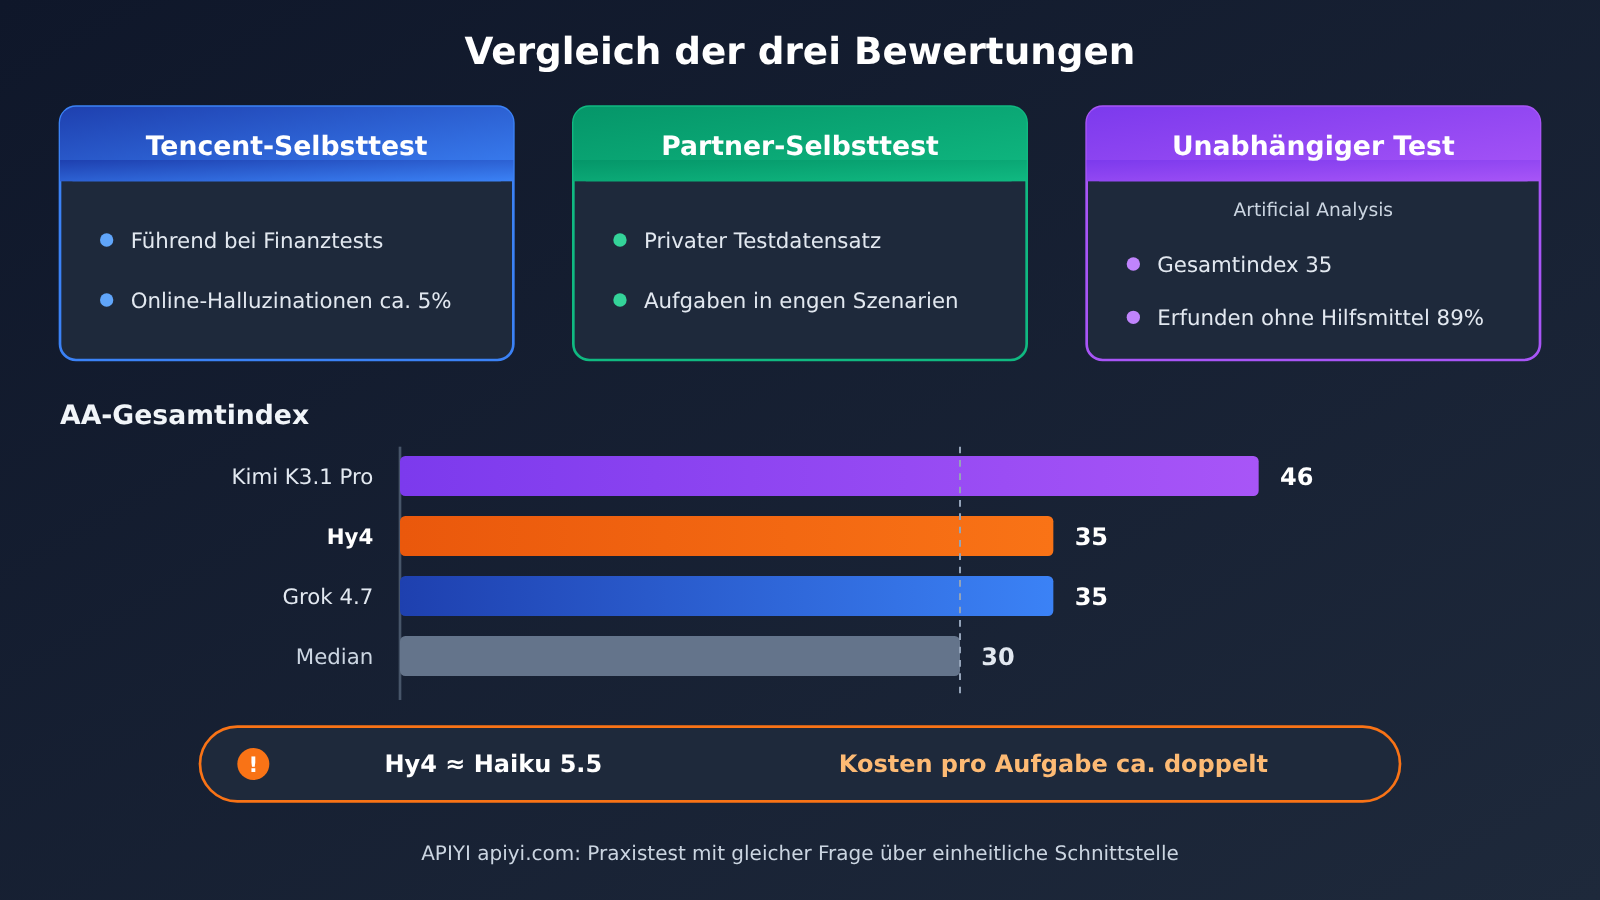
| Artificial Analysis | 35 Punkte im Gesamtindex, über dem Median von 30 Punkten und gleichauf mit Grok 4.7; unter den chinesischen Modellen auf Platz zwei, hinter Kimi K3.1 Pro mit 46 Punkten | Unabhängiger Test durch Dritte | 60 % der Testdaten sind nicht öffentlich, was eine gezielte Optimierung erschwert |
| Artificial Analysis | Ohne Internetzugang beantwortet Hy4 etwa die Hälfte der Faktenfragen richtig. Kennt es die Antwort nicht, erfindet es in 89 % der Fälle eine | Unabhängiger Test durch Dritte | Test der Faktenkenntnisse ohne Zugriff auf externe Quellen |
Die wichtigsten Unterschiede zwischen Tencents Hy4-Selbsttest und unabhängigen Bewertungen
Am deutlichsten zeigt sich der Unterschied beim Vergleich von Hy4 und Kimi K3.1 Pro. In Tencents Finanztest liegt Hy4 vor Kimi, im Gesamtindex von Artificial Analysis dagegen 11 Punkte dahinter. Das muss kein Widerspruch sein: Der Finanztest betrachtet ein enges Anwendungsszenario, während der Gesamtindex mehrere Bereiche abdeckt, darunter Wissensarbeit, Programmierung, Naturwissenschaften und Alltagswissen. Hy4 scheint also in Finanzanwendungen, auf die Tencent bei der Entwicklung besonders Wert gelegt hat, Vorteile zu haben – bei den Gesamtfähigkeiten liegt es aber nicht vorn.
Auch beim Preis-Leistungs-Verhältnis gibt es einen wichtigen Punkt: Laut Artificial Analysis erzielt Hy4 ungefähr denselben Gesamtwert wie Haiku 5.5, Anthropics kleinstes Modell. Die Kosten pro Aufgabe betragen bei Haiku 5.5 in diesem Benchmark aber fast nur die Hälfte. Aus dem Token-Preis allein lässt sich also nicht schließen, dass „Hy4 günstiger“ ist. Entscheidend ist auch, wie viele Token tatsächlich für eine Aufgabe verbraucht werden.
Schwächen von Tencent Hy4 bei anspruchsvollen Aufgaben
Tencent räumt selbst ein, dass Hy4 bei höherer Mathematik, umfangreichen Programmierprojekten und komplexen Bildanalysen noch deutlich hinter den besten kommerziellen Modellen zurückliegt. Am grössten ist der Abstand bei Hy-FrontierMath T5:
| Benchmark / Dimension | Hy4 | GPT 6.1 Sol | Claude Opus 5.5 | Quelle |
|---|---|---|---|---|
| Hy-FrontierMath T5 | 13.0 | 97.5 | 91.3 | Tencent, offiziell |
| 12 eigene Benchmarks von Tencent | In allen hinter Opus 5.5 | In 8 vor Hy4 | In allen 12 vorne | Tencent, offiziell |
| AA-Gesamtindex | 35 | In den Unterlagen nicht angegeben | In den Unterlagen nicht angegeben | Artificial Analysis |
| Faktentreue ohne Internetzugang | Etwa die Hälfte richtig beantwortet; bei fehlendem Wissen in 89 % der Fälle Antworten erfunden | In den Unterlagen nicht angegeben | In den Unterlagen nicht angegeben | Artificial Analysis |
13.0 gegenüber über 90 – das ist nicht mehr nur „etwas schwächer“, sondern eine ganz andere Leistungsklasse. Wenn Ihr Anwendungsfall mathematisches Schlussfolgern auf Wettbewerbsniveau, langfristige Softwareprojekte oder hochpräzise Bildanalysen umfasst, eignet sich Hy4 derzeit nicht als Hauptmodell.
Tencent Hy4: Was bedeutet das für Entwickler und Produktteams?
Für Entwickler: Mit und ohne Internetzugang praktisch zwei verschiedene Modelle
Betrachtet man die beiden Zahlen „etwa 5 % Halluzinationen mit Internetzugang“ und „89 % erfundene Antworten ohne Internetzugang“ zusammen, wird eines klar: Die faktische Zuverlässigkeit von Hy4 hängt stark von externer Recherche ab. Die 5 % stammen aus einem internen Test von Tencent mit Internetsuche. Die 89 % hat Artificial Analysis unter Bedingungen ohne Zugriff auf externe Quellen ermittelt. Bei der Integration in ein Produkt sollte Hy4 daher grundsätzlich als Modell geplant werden, das eine Rechercheanbindung benötigt.
Für die Umsetzung bieten sich unter anderem diese Maßnahmen an:
- Faktenfragen immer mit Recherche beantworten: Zuerst Material per Suche oder RAG abrufen und das Modell anschließend auf dieser Grundlage antworten lassen – nicht aus dem Gedächtnis.
- In der Eingabeaufforderung ausdrücklich erlauben, dass das Modell etwas nicht weiß: Für Inhalte, die in den Quellen fehlen, soll es direkt mit „In den Quellen nicht erwähnt“ antworten. Das senkt das Risiko erfundener Aussagen.
- Quellenangaben verlangen: Das Modell soll für jede Schlussfolgerung den entsprechenden Quellenabschnitt nennen, damit sich die Antworten stichprobenartig prüfen lassen.
- Wichtige Zahlen doppelt prüfen: Zahlen in Finanz- und Berichtsausgaben sollten zusätzlich programmatisch oder anhand von Regeln überprüft werden. Wie die GDPx-Bewertung zeigt, kann schon ein falscher Tabellenwert eine gesamte Ausgabe wertlos machen.
Hier ein minimales Aufrufbeispiel mit „Retrieval-Augmentierung + erlaubter Antwortverweigerung“. Ersetzen Sie den Modellnamen durch ein tatsächlich verfügbares Modell. Die konkrete Modell-ID für Hy4 finden Sie in der Konsole der jeweiligen Plattform.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "(这里放检索召回的资料片段)"
resp = client.chat.completions.create(
    model="your-model-name",
    messages=[
        {"role": "system", "content": "只依据给定资料回答;资料没有的内容回答“资料未提及”,并标注出处段落。"},
        {"role": "user", "content": f"资料:{context}\n\n问题:该公司三季度营收是多少?"}
    ],
    temperature=0
)
print(resp.choices[0].message.content)
Vollständige Implementierung ansehen: Dieselbe Frage mit mehreren Modellen vergleichen und die Antwortverweigerungsrate ermitteln
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "只依据给定资料回答问题。"
    "如果资料中没有答案,必须只回答:资料未提及。"
    "回答时注明依据的资料段落编号。"
)

def ask(model: str, context: str, question: str) -> str:
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": f"资料:\n{context}\n\n问题:{question}"}
            ],
            temperature=0,
            max_tokens=500
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

def evaluate(models: List[str], cases: List[Dict]) -> None:
    """Bei Fällen mit answerable=False enthalten die Unterlagen absichtlich keine Antwort, um die Tendenz zum Erfinden von Antworten zu testen."""
    for m in models:
        refused, fabricated = 0, 0
        for c in cases:
            out = ask(m, c["context"], c["question"])
            if not c["answerable"]:
                if "资料未提及" in out:
                    refused += 1
                else:
                    fabricated += 1
        print(f"{m}: 正确拒答 {refused},疑似编造 {fabricated}")

cases = [
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "三季度营收是多少?", "answerable": False},
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "二季度营收是多少?", "answerable": True},
]

# Ersetze die Liste durch die IDs der Modelle, die du vergleichen möchtest
evaluate(["model-a", "model-b"], cases)
🎯 Empfehlung zur Modellauswahl: Um neue Modelle wie Hy4 zu bewerten, vergleichst du sie am zuverlässigsten anhand derselben Fragen aus deinen eigenen Anwendungsfällen, statt nur auf Ranglisten zu schauen. APIYI apiyi.com bietet eine einheitliche OpenAI-kompatible Schnittstelle: Mit einem API-Schlüssel kannst du Claude, GPT, Gemini und Modelle mehrerer chinesischer Anbieter aufrufen und so alle Kandidaten mit demselben Testdatensatz prüfen. Ob Hy4 bereits auf der Plattform verfügbar ist, siehst du in der Modellliste der Konsole.
Auswirkungen für Produktverantwortliche: Für welche Aufgaben eignet sich Hy4?
Aus den Informationen der drei Quellen lässt sich die Eignung von Hy4 für verschiedene Aufgaben grob wie folgt einordnen.
| Aufgabentyp | Eignung | Grundlage | Nutzungsempfehlung |
|---|---|---|---|
| Finanzdaten abfragen, Research-Berichte aufbereiten | Gut geeignet | Finanztests von Tencent und Feedback von Comein, beides eigene Tests | Recherche zwingend einbinden und wichtige Zahlen programmatisch prüfen |
| Word-, Excel- und PowerPoint-Dokumente bearbeiten | Gut geeignet | Echtzeit-Zusammenarbeit bei Tencent; Manus meldet eine hohe Abschlussrate bei Dokumentaufgaben | Zunächst mit risikoarmen Dokumentaufgaben beginnen |
| Game-Engines konfigurieren, Bugs lokalisieren | Einen Versuch wert | Feedback interner Spiele-Teams von Tencent | Geeignet für Konfiguration und Fehlersuche, nicht für langfristige Projekte |
| Webseiten und Minispiele als Prototypen erstellen | Einen Versuch wert | Bildverständnis zur Unterstützung beim Programmieren | Als Prototyping-Tool nutzen; Produktionscode muss von Menschen geprüft werden |
| Fragen mithilfe einer Online-Recherche beantworten | Einen Versuch wert | In internen Tests lag die Halluzinationsrate bei Online-Recherchen bei etwa 5 % | Recherche aktivieren und Quellenangaben verlangen |
| Wissensfragen ohne Internetzugriff beantworten | Nicht empfohlen | Bei fehlendem Wissen werden in 89 % der Fälle Antworten erfunden | Das Modell Faktenfragen nicht aus dem Gedächtnis beantworten lassen |
| Höhere Mathematik, Wettbewerbsaufgaben zum logischen Schlussfolgern | Nicht empfohlen | Bei Hy-FrontierMath T5 nur 13,0 Punkte | Führende kommerzielle Modelle wählen |
| Langfristige Programmierprojekte, komplexe Bildanalysen | Nicht empfohlen | Tencent räumt offiziell einen deutlichen Rückstand ein | Ein leistungsfähigeres Modell wählen oder Aufgaben aufteilen |
Auswirkungen auf die Branche: Offene Modellgewichte bei zugleich strengerer Regulierung
Für Hy4 ist die Veröffentlichung der Modellgewichte geplant. Unternehmen könnten das Modell dadurch künftig in ihrer eigenen Infrastruktur betreiben. Ein Veröffentlichungstermin und die Lizenz stehen allerdings noch nicht fest. Für Vorhaben mit verbindlichen Lieferterminen sollte diese Option daher vorerst nicht eingeplant werden.
Auch auf regulatorischer Ebene gibt es Veränderungen. Das chinesische Handels- und das Wissenschaftsministerium haben im Oktober einen Entwurf für Exportkontrollen veröffentlicht. Er betrifft die Gewichte von Modellen, die weltweit zu den zehn führenden zählen oder mehr als zwei Billionen Parameter haben. Für Open-Source-Veröffentlichungen ist jedoch ein beschleunigtes Verfahren mit automatischer Genehmigung vorgesehen. Zur Sicherheit erklärt Tencent, dass beim Training Material mit Bezug zu Hacking gezielt herausgefiltert wurde. Das eigene Sicherheitslabor habe kein erhöhtes Missbrauchsrisiko festgestellt; auch das biologische Gefährdungspotenzial liege deutlich unter dem festgelegten Risikoschwellenwert. Ein ausführlicher Sicherheitsbericht soll zusammen mit den Modellgewichten veröffentlicht werden.
Häufige Fragen zu Tencent Hy4
Q1: Was ist Tencent Hy4?
Hy4 ist Tencents erste reguläre Version des Großen Sprachmodells nach der Preview. Es unterstützt erstmals Bildverständnis und kann Computersoftware eigenständig bedienen. Optimiert wurde es vor allem für Programmierung, Finanz- und Büroaufgaben. Derzeit ist es über Tencent Cloud, OpenRouter und Anwendungen wie Yuanbao nutzbar. Die Modellgewichte sollen später veröffentlicht werden.
Q2: Wie schneidet Hy4 im Vergleich zu Kimi K3.1 Pro und Claude Opus 5.5 ab?
In Tencents eigenem Finanztest liegt Hy4 vor Kimi K3.1 Pro. In der unabhängigen Bewertung von Artificial Analysis erreicht Hy4 dagegen 35 Punkte und liegt damit hinter Kimis 46 Punkten. Gegenüber Claude Opus 5.5 liegt Hy4 in allen zwölf Benchmarks von Tencent zurück. Wer die Modelle für den eigenen Anwendungsfall vergleichen möchte, kann über APIYI apiyi.com mehrere Modelle über eine einheitliche Schnittstelle mit denselben Aufgaben testen.
Q3: Wann werden die Modellgewichte und Hy4 flash veröffentlicht?
Stand 6. November 2026 hat Tencent weder ein konkretes Datum noch eine Lizenz für die Veröffentlichung der Modellgewichte bekannt gegeben. Lediglich der Sicherheitsbericht soll gleichzeitig mit den Gewichten erscheinen. Auch für das schnellere und günstigere Hy4 flash ist bisher nur bestätigt, dass es geplant ist. Erscheinungsdatum und Preis sind noch nicht öffentlich. Hier lohnt es sich, die offiziellen Ankündigungen im Blick zu behalten.
Q4: Ist Hy4 teuer?
Hy4 kostet rund 0,83 US-Dollar pro Million Eingabe-Token und rund 2,50 US-Dollar pro Million Ausgabe-Token – genauso viel wie die Preview. Laut Artificial Analysis kostet eine einzelne Aufgabe mit Haiku 5.5, das eine ähnliche Punktzahl erreicht, jedoch fast nur halb so viel. Für die Gesamtkosten sollte man daher den tatsächlichen Verbrauch bei den eigenen Aufgaben berücksichtigen.
Q5: Wie lässt sich das Risiko verringern, dass Hy4 Fakten erfindet?
Entscheidend ist, das Modell Faktenfragen nicht aus dem Gedächtnis beantworten zu lassen: Aktivieren Sie die Websuche oder binden Sie RAG ein. Erlauben Sie ihm in der Eingabeaufforderung, mit „In den Unterlagen nicht erwähnt“ zu antworten, und verlangen Sie Quellenangaben. Das Vergleichsskript weiter oben hilft dabei, verweigerte Antworten und erfundene Angaben verschiedener Modelle zu erfassen. Zusammen mit dem kostenlosen Testguthaben für Neukunden von APIYI apiyi.com lässt sich so eine erste Überprüfung kostengünstig durchführen.
Q6: Welche Einschränkungen von Hy4 sind bekannt?
Es gibt drei wesentliche Einschränkungen: Erstens fällt Hy4 bei besonders schwierigen Aufgaben deutlich zurück und erreicht in Hy-FrontierMath T5 nur 13,0 Punkte. Zweitens sind seine Faktenkenntnisse ohne Internetverbindung unzuverlässig: Kennt es die Antwort nicht, erfindet es in 89 % der Fälle eine. Drittens stammen mehrere positive Ergebnisse aus Tests von Tencent oder seinen Partnern, deren methodische Details nicht öffentlich sind. Deshalb sollten sie mit eigenen Daten überprüft werden.
Tencent Hy4: Die wichtigsten Punkte
- Zwei Neuerungen: Hy4 unterstützt erstmals Bildverständnis und die eigenständige Bedienung eines Computers, unter anderem für Blender, CAD und Office-Dokumente.
- Preise unverändert: Rund 0,83 US-Dollar pro Million Eingabetokens und 2,50 US-Dollar pro Million Ausgabetokens – genau wie bei der Vorschauversion.
- Im unabhängigen Test im oberen Mittelfeld: 35 Punkte im Gesamtindex von Artificial Analysis (AA), Platz zwei unter den chinesischen Modellen, aber deutlich hinter Kimi K3.1 Pro.
- Rechercheanbindung ist Pflicht: Mit Internetzugang liegt die Halluzinationsrate bei etwa 5 %. Ohne Internet erfindet das Modell in 89 % der Fälle eine Antwort, wenn es die Antwort nicht kennt.
- Rückstand bei schwierigen Aufgaben: Bei höherer Mathematik, langen Programmierprojekten und komplexen Bildanalysen liegt Hy4 deutlich hinter den führenden kommerziellen Modellen.
- Eigene Tests überprüfen: Finanz-Rankings und Schlussfolgerungen von Partnern basieren überwiegend auf eigenen Tests. Vor dem produktiven Einsatz sollten Unternehmen sie mit eigenen Beispielen überprüfen.
- Sicherer vergleichen: Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich Alternativen und Vergleichsmodelle zu Hy4 mit demselben Testsatz prüfen.
Zusammenfassung
Die wichtigsten Erkenntnisse zu Tencent Hy4:
- Deutliche Fortschritte bei den Fähigkeiten: Bildverständnis und Computerbedienung sind die größten Neuerungen dieser Generation. Besonders intensiv wurde an Anwendungen für Finanzen und Büroarbeit gearbeitet.
- Aussagen der drei Seiten getrennt betrachten: Die eigenen Tests des Herstellers und seiner Partner fallen eher optimistisch aus. Die unabhängige Bewertung von Artificial Analysis sieht Hy4 auf Platz zwei unter den chinesischen Modellen, auf einem ähnlichen Niveau wie Haiku 5.5.
- Konkrete Schwächen: Ohne Internetzugang erfindet das Modell leicht Antworten; bei anspruchsvoller Mathematik und langen Programmierprojekten fällt es deutlich zurück. Das ist für die Modellauswahl unmittelbar relevant.
Für Aufgaben wie Finanzdatenabfragen, Dokumentenverarbeitung oder Spielkonfigurationen ist ein Pilotversuch mit Hy4 und Rechercheanbindung sinnvoll. Wenn die Anwendung dagegen auf Wissen ohne externe Quellen oder anspruchsvolle Schlussfolgerungen angewiesen ist, eignen sich derzeit stärkere Modelle besser. Empfehlenswert ist, die Kandidaten zunächst über die einheitliche Schnittstelle von APIYI apiyi.com anhand derselben Aufgaben zu testen und anschließend Kosten und Genauigkeit gegeneinander abzuwägen.
📚 Quellen
- THE DECODER – Tencent releases Hy4 with vision and computer use: Bericht zur Veröffentlichung von Hy4
- Link:
the-decoder.com/tencent-releases-hy4-with-vision-and-computer-use-claims-second-place-among-chinese-ai-models -
Inhalt: Offizielle Daten von Tencent, Rückmeldungen von Partnern und unabhängige Testergebnisse von Artificial Analysis
-
THE DECODER – SemiAnalysis GDPx 基准报道: Bewertung von KI-Agenten in realen Arbeitsszenarien
- Link:
the-decoder.com/no-ai-agent-scores-above-12-percent-on-semianalysis-new-real-world-work-benchmark -
Inhalt: Ein Überblick über die Leistungsfähigkeit von Agenten, die professionelle Software am Computer bedienen
-
Artificial Analysis: Unabhängige Organisation zur Bewertung von Modellen
- Link:
artificialanalysis.ai - Inhalt: Aktuelle Ergebnisse unter anderem zum Intelligence Index und zu AA-Omniscience
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI unter apiyi.com. Weitere Informationen zur Integration finden Sie im Dokumentationsportal unter docs.apiyi.com.


