
著者注:テンセントの Hy4 正式版がリリースされ、初めて画像理解とパソコン操作に対応しました。この記事では、メーカーの発表、パートナーによるテスト、第三者による独立評価を比較し、能力の限界と適した用途を整理します。
テンセントは、プレビュー版の公開から約2か月後に Hy4 の正式版をリリースしました。初めて画像理解とパソコンソフトの自律操作に対応し、価格はプレビュー版から据え置かれています。テンセントは、Hy4 が初めて最強クラスのオープンウェイトモデルの仲間入りを果たしたとしていますが、モデルの重みが公開されるのは、まだ発表されていない将来の日付です。
この記事は、発表会の内容をそのまま伝えるだけのものではありません。テンセント自身のテスト、パートナーからのフィードバック、Artificial Analysis による独立評価は必ずしも一致しておらず、結果に大きな差がある項目もあります。この記事では三者の見解を一つずつ比較し、メーカーの主張と独立した評価結果を区別します。
この記事でわかること:Hy4 に追加された機能や価格、明らかに後れを取っているタスク、そしてプログラミング、金融、オフィス業務で堅実に活用する方法を紹介します。
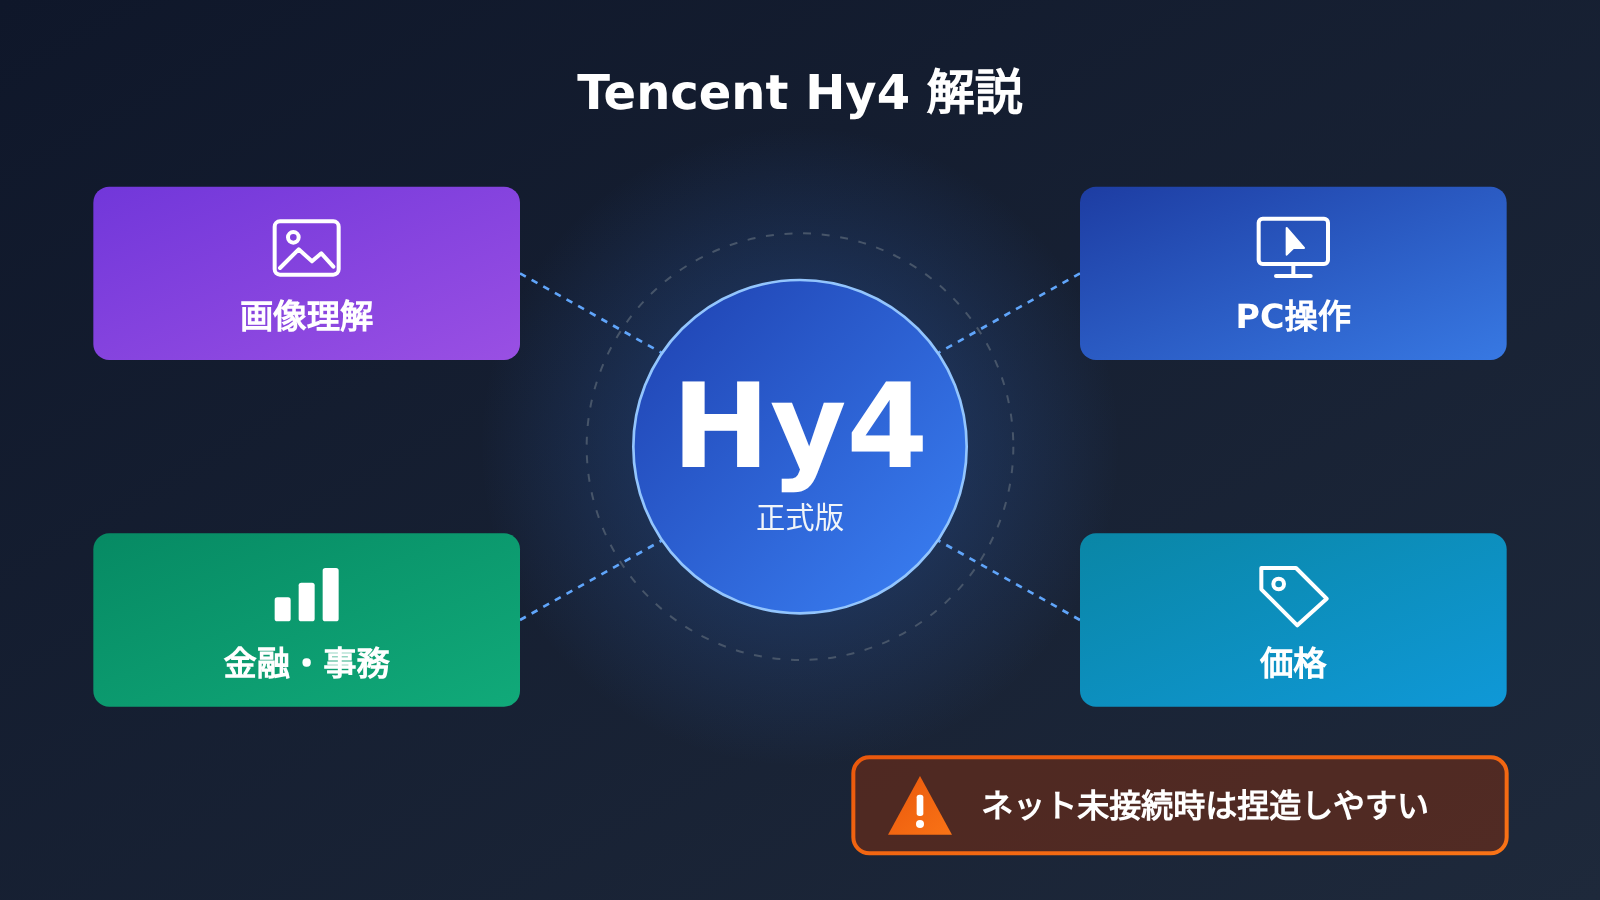
Tencent Hy4の基本情報
まず、確認済みの情報を表にまとめました。能力に関する記述の多くはTencentの公式発表に基づいています。第三者によるデータは後ほど個別に明記します。
| 項目 | 詳細 |
|---|---|
| 提供元 | Tencent |
| リリース時期 | プレビュー版のリリースから約2か月後に正式版を公開 |
| 現在の利用方法 | Tencent Cloud、OpenRouter、元宝などのTencent自社アプリ |
| モデルの重み | 公開予定。具体的な日付は未発表。安全性レポートも重みとあわせて公開予定 |
| 主な新機能 | 画像理解と、コンピューター上のソフトウェアの自律操作に初めて対応 |
| 重点的な最適化分野 | プログラミング、金融、オフィス業務 |
| 料金 | 入力100万トークンあたり約0.83ドル、出力100万トークンあたり約2.50ドル。プレビュー版と同額 |
| 今後の予定 | より高速で安価なHy4 flash版をリリース予定。時期と料金は未定 |
Tencent Hy4のリリース背景
Tencentの前世代モデルHy3は、2,950億のパラメータを持ち、Apache 2.0ライセンスで公開されました。その後の数か月間に、智谱はGLM-5.3を、DeepSeekはV4.1-Flash-1017を、月之暗面はKimi K3.1 Proをリリースし、中国国内のモデル間競争は激しさを増しています。Hy4は、こうした競争の中でTencentを再びトップグループに引き戻すモデルとして位置づけられています。
もう一つ注目したいのが、評価基準の変更です。Artificial Analysisは10月下旬に総合指数を改定し、現在はその60%が非公開の独自テストセットに基づいています。新基準では、オープンモデルと最先端モデルの差が3ポイントから12ポイントに広がりました。そのため、Hy4のスコアを改定前の旧ランキングと直接比較するのは適切ではありません。
腾讯 Hy4のマルチモーダル能力とPC操作能力を解説
画像理解とPC操作は、Hy4世代における2つの大きな変化です。前者によってモデルは画像を理解でき、後者によって実際に操作できるようになります。この2つが組み合わさって初めて、実際のオフィス業務や開発フローに対応できる可能性が生まれます。
Hy4の画像理解:コードで画像を切り出して細部を探す
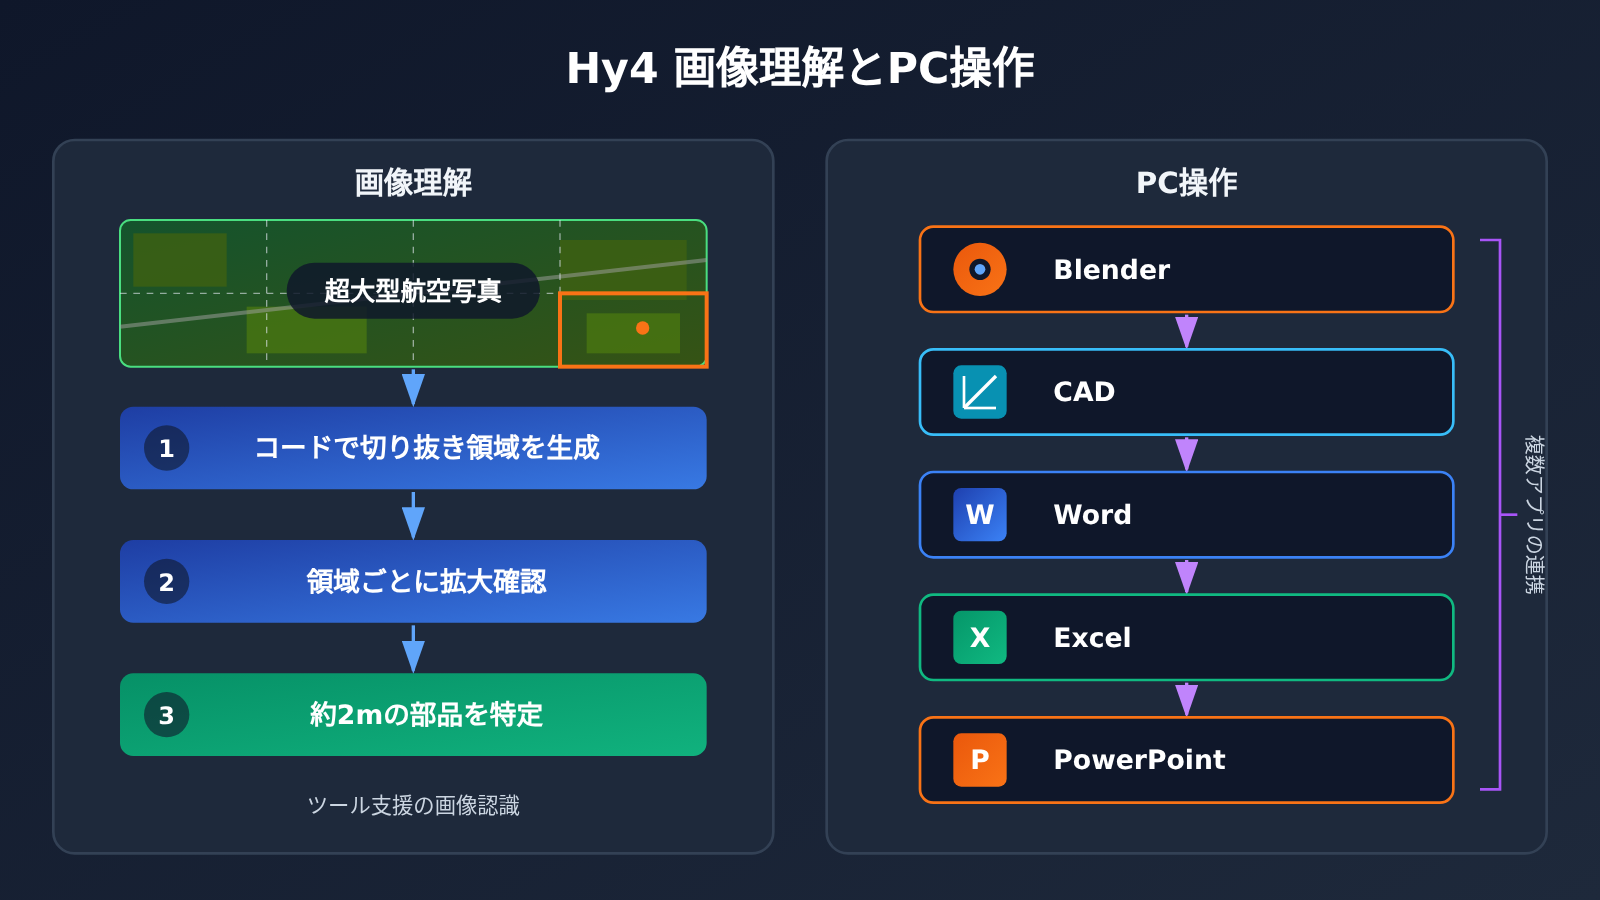
腾讯のデモでは、Hy4が28億画素の航空写真から、ある倉庫の屋根にある約2メートルの部品を探しました。画像全体を一度に「見る」のではなく、コードで切り出す領域を生成し、一部分ずつ拡大して確認する方法です。このように「ツールを使って画像を見る」アプローチは、超大サイズの図面やリモートセンシング画像、複雑なグラフを扱う際にも参考になりそうです。
腾讯によると、画像理解は、デザイン画像をもとにWebサイトやゲームを構築するなど、プログラミングにも役立ちます。ゲーム開発では、自社のゲームスタジオと協力し、Unreal、Unity、Godotなどの主要エンジンに対応しました。『王者荣耀』開発チームのフィードバックによれば、Hy4は設定関連のタスクをほぼミスなく処理し、バグの根本原因を特定する成功率も以前より大幅に向上したとのことです。ただし、これは腾讯の社内チームによるフィードバックで、テスト方法は公開されていません。
Hy4のPC操作:専門ソフトや複数アプリを連携
Hy4は初めてPCを自律的に操作する能力を備え、ソフトウェアを直接操作してタスクを実行できるようになりました。腾讯はBlenderやCADなどの専門ツールを使った訓練を行い、複数のアプリを順番に使うタスクにも対応させています。オフィス業務では、人間とリアルタイムで協力しながらWord、Excel、PowerPointのファイルを扱えます。
ここで、参考になる重要なデータがあります。同日、調査機関のSemiAnalysisはGDPxベンチマークを公開しました。このベンチマークでは、実際の職場を模した環境でAIエージェントにSiemens NXなどの専門ソフトを操作させ、1つのタスクに最大8時間をかけます。その結果、12%を超えるスコアを獲得したモデルはなく、1位のClaude Opus 5.5も12%にとどまりました。Hy4はこのランキングに登場していませんが、この結果は、PC操作能力が業界全体でまだ初期段階にあり、「ソフトを操作できる」ことと「専門的な仕事を自力で完遂できる」ことの間には、依然として大きな隔たりがあることを示しています。
Hy4が自らの「後継モデル」の訓練に参加
腾讯は、Hy4を使ってAI開発そのものを改善するという、少し変わった方向性も示しました。7分野の社内研究タスクを使ったテストでは、Hy4がオープンモデルの中で1位になったと腾讯は発表しています。また、Hy4とエージェントシステムHyra 2.0を組み合わせ、6つのステップで腾讯社内の訓練インフラのスループットを約20%向上させました。
その後、Hy4は米国のスタートアップTypeSafe AIの意思決定モデルJevの一バージョンを自律的に訓練しました。このHyra-Jevの派生モデルは、8項目のベンチマークのうち6項目で元のJevを上回っています。腾讯はまた、この方法で開発した生物学と物理学の専用モデルを2つ、オープンモデルとして公開する予定です。いずれも腾讯による自主テストですが、Hy4を社内のAI研究開発を加速する存在にしたいという長期的な意図がうかがえます。
腾讯 Hy4 の三者評価比較:メーカー、パートナー、独立機関
このセクションは記事全体の要点です。同じモデルでも、三者の評価には明確な違いがあります。モデルを選ぶ際は、まず誰の評価なのかを確認しましょう。
| 情報源 | 主な結論 | 評価の種類 | 信頼性の判断ポイント |
|---|---|---|---|
| 腾讯公式 | 200人以上の金融実務者が約600件の実際のタスクを評価し、Hy4 は DeepSeek V4.1 Flash、Kimi K3.1 Pro、GLM-5.3 Flash を上回った | メーカーによる自主評価 | テスト方法の詳細は非公開 |
| 腾讯公式 | 検索機能の改修後、インターネット検索時のハルシネーション率が約16%から約5%に低下した | メーカーの内部テスト | インターネット検索の場面に限定 |
| 腾讯公式 | 自社の12項目のベンチマークで、Claude Opus 5.5 はすべて Hy4 を上回り、GPT 6.1 Sol は8項目で上回った | メーカーによる自主評価 | 腾讯自身が差を認めており、参考価値は比較的高い |
| パートナー Comein | Hy4 は Claude Opus 5.5 と並んで2位になった唯一の中国製モデルで、データ照会では GPT-6.1 Sol を明確に上回った | パートナーによる自主評価 | 同社の金融データ照会の場面に限定 |
| パートナー Manus | Hy4 は文書関連のタスクをほぼすべて成功させた | パートナーによる自主評価 | タスクの難易度と範囲は非公開 |
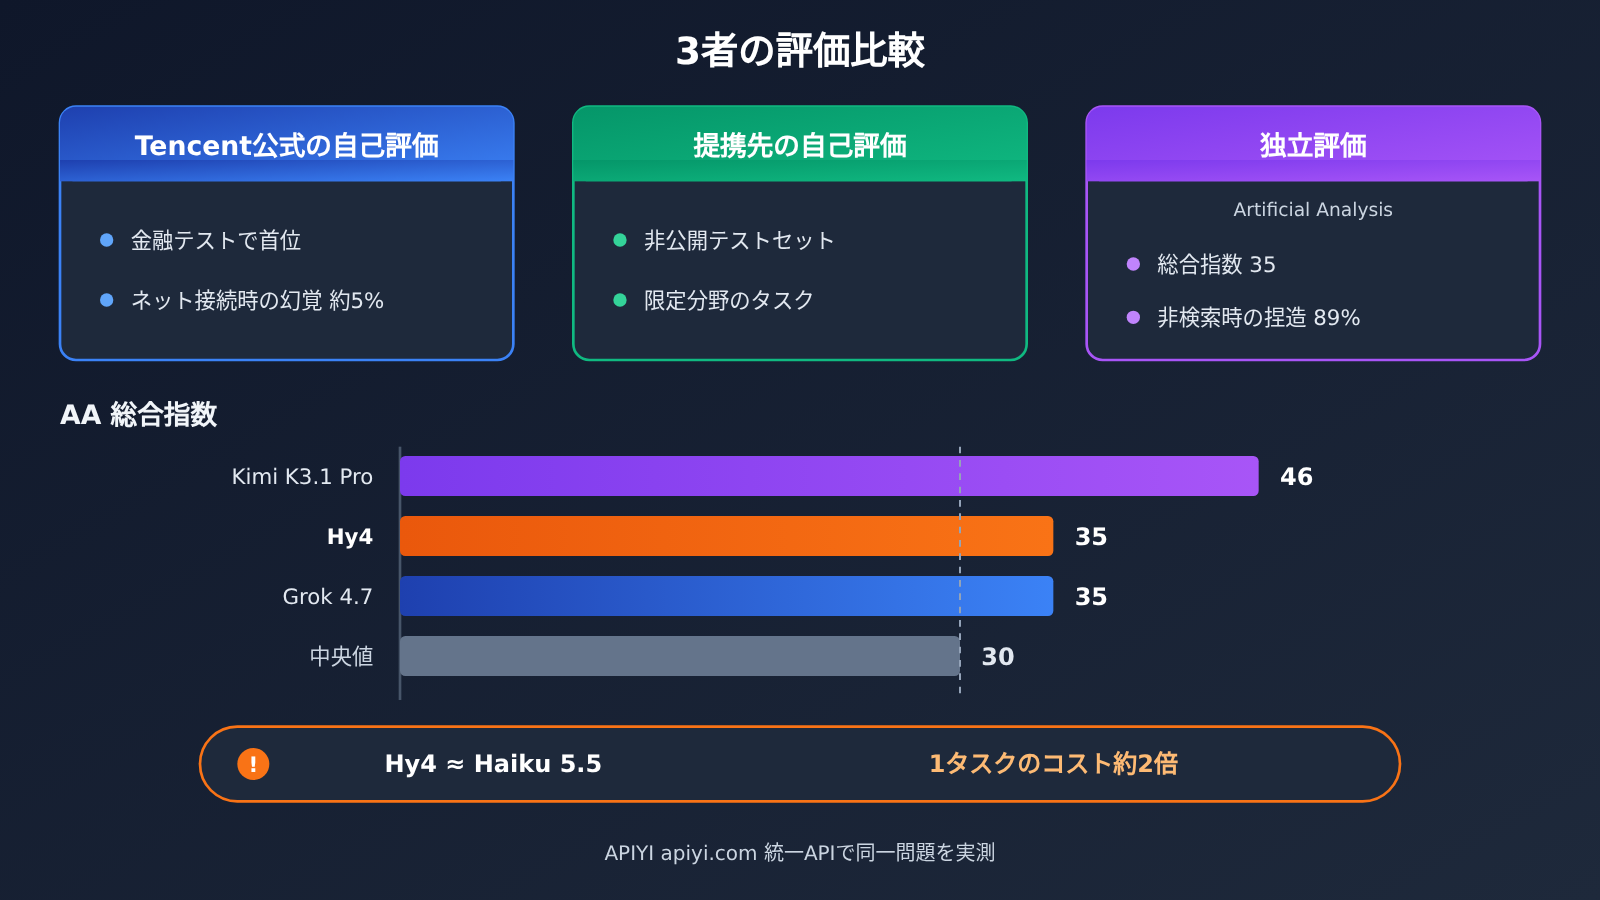
| Artificial Analysis | 総合指数は35点で、中央値の30点を上回り、Grok 4.7 と同点。中国製モデルでは2位で、46点の Kimi K3.1 Pro に次ぐ | 第三者による独立評価 | 60%が非公開のテストセットで、特定のテストに向けた最適化が難しい |
| Artificial Analysis | インターネットに接続しない場合、事実に関する質問の正答率は約半分で、答えを知らない場合は89%の確率で回答を捏造した | 第三者による独立評価 | 外部情報にアクセスしない状態での知識の正確性テスト |
Tencent Hy4の自社テストと独立評価における主な相違点
最も顕著な違いは、Hy4とKimi K3.1 Proの比較に見られます。Tencentの金融分野のテストではHy4がKimiを上回りましたが、Artificial Analysisの総合指数では、Hy4はKimiに11ポイント差をつけられています。ただし、両者は必ずしも矛盾しません。金融テストは限定された領域を対象としているのに対し、総合指数は知識業務、プログラミング、科学、常識など、幅広い分野を評価しているためです。Hy4はTencentが重点的に磨き上げた金融分野では強みがあるものの、全体的な能力ではトップではないと考えられます。
コストパフォーマンスにも注意が必要です。Artificial Analysisのデータによると、Hy4の総合スコアはAnthropicの最小モデルであるHaiku 5.5とほぼ同水準ですが、このベンチマークにおけるHaiku 5.5のタスクあたりのコストはHy4の約半分です。つまり、トークンの単価だけを見て「Hy4のほうが安い」とは言えません。タスクの完了に実際に消費するトークン量も考慮する必要があります。
Tencent Hy4 の高難度タスクにおける課題
Tencent 自身も、Hy4 は高度な数学、長期にわたるプログラミングプロジェクト、複雑な画像分析において、最高水準の商用モデルにまだ大きく遅れを取っていると認めています。最も差が大きいのは Hy-FrontierMath T5 で、結果は以下のとおりです。
| ベンチマーク / 指標 | Hy4 | GPT 6.1 Sol | Claude Opus 5.5 | 出典 |
|---|---|---|---|---|
| Hy-FrontierMath T5 | 13.0 | 97.5 | 91.3 | Tencent 公式 |
| Tencent 独自の 12 項目のベンチマーク | すべてで Opus 5.5 に劣る | 8 項目で Hy4 を上回る | 12 項目すべてで上回る | Tencent 公式 |
| AA 総合指数 | 35 | 資料に記載なし | 資料に記載なし | Artificial Analysis |
| インターネットに接続しない場合の事実の正確性 | 約半数に正答、答えが分からない場合は 89% で回答を捏造 | 資料に記載なし | 資料に記載なし | Artificial Analysis |
13.0 対 90 以上という結果は、もはや「やや劣る」という程度ではなく、まったく別の水準です。競技レベルの数学的推論、長期にわたる開発プロジェクト、または高精度な画像分析を必要とする業務では、現時点の Hy4 は主力モデルには適していません。
テンセント Hy4の影響分析:開発者とプロダクトチームにとって何を意味するのか
開発者への影響:オンラインとオフラインでは別のモデルと考える
「オンライン時のハルシネーション率は約5%」と「オフライン時は89%の割合で情報を捏造」という2つの数字をあわせて見ると、結論は明らかです。Hy4の事実に関する信頼性は、外部検索に大きく依存しています。Tencentの5%はオンライン検索を利用した条件での内部テスト結果であり、89%はArtificial Analysisが外部情報を参照できない条件で測定した捏造傾向です。製品にHy4を組み込む際は、基本的に「検索機能を必ず併用するモデル」として設計するとよいでしょう。
具体的な実装では、次のような方法が参考になります。
- 事実に関する質問は必ず検索を経由する:まず検索やRAGで資料を取得し、その資料に基づいて回答させます。モデルの記憶だけで答えさせないようにしましょう。
- プロンプトで「わからないと言ってよい」と明示する:資料にない内容については「資料に記載なし」と直接回答するよう指示し、情報を捏造する可能性を下げます。
- 出典の明記を求める:それぞれの結論が資料のどの段落に基づくかを示させることで、人による抜き取り確認がしやすくなります。
- 重要な数値は再検証する:金融やレポート関連の出力に含まれる数値は、プログラムやルールでもう一度確認します。GDPxの評価でも指摘されているように、表内の数値が1つ間違っているだけで、出力全体の価値が損なわれる可能性があります。
以下は「検索拡張+回答拒否を許可する」最小限の呼び出し例です。モデル名は実際に利用可能なものに置き換えてください。各プラットフォームにおけるHy4の具体的なモデルIDは、そのプラットフォームのコンソールで確認してください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "(这里放检索召回的资料片段)"
resp = client.chat.completions.create(
    model="your-model-name",
    messages=[
        {"role": "system", "content": "只依据给定资料回答;资料没有的内容回答“资料未提及”,并标注出处段落。"},
        {"role": "user", "content": f"资料:{context}\n\n问题:该公司三季度营收是多少?"}
    ],
    temperature=0
)
print(resp.choices[0].message.content)
完全な実装を見る:複数モデルによる同一質問の比較+回答拒否率の集計
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "只依据给定资料回答问题。"
    "如果资料中没有答案,必须只回答:资料未提及。"
    "回答时注明依据的资料段落编号。"
)

def ask(model: str, context: str, question: str) -> str:
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content": f"资料:\n{context}\n\n问题:{question}"}
            ],
            temperature=0,
            max_tokens=500
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

def evaluate(models: List[str], cases: List[Dict]) -> None:
    """cases 中の answerable=False の質問は、資料に意図的に答えを含めず、捏造傾向のテストに使用する"""
    for m in models:
        refused, fabricated = 0, 0
        for c in cases:
            out = ask(m, c["context"], c["question"])
            if not c["answerable"]:
                if "资料未提及" in out:
                    refused += 1
                else:
                    fabricated += 1
        print(f"{m}: 正确拒答 {refused},疑似编造 {fabricated}")

cases = [
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "三季度营收是多少?", "answerable": False},
    {"context": "[1] 公司二季度营收 12 亿元。", "question": "二季度营收是多少?", "answerable": True},
]

# リストを比較したいモデルの ID に置き換える
evaluate(["model-a", "model-b"], cases)
🎯 モデル選定のアドバイス:Hy4 のような新しいモデルを評価する際は、ランキングだけを見るのではなく、自社の業務サンプルを使って同じ課題で比較するのが最も確実です。APIYI apiyi.com は OpenAI 互換の統一インターフェースを提供しており、1つの APIキーで Claude、GPT、Gemini や中国国内の複数のモデルを呼び出せます。候補モデルを同じテストセットで比較するのに便利です。Hy4 がプラットフォームで提供されているかどうかは、コンソールのモデル一覧をご確認ください。
プロダクト責任者への影響:Hy4 に向いているタスクと向いていないタスク
3者からの情報を踏まえると、Hy4 のタスク適性はおおむね次のように整理できます。
| タスクの種類 | 適性 | 根拠 | 利用上のアドバイス |
|---|---|---|---|
| 金融データの照会、調査レポートの整理 | 比較的適している | Tencent の金融テストと Comein のフィードバック。いずれも自社テスト | 必ず検索機能を併用し、重要な数値はプログラムで検証する |
| Word、Excel、PPT の文書処理 | 比較的適している | Tencent のリアルタイム共同作業機能、文書タスクの完了率が高いという Manus のフィードバック | まずはリスクの低い文書タスクから試験導入する |
| ゲームエンジンの設定、バグの特定 | 試す価値あり | Tencent 内部のゲームチームからのフィードバック | 設定やトラブルシューティングには適するが、長期プロジェクトを任せるのは避ける |
| Webページ、ミニゲームのプロトタイプ作成 | 試す価値あり | 画像理解によるプログラミング支援 | プロトタイプ作成に利用し、本番コードは人間がレビューする |
| Web検索を使った質疑応答 | 試す価値あり | Web検索時のハルシネーション率は内部テストで約 5% | 検索を有効にし、出典の明記を求める |
| Web検索を使わない知識に関する質疑応答 | 非推奨 | 分からない場合の 89% で回答を捏造 | 事実に関する質問にモデルの記憶だけで回答させるのは避ける |
| 高等数学、競技レベルの推論 | 非推奨 | Hy-FrontierMath T5 でわずか 13.0 点 | トップクラスの商用モデルを選ぶ |
| 長期のプログラミングプロジェクト、複雑な画像分析 | 非推奨 | Tencent が公式に大きく遅れを取っていると認めている | より高性能なモデルを選ぶか、タスクを分割する |
業界への影響:重みの公開と規制強化が同時に進む
Hy4 は重みの公開を予定しており、将来的には企業が自社環境にデプロイできるようになる可能性があります。ただし、公開日やライセンスはまだ発表されていないため、納期の確定が必要な計画に組み込むのは時期尚早です。
政策面でも変化があります。中国の商務部と科学技術部は10月、世界トップ10に入るモデル、またはパラメータ数が2兆を超えるモデルの重みを対象とする輸出管理の枠組みの草案を発表しました。一方、オープンソースとしての公開には、自動承認される迅速な手続きが設けられています。安全面について、テンセントは学習時にハッキング関連の資料を意図的に除外したと説明しています。また、同社のセキュリティ研究所では悪用リスクの上昇は確認されず、バイオハザードのリスクも同社のリスク閾値を大きく下回ったとしています。詳細な安全性レポートは、重みと同時に公開される予定です。
テンセント Hy4 のよくある質問 FAQ
Q1:テンセント Hy4 とは何ですか?
Hy4 は、テンセントがプレビュー版に続いてリリースした正式版の大規模言語モデルです。初めて画像理解とコンピュータソフトウェアの自律操作に対応し、プログラミング、金融、オフィス業務向けに重点的に最適化されています。現在はテンセントクラウド、OpenRouter、元宝などのアプリから利用でき、重みは後日公開される予定です。
Q2:Hy4 は Kimi K3.1 Pro や Claude Opus 5.5 と比べてどうですか?
テンセントによる金融分野の自社テストでは、Hy4 は Kimi K3.1 Pro を上回りました。一方、Artificial Analysis の独立評価では Hy4 が35点で、Kimi の46点を下回っています。Claude Opus 5.5 との比較では、テンセント自社の12項目のベンチマークすべてで Hy4 が下回りました。自分の用途で直接比較したい場合は、APIYI apiyi.com の統一インターフェースから複数のモデルを呼び出し、同じ問題でテストできます。
Q3:Hy4 の重みと Hy4 flash はいつ公開されますか?
2026年11月6日時点で、テンセントは重みの公開日やライセンスを発表していません。安全性レポートを重みと同時に公開することだけが明らかになっています。より高速で低価格な Hy4 flash も計画中であることは確認されていますが、リリース時期と価格は未公開です。今後も公式情報を確認する必要があります。
Q4:Hy4 の価格は高いですか?
Hy4 の料金は、入力100万 Token あたり約0.83ドル、出力100万 Token あたり約2.50ドルで、プレビュー版と同じです。ただし、Artificial Analysis のデータによると、スコアが近い Haiku 5.5 のタスクあたりのコストは Hy4 のほぼ半分です。そのため、実際のタスクでの消費量を踏まえて総コストを計算する必要があります。
Q5:Hy4 が事実を作り出すリスクを減らすにはどうすればよいですか?
ポイントは、事実に関する質問に記憶だけで答えさせないことです。インターネット検索を有効にするか RAG を導入し、プロンプトで「資料に記載がない」と回答してもよいと伝え、出典の明記を求めましょう。上記の比較スクリプトを使えば、各モデルの回答拒否や事実の捏造を集計できます。APIYI apiyi.com の新規ユーザー向け無料テスト枠と組み合わせれば、低コストでまず一度検証できます。
Q6:Hy4 にはどのような既知の制限がありますか?
主に3点あります。1つ目は、高難度タスクでの差が大きく、Hy-FrontierMath T5 では13.0点にとどまっていることです。2つ目は、インターネットに接続していない場合の知識の信頼性が低く、答えが分からないときに89%の割合で事実を作り出すことです。3つ目は、肯定的な評価の多くがテンセントや協力企業による自社テストに基づいており、手法の詳細も公開されていないため、自分のデータで再検証する必要があることです。
Tencent Hy4 の重要ポイント
- 2つの初対応:Hy4 は画像理解と自律的なコンピューター操作に初めて対応。Blender、CAD、Office 文書を扱えます。
- 価格は据え置き:100万トークンあたり入力約0.83ドル、出力約2.50ドルで、プレビュー版と同じです。
- 独立評価では中上位:AA 総合指数は35点で、中国製モデルでは2位。Kimi K3.1 Pro には大きく及びません。
- 検索との併用が必須:ネット接続時のハルシネーション率は約5%。接続なしでは、答えを知らない場合の89%で回答を作り出します。
- 高難度タスクは苦手:高度な数学、長期的なプログラミングプロジェクト、複雑な画像分析では、最上位の商用モデルとの差が顕著です。
- 自己評価は要検証:金融分野のランキングやパートナーによる評価は多くが自己評価です。本番導入前に自社のサンプルで検証しましょう。
- 比較して判断を:APIYI apiyi.com の統一インターフェースを使えば、Hy4 の代替モデルや比較対象モデルを同じテストセットで比較できます。
まとめ
Tencent Hy4 の重要ポイントは次のとおりです。
- 能力は大きく進歩:画像理解とコンピューター操作が今回の主な新機能です。金融とオフィス業務の用途に重点を置いて改良されています。
- 各評価は分けて見る必要あり:メーカーやパートナーの自己評価は楽観的な傾向があります。一方、Artificial Analysis の独立評価では、中国製モデルで2位、Haiku 5.5 に近い位置づけです。
- 弱点は明確:ネットに接続しないと回答を作り出しやすく、高難度の数学や長期的なプログラミングプロジェクトでは大きく劣ります。いずれもモデル選定に直接影響するポイントです。
金融データの検索、文書処理、ゲームの設定といった用途なら、Hy4 を検索と組み合わせて試験導入する価値があります。一方、外部情報を参照しない知識や高度な推論に依存する用途では、現時点ではより強力なモデルが適しています。まずは APIYI apiyi.com の統一インターフェースを使い、候補モデルに同じ問題を解かせて実測したうえで、コストと正確性を合わせて判断することをおすすめします。
📚 参考資料
- THE DECODER – Tencent releases Hy4 with vision and computer use:Hy4 のリリース報道
- リンク:
the-decoder.com/tencent-releases-hy4-with-vision-and-computer-use-claims-second-place-among-chinese-ai-models -
説明:Tencent の公式データ、パートナーからのフィードバック、Artificial Analysis による独立評価の結果を掲載
-
THE DECODER – SemiAnalysis GDPx ベンチマーク報道:AI エージェントの実際の業務における評価
- リンク:
the-decoder.com/no-ai-agent-scores-above-12-percent-on-semianalysis-new-real-world-work-benchmark -
説明:コンピューター操作型エージェントの専門ソフトウェアにおける全体的な実力を把握できます
-
Artificial Analysis:独立したモデル評価機関
- リンク:
artificialanalysis.ai - 説明:Intelligence Index や AA-Omniscience などの評価の最新データを確認できます
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI apiyi.com のトップページからお気軽にお問い合わせください。接続方法などの詳細は docs.apiyi.com のドキュメントをご覧ください。


