
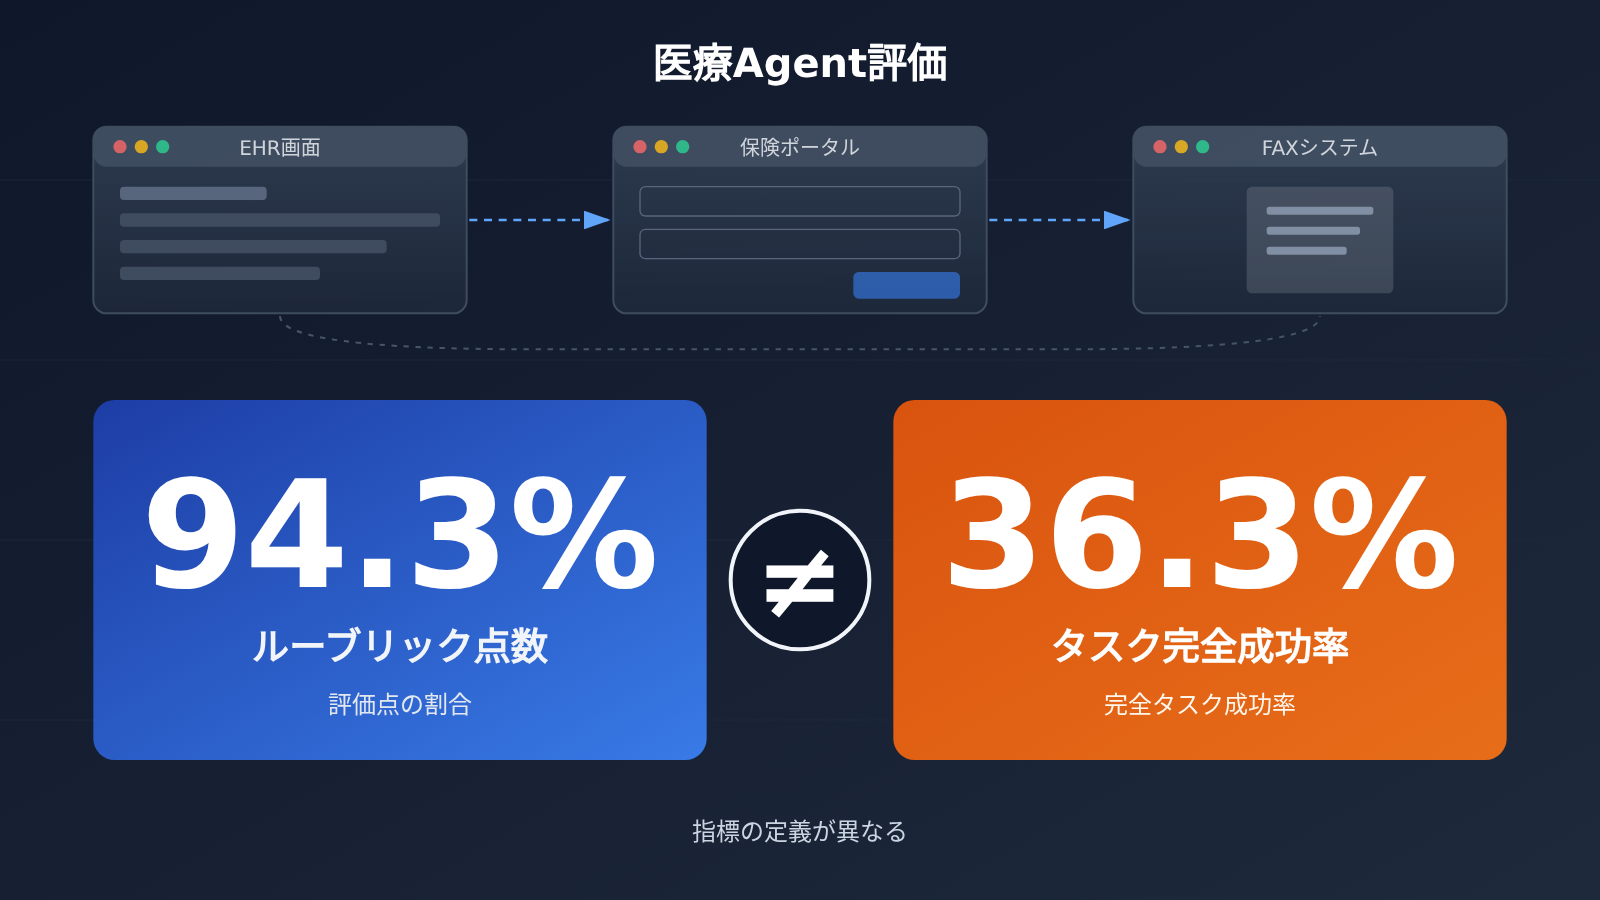
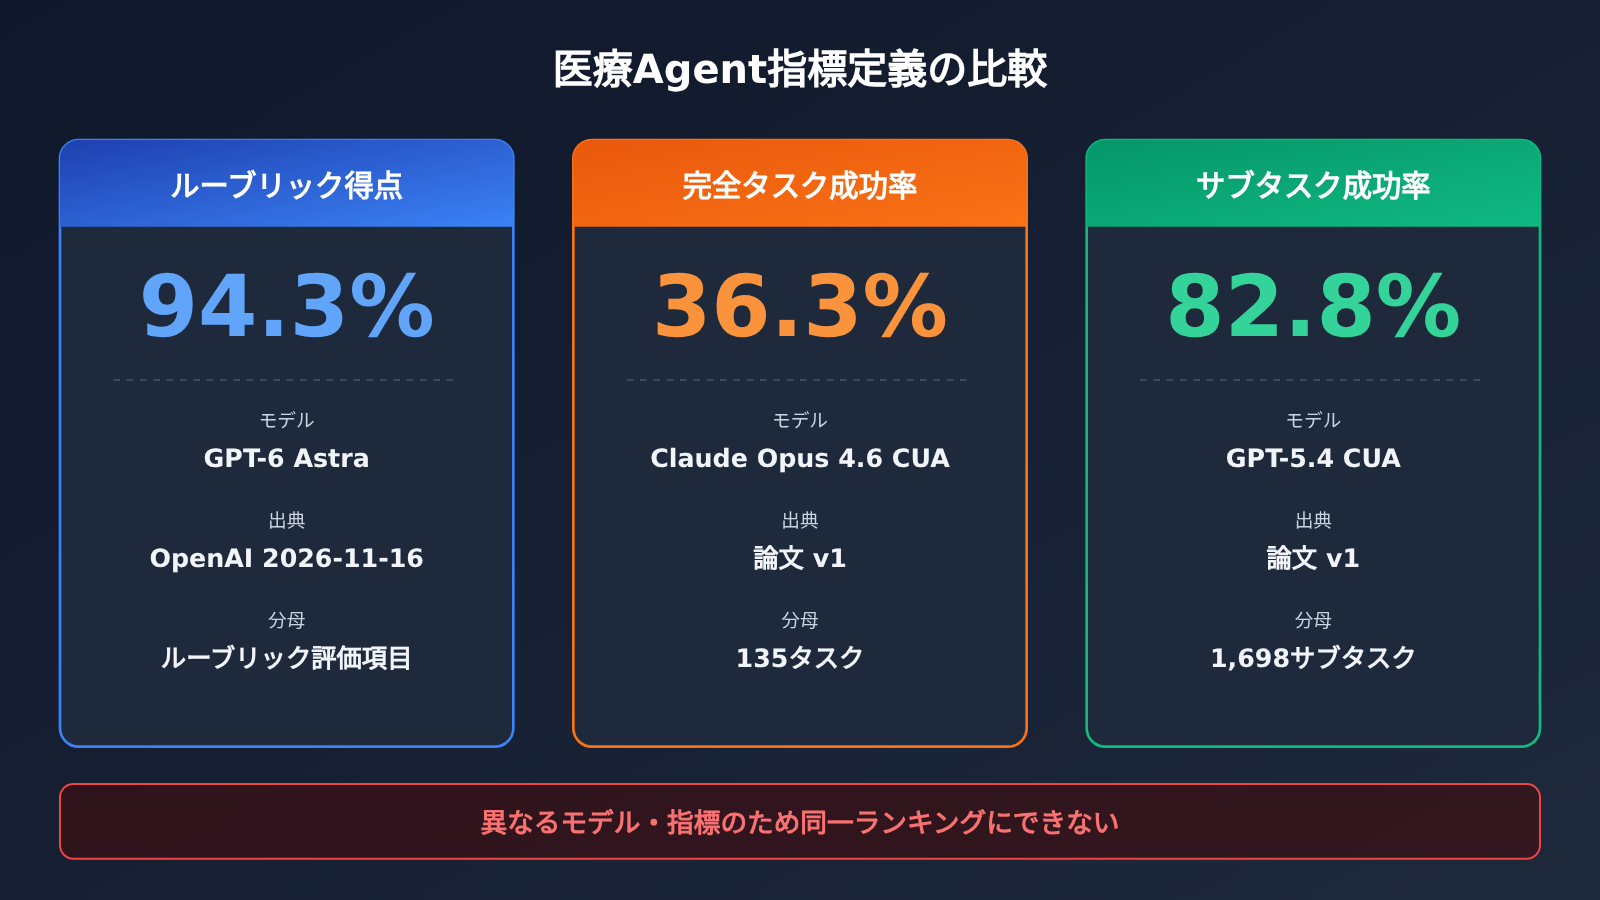
94.3% は、医療事務タスクの94.3%が完全に遂行されたことを意味しません。OpenAIが2026年11月16日に発表したGPT-6 Astraの94.3%は、HealthAdminBenchのrubric points(ルーブリック評価点)の得点率です。一方、スタンフォード大学Shah Labの論文におけるClaude Opus 4.6 CUAの36.3%は、完全タスク成功率(full-task success)です。前者は「評価点をどれだけ満たしたか」を測り、後者は「成功条件をすべて満たしたタスクがどれだけあるか」を測ります。両者は同じ指標ではなく、同じランキングに並べることもできません。
医療エージェントは、情報検索、文書処理、フォーム入力などの個別操作では優れた性能を発揮できても、システムをまたぐ業務プロセスを安定して最後まで通せるとは限りません。あるエージェントに本番導入価値があるかを判断するには、サブタスクの性能、エンドツーエンド成功率、エラー種別、実行コスト、人手介入の状況を同時に見る必要があり、単一のスコアだけでは足りません。
この記事を読むと、次のことがわかります
- 94.3%と36.3%がそれぞれ何を集計しているのか、なぜ直接比較できないのか
- HealthAdminBenchのタスク構成、評価点の由来、2種類の検証メカニズム
- 本番環境を想定し、他の企業向けエージェントにも適用できる評価軸のセット
目次:客観的事実のパートでは、94.3%という成績がなぜ注目を集めたのか、HealthAdminBenchが実際に何を測定しているのか、サブタスク成功と完全タスク成功の違い、医療エージェントが最も失敗しやすい工程、そして同じモデルでも実行フレームワークによって性能が変わる理由を順に説明します。分析・判断のパートでは、総合評価フレームワークの作り方、コストの算定方法、企業が導入時にどう取捨選択すべきかを論じます。
To Know:医療エージェント評価を理解するための7つの概念
| 概念 | 簡単な説明 |
|---|---|
| Computer Use | ソフトウェアの画面を観察し、クリック・入力・スクロールなどの操作をシミュレートしてタスクを完了させる能力 |
| EHR | 電子健康記録システム。病院が患者の診療情報を保存する中核ソフトウェア |
| MCP | 外部ツールを検出・呼び出すための標準プロトコル |
| RPA | あらかじめ設定したルールやスクリプトで反復的なプロセスを実行する自動化手法 |
| Rubric points | 評価ルールに基づいて得られる採点ポイント。部分的な要件の達成状況を測るために用います |
| エンドツーエンド成功率 | タスク全体がすべての成功条件を満たす割合。いずれか1つの重要条件が失敗すれば失敗と判定されます |
| Trace | 実行プロセス、操作アクション、画面上の状態を記録した軌跡の証拠 |
医療エージェント評価の影響をひと目で
- 開発者・技術責任者:ベンダーが公表した単一のスコアだけを引用して選定するのではなく、自社のタスクに照らして実行メカニズム、エンドツーエンドの完了率、そしてスクリーンショット・リトライ・実行環境を含むトータルコストを検証する必要があります。
- 医療機関・ワークフロー責任者:合成環境でのデモ、ベンチマーク評価、機関でのパイロット、本番事例という4種類の証拠を区別する必要があります。また、導入時には人による承認、最小権限、操作監査を確実に実施してください。
客観的事実:94.3% と 36.3% の背景にある医療エージェント評価
94.3% という成績がなぜ注目されたのか?
2026年11月16日、OpenAIは医療チーム向けのコンピュータ操作エージェントに関する進展を発表し、複数組の評価データを公表しました。そのうちGPT-6 AstraはHealthAdminBenchで94.3%、GPT-6 Lunaは91.8%を記録し、いずれも最高推論強度(maximum reasoning effort)で評価されました。OpenAIは同時に、Lunaの1タスクあたりのコストが0.085ドルで、Astraより98%低いと公表しています。
これらの数字が注目を集めたのは、スタンフォード大学が以前に公開したHealthAdminBenchの結果が明らかに低かったからです。ここで強調しておきたいのは、OpenAIが公表した94.3%と91.8%がrubric pointsの得点比率であり、独立した完全タスクの成功率ではないという点です。同じ発表に含まれる別の2組のデータも、それぞれ異なる評価段階に由来し、分母も異なります:
| 指標 | 数値 | 分母/基準 | 何を意味しないか |
|---|---|---|---|
| HealthAdminBench スコア(Astra) | 94.3% | rubric points の割合 | 完全タスク成功率 |
| HealthAdminBench スコア(Luna) | 91.8% | rubric points の割合 | 完全タスク成功率 |
| 臨床タスクの安全性(Astra) | 99% | 325件の審査済みタスク | 医学診断の正確率 |
| 医師による高評価の割合(Astra) | 93% | 646件の医師評価 | タスク成功率でも、646名の医師でもない |
| Lunaの1タスクあたりコスト | $0.085 | 特定の評価条件下での1タスクあたりコスト | 本番環境への展開価格 |
これら3組のデータは分母が異なり、1つの「総合的な正確率」にまとめることはできません。さらに、OpenAIの発表本文はタスクごとの結果、完全な実験設定、信頼区間、すべての失敗事例を公開しておらず、現時点では外部による94.3%の得点構成の独立検証はできません。Astraの1タスクあたりコストは約4.25ドルですが、これは98%の低下幅から逆算した推定値であり、公式に直接公表された価格ではありません。
HealthAdminBench は何を測定するのか?
HealthAdminBench はスタンフォード大学の Shah Lab によって提案され、コンピュータ操作 Agent の医療行政タスクにおけるパフォーマンスを専門的に評価するものです。その公開バージョンには前後に差異があります。早期の研究ウェブページでは 70 項目のタスク、947 個の採点点、6 つの Agent が説明されていましたが、論文 2604.09937v1 のバージョンでは 135 項目のタスク、1,698 個の検証可能なサブタスク、7 組のモデル設定に拡張されています。本記事では論文バージョンを基準とし、早期ウェブページのデータは歴史的な対照としてのみ扱います。
論文バージョンの 4 つのシミュレーション GUI 環境は、それぞれ EHR、保険支払ポータル A、保険支払ポータル B、FAX ポータルです。135 項目のタスクは 3 種類の行政ワークフローに分類されます:
| タスク種別 | 数量 | 主な内容 |
|---|---|---|
| Prior Authorization(事前承認) | 60 | 保険資格の検証、医療記録の収集、事前承認申請の提出 |
| Appeals and Denials Management(異議申立てと拒否対応) | 60 | 拒否の審査、証拠の収集、異議申立ての準備と提出 |
| DME Order Processing(医療機器の注文) | 15 | 医療機器資料の収集、注文の提出、結果の記録 |
1,698 個の採点点は 2 つのメカニズムによって生成されます。1,177 項目は決定論的なチェックを採用し、JMESPath などの構造化手段を用いてシステム状態を照合します。たとえば、正しい患者が見つかったか、指定されたフィールドが入力されたか、正しい注文が生成されたかといった点を確認するもので、その発想は従来のソフトウェアテストに近いものです。残りの 521 項目は LLM Judge に委ねられ、主にドキュメントの内容が十分か、提出資料が要件を満たしているかなど、ルールでは直接検証しにくい部分を評価します。
すべてのタスクは実際の患者記録ではなく、合成患者データを使用しています。これは、このベンチマークが再現可能なテスト環境を提供するものであって、実際の病院の本番システムでテストを行うものではなく、患者ケアの結果を直接測定するものでもないことを意味します。
サブタスク成功とタスク全体の成功の違いは何ですか?
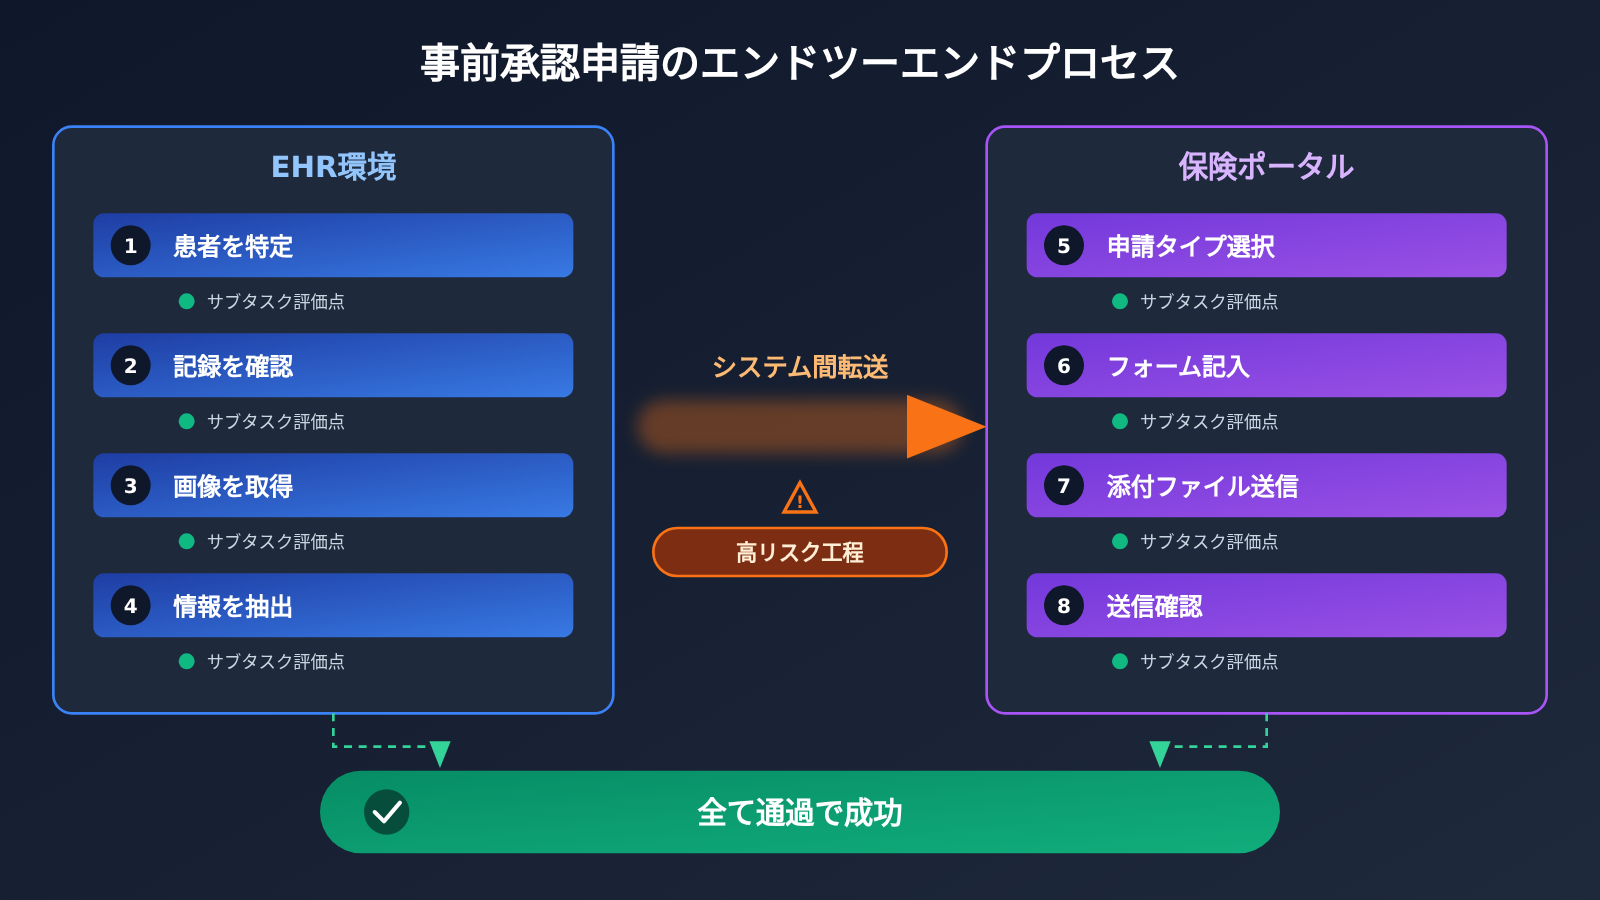
事前承認申請の流れを見ると、両者の違いが最も分かりやすくなります。研究資料の記述によると、事前承認タスクでは、エージェントが次の10ステップを順番に実行するよう求められる場合があります:
- EHR内で正しい患者を見つける
- 患者の診療記録を確認する
- 画像検査と過去の治療資料を見つける
- 保険申請に必要な証明書類を判断する
- 診療記録から必要な情報を抽出する
- 保険支払いポータルにアクセスする
- 正しい申請タイプを選択する
- 申請フォームに入力する
- 必要な書類を添付する
- 申請を送信し、ステータスを確認する
これら10ステップの間には強い依存関係があります。第1ステップで患者を間違えると、その後のステップをどれだけ正確にこなしても誤りになります。たとえ前のステップをすべて正しくこなしても、第9ステップで添付を漏らす、あるいは第10ステップで実際に送信しないといった問題があれば、タスク全体は失敗と判定されます。サブタスク成功率は「10ステップのうち何ステップ正しくできたか」を数え、タスク全体の成功率は「10ステップすべてを正しくできたか」を数えます。
論文が示すデータは、この落差を明確に表しています。GPT-5.4 CUAのサブタスク成功率は82.8%、Claude Opus 4.6 CUAのタスク全体の成功率は36.3%です。これらの数値は異なるモデルに属するため、直接比較することはできませんが、両者はある事実を共通して示しています。局所的な動作の完了と、業務プロセス全体の完了は、異なる能力であるということです。
初期の研究ページでも同様の落差が報告されています:Claude Opus 4.5の最高タスク全体成功率は22.9%、Gemini 3のサブタスク成功率は76.4%です。タスク規模とバージョンが異なるため、これらの数値は傾向を観察するためだけに使え、論文のバージョンやOpenAIの結果と同じランキングに入れることはできません。
医療Agentが最も失敗しやすいのはどの工程か?
論文はサブタスクカテゴリーごとに、2つのCUA構成のスコアを公開しています:
| サブタスクカテゴリー | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| 情報検索 | 96.5% | 96.1% |
| 文書作成 | 74.3% | 84.4% |
| フォーム入力 | 88.9% | 84.9% |
| タスク解決 | 70.7% | 66.2% |
| 文書処理 | 92.3% | 94.3% |
| 臨床推論 | 61.3% | 77.0% |
特にご注意いただきたいのは、表の中でGPT-5.4 CUAの文書処理における94.3%という数値が、OpenAIが公表したGPT-6 Astraの総合rubric points 94.3%と一致しているのは単なる数字の偶然であり、両者はモデルも指標も情報源もまったく異なるという点です。
項目別に見ると、情報検索はすでにほぼ飽和状態に達している一方、臨床推論、タスク解決、文書作成は相対的に弱い結果となっています。論文は同時に、文書処理(Document Handling)とシステム間データ転送(Cross-system Data Transfer)がエンドツーエンドの失敗を引き起こす主な問題であると指摘しています。初期のWeb版では、6つのモデルのうち5つが文書処理サブタスクで精度20%未満だったと報告されていましたが、それは異なるバージョンのタスク設定によるものであり、上表と直接比較することはできません。
システム間転送が特にエラーを起こしやすいのはなぜでしょうか。事前承認のプロセスでは、同じ情報をEHRから読み出し、Agentのコンテキスト内に保存し、さらに保険ポータルの別のフォーム構造へ書き込む必要があり、添付ファイルがファックスポータルを経由して流れることもあります。転送のたびにエラーが発生する可能性があり、上流での1つの誤りはそのまま下流のシステムに複製されてしまいます。OpenAIの資料に列挙されたリスクには、「誤った情報をあるシステムから別のシステムへ伝播させること」や「システムの状態が不明確なときにタスク完了を誤って報告すること」も含まれています。
なぜ同じモデルでも実行フレームワークによってパフォーマンスが変わるのか?
論文ではプロンプト方式と観察モードに関するアブレーション実験を行い、主に3つの知見が得られました。
- Portal Guidance(ポータル操作ガイダンス)を提供する方が、タスク説明だけを与えるよりも一般的にパフォーマンスが向上する
- Accessibility Tree(アクセシビリティツリー)による観察は、スクリーンショットのみによる観察よりも一般的に優れている
- ポータル操作ガイダンスと構造化されたページ情報を組み合わせると、エンドツーエンドのパフォーマンスが一般的に向上する
論文はまた、実際の本番環境では完全な Accessibility Tree を提供できるとは限らないと指摘しています。つまり、Agent の成績は基盤モデルだけでなく、実行フレームワーク(Harness)、ページの観察方法、プロンプト、タスク説明にも左右されるということです。
OpenAI の開発者向けドキュメントも、実行経路の違いを反映しています。公式ガイドでは ComputerToolset、BrowserToolset、ホスト型ブラウザのエントリポイントをそれぞれ説明しており、GPT-6 Astra については現在のドキュメントで Code Execution 方式を推奨しています。これはモデルが Playwright などのコードを生成して UI を操作する方式で、Computer Tool は引き続き選択肢の一つとして位置づけられています。ドキュメントはさらに、モデルが操作指示を生成することは操作が成功したことを意味せず、アプリケーションは実行後に新しいスクリーンショットなどで結果を検証しなければならないと強調しています。
CVS Health がオープンソース化した CUA Agent Kit(Apache-2.0)は、別のエンジニアリングアプローチを提示しています。README で公開されている仕組みは次のとおりです。まず Computer-use Agent がワークフローを探索し、スクリーンショット、アクション、Trace をエビデンスとして保存します。次に Codex Skill が成功した軌跡を決定論的なコードとして固定化し、エンジニアのレビューを経ます。その後の決定論的な実行ではモデルキーは不要です。これにより「どうやるかを発見する」ことと「安定して繰り返し実行する」ことが、2つの問題として切り分けられています。
分析と判断:本当に使える医療 Agent をどう評価するか
本当に使える Agent をどう評価するか?
以下は本稿の判断であり、特定機関の公式基準ではありません。94.3% のような rubric points のスコアは「モデルの部分的な能力がどれだけ進歩したか」に答えるには適していますが、「生産プロセスに組み込めるか」に答えるには不十分です。後者の問いには、互いに制約し合う指標のセットが必要です:
| 評価軸 | 何を測るか | なぜ必要か | データソース |
|---|---|---|---|
| エンドツーエンド成功率 | タスク全体の成功条件をすべて満たした割合 | ビジネスは最終結果しか見ない | システムの最終状態検証 |
| 重要ステップの正確性 | 患者選択、送信、添付ファイルのアップロードなど重要ノードの正答率 | 重要ステップが1つでも誤れば全体が誤る | 決定論的チェック |
| エラーの深刻度 | 失敗が回復可能な漏れなのか、データの書き間違いや誤送信なのか | 同じ失敗率でもリスクの差は大きい | 人手によるレビュー + 深刻度ラベル |
| 人手介入率 | 人手による引き継ぎや承認・修正が必要な割合 | 実際に削減できる工数を左右する | 承認ログ |
| 実行時間 | 単一タスクの所要時間とロングテールの所要時間 | スループットと待ち行列に影響する | Trace タイムスタンプ |
| タスクあたりの総コスト | モデル、スクリーンショット、リトライ、実行環境、保守の合計 | Token 単価だけでは実コストを表せない | 請求書 + 実行記録 |
| 異常回復能力 | 曖昧さ、タイムアウト、画面変化に直面したとき停止またはロールバックできるか | 医療の現場では「止まれること」が必須 | 故障注入テスト |
この枠組みの核心は、「何ステップ正しくこなしたか」と「何件を成し遂げたか」を分けて報告し、さらにエラーの深刻度と人手介入率で両者を補正することにあります。Ambience が示した設計は、まさに「異常回復」という軸を体現しています。病历に曖昧さがあると、Agent は止まって医師に確認し、医師の承認を得てから事前承認申請を送信します。ただしこれは同社が示したガバナンス設計の一例であり、すべての医療 Agent がデフォルトで同じ構成を備えているという意味ではありません。
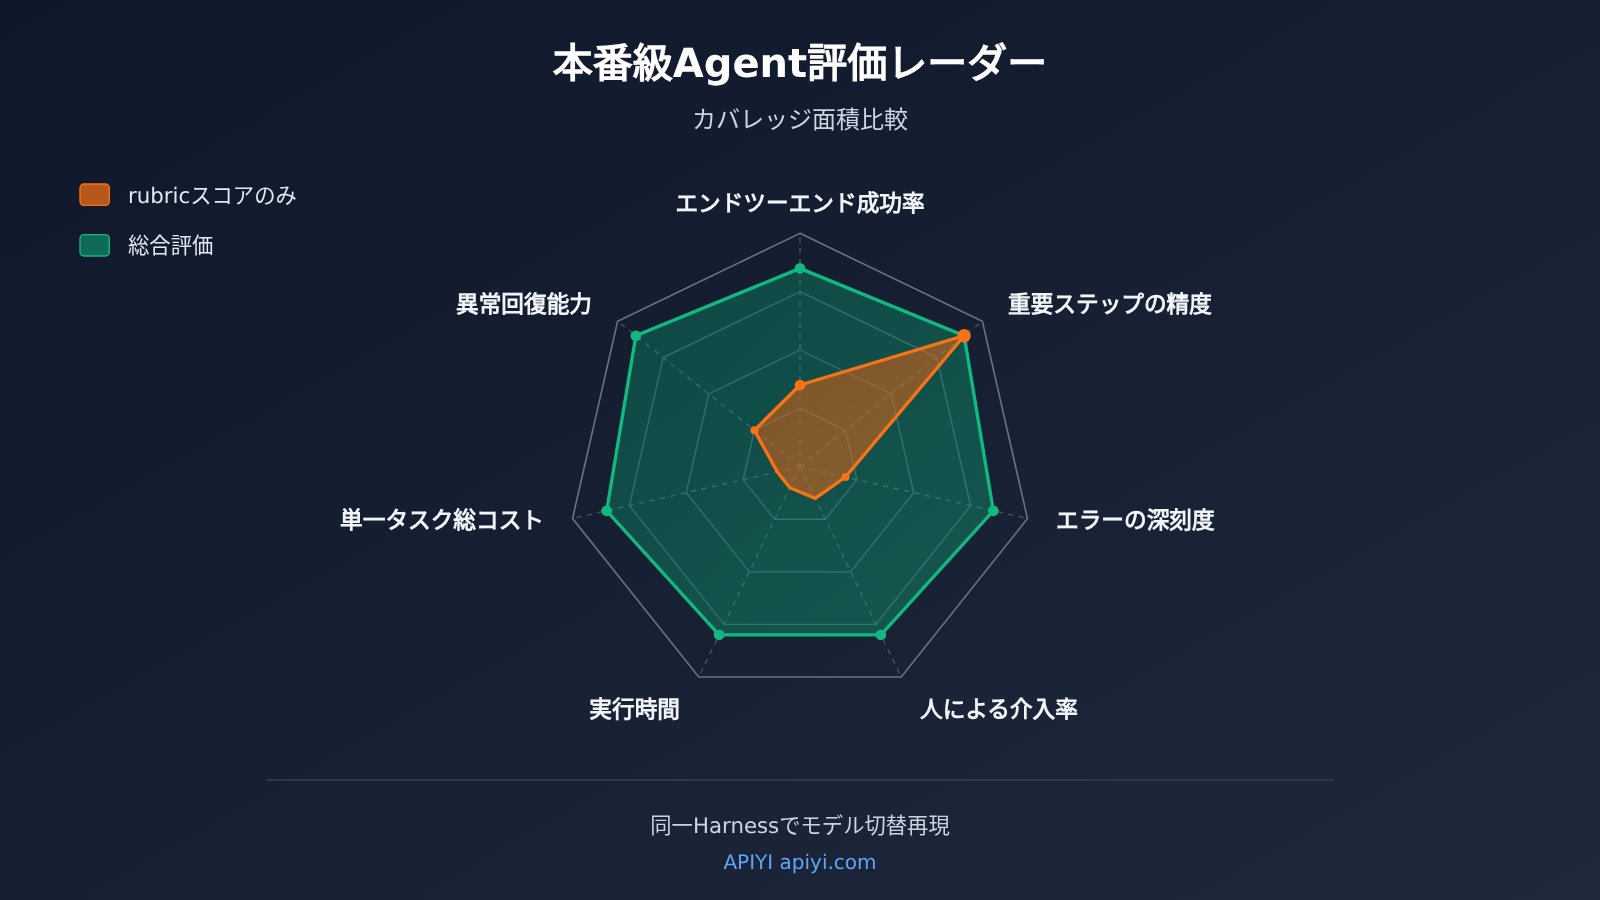
サンプル数と繰り返し回数も同様に公開すべきです。RPA と Agent を比較したある研究(DOI: 10.1080/23311975.2026.2724760)では、P2 と P3 の2つのフローで各技術を10回ずつ実行しましたが、P1 では Agent を1回だけ実行して失敗し、以降の統計には含めていません。この研究は2025年のツール構成を用いたものであり、2026年のモデルの直接的な成績として扱うことはできません。この例が示すのは、評価の結論を読むときには、まず各数値の背後で何回実行したのか、どの結果が除外されたのかを確認すべきだということです。
医療 Agent 評価の実践的な進め方:同一 Harness 上で自ら実行する
開発チームにとって最も現実的なのは、実行フレームワークを固定し、自社のタスクセット上でサブタスクとエンドツーエンドの2種類の指標を同時に集計することです。以下の例では、LLM Judge を使って Agent の提出物を採点します。インターフェースは OpenAI SDK と互換性があります:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース、異なる裁判モデルを切り替え可能
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
完全な実装を見る:サブタスク成功率とエンドツーエンド成功率を同時に計算する
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # 重要ステップかどうか(失敗するとタスク全体が失敗)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # リトライのトークンを含む、重複して加算しないこと

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """ルール化が困難なサブタスクには LLM Judge を使用する"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 技術的なアドバイス:サブタスクのスコアとエンドツーエンドの成功率は、同じ Harness・同じタスクセット上で並べて報告するのが望ましいです。APIYI apiyi.com の OpenAI 互換インターフェースを使えば、1つの APIキーで OpenAI、Claude、Gemini などのモデル間で実行モデルや裁判モデルを切り替えられ、接続方式の違いによる変数を減らせます。
医療エージェントのコスト計算とモデル階層化
Token 単価はあくまで出発点にすぎません。2026年11月17日に OpenAI が公開した Standard 短コンテキスト価格では、GPT-6 Astra の入力・出力・キャッシュ入力はそれぞれ 100万 Token あたり 10 ドル、50 ドル、1 ドル、GPT-6 Luna は 0.10 ドル、0.50 ドル、0.01 ドルです。処理速度、コンテキスト長、地域によって実際の課金は変わります。Computer Use はマルチターン呼び出しで、各ターンのスクリーンショットが視覚入力としてカウントされるため、コスト計算では各ターンの視覚入力/テキスト入力と課金対象の出力を個別に集計し、さらにツール、実行環境、エンジニアリング保守を加える必要があります。リトライで消費した Token がすでに総量に含まれている場合は、重複して再加算しないでください。
0.085 ドルと約 4.25 ドルの差から見ると、モデルの階層化は今後常態化する可能性が高いでしょう。複雑で高度な推論が必要なタスクは高性能モデルに任せ、構造化の度合いが高く頻度の多いタスクは低コストモデルに任せ、すでに安定稼働している固定フローは CVS の発想と同じように決定論的なコードとして固定化します。なお、これらの単一タスクのコストは特定のベンチマーク条件に基づくものであり、本番環境の見積もりとして使用することはできません。
💰 コスト最適化:階層化に基づくモデル選定を行う前に、まず小規模な実タスクで各モデルのエンドツーエンド成功率と単一タスクのトータルコストを測定することをおすすめします。APIYI apiyi.com は従量課金制を採用しており、新規ユーザーには無料のテスト枠があります。プロジェクト立ち上げ段階で、この種の比較実験を低コストで行うのに適しています。
医療エージェントから企業エージェントへ:移植可能な評価の考え方
医療行政の特殊性は、高リスクと強い規制にあります。しかし、そこで露呈する問題は保険請求、財務照合、サプライチェーン書類などの企業プロセスにも同様に存在します。複数システム、強い依存関係、システム間のデータ移行です。私たちの判断では、次の4つの原則はそのまま移植できます。
- レポートを分ける:サブタスクのスコアとエンドツーエンドの成功率を別々に記載し、前者で後者を代替しない
- 証拠レベルを明記する:合成環境デモ、ベンダー自己評価、第三者ベンチマーク、企業パイロット、本番事例をそれぞれ分類し、混同しない
- Harness を固定してから比較する:観察方法、プロンプト、ポータルガイダンスが一度でも変われば、スコアは比較不能になる
- ガバナンスをスコアより優先する:最小権限、重要操作の人手承認、操作後の状態検証、全体の Trace 記録、異常停止メカニズムを、リリース前の受け入れ項目とする
社内で PoC を行う場合は、タスクセットに「重要ステップ」のタグを付け、まずエンドツーエンドのベースラインを測定します。その後、ポータルガイダンス、構造化観察、コード固定化を段階的に導入し、各変更が完全な成功率に与える実際の貢献を観察できます。複数モデル間で同じタスク群を素早く再現する必要がある場合は、APIYI apiyi.com から統合接続でき、横断比較のエンジニアリングコストを下げられます。
継続して注目すべき今後の展開には、OpenAI が 94.3% の背後にあるタスク別結果と実験設定を公開するかどうか、HealthAdminBench の後続バージョンが同じ基準で新モデルの完全なタスク成功率を公表するかどうか、さらに多くの機関が実運用環境における人手介入率とエラー分類データを開示できるかどうかが含まれます。これらの情報が出るまで、「医療行政はすでに完全自動化可能」という主張は推測にすぎません。
94.3% はモデルが採点項目で大きく進歩したことを示し、36.3% は、ある業務プロセスを確実に完了できるかどうかは、最終的に完全なタスク、実際のシステム、人手による監督の下で検証しなければならないことを思い出させます。英語のことわざにある通り、「The proof of the pudding is in the eating.」(プディングの味は食べてみて分かる、つまり実際の効果は実践で検証する必要がある)。
参考文献
- OpenAI:Advancing computer-use agents for healthcare teams:94.3%、91.8%、99%、93% などの評価データと協業事例
- リンク:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- リンク:
- HealthAdminBench 論文 2604.09937v1:135 タスク、1,698 サブタスク、項目別の結果とアブレーション実験
- リンク:
arxiv.org/html/2604.09937v1
- リンク:
- HealthAdminBench プロジェクトページとコードリポジトリ:ベンチマーク環境と評価実装
- リンク:
som-shahlab.github.io/health-admin-bench-website/ - リンク:
github.com/som-shahlab/health-admin-bench
- リンク:
- Stanford Shah Lab の初期研究ページ:70 タスク、947 の採点ポイントを持つ過去バージョン
- リンク:
shahlab.stanford.edu/doku.php?id=healthadminbench
- リンク:
- OpenAI Computer Use の開発者ドキュメントと API 料金:実行パスと Standard 価格
- リンク:
developers.openai.com/api/docs/guides/tools-computer-use - リンク:
developers.openai.com/api/docs/pricing
- リンク:
- CVS Health CUA Agent Kit:探索、エビデンス、コードの固定化とエンジニアレビューの仕組み
- リンク:
github.com/cvs-health/cua-agent-kit
- リンク:
- RPA と Agent の比較研究:繰り返し実行回数と P1 例外の説明
- リンク:
doi.org/10.1080/23311975.2026.2724760
- リンク:
- Cambridge Dictionary:ことわざ “proof of the pudding is in the eating” の定義
- リンク:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- リンク:
著者:APIYI 技術チーム
技術交流:APIYI(apiyi.com)にアクセスして、Agent 評価の実践についてぜひ意見交換しましょう。接続方法の詳細は docs.apiyi.com のドキュメントセンターをご覧ください


