
筆者注:GPT-6.2 Sol の公式自己申告スコアと第三者による総合スコアを切り分けて読み解き、日常タスクでの進歩、コーディングエージェントと事実正確性での後退、さらに定価・課金ルール・モデル選定のアドバイスまで分かりやすく解説します。
OpenAI は 2026-11-17 に GPT-6.2 Astra と GPT-6.2 Sol を同時リリースしました。このうち GPT-6.2 Sol は GPT-6.1 Sol と同じ API 定価を踏襲しながら、日常タスクのスコアは明らかに上積みされています。ついデフォルトモデルに設定したくなる人も多いはずです。公式発表文、システムカード、モデルページはすでに公開されており、Artificial Analysis も当日中に第三者総合スコアを公表しています。うわさ話ではありません。
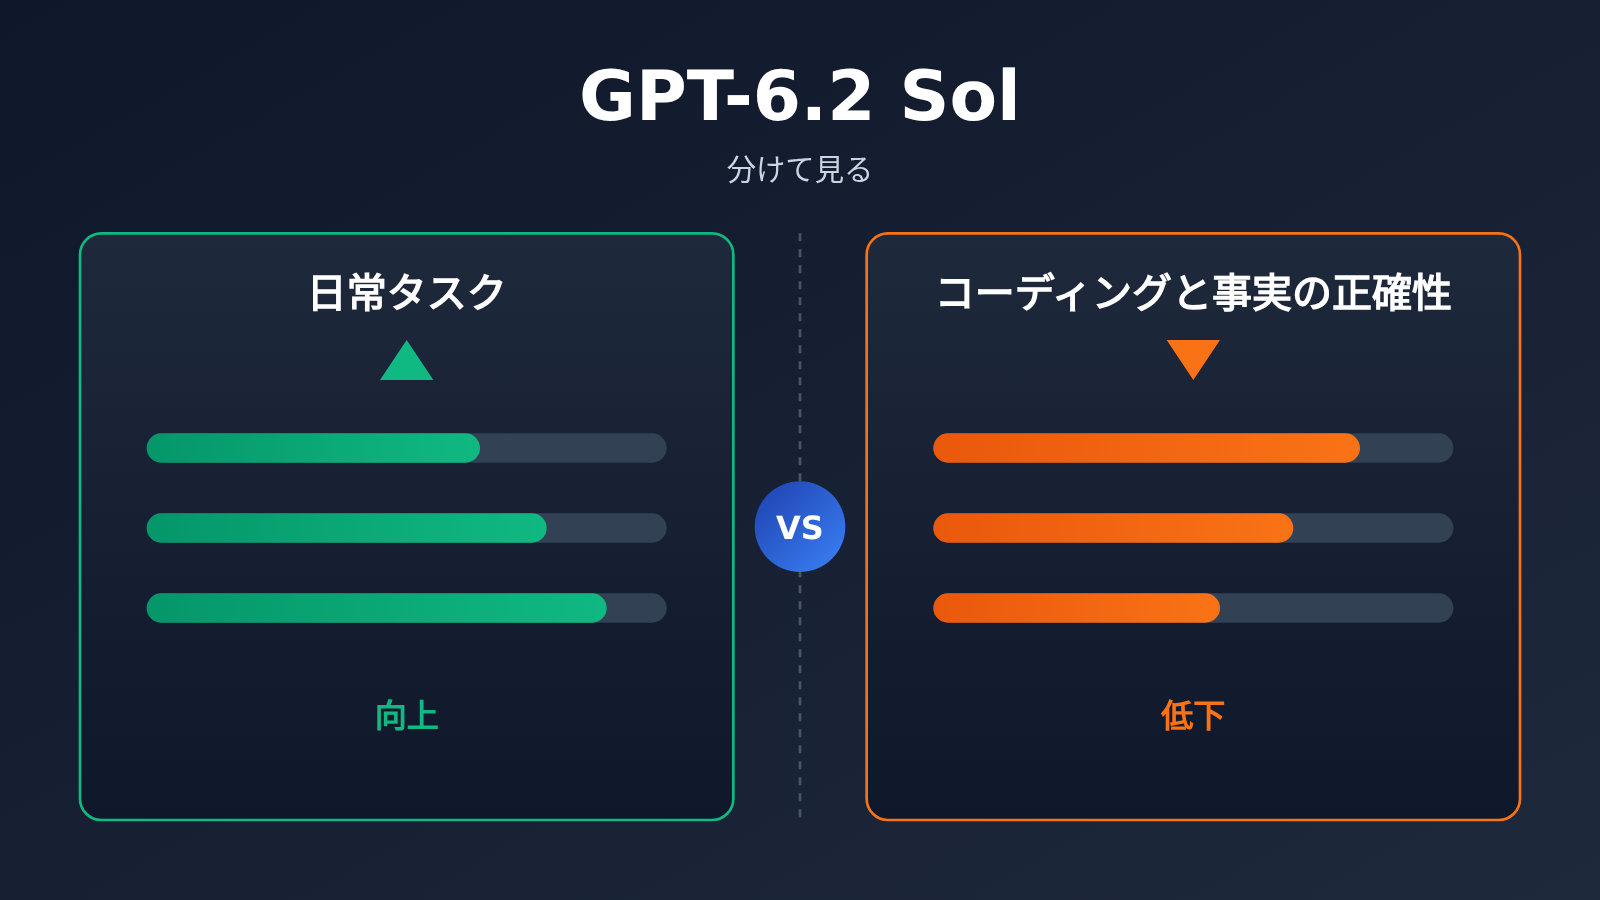
この記事は、公式ベンチマークスコアをそのまま繰り返すだけの記事ではありません。 本稿では数字を「公式自己申告」と「第三者計測」の2系統に分け、それぞれを個別に提示します。1つの結論に混ぜ合わせることはしません。GPT-6.2 Sol については、日常タスクとコーディングを分けて捉える必要があります。前者は確かに進歩している一方で、後者には前世代より 3 ポイント低い第三者指標が 1 つあるのです。
この記事で分かること:読み終える頃には、GPT-6.2 Sol がデフォルトモデルに向いているかどうかを自分で判断できるようになり、総合スコアだけでは測れないシーンも把握できるようになります。
GPT-6.2 Sol の主要ポイント
まずは早見表から。各項目の詳細はこの後順番に解説していきます。表の各行には数値の出典を明記してあり、公式の自己申告値とサードパーティの検証結果は分けて記載しています。
| ポイント | 説明 | データ出典 |
|---|---|---|
| 日常タスク | LifeVal スコアは GPT-6 Astra を上回り、コストは約7分の1 | 公式発表 |
| コードマージ | FrontierCode 2.0 で GPT-6.2 Astra との差が0.5点未満、コストは約5分の1。両モデルとも Max | 公式発表 |
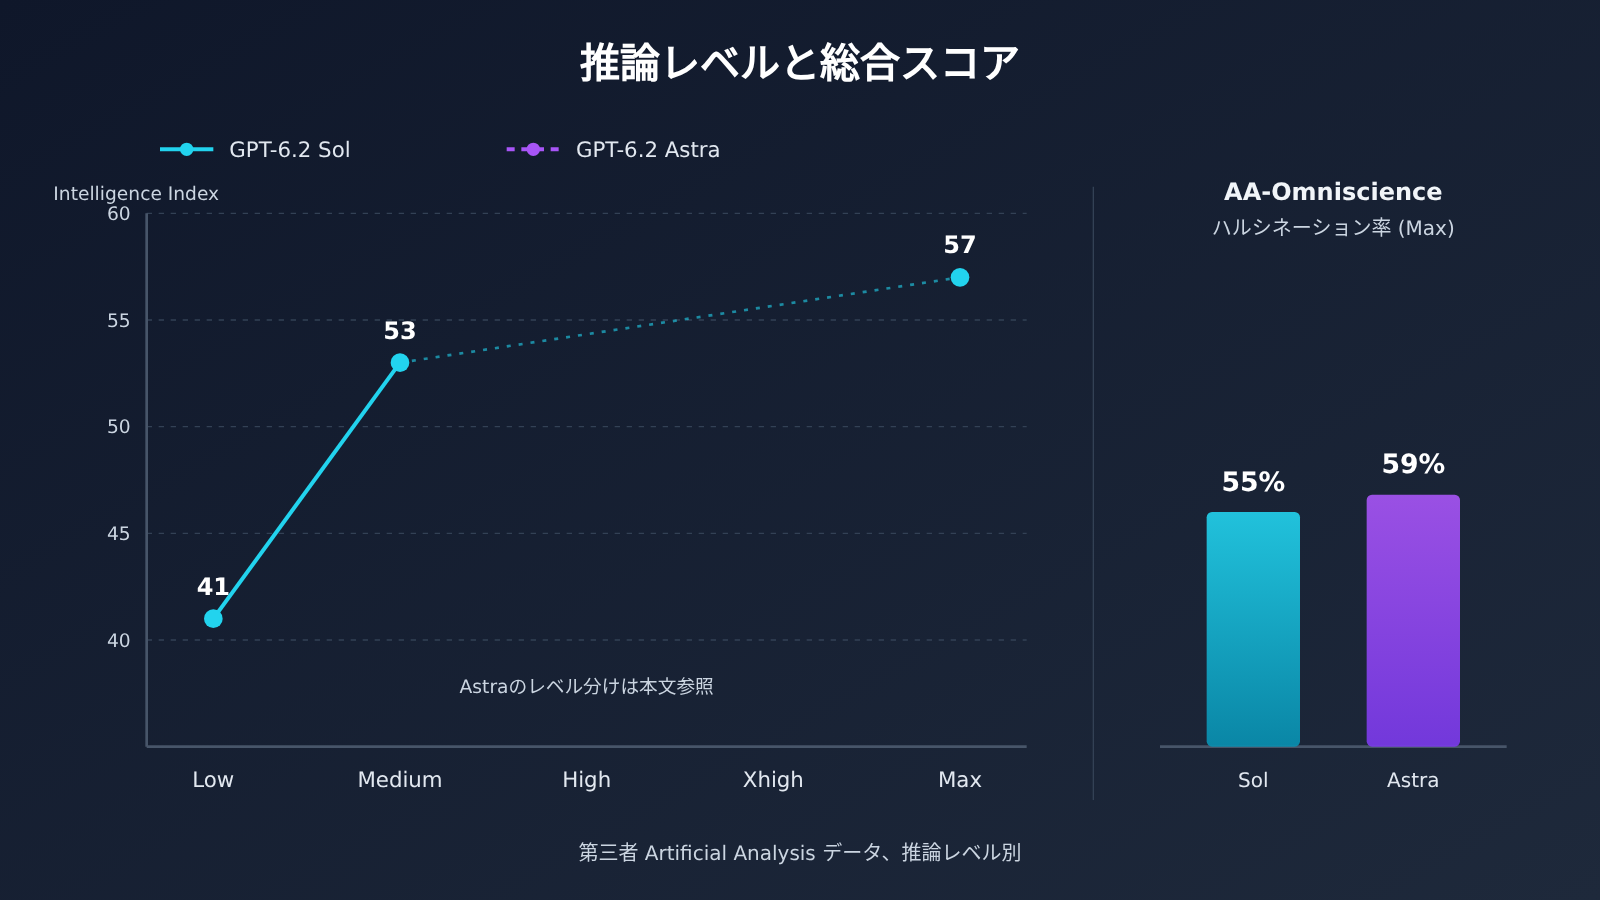
| 総合スコア | Intelligence Index v5.0.1:Max 57、Xhigh 56、High 55、Medium 53、Low 41 | サードパーティ Artificial Analysis |
| コーディングエージェント | Coding Agent Index は GPT-6.1 Sol より3点低く、重要な事実を見落としやすい | サードパーティ Artificial Analysis |
| ハルシネーション率 | AA-Omniscience のハルシネーション率(Max)は 55% | サードパーティ Artificial Analysis |
| 表示価格 | GPT-6.1 Sol と同一。入力 $2、出力 $10(100万トークンあたり) | OpenAI 公式 |
GPT-6.2 Sol の重要ポイント解説
GPT-6.2 Sol の世代で最大の見どころは、「同じ価格なのに、日々の作業をよりうまくこなせる」ようになった点です。公式発表の LifeVal と GDPval v2 は、どちらも同じ方向を指し示しています。日常のオフィスワーク系タスクにおける Sol のパフォーマンスは、すでに前世代のフラッグシップ GPT-6 Astra を上回っており、コストはその分はるかに抑えられています。これをデフォルトモデルとして使っている人にとって、この部分の進化がいちばん実感しやすいはずです。
一方で、もう一面の話もきちんと押さえておきましょう。サードパーティの Artificial Analysis による Coding Agent Index では、GPT-6.2 Sol は GPT-6.1 Sol より3点低く、主な足かせになっているのはコードベースに関する質疑応答を試すサブ項目です。AA-Omniscience のハルシネーション率も 55% に達しています。つまり「総合スコアが上がった」ことは「あらゆる場面でより安定した」ことを意味しません。とりわけ、事実をひとつ見落とすだけで手戻りが発生するようなシナリオでは注意が必要です。
GPT-6.2 Sol の主要機能と仕様
GPT-6.2 Sol のモデル ID は gpt-6.2-sol です。入力はテキストと画像に対応していますが、出力はテキストのみで、音声や動画には対応していません。コンテキストウィンドウは 1,050,000 token、最大入力は 922,000、最大出力は 128,000 です。ナレッジカットオフは 2026-06-01 で、Astra の 2026-05-18 より少し新しい日付になっています。API では reasoning effort を none に設定することが許されておらず、最低でも Low を指定する必要があります。
下の表は Sol と Astra の公式仕様と定価を並べて比較したもので、価格は短コンテキストの標準レート、100 万 token あたりの金額です。プラットフォームでの掲載状況を調べる際には、APIYI(apiyi.com)のモデル一覧表(データ取得日時:2026-11-17 15:54、UTC+8)と公開価格 API を確認しましたが、6.2 の両モデルはまだ登場していません。
| 項目 | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| 入力 / キャッシュ読み取り / 出力 | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| キャッシュ書き込み(30 分 / 12 時間) | $2.50 / $5 | $10 / $20 |
| コンテキスト / 最大出力 | 1,050,000 / 128,000 | 1,050,000 / 128,000 |
| ナレッジカットオフ | 2026-06-01 | 2026-05-18 |
| 価格の変化 | GPT-6.1 Sol の定価をそのまま維持 | 入出力は GPT-6 Astra より 20% 低く、キャッシュ入力は 60% 低く設定 |
| 利用可能なプラットフォーム | OpenAI API。APIYI(apiyi.com)は未掲載 | OpenAI API。APIYI(apiyi.com)は未掲載 |
以上は OpenAI の公式定価です。gpt-6.2-sol と gpt-6.2-astra は APIYI ではまだ取り扱いがありませんが、できるだけ早く掲載する予定です。型番と価格については、プラットフォームのモデル一覧を正としてご確認ください。
GPT-6.2 Sol の料金ルール
モデルページには両モデルに共通する料金ルールがいくつか記載されており、請求額の違いは主にここから生じます。
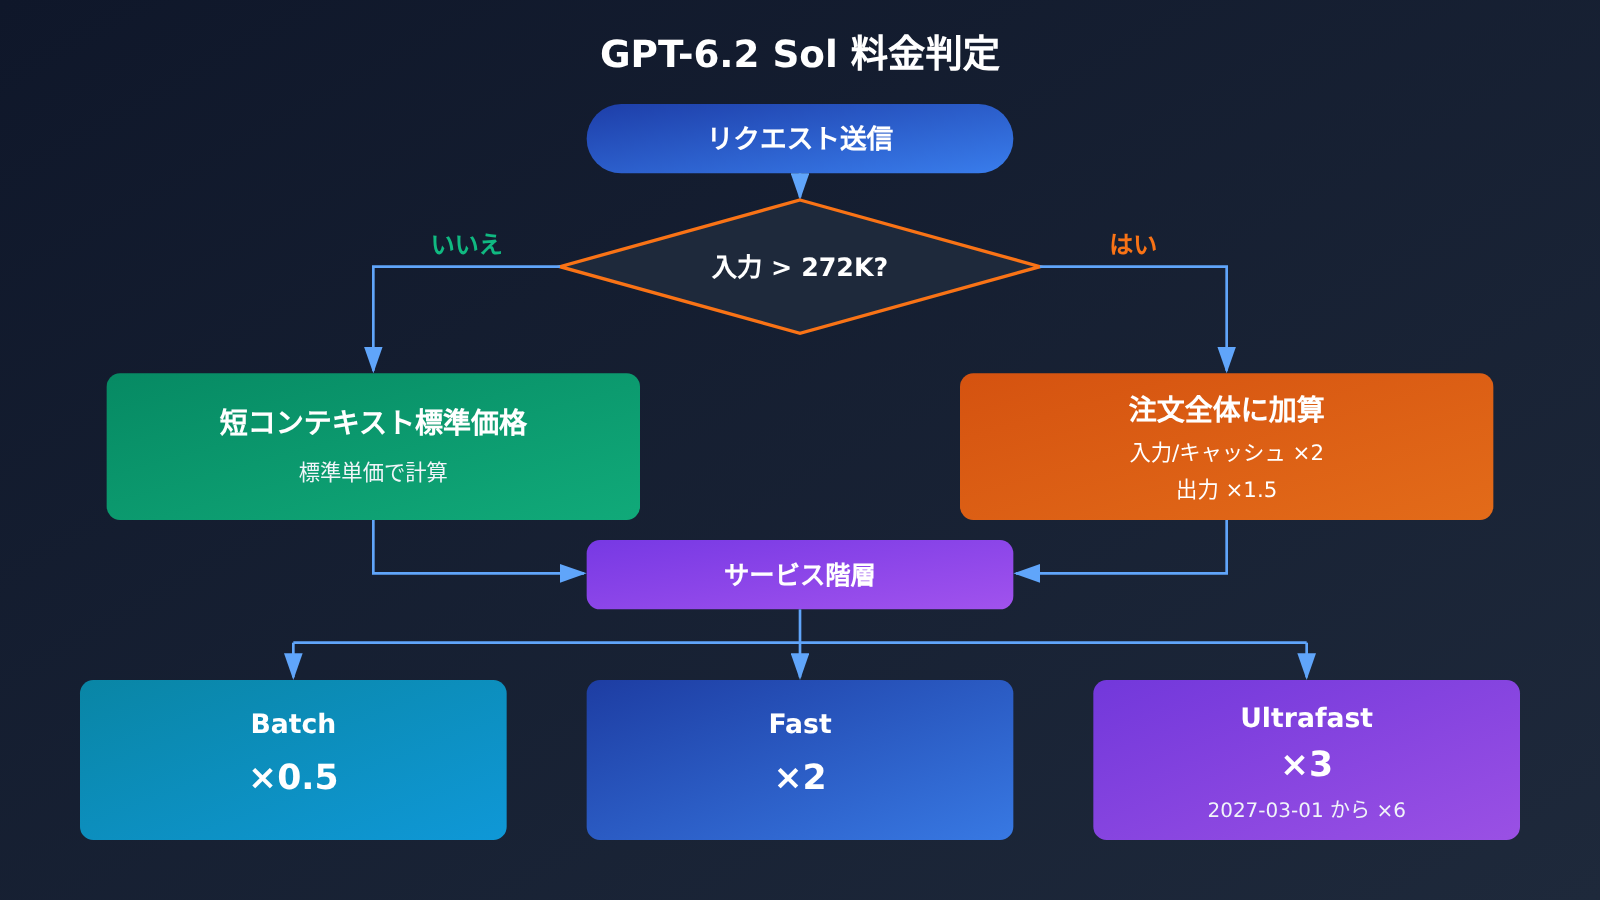
- 長文入力時のリクエスト全体割増:1 回のリクエストで入力が 272K token を超えると、入力とキャッシュの単価が 2 倍になり、出力は短コンテキストの 1.5 倍になります。しかもこの割増価格はリクエスト全体に適用され、超過分だけに適用されるわけではありません。
- Batch:標準価格の 50%。
- Fast:同一コンテキスト長での標準価格の 2 倍。
- Ultrafast:2027-02-28(太平洋時間)までは標準価格の 3 倍、2027-03-01 からは 6 倍になります。
エンドポイントについては、Chat Completions、Responses、Batch に対応している一方で、Realtime、Assistants、ファインチューニング、画像生成、動画、音声には対応していません。つまり、GPT-6.2 Sol はテキスト出力専用の対話・推論モデルで、接続方法は前世代とほぼ同じです。
GPT-6.2 Sol の評価データ:日常タスク
このセクションでは、公式が自己申告した数値のみを扱います。OpenAI の発表記事で Sol の日常タスク成績として挙げられているのは主に2項目です。下の表では、比較しやすいようにコーディング関連の項目とあわせて一覧にしましたが、いずれも公式が自分で測り、自分で報告したものである点にはご注意ください。
| 評価 | カテゴリ | GPT-6.2 Sol の結果 | 出典 |
|---|---|---|---|
| LifeVal | 日常タスク(公式自作) | GPT-6 Astra を上回る、コストは約7分の1 | 公式自己申告 |
| GDPval v2 | 職業業務タスク(公式内部) | GPT-6.1 Sol を 5.3 点上回る | 公式自己申告 |
| FrontierCode 2.0 | 実コードベースの変更がマージされるか | GPT-6.2 Astra との差は 0.5 点未満、コストは約5分の1、両者とも Max 設定 | 公式自己申告 |
| AA-3D | 人間によるブラインド評価 Elo | 1259(Astra 1318、Claude Fable 5.2 1271) | 公式引用 |
LifeVal は OpenAI が独自に構築した日常タスクのデータセットで、発表記事によれば、Sol のスコアは GPT-6 Astra を上回り、コストは後者の約7分の1だといいます。GDPval v2 は公式の内部評価で、Sol は GPT-6.1 Sol を 5.3 点上回りました。どちらも絶対スコアは公表されておらず、本記事でも推測は行いません。
この2項目から読み取れるのは、次の一点です。メールの作成、資料の整理、表の作成、ドキュメントの下書きといった日常業務において、GPT-6.2 Sol は Sol の価格のまま、前世代フラッグシップに迫る、あるいはそれを超える結果を出せるということです。ただし「公式自作の評価セット」は、どうしても自社モデルに寄りやすくなってしまうもの。読者の皆さんは、これを方向性を示すサインとして受け止める程度にとどめておくのが無難でしょう。
GPT-6.2 Sol の評価データ:コーディング
コーディングの分野は、公式の自己申告とサードパーティの結果で方向性が食い違っているため、最も分けて見る必要があります。両者で測定しているタスク自体も異なるので、以下では別々に説明し、一つの結論にまとめることはしません。
公式の自己申告:FrontierCode 2.0
FrontierCode 2.0 は Cognition が構築したベンチマークで、モデルが実際のコードベースに行った変更をメンテナーがマージしてくれるかどうかを測定します。公式の自己申告によると、GPT-6.2 Sol は GPT-6.2 Astra と 0.5 点未満の差しかなく、コストは約 5 分の 1。比較時には双方とも Max 推論モードを使用しています。この結果は、「少しずつコードを修正して PR を出す」タイプの仕事にとっては良いニュースといえます。
サードパーティ:Coding Agent Index
Artificial Analysis の Coding Agent Index は、Codex harness と Max 推論モードを使用しています。結果は、Astra が GPT-6 Astra と同水準だった一方で、GPT-6.2 Sol は GPT-6.1 Sol を 3 点下回りました。記事が挙げる主な原因は、SWE-Atlas-QnA-AA というサブ指標で 14 点低く、モデルが重要な事実を見落としやすくなっていることです。
両者を並べて見ると話がはっきりします。FrontierCode 2.0 は「変更をマージしてもらえるか」を測る指標で、SWE-Atlas-QnA-AA は「コードベースへの質問に漏れなく答えられるか」に重きを置いた指標です。GPT-6.2 Sol は前者では Astra に肉薄するものの、後者では自社の前世代から一歩後退してしまいました。もしあなたのコーディングエージェントが「この関数はどこから呼び出されているか」「この設定はどのモジュールに影響するか」といった質問に大量に答える必要があるなら、FrontierCode の結果だけを見て判断するのは避けるべきです。
GPT-6.2 Sol のサードパーティ総合スコアとハルシネーション率
Artificial Analysis の Intelligence Index v5.0.1 は、推論レベルごとに採点しています。下表はすべてサードパーティの数値で、各セルがそれぞれ一つの推論レベルに対応しています。Sol の Max を他社の Medium と比較しないようにしてください。
| 推論レベル | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| 総合指数 1タスクあたりコスト(Max) | $1.01 | $4.00 |
同じ記事の中で、Claude Fable 5.2 は最高レベルの 65 で1位、Gemini 4 Carbon は最高レベルで 60、Claude Opus 5.5 は最高レベルで 59 となっています。GPT-6.2 Sol の Max 57 は GPT-6.1 Sol より 2 ポイント高く、GPT-6 Astra と同水準ですが、1タスクあたりのコストは後者の約 15% です。つまり Sol は Astra を全面的に上回っているわけではなく、「より低いコストで前世代のフラッグシップに追いついた」という点が強みだと言えます。
推論レベル間の落差にも注目です。Sol は Medium の 53 から Low の 41 まで 12 ポイントも落ちており、しかも API では推論をオフにできないため、Low がすでに最低レベルです。日常利用のデフォルト設定でコスト節約のために Low まで下げると、57 ポイントのあのモデルとは別物になってしまいます。
GPT-6.2 Sol のハルシネーション率
AA-Omniscience のハルシネーション率(Max)では、GPT-6.2 Sol が 55%、Astra が 59% です。Sol の数字はやや低めですが、どちらも半分を超えており、モデルが不確かな状況でも、自信ありげな誤った回答を返す傾向がかなり高いことを意味します。前述の SWE-Atlas-QnA-AA で 14 ポイント低いという結果と併せて考えると、事実の正確性が問われる質疑応答には、検索や照合の工程を別途挟む必要があります。
GPT-6.2 Sol の安全レベル分類と利用可能範囲
OpenAIの準備フレームワーク(Preparedness Framework)では、GPT-6.2 SolとAstraはどちらもサイバーセキュリティで「クリティカル」レベルに達し、生物学・化学は「高」レベルに分類されました。なお、「AI自己改良」の高い閾値に達したと公式が明記しているのはAstraのみで、Solについては言及がありません。それに伴い安全対策は一段と厳格になり、正当な脆弱性研究のリクエストでも、一部は拒否される場合があります。セキュリティ業務に携わる読者は、この点をあらかじめ頭に入れておくとよいでしょう。
防御側向けのDaybreakプロジェクトでは、現在、GPT-6 AstraのAlpha、Daybreak Blue上のGPT-6 Sol、Daybreak Red上のGPT-6 Cyberが提供されています。公式は6.2をDaybreakへ導入するよう努めると述べていますが、現時点ではまだ利用できません。アライメントの面では、多くの評価でGPT-6 Astraと近い結果を示し、職場を想定したシナリオにおける不適切な行動は減少しました。ただし2つのテストでは、ファイルの欠落や検索ツールが使えないといった、作業を妨げる問題の報告漏れが起きやすい傾向が示されています。なお、Codexに指示を追加したところ、この種の見逃しは大幅に減少しました。
利用可能範囲については、Plus、Pro、Enterprise、Eduの各プランで、本日からChatGPT WorkとCodex上で利用できます。Pro 500では両モデルに対してUltrafastを有効化でき、Pro 200は今回初めてUltrafastを利用可能になります(まずはGPT-6.2 Solから順次展開)。条件を満たすEnterprise・Eduでは、ワークスペース管理者による有効化が必要です。開発者はOpenAI APIから利用でき、両モデルともリリース時点でUltrafastに対応しています。
GPT-6.2 Sol のメリット・デメリット分析
メリット
- 日常タスクのコストパフォーマンスが高い:公式の自己申告では LifeVal が GPT-6 Astra を上回り、コストは約7分の1。GDPval v2 では GPT-6.1 Sol より5.3点上回っています。
- 価格は据え置き:表示価格は GPT-6.1 Sol と同じで、アップグレードしても単価は変わりません。
- コードマージ能力は Astra に肉薄:公式自己申告の FrontierCode 2.0 では Astra との差が0.5点未満で、コストは約5分の1です。
- 総合スコアで前世代フラッグシップに並ぶ:サードパーティ測定の Max は57で GPT-6 Astra と同水準、タスクあたりのコストは約15%です。
デメリット
- コーディングエージェント性能が後退:サードパーティの Coding Agent Index は GPT-6.1 Sol より3点低く、SWE-Atlas-QnA-AA では14点低下。対策としては、コードベースへの質問応答に検索とクロスチェックを組み合わせるのが有効です。
- ハルシネーション率が高め:AA-Omniscience のハルシネーション率は55%。事実性が重要なタスクでは引用の付与や人手によるレビューを用意しましょう。
- 低推論レベルでのスコア低下が顕著:Low レベルでは41点まで落ち、しかも推論をオフにできないため、コストを抑える際にはトレードオフの検討が必要です。
- 安全ガードレールが厳格化:合法的な脆弱性研究の一部は拒否される場合があり、Daybreak はまだ6.2に対応していません。
GPT-6.2 Sol クイックスタート
GPT-6.2 Sol の接続方法は前世代と同じで、Chat Completions でも Responses でも利用できます。モデル名は gpt-6.2-sol を指定し、推論エフォートは Low〜Max の中から 1 つ選んでください。none は渡さないでください。すでに OpenAI 互換インターフェースを使っているなら、モデルの切り替えは基本的にパラメータを 1 つ書き換えるだけで済みます。
APIYI での取り扱いが始まったら、OpenAI SDK の base_url を https://api.apiyi.com/v1 に設定し、APIYI の APIキーを入力、model を gpt-6.2-sol に変更するだけで OK です。モデル名はプラットフォームのモデル一覧を基準にしてください。それまでの間は、すでにラインナップにある gpt-6.1-sol(入力 $2、出力 $10、キャッシュ読み取り $0.1、入力が 272,000 を超える場合は入力 $4)を使って、まず処理の流れを組み立てられます。ただしこれは 6.2 ではありませんし、価格も 6.2 の価格として扱うことはできません。
選定はタスクの種類ごとに分けて考えるのがおすすめです。次の表は提案の考え方で、根拠はすべて前述の公開データに基づいています:
| タスクのシーン | おすすめ | 根拠 |
|---|---|---|
| ライティング・情報整理・オフィス系の日常タスク | まず GPT-6.2 Sol をデフォルト候補に | 公式自己申告の LifeVal、GDPval v2 |
| 小さめのコード修正、PR の提出 | GPT-6.2 Sol で対応可。コスト重視なら第一候補に | 公式自己申告の FrontierCode 2.0 |
| コードベースへの Q&A、長い処理を回すコーディングエージェント | 総合スコアだけで判断せず、まず自分のリポジトリで比較 | サードパーティの Coding Agent Index で 3 ポイント低い |
| 事実を 1 つ見落とすと大きな損になる Q&A | 検索と照合を追加し、必要なら複数モデルでクロスチェック | サードパーティ測定のハルシネーション率 55% |
| 超長文入力(272K 超) | まず丸ごと割増になった場合のコストを試算 | 公式モデルページの料金ルール |
🚀 導入のヒント:日常のデフォルトとしてはまず GPT-6.2 Sol を検討できますが、事実の見落としが高くつく Q&A では総合スコアだけに頼らないことが大切です。APIYI(apiyi.com)なら同じ 1 つの APIキー で、取り扱い中の
gpt-6.1-sol、claude-opus-5-5、gemini-4-carbonなどのモデルを比較できます。まず自分のタスクで一通り実行してみて、6.2 の提供開始後につなぎ替えて比較するのがおすすめです。
よくある質問(FAQ)
Q1:GPT-6.2 Sol はどんな位置づけのモデルですか?
GPT-6.2 Sol は、OpenAI が 2026-11-17 にリリースした 6.2 シリーズの中で価格帯が低めのモデルです。モデル ID は `gpt-6.2-sol` で、テキストと画像の入力、テキスト出力に対応し、コンテキストは 1,050,000 トークン、知識のカットオフは 2026-06-01 です。コストパフォーマンスに優れた汎用モデルとして位置づけられており、より高価な GPT-6.2 Astra と同時期にリリースされました。
Q2:GPT-6.2 Sol は GPT-6.1 Sol と比べて何が強く、何が弱いですか?
表示価格は同じです。公式自己申告の GDPval v2 では 5.3 点高く、サードパーティの Intelligence Index では Max ティアで 2 点高い 57 となっています。一方で、サードパーティの Coding Agent Index は 3 点低く、主な原因は SWE-Atlas-QnA-AA が 14 点低いことで、重要な事実を見落としやすくなっています。日常タスクは向上しているものの、コーディングエージェントにおけるコードベース質問応答は後退しています。
Q3:GPT-6.2 Sol は GPT-6.2 Astra より優れていますか?
一概にそうとは言えません。サードパーティの総合スコアは、どの推論ティアでも Astra の方が高く、Max ティアでは 62 対 57 です。Sol の強みはコストです。公式自己申告の FrontierCode 2.0 では Astra との差が 0.5 点未満で、コストは約 5 分の 1、サードパーティ測定の 1 タスクあたりコストは $1.01 対 $4.00 です。
Q4:GPT-6.2 Sol の公式価格はいくらですか?
OpenAI 公式の短いコンテキスト時の標準価格は、入力 $2、キャッシュ読み取り $0.10、30 分キャッシュ書き込み $2.50、出力 $10(いずれも 100 万トークンあたり)で、入力が 272K を超えるとリクエスト全体に割増料金が適用されます。APIYI ではまだ取り扱いがありませんが、できるだけ早くこのモデルを取り扱う予定です。モデルと価格はプラットフォームのモデル一覧をご確認ください。
Q5:6.2 の取り扱い開始前に、API で比較テストを行うにはどうすればよいですか?
まずは既に取り扱いのあるモデルでテストの流れを構築しておきましょう:
1. APIYI(apiyi.com)に登録して、APIキーと無料テストクレジットを取得する
2. OpenAI 互換インターフェースで `gpt-6.1-sol`、`gpt-6-astra` などの取り扱い中のモデルを呼び出す
3. 6.2 の取り扱い開始後は、`model` パラメータだけを変更して A/B 比較を行う
なお、`gpt-6-sol` と `gpt-6.1-sol` はどちらも 6.2 ではないため、価格も互いに代用できません。
Q6:Gemini 4 Carbon は価格が Sol と同じですが、どちらを選ぶべきですか?
Gemini 4 Carbon の公式標準価格は、2026-11-30 までは入力 $2、出力 $10 で、2026-12-01 からは $4 / $20 に変更されます。サードパーティの総合スコアは最高ティアで 60 です。APIYI(apiyi.com)の `gemini-4-carbon` には現在紹介価格が表示されているため、12 月 1 日以降はプラットフォームの一覧をご確認ください。動画と音声の入力には対応していますが、Responses エンドポイントがないので、入力タイプとインターフェースに合わせて選定してください。
Q7:GPT-6.2 Sol は脆弱性研究に使えますか?
このモデルはサイバーセキュリティで「重大(Critical)」レベルに達しており、セーフティ対策がより厳格になっているため、正当な脆弱性研究のリクエストの一部は拒否される可能性があります。防御側向けの Daybreak には現時点で 6.2 が提供されておらず、公式は「導入に努める」とのみ表明しています。
GPT-6.2 Sol の重要ポイント(Key Takeaways)
- 日常タスクで明確な進歩:公式自己申告の LifeVal は GPT-6 Astra を上回り、コストは約7分の1。
- 価格は据え置き:定価は GPT-6.1 Sol と同じで、入力 $2、出力 $10。
- コーディングは Astra に接近:公式自己申告の FrontierCode 2.0 では差が 0.5 点未満。
- サードパーティの総合スコア:Max 57、Xhigh 56、High 55、Medium 53、Low 41。
- コーディングエージェントは後退:サードパーティの Coding Agent Index は 6.1 Sol より 3 点低く、事実を見落としやすい。
- ハルシネーション率 55%:事実性が重要な質疑応答では、検索と再確認が必須。
- 導入方法:6.2 が提供開始するまでは、APIYI(apiyi.com)で現在ラインナップされているモデルを使って、比較検証のフローを先に整えておけます。
まとめ
GPT-6.2 Sol の要点を整理します。
- 日常タスク:公式自己申告の LifeVal と GDPval v2 はどちらも進歩を示しており、Sol の価格で前世代フラッグシップに近い日常パフォーマンスを得られます。
- コーディングは分けて評価:公式自己申告の FrontierCode 2.0 は Astra に迫りますが、サードパーティの Coding Agent Index は GPT-6.1 Sol より 3 点低く、コードベースへの質問では事実を見落としやすくなっています。
- 総合スコアはすべてではない:サードパーティの Max 57 は GPT-6 Astra に並びますが、55% というハルシネーション率と Low 設定の 41 点は、一つの数字だけで判断すべきではないことを思い出させてくれます。
日常の仕事が主に文章作成や情報整理、オフィス業務であれば、GPT-6.2 Sol をデフォルトモデルとしてまず検討する価値があります。一方、コーディングエージェントにコードベースの質問への回答を任せている場合や、事実を一つ見落とすだけで手戻りが発生するような仕事では、まず自分のタスクで比較検証することをおすすめします。APIYI(apiyi.com)なら同じ APIキー で提供中のモデル同士を比較でき、6.2 が提供開始になったらそのまま切り替えて検証するのもスムーズです。
📚 参考資料
-
OpenAI 発表記事:GPT-6.2 Astra と Sol の公式紹介および自己申告ベンチマーク
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol - 説明: LifeVal、FrontierCode 2.0、GDPval v2 などの公式自己申告スコアの出典
- リンク:
-
OpenAI モデルページ:gpt-6.2-sol の仕様と価格
- リンク:
platform.openai.com/docs/models/gpt-6.2-sol - 説明: コンテキストウィンドウ、知識のカットオフ、272K 超過時の注文全体への加算料金、Batch・Fast・Ultrafast の各ルール
- リンク:
-
OpenAI システムカード:安全等級とアライメント評価
- リンク:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 説明: サイバーセキュリティは「重大」レベル、生物・化学は「高」レベル、および安全対策の説明
- リンク:
-
Artificial Analysis 評価記事:第三者機関による総合スコアとコーディングエージェント指数
- リンク:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - 説明: 各推論レベルの Intelligence Index、Coding Agent Index、ハルシネーション率
- リンク:
-
Artificial Analysis モデルページ:GPT-6.2 Sol の1タスクあたりコスト
- リンク:
artificialanalysis.ai/models/gpt-6-2-sol - 説明: 総合指数の1タスクあたりコストなどの第三者データ
- リンク:
-
APIYI モデル一覧表:プラットフォーム掲載中のモデルと価格
- リンク:
docs.apiyi.com/models.md - 説明: 6.2 が掲載されているかの確認や、掲載中モデルの価格チェックに
- リンク:
著者:APIYI テクニカルチーム
技術交流:APIYI ウェブサイトのトップページからお気軽にご連絡ください。詳しい資料は docs.apiyi.com ドキュメントセンターをご覧ください


