
直接回答:理想的な条件下では、OpenAIのデフォルト30分プロンプトキャッシュは2回目の利用からキャッシュなしより安くなり、12時間キャッシュは3回目の利用から元が取れます。 ここでいう理想的条件とは、同じ固定プレフィックスをまず一度完全にキャッシュへ書き込み、以降のリクエストがすべてヒットし、その間に再書き込みが発生しない状態です。gpt-6-lunaの標準的な短コンテキスト向け公式料金で計算すると、10000トークンの固定プレフィックスを合計10回使う場合、30分キャッシュはキャッシュなしより約78.5%節約でき、12時間キャッシュは約66%節約できます。ただし、これは固定プレフィックス部分だけの計算であり、リクエスト全体が割引されるわけではありません。
この記事を読むと何が分かりますか?
- プロンプトキャッシュがヒットする実際の条件と、「意味的に類似」していることとの違い。
- 30分と12時間の2種類の書き込み料金がどのように計算されるか、なぜ通常の入力料金を重ねて課金できないのか。
- 検証可能な1回・2回・3回・10回利用の計算例と、任意のプレフィックス長に適用できる元を取るための公式。
- これらのルールが、開発者のプロンプト構造設計やバッチタスクの配置にとってそれぞれ何を意味するか。
目次: まず概念表と影響の概要で、用語と影響を受ける読者を整理します。「客観的事実」パートでは、公式ドキュメントにあるキャッシュルール、料金、計算例のデータをまとめます。「分析と判断」パートでは、元が取れるラインの背景にある数学的な関係を説明し、プロンプト構造、バッチの配置、よくある誤解について論じます。
OpenAI プロンプトキャッシュ To Know:概念を解説
| 概念 | 簡単な説明 |
|---|---|
| プロンプトキャッシュ(Prompt Caching) | OpenAI は繰り返し現れるプロンプトのプレフィックスをキャッシュし、後続のリクエストがヒットした際には、より低い「キャッシュ読み取り」価格で課金します |
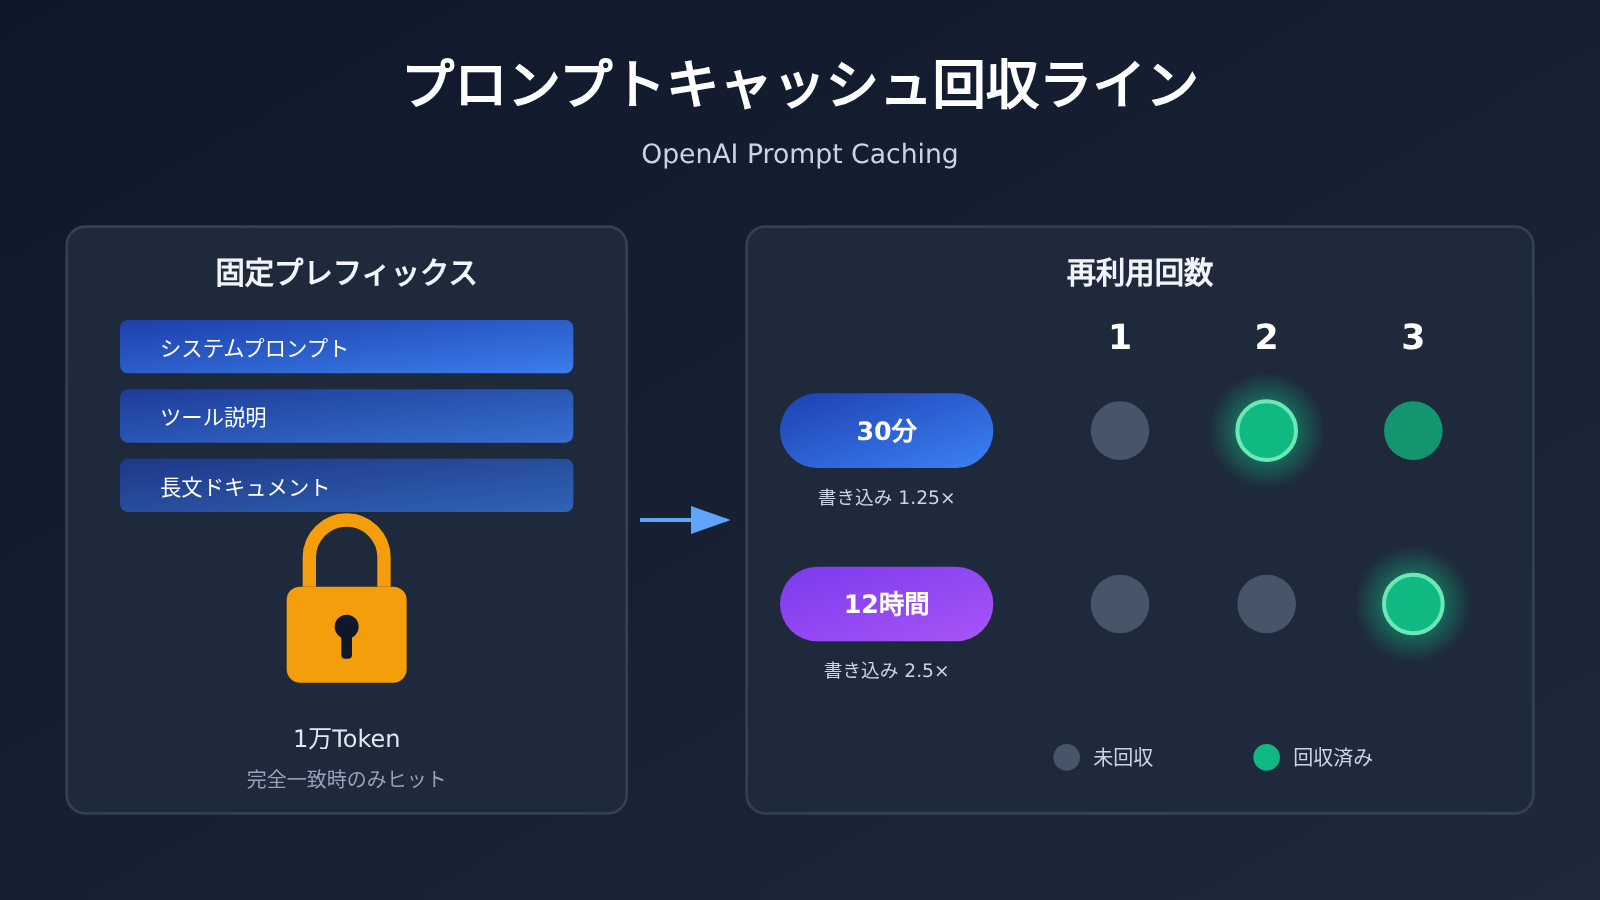
| プロンプトプレフィックス | 1回のリクエスト入力の先頭から連続する内容です。キャッシュが一致するのは完全に同一のプレフィックスであり、意味が近い内容ではありません |
| 可視入力トークン | キャッシュのしきい値に算入される入力トークンです。GPT-5.6 以降のモデルでは、キャッシュを利用するために最低 1024 個必要です |
| キャッシュ書き込み | 初回にプレフィックスをキャッシュへ保存する際の課金です。通常の入力価格の倍数で計算され、総書き込みレートとなります |
| キャッシュ読み取り | 後続のリクエストがキャッシュにヒットした際の課金です。価格は通常入力より大幅に低くなります |
| 30分 / 12時間キャッシュ | キャッシュの有効時間には2つの区分があります。デフォルトは30分です。12時間区分は Responses API で提供され、書き込みコストはより高くなります |
| Standard 処理ティア | 公式価格表における標準処理ティアです。処理ティアごとに価格が異なり、混用できません |
| Short context ティア | 公式価格表はコンテキスト長でティアを分けていますが、本記事では短いコンテキストの価格のみを使用します |
OpenAI プロンプトキャッシュの影響をひと目で
- API 開発者: キャッシュでコストを削減できるかどうかは、「有効にすれば必ず節約できる」ではなく、再利用回数と有効時間内のヒット率に左右されます。30分ティアは、合計2回の利用(初回書き込み+1回のヒット)でキャッシュなしより安くなります。12時間ティアは書き込みコストが高く、より多くの再利用によってコストを分散させる必要があります。
- Agent や長いシステムプロンプトを扱うチーム: 固定ルール、ツール説明、長い文書を先頭に置き、変化する内容を後ろに置くことで、プレフィックスが安定してヒットします。これはパラメータの問題ではなく、構造設計の問題です。
- バッチ処理タスクのチーム: 同じプレフィックスのリクエストをキャッシュの有効時間内に集中して送ると、ヒット率を大きく高められます。タスクが1日中分散している場合は、12時間ティアが妥当かどうかを評価する必要があります。
- コスト計算を担当する人: キャッシュは固定プレフィックス部分の入力費用だけに影響し、出力、追加資料、ツール呼び出し、リトライは含まれません。予算表でキャッシュ削減率をそのまま請求総額に適用してはいけません。
OpenAI プロンプトキャッシュに関する客観的な事実
情報源と有効性について
本記事の資料は 2026-11-17 に確認したもので、情報源は OpenAI が継続的に管理している公式ドキュメントです。具体的には、プロンプトキャッシュのガイド developers.openai.com/api/docs/guides/prompt-caching と、料金ページ developers.openai.com/api/docs/pricing.md です。これらのドキュメントは随時更新されるため、関連ルールの初回公開日は確認していません。そのため本記事はその日のニュースではなく、現行ルールを整理し試算したものです。
プロンプトキャッシュのヒット条件
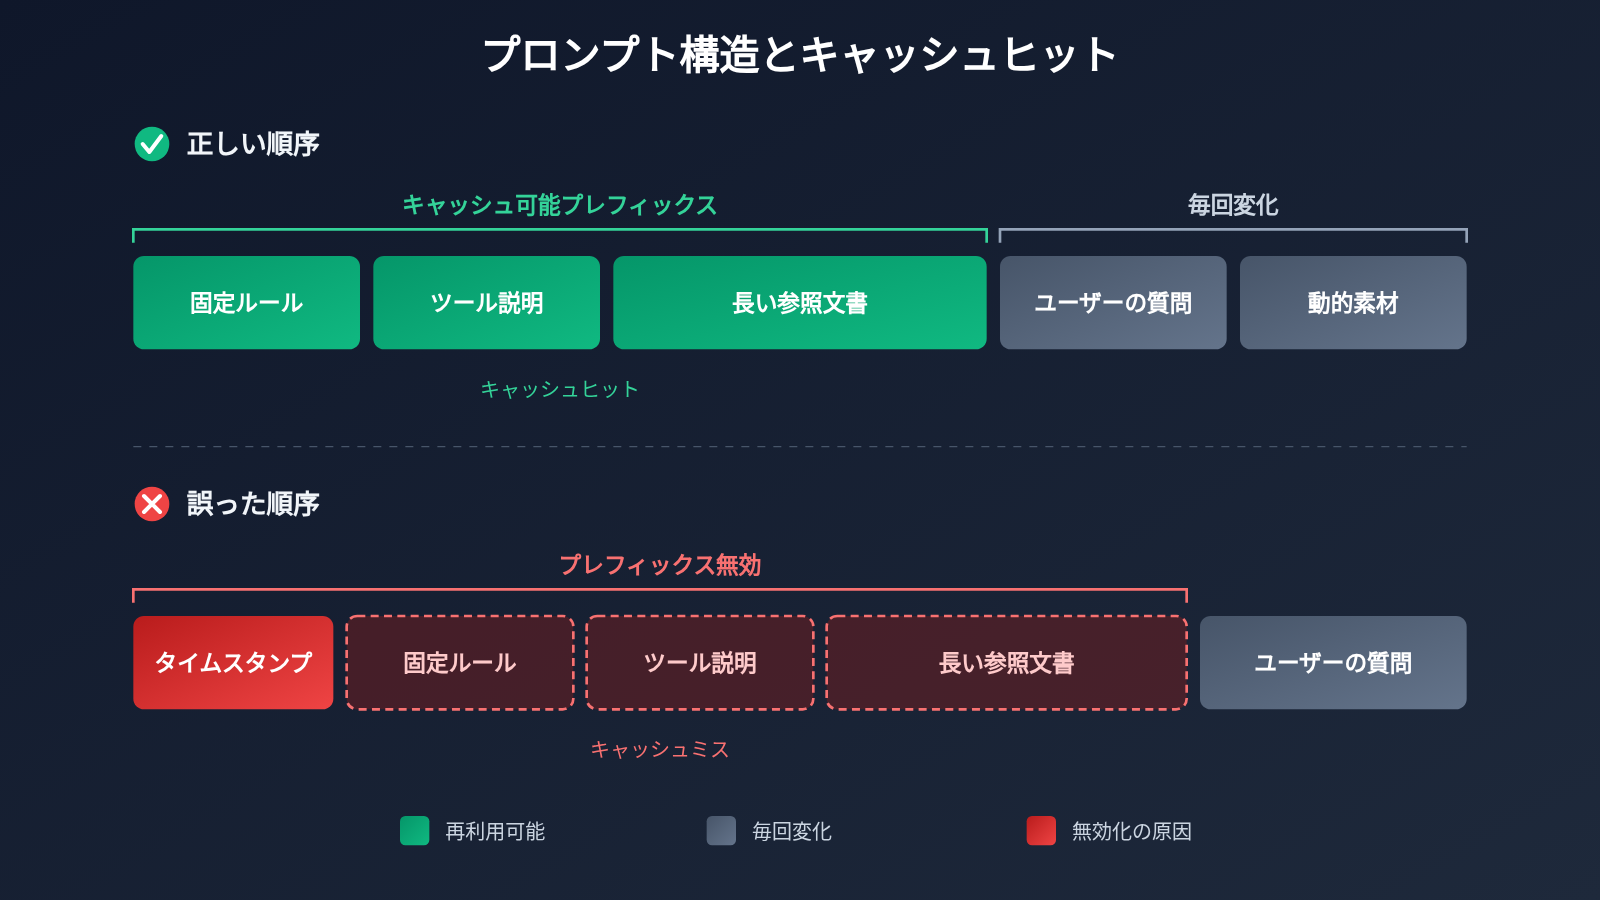
OpenAI のプロンプトキャッシュが照合する対象は、同一のプロンプトプレフィックスです。2つのプロンプトが意味的にほぼ同じでも、冒頭部分の内容が異なっていればヒットしません。意味的な類似度検索ではないからです。つまり、プレフィックス内の1文字でも変化があれば、たとえばシステムプロンプトの冒頭に現在時刻を挿入するだけで、それ以降の内容がすべてヒットの機会を失う可能性があります。
GPT-5.6 以降のモデルでは、キャッシュのしきい値は少なくとも 1024 個の可視入力トークンです。旧モデルではルールが異なるため、本記事の料金計算としきい値に関する結論は、公式ドキュメントに記載された新しいルールにのみ当てはまり、旧モデルにそのまま適用することはできません。
2種類のキャッシュ書き込み料率
| キャッシュの種類 | 書き込み料率(通常入力に対する相対値) | 適用説明 |
|---|---|---|
| 30分(デフォルト) | 1.25 倍 | デフォルトのキャッシュ有効時間 |
| 12時間 | 2.5 倍 | Responses API で提供 |
公式ドキュメントでは、この2つの倍数がいずれも総書き込み料率であることが明記されています。初回書き込み時にこの料率で課金され、通常入力料金が別途上乗せされることはありません。また、12時間とはキャッシュの有効時間を指し、データの削除期限ではない点にも注意が必要です。この2つは混同してはいけません。
gpt-6-luna の公式価格
以下は OpenAI 公式価格ページにおける、gpt-6-luna の Standard 処理ティア、Short context ティアの価格です。単位は100万トークンあたりです。この価格はロングコンテキストティアやその他の処理ティアには適用できません。また、第三者プラットフォームの見積もりでもありません。
| 課金項目 | 価格(米ドル / 100万トークン) |
|---|---|
| 通常入力 | $0.10 |
| 出力 | $0.50 |
| キャッシュ読み取り | $0.01 |
| 30分キャッシュ書き込み | $0.125 |
| 12時間キャッシュ書き込み | $0.25 |
ご覧のとおり、30分書き込み価格 $0.125 は通常入力のちょうど1.25倍、12時間書き込み価格 $0.25 は2.5倍で、ドキュメントに記載された倍数ルールと一致しています。キャッシュ読み取りは通常入力の10分の1にすぎません。
再利用回数の計算例
以下の計算例は公式価格に基づく理論計算であり、実測値ではありません。前提条件は、固定プレフィックス 10000 個の課金対象トークンを使用し、初回使用時にキャッシュへ完全に書き込み、以降は毎回キャッシュヒットし、その間に重複書き込みは発生しないものとします。
| 総使用回数 | キャッシュなし | 30分キャッシュ | 12時間キャッシュ |
|---|---|---|---|
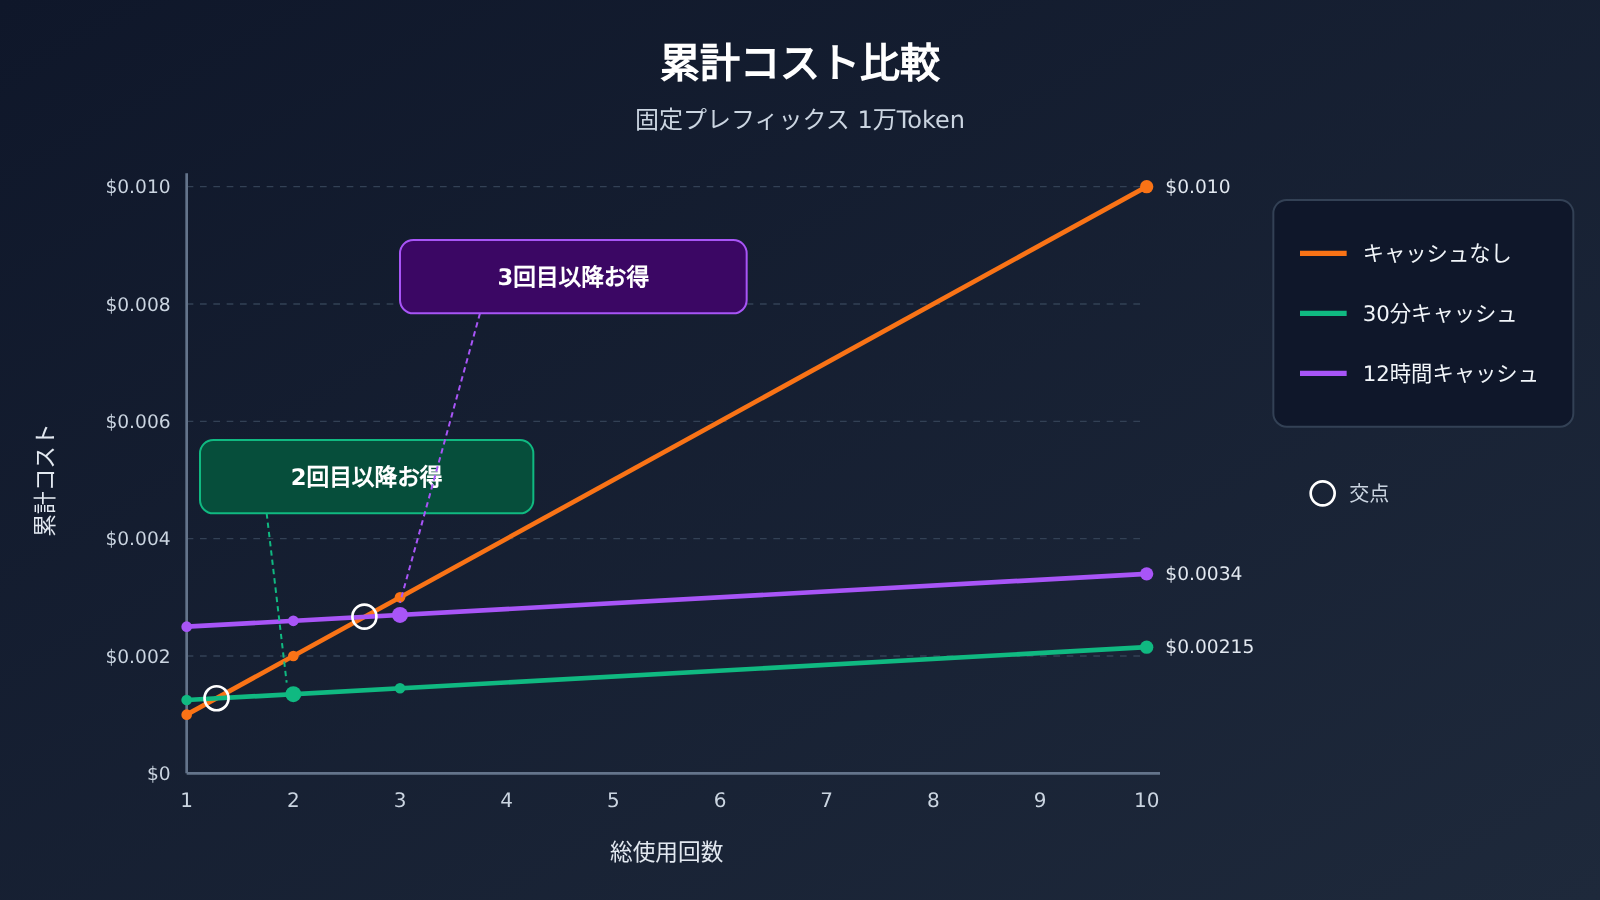
| 1回 | $0.001 | $0.00125 | $0.0025 |
| 2回 | $0.002 | $0.00135 | $0.0026 |
| 3回 | $0.003 | $0.00145 | $0.0027 |
| 10回 | $0.010 | $0.00215 | $0.0034 |
この前提では、30分キャッシュは総使用回数が2回目からキャッシュなしより安くなり、12時間キャッシュは3回目から安くなります。1回だけ使う場合、どちらのキャッシュもキャッシュなしより高くなります。書き込みの割増料金を支払ったものの、読み取り割引を受けられないためです。
計算例の適用範囲
この数値は固定プレフィックス部分のみを計算しています。各リクエストで追加される素材、モデル出力、ツール呼び出し、失敗によるリトライは計算範囲に含まれていないため、これはリクエスト全体に対する割引ではありません。2回の利用間隔がキャッシュの有効期間を超えた場合、後続のリクエストは「全件ヒット」として計算できなくなり、再書き込みの費用を加算する必要があります。
OpenAI プロンプトキャッシュの分析と判断
元が取れる回数が2回と3回になる理由
計算例を使用回数 N に一般化すると、3本のコスト線を次のように表せます(単位は100万プレフィックスTokenあたりの米ドルコスト)。
- キャッシュなし:0.10 × N
- 30分キャッシュ:0.125 + 0.01 ×(N − 1)
- 12時間キャッシュ:0.25 + 0.01 ×(N − 1)
キャッシュのコストがキャッシュなしのコストを下回る条件を解くと、30分キャッシュでは N が約1.28より大きい場合、つまり2回目から割安になります。12時間キャッシュでは N が約2.67より大きい場合、つまり3回目から割安になります。この結論はプレフィックスの長さに依存しません。3本のコスト線はいずれもToken数に比例するため、プレフィックスを2000 Tokenから50000 Tokenに変えても元が取れる回数は変わらず、変わるのは節約できる絶対額だけです。前提として、プレフィックスが1024 Tokenのしきい値を満たし、価格ティアが同一である必要があります。
構造を見ると、書き込み時のプレミアムは一度きりのコストで、キャッシュヒットごとの節約額は通常入力価格とキャッシュ読み取り価格の差、つまり100万Tokenあたり $0.09 です。30分ティアのプレミアムはわずか $0.025 なので、1回ヒットすれば回収できます。12時間ティアのプレミアムは $0.15 で、回収には2回のヒットが必要です。これが2つの損益分岐点が1回ずれる理由です。
再利用できるコスト回収計算スクリプト
以下のスクリプトは、この記事の前提に沿って計算例を再現します。価格と使用回数を置き換えれば、自分のシナリオをすばやく判断できます。価格パラメータは、公式価格ページの最新値を基準にしてください。
# 公式の gpt-6-luna Standard / Short context 価格(米ドル / 100万トークン)に基づく
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """固定プレフィックスのコストのみを計算します。初回は完全に書き込み、以降はすべてキャッシュヒットし、重複書き込みはないものと仮定します。"""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} 次  不缓存 ${base:.5f}  30分钟 ${c30:.5f}  12小时 ${c12:.5f}")
実行結果は、前述の計算例の表と一致します。実際の状況で一部のリクエストがキャッシュにヒットしない場合は、ヒットしなかった回数を「再書き込み」として扱えます。その場合、コスト回収ラインはそれに応じて後ろにずれます。
プロンプトの構造はスイッチよりも重要
キャッシュは完全に同一のプレフィックスしか認識しないため、プロンプトの並び順がそのままヒット率を決めます。より確実な方法は、固定のシステムルール、ロール設定、ツール定義、参照ドキュメントを先頭に置き、ユーザーの質問、検索結果、タイムスタンプなど毎回変わる材料を末尾に置くことです。変化するフィールドが先頭のプレフィックスに混ざってしまえば、その後ろにどれだけ長い固定コンテンツが続いても再利用できません。
もう一つ、よくある誤解をあえて指摘しておきたいと思います。1024 Token のしきい値を満たすためにプロンプトへ無関係な内容を詰め込むのは得策ではありません。詰め込んだ Token は初回に書き込み価格で課金され、その後も毎回キャッシュ読み出し価格で課金されます。さらに、モデルが本来の指示を理解するのを妨げる可能性もあります。しきい値の意味は、短いプロンプトにはそもそもキャッシュが必要ないことを示す点にあり、短いプロンプトを長くしようと促すものではありません。
バッチ編成が「すべてヒット」を左右する
計算例のもうひとつの重要な前提は、後続のリクエストがすべてキャッシュヒットすることです。現実には、同じプレフィックスを使うリクエストが1日のうちに散在していると、30分枠は2回のリクエストの間に期限切れになる可能性が高く、そのたびに書き込み直すことになります。その結果、キャッシュを使わない場合よりも高くつくことがあります。この場合の考え方は2つあります。同種のタスクをバッチにまとめ、30分以内に連続して送信する方法と、12時間枠を検討し、割高な一度きりの書き込みと引き換えに、より長い有効期間を確保する方法です。
選択は、経験則ひとつに単純化できます。リクエストが密集していて間隔が短いなら、デフォルトの30分枠を使い、合計2回の使用でキャッシュなしより安くなります。リクエストはまばらでも、同じ日中に同じプレフィックスを繰り返し使い、合計の使用回数が安定して3回以上見込めるなら、12時間枠に意味があります。あるプレフィックスが有効期間内に高い確率で1回しか使われないなら、キャッシュを使わないことが最も安上がりです。
コスト計算で過大評価されやすい部分
10回使うと約78.5%節約できるという数字は目を引きますが、これは固定プレフィックスの入力費用だけを対象にしたものです。gpt-6-luna の価格体系では、出力価格は通常の入力価格の5倍です。アプリケーションの出力が長い場合や、リクエストごとに大量の新しい検索資料を添付する場合、プレフィックスキャッシュで節約できる金額が請求総額に占める割合は、それほど高くないかもしれません。予算を組むときは、リクエストを「固定プレフィックス」「動的入力」「出力」「ツールとリトライ」に分けて個別に見積もり、最初の区分にだけキャッシュの計算式を適用するのがより合理的です。
なお、本稿で述べた書き込み倍率のルールは GPT-5.6 以降のモデルを対象としています。計算例の具体的な価格は、gpt-6-luna の Standard 処理枠および Short context 枠にのみ対応します。旧モデルや長いコンテキスト枠、その他の処理枠に切り替える場合は、価格を調べ直して再計算する必要があり、元を取るのに必要な利用回数もそれに伴って変わり得ます。公式ドキュメントは継続的に更新されているため、今後ルールが調整された場合は、その時点のドキュメントを基準に結論を判断すべきです。これは継続的に注目すべき変数であり、すでに起きた変化ではありません。
荀子は『勧学』の中で次のように記しています。「土を積んで山とすれば、風雨はここから起こり、水を積んで淵とすれば、蛟竜はここに生まれる」。プロンプトキャッシュの収支も同じです。一度の書き込みはコストを払うだけであり、本当の節約は有効期間内に何度も安定して再利用されることから生まれます。


