
著者注:テンセント・グローバル・デジタル・エコシステム大会で提起された「個人の生産性向上は、組織の強化とイコールではない」という考えを手がかりに、チームでAIを活用する際、モデル呼び出し層にまず整えるべき5つの管理の仕組みを解説します。
2026年11月初旬、テンセント・グローバル・デジタル・エコシステム大会にはAI製品専用の発表ステージが設けられ、2日間で40件以上の製品発表が集中的に行われました。その中で注目したいのが、個人の生産性向上は組織の強化とイコールではなく、その間には組織としてのさまざまな能力が必要になるという指摘です。これは、Tencent Cloud副総経理でWorkBuddyの企業向け製品責任者を務める張曦耀氏の言葉です。
この記事は、よくあるエージェント製品発表のまとめではありません。ここで考えたいのは、より根本的な問題です。個人でのAI活用からチームでのAI活用へと進むと、メンバーは同じモデル群を共用することになります。誰が呼び出せるのか、各メンバーがどれだけ使ったのか、どのプロジェクトに費用がかかっているのか。これらはまず、モデル呼び出し層で管理する必要があります。
この記事で得られること:チームにAIを普及させる前に確認しておきたいポイントがわかります。モデルの接続、APIキーと権限、コストの集計、呼び出しの追跡、知見の再利用を網羅し、統一ゲートウェイで解決できることとできないことも明確にします。
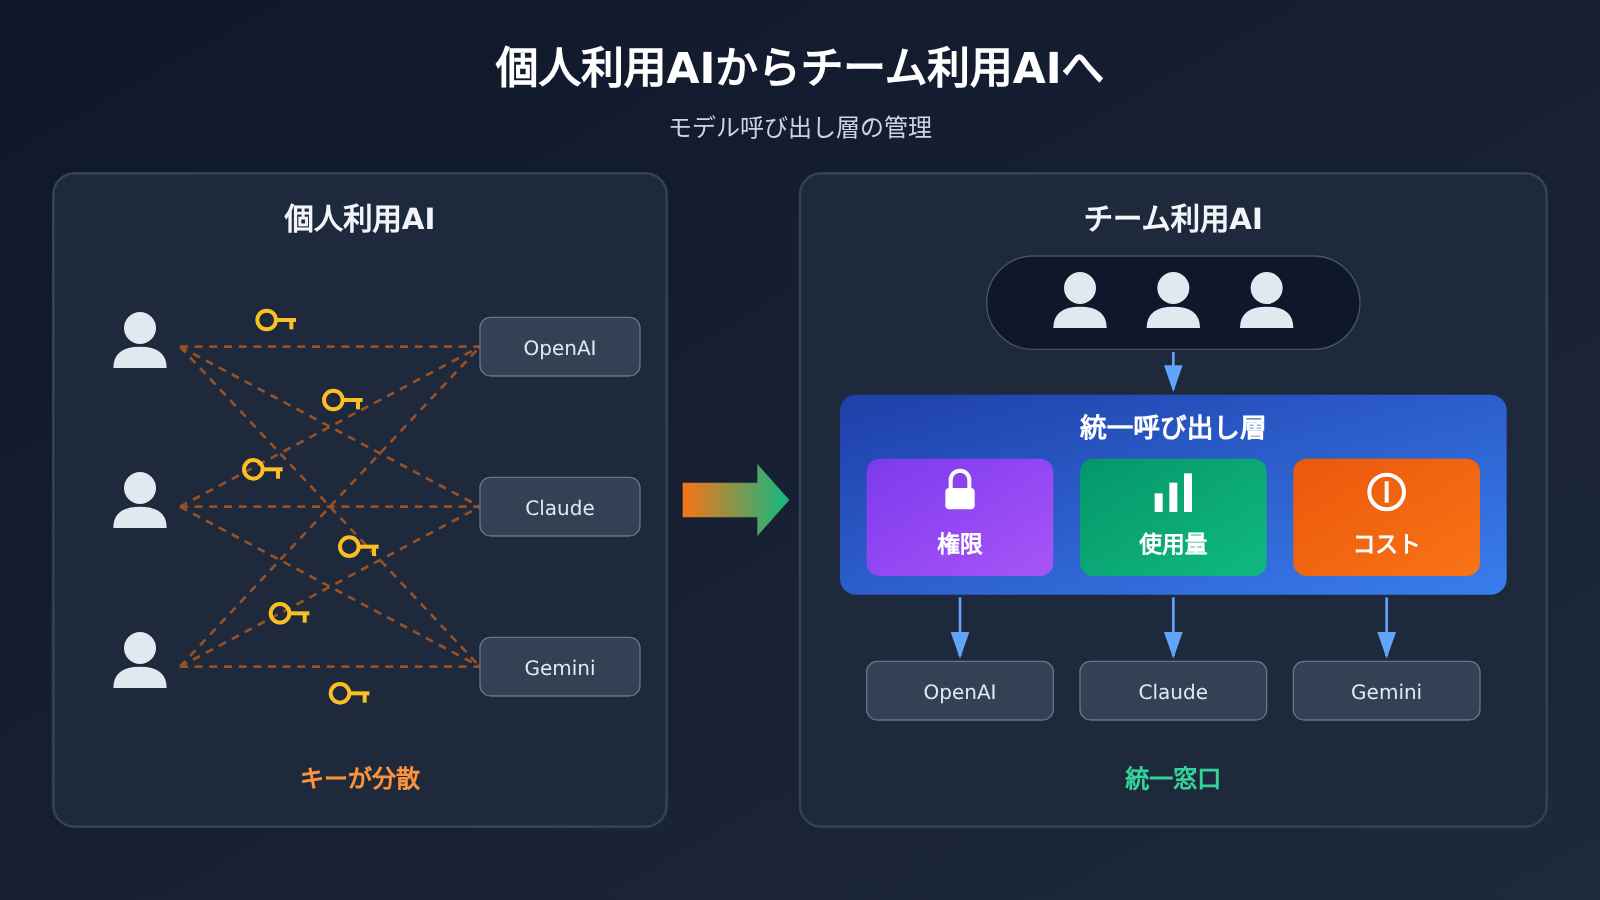
チームでのAI活用:重要ポイント
まずは今回の議論の背景を整理しましょう。以下の表は、GeekParkによる大会レポートに基づいています。
| 項目 | 詳細 |
|---|---|
| イベント | Tencent Global Digital Ecosystem SummitのAI製品発表ステージ。2日間で7つのテーマ、40件以上の製品発表 |
| 核心となる見解 | 個人の効率向上は、組織の強化とイコールではない。その間には組織としての能力が必要 |
| エンタープライズ版の主なアップデート | オープンプラットフォームによる業務システムとの連携。権限、実行プロセス、利用コストを管理するエンタープライズ向けセキュリティソリューションと可観測性センター。マネージドエージェントの24時間365日稼働への対応 |
| 関連スイート | Buddy Oneは統一アカウント、共有Creditプール、一元管理を提供し、企業によるAIの設定・展開の複雑さを軽減することを目指す |
| 導入事例 | 蘇寧は組織全体で利用できるエージェントプラットフォームを構築。14部門、48の協業シナリオをカバーし、再利用可能なエージェントを36個蓄積 |
| 規模拡大の課題 | 各Agentに独立した実行環境が必要な場合、10万人のデジタル従業員を稼働させるには、10万個のサンドボックスが必要になる可能性がある |
チームでAIを活用する際の3つの現実的な課題
報道では、企業がAgentの導入を進める際に、3つの問いに答える必要があるとしています。Agentは既存システムに接続し、必要なデータにアクセスできるか。従業員やAgentごとの権限をどう管理するか。ある人が試行錯誤して見つけた良い方法を、ほかの人もすぐに使えるようにするにはどうすればよいか。この3つは、どの企業の製品を使うかにかかわらず、AIの導入を進めようとするすべてのチームに当てはまります。
注目したいのは、エンタープライズ版のアップデートでは「権限、実行プロセス、利用コスト」が同じモジュールで議論され、共有Creditプールも導入の複雑さを軽減する手段として位置づけられていることです。これは、AIが個人用ツールからチームのリソースへと変わるとき、アクセス制御とコストの集約は、後から対処するものではなく、インフラの課題になることを示しています。
なぜモデル呼び出し層がチームの AI 活用における最初の関門なのか
個人で AI を使う場合、それぞれが複数のモデルサービスに登録し、クレジットカードを登録して APIキーを管理し、自分のスクリプトやツールに呼び出し先のアドレスを直接書き込むのが一般的です。探索段階では効率のよい方法ですが、チームの人数が増えると、さまざまな問題が一気に表面化します。
よくある混乱としては、キーが個人のパソコンやチャット履歴に散在し、退職時の引き継ぎで使用中のキーの数を誰も把握できない、といったことが挙げられます。また、月末の請求書では合計額しか分からず、どのプロジェクトや担当者がどれだけ使ったかを区別できないこともあります。あるモデルで突然エラーが発生したり、価格が上がったりすると、呼び出し先を直接書き込んだ箇所を一つずつ修正しなければなりません。これらは Agent の能力とは関係なく、モデル呼び出し層が一元管理されていないことが本質的な原因です。
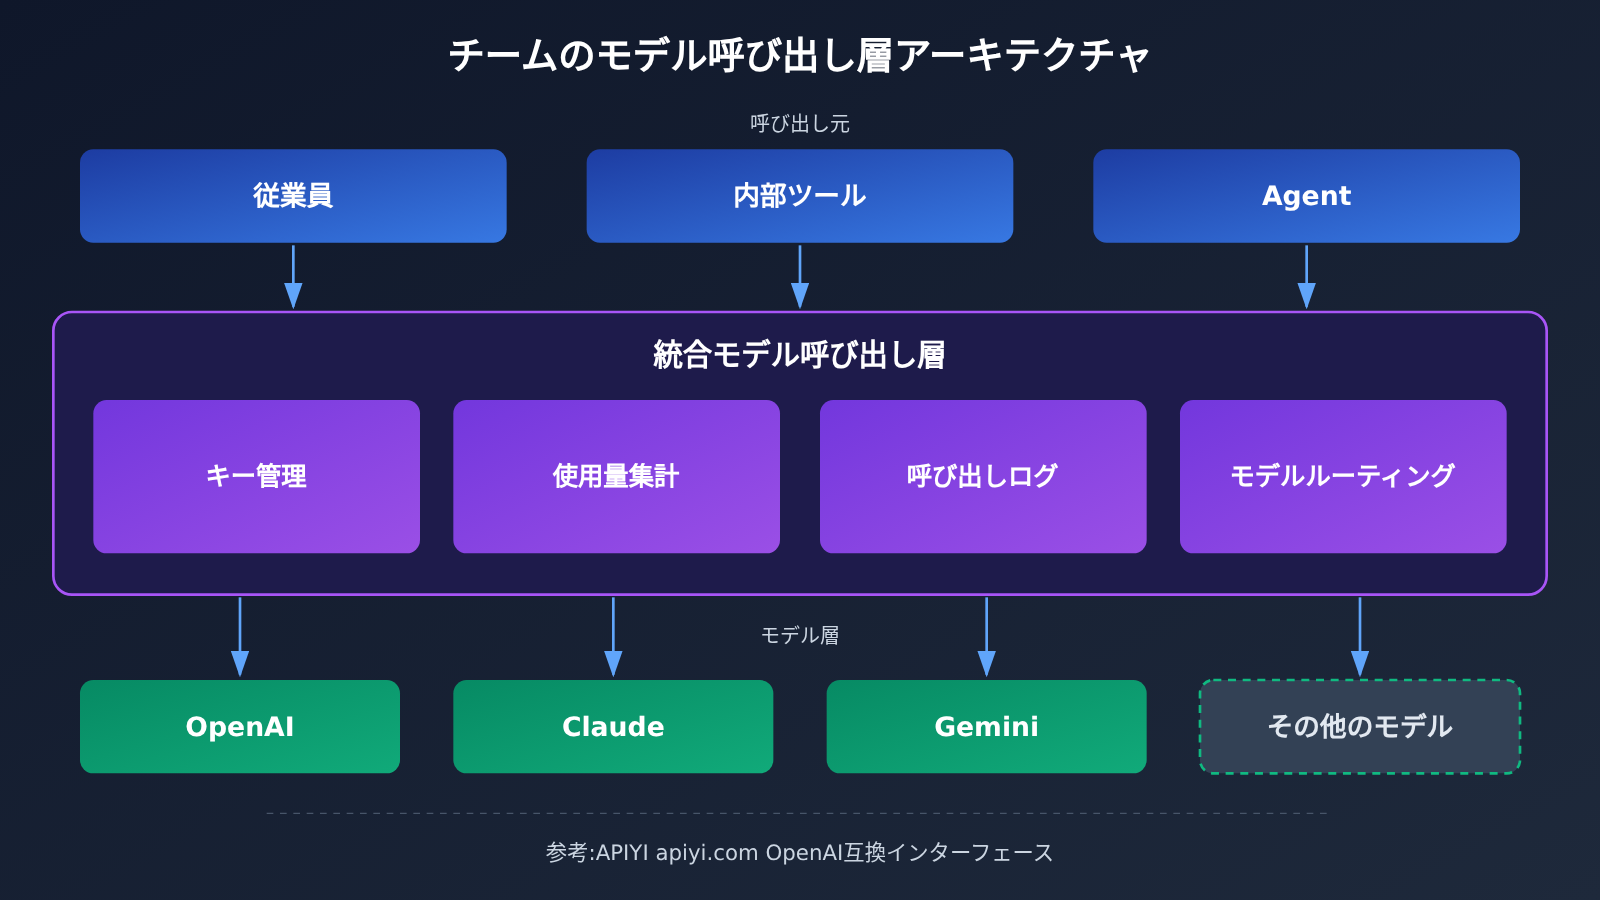
呼び出しを一つの層に集約することで、チーム全体に共通のルールを適用できるようになります。「まず適切に管理する」とは、最初から複雑な承認フローを作ることではありません。まずはすべての呼び出しが同じ窓口を通るようにすることで、その後の権限、使用量、コスト管理の土台が整います。
チームで AI を使う前に確認したい、モデル呼び出し層の 5 項目チェックリスト
このチェックリストは特定のベンダーに依存しません。自社構築のゲートウェイ、クラウドベンダーのサービス、第三者の集約プラットフォームなどの評価に活用できます。
| チェック項目 | 確認すべきこと | 最低限の対応 |
|---|---|---|
| 1. モデルの接続 | チームにはどのモデルが必要か?モデルの切り替えにどれだけのコード変更が必要か? | OpenAI 互換インターフェースに統一し、モデル名を設定項目にする |
| 2. キーと権限 | 誰がキーを持っているか?退職や漏えいの際、すぐに失効できるか? | プロジェクトやサービスごとにキーを発行し、個人のキーを本番コードに入れない |
| 3. コストの集計 | プロジェクトやチームごとにいくら使ったか? | 少なくともキーまたはプロジェクトごとに使用量を区別し、毎月の請求明細を出す |
| 4. 呼び出しの追跡 | 問題が起きたとき、どの呼び出しで、どのモデルが使われたかを特定できるか? | リクエスト時刻、モデル、トークン数、呼び出し元の識別子を記録する |
| 5. ノウハウの再利用 | 優れたプロンプトやワークフローを他の人がそのまま使えるか? | 検証済みのプロンプトやパラメータを共有テンプレートや社内サービスとして蓄積する |
チェック項目 1〜2:モデルの接続とキーの権限管理
モデル接続のポイントは「交換できること」です。モデルによって得意なタスクは異なり、価格や安定性も変わります。業務コードが互換インターフェースだけに依存し、モデル名を設定で管理していれば、モデルの切り替えは設定を変更するだけで済み、再開発は必要ありません。
キーの権限管理のポイントは「失効できること」です。チーム全体で強い権限を持つキーを共用するのではなく、サービスごとにキーを発行し、プロジェクトごとに利用枠を設定することをおすすめします。こうすれば、キーが漏えいしても影響範囲をそのサービスに限定でき、失効させても他の業務には影響しません。
チェック項目 3〜5:コストの集計、呼び出しの追跡、ノウハウの再利用
コストを集計できるかどうかは、AI への投資が事業部門に認められるかを左右します。請求総額しか見られなければ、どの用途で実際に価値が生まれているかを判断できず、経営層への予算申請も難しくなります。また、呼び出しの追跡は問題調査の前提です。ユーザーから「AI の回答が間違っている」と報告されたときに、その呼び出しでどのモデルが使われ、何が入力されたのかを確認できる必要があります。
ノウハウの再利用は、まさに蘇寧の事例に見られる考え方です。新製品発表の手順をテンプレートにまとめ、作業過程のファイルをナレッジベースに収めたことで、準備時間が 3 営業日から 4 時間に短縮されました。方法も保存されているため、次回はそのまま使えます。モデル呼び出し層では、検証済みのプロンプト、モデルの選択、パラメータの組み合わせを、個人の頭の中にとどめず、まとめて再利用できる形にすることを意味します。
チームでの AI の統一呼び出し例
以下は、OpenAI 互換インターフェースを通じてモデルを呼び出す最小限の例です。モデル名を環境変数から読み込むため、チーム全体で簡単に切り替えられます。
import os
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),      # プロジェクトごとに発行するキー
    base_url="https://api.apiyi.com/v1"          # APIYI の統一インターフェース
)

resp = client.chat.completions.create(
    model=os.getenv("DEFAULT_MODEL", "gpt-4o-mini"),
    messages=[{"role": "user", "content": "总结本周项目进展"}]
)
print(resp.choices[0].message.content)
呼び出し記録を残すチーム向けラッパーの例を見る
import os
import time
import json
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),
    base_url="https://api.apiyi.com/v1"  # 1つのキーで複数社のモデルを呼び出す
)

def team_chat(prompt: str, project: str, caller: str,
              model: str = None, max_tokens: int = 1000) -> str:
    """チーム共通の呼び出し窓口:プロジェクト、呼び出し元、モデル、Token 使用量を記録する"""
    model = model or os.getenv("DEFAULT_MODEL", "gpt-4o-mini")
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    usage = resp.usage
    record = {
        "ts": int(start),
        "project": project,
        "caller": caller,
        "model": model,
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "latency_ms": int((time.time() - start) * 1000),
    }
    # ローカルログに書き込み、後でレポートに取り込んでプロジェクト別にコストを集計する
    with open("ai_usage.log", "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.choices[0].message.content

print(team_chat("生成一份周报大纲", project="marketing", caller="alice"))
このラッパーは、アプリケーション側で「プロジェクト」と「呼び出し元」の2つの情報を記録します。プラットフォーム側で使用量の統計が提供されていても、アプリケーション側で独自の呼び出し記録を残すことには価値があります。どの業務シーンで行われた呼び出しかを把握できるのは、自分たちのシステムだけだからです。
🚀 クイックスタート:チームがまだ「一人ひとりが別のキーを使う」段階にあるなら、まずは APIYI apiyi.com を通じて、1つの APIキーで OpenAI、Claude、Gemini などの主要モデルに統一的にアクセスできます。プラットフォームは OpenAI 互換インターフェースと従量課金制を採用しており、新規ユーザーには無料のテスト枠があるため、統一的な呼び出し窓口をまず試してみるのに適しています。
統一されたモデル呼び出し層で解決できること、できないこと
統一ゲートウェイを「AIガバナンスのすべてを解決するもの」と捉えがちですが、実際にカバーするのはモデル呼び出しの層だけです。次の表で、その境界を整理します。
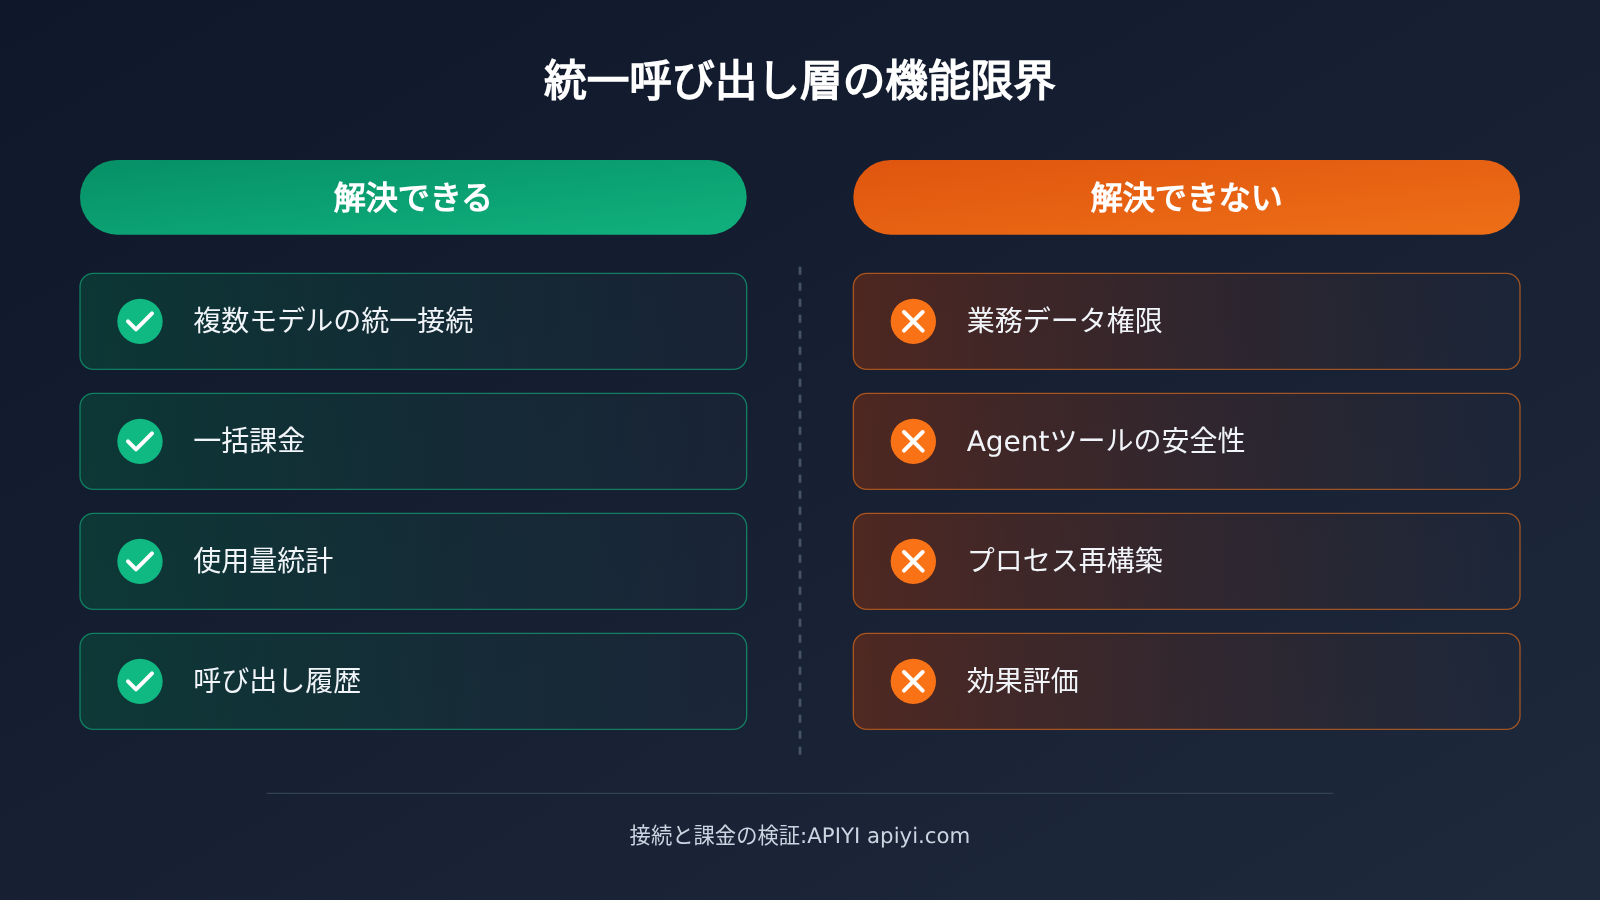
| 項目 | 統一された呼び出し層でできること | 別途対応が必要なこと |
|---|---|---|
| モデルへの接続 | 1つのインターフェースで複数社のモデルを呼び出せ、切り替えの負担も小さい | どのモデルがどの業務に適しているか判断する |
| コスト | 残高を一元管理し、従量課金によって費用を集計しやすくする | コストを業務成果と結び付け、ROIを評価する |
| 権限 | 「誰がモデルを呼び出せるか」を管理する | 「Agentがどのデータを読み、どの操作を実行できるか」を管理する |
| 追跡 | 呼び出し時のモデル、Token、時刻を記録する | Agentの実行経路全体と結果の品質を追跡する |
| 再利用 | 安定した呼び出し窓口を提供する | プロンプト、プロセステンプレート、ナレッジベースを蓄積する |
これを見ると、Tencentがカンファレンスでセキュリティソリューション、可観測性センター、Agent Runtime、ナレッジ関連製品を同時に発表した理由もわかります。報道によると、Agentは自律的にツールを呼び出し、データにアクセスし、コードを実行することもできます。そのため、操作範囲の制限や機密情報の保護、問題発生時の原因追跡が重要です。これらはAgentの実行層とデータ層の課題であり、モデルゲートウェイでは管理できません。
したがって、合理的な順序は、まずモデル呼び出し層を統一してアクセスと費用を可視化し、その上にデータ権限の管理、Agentの安全対策、プロセスの改善を重ねることです。土台が見えていなければ、その上のガバナンスも始められません。
チームでのAI活用がもたらす影響
技術責任者への影響
- アーキテクチャに統一された接続口を設ける:新しいプロジェクトで大規模言語モデルを導入する際は、特定の公式エンドポイントを直接ハードコードせず、チームで定めた互換インターフェースを経由します。
- APIキー管理を運用業務に組み込む:APIキーはデータベースのパスワードと同様に管理し、発行・ローテーション・失効の記録を残します。
- ログの項目を事前に設計する:少なくともプロジェクト、呼び出し元、モデル、Token使用量を関連付けられるようにしておきます。そうしないと、月末の照合作業で後から対応するのが難しくなります。
事業責任者・調達担当者への影響
チームでAI機能を調達する際の評価軸は、「どのモデルが最も優れているか」から「きちんと管理できるか」へと移ります。以下の表は、導入計画の参考として、チームの段階ごとに重視すべき点をまとめたものです。
| チームの段階 | 典型的な状況 | モデル呼び出し層の優先事項 |
|---|---|---|
| 個人での検証 | 少数のメンバーが自費で試用し、それぞれがキーを保有 | 統一インターフェースを選び、分散したアカウントを集約する |
| 小規模チームでの試験導入 | 1〜2件のプロジェクトでAIへの依存が始まる | プロジェクトごとにキーを発行し、基本的な使用量を集計する |
| 部門内への展開 | 複数の事業部門が同時に利用する | コストをプロジェクトごとに集計し、呼び出し記録を検索できるようにする |
| 組織全体での活用 | Agentが中核的な業務プロセスに組み込まれる | データへのアクセス権限、Agentのセキュリティ、効果測定を加える |
調達担当者は、支払いと請求書・領収書の処理が自社の財務要件に合っているかも確認する必要があります。また、プラットフォームの権限設定の細かさ、ログの項目、保存期間、エクスポート方法にも注意が必要です。これらの詳細はプラットフォームによって大きく異なるため、契約前にサービス提供元へ一つひとつ確認し、正式なドキュメントを基準に判断することをおすすめします。
業界への影響
カンファレンスでBuddy Oneが共有Creditプールと集中管理を提案したことは、「モデルの利用枠をチームの共有リソースとして一元的に割り当てる」という考え方が、企業向けAI製品の標準になりつつあることを示しています。大手企業の製品スイートでも独立系のモデル集約プラットフォームでも、使用量の可視化やコストの集計は、付加価値ではなく、企業顧客の基本要件になっていくと考えられます。
💡 選定のポイント:本格展開の前に、実際の業務データを使って小規模な試験導入を行うことをおすすめします。APIYI apiyi.com では複数社のモデルを呼び出せるため、同じタスクにおける各モデルの結果とToken消費量を比較してから、チームの標準モデルを決められます。
よくある質問 FAQ
Q1:チームで AI を使う際の「モデル呼び出し層のガバナンス」とは何ですか?
チームが大規模言語モデルにアクセスする方法を一元管理することです。使用するモデル、キーの管理者、プロジェクトごとの使用量、各呼び出しの追跡可能性などを管理します。Agent の業務ロジックは担当せず、すべての呼び出しを管理可能な窓口に集約する役割を担います。
Q2:統一モデル呼び出し層と企業向け Agent プラットフォームの違いは何ですか?
企業向け Agent プラットフォームは、Agent が業務システムに接続し、データにアクセスし、連携して長時間動作するための仕組みを扱います。一方、モデル呼び出し層が扱うのは「モデルを呼び出す」という部分だけです。前者のほうが対象範囲は広いものの、その動作は下位にあるモデルアクセスの安定性と管理可能性に依存します。両者は上下のレイヤーに位置するもので、互いに代替するものではありません。
Q3:小規模なチームでも、今から取り組む必要はありますか?
はい。ただし、まずは簡易的な仕組みで十分です。小規模チームが最初に取り組みたいのは、呼び出しインターフェースを統一することと、個人のキーを本番コードに含めないことです。この2つは低コストで実施できますが、チームが拡大してから対応しようとすると、はるかに手間がかかります。
Q4:チーム共通のモデル呼び出し窓口を素早く構築するにはどうすればよいですか?
手軽な方法の一つは、OpenAI 互換の集約プラットフォームを利用することです。例えば、APIYI apiyi.com に登録して APIキーを取得し、コード内の base_url を `https://api.apiyi.com/v1` に置き換えると、同じコードで OpenAI、Claude、Gemini などのモデルを呼び出せます。さらに、本文で紹介したラッパー関数と組み合わせれば、プロジェクトごとの使用量を記録できます。
Q5:集約プラットフォームは、チームの権限管理システムをそのまま代替できますか?
完全には代替できません。プラットフォームはモデルへのアクセスや課金を管理できますが、メンバー単位・プロジェクト単位の権限の細かさ、利用上限、ログの保持ポリシーはプラットフォームによって異なるため、各プラットフォームのドキュメントを確認してください。業務データのアクセス権限や Agent の操作権限は、企業自身のシステムで管理する必要があります。具体的な機能は、APIYI apiyi.com のドキュメントセンターで確認したうえで計画を立てましょう。
チームで使うAIモデル呼び出し層の要点 Key Takeaways
- 個人の生産性向上が、そのまま組織の強化につながるわけではありません:チームでモデルを共用すると、モデルの性能より先に管理上の課題が表面化します。
- まずは接続先を統一し、それからガバナンスを考えます:すべての呼び出しを同じ層に集約することで、権限やコストのルールを適用できます。
- キーはプロジェクトごとに発行します:サービスごとにKeyを分ければ、漏えいや退職の際にすばやく無効化できます。
- コストをプロジェクトごとに集計できるようにします:アプリ側でプロジェクトと呼び出し元の情報を記録することで、月末に利用状況を照合できます。
- ゲートウェイには役割の限界があります:データのアクセス権限、Agentのセキュリティ、業務プロセスの改善は、別の仕組みで対応する必要があります。
- 低コストで始められます:APIYI apiyi.com を利用すれば、1つのKeyで複数のモデルに統一的にアクセスし、まずは試験導入を進められます。
まとめ
Tencentのカンファレンスで行われた企業向けAgentについての議論では、特定のAgentの性能よりも、組織がそれらの能力をどう活用できる体制を整えるかが重視されていました。チームへのAI導入を進める責任者にとって、モデル呼び出し層は、最初に取り組みやすい一方で、見落とされやすい領域でもあります。
- モデルを入れ替えられるようにします:互換性のあるインターフェースに統一し、モデル名は設定で変更できるようにします。
- 権限とコストを可視化します:プロジェクトごとにキーを発行し、利用量を集計することで、コストが不透明になるのを防ぎます。
- 経験を再利用できるようにします:検証済みのプロンプトやワークフローをチームの資産として蓄積します。
一時的な熱が落ち着いても、このチェックリストは、どのような規模のチームでAIを導入する際にも役立ちます。まずは1〜2つの業務シナリオを選んで試験導入し、呼び出し先の統一と利用量の記録を軌道に乗せてから、徐々に対象を広げるのがおすすめです。APIYI apiyi.com を使えば、複数モデルへの統一的なアクセスをすばやく検証できます。無料のテスト枠と従量課金方式が用意されています。
📚 参考資料
- 极客公园 – 一个人用得好 AI,为什么一家公司却用不好?:Tencentのグローバルデジタルエコシステム大会における企業向けAgent関連発表のレポート
- リンク:
geekpark.net/news/373541 -
内容: WorkBuddy企業版のアップグレード、Buddy One、蘇寧の事例、Agent Runtimeなどを紹介
-
OpenAI APIドキュメント:Chat Completionsインターフェースとusageフィールドの解説
- リンク:
platform.openai.com/docs - 内容: 互換インターフェースのリクエスト構造とTokenの集計方法を理解するための資料
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI公式サイト apiyi.com のトップページからお気軽にお問い合わせください。接続に関する詳しい資料は、ドキュメントセンター docs.apiyi.com でもご覧いただけます。


