
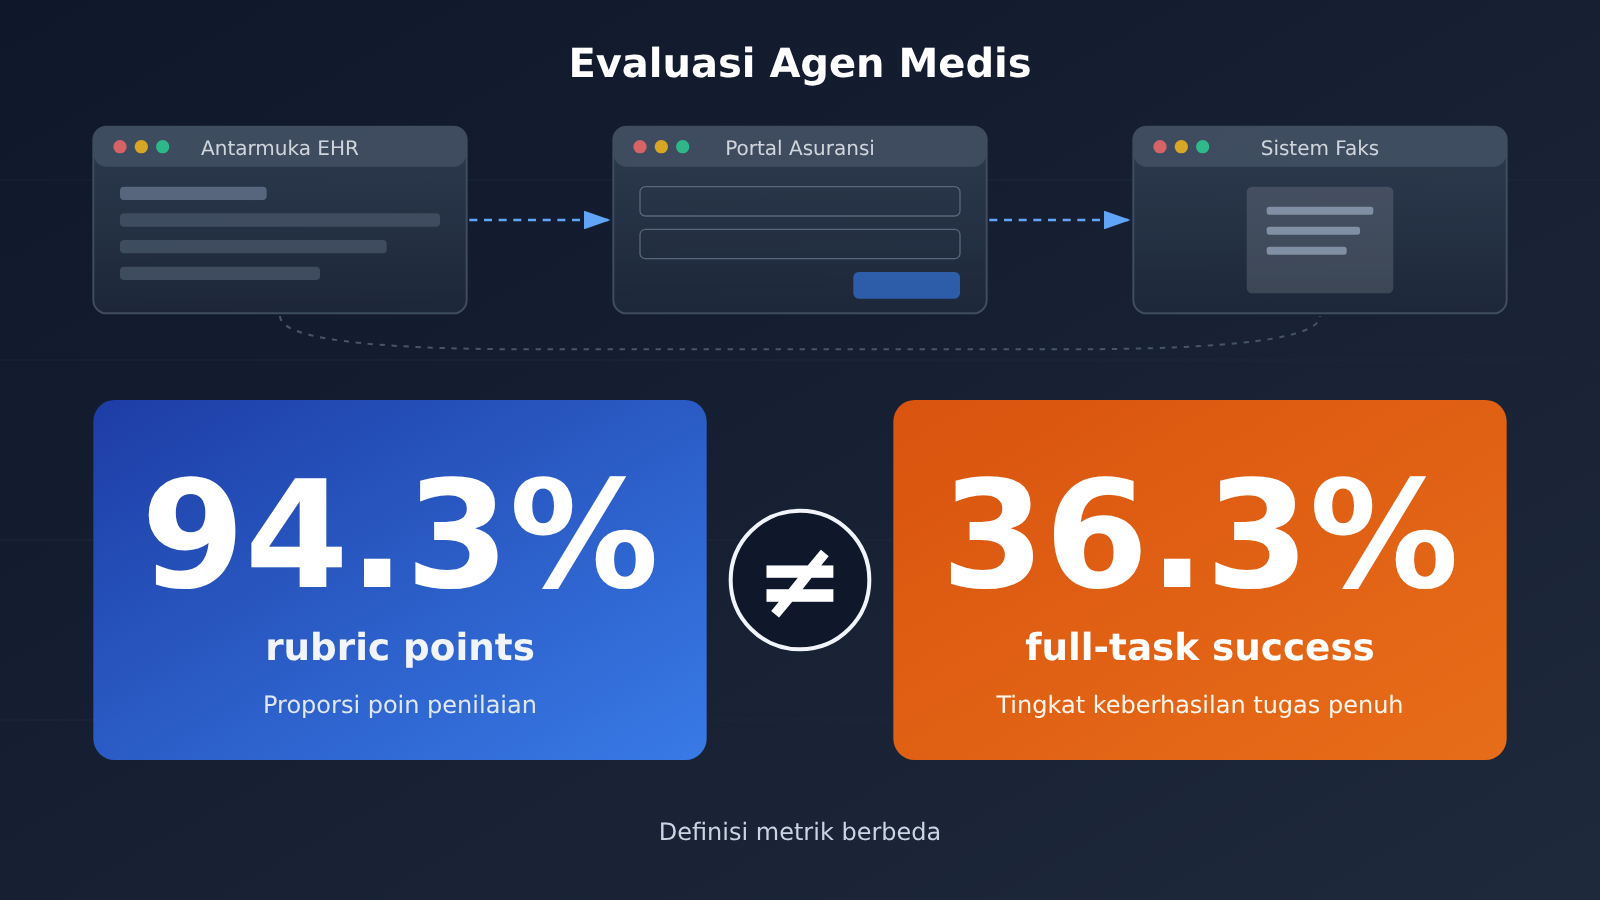
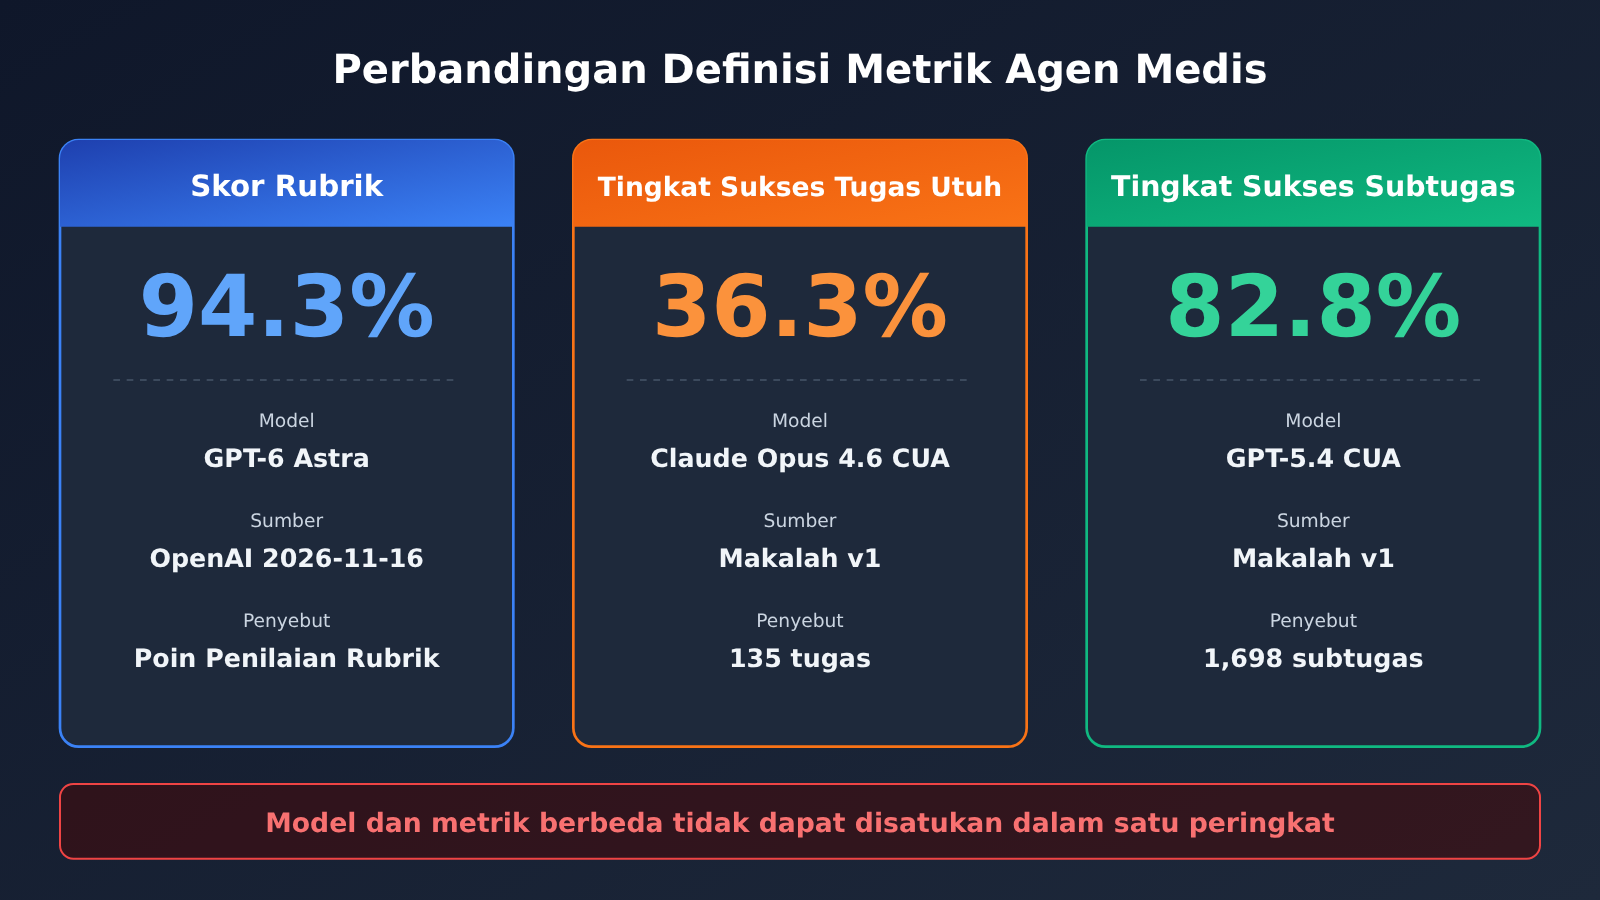
94.3% bukan berarti 94.3% tugas administrasi medis sudah diselesaikan secara utuh. Angka 94.3% untuk GPT-6 Astra yang diumumkan OpenAI pada 16 November 2026 adalah proporsi skor poin rubrik (rubric points) pada HealthAdminBench; sedangkan 36.3% untuk Claude Opus 4.6 CUA dalam makalah Shah Lab Stanford adalah tingkat keberhasilan tugas penuh (full-task success). Yang pertama mengukur “berapa banyak poin penilaian yang terpenuhi”, yang kedua mengukur “berapa banyak tugas yang seluruh kondisi keberhasilannya terpenuhi”. Keduanya bukan metrik yang sama dan tidak dapat dimasukkan ke dalam satu papan peringkat yang sama.
Agent medis bisa tampil baik pada operasi tunggal seperti pencarian informasi, pemrosesan dokumen, dan pengisian formulir, tetapi tetap belum bisa secara stabil menyelesaikan satu alur proses bisnis lintas sistem. Untuk menilai apakah sebuah Agent memiliki nilai produksi, kita perlu melihat performa subtugas, tingkat keberhasilan end-to-end, jenis kesalahan, biaya eksekusi, dan keterlibatan manusia secara bersamaan; satu skor saja tidak cukup.
Apa yang bisa Anda pahami setelah membaca artikel ini?
- Apa yang masing-masing diukur oleh 94.3% dan 36.3%, dan mengapa keduanya tidak bisa dibandingkan secara langsung
- Komposisi tugas HealthAdminBench, sumber poin rubrik, dan dua mekanisme validasi
- Seperangkat dimensi evaluasi yang berorientasi produksi dan dapat diterapkan ke Agent perusahaan lain
Daftar Isi: Bagian fakta objektif menjelaskan secara berurutan mengapa skor 94.3% menarik perhatian, apa yang sebenarnya diukur HealthAdminBench, perbedaan antara keberhasilan subtugas dan keberhasilan tugas penuh, di tahap mana Agent medis paling mudah gagal, dan mengapa model yang sama dapat tampil berbeda karena kerangka eksekusi yang berbeda; bagian analisis dan penilaian membahas cara membangun kerangka evaluasi terpadu, cara menghitung biaya, serta bagaimana perusahaan harus memilih dan mengambil keputusan dalam penerapannya.
Perlu Diketahui: Memahami 7 Konsep dalam Evaluasi Agent Medis
| Konsep | Penjelasan singkat |
|---|---|
| Computer Use | Kemampuan menyelesaikan tugas dengan mengamati antarmuka perangkat lunak dan mensimulasikan operasi seperti klik, input, dan gulir |
| EHR | Sistem rekam kesehatan elektronik, perangkat lunak inti rumah sakit untuk menyimpan informasi diagnosis dan perawatan pasien |
| MCP | Protokol standar untuk menemukan dan memanggil alat eksternal |
| RPA | Cara otomatisasi untuk menjalankan proses berulang melalui aturan atau skrip yang telah dikonfigurasi sebelumnya |
| Rubric points | Poin penilaian yang diperoleh berdasarkan aturan evaluasi, digunakan untuk mengukur tingkat pemenuhan sebagian persyaratan |
| Tingkat keberhasilan end-to-end | Proporsi tugas lengkap yang memenuhi semua kondisi keberhasilan; jika satu kondisi kunci gagal, maka dinilai gagal |
| Trace | Bukti jejak yang merekam proses eksekusi, tindakan operasi, dan status antarmuka |
Sekilas Dampak Evaluasi Agent Medis
- Pengembang dan penanggung jawab teknis: Jangan hanya mengutip satu skor yang diumumkan vendor untuk memilih solusi. Anda perlu memverifikasi mekanisme eksekusi, tingkat penyelesaian end-to-end, dan biaya total—termasuk tangkapan layar, percobaan ulang, serta lingkungan runtime—sesuai tugas Anda sendiri.
- Institusi medis dan penanggung jawab alur kerja: Anda perlu membedakan empat jenis bukti: demo di lingkungan sintetis, evaluasi benchmark, uji coba institusi, dan studi kasus produksi. Saat penerapan, terapkan persetujuan manusia, hak akses minimum, dan audit operasi.
Fakta objektif: evaluasi agen medis di balik 94.3% dan 36.3%
Mengapa skor 94.3% menarik perhatian?
Pada 16 November 2026, OpenAI merilis perkembangan agen operasi komputer untuk tim medis dan mengungkap beberapa kumpulan data evaluasi. Di antaranya, GPT-6 Astra memperoleh skor 94.3% pada HealthAdminBench, sedangkan GPT-6 Luna memperoleh 91.8%; keduanya dievaluasi pada tingkat upaya penalaran maksimum (maximum reasoning effort). OpenAI juga mengumumkan bahwa biaya per tugas Luna adalah $0.085, yaitu 98% lebih rendah daripada Astra.
Angka-angka ini menarik perhatian karena hasil HealthAdminBench yang sebelumnya dipublikasikan Stanford jelas lebih rendah. Perlu ditekankan bahwa 94.3% dan 91.8% yang diumumkan OpenAI adalah proporsi skor poin rubrik, bukan tingkat keberhasilan tugas penuh yang independen. Dua kelompok data lain dalam pengumuman yang sama juga berasal dari tahap evaluasi berbeda, dengan penyebut yang berbeda pula:
| Indikator | Nilai | Penyebut/dasar pengukuran | Bukan berarti |
|---|---|---|---|
| Skor HealthAdminBench (Astra) | 94.3% | Proporsi poin rubrik | Tingkat keberhasilan tugas penuh |
| Skor HealthAdminBench (Luna) | 91.8% | Proporsi poin rubrik | Tingkat keberhasilan tugas penuh |
| Keamanan tugas klinis (Astra) | 99% | 325 tugas yang telah ditinjau | Akurasi diagnosis medis |
| Proporsi dokter yang sangat menyetujui (Astra) | 93% | 646 penilaian dokter | Tingkat keberhasilan tugas; juga bukan berarti 646 dokter |
| Biaya per tugas Luna | $0.085 | Biaya per tugas dalam kondisi evaluasi tertentu | Harga penawaran untuk deployment produksi |
Ketiga kumpulan data ini memiliki penyebut berbeda dan tidak dapat digabungkan menjadi satu “akurasi komprehensif”. Selain itu, teks pengumuman OpenAI tidak memublikasikan hasil per tugas, konfigurasi eksperimen lengkap, interval kepercayaan, dan seluruh kasus kegagalan; pihak luar saat ini tidak dapat memverifikasi secara independen komposisi skor 94.3%. Biaya per tugas Astra sekitar $4.25, yaitu nilai perkiraan yang dihitung mundur dari penurunan 98%, bukan harga yang diumumkan langsung secara resmi.
Apa sebenarnya yang diukur oleh HealthAdminBench?
HealthAdminBench diajukan oleh Shah Lab di Universitas Stanford dan secara khusus mengevaluasi performa Agent pengoperasian komputer dalam tugas administrasi medis. Versi publiknya mengalami perubahan dari waktu ke waktu: halaman riset awal menjelaskan 70 tugas, 947 titik penilaian, dan 6 Agent; sedangkan versi makalah 2604.09937v1 diperluas menjadi 135 tugas, 1.698 subtugas yang dapat diverifikasi, dan 7 konfigurasi model. Artikel ini mengacu pada versi makalah, sedangkan data dari halaman web awal hanya digunakan sebagai pembanding historis.
Empat lingkungan GUI simulasi dalam versi makalah adalah EHR, Portal Pembayaran Asuransi A, Portal Pembayaran Asuransi B, dan Portal Faksimili. Sebanyak 135 tugas dibagi ke dalam tiga jenis alur kerja administrasi:
| Jenis Tugas | Jumlah | Isi Utama |
|---|---|---|
| Prior Authorization (pre-autorisasi) | 60 | Verifikasi kelayakan asuransi, mengumpulkan riwayat medis, mengajukan permohonan pre-autorisasi |
| Appeals and Denials Management (banding dan penolakan klaim) | 60 | Meninjau penolakan klaim, mengumpulkan bukti, menyiapkan dan mengajukan banding |
| DME Order Processing (pesanan peralatan medis) | 15 | Mengumpulkan data peralatan medis, mengirimkan pesanan, mencatat hasil |
1.698 titik penilaian dihasilkan melalui dua mekanisme. Sebanyak 1.177 titik menggunakan pemeriksaan deterministik, dengan memanfaatkan pendekatan terstruktur seperti JMESPath untuk memeriksa status sistem, misalnya apakah pasien yang benar ditemukan, apakah kolom yang ditentukan telah diisi, dan apakah pesanan yang benar telah dibuat; pendekatannya mirip dengan pengujian perangkat lunak tradisional. Sebanyak 521 titik lainnya diserahkan kepada LLM Judge, yang terutama menilai apakah isi dokumen sudah memadai, apakah materi yang diajukan sesuai persyaratan, dan bagian-bagian lain yang sulit diverifikasi langsung dengan aturan.
Semua tugas menggunakan data pasien sintetis, bukan catatan pasien asli. Artinya, benchmark ini menyediakan lingkungan pengujian yang dapat direproduksi, bukan pengujian di sistem produksi rumah sakit sungguhan, dan juga tidak mengukur hasil perawatan pasien secara langsung.
Apa perbedaan antara keberhasilan subtugas dan keberhasilan tugas lengkap?
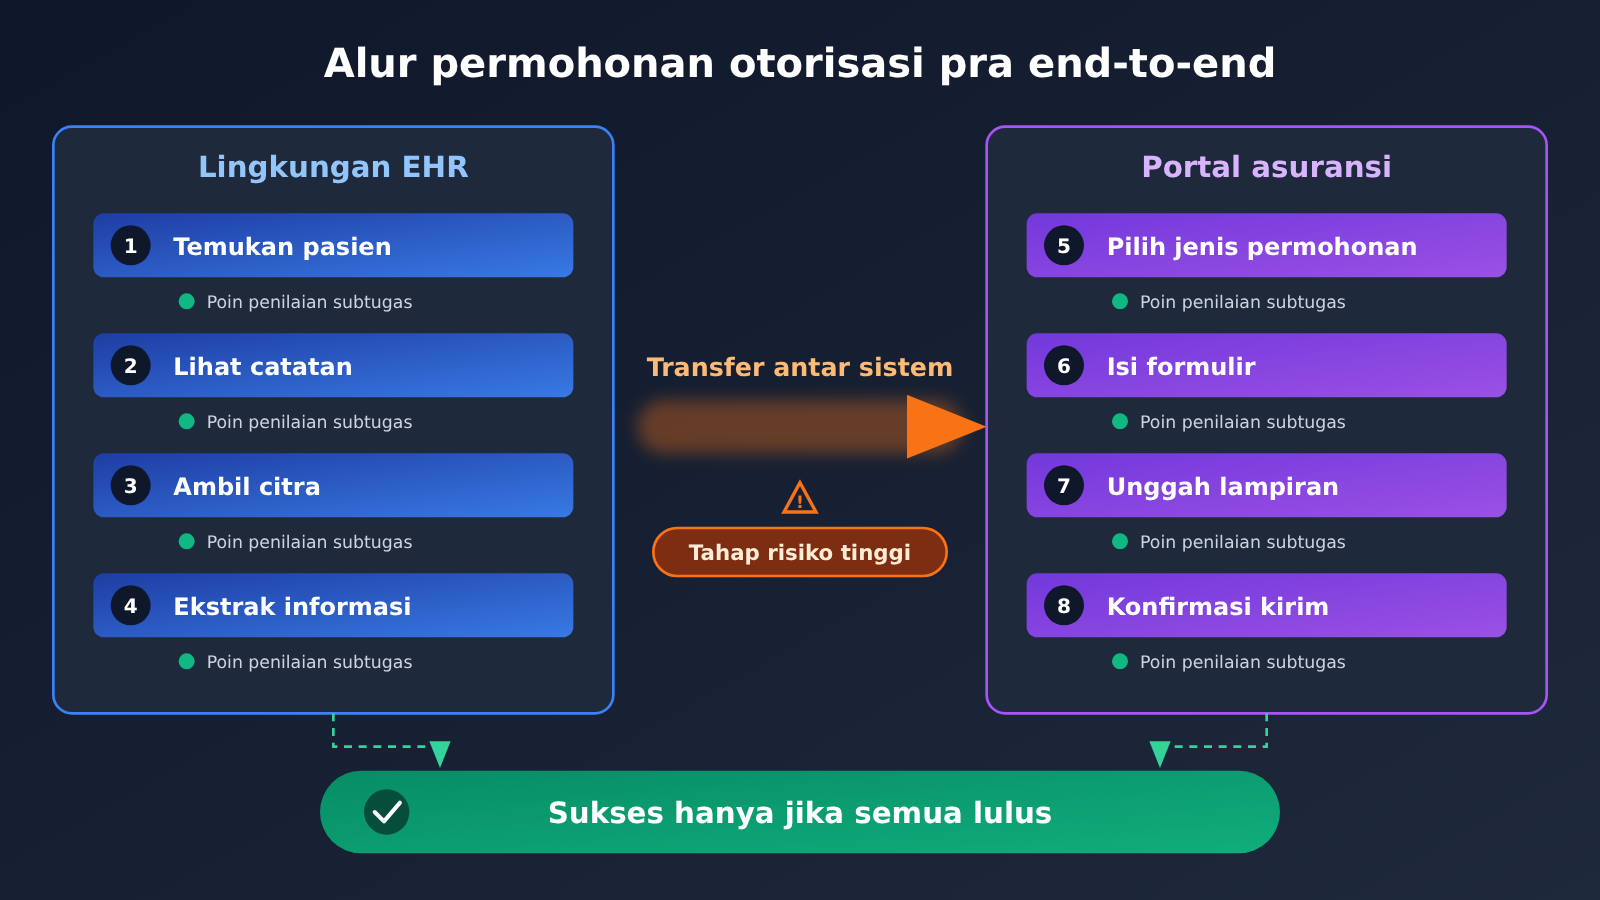
Cara termudah untuk melihat perbedaan keduanya adalah melalui satu alur permintaan otorisasi pra-persetujuan. Menurut deskripsi dalam materi penelitian, sebuah tugas otorisasi pra-persetujuan mungkin mengharuskan Agent untuk menyelesaikan secara berurutan:
- Menemukan pasien yang benar di EHR
- Melihat catatan medis pasien
- Menemukan bahan pemeriksaan pencitraan dan pengobatan sebelumnya
- Menentukan bukti apa yang dibutuhkan untuk klaim asuransi
- Mengekstrak informasi yang diperlukan dari rekam medis
- Masuk ke portal pembayaran asuransi
- Memilih jenis permohonan yang benar
- Mengisi formulir permohonan
- Melampirkan dokumen yang diperlukan
- Mengirimkan permohonan dan mengonfirmasi status
Kesepuluh langkah ini memiliki ketergantungan yang kuat satu sama lain. Jika langkah 1 salah memilih pasien, seberapa pun rapi langkah-langkah berikutnya dilakukan, semuanya tetap salah; jika sembilan langkah pertama semuanya benar, tetapi langkah 9 melewatkan lampiran atau langkah 10 tidak benar-benar mengirimkan, seluruh tugas tetap dinilai gagal. Tingkat keberhasilan subtugas mengukur “berapa banyak dari sepuluh langkah yang dilakukan dengan benar”, sedangkan tingkat keberhasilan tugas lengkap mengukur “apakah kesepuluh langkah semuanya dilakukan dengan benar”.
Data yang diberikan dalam makalah dengan jelas mencerminkan kesenjangan ini: tingkat keberhasilan subtugas GPT-5.4 CUA adalah 82,8%, sedangkan tingkat keberhasilan tugas lengkap Claude Opus 4.6 CUA adalah 36,3%. Kedua angka ini berasal dari model yang berbeda, jadi juga tidak dapat dibandingkan secara langsung, tetapi keduanya bersama-sama menunjukkan satu fakta: menyelesaikan tindakan lokal dan menyelesaikan seluruh proses bisnis adalah dua kemampuan yang berbeda.
Halaman penelitian awal juga melaporkan kesenjangan serupa: tingkat keberhasilan tugas lengkap terbaik Claude Opus 4.5 adalah 22,9%, sedangkan tingkat keberhasilan subtugas Gemini 3 adalah 76,4%. Karena skala tugas dan versinya berbeda, angka-angka ini hanya dapat digunakan untuk mengamati tren, dan tidak dapat dimasukkan ke dalam peringkat yang sama dengan versi makalah atau hasil OpenAI.
Di tahap mana Agent medis paling sering gagal?
Makalah mempublikasikan skor dua konfigurasi CUA berdasarkan kategori subtugas:
| Kategori subtugas | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| Pengambilan informasi | 96,5% | 96,1% |
| Penyusunan dokumen | 74,3% | 84,4% |
| Pengisian formulir | 88,9% | 84,9% |
| Penyelesaian tugas | 70,7% | 66,2% |
| Pemrosesan dokumen | 92,3% | 94,3% |
| Penalaran klinis | 61,3% | 77,0% |
Perlu catatan khusus: angka 94,3% milik GPT-5.4 CUA pada pemrosesan dokumen dalam tabel hanyalah kebetulan numerik dengan total rubric points 94,3% milik GPT-6 Astra yang diumumkan OpenAI; model, metrik, dan sumber keduanya sepenuhnya berbeda.
Dilihat dari rincian per kategori, pengambilan informasi sudah mendekati titik jenuh, sementara penalaran klinis, penyelesaian tugas, dan penyusunan dokumen relatif lebih lemah. Makalah juga menunjukkan bahwa Pemrosesan Dokumen (Document Handling) dan Transfer Data Antar-Sistem (Cross-system Data Transfer) adalah masalah utama yang menyebabkan kegagalan end-to-end. Versi web awal pernah melaporkan bahwa lima dari enam model memiliki akurasi di bawah 20% pada subtugas pemrosesan dokumen, tetapi itu termasuk pengaturan tugas versi yang berbeda sehingga tidak dapat dibandingkan langsung dengan tabel di atas.
Mengapa transfer antar-sistem begitu rentan terhadap kesalahan? Dalam alur otorisasi pra-persetujuan, informasi yang sama harus dibaca dari EHR, disimpan dalam konteks Agent, lalu ditulis ke struktur formulir lain di portal asuransi, dan lampirannya pun bisa melewati portal faks. Setiap perpindahan adalah peluang terjadinya kesalahan, dan satu kesalahan di hulu akan disalin apa adanya ke sistem hilir. Risiko yang tercantum dalam materi OpenAI juga mencakup “menyebarkan informasi yang salah dari satu sistem ke sistem lain” dan “melaporkan penyelesaian tugas secara keliru ketika status sistem tidak jelas”.
Mengapa model yang sama bisa berperilaku berbeda karena kerangka eksekusi yang berbeda?
Makalah ini melakukan eksperimen ablasi terhadap metode pemberian petunjuk dan mode observasi, dengan tiga temuan utama:
- Memberikan Portal Guidance (panduan operasi portal) biasanya berkinerja lebih baik daripada hanya memberikan deskripsi tugas
- Cara observasi Accessibility Tree (pohon struktur aksesibilitas) biasanya lebih unggul daripada observasi berbasis tangkapan layar saja
- Ketika panduan operasi portal dipadukan dengan informasi halaman terstruktur, kinerja end-to-end biasanya lebih baik
Makalah juga menunjukkan bahwa lingkungan produksi nyata belum tentu dapat menyediakan Accessibility Tree secara lengkap. Dengan kata lain, performa Agent tidak hanya bergantung pada model dasar, tetapi juga pada kerangka eksekusi (Harness), cara observasi halaman, petunjuk, dan deskripsi tugas.
Dokumentasi pengembang OpenAI juga mencerminkan perbedaan jalur eksekusi. Panduan resmi menjelaskan ComputerToolset, BrowserToolset, dan pintu masuk browser terkelola secara terpisah; untuk GPT-6 Astra, dokumentasi saat ini merekomendasikan metode Code Execution, yaitu model menghasilkan kode seperti Playwright untuk mengoperasikan antarmuka, sementara Computer Tool tetap menjadi opsi. Dokumentasi juga menekankan bahwa model menghasilkan instruksi operasi bukan berarti operasi tersebut sudah berhasil; aplikasi harus mengeksekusinya terlebih dahulu, lalu memverifikasi hasilnya melalui tangkapan layar baru atau cara lain.
CUA Agent Kit (Apache-2.0) yang open source dari CVS Health menawarkan pendekatan rekayasa lain. Mekanisme yang diungkapkan dalam README-nya adalah: pertama, Computer-use Agent menjelajahi alur kerja dan menyimpan tangkapan layar, aksi, dan Trace sebagai bukti; kemudian Codex Skill mengubah lintasan yang berhasil menjadi kode deterministik, dan kode tersebut ditinjau oleh engineer; eksekusi deterministik berikutnya tidak memerlukan kunci model. Ini memisahkan “menemukan cara melakukannya” dan “melakukannya secara stabil dan berulang” menjadi dua masalah.
Analisis dan Penilaian: Bagaimana Menilai Agent Medis yang Benar-Benar Layak Pakai
Bagaimana menilai Agent yang benar-benar layak pakai?
Berikut adalah penilaian dalam artikel ini, bukan standar resmi lembaga mana pun. Kami berpendapat bahwa skor poin rubrik seperti 94,3% cocok untuk menjawab “seberapa besar kemajuan kemampuan lokal model”, tetapi tidak cukup untuk menjawab “apakah bisa dimasukkan ke dalam alur produksi”. Pertanyaan terakhir memerlukan sekumpulan metrik yang saling membatasi:
| Dimensi evaluasi | Apa yang diukur | Mengapa diperlukan | Sumber data |
|---|---|---|---|
| Tingkat keberhasilan end-to-end | Proporsi tugas lengkap yang memenuhi semua kondisi keberhasilan | Bisnis hanya melihat hasil akhir | Validasi status akhir sistem |
| Akurasi langkah kritis | Tingkat kebenaran node kritis seperti memilih pasien, mengirim, mengunggah lampiran | Satu kesalahan pada langkah kritis membuat semuanya salah | Pemeriksaan deterministik |
| Tingkat keparahan kesalahan | Apakah kegagalan berupa kelalaian yang dapat dipulihkan, atau salah menulis data, salah mengirim pesan | Tingkat kegagalan yang sama bisa memiliki risiko yang sangat berbeda | Tinjauan manual + label tingkat |
| Tingkat intervensi manusia | Proporsi yang memerlukan pengambilalihan manual atau koreksi persetujuan | Menentukan penghematan tenaga kerja aktual | Log persetujuan |
| Waktu eksekusi | Waktu per tugas dan waktu ekor panjang | Memengaruhi throughput dan antrean | Stempel waktu Trace |
| Biaya lengkap per tugas | Total biaya model, tangkapan layar, percobaan ulang, lingkungan runtime, dan pemeliharaan | Harga satuan token tidak dapat mewakili biaya sebenarnya | Tagihan + catatan operasional |
| Kemampuan pemulihan dari anomali | Apakah dapat berhenti atau mundur saat menghadapi ambiguitas, timeout, perubahan halaman | Skenario medis harus “tahu kapan harus berhenti” | Uji injeksi kegagalan |
Inti dari kerangka ini adalah melaporkan secara terpisah “berapa banyak langkah yang dilakukan dengan benar” dan “berapa banyak hal yang berhasil diselesaikan”, lalu mengoreksi keduanya dengan tingkat keparahan kesalahan dan tingkat intervensi manusia. Solusi yang ditampilkan Ambience justru mencerminkan dimensi “pemulihan dari anomali”: ketika catatan medis ambigu, Agent berhenti dan bertanya kepada dokter, serta baru mengajukan permohonan otorisasi awal setelah dokter menyetujuinya. Ini hanya skema tata kelola yang ditampilkan perusahaan tersebut, bukan berarti semua Agent medis secara default memiliki konfigurasi yang sama.
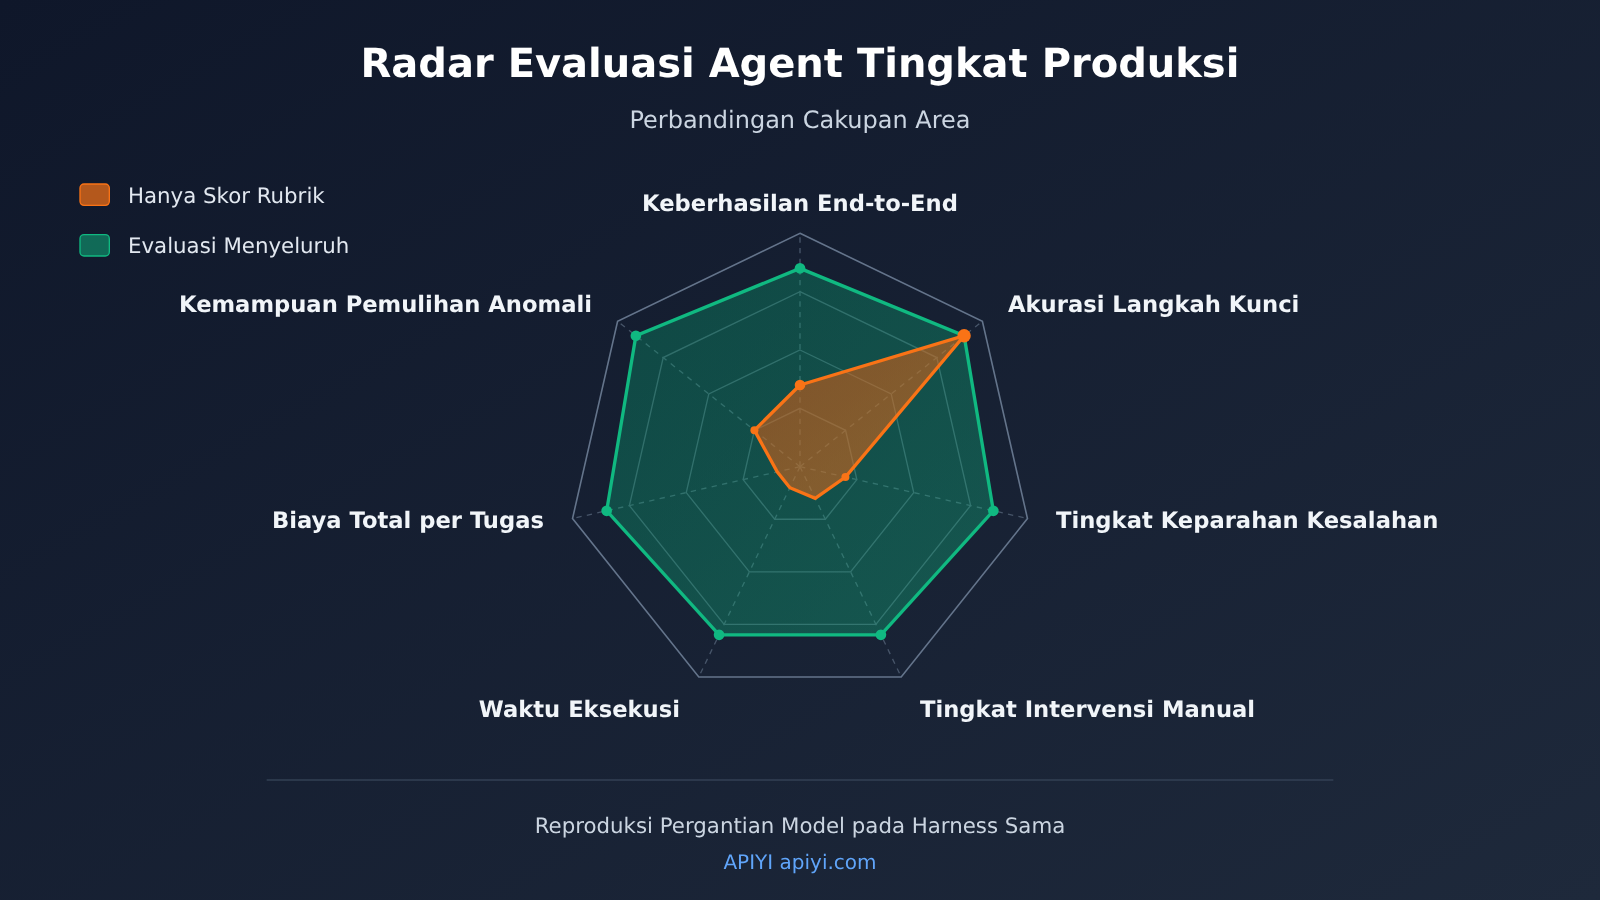
Ukuran sampel dan jumlah pengulangan juga harus dipublikasikan. Sebuah studi yang membandingkan RPA dan Agent (DOI: 10.1080/23311975.2026.2724760) menjalankan masing-masing teknologi 10 kali pada dua alur P2 dan P3, tetapi pada P1 Agent hanya dijalankan 1 kali dan gagal, sehingga tidak dimasukkan ke dalam statistik selanjutnya; studi tersebut menggunakan konfigurasi alat tahun 2025, sehingga tidak dapat dianggap sebagai hasil langsung model tahun 2026. Contoh ini menunjukkan bahwa saat membaca kesimpulan evaluasi, pertama-tama lihat berapa kali setiap angka dijalankan dan hasil mana yang dikecualikan.
Praktik nyata evaluasi Agent medis: menjalankannya sendiri di bawah Harness yang sama
Bagi tim pengembang, pendekatan paling praktis adalah mematok kerangka eksekusi (harness) lalu menghitung dua set metrik sekaligus — subtugas dan end-to-end — pada kumpulan tugas milik sendiri. Contoh di bawah ini memakai LLM Judge untuk memberi skor pada materi yang diserahkan Agent; antarmukanya kompatibel dengan OpenAI SDK:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, bisa berganti model juri yang berbeda
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
Lihat implementasi lengkap: menghitung tingkat keberhasilan subtugas sekaligus tingkat keberhasilan end-to-end
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # Apakah ini langkah krusial (gagal = seluruh tugas gagal)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # Sudah termasuk Token percobaan ulang, jangan dijumlahkan dua kali

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """Gunakan LLM Judge untuk subtugas yang sulit dirumuskan aturan formalnya"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 Saran teknis: Skor subtugas dan tingkat keberhasilan end-to-end sebaiknya dilaporkan berdampingan pada harness yang sama dan kumpulan tugas yang sama. Lewat antarmuka kompatibel OpenAI dari APIYI apiyi.com, satu kunci API bisa dipakai untuk berpindah antara OpenAI, Claude, Gemini, dan model lain — baik sebagai model eksekutor maupun model juri — sehingga variabel yang timbul akibat perbedaan cara integrasi bisa ditekan.
Perhitungan Biaya Agen Medis dan Pelapisan Model
Harga satuan Token hanyalah titik awal. Berdasarkan harga Standard untuk konteks pendek yang diumumkan OpenAI pada 17 November 2026, GPT-6 Astra memiliki harga input, output, dan input yang di-cache masing-masing sebesar 10, 50, dan 1 dolar AS per juta Token; sedangkan GPT-6 Luna sebesar 0.10, 0.50, dan 0.01 dolar AS. Kecepatan pemrosesan, panjang konteks, dan wilayah semuanya memengaruhi penagihan aktual. Computer Use adalah pemanggilan multi-turn; setiap tangkapan layar per putaran dihitung sebagai input visual. Oleh karena itu, saat menghitung, input visual/teks dan output yang ditagih per putaran harus dihitung secara terpisah, lalu tambahkan biaya alat, lingkungan runtime, dan pemeliharaan teknis. Jika Token yang dikonsumsi untuk percobaan ulang sudah dimasukkan ke total, jangan menambahkannya lagi.
Dari selisih antara 0.085 dolar AS dan sekitar 4.25 dolar AS, pelapisan model kemungkinan besar akan menjadi hal yang lazim: tugas kompleks yang membutuhkan penalaran kuat diserahkan kepada model berkemampuan tinggi, tugas dengan struktur tinggi dan frekuensi besar diserahkan kepada model berbiaya rendah, sedangkan alur tetap yang sudah terbukti berjalan dibakukan menjadi kode deterministik seperti pendekatan CVS. Perlu dicatat bahwa biaya per tugas ini berasal dari kondisi benchmark tertentu dan tidak dapat dijadikan penawaran harga produksi.
💰 Optimasi biaya: Sebelum memilih model secara bertingkat, sebaiknya uji lebih dahulu dengan sekumpulan kecil tugas nyata untuk mengukur tingkat keberhasilan end-to-end dan biaya lengkap per tugas dari masing-masing model. APIYI apiyi.com menerapkan penagihan berdasarkan pemakaian, pengguna baru mendapatkan kuota pengujian gratis, sehingga cocok untuk menyelesaikan eksperimen pembanding semacam ini dengan biaya rendah pada tahap perencanaan proyek.
Dari Agen Medis ke Agen Perusahaan: Pendekatan Evaluasi yang Dapat Ditransfer
Kekhususan administrasi medis terletak pada risiko tinggi dan regulasi yang ketat, tetapi masalah yang terungkap di sana juga muncul dalam proses perusahaan seperti klaim asuransi, rekonsiliasi keuangan, dan dokumen rantai pasok: banyak sistem, ketergantungan kuat, serta pemindahan data lintas sistem. Menurut kami, empat prinsip berikut dapat langsung ditransfer:
- Pisahkan laporan: Skor subtugas dan tingkat keberhasilan end-to-end disajikan terpisah, jangan pernah menggunakan yang pertama untuk menggantikan yang kedua
- Tandai tingkat bukti: Demonstrasi lingkungan sintetis, penilaian mandiri vendor, tolok ukur pihak ketiga, pilot perusahaan, dan kasus produksi masing-masing dikategorikan, tidak dicampur
- Tetapkan Harness sebelum membandingkan: Begitu cara observasi, petunjuk, atau panduan portal berubah, hasil tidak lagi dapat dibandingkan
- Tata kelola lebih diutamakan daripada skor: Hak akses minimum, persetujuan manusia untuk tindakan kritis, verifikasi status setelah tindakan, pencatatan jejak Trace menyeluruh, dan mekanisme penghentian saat anomali harus menjadi item penerimaan sebelum peluncuran
Saat melakukan PoC di dalam perusahaan, kumpulan tugas dapat diberi label berdasarkan “langkah kritis”, jalankan dulu baseline end-to-end, lalu secara bertahap perkenalkan panduan portal, observasi terstruktur, atau penguncian lewat kode, sambil mengamati kontribusi nyata setiap perubahan terhadap tingkat keberhasilan penuh. Jika perlu mereproduksi kumpulan tugas yang sama secara cepat di antara beberapa model, akses dapat disatukan melalui APIYI apiyi.com untuk menurunkan biaya rekayasa perbandingan lintas model.
Perkembangan lanjutan yang perlu terus dipantau antara lain: apakah OpenAI akan mempublikasikan hasil per tugas dan konfigurasi eksperimen di balik angka 94.3%; apakah versi berikutnya HealthAdminBench akan merilis tingkat keberhasilan tugas penuh untuk model baru dengan definisi yang sama; serta apakah lebih banyak organisasi dapat mengungkap tingkat intervensi manusia dan data klasifikasi kesalahan di lingkungan produksi nyata. Sebelum informasi tersebut muncul, segala pernyataan bahwa “administrasi medis sudah dapat diotomatisasi sepenuhnya” masih merupakan spekulasi.
Angka 94.3% membuktikan kemajuan signifikan model pada titik penilaian, sedangkan 36.3% mengingatkan bahwa apakah suatu proses bisnis dapat diselesaikan secara andal pada akhirnya harus diuji dalam tugas utuh, sistem nyata, dan pengawasan manusia. Seperti kata pepatah Inggris: “The proof of the pudding is in the eating.”(Apakah pudingnya enak baru diketahui setelah dimakan; efek nyata harus diuji melalui praktik.)
Referensi
- OpenAI: Advancing computer-use agents for healthcare teams: data evaluasi dan studi kasus kemitraan seperti 94.3%, 91.8%, 99%, 93%, dll.
- Tautan:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- Tautan:
- Makalah HealthAdminBench 2604.09937v1: 135 tugas, 1,698 subtugas, hasil per komponen, dan eksperimen ablasi
- Tautan:
arxiv.org/html/2604.09937v1
- Tautan:
- Halaman proyek dan repositori kode HealthAdminBench: lingkungan benchmark dan implementasi evaluasi
- Tautan:
som-shahlab.github.io/health-admin-bench-website/ - Tautan:
github.com/som-shahlab/health-admin-bench
- Tautan:
- Halaman penelitian awal Stanford Shah Lab: versi historis dengan 70 tugas dan 947 titik penilaian
- Tautan:
shahlab.stanford.edu/doku.php?id=healthadminbench
- Tautan:
- Dokumentasi developer dan harga API OpenAI Computer Use: jalur eksekusi dan harga Standard
- Tautan:
developers.openai.com/api/docs/guides/tools-computer-use - Tautan:
developers.openai.com/api/docs/pricing
- Tautan:
- CVS Health CUA Agent Kit: mekanisme eksplorasi, bukti, penguncian kode, dan tinjauan engineer
- Tautan:
github.com/cvs-health/cua-agent-kit
- Tautan:
- Studi perbandingan RPA dan Agent: jumlah eksekusi berulang dan penjelasan pengecualian P1
- Tautan:
doi.org/10.1080/23311975.2026.2724760
- Tautan:
- Cambridge Dictionary: arti peribahasa proof of the pudding is in the eating
- Tautan:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan kunjungi APIYI apiyi.com untuk berdiskusi dengan kami seputar praktik evaluasi Agent; untuk informasi integrasi lebih lanjut, Anda dapat mengunjungi pusat dokumentasi docs.apiyi.com


