
Catatan penulis: Artikel ini memisahkan batas kecepatan resmi, harga promosi, dan harga daftar (list price) GPT-6.2 Sol Ultrafast, sekaligus menyajikan satu algoritme premi kecepatan yang bisa Anda terapkan pada tugas Anda sendiri.
Apakah Anda perlu mengaktifkan Ultrafast untuk GPT-6.2 Sol? Jawabannya bergantung pada berapa banyak waktu tunggu yang bisa dihemat oleh tugas ini. Kecepatan resmi yang diberikan adalah hingga 4,5 kali lipat dibandingkan tier standar model yang sama, harga selama periode promosi adalah 3 kali harga standar, dan harga daftar (list price) mulai Maret 2027 adalah 6 kali lipat. Kecepatan hanyalah batas atas, sedangkan harga adalah angka yang pasti — tingkat kepastian keduanya berbeda, jadi keduanya tidak bisa langsung dibagi.
Artikel ini tidak menjawab “apakah layak dibeli” untuk Anda. Kami tidak membuat kesimpulan pengukuran kecepatan versi kami sendiri, dan juga tidak akan menganggap satu catatan komunitas tanpa kelompok pembanding sebagai hasil akhir. Artikel ini hanya menyediakan satu algoritme: ukur dulu waktu yang dibutuhkan tugas Anda di tier standar, lalu gunakan pengali “maksimum” resmi untuk menghitung batas atas waktu yang bisa dihemat, dan terakhir bandingkan dengan selisih harganya.
Nilai inti: Setelah membaca artikel ini, Anda bisa menghitung untuk tugas apa pun “berapa tambahan biaya untuk setiap 1 menit yang dihemat”, lalu memutuskan berdasarkan tugas tersebut apakah akan mengaktifkan tier kecepatan.
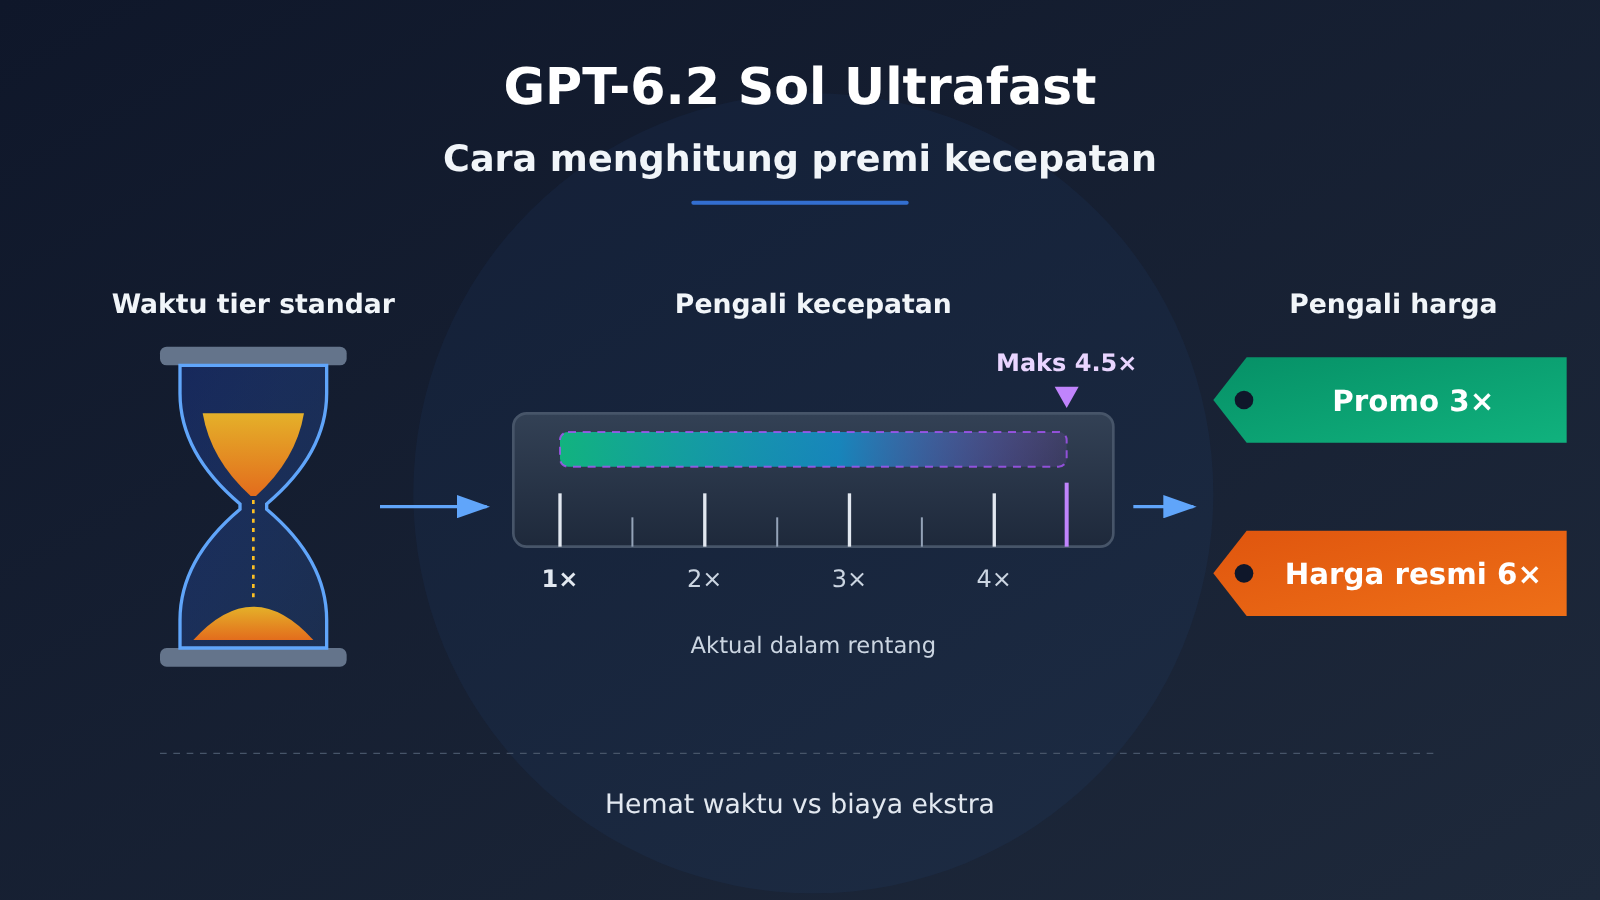
Perbedaan Inti dari Premi Kecepatan GPT-6.2 Sol Ultrafast
Perlu diperjelas satu konsep: Ultrafast adalah tingkatan layanan, bukan model lain. Menurut dokumentasi API resmi, model dalam permintaan tetap gpt-6.2-sol; cukup tambahkan service_tier dan atur ke ultrafast. Saat ini yang mendukung tingkatan layanan ini adalah GPT-6.2 Astra, GPT-6.2 Sol, GPT-6 Astra, dan GPT-6.1 Sol.
Jadi, Anda membandingkan dua kecepatan pengiriman dari model yang sama, bukan perbedaan kemampuan dua model. Pertanyaan tentang kualitas output bisa dikesampingkan; kini hanya tersisa dua variabel: waktu dan harga.
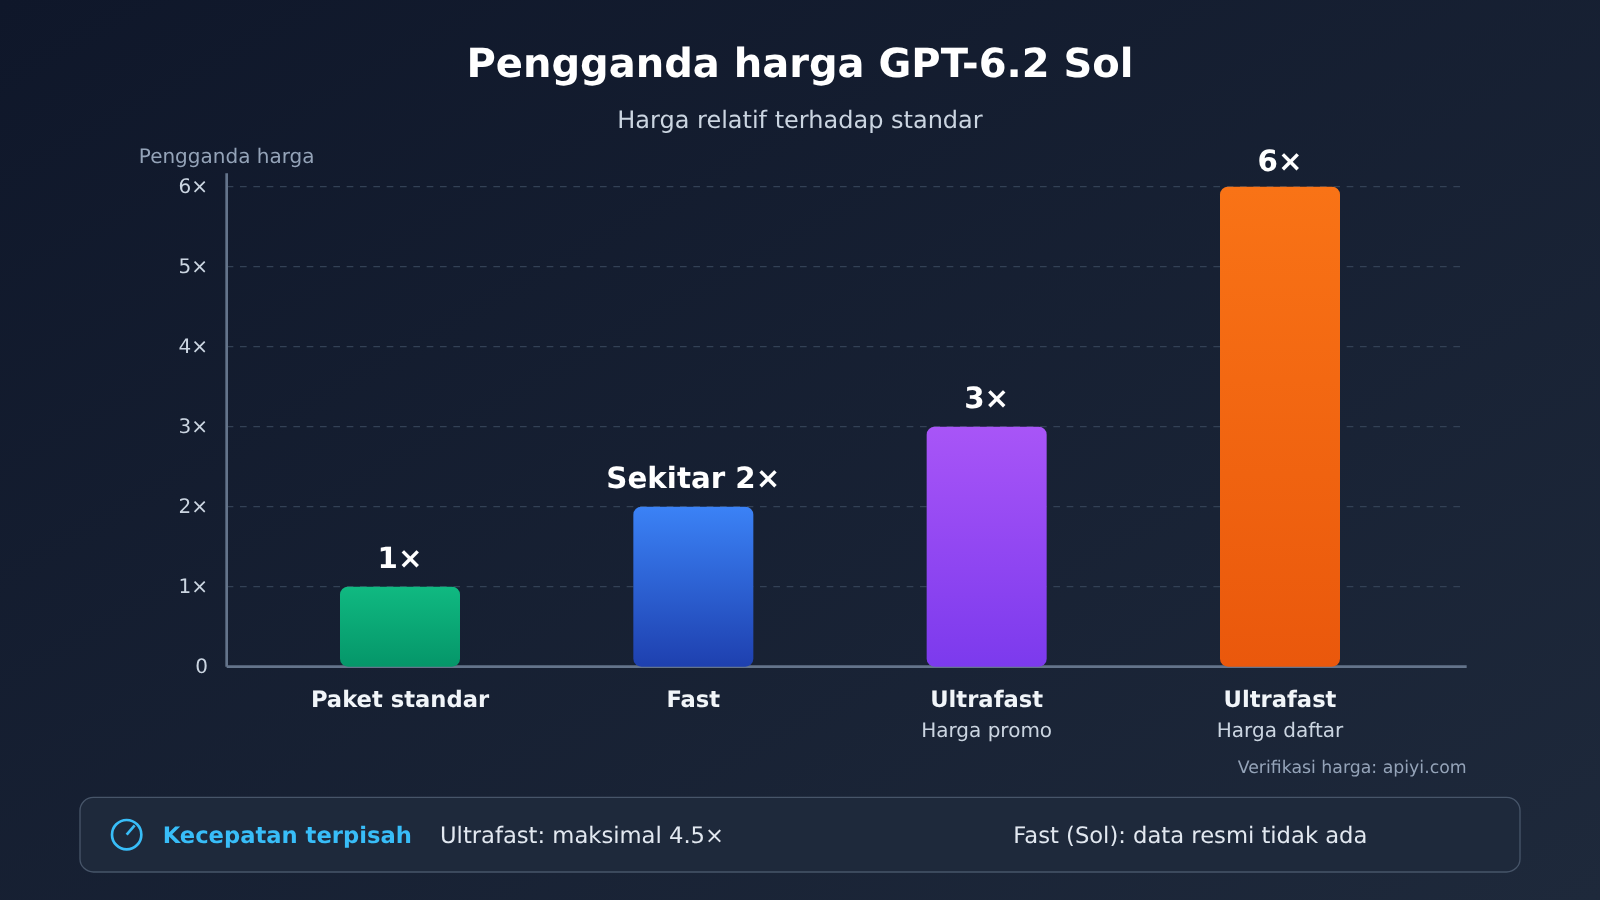
| Tingkatan (gpt-6.2-sol, konteks pendek) | Input | Baca cache | Output | Relatif terhadap harga standar | Klaim kecepatan resmi |
|---|---|---|---|---|---|
| Standar | 2 | 0,10 | 10 | 1× | Acuan |
| Fast | 4 | 0,20 | 20 | Sekitar 2× | Dokumentasi tidak mencantumkan pengali kecepatan untuk Sol |
| Promosi Ultrafast (hingga 2027-02-28 waktu Pasifik) | 6 | 0,30 | 30 | 3× | Hingga 4,5 kali |
| Daftar harga Ultrafast (mulai 2027-03-01) | 12 | 0,60 | 60 | 6× | Hingga 4,5 kali |
Satuan harga dalam tabel adalah dolar per juta token; konteks pendek berarti input tidak melebihi 272 ribu token. Untuk tingkatan Fast perlu catatan tersendiri: “kecepatan sekitar 1,5 kali” yang tertulis di dokumentasi resmi berlaku untuk GPT-6.2 Astra dan GPT-5.6, bukan untuk GPT-6.2 Sol, jadi pengali tersebut tidak boleh diterapkan pada tingkatan Fast milik Sol.
Harga GPT-6.2 Sol Ultrafast untuk Konteks Panjang
Jika input melebihi 272 ribu token, maka masuk ke penetapan harga konteks panjang. Harga konteks panjang untuk tingkatan standar resmi adalah input 4, baca cache 0,20, output 15. Harga promosi Ultrafast adalah 12 / 0,60 / 45, dan harga daftar adalah 24 / 1,20 / 90, yang tetap 3 kali dan 6 kali harga standar.
| Item harga (konteks panjang, dolar per juta token) | Input | Baca cache | Output |
|---|---|---|---|
| Standar resmi | 4 | 0,20 | 15 |
| Promosi Ultrafast | 12 | 0,60 | 45 |
| Daftar harga Ultrafast | 24 | 1,20 | 90 |
Tabel ringkasan APIYI gpt-6.2-sol (input di atas 272 ribu) |
3 | Sesuai daftar platform | Sesuai daftar platform |
Ada satu ketidaksesuaian angka di sini yang perlu dijelaskan secara terpisah: tabel ringkasan model APIYI apiyi.com menuliskan tingkatan 0 hingga 272 ribu token dengan input 2 dolar, dan di atas 272 ribu input 3 dolar, sedangkan harga input konteks panjang untuk tingkatan standar resmi adalah 4 dolar. Jangan menggabungkan kedua angka ini: pemanggilan melalui APIYI dihitung berdasarkan 3 dolar dari tabel ringkasan, sedangkan akses langsung ke resmi dihitung berdasarkan 4 dolar.
Dari Mana Kecepatan GPT-6.2 Sol Ultrafast Berasal: Batas Atas Resmi dan Catatan Komunitas
Di sisi kecepatan, saat ini ada dua jenis informasi dengan tingkat kredibilitas yang sangat berbeda, sebaiknya diperlakukan secara terpisah.
| Sumber | Isi | Sifat | Bisa Dipakai sebagai Patokan Pengali Anda? |
|---|---|---|---|
| Dokumentasi Codex / API resmi | Kecepatan pembuatan Ultrafast hingga 4.5 kali lipat dibandingkan tingkat standar model yang sama (up to 4.5 times) | Pernyataan batas atas resmi | Hanya bisa dianggap batas atas |
| Artificial Analysis | Tingkat standar model yang sama sekitar 85 token output/detik | Tolok ukur publik pihak ketiga | Hanya bisa dijadikan referensi |
| Kutipan ulang OrcaRouter 2026-11-18 | Satu tugas rata-rata sekitar 126 token/detik, puncak sekitar 252 | Kutipan ulang satu kali jalan, tanpa pembanding tingkat standar | Tidak bisa |
Teks resmi memakai frasa “up to”, yang berarti paling tinggi bisa mencapai, bukan janji bahwa setiap permintaan akan mencapai 4.5 kali lipat. Dalam algoritma, angka ini paling cocok diletakkan di kolom “skenario terbaik”.
OrcaRouter pada 2026-11-18 mengutip ulang satu tugas tunggal dari seorang editor video di X: Ultrafast rata-rata sekitar 126 token per detik, dengan puncak sekitar 252; waktu dinding (wall clock) tugas sekitar 27 menit, di mana respons model memakan sekitar 14 menit. Penulis kutipan ulang membandingkan angka ini dengan 85 token/detik tingkat standar yang diumumkan Artificial Analysis, lalu menyimpulkan sekitar 1.5 kali lipat. Catatan ini hanya berasal dari satu kali eksekusi, tanpa pengulangan, dan tanpa pembanding tingkat standar pada tugas yang sama, sehingga hanya bisa dianggap satu titik data dan tidak mewakili performa akhir dari tingkat kecepatan ini.
Catatan ini juga membuka fakta yang mudah terlewat: dari 27 menit waktu dinding, respons model hanya mengambil sekitar 14 menit. Tingkat kecepatan hanya bisa mempercepat proses pembuatan oleh model; pemanggilan tool, pembacaan dan penulisan file, konfirmasi manual, dan tahap-tahap lain tidak ikut menjadi lebih cepat.
Cara menghitung premi kecepatan GPT-6.2 Sol Ultrafast: satu algoritma yang bisa langsung dipakai
Algoritma berikut sengaja tidak menggunakan “kelipatan hasil pengukuran orang lain” mana pun. Satu-satunya data yang perlu Anda sediakan sendiri adalah waktu yang dibutuhkan tugas ini pada tier standar.
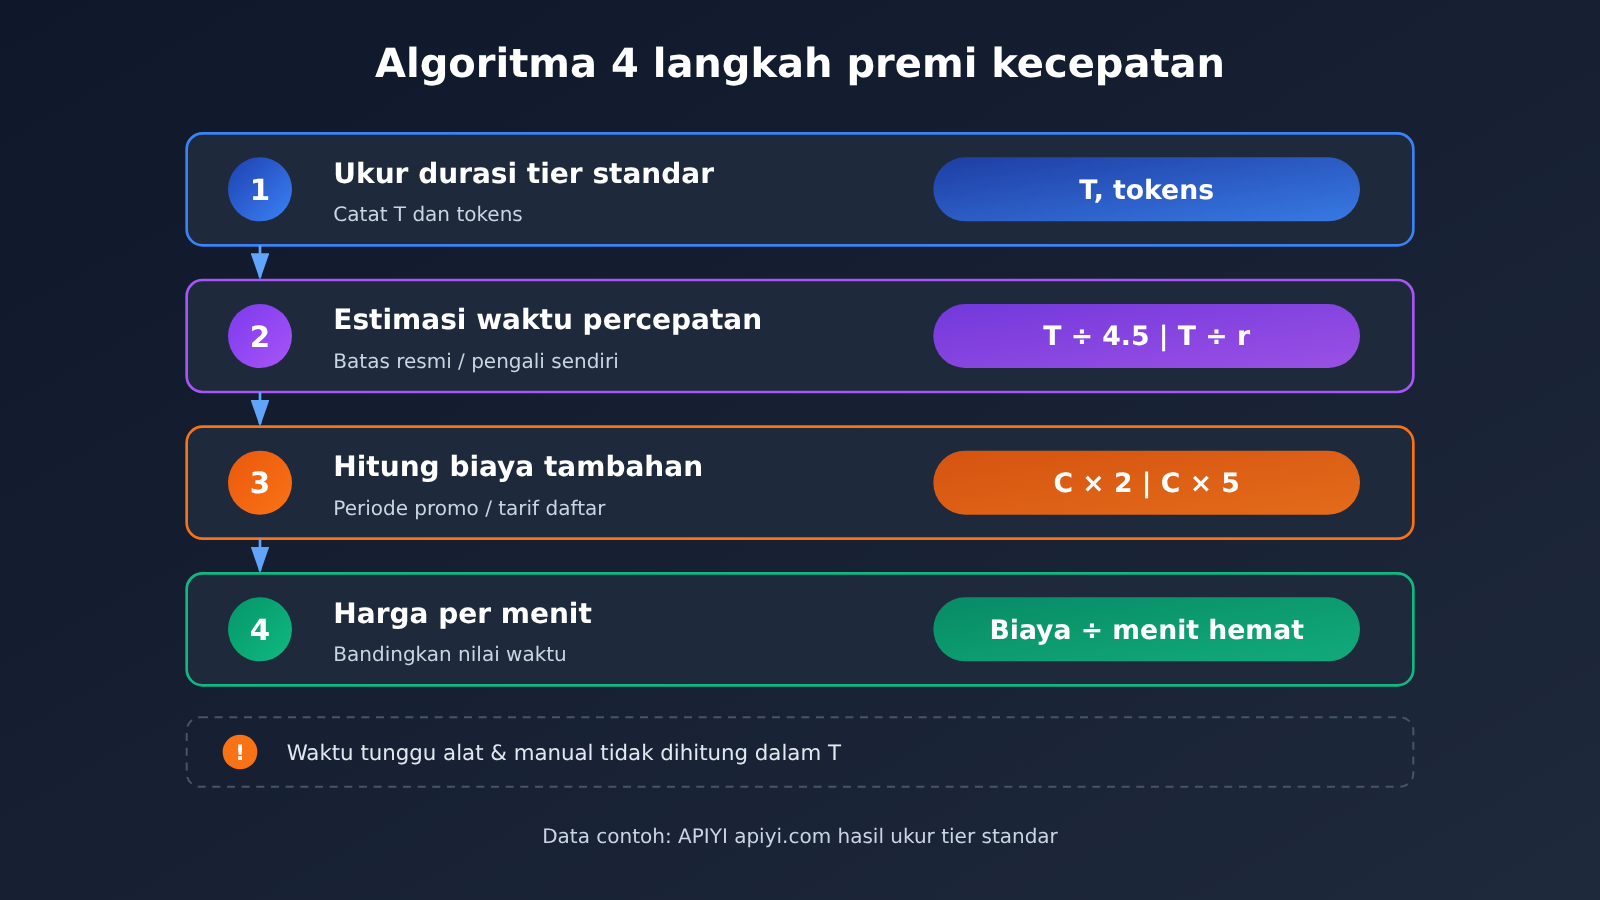
| Langkah | Item perhitungan | Rumus | Keterangan |
|---|---|---|---|
| ① | Waktu generasi tier standar T | Diukur sendiri | Hanya menghitung generasi model, tidak menghitung waktu alat |
| ② | Waktu yang bisa dihemat pada skenario terbaik | T ×(1 − 1/4.5)≈ 0.78T | Menggunakan batas atas resmi |
| ②′ | Waktu yang bisa dihemat pada skenario konservatif | T ×(1 − 1/r) | r adalah pengali yang Anda tentukan sendiri, dan r ≤ 4.5 |
| ③ | Biaya tier standar C | input × harga satuan + pembacaan cache × harga satuan + output × harga satuan | Pilih tier harga berdasarkan panjang konteks |
| ④ | Biaya tambahan periode promosi | C × 2 | Harga promosi Ultrafast adalah 3C |
| ④′ | Biaya tambahan periode tarif resmi | C × 5 | Harga tarif resmi Ultrafast adalah 6C |
| ⑤ | Harga per 1 menit yang dihemat | biaya tambahan ÷ jumlah menit yang dihemat | Bandingkan dengan nilai waktu Anda |
Contoh Perhitungan GPT-6.2 Sol Ultrafast
Berikut adalah demonstrasi algoritma menggunakan sekumpulan angka hipotetis — angka-angka ini bukan hasil pengukuran kecepatan. Misalkan sebuah tugas mengirimkan 200 ribu token (konteks pendek), menghasilkan 50 ribu token, tanpa cache hit; kecepatan keluaran yang Anda dapatkan saat menjalankannya dengan tier standar adalah 80 token/detik.
- Biaya tier standar C = 0,2 × 2 + 0,05 × 10 = 0,9 dolar.
- Waktu pembuatan tier standar T = 50000 ÷ 80 ≈ 625 detik, sekitar 10,4 menit.
- Harga promo Ultrafast adalah 2,7 dolar, pengeluaran tambahan 1,8 dolar; harga resmi adalah 5,4 dolar, pengeluaran tambahan 4,5 dolar.
| Asumsi kelipatan r | Waktu pembuatan | Waktu yang dihemat | Harga per menit periode promo | Harga per menit periode harga resmi |
|---|---|---|---|---|
| 4,5 (batas atas resmi) | sekitar 2,3 menit | sekitar 8,1 menit | sekitar 0,22 dolar | sekitar 0,56 dolar |
| 3 | sekitar 3,5 menit | sekitar 6,9 menit | sekitar 0,26 dolar | sekitar 0,65 dolar |
| 2 | sekitar 5,2 menit | sekitar 5,2 menit | sekitar 0,35 dolar | sekitar 0,87 dolar |
| 1,5 | sekitar 6,9 menit | sekitar 3,5 menit | sekitar 0,51 dolar | sekitar 1,29 dolar |
Dari tabel ini terlihat dua hal. Pertama, ketika kelipatan turun dari 4,5 ke 1,5, harga per menit kira-kira menjadi dua kali lipat, sehingga asumsi kelipatan lebih krusial daripada harga itu sendiri. Kedua, setelah harga resmi berlaku pada Maret 2027, untuk menghemat 1 menit yang sama Anda perlu membayar sekitar 2,5 kali lebih banyak, sehingga kesimpulan dari periode promo tidak bisa langsung diterapkan ke tahun depan.
💰 Saran pemeriksaan biaya: Harga satuan tier standar dalam contoh dapat langsung dibandingkan dengan harga
gpt-6.2-soldi tabel lengkap APIYI apiyi.com (input 2, baca cache 0,1, output 10). Kelompok harga ini konsisten dengan tier standar resmi untuk konteks pendek, dan cocok dijadikan sumber nilai C dalam algoritma.
Ukur sendiri waktu proses tier standar GPT-6.2 Sol dengan kode
Langkah pertama algoritme membutuhkan T yang nyata. Kode berikut menggunakan streaming output untuk mencatat waktu token pertama dan total waktu generasi, sekaligus membaca jumlah token dari usage, agar bisa menghitung kecepatan tugas Anda di tier standar.
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Entri kompatibel OpenAI APIYI
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "把你的真实任务提示词放在这里"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"首 token {first - start:.1f}s,生成 {gen:.1f}s,"
      f"输出 {usage.completion_tokens} tokens,约 {usage.completion_tokens / gen:.0f} tok/s")
Lihat skrip perbandingan lengkap yang menyertakan service_tier
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # dolar per juta token, konteks pendek
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # Cara resmi: tambahkan service_tier pada ID model yang sama
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "把你的真实任务提示词放在这里"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"标准档:生成 {t_std:.1f}s,费用约 ${c_std:.3f},返回档位 {s_std}")

for name, r in [("官方上限", 4.5), ("保守假设", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:省 {saved_min:.1f} 分钟,"
          f"促销每分钟 ${c_std * 2 / saved_min:.3f},刊例每分钟 ${c_std * 5 / saved_min:.3f}")

# Jika ingin mengukur tier kecepatan secara langsung, hapus komentar di bawah ini dan periksa apakah field service_tier yang dikembalikan bernilai ultrafast
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度档:生成 {t_uf:.1f}s,实际倍数约 {t_std / t_uf:.2f},返回档位 {s_uf}")
Perlu penjelasan mengenai service_tier: tabel model APIYI apiyi.com hanya mencantumkan gpt-6.2-sol, tidak ada model ultrafast terpisah, dan field service_tier juga tidak ditulis; harga yang tertera di daftar mengacu pada tier standar. Artikel ini hanya memeriksa dokumentasi dan daftar harga, tidak mengirim permintaan sungguhan, jadi tidak bisa menjelaskan perilaku parameter ini saat dipanggil melalui https://api.apiyi.com/v1. Jika Anda membutuhkan tier kecepatan, patokannya adalah field tier yang dikembalikan dalam respons dan tagihan; model serta harga mengikuti daftar model platform.
🚀 Saran memulai: Jalankan dulu
gpt-6.2-solpada tier standar di APIYI apiyi.com untuk dua-tiga tugas nyata Anda sendiri, lalu ambil median waktu generasi sebagai T. Langkah ini hanya memakan biaya standar, tetapi menentukan akurasi semua perhitungan setelahnya.
Rekomendasi skenario GPT-6.2 Sol Ultrafast
Kesimpulan harus diambil per tugas. Orang yang sama bisa mendapat jawaban yang berlawanan pada tugas yang berbeda.
Skenario yang cocok untuk mengaktifkan Ultrafast
- Tugas interaktif saat orang menunggu hasil di depan layar: misalnya pemrograman berpasangan real-time, demo langsung. Waktu menunggu langsung menjadi biaya tenaga kerja; dengan rumus di atas, harga per unit biasanya bisa menutupinya.
- Tugas dengan proporsi waktu generasi tinggi terhadap wall clock: jika T menyumbang sebagian besar durasi tugas, waktu yang dihemat bisa langsung terlihat pada waktu pengiriman.
- Tugas konteks pendek selama masa promosi: harga 3 kali lipat dipadukan dengan harga per unit yang rendah untuk konteks pendek membuat nominal pengeluaran tambahan relatif kecil.
Skenario yang lebih baik tetap di tier standar
- Pemrosesan batch latar belakang, tugas malam hari: tidak ada yang menunggu, menit yang dihemat tidak punya nilai waktu yang sepadan.
- Tugas Agent padat pemanggilan tool: seperti catatan yang dikutip sebelumnya, dari 27 menit wall clock respons model hanya sekitar 14 menit, tier kecepatan hanya bisa memangkas sebagian.
- Tugas konteks panjang dengan output besar: pada periode tarif resmi harga per unit output konteks panjang mencapai 90, pengeluaran tambahan meningkat cepat.
| Karakteristik tugas | Proporsi waktu generasi | Ada yang menunggu | Kecenderungan |
|---|---|---|---|
| Pengkodean interaktif, demo langsung | Tinggi | Ya | Hitung dulu dengan algoritme, harga per unit biasanya bisa menutupi |
| Agent padat tool | Menengah ke rendah | Tergantung situasi | Hitung hanya bagian generasi, manfaatnya akan terdilusi |
| Pemrosesan batch malam hari | Tinggi | Tidak | Tetap di tier standar |
| Konteks panjang output besar | Tinggi | Tergantung situasi | Pada periode tarif resmi perlu dihitung cermat |
💡 Saran pemilihan: Jika dalam satu proyek ada kedua jenis tugas, Anda bisa menentukan di kode apakah akan menyertakan
service_tierberdasarkan jenis tugas, tidak perlu mengaktifkannya secara global. Gunakan Key yang sama di APIYI apiyi.com untuk menjalankan baseline tier standar, lalu putuskan jenis tugas mana yang layak diuji lebih lanjut dengan tier kecepatan.
Rekomendasi keputusan GPT-6.2 Sol Ultrafast
Rangkum konten sebelumnya menjadi satu alur kerja tetap:
- Jalankan tugas nyata dengan tier standar, catat waktu generasi T dan pemakaian token, jangan pakai angka kecepatan orang lain.
- Hitung skenario terbaik dengan batas atas resmi 4,5, lalu pilih faktor pengali konservatif r yang menurut Anda wajar, dan hitung kedua skenario tersebut.
- Hitung biaya tambahan masing-masing pada tarif promo 3x dan tarif daftar 6x, sehingga diperoleh dua “harga per menit”.
- Bandingkan dengan nilai waktu Anda: hanya tugas yang tetap menguntungkan pada faktor konservatif yang layak diaktifkan.
- Sebelum tarif daftar berlaku pada 2027-03-01, hitung ulang dengan harga baru.
Kunci alur ini ada di langkah 2. Batas atas resmi “hingga 4,5 kali lipat” bisa dipakai sebagai plafon, sedangkan catatan sekitar 126 token/detik pada 2026-11-18 hanyalah satu titik data tunggal; keduanya bukan faktor pengali aktual untuk tugas Anda. Faktor aktual hanya bisa diperoleh melalui uji banding pada tugas Anda sendiri.
FAQ umum
Q1: Apakah GPT-6.2 Sol Ultrafast model baru?
Bukan. Menurut dokumentasi API resmi, Ultrafast adalah tier layanan; `model` dalam permintaan tetap `gpt-6.2-sol`, ditambah `service_tier` yang diset ke `ultrafast`, modelnya sendiri tidak berubah.
Q2: Apakah dengan mengaktifkan Ultrafast pasti mencapai 4,5 kali lipat?
Belum tentu. Teks resmi menyebut “up to 4.5 times”, yang merupakan pernyataan batas atas. Saat menghitung, siapkan juga faktor konservatif yang lebih rendah, dan jadikan uji banding Anda sendiri sebagai acuan.
Q3: Kapan harga promo GPT-6.2 Sol Ultrafast berakhir?
Harga promo resmi berlaku sampai 2027-02-28 (waktu Pasifik), yaitu 3x harga standar; mulai 2027-03-01 tarif daftar berlaku, yaitu 6x harga standar. Konteks pendek maupun konteks panjang mengikuti rasio pengali ini.
Q4: Bisakah catatan sekitar 126 token/detik itu dijadikan referensi?
Bisa sebagai satu titik data, tetapi jangan dijadikan kesimpulan. Itu adalah satu tugas yang dilaporkan OrcaRouter pada 2026-11-18, tanpa pengulangan dan tanpa pembanding tier standar pada tugas yang sama; klaim sekitar 1,5 kali lipat di artikel tersebut diperoleh dengan membandingkan angka 85 token/detik tier standar yang dipublikasikan Artificial Analysis.
Q5: Harga gpt-6.2-sol yang terlihat di APIYI itu tier yang mana?
Tier standar. Di tabel utama APIYI apiyi.com, harga `gpt-6.2-sol` adalah input 2, baca cache 0,1, output 10, konsisten dengan tier standar resmi untuk konteks pendek, serta mendukung endpoint responses dan chat. Tabel utama tidak memuat model ultrafast terpisah, juga tidak mencantumkan `service_tier`.
Q6: Saat input melebihi 272 ribu token, tier standar dihitung berapa?
Angka dari dua sumber berbeda, jadi perlu dihitung terpisah: tabel utama APIYI menulis input di atas 272 ribu sebesar 3 dolar, sedangkan tier standar resmi untuk konteks panjang menetapkan input 4 dolar. Saat memanggil lewat https://api.apiyi.com/v1, perhitungan mengikuti daftar model platform; jika langsung ke pihak resmi, dihitung 4 dolar.
Poin Penting Premium Kecepatan GPT-6.2 Sol Ultrafast
- Ultrafast adalah tingkat layanan: cukup gunakan ID model yang sama
gpt-6.2-solditambahservice_tier, kemampuan model tidak berubah. - 4,5x adalah batas atas resmi: teks aslinya “up to”, saat menghitung jangan menganggapnya sebagai kelipatan yang selalu bisa dicapai setiap saat.
- Harga terbagi dua tahap: masa promosi sebesar 3x harga standar, mulai 2027-03-01 harga daftar menjadi 6x.
- Hanya waktu generasi yang menjadi lebih cepat: waktu non-generasi seperti pemanggilan alat tidak termasuk dalam bagian yang bisa dihemat.
- Satu kali pengukuran tidak bisa mewakili hasil: catatan sekitar 126 token/detik pada 2026-11-18 tidak memiliki pembanding tingkat standar.
- Ukur dulu tingkat standar Anda sendiri: Anda bisa memakai tingkat standar
gpt-6.2-soldi APIYI apiyi.com untuk mengukur T, lalu memasukkannya ke dalam perhitungan.
Ringkasan
Perhitungan premium kecepatan GPT-6.2 Sol Ultrafast bisa diringkas menjadi tiga poin:
- Kecepatan diambil dari dua nilai, batas atas dan konservatif: nilai tertinggi resmi 4,5x diletakkan pada skenario terbaik, sedangkan kelipatan konservatif yang Anda tentukan sendiri diletakkan di kolom lain.
- Harga dihitung terpisah: pengeluaran tambahan pada masa promosi adalah 2x biaya standar, sedangkan pada masa harga daftar adalah 5x; dua kesimpulan ini tidak boleh dicampur.
- Kesimpulan ditentukan oleh tugas: hanya jika harga untuk menghemat 1 menit lebih rendah daripada nilai waktu Anda, tugas ini layak mengaktifkan tingkat kecepatan.
Jawaban atas pertanyaan di judul bergantung pada data tugas Anda sendiri. Sebaiknya ukur dulu baseline dengan tingkat standar di APIYI apiyi.com, lalu masukkan angka tersebut ke tabel perhitungan di artikel ini.
📚 Referensi
-
Penjelasan tingkat kecepatan OpenAI Codex:pernyataan resmi Ultrafast hingga 4,5 kali
- Tautan:
developers.openai.com/codex/agent-configuration/speed - Keterangan:mengonfirmasi teks asli “up to 4.5 times” dan model yang berlaku
- Tautan:
-
Panduan API mode Ultrafast OpenAI:penggunaan
service_tierdan model yang didukung- Tautan:
developers.openai.com/api/docs/guides/ultrafast-mode - Keterangan:mengonfirmasi bahwa Ultrafast adalah service tier,
modeltidak berubah
- Tautan:
-
Halaman harga OpenAI API:harga tier standar, Fast, dan Ultrafast (promosi serta harga resmi/katalog)
- Tautan:
developers.openai.com/api/docs/pricing - Keterangan:harga lengkap untuk konteks pendek dan konteks panjang
- Tautan:
-
Catatan parafrase OrcaRouter:data tugas Ultrafast tunggal pada 2026-11-18
- Tautan:
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - Keterangan:parafrase dari satu kali tugas tanpa pembanding, hanya dapat dianggap sebagai satu titik data
- Tautan:
-
Tabel model APIYI:harga tier standar
gpt-6.2-soldan strukturnya- Tautan:
docs.apiyi.com/models.md - Keterangan:untuk memeriksa harga satuan tier standar dan harga untuk input di atas 272 ribu
- Tautan:
Penulis:Tim Teknis APIYI
Konsultasi teknis:jika ada pertanyaan tentang perhitungan atau integrasi, silakan hubungi kami melalui halaman beranda situs resmi APIYI; untuk materi lainnya dapat mengakses pusat dokumentasi docs.apiyi.com


