
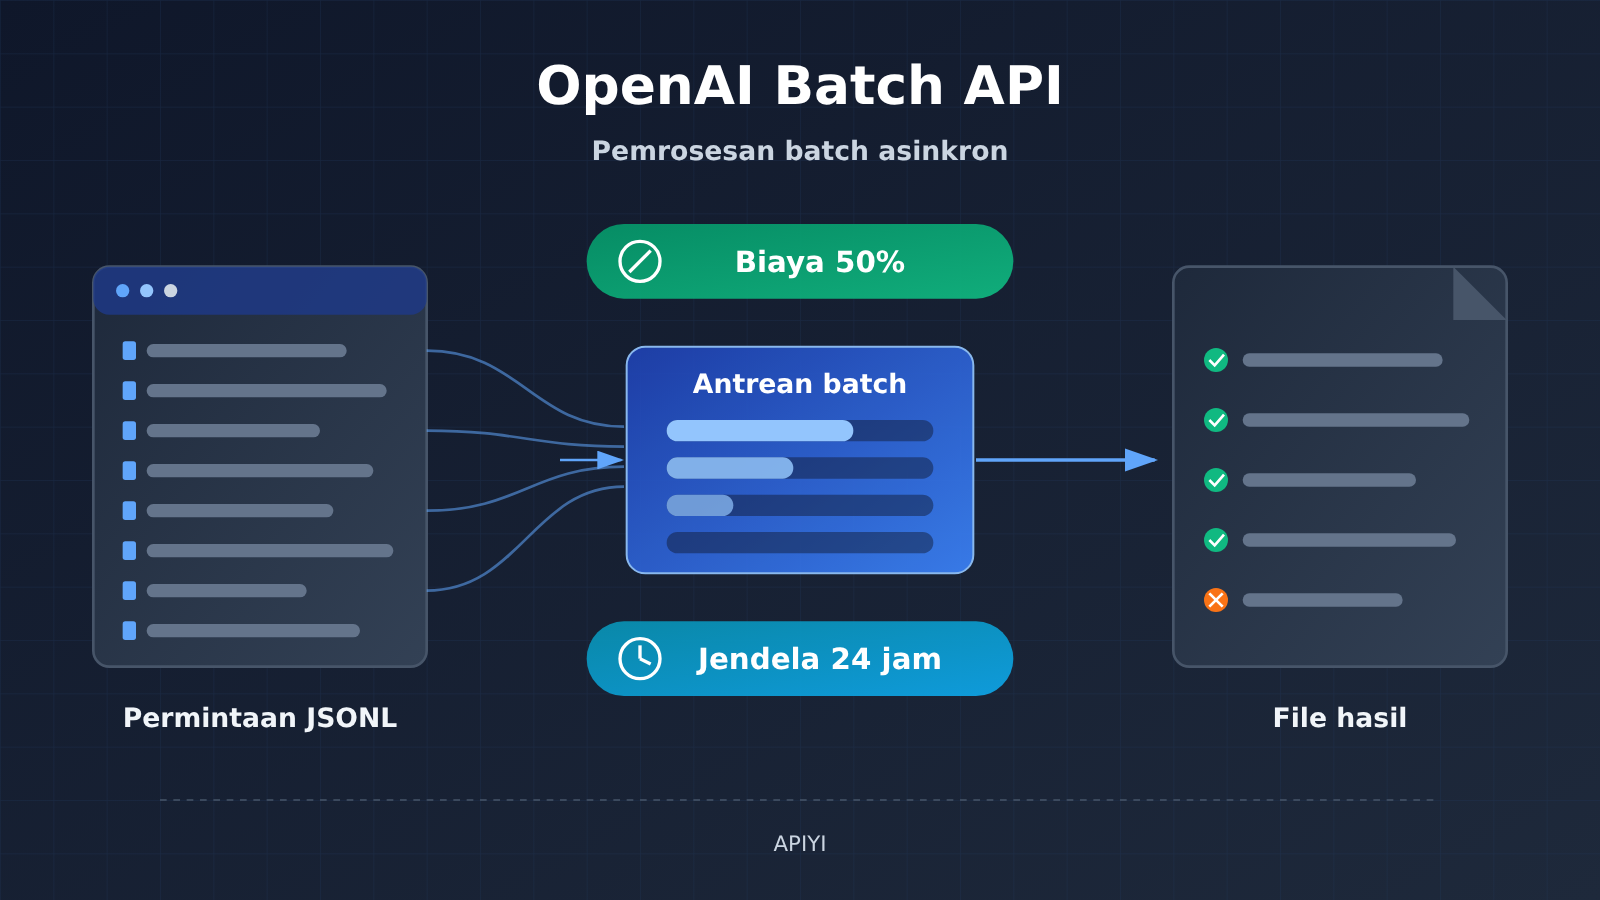
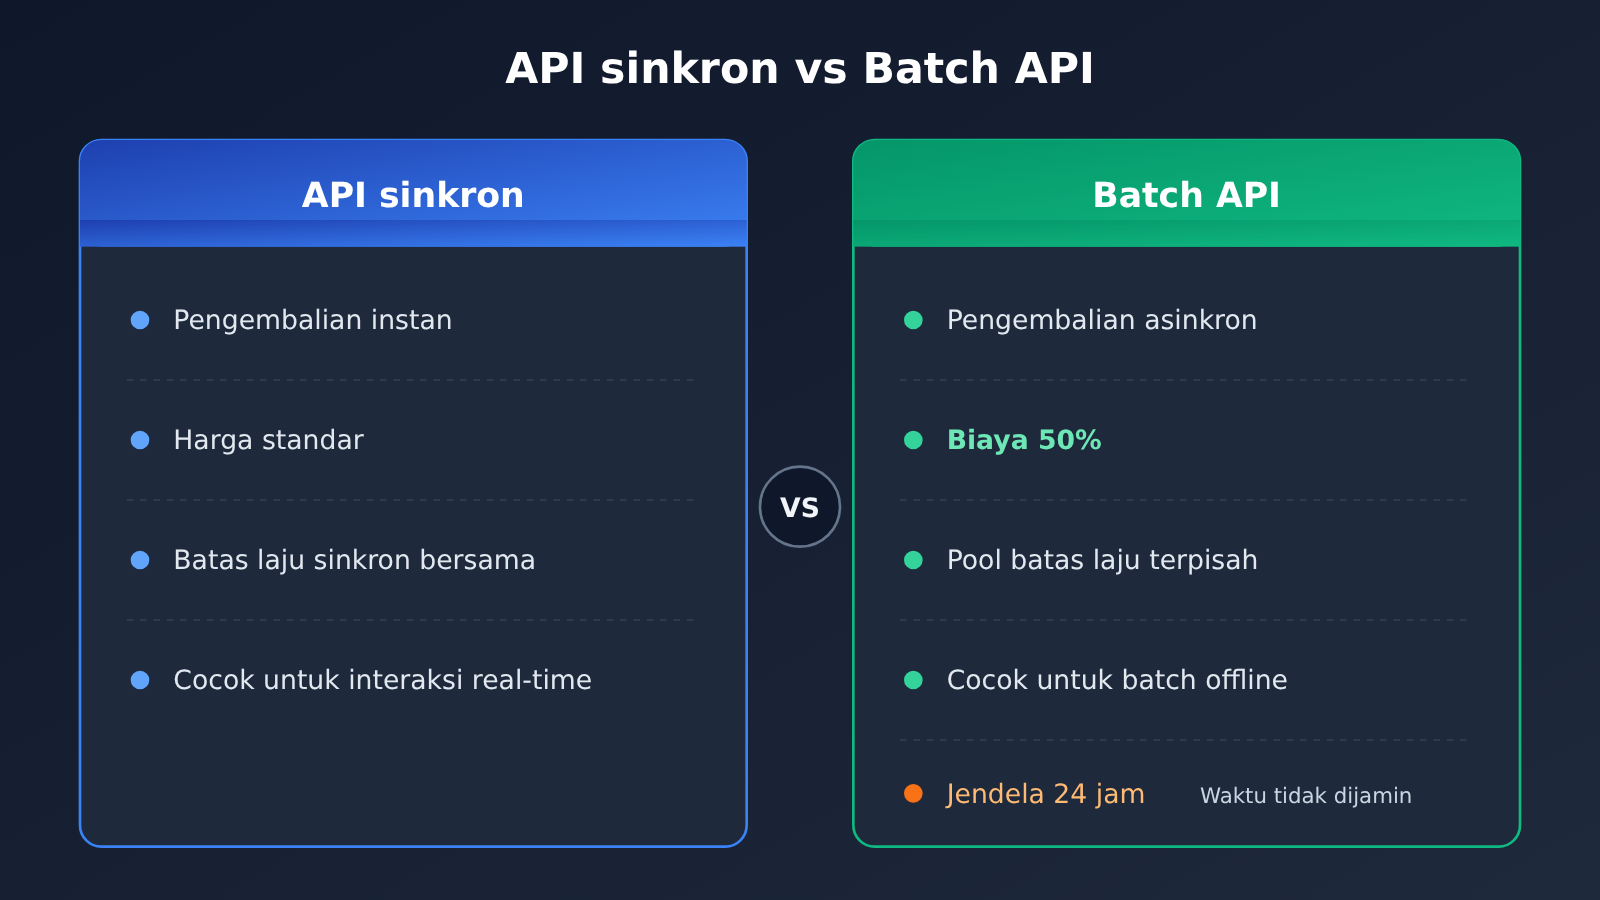
Jawaban langsung: OpenAI Batch API cocok untuk tugas-tugas yang “hasilnya bisa didapat belakangan, saling independen, dan bervolume besar”. Harganya setengah dari API sinkron, dan menggunakan pool batas laju tersendiri. Batasannya adalah jendela pemrosesan 24 jam, dan jendela ini tidak menjamin hasil dikirim pada titik waktu tertentu. Pekerjaan offline seperti klasifikasi berdasarkan aturan tetap, pemrosesan basis pengetahuan, dan evaluasi model dapat dipertimbangkan lebih dahulu untuk Batch. Layanan pelanggan real-time, interaksi yang membutuhkan balasan instan, serta alur dependen di mana hasil langkah sebelumnya menentukan isi langkah berikutnya, tidak seharusnya diserahkan kepada Batch API.
Apa yang bisa Anda pahami setelah membaca artikel ini?
- Aturan inti OpenAI Batch API: diskon, batas laju, jendela, format file, dan batas jumlah.
- Perbedaan antara tiga hal: pengiriman berhasil, pembuatan berhasil, dan pengiriman tepat waktu.
- Bagaimana penagihan dilakukan setelah batch kedaluwarsa, dan bagaimana hanya menjalankan ulang permintaan yang gagal.
- Bagian biaya mana yang secara spesifik dihemat oleh diskon 50%, dan biaya mana yang tidak ikut berkurang setengah.
- Metode praktis untuk menilai apakah suatu tugas cocok untuk Batch.
Indeks: Sebelum masuk ke isi utama, sebuah tabel konsep dan ringkasan dampak akan membantu Anda membangun pemahaman dasar. Bagian 「Fakta Objektif」 merangkum aturan dari dokumentasi resmi satu per satu; bagian 「Analisis dan Penilaian」 membahas apa arti aturan-aturan ini bagi pemilihan tugas, perhitungan biaya, dan desain teknik, sekaligus memberikan jenis tugas yang cocok dan tidak cocok.
Perlu dijelaskan bahwa artikel ini berdasarkan panduan Batch resmi OpenAI yang terus dipelihara, diperiksa pada 2026-11-17. Dokumen ini tidak memiliki tanggal rilis pertama yang jelas, sehingga artikel ini tidak menganggapnya sebagai fitur baru yang dirilis pada hari itu, melainkan sebagai interpretasi aturan atas kemampuan yang sudah ada.
Yang Perlu Diketahui: Memahami Konsep Kunci OpenAI Batch API
| Konsep | Penjelasan singkat |
|---|---|
| API Sinkron | Cara pemanggilan biasa: permintaan dikirim lalu hasilnya langsung ditunggu dan dikembalikan |
| Batch API | Antarmuka untuk mengirim banyak permintaan sekaligus, diproses secara asinkron, lalu hasilnya diambil kembali secara seragam di kemudian hari |
| JSONL | Format teks di mana setiap baris adalah objek JSON mandiri; dalam Batch, setiap baris mewakili satu permintaan |
| custom_id | Pengenal unik yang Anda tetapkan untuk tiap permintaan, dipakai untuk memetakan hasil keluaran kembali ke permintaan aslinya |
| Pool batas laju terpisah | Batas laju untuk permintaan Batch dihitung terpisah dari permintaan sinkron, sehingga keduanya tidak saling mengambil jatah |
| Jendela pemrosesan 24 jam | Batas waktu pemrosesan sebuah batch; permintaan yang belum selesai setelah waktu habis akan dibatalkan |
| Batch kedaluwarsa | Batch yang masih belum selesai seluruhnya meski sudah melewati jendela pemrosesan |
Ringkasan Dampak OpenAI Batch API
- Developer: Biaya API untuk tugas batch offline bisa diperkirakan sekitar setengah dari harga sinkron, sekaligus tidak memakan kuota batas laju sinkron layanan online. Hanya saja, Anda perlu mengimplementasikan sendiri pencocokan custom_id, pengiriman ulang saat gagal, dan validasi hasil.
- Tim konten dan data: Pekerjaan klasifikasi, ringkasan, dan pembersihan basis pengetahuan dalam jumlah besar jadi lebih hemat biaya. Konsekuensinya, Anda harus melepaskan “hasil instan saat itu juga”, dan waktu penyelesaian perlu diberi kelonggaran.
- Tim evaluasi dan peneliti: Menjalankan set pengujian dalam skala besar sangat cocok menggunakan Batch. Namun perlu diperhatikan, satu file hanya bisa memakai satu model; untuk membandingkan beberapa model, harus dipecah menjadi beberapa file.
- Penanggung jawab produk dan operasi: Jangan memahami “24 jam” sebagai “pasti selesai besok pagi”. Saat menjanjikan waktu penyelesaian ke pihak eksternal, Batch sebaiknya dianggap sebagai kanal upaya terbaik (best-effort).
Fakta Objektif OpenAI Batch API
Aturan Penagihan dan Batas Kecepatan Batch API
Berdasarkan panduan resmi Batch (dokumentasi resmi OpenAI: developers.openai.com/api/docs/guides/batch), Batch API memiliki tiga karakteristik inti:
- Diskon biaya: memberikan diskon biaya 50% dibandingkan API sinkron.
- Batas kecepatan terpisah: menggunakan kumpulan batas kecepatan tersendiri, tidak berbagi kuota dengan permintaan sinkron.
- Jendela pemrosesan: batch diselesaikan dalam jendela 24 jam.
Model dan endpoint apa saja yang didukung mengikuti cakupan yang tercantum dalam dokumentasi resmi. Saat ini tidak bisa dikatakan secara general bahwa “semua model mendukung Batch”.
Format File dan Batas Jumlah Batch API
| Butir Aturan | Persyaratan Resmi | Makna Sebenarnya |
|---|---|---|
| Format file | JSONL, satu permintaan per baris | Satu baris adalah satu tugas mandiri |
| Penanda permintaan | Setiap permintaan memiliki custom_id unik | Pengambilan hasil sepenuhnya bergantung pada ini untuk pencocokan |
| Batasan model | Satu file hanya boleh menggunakan satu model | Tugas multi-model perlu dipecah menjadi beberapa file |
| Batas jumlah | Maksimal 50.000 permintaan per batch | Melebihi batas harus dikirim dalam beberapa batch |
| Batas ukuran | Ukuran file maksimal 200MB per batch | Tugas dengan konteks panjang mungkin lebih dulu mencapai batas ukuran |
| Urutan output | Tidak dijamin sama dengan urutan input | Tidak bisa mencocokkan hasil berdasarkan nomor baris |
Berikut adalah struktur ilustratif satu baris permintaan, untuk menjelaskan posisi custom_id. Endpoint dan parameter spesifik mengikuti daftar dukungan dalam dokumentasi resmi:
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "为以下主题写一段摘要:..."}]}}
Aturan Kedaluwarsa dan Penagihan Batch API
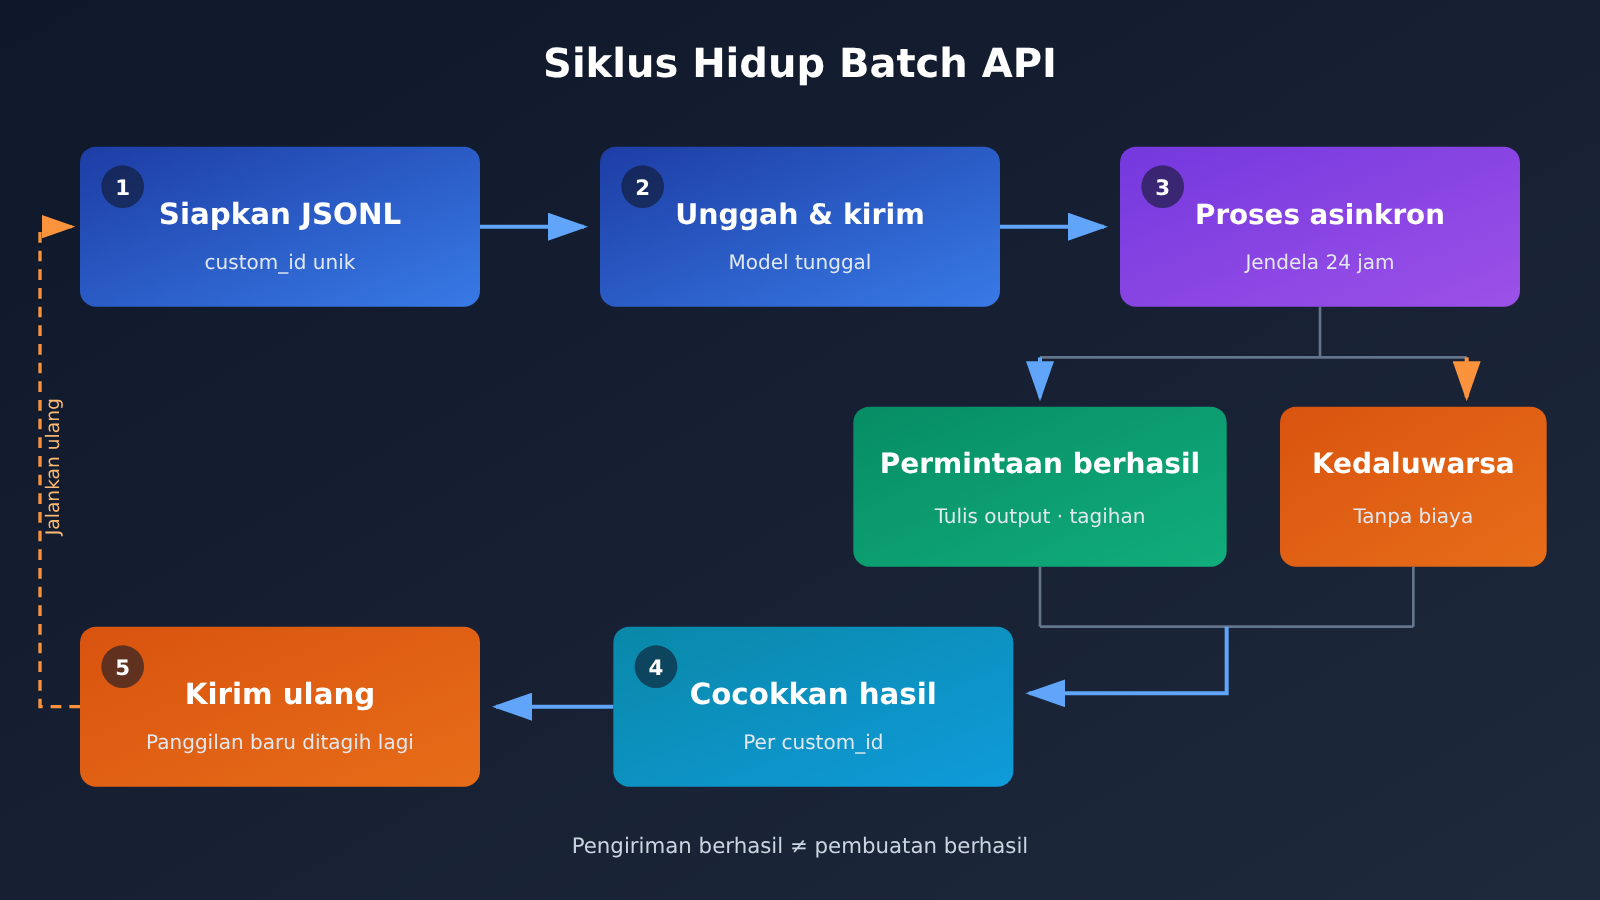
Jika batch melewati jendela pemrosesan, permintaan yang belum selesai akan dibatalkan. Hasil yang sudah berhasil tetap dapat diunduh, dan penagihan hanya berlaku untuk permintaan yang berhasil.
Dokumentasi juga mengingatkan satu hal: pengiriman berhasil tidak sama dengan pembuatan berhasil. Batch yang diterima hanya berarti telah masuk ke alur pemrosesan, bukan berarti setiap baris akan menghasilkan keluaran. Jendela 24 jam juga bukan janji “naskah diserahkan pada suatu titik besok pagi”.
Analisis dan Pertimbangan OpenAI Batch API
Bagian biaya mana yang dihemat oleh diskon 50%
“Diskon 50%” berlaku untuk biaya pemanggilan model pada pemrosesan Batch itu sendiri. Berikut contoh desain untuk menjelaskannya; angka-angka di sini bukan data hasil pengukuran.
Misalkan sebuah tugas ditagih 100 yuan untuk permintaan sinkron, maka permintaan yang sama melalui Batch secara ilustratif dikenakan biaya 50 yuan. Namun total biaya proyek belum tentu berkurang separuh, karena beberapa jenis biaya tidak otomatis mendapat diskon:
| Item biaya | Ikut diskon 50% Batch? | Keterangan |
|---|---|---|
| Biaya pemanggilan model untuk permintaan batch | Ya | Ilustrasi: permintaan sinkron 100 yuan setara dengan Batch 50 yuan |
| Pemanggilan alat untuk riset pendahuluan | Tidak | Misalnya mencari referensi dan melakukan riset sebelum menentukan apa yang akan ditulis |
| Peninjauan manual | Tidak | Biaya tenaga kerja tidak bergantung pada metode penagihan |
| Percobaan ulang tambahan | Tidak, perlu dihitung terpisah | Menjalankan ulang setelah gagal atau kedaluwarsa akan menghasilkan pemanggilan baru |
| Pengembangan dan pemeliharaan teknis | Tidak | Pembuatan file, pencocokan hasil, dan logika pengiriman ulang memerlukan investasi |
Jadi, saat menyusun anggaran, terapkan diskon 50% hanya pada “bagian pemanggilan yang bisa diproses secara batch”, dan jangan langsung memotong setengah total anggaran proyek. Jika proporsi riset dan peninjauan dalam sebuah proyek cukup tinggi, penghematan keseluruhan yang dihasilkan Batch akan jelas lebih kecil dari 50%.
Bagaimana memahami jendela 24 jam
Jendela 24 jam menggambarkan batas waktu pemrosesan, bukan jaminan pengiriman. Pendekatan yang lebih aman adalah: perlakukan hasil Batch sebagai output yang “kemungkinan besar tersedia dalam periode jendela, tetapi bisa saja sebagian hilang”, dan sisakan waktu dalam jadwal untuk pengiriman ulang.
Jika pihak bisnis menuntut “semua hasil harus sudah diterima sebelum pukul 9 pagi besok”, maka mengandalkan satu kali pengiriman Batch saja berisiko. Untuk tugas dengan persyaratan waktu yang kaku, Anda bisa mengirim lebih awal, menyisakan jendela untuk pengiriman ulang, atau mengalihkan bagian penting ke permintaan sinkron.
custom_id adalah inti dari desain rekayasa Batch
Karena urutan output tidak dijamin, pengumpulan hasil harus sepenuhnya bergantung pada custom_id. Ini menuntut custom_id sudah memiliki makna bisnis sejak tahap desain dan unik secara global, misalnya “jenis tugas-nomor batch-nomor urut”.
Contoh desain berikut juga bukan hasil pengujian nyata: untuk menghasilkan 20 artikel independen dengan model yang sama, Anda dapat menuliskannya sebagai 20 baris JSONL. Jika pada akhirnya 18 artikel berhasil dan 2 dibatalkan karena kedaluwarsa, Anda hanya perlu mencari 2 yang hilang melalui custom_id lalu mengirimkannya ulang, tanpa harus menjalankan ulang semua 20 artikel. 18 artikel yang berhasil ditagih sebagai permintaan sukses, sedangkan 2 yang dibatalkan tidak ditagih.
Poin-poin kunci dari alur ini dapat dirangkum sebagai berikut:
- Validasi apakah custom_id di setiap baris unik sebelum pengiriman.
- Setelah hasil terkumpul, kurangi himpunan custom_id input dengan himpunan custom_id output untuk mendapatkan daftar yang hilang.
- Buat JSONL baru hanya untuk daftar yang hilang, lalu kirim ulang.
- Pengiriman ulang menimbulkan biaya pemanggilan baru yang harus dimasukkan ke anggaran.
Model ganda dan alur dependen harus ditangani secara terpisah
Satu file hanya bisa menggunakan satu model. Jika dalam proyek yang sama ingin model A melakukan klasifikasi dan model B melakukan ringkasan, maka perlu menyiapkan dua file terpisah, masing-masing dikirim dan masing-masing diambil hasilnya.
Yang lebih perlu diperhatikan adalah hubungan dependensi. Jika alurnya adalah “pertama meneliti materi, lalu berdasarkan kesimpulan penelitian menentukan apa yang akan ditulis”, langkah kedua bergantung pada output langkah pertama, maka Batch tidak akan mengatur otomatis kedua langkah tersebut untuk Anda. Anda perlu, setelah hasil batch pertama diambil, membuat program sendiri untuk menghasilkan permintaan batch kedua lalu mengirimkannya. Ini juga berarti total waktu seluruh rantai proses bisa menumpuk dari beberapa jendela pemrosesan.
Tugas apa saja yang cocok untuk OpenAI Batch API
| Jenis tugas | Cocok untuk Batch | Alasan |
|---|---|---|
| Klasifikasi batch berdasarkan aturan yang sudah ditetapkan | Cocok | Aturan tetap, item independen, tidak perlu pengembalian real-time |
| Pemrosesan basis pengetahuan (ringkasan, pembersihan, strukturisasi) | Cocok | Volume data besar, bisa diselesaikan offline |
| Evaluasi model, inferensi batch pada set pengujian | Cocok | Secara alami bersifat batch, tidak sensitif terhadap waktu |
| Pembuatan konten batch independen dengan model yang sama | Cocok | Setiap baris independen, kegagalan bisa dijalankan ulang berdasarkan custom_id |
| Layanan pelanggan real-time, interaksi percakapan | Tidak cocok | Pengguna membutuhkan balasan instan, sebaiknya gunakan cara sinkron |
| Tugas dengan tenggat waktu pengiriman yang ketat | Hati-hati | Jendela 24 jam tidak menjamin waktu tertentu |
| Alur multi-langkah yang meneliti dulu lalu menentukan konten | Perlu diatur sendiri | Batch tidak menangani dependensi antar langkah secara otomatis |
Cara sederhana untuk menilai adalah dengan bertanya tiga hal berturut-turut: Apakah hasilnya bisa didapat nanti? Apakah setiap permintaan saling independen? Apakah jumlahnya cukup besar sehingga layak menulis logika file dan pengambilan hasil? Jika ketiga jawabannya adalah “ya”, Batch biasanya menjadi pilihan yang lebih hemat. Selama ada satu jawaban “tidak”, maka perlu memecah tugas terlebih dahulu, atau tetap menggunakan pemanggilan sinkron.
Perubahan yang patut diperhatikan ke depannya
Karena ini adalah dokumen resmi yang terus dipelihara, cakupan model dan endpoint yang didukung, jumlah, serta batas ukuran bisa saja berubah. Penilaian berikut bersifat prediksi: seiring makin banyak model dan endpoint dimasukkan ke Batch, alur kerja evaluasi offline dan pemrosesan data akan lebih sering memakai pemrosesan batch secara default. Saat benar-benar mengintegrasikan, tetap ikuti aturan yang tercantum dalam dokumentasi pada saat itu; jangan langsung memakai angka dari tanggal verifikasi artikel ini.
Nilai Batch API terletak pada kemampuannya membuat kita berpikir jernih tentang hal-hal apa yang bisa ditunggu. Tugas yang bersedia menunggu ditukar dengan harga separuh dan kuota batas laju yang tidak terganggu; tugas yang harus segera direspons tetap diserahkan ke permintaan sinkron.
“Jangan ingin cepat, jangan melihat keuntungan kecil. Ingin cepat justru tidak akan sampai; melihat keuntungan kecil membuat hal besar tidak terwujud.” —《Analek Konfusius·Zilu》


