
Catatan penulis: Agent multi-proyek memerlukan konteks independen, status persisten, penjadwalan tugas, dan mekanisme pemulihan. Dengan begitu, pekerjaan paralel dapat dilacak dan tidak saling mengganggu.
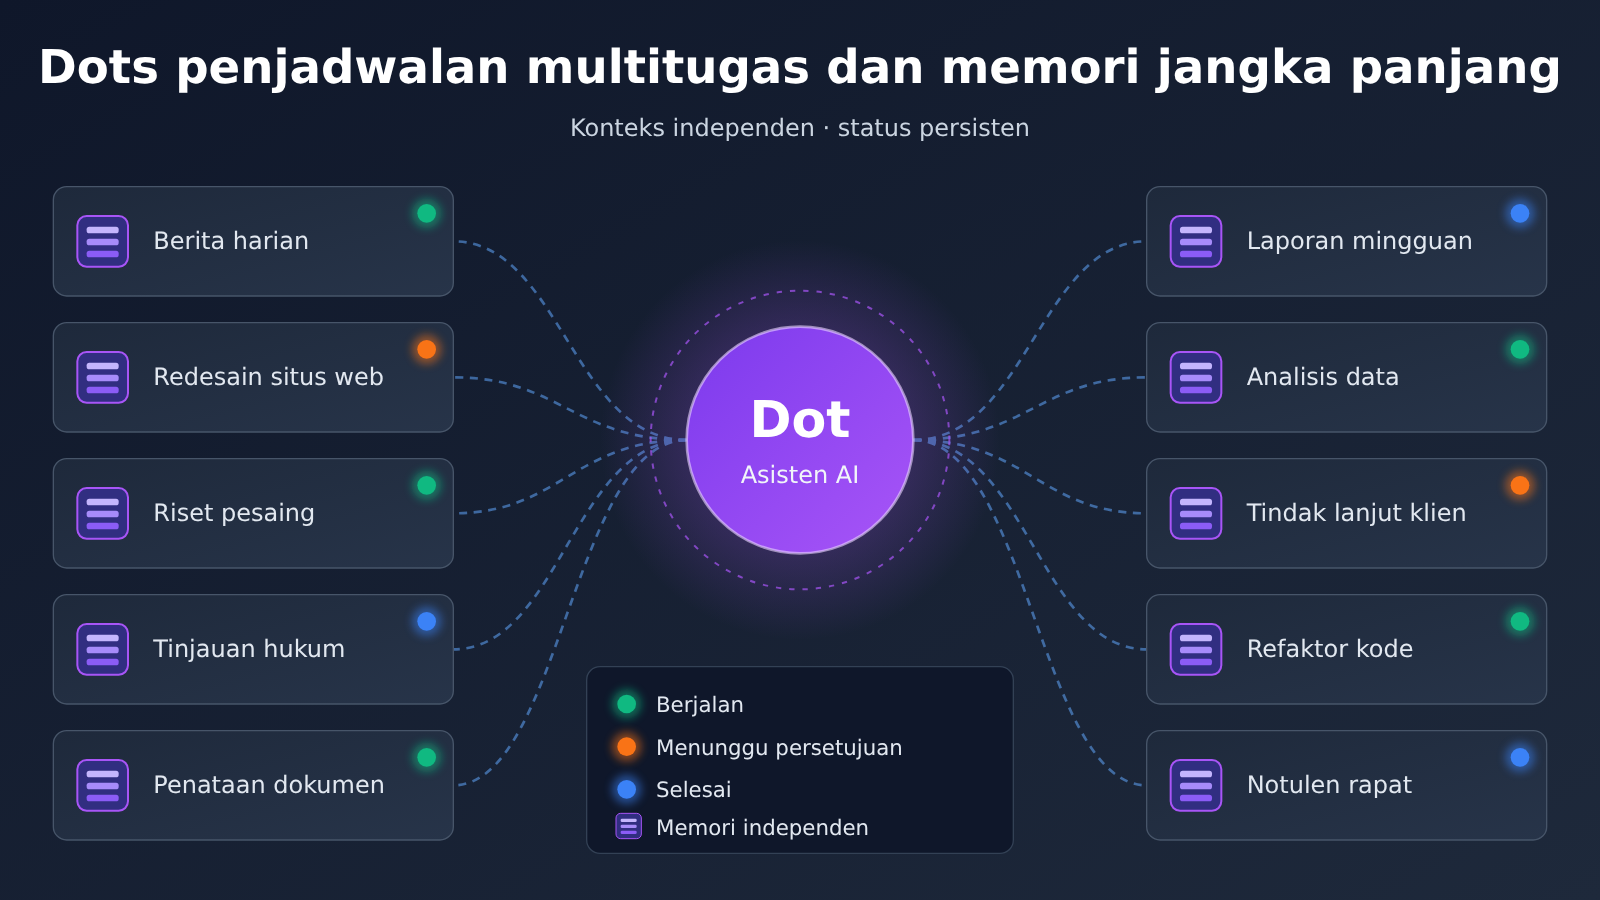
Apakah sebuah asisten AI dapat menjalankan beberapa proyek sekaligus bergantung pada empat hal: setiap pekerjaan memiliki konteks independen, status eksekusi disimpan secara persisten, penjadwal mengatur prioritas dan konkurensi secara terpusat, dan setelah gangguan pekerjaan dapat dipulihkan dari titik pemeriksaan. Memanggil beberapa model secara bersamaan tidak sulit; yang sulit adalah membuat setiap pemanggilan mengingat apa yang sedang dikerjakannya. Dots yang dirilis OpenAI pada 29 September 2026 mengadopsi pola ini. Dokumentasi resmi menyatakan bahwa satu Dot dapat memelihara beberapa butir tanggung jawab dan membagi pekerjaan ke Agent latar belakang untuk diproses secara paralel. Setiap tugas baru memiliki konteks percakapan sendiri dan tidak otomatis mendapatkan seluruh riwayat percakapan antara pengguna dan Dot. Pengembang dapat menggunakan Checkpointer, Store, antrean tugas, dan mesin status untuk membangun sistem manajemen multi-proyek yang serupa.
Berikut ini, berdasarkan materi resmi, kita uraikan lebih dulu mekanisme multitugas dan memori Dots, lalu dengan contoh manajemen proyek yang dipakai sepanjang artikel, kita rancang berturut-turut struktur tugas empat lapis, penjadwalan paralel, pemulihan setelah gangguan, pelacakan eksekusi, dan batas biaya. Angka “sepuluh proyek” dalam judul hanyalah ekspresi contoh untuk pola kerja; Dots maupun sistem yang dibangun sendiri tidak memiliki konkurensi sepuluh jalur yang tetap, dan tidak bisa berjalan paralel tanpa batas. Kode Agent buatan sendiri dalam artikel ini merupakan rancangan desain dan tidak menyertakan hasil eksekusi fiktif.
Yang Perlu Diketahui: Terminologi Terkait Penjadwalan Multitugas Dots
| Istilah | Penjelasan |
|---|---|
| Workspace | Ruang kerja untuk mengorganisasi proyek dan izin akses, biasanya terkait dengan satu pengguna atau satu tim. |
| Project | Unit proyek yang mencakup tujuan, materi, dan tugas-tugas terkait. |
| Task | Pekerjaan dengan tujuan yang jelas, misalnya “mencari berita OpenAI hari ini”. |
| Run | Catatan eksekusi aktual dari suatu tugas; Task yang sama dapat dieksekusi berkali-kali. |
| Agent Latar Belakang | Pelaksana yang dikirim Dots untuk menangani subtugas secara paralel; setelah selesai, ia melapor kembali kepada Dots. |
| Checkpointer | Komponen yang menyimpan checkpoint eksekusi tugas dan bertanggung jawab memulihkan kondisi setelah terjadi interupsi. |
| Store | Komponen penyimpanan informasi jangka panjang lintas tugas, yang bertanggung jawab menjaga kesinambungan konteks proyek. |
| Mesin Status | Mekanisme yang mengatur perpindahan antar-tahap tugas sesuai aturan, seperti menunggu eksekusi, sedang berjalan, dan menunggu persetujuan. |
| Batas Konkurensi | Batas maksimum jumlah tugas yang dieksekusi secara bersamaan, yang dipengaruhi oleh kuota API, sumber daya server, dan biaya. |
| Tracing | Kemampuan mencatat pemanggilan model, pemanggilan alat, dan proses serah terima. |
| Proactive Research | Penelitian latar belakang hanya-baca yang dilakukan Dots pada sumber materi yang telah diizinkan ketika tidak ada pesan baru. |
1 Penjadwalan multitugas Dots: mengapa satu Dot bisa memikul beberapa tanggung jawab sekaligus
1.1 Kemampuan multi-proyek yang diungkap resmi Dots
Menurut posisi resminya, Dots adalah Agent personal yang selalu aktif. Ia punya komputer cloud dan browser sendiri, sehingga pekerjaan yang sudah didelegasikan tetap bisa berjalan meski pengguna sudah pergi. Soal multitugas, dokumentasi Tasks and memory mencantumkan kemampuan berikut:
- Menyimpan status beberapa urusan pekerjaan sekaligus, dan berpindah tugas dalam satu percakapan yang sama;
- Pengguna dapat menambahkan informasi atau mengubah prioritas kapan saja;
- Memecah tugas kompleks menjadi beberapa bagian, lalu menyerahkannya ke Agent latar belakang untuk diproses secara paralel;
- Membuat thread tugas terpisah yang terlihat, lalu mengumpulkan dan merangkum hasil tiap tugas;
- Meminta pengguna ikut campur saat pekerjaan terhambat; selama tugas latar belakang berjalan, pengguna tetap bisa terus mengirim pesan.
Semua kemampuan ini membuat peran Dot lebih mirip koordinator proyek. Ia yang memutuskan mana yang dikerjakan dulu, mana yang dipecah dan dilempar ke belakang, dan mana yang dikembalikan ke pengguna. Eksekusi konkret satu tugas bisa ditangani oleh Agent latar belakang, tugas ChatGPT Work, atau tugas Codex.
1.2 Perbedaan antara multi-percakapan, multitugas, dan multi-Agent
Ketiga konsep ini sering tertukar, padahal masing-masing menyelesaikan masalah yang berbeda. Mari pakai satu contoh yang sama: anggaplah ruang kerja pengguna berisi tiga proyek, yaitu AI Radar (buletin harian berita AI), Website (perombakan situs), dan Research (riset kompetitor).
| Mode | Cara kerja | Perwujudan dalam contoh | Masalah yang diselesaikan |
|---|---|---|---|
| Multi-percakapan | Pengguna membuka satu jendela chat untuk tiap proyek | Pengguna sendiri yang mengingat sampai tahap mana Research sudah jalan | Memisahkan isi chat; progres tetap dikelola manusia |
| Multitugas | Satu koordinator memelihara status beberapa tugas | Dot mencatat progres dan prioritas masing-masing dari ketiga proyek | Penjadwalan dan pelacakan status yang terpadu |
| Multi-Agent | Koordinator membagikan subtugas ke beberapa eksekutor | Agent latar belakang mengumpulkan bahan, eksekutor lain menulis laporan | Eksekusi paralel dan pembagian kerja sesuai keahlian |
Dots menumpuk ketiganya: pengguna berkomunikasi dengan Dot lewat satu pintu masuk, Dot memelihara banyak tugas, dan mengirim Agent latar belakang sesuai kebutuhan. Kalau membangun sistem sendiri, ketiga lapisan kemampuan itu harus diwujudkan semua; sekadar membuka banyak jendela chat jelas tidak cukup.
1.3 Pengamatan paralel dari seorang pengguna
Seorang pengguna di Reddit menuturkan pengujian yang ia lakukan dalam sehari. Ia menyerahkan ratusan PDF dan dokumen ribuan halaman untuk ditinjau Dot, sambil menjalankan tugas riset hukum. Ia mengamati tiga proses eksekusi yang berjalan bersamaan: komputer cloud milik Dot sendiri menangani tugas A, satu komputer Linux yang ia hubungkan menangani tugas B, dan satu Agent riset latar belakang menangani tugas C. Ia juga menyebut pernah menemui lingkungan eksekusi tidak tersedia saat memulai tugas riset hukum mandiri, dan pengiriman baru berhasil setelah ia menghubungkan komputer lokal.
Pengamatan pribadi ini menunjukkan bahwa komputer cloud Dot, komputer lokal, dan lingkungan Work/Codex adalah sumber daya eksekusi yang berbeda. Penulisnya sendiri juga menegaskan bahwa ia belum memverifikasi apakah jalur-jalur tersebut punya kuota yang terpisah dan tak terbatas. Jadi pengujian ini hanya menunjukkan bahwa Dots mampu mendistribusikan pekerjaan ke lingkungan yang berbeda; dari situ tidak bisa disimpulkan bahwa setiap pengguna Pro akan mendapat skala paralel yang sama.
2 Memori jangka panjang Dots: mengapa sebuah tugas memerlukan memori independen
2.1 Batas konteks tugas baru
Dokumentasi resmi menyatakan dengan jelas: setiap tugas baru memiliki konteks percakapan sendiri dan tidak otomatis mendapatkan seluruh riwayat percakapan antara Dot dan pengguna. Dot dapat menelusuri percakapan ChatGPT sebelumnya untuk mencari latar belakang; konten yang ditemukan hanya digunakan sebagai konteks untuk pekerjaan saat ini.
Desain ini sangat praktis. Jika setiap tugas memuat seluruh riwayat, laporan pesaing dari proyek Research bisa tercampur dengan diskusi perubahan desain proyek Website, dan konteks akan semakin panjang serta semakin mahal. Proyek jangka panjang perlu mengelola secara eksplisit “apa yang harus diketahui tugas ini”; mengandalkan satu catatan obrolan yang terus memanjang tidak bisa melakukan itu.
2.2 Empat lapisan data memori Dots
Berdasarkan materi resmi, konteks Dot berasal dari empat sumber berbeda:
- Memori ChatGPT: Dot dapat membaca memori terkait dan percakapan terbaru di ChatGPT;
- Catatan Dot sendiri: mengumpulkan preferensi pengguna, kebiasaan kerja, keputusan proyek, dan hal-hal yang menjadi tanggung jawab jangka panjang;
- Konteks tugas saat ini: instruksi, file, hasil penelusuran, dan hasil eksekusi alat dalam percakapan ini;
- Data aplikasi yang terhubung: Dot membaca data aplikasi yang telah diizinkan dan dapat membentuk memori melalui riset aktif.
Siklus hidup setiap lapisan berbeda. Memori ChatGPT dan catatan Dot termasuk lapisan data yang berbeda; menonaktifkan berbagi Memori ChatGPT tidak otomatis menghapus informasi yang telah diperoleh Dot, dan memutus plugin hanya akan menghentikan akses baru. Hingga 16 November 2026, pengguna masih belum dapat melihat, mengubah, atau menghapus memori independen Dot satu per satu; menghapus Dot akan memulai penghapusan konteks Dot itu sendiri. Saat merancang lapisan memori untuk sistem yang dibangun sendiri, kita dapat merujuk pada pendekatan berlapis ini sekaligus menambahkan antarmuka pengelolaan yang memungkinkan melihat dan menghapus.
3 Checkpointer dan Store: Dua Jenis Memori untuk Agent Multi-tugas
Dokumentasi persistensi LangGraph membagi memori Agent menjadi dua kategori. Pembagian ini tepat sejalan dengan “konteks tugas” dan “catatan jangka panjang” di Dots. Berikut masih menggunakan contoh laporan kompetitor bulanan dari proyek Research.
3.1 Checkpointer: Mengingat Sejauh Mana Pekerjaan Sudah Berjalan
Checkpointer menyimpan snapshot eksekusi dari satu thread tugas, mencakup langkah saat ini, tool yang sudah dipanggil, hasil yang dikembalikan tool, dan langkah mana yang sedang menunggu persetujuan manusia. Dalam contoh, tugas laporan bulanan sudah selesai mengambil halaman harga dari 6 kompetitor dan sedang bersiap melakukan analisis ketika layanan restart. Dengan adanya checkpoint, tugas dapat dilanjutkan dari langkah “analisis”, dan data yang sudah diambil tidak perlu diambil ulang.
Media penyimpanan menentukan apakah checkpoint dapat bertahan melewati restart. Implementasi berbasis memori cocok untuk pengembangan dan pengujian, tetapi status akan hilang setelah proses restart; persistensi lokal dapat menggunakan SQLite, sedangkan layanan yang di-deploy jangka panjang lebih cocok menggunakan PostgreSQL. Checkpoint akan terus bertambah, sehingga sistem produksi juga perlu menetapkan strategi pembersihan untuk status lama.
3.2 Store: Mengingat Latar Belakang Proyek
Store menyimpan materi jangka panjang lintas tugas dan lintas sesi, misalnya preferensi pengguna, latar belakang proyek, keputusan historis, dan pengetahuan yang dibagikan antar beberapa tugas. Dalam contoh, “pembaca laporan adalah tim produk”, “hanya memantau harga API dan pembaruan fitur”, dan “bulan lalu sudah diputuskan untuk berhenti memantau salah satu kompetitor yang tidak lagi memperbarui produk” semuanya termasuk isi Store. Saat membuat tugas laporan baru bulan depan, Store akan membaca keputusan-keputusan ini, sehingga pengguna tidak perlu menjelaskannya lagi.
3.3 Perbandingan Tanggung Jawab Checkpointer dan Store
| Dimensi | Checkpointer | Store |
|---|---|---|
| Cakupan | Satu thread tugas | Multi-tugas, lintas thread |
| Isi yang disimpan | Snapshot status eksekusi | Materi dan fakta jangka panjang |
| Nilai inti | Melanjutkan pekerjaan setelah terputus | Melanjutkan latar belakang proyek untuk tugas baru |
| Contoh isi | “Sudah mengambil 6 halaman harga, langkah berikutnya analisis” | “Pembaca laporan adalah tim produk” |
| Siklus hidup | Mengikuti status tugas, dapat dibersihkan setelah selesai | Dipertahankan dan diperbarui sesuai strategi memori jangka panjang |
Keduanya memiliki pembagian peran yang jelas dan tidak bisa saling menggantikan. Hanya dengan Checkpointer, setiap tugas baru seperti karyawan baru yang baru masuk; hanya dengan Store, begitu tugas terputus harus memulai dari awal lagi.
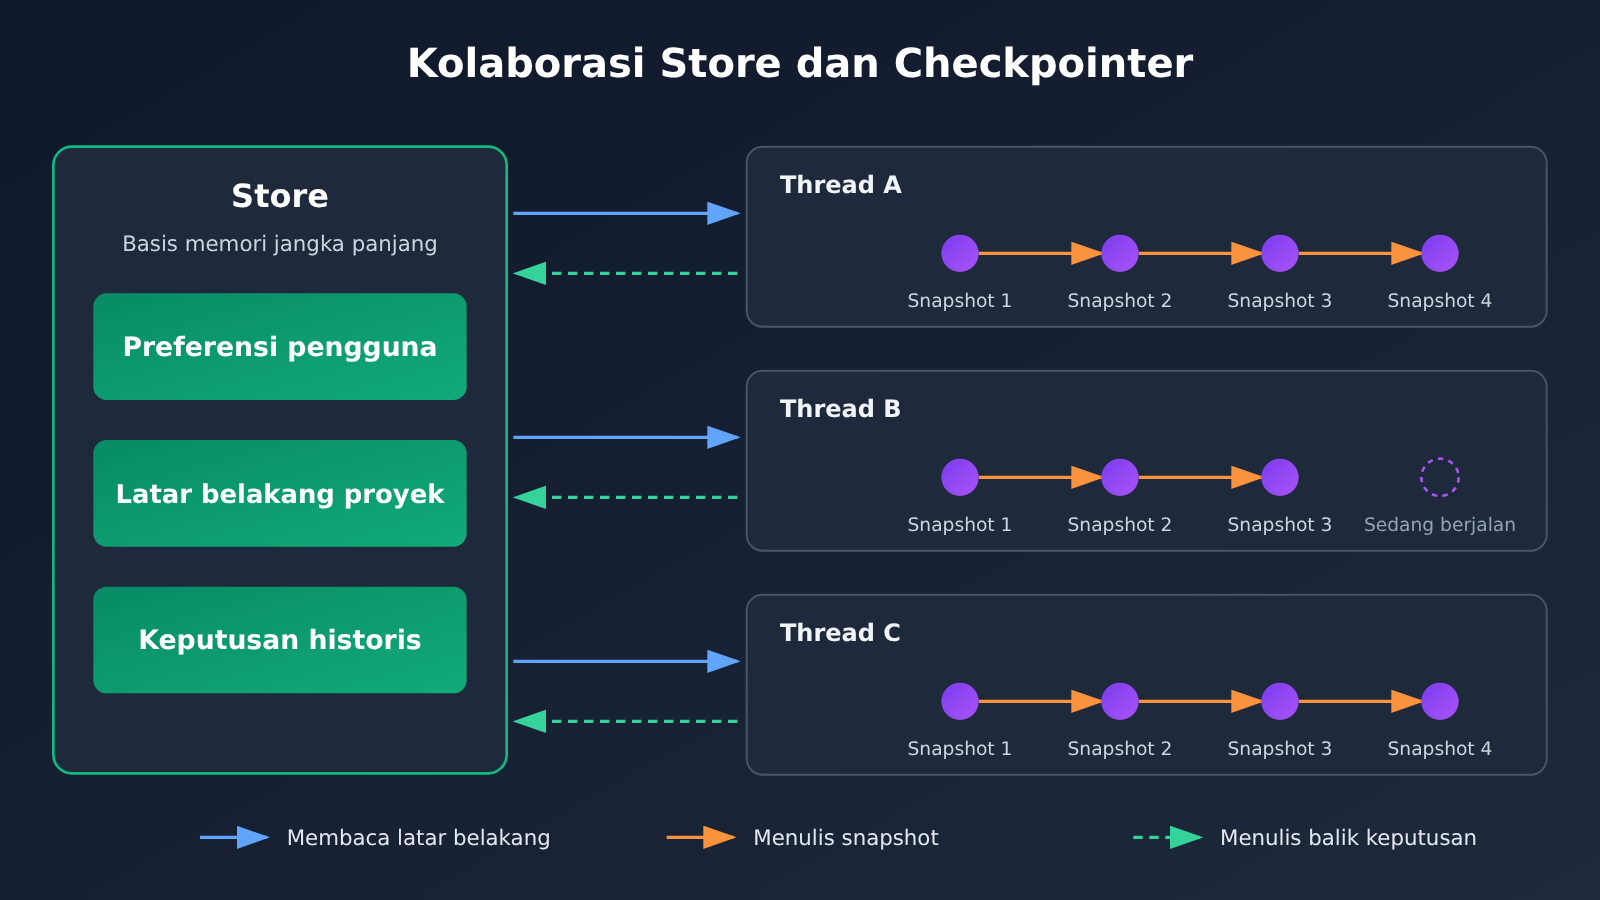
Siklus “membaca latar belakang—menulis snapshot—menulis kembali keputusan” pada gambar di atas dapat dipetakan langsung ke kode di bagian 6. Kode contoh memanggil model melalui antarmuka kompatibel OpenAI dari APIYI di apiyi.com; saat mengganti model, cukup mengubah nama model.
4 Desain Sistem Manajemen Tugas Multi-Proyek: Workspace, Project, Task, Run
4.1 Struktur Empat Lapis dengan ID Independen
Untuk Agent multi-proyek yang dibangun sendiri, disarankan memakai struktur empat lapis, di mana setiap lapis memiliki ID independen:
| Lapisan | Fungsi | Contoh |
|---|---|---|
| Workspace | Mengelola workspace dan izin satu pengguna | regulus |
| Project | Mengelola tujuan dan materi proyek independen | AI Radar, Website, Research |
| Task | Mengelola tugas spesifik | Daily News, Monthly Report |
| Run | Mencatat eksekusi aktual tertentu | Eksekusi Daily News pada 2026-11-16 09:00 |
Struktur pohon yang sesuai adalah sebagai berikut:
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Memisahkan pencatatan Task dan Run adalah kunci. Daily News berjalan sekali sehari, dan setiap Run memiliki input, output, durasi, serta statusnya sendiri. Jadi kalau ada masalah, kita bisa melacaknya secara presisi sampai ke eksekusi tertentu pada hari tertentu.
4.2 Cakupan Akses Memori dan Isolasi Proyek
Saat satu Agent mengelola banyak proyek, file antarproyek secara default tidak boleh saling dibaca. Disarankan membagi cakupan akses memori berdasarkan lapisan:
- Preferensi umum pengguna (misalnya laporan dalam bahasa Mandarin, kesimpulan di awal): dapat dibaca oleh semua proyek yang diizinkan;
- Latar belakang proyek (misalnya pembaca dan cakupan pemantauan Research): hanya dapat dibaca oleh tugas proyek tersebut;
- Catatan tugas sekali jalan: hanya dapat dibaca oleh tugas saat ini dan tugas terkait yang diizinkan secara eksplisit;
- Data pelanggan perusahaan: hanya dapat dibaca oleh proyek pelanggan yang ditunjuk;
- Kredensial sensitif: disimpan di penyimpanan aman terpisah, tidak pernah masuk ke konteks model.
Saat berbagi materi antarproyek, catat sumber dan cakupan izinnya. Ini konsisten dengan pendekatan Dots: dokumentasi resmi menyebutkan bahwa konteks Dot tidak menyimpan kredensial, gambar, dan tangkapan layar, sedangkan batas izin dikendalikan bersama oleh otorisasi plugin dan Custom Rules.
5 Penjadwalan multitugas: bagaimana membuat tugas berjalan paralel tanpa saling mengganggu
5.1 Memisahkan penjadwal dari penalaran Agent
Sebaiknya serahkan “kapan dilakukan” dan “bagaimana melakukannya” kepada dua komponen. Penjadwal bertanggung jawab atas waktu mulai, pemilihan proyek, jumlah yang sedang berjalan, prioritas, timeout, dan percobaan ulang; Agent bertanggung jawab memahami tugas, menyusun langkah, memilih alat, menganalisis hasil, dan mengirimkan hasil. Dengan begitu, aturan penjadwalan dapat dijalankan secara deterministik, dan model hanya menangani bagian yang memang memerlukan penalaran.
Untuk pilihan teknologi, Anda bisa mempertimbangkan kombinasi ini: APScheduler mengelola tugas berkala, Celery menjadi antrean tugas latar belakang, Redis menangani pesan dan koordinasi jangka pendek, PostgreSQL menyimpan status proyek dan eksekusi, dan framework seperti LangGraph mengelola alur Agent serta status persisten. Prototipe skala kecil pun bisa berjalan dengan asyncio Python plus SQLite; kode di bagian 6 dirancang seperti itu.
5.2 Tiga cara menjalankan paralel
Agent multitugas setidaknya memiliki tiga bentuk paralel:
- Paralel tugas independen: berita harian AI Radar dan laporan bulanan Research tidak saling bergantung, sehingga bisa berjalan bersamaan;
- Paralel subtugas: satu proyek dipecah menjadi subtugas seperti pengumpulan materi dan verifikasi fakta yang dikerjakan masing-masing;
- Paralel peran model: model berbeda menangani pekerjaan spesialis berbeda, lalu digabungkan di akhir.
Batasan yang menentukan bisa atau tidaknya paralel meliputi kuota konkurensi API, sumber daya server, ketergantungan tugas, persaingan penulisan basis data, biaya model, konflik hasil, dan eksekusi ganda.
5.3 Contoh: pengumpulan materi, analisis data, pembuatan laporan
Laporan bulanan proyek Research dipecah menjadi tiga subtugas. Pengumpulan materi bisa berjalan paralel dengan berita harian AI Radar; analisis data bergantung pada hasil pengumpulan materi sehingga harus menunggunya selesai; pembuatan laporan bergantung pada kesimpulan analisis, dan setelah selesai masuk ke status menunggu persetujuan — baru dianggap terkirim setelah pengguna mengonfirmasi.
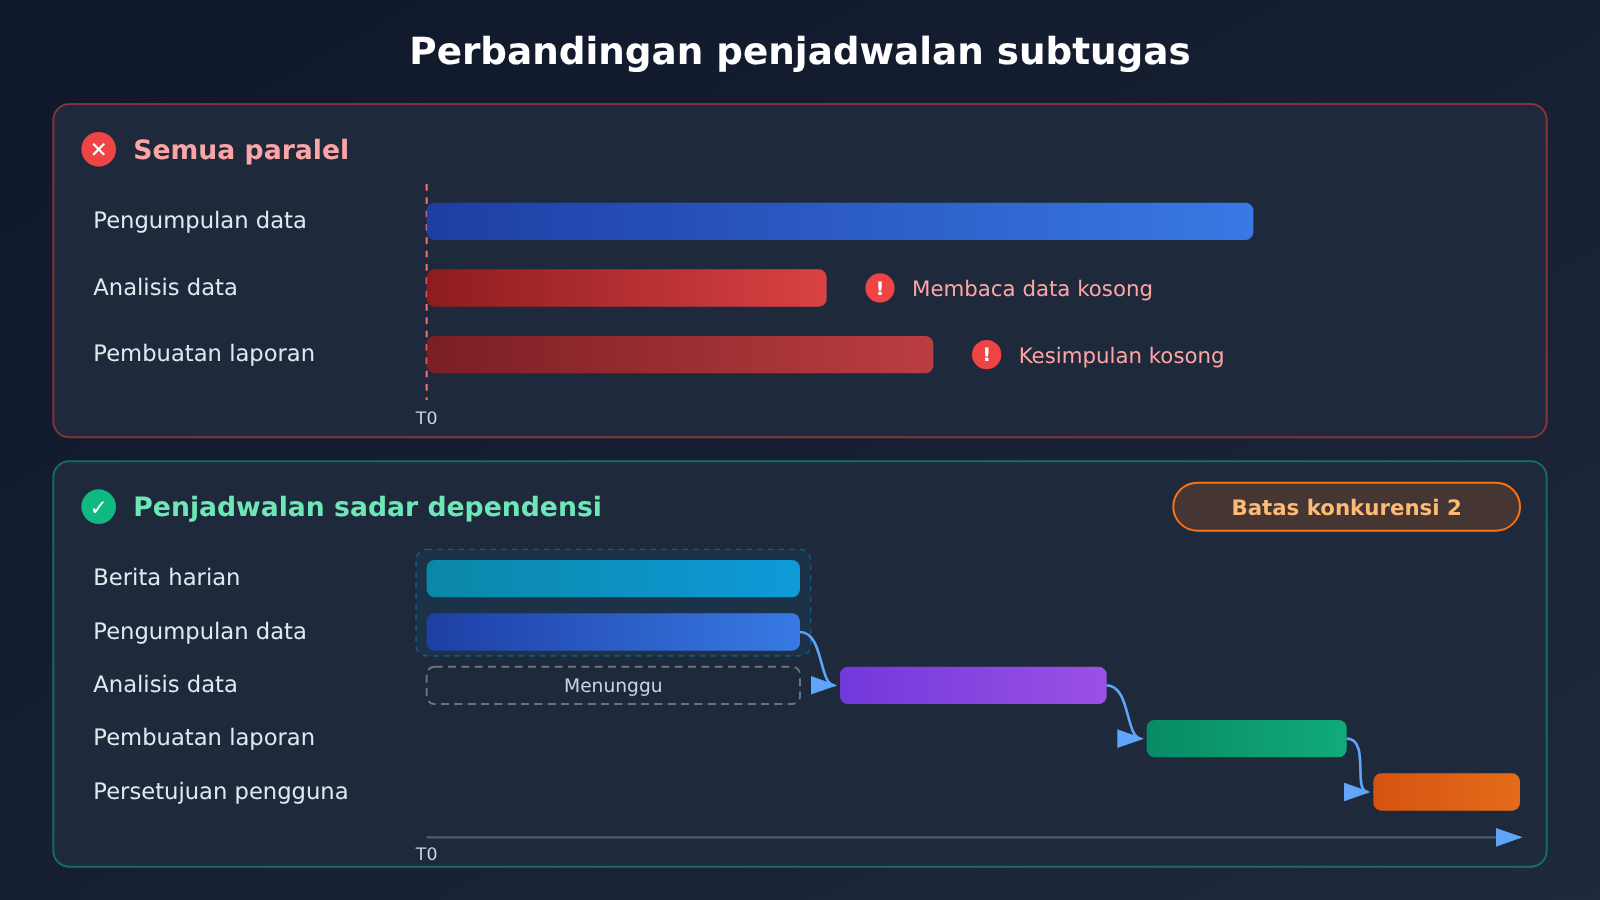
Menjalankan ketiga subtugas sekaligus terlihat lebih cepat, tetapi analisis data bisa menghasilkan kesimpulan kosong karena tidak mendapat materi, bahkan mengarang data sendiri. Hubungan dependensi menentukan tugas mana yang harus serial, batas konkurensi menentukan berapa banyak yang bisa berjalan sekaligus; keduanya sebaiknya ditulis ke dalam penjadwal, karena menyerahkannya pada penilaian spontan model mudah menimbulkan kesalahan.
5.4 Pembagian peran model
| Subtugas | Jenis model yang disarankan | Alasan pemilihan | Platform yang tersedia |
|---|---|---|---|
| Pengumpulan materi dan ringkasan | Model ringan dan cepat | Volume pemanggilan besar, sensitif terhadap biaya | APIYI apiyi.com, API resmi |
| Analisis data | Model dengan kemampuan penalaran kuat | Membutuhkan perbandingan dan perhitungan bertahap | APIYI apiyi.com, API resmi |
| Pembuatan laporan | Model dengan kemampuan menulis teks panjang yang kuat | Tuntutan tinggi pada kualitas struktur dan ekspresi | APIYI apiyi.com, API resmi |
| Verifikasi fakta | Model yang berbeda dari model penulisan | Validasi silang, mengurangi kesalahan dari sumber yang sama | APIYI apiyi.com, API resmi |
Model spesifik mengacu pada daftar model platform saat ini. Ketika satu kunci API terhubung ke beberapa model, pembagian peran dapat disesuaikan lewat konfigurasi tanpa mengubah struktur kode.
6 Mulai cepat: membangun prototipe Agent multi-tugas dengan antarmuka terpadu
6.1 Contoh minimal: menyuntikkan latar belakang proyek ke dalam tugas
Kode di bawah ini menunjukkan poin paling inti: sebelum tugas dijalankan, ambil dari memori jangka panjang hanya latar belakang proyek yang bersangkutan.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI
)

# Store: latar belakang jangka panjang yang diisolasi per proyek
project_memory = {
    "research": "读者:产品团队;只跟踪 API 价格与功能更新;报告结论先行",
    "ai-radar": "每日 09:00 汇总 OpenAI、Anthropic、Google 官方动态",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"项目背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "列出本月需要关注的竞品更新清单"))
6.2 Rancangan Lengkap: State Machine, Checkpoint, Dependensi, dan Konkurensi
Kode berikut adalah sebuah rancangan desain yang mencakup Store, Checkpoint, state machine, penjadwalan dependensi, pembatasan konkurensi, retry, timeout, dan pencatatan eksekusi, yang digunakan untuk menjelaskan bagaimana setiap komponen bekerja sama. Rancangan ini belum terverifikasi di lingkungan produksi, dan artikel ini juga tidak menyajikan hasil eksekusi fiktif.
Lihat kode rancangan lengkap
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, satu kunci API untuk beralih antar beberapa model
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """Hanya membaca cakupan yang diizinkan: user dan project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"长期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游结果:\n{upstream or '无'}"},
    ]
    async with sem:  # Batasi konkurensi
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # Timeout atau error API: coba lagi dengan backoff eksponensial
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # Tugas prasyarat gagal, menunggu persetujuan, atau ada dependensi melingkar
            print("阻塞任务:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "汇总今日 AI 官方动态", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月竞品 API 价格与功能变更", "gpt-4.1-mini"),
    Task("analyze", "research", "对比变更并归纳趋势", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度竞品报告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
Ada beberapa bagian dalam kode yang mencerminkan desain yang sudah dibahas sebelumnya. store_get hanya membaca user dan cakupan proyek saat ini, sehingga tercipta isolasi antarproyek; tabel checkpoint mencatat setiap langkah per run, dan bersama tabel runs menyimpan Token serta status akhir; schedule memakai hubungan dependensi untuk menentukan eksekusi serial, dan semaphore untuk membatasi konkurensi. Sistem nyata masih perlu dilengkapi pemanggilan tool, callback persetujuan, dan titik masuk untuk pemulihan.
🚀 Mulai cepat: Pada tahap membangun prototipe, disarankan mengambil kuota uji gratis lewat APIYI apiyi.com, lalu memakai Key yang sama untuk mengonfigurasi model berbeda bagi tiga peran — pengumpul, analis, dan penulis — kemudian membandingkan hasil serta biaya sebelum menetapkan pembagian tugas.
7 Bagaimana Agent multitugas menangani interupsi, kegagalan, dan persetujuan manusia
7.1 State machine tugas
Kemajuan tugas harus dicatat lewat status yang eksplisit; progres yang diceritakan model di obrolan hanya bisa dijadikan referensi. Alur utama yang disarankan adalah Pending (menunggu eksekusi) → Running (sedang berjalan) → Waiting (menunggu kondisi eksternal) atau Approval (menunggu persetujuan) → Completed (selesai), ditambah tiga status penghentian atau jeda: Failed, Cancelled, dan Paused. Setiap transisi status ditulis ke database, dan penjadwal hanya mengambil keputusan berdasarkan status yang ada di database.
7.2 Percobaan ulang, timeout, dan pemulihan dari jeda
- Percobaan ulang: Setelah error antarmuka atau timeout, lakukan percobaan ulang dengan backoff eksponensial dan catat retry_count, agar langkah yang sering gagal mudah ditemukan;
- Timeout: Tetapkan batas waktu eksekusi untuk setiap Run; bila terlampaui, status berubah menjadi Failed dan muncul peringatan, sehingga tugas yang macet tidak terus-menerus memakan kuota konkurensi;
- Pemulihan dari jeda: Saat dijeda, simpan checkpoint; saat dilanjutkan, lanjutkan dari checkpoint terakhir, sehingga pemanggilan tool yang sudah selesai tidak perlu diulang;
- Idempotensi: Untuk langkah yang punya efek samping seperti mengirim email atau menulis ke database, periksa dulu apakah sudah dieksekusi sebelum mencoba ulang, agar tidak terjadi operasi ganda.
Ada satu detail menarik dalam materi resmi Dots: menghentikan tugas yang sedang berjalan dan membatalkan jadwal berkala yang sudah dibuat adalah dua hal berbeda. Saat Dot dijeda, Work, Codex, dan tugas terjadwal yang independen pun bisa tetap berjalan. Sistem yang dibangun sendiri sebaiknya merancang “hentikan Run ini”, “jeda Task”, dan “batalkan jadwal berkala” sebagai tiga operasi yang terpisah.
7.3 Persetujuan manusia: mengacu pada Custom Rules milik Dots
Dots memakai Custom Rules untuk membagi perilaku menjadi empat tingkat: langsung dieksekusi tanpa bertanya, dieksekusi setelah otorisasi sebelumnya, bertanya sebelum eksekusi, dan diserahkan kembali kepada pengguna. Operasi seperti mengubah kata sandi atau memindahkan dana harus diambil alih oleh pengguna; menghapus data secara permanen atau memasang perangkat lunak mungkin menuntut persetujuan setiap kali. Persetujuan pengguna pun tidak bisa menimpa batasan keamanan inti.
Sistem yang dibangun sendiri bisa meniru pendekatan ini dengan memberi label pada setiap tool. Pencarian hanya-baca langsung dieksekusi; draf laporan masuk ke Approval setelah selesai dibuat; pengiriman ke pihak luar, pembayaran, dan penghapusan selalu diserahkan kepada manusia. Tugas laporan pada contoh menyetel needs_approval=True, sehingga setelah dibuat ia berhenti pada status persetujuan dan baru ditulis sebagai Completed setelah pengguna mengonfirmasi.
8 Pelacakan eksekusi Agent multi-tugas: Tracing dan log
Saat beberapa proyek berjalan paralel, pertanyaan yang paling sering diajukan pengguna adalah “apa sebenarnya yang dilakukannya”. Tracing di OpenAI Agents SDK dapat mencatat Agent mana yang dipanggil, model mana yang dipakai, pemanggilan alat apa saja yang terjadi, di mana handoff dilakukan, pemeriksaan keamanan apa yang terpicu, dan bagaimana tugas akhirnya berakhir.
Tracing unggul dalam merekonstruksi proses eksekusi tunggal; statistik tingkat proyek masih perlu dilengkapi dengan log bisnis. Sebaiknya setiap Run mencatat setidaknya project_id, task_id, run_id, model_id, input_tokens, output_tokens, tool_calls, duration, retry_count, dan final_status. Dengan field-field ini, kita dapat menjawab pertanyaan manajemen seperti “berapa token yang dihabiskan proyek Research bulan ini”, “langkah mana yang paling sering diulang”, dan “tugas analisis model mana yang paling sering timeout”. Tabel runs di Bagian 6 adalah implementasi minimal dari kumpulan field ini.
9 Batas biaya dan pengelolaan Agent multi-tugas
9.1 Struktur biaya Dots
Per 16 November 2026, pengguna individu dapat menggunakan Dots melalui tiga tingkatan langganan ChatGPT Pro 100, Pro 200, dan Pro 500, dengan biaya bulanan masing-masing 100, 200, dan 500 dolar AS. Dokumentasi resmi tidak mencantumkan biaya bulanan Dot tersendiri dalam penjelasan Dots untuk Pro individu. Tugas ChatGPT Work atau Codex yang didelegasikan Dot dihitung berdasarkan kuota dan aturan produk yang bersangkutan; konsumsinya bergantung pada model, konteks, penalaran, pemanggilan alat, dan pengambilan informasi. Penggunaan Pro individu juga memiliki batasan usia (18 tahun ke atas) dan wilayah; tidak mencakup Wilayah Ekonomi Eropa, Inggris, dan Swiss.
Penagihan untuk workspace perusahaan berbeda. Dokumentasi resmi yang berlaku menyatakan bahwa workspace perusahaan yang memenuhi syarat dapat memilih tarif tetap per jenis pekerjaan atau penagihan berbasis penggunaan; gratis selama masa pratinjau, dan mulai 18 November 2026 penagihan dimulai untuk Dots yang sudah diaktifkan; tugas yang didelegasikan ke Work atau Codex ditagih terpisah. Jumlah pastinya mengikuti harga yang berlaku di workspace tersebut.
9.2 Sumber biaya sistem yang dibangun sendiri
Biaya Agent multi-tugas yang dibangun sendiri terutama berasal dari empat hal:
- Membaca ulang konteks: setiap tugas menyuntikkan latar belakang proyek; semakin panjang latar belakang, semakin banyak token input pada tiap pemanggilan, dan isi di Store perlu diringkas secara berkala;
- Percobaan ulang dan kegagalan: satu tugas analisis yang gagal akan mengirim ulang materi dari tahap sebelumnya ke model sekali lagi;
- Pilihan model: jika semua subtugas memakai model terkuat, biaya akan meningkat berlipat ganda;
- Kuota konkrensi: batas laju API menentukan jumlah pekerjaan paralel yang benar-benar tersedia.
9.3 Jumlah paralel dan volume kerja efektif
Jumlah paralel dan volume kerja efektif adalah dua hal yang berbeda. Memulai tugas yang dependensinya belum terpenuhi lebih awal hanya akan menghasilkan hasil yang tidak berguna; kesimpulan yang saling bertentangan harus digabungkan secara manual; jika data keliru dari satu proyek menyebar ke proyek lain melalui memori bersama, biaya pengerjaan ulang akan lebih tinggi. Cara yang masuk akal adalah memastikan isolasi proyek dan dependensi sudah benar terlebih dahulu, lalu menaikkan batas konkrensi secara bertahap berdasarkan data pemantauan.
10 Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa itu penjadwalan multi-tugas pada Dots?
Satu Dot memelihara beberapa tanggung jawab sekaligus. Pengguna dapat berpindah tugas dan menyesuaikan prioritas; Dot memecah pekerjaan rumit lalu menyerahkannya ke Agent latar belakang untuk diproses secara paralel, merangkum hasilnya, dan mengembalikannya ke pengguna saat keputusan perlu diambil.
Q2: Apakah memori jangka panjang Dots mengingat semua percakapan historis?
Tidak, semuanya tidak dimuat. Tugas baru punya konteks percakapannya sendiri; Dot bekerja dengan mengandalkan ChatGPT Memory, catatannya sendiri, konteks tugas saat ini, dan data dari aplikasi yang terhubung, lalu mengambil percakapan lampau saat dibutuhkan.
Q3: Apakah Checkpointer dan Store bisa saling menggantikan?
Keduanya punya tanggung jawab yang berbeda. Checkpointer menyimpan snapshot eksekusi satu tugas untuk pemulihan setelah gangguan; Store menyimpan latar belakang proyek dan keputusan lintas tugas, supaya tugas baru bisa melanjutkan konteks. Untuk proyek jangka panjang, keduanya dibutuhkan.
Q4: Berapa banyak tugas yang bisa dijalankan Dots secara paralel sekaligus?
Dokumentasi resmi tidak menyebutkan angka konkurensi yang tetap. Dots mendukung eksekusi paralel, tetapi lingkungan eksekusi dan kuota penggunaan punya batasannya. Seorang pengguna Reddit mengaku mengamati tiga proses eksekusi berjalan bersamaan, tapi itu hanya hasil pengujian pribadinya.
Q5: Bagaimana cara cepat memanggil berbagai model pada Agent multi-proyek yang dibangun sendiri?
Bisa menggunakan antarmuka agregator yang kompatibel dengan OpenAI. Setelah mendaftar di APIYI apiyi.com untuk mendapatkan kunci API dan kuota uji gratis, setel `base_url` pada kode di artikel ini ke `https://api.apiyi.com/v1`, maka dengan satu set kode yang sama Anda dapat mengonfigurasi model GPT, Claude, Gemini, dan lainnya untuk berbagai subtugas.
Q6: Bagaimana mengendalikan biaya model pada Agent multi-tugas?
Alokasikan model berdasarkan peran: model ringan untuk pengumpulan materi, model kuat untuk analisis dan penulisan; ringkas latar belakang proyek di Store; gunakan tabel runs untuk menghitung Token tiap proyek. Dengan penagihan sesuai pemakaian lewat APIYI apiyi.com, Anda bisa menguji dalam skala kecil dulu sebelum menentukan kuota.
Q7: Apa yang perlu diperhatikan soal keamanan pada Dots dan sistem yang dibangun sendiri?
Agent bisa salah memahami tugas, salah menilai materi, atau terkena Prompt Injection; pihak resmi juga menyatakan langkah perlindungan yang ada belum bisa menghilangkan seluruh risiko. Operasi yang menyangkut akun, dana, atau pengiriman ke pihak luar sebaiknya diberi persetujuan manual, dan kredensial sensitif jangan dimasukkan ke konteks model.
11 Dots: Penjadwalan Multitugas dan Memori Jangka Panjang — Poin-Poin Utama
- Tantangan inti: Kunci dari Agent multitugas terletak pada konteks independen, status persisten, penjadwalan, dan pemulihan.
- Mekanisme Dots: Satu Dot mengoordinasikan beberapa hal, Agent latar belakang mengeksekusi secara paralel, dan konteks tugas baru saling independen.
- Dua jenis memori: Checkpointer bertanggung jawab memulihkan eksekusi, Store bertanggung jawab melanjutkan latar belakang proyek.
- Struktur empat lapis: Workspace, Project, Task, dan Run masing-masing memiliki ID independen, dan proyek-proyek saling terisolasi.
- Prinsip penjadwalan: Dependensi menentukan serialisasi, batas konkurensi menentukan skala, dan aturan ditulis ke dalam penjadwal.
- Keterlacakan: Setiap Run mencatat model, Token, waktu eksekusi, jumlah percobaan ulang, dan status akhir.
- Cara memulai: Melalui antarmuka terpadu APIYI apiyi.com, konfigurasikan model berbeda untuk subtugas yang berbeda.
12 Kesimpulan
Dots menunjukkan bentuk produk di mana Agent pribadi mengelola beberapa proyek jangka panjang: berjalan terus-menerus, konteks tugas saling independen, memori disimpan berlapis, Agent latar belakang dieksekusi paralel, dan operasi berisiko tinggi dikembalikan ke pengguna. Kemampuan multiproyeknya dibangun di atas manajemen status; sekadar menambah jumlah paralel tidak akan mencapai hal ini.
Saat membangun sistem serupa sendiri, Anda dapat menerapkannya mengikuti urutan artikel ini: pertama gunakan struktur empat lapis dan pembagian cakupan untuk mewujudkan isolasi proyek, lalu gunakan Store dan Checkpointer untuk menyelesaikan “mengingat latar belakang” dan “dapat dipulihkan” secara terpisah, kemudian gunakan penjadwal untuk mengelola dependensi dan konkurensi, dan terakhir gunakan mesin status, persetujuan, serta log eksekusi agar setiap langkah dapat dikendalikan dan diperiksa. Pada tahap prototipe, disarankan memverifikasi efek berbagai model pada setiap peran dengan cepat melalui APIYI apiyi.com, lalu menyesuaikan pembagian tugas dan konkurensi berdasarkan data log.
Referensi
- OpenAI: Introducing dots: Pengumuman peluncuran produk
- Link:
openai.com/index/introducing-dots - Keterangan: Posisi produk, komputer awan, dan eksekusi multi-proyek
- ChatGPT Learn: Tasks and memory: Dokumentasi tugas dan memori Dots
- Link:
learn.chatgpt.com/docs/dots/tasks-and-memory - Keterangan: Agent latar belakang, konteks tugas terpisah, riset proaktif
- OpenAI Help Center: Dots privacy, security, and safety FAQs: Penjelasan privasi dan keamanan
- Link:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - Keterangan: Izin, persetujuan, penghapusan memori, dan retensi data
- ChatGPT Learn: Dots admin guide: Manajemen dan penagihan versi enterprise
- Link:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - Keterangan: Cara penagihan ruang kerja enterprise dan tanggal mulai penagihan
- About ChatGPT Pro tiers: Penjelasan tingkatan langganan Pro
- Link:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - Keterangan: Harga dan aturan kuota Pro 100, 200, 500
- LangGraph Persistence documentation: Checkpointer dan Store
- Link:
github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx - Keterangan: Pembagian antara status eksekusi jangka pendek dan memori jangka panjang
- OpenAI Agents SDK: Tracing dan alur kerja
- Link:
developers.openai.com/api/docs/guides/agents/sdk - Keterangan: Pelacakan dan debugging proses eksekusi Agent
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami di halaman utama APIYI apiyi.com, materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com


