
Kesimpulan: biaya API untuk artikel AI, hitung dulu pemanggilannya, baru hasil akhirnya
Berdasarkan snapshot harga di artikel ini, dengan input 10.000 dan output 3.000 Token, biaya teoretis untuk sekali pembuatan sekitar 0.0066–0.10 dolar AS. Untuk menghasilkan satu artikel yang siap terbit, masih harus ditambahkan biaya kumulatif dari revisi, verifikasi, pemanggilan alat, dan pengeditan manual.
Yang benar-benar layak dibandingkan adalah “biaya per artikel yang lolos kualitas”. Artikel ini membandingkan 7 model dengan volume input dan output yang sama, lalu menjelaskan bagaimana kanal, cache, reasoning, dan jumlah putaran revisi mengubah tagihan.
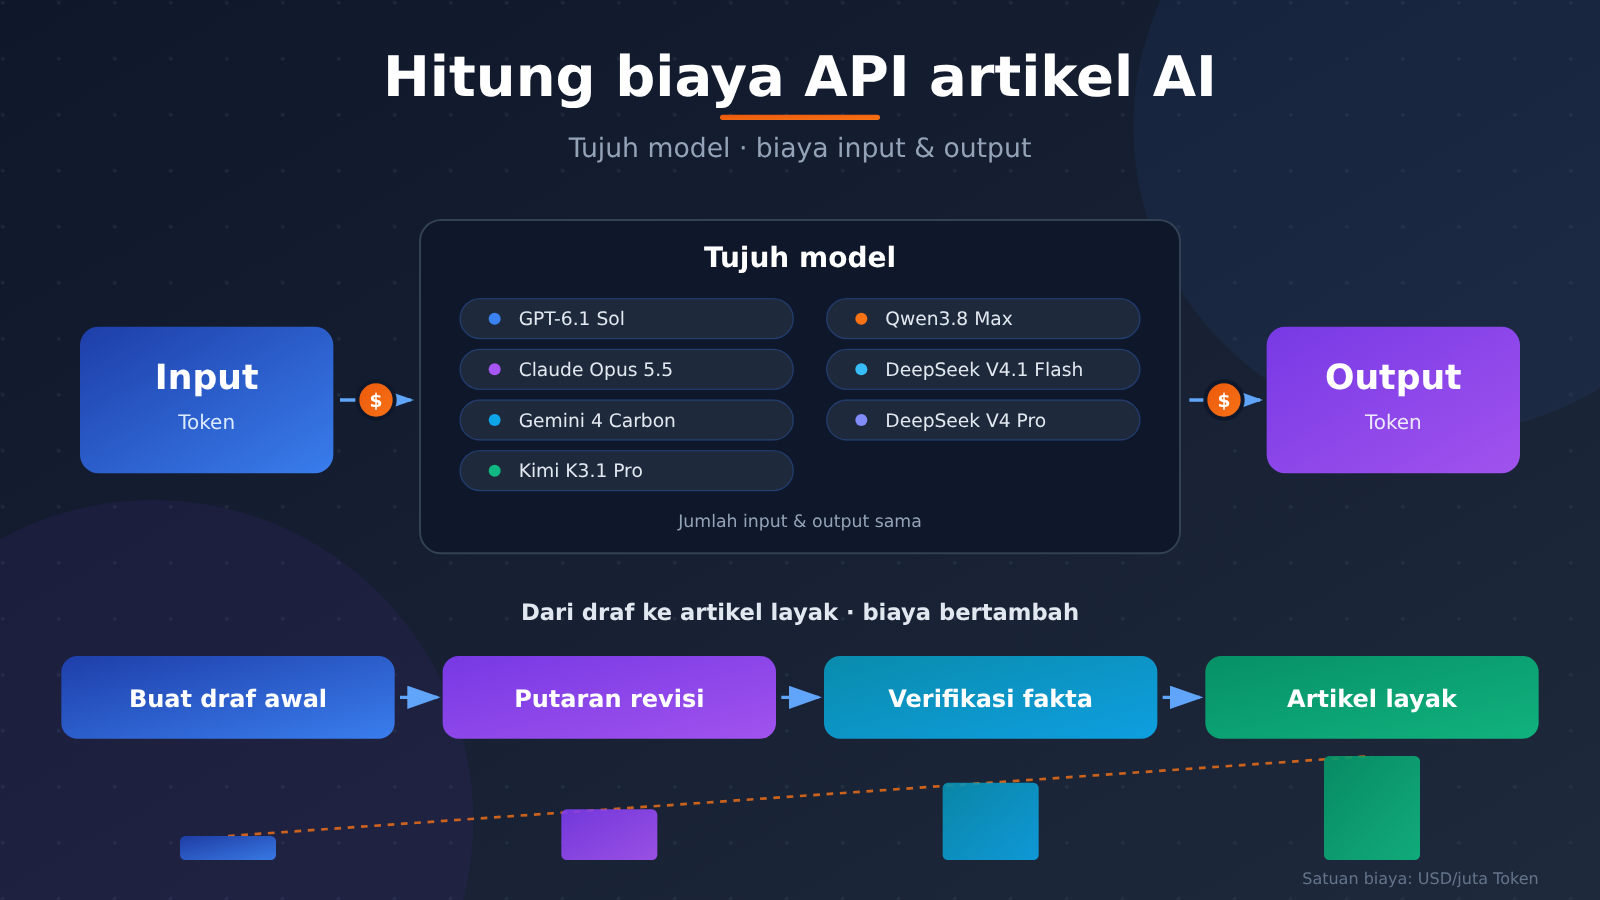
Apa yang dibahas berikutnya: jalur perhitungan biaya API untuk artikel AI
- Memahami input, output, dan rumus penagihan.
- Membandingkan biaya 7 model pada tiga skala tugas.
- Membedakan harga platform, harga resmi per wilayah, dan aturan per periode waktu.
- Menggunakan catatan pemanggilan dan waktu pengeditan untuk menentukan rencana produksi.
Saran untuk mulai cepat: Anda bisa menguji paket materi yang sama melalui antarmuka terpadu APIYI apiyi.com. Pengguna baru mendapat kuota uji gratis; besaran kuota dan aturan berlakunya mengikuti penjelasan platform saat ini.
Biaya API artikel AI: menyamakan satuan pengukuran lebih dulu
Token adalah satuan yang dipakai API untuk mengukur teks, dan tidak ada rasio konversi tetap dengan jumlah karakter bahasa Mandarin. Paket materi, petunjuk, rencana artikel, serta riwayat percakapan yang dikirim akan memakan Token input.
Harga input dan harga output biasanya dinyatakan dalam “dolar AS per juta Token”. Semua simulasi dalam artikel ini memakai harga satuan input dan output standar, tanpa memperhitungkan cache, penalaran tambahan, diskon batch, maupun biaya alat.
Rumus perhitungannya:
$$
C=\frac{T_{\text{input}}}{1{,}000{,}000}P_{\text{input}}
+\frac{T_{\text{output}}}{1{,}000{,}000}P_{\text{output}}
$$
Sebagai contoh, GPT-6.1 Sol dengan input 10.000 dan output 3.000 Token:
$$
C=0.01\times2+0.003\times10=0.05\text{ dolar AS}
$$
Uang sebesar itu untuk satu kali proses pembuatan. Apakah artikel bisa langsung diterbitkan tergantung pada apakah fakta, struktur, dan gaya penulisannya memenuhi standar; tagihan tidak akan menandatangani atas nama editor.
Biaya API artikel AI: perbandingan harga input dan output 7 model
Tabel di bawah memakai snapshot harga APIYI apiyi.com pada 12 November 2026 pukul 10.45 (UTC+8). Satuannya dolar AS per juta Token, dengan mode penagihan Token berdasarkan pemakaian.
| Model | Harga input | Harga output | Rasio harga output/input |
|---|---|---|---|
| GPT-6.1 Sol | 2,00 | 10,00 | 5 kali |
| Claude Opus 5.5 | 4,00 | 20,00 | 5 kali |
| Gemini 4 Carbon | 2,00 | 10,00 | 5 kali |
| Kimi K3.1 Pro | 2,00 | 10,00 | 5 kali |
| Qwen3.8 Max | 1,65 | 4,95 | 3 kali |
| DeepSeek V4.1 Flash | 0,30 | 1,20 | 4 kali |
| DeepSeek V4 Pro | 1,32 | 3,96 | 3 kali |
| Item perbandingan | Keterangan akses |
|---|---|
| Platform yang tersedia | APIYI apiyi.com; API resmi vendor, dengan wilayah dan aturan penagihan yang perlu diperiksa masing-masing |
Token output biasanya lebih mahal, tetapi ketika paket materi sangat panjang, biaya input juga bisa menjadi pengeluaran utama. Karena itu, pemilihan model sebaiknya melihat kedua kolom harga sekaligus, bukan hanya terpaku pada panjang artikel.
Biaya API artikel AI: apa saja perbedaan harga pada koneksi langsung resmi?
Berikut adalah aturan koneksi langsung resmi yang dicek hingga 12 November 2026, untuk memeriksa perbedaan antarkanal, dan tidak dimasukkan ke tabel harga platform di atas.
| Model/kanal | Harga atau aturan resmi |
|---|---|
| GPT-6.1 Sol, Standard | Input 2, output 10 |
| Claude Opus 5.5, pemanggilan standar | Input 4, output 20 |
| Gemini 4 Carbon, pemanggilan standar | Masa perkenalan sampai 30 November, input 2, output 10; mulai 1 Desember input 4, output 20 |
| Qwen3.8 Max, Beijing/Virginia Global (AS) | Input 1,65, output 4,951 |
| Qwen3.8 Max, Singapura International | Input 2, output 6 |
| Kimi K3.1 Pro, Alibaba Cloud Beijing/Singapura | Masing-masing 1,837/9,611 dan 2/10 |
| DeepSeek, dua model | Harga jam sibuk sama dengan nilai pada tabel di atas, di luar jam sibuk setengahnya |
Penyesuaian harga Gemini berlaku untuk koneksi langsung resmi Google; kanal pihak ketiga harus memeriksa pengumuman masing-masing. Harga output platform Qwen sebesar 4,95 dan harga resmi sebagian wilayah sebesar 4,951 juga sebaiknya dicatat secara terpisah.
Jam sibuk resmi DeepSeek adalah hari kerja pukul 09.00—12.00 dan 14.00—18.00 waktu Beijing; waktu lain serta akhir pekan mengikuti aturan di luar jam sibuk, dan hari libur nasional dihitung terpisah.
Berdasarkan harga satuan resmi di luar jam sibuk, Flash input 0,15 dan output 0,60; Pro input 0,66 dan output 1,98. Keuntungan dari penjadwalan bergantung pada apakah kanal yang dipakai benar-benar menerapkan aturan tersebut.
Biaya API untuk Artikel AI: Bagaimana Menghitung Skala Bahan dan Tiga Putaran Revisi?
Mari bandingkan dua skala bahan terlebih dahulu. Semua angka berikut adalah simulasi teoretis; Token keluaran mewakili panjang yang dihitung oleh model, bukan jumlah karakter bahasa Mandarin.
| Model | Masukan 50 ribu + 5000 keluaran | Masukan 100 ribu + 10 ribu keluaran | Akumulasi tiga putaran |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
Satuan: dolar AS. Ketiga kolom menggunakan snapshot platform yang disebut sebelumnya, belum termasuk cache dan biaya lain.
Sebagai contoh, tugas GPT dengan masukan 50 ribu dan keluaran 5000:
$$
C=0.05\times2+0.005\times10=0.15\text{ dolar AS}
$$
Di dalamnya, biaya masukan adalah 0.10 dolar AS dan biaya keluaran 0.05 dolar AS. Pada tugas yang padat materi, merapikan bahan masukan sering kali lebih layak diprioritaskan daripada memadatkan beberapa paragraf teks utama.
“Akumulasi tiga putaran” menggunakan alur pemanggilan terpisah berikut:
- Draf awal: masukan 10000, keluaran 3000 Token.
- Revisi: paket materi ditambah draf awal, masukan 13000, keluaran 3000 Token.
- Finalisasi: paket materi ditambah versi sebelumnya, masukan 13000, keluaran 3000 Token.
Total masukan 36000 dan keluaran 9000 Token. Biaya untuk GPT adalah:
$$
C=0.036\times2+0.009\times10=0.162\text{ dolar AS}
$$
Angka ini 3,24 kali biaya pembuatan pertama. Alur ini hanya menyimpan versi sebelumnya; jika setiap putaran menyertakan seluruh riwayat, jumlah masukan akan terus bertambah.
Grafik di bawah ini cocok untuk menunjukkan selisih biaya pada tugas yang sama; datanya berasal dari perhitungan rumus di atas, bukan hasil penilaian kualitas.
Biaya API untuk artikel AI: empat jenis biaya yang mudah terlewat
Biaya API artikel AI serta Token pemikiran dan pemanggilan alat
Token pemikiran adalah konten penalaran yang dihasilkan sebagian model sebelum memberikan jawaban. Google secara eksplisit menghitung Token penalaran Gemini ke dalam biaya output, dan penalaran tambahan pada mode Qwen Thinking juga menambah biaya.
Alat seperti pencarian online dan pengambilan halaman bisa dikenakan biaya terpisah. Catat Token model dan permintaan alat secara terpisah, terutama karena satu permintaan penulisan dapat memicu beberapa kali pencarian.
Biaya API artikel AI serta cache dan Batch API
Cache petunjuk menekan sebagian biaya input dengan memakai kembali prefiks yang sama. Jumlah hit, biaya penulisan, dan masa berlaku menentukan seberapa besar penghematan yang akhirnya didapat.
Harga input cache resmi GPT-6.1 Sol adalah 0.10; pembacaan cache Claude Opus 5.5 adalah 0.20, sedangkan penulisan cache 5 menit dan 1 jam masing-masing 5 dan 8, semuanya dengan satuan dolar per juta Token.
Batch API dipakai untuk pemrosesan batch secara asinkron. Batch resmi Claude mendapat diskon 50% baik untuk input maupun output; harga Batch resmi Gemini juga ikut menyesuaikan dengan harga standar per 1 Desember.
Aturan-aturan ini harus diperiksa sesuai saluran akses yang digunakan. Contohnya, Alibaba Cloud Kimi K3.1 Pro tidak mendukung Batch Inference; Qwen Beijing Batch File adalah 0.825/2.475 dengan batas atas konteks 256K.
Inti pendekatannya sederhana: untuk paket materi yang stabil, evaluasi cache lebih dulu; untuk tugas yang tidak mendesak, evaluasi Batch; dan masukkan biaya penulisan cache ke dalam perhitungan total.
Biaya API untuk artikel AI: mencatat Token aktual lewat kode
Contoh berikut menggunakan antarmuka yang kompatibel dengan OpenAI. Kunci API dibaca dari variabel lingkungan agar tidak ditulis langsung ke dalam kode; ketersediaan model dan dukungan parameter mengikuti dokumentasi terkini.
Pemanggilan paling sederhana:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
Contoh lengkap estimasi biaya Token biasa:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
Kode ini dipakai untuk memperkirakan biaya Token biasa. Rincian cache, pengukuran inferensi, dan biaya penggunaan alat sebaiknya dicocokkan dengan field penggunaan dari penyedia layanan serta log penyelesaian transaksi.
Biaya API untuk Artikel AI: Rekomendasi Skenario dan Saran Pengambilan Keputusan
Untuk draf awal rutin yang sensitif terhadap anggaran, uji dulu Flash, Pro, dan Qwen. Untuk blog kompleks dan naskah mendalam, masukkan GPT, Claude, dan sejenisnya ke dalam daftar kandidat, lalu gunakan waktu editing untuk memverifikasi apakah harga per unit yang lebih tinggi memang sepadan.
Pada peringkat berbahasa Inggris AI Writing Benchmark yang diperbarui 11 November 2026, GPT-6.1 Sol memperoleh skor komprehensif 95.3 dan skor kategori artikel 98.5, keduanya merupakan skor baseline.
Benchmark tersebut mendukung dimasukkannya GPT dalam pengujian blog berbahasa Inggris. Naskah berbahasa Mandarin tetap perlu diverifikasi terpisah: pengujian artikel panjang bidang finansial pada 26 Oktober–3 November 2026 hanya mencakup 26 artikel dengan sampel yang tidak seimbang, sehingga lebih tepat dijadikan petunjuk awal kandidat.
Sebaiknya seragamkan paket materi, target panjang, dan izin alat, sembunyikan nama model saat evaluasi, serta catat kesalahan fakta, jumlah putaran revisi, menit editing, dan status penerapan akhir.
Perhitungan akhir dapat menggunakan:
$$
C_{\text{合格文章}}
=C_{\text{全部API调用及相关费用}}
+C_{\text{人工编辑}}
$$
Biaya tenaga kerja dapat dihitung dari biaya per jam editor dikalikan waktu aktual. Jika verifikasi melibatkan API tambahan atau tenaga kerja manusia, masukkan juga ke pos yang sesuai agar tidak terjadi pencatatan ganda.
FAQ biaya API artikel AI: bagaimana membandingkan 7 model secara adil?
Saat berganti model melalui APIYI apiyi.com, pastikan materi, persyaratan penulisan, dan izin alat tetap konsisten. Lakukan beberapa kali pembuatan dan catat penggunaan; dengan begitu stabilitas serta biaya revisi lebih mudah terlihat.
FAQ biaya API artikel AI: apakah kuota gratis bisa menggantikan perhitungan biaya?
Kuota uji gratis APIYI apiyi.com cocok untuk memverifikasi antarmuka dan gaya tulisan. Untuk anggaran jangka panjang, perhitungan tetap harus mengacu pada harga satuan saat ini dan konsumsi aktual, sementara kuota diskon dicatat sebagai pos terpisah.
Penutup: Biaya API untuk artikel AI, ujungnya adalah produktivitas
Tabel harga satuan digunakan untuk penyaringan, log pemanggilan untuk perhitungan, dan catatan editor untuk pengambilan keputusan. Kompresi materi, penggunaan ulang cache, dan pengurangan pekerjaan ulang bisa jadi lebih efektif daripada mengejar harga output terendah.
Disarankan untuk memverifikasi model kandidat melalui APIYI apiyi.com, lalu pada akhirnya memilih solusi yang mampu secara stabil menghasilkan artikel yang memenuhi standar dengan total biaya yang wajar, sehingga editor dapat mencurahkan waktunya untuk menilai.
Referensi biaya API untuk artikel AI
- Harga model dan dokumentasi antarmuka APIYI: help.apiyi.com. Snapshot harga platform dalam artikel ini adalah 12 November 2026.
- Harga model Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing. Digunakan untuk memeriksa harga regional.
- Pengumuman resmi Google Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
- AI Writing Benchmark: aiwritingbenchmark.com. Artikel ini menggunakan tolok ukur peringkat berbahasa Inggris tanggal 11 November 2026.
- Uji artikel panjang mendalam berbahasa Mandarin: omnitools.ai/evals/longform-writing. Keterbatasan sampel dan tugas dijelaskan di badan artikel.
Penulis: Tim Konten Teknis APIYI. Kami menyambut baik pertukaran pengalaman seputar pemanggilan model dan perhitungan biaya artikel melalui apiyi.com.


