
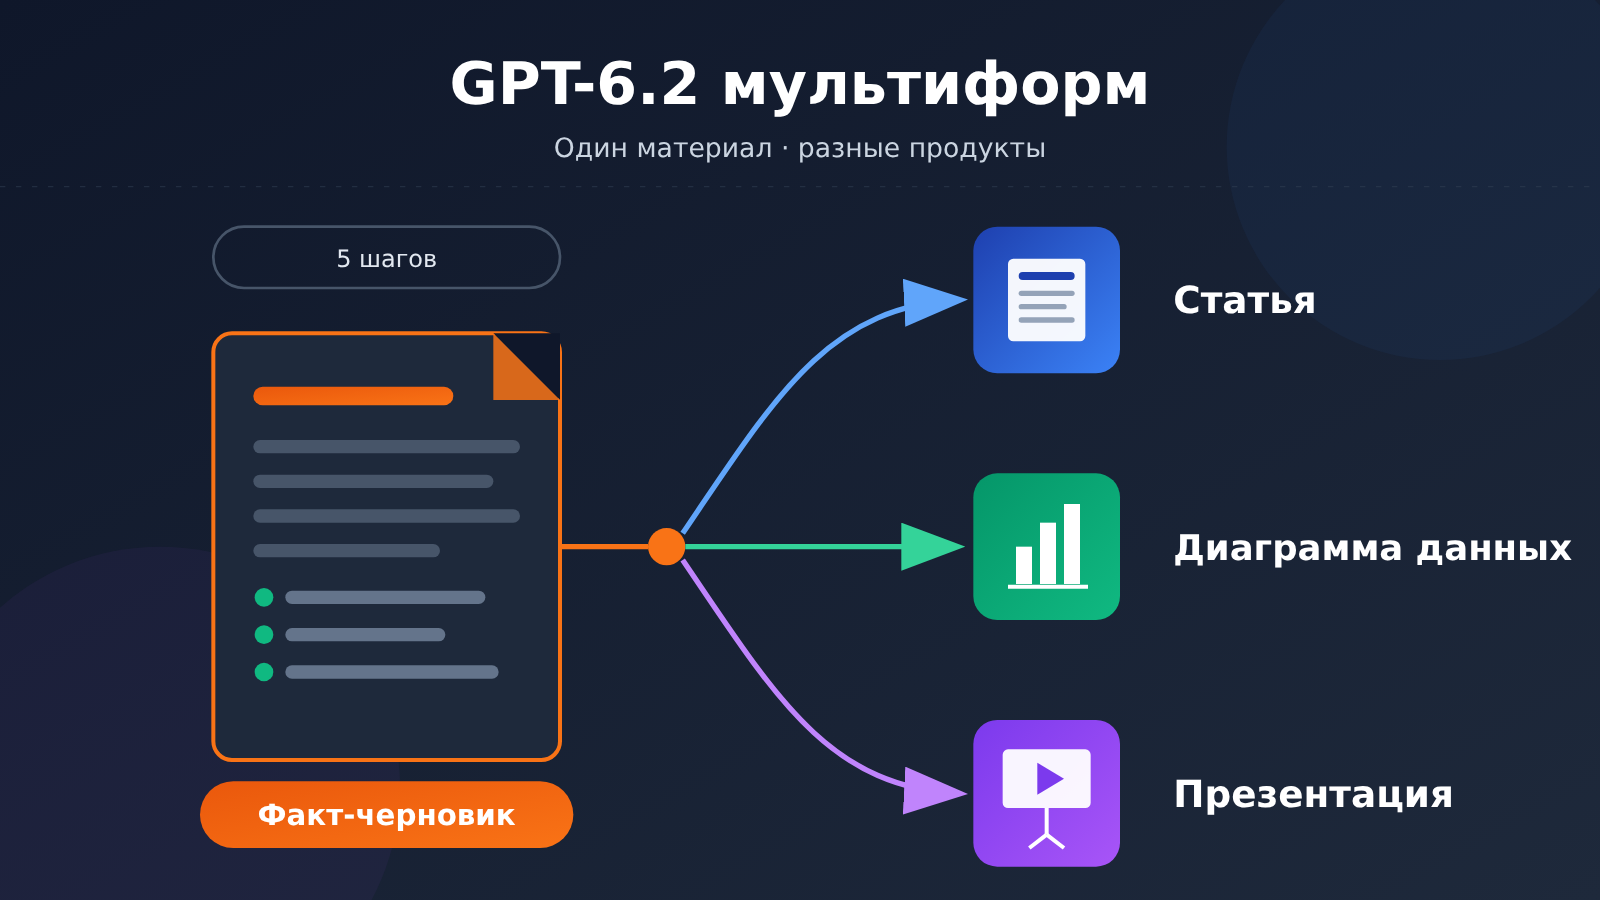
一份 материалов может превратиться в статью, диаграммы и презентацию — при условии, что сначала есть проверенный фактический черновик.Надёжнее сначала проверить материалы, а затем создавать разные продукты под цели читателя. OpenAI 17 ноября 2026 года выпустила GPT-6.2 Astra и Sol; на официальной странице релиза упоминаются следование шаблонам и умение работать с документами, слайдами и таблицами. Но чтобы эти возможности превратились в надёжные результаты, по-прежнему нужны инструментальная среда, организация материалов и проверка по пунктам.
Что вы узнаете из этой статьи
- Какие факты, связанные с многoформатной работой, подтверждает официальная страница релиза GPT-6.2 Astra и Sol, а что представляет собой лишь отзывы клиентов.
- Почему «многоформатная сдача» зависит от инструментальной среды, а не от того, что модель напрямую выдаёт файл.
- Метод рабочего процесса: от фактического черновика к разветвлению на статью, диаграммы и слайды в зависимости от цели читателя.
- Что нужно проверять в каждом продукте и как поддерживать согласованность версий между несколькими продуктами.
Содержание статьи
Ниже сначала с помощью концептуальной таблицы и краткого обзора влияния вы построите базовое понимание, затем в разделе «Объективные факты» по пунктам соберём информацию со страницы релиза GPT-6.2 и справочных страниц, указав источник и характер сведений. Раздел «Аналитические суждения» — это редакторские рекомендации: 5 шагов и список рисков вокруг многoформатного рабочего процесса GPT-6.2, его стоит внимательно прочитать тем, кто готов внедрять ИИ в производственный процесс контента.
GPT-6.2 Многоформатный рабочий процесс To Know: объяснение понятий
Перечисленные ниже понятия будут неоднократно встречаться в тексте, поэтому для начала сведём их в одну таблицу.
| Понятие | Краткое объяснение |
|---|---|
| GPT-6.2 Astra / Sol | Две модели, выпущенные OpenAI 17.11.2026; статья основана на официальной странице релиза, документации моделей и странице помощи |
| Соблюдение шаблона | Способность модели организовывать вывод согласно заданному макету, структуре или требованиям к формату; страница релиза называет это одним из ключевых моментов |
| Инструментальная среда | Программы или продуктовые функции вне самой модели, отвечающие за генерацию, рендеринг и сохранение файлов, например редакторы документов и средства рендеринга презентаций |
| Фактологический черновик | Метод работы, предлагаемый в этой статье: по пунктам свести факты, источники, даты, единицы измерения и неопределённости из материалов в структурированный список |
| Многоформатная выдача | Процесс создания из одного и того же набора материалов результатов в разных формах: статьи, графики, презентации и т. п. |
| Поэтапное открытие | Новая модель запускается не одновременно на всех входах, а постепенно — по продуктовым каналам и охвату пользователей |
GPT-6.2: краткий обзор влияния на мультиформатные рабочие процессы
Разные группы пользователей почувствуют это обновление по-разному. В таблице ниже — только различия, которые можно обосновать.
| Группа | Основное влияние | На что обратить внимание |
|---|---|---|
| Создатели контента | Акцент OpenAI на следовании шаблонам и работе с документами может упростить переиспользование одного материала в нескольких форматах | Обычный Chat в этом релизе ещё не запущен — проверьте, через какую точку входа вы работаете |
| Специалисты, работающие с информацией | Брифинги, таблицы и слайды — направления, прямо упомянутые на странице релиза | Готовые файлы зависят от инструментов среды и не считаются собственным выводом модели |
| Разработчики | API уже выпущен; информацию о доступе к аккаунту и ограничениях смотрите на официальной платформе | Модель на выходе даёт текст, а для генерации файлов придётся самому настроить рендеринг |
| Руководители команд | Можно перестроить рабочий процесс команды по принципу «один материал — несколько результатов» | Согласованность цифр и цитат между разными результатами по-прежнему требует ручной проверки |
1. Факты: что на самом деле показывают официальные примеры
Дата проверки: 18 ноября 2026 года. Примеры ниже взяты со страницы релиза OpenAI, это не результаты собственных тестов автора статьи.
1.1 Два примера официальных результатов, которые можно проверить
| Официальный пример | Исходные данные и требования | Что показали | Что это даёт для мультиформатной работы |
|---|---|---|---|
| Финансовая книга Alderfen Field Systems | Финансовые отчёты, бизнес-допущения и рыночные данные вымышленной агротех-компании | Редактируемая книга Excel с прогнозом и оценкой стоимости | Цифры, допущения и связи между расчётами должны прослеживаться |
| Предложение по мерчу на тему животных для команд | Публичный шаблон слайдов OpenAI и дизайнерские требования четырёх команд | Слайды с тематическим предложением, файлы векторного дизайна и инструкции по производству | Один и тот же проект можно разделить на материалы для обсуждения и материалы для реализации |
OpenAI также ссылается на отзыв IMC о брифинге и инфографике. Это отзыв клиента, а не результат тестов в этой статье. Показанные примеры относятся к разным задачам. Это не цельный эксперимент в духе «из одного материала в один клик получаем статью, графики и PPT».
1.2 Работа с файлами и точки входа в продукты
В документации модели GPT-6.2 Astra перечислены текстовый ввод, ввод изображений и текстовый вывод. Чтобы получить редактируемый файл, всё ещё нужны инструменты, которые предоставляет продукт, или программа генерации и рендеринга файлов, которую настроит разработчик; один текстовый ответ — это не готовый и не проверенный файл.
На странице помощи Work и Codex прямо сказано, что текущий поэтапный запуск не включает селектор моделей для обычного Chat. В анонсе релиза также подтверждается, что API уже предоставляет две новые модели. Перед использованием стоит отдельно проверить права доступа к аккаунту и возможности инструментов в каждом продукте.
2. Анализ и оценка: 5 шагов от одного исходного материала к статье, диаграммам и презентации
Дальше — редакционные рекомендации, а не официальная позиция. В этой статье мы не делали полный комплект материалов с помощью GPT-6.2; примеры ниже лишь показывают логику организации и не отражают каких-либо реальных результатов генерации. Чтобы не выдумывать цифры, мы используем сам материал «Публикация GPT-6.2» как структурный пример.
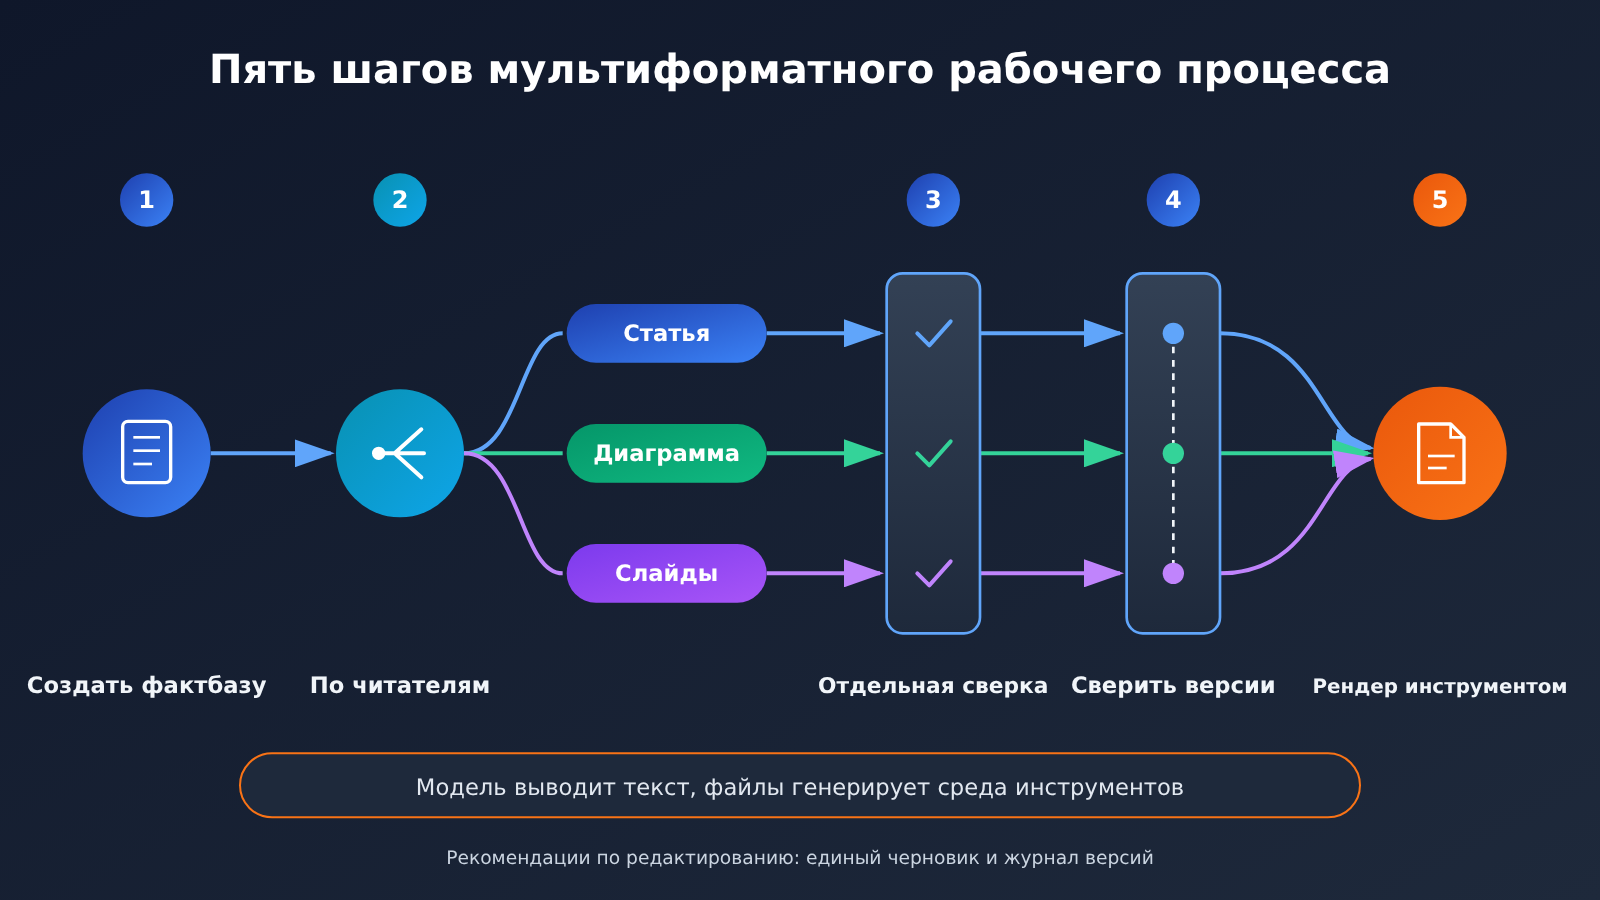
2.1. Создаём фактологическую основу для мультиформатного рабочего процесса GPT-6.2
Ошибки в мультиформатных материалах часто возникают не из-за текста, а из-за того, что исходные факты не зафиксированы. Рекомендую сначала разбить материал на отдельные факты и для каждого указать источник, дату, единицу измерения и неопределённость. Когда основа готова, все последующие артефакты берут данные только из неё, а не возвращаются каждый раз к исходным материалам.
| Факт | Источник | Дата | Единица | Неопределённость |
|---|---|---|---|---|
| OpenAI выпустила GPT-6.2 Astra и Sol | Официальная страница релиза | 2026-11-17 | нет | Низкая |
| В официальном анонсе упоминаются соблюдение шаблонов и работа с документами, слайдами и таблицами | Официальная страница релиза | 2026-11-17 | нет | Это рекламное описание; результат нужно проверять самостоятельно |
| Отзыв IMC о брифинге и инфографике | Цитируется на странице релиза | 2026-11-17 | нет | Отзыв одного клиента; нельзя экстраполировать |
| Обычный Chat в этом релизе не запущен | Страница помощи | проверено 2026-11-18 | нет | Может измениться позже |
| Work/Codex постепенно становятся доступны, API уже выпущен | Страница помощи и анонс релиза | проверено 2026-11-18 | нет | Сроки открытия доступа для разных аккаунтов неопределённы |
В этом примере в столбце «Единица» везде стоит «нет», но в материалах с ценами, числом пользователей и данными о производительности именно этот столбец чаще всего становится источником ошибок при переносе в диаграммы. А столбец «Неопределённость» определяет, может ли факт попасть на итоговый слайд с выводами.
2.2. Ветвление на статью, график и презентацию в зависимости от целей читателя
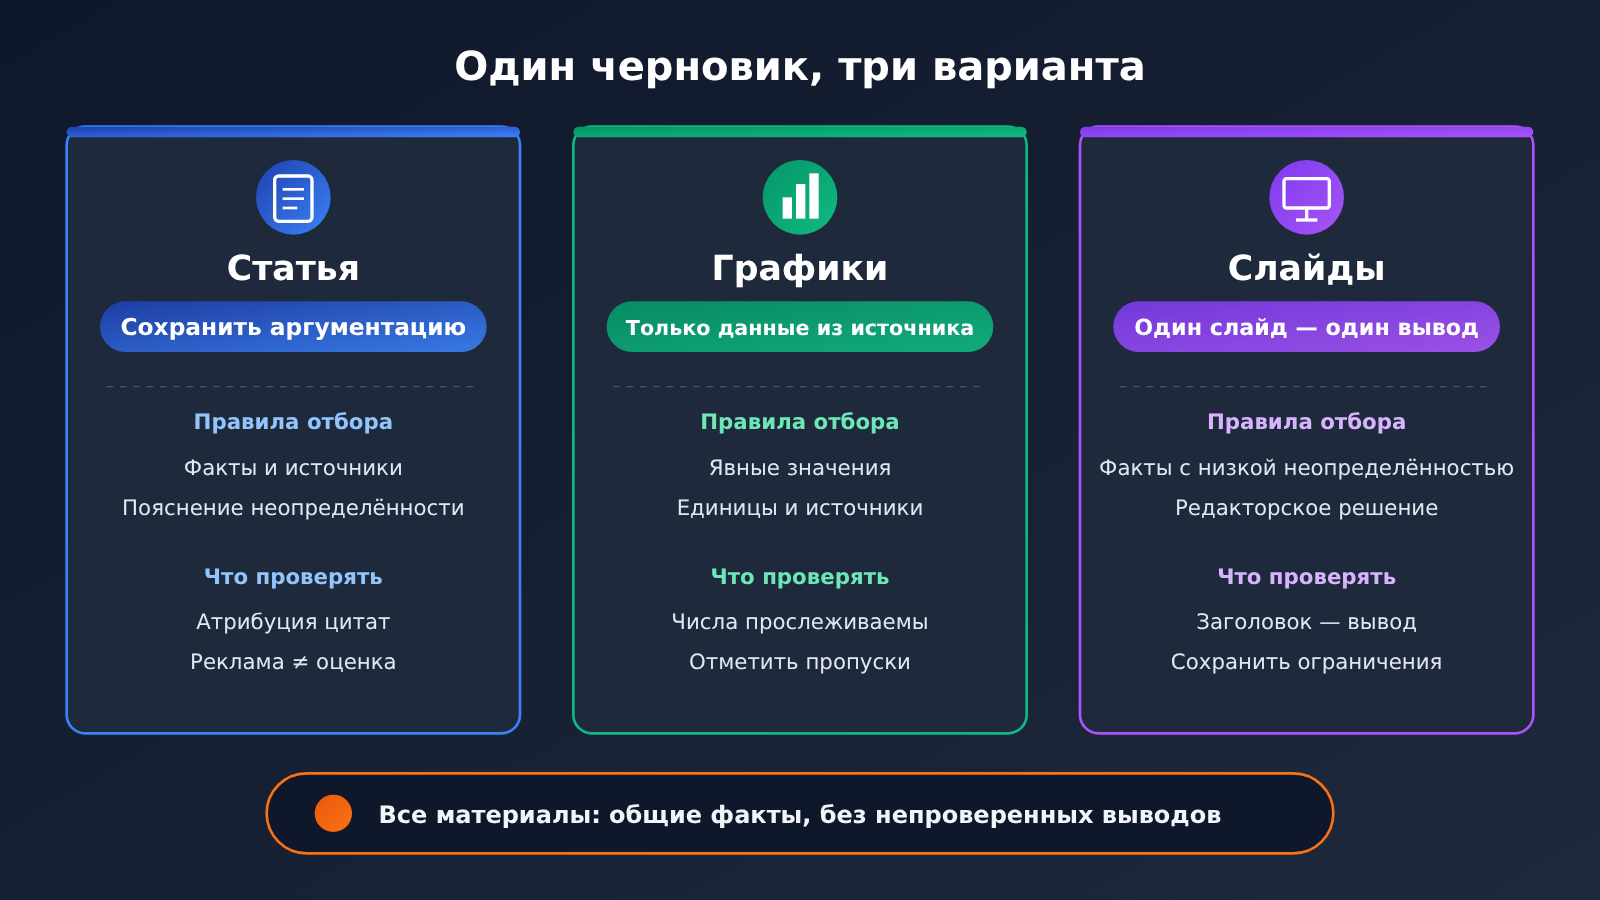
Один и тот же исходный черновик попадает к разным читателям, и отбор материала в каждом случае должен быть разным. Читатель статьи готов разбираться в ходе рассуждений, читателю графика нужно быстро увидеть связь между данными, а аудитории презентации — по одному чёткому выводу на каждый слайд.
| Продукт | Основной принцип | Что берём из черновика | Частые риски |
|---|---|---|---|
| Статья | Сохранить аргументацию | Факты + источники + оговорки о неопределённости | Превратить рекламное описание в выводы обзора |
| График | Только данные с источником | Пункты с явными числами, единицами измерения и источником | При нехватке данных дописываются «правдоподобные» цифры |
| Слайд | Один вывод на страницу | Факты с низкой неопределённостью + редакционное суждение | При сжатии теряются оговорки и ограничения |
На примере черновика из этой статьи видно: в нём нет ни одного числового факта, поэтому он не подходит для графика с данными — лучше сделать таймлайн или схему со статусами открытости каналов. Это важный момент: если настойчиво просить модель «построить сравнительную диаграмму», она может дописать цифры, которых в исходных материалах нет.
Совет редактору: укажите в промпте «использовать только пункты из черновика, а для недостающих данных помечать, что их нужно дописать», и сохраняйте список источников по каждому продукту.
2.3 Проверяем числа, цитаты и вёрстку в выводе GPT-6.2 по отдельности
У трёх типов артефактов разные акценты при проверке — лучше разбирать их по отдельности, а не один раз смотреть «в целом вроде нормально».
- Проверка чисел: каждое значение на диаграмме должно находиться в черновике в виде соответствующей записи, с теми же единицами и датой.
- Проверка цитат: любые формулировки в статье, касающиеся обратной связи IMC, должны сохранять атрибуцию «отзыв клиента, цитируемый на странице публикации».
- Проверка вёрстки: заголовок слайда — это и есть вывод? Элементы шаблона соблюдены правильно? Именно способность следовать шаблону, которую подчёркивает официальная документация, и нужно фактически проверять на этом этапе.
- Проверка границ: ни в одном артефакте не должно быть формулировок вроде «обычный Chat уже доступен», которые противоречат странице помощи.
2.4 Согласовываем версии между статьёй, диаграммой и презентацией
Самая коварная проблема работы с несколькими форматами — расхождение версий: в статье поправили формулировку, а слайд остался в старой версии. Советую присвоить черновику номер версии и в каждом артефакте фиксировать, на какую версию черновика он опирается. Когда статус доступности на странице помощи обновится, достаточно поправить черновик, а потом по номеру версии пакетно проверить, какие артефакты нужно синхронизировать.
2.5 Генерируем файлы, а затем проверяем реальный результат поставки
Когда есть среда разработки, можно сначала попросить модель вернуть текст статьи, спецификации диаграмм и постраничный план, а потом передать всё это в инструменты для документов, графики и презентаций. При работе с Work стоит прямо требовать редактируемые файлы и уточнять шаблон, шрифты и пропорции страниц. Здесь описан рекомендуемый процесс — сами вызовы не выполнялись, вложения не создавались.
Готовый шаблон задания, который можно копировать:
Используй только проверенные факты из исходного документа во вложении. Сначала перечисли, какой информации не хватает, а затем подготовь по отдельности: статью с сохранением аргументации и источников; план диаграмм, где используются только имеющиеся данные; план презентации, где на каждом слайде один вывод. Если числовых данных нет, строй схему связей, а не выдуманную столбчатую диаграмму. На всех продуктах указывай версию исходного документа. После завершения файлов сообщи о том, что проверить не удалось, и не называй незавершённое завершённым.
После генерации файлов их нужно проверить ещё раз: открой документ и посмотри абзацы и разбивку на страницы, открой диаграммы и сверь оси и подписи, пролистай слайды и проверь, нет ли выхода за границы, перекрытий и отсутствующих шрифтов. Сверка исходных данных не заменяет такую проверку после рендеринга.
2.6 Риски и критерии приёмки
Когда официальное описание возможностей превращают в командный процесс, несколько категорий рисков стоит заранее прописать в регламенте.
- Смешение рекламы и оценки: описание возможностей на странице релиза и обратная связь IMC — это не независимая оценка, поэтому во внешних материалах не стоит писать «доказано».
- Неверная оценка канала: обычный Chat в этот раз не запущен, и если члены команды работают через разные точки входа, они могут получить не одну и ту же модель.
- Неверная оценка файловых возможностей: модель выводит текст, а качество файла во многом зависит от самого инструмента рендеринга и шаблона.
- Риск выдумывания цифр: когда в материалах не хватает данных, просьба построить диаграмму легче всего приводит к цифрам без источника.
- Риск устаревания: поэтапное открытие означает, что статус меняется; в исходном документе у информации о доступности нужно указывать дату проверки.
Создателям контента стоит сначала зафиксировать исходный документ и цитаты; специалистам по знаниям — проверить реальную вёрстку на шаблоне своей компании; разработчикам — разделить вызов модели, генерацию файлов и приёмку на отдельные этапы. Для записи результатов пилота предлагаю три метрики: число исправлений фактов, число переделок вёрстки и прошёл ли итоговый редактируемый файл приёмку. Только так можно понять, действительно ли новая модель улучшает вашу работу, а не просто увеличивает количество продуктов.
Возможности моделей растут, но порядок «сначала зафиксировать факты, потом разделить по читателям, в конце проверить по пунктам» не меняется из-за модели. Чем мощнее инструмент, тем нужнее понятный способ организации материалов, чтобы им управлять, — недаром в «Луньюй» (глава «Вэй Лин-гун») сказано: «Хочешь хорошо выполнить работу — сначала заточи инструмент».


