
Note de l’auteur : si votre modèle donne des résultats moins bons que le classement officiel, ne tirez pas de conclusions trop vite. Bien souvent, c’est le niveau de réflexion, la fenêtre d’entrée ou l’ID du modèle qui ne correspond pas à celui utilisé pour le test du classement. Cet article donne l’ordre dans lequel vérifier ces trois points ; une fois la vérification faite, vous pourrez décider s’il faut changer de modèle.
Beaucoup de développeurs rencontrent le même écart. Une annonce officielle indique qu’un modèle a obtenu un score élevé dans un classement ; vous essayez avec des problèmes du même type et le résultat est nettement en dessous de vos attentes. Vous en venez alors à soupçonner que le modèle « est devenu bête » ou qu’il a été « bridé ». Cet article propose une démarche de diagnostic plus pragmatique : d’abord aligner le niveau de réflexion, la fenêtre d’entrée et le même ID de modèle, puis déterminer si l’écart est réel.
Ce n’est pas une recette miracle « trois réglages et vous égalisez le classement officiel ». Les différences décrites ci-dessous viennent toutes de la documentation publique. Elles ne font que vous aider à confirmer que vous comparez bien la même chose ; elles ne garantissent pas qu’après ajustement vous obtiendrez le score du classement, et elles ne signifient pas non plus qu’APIYI ait reproduit le classement officiel.
L’essentiel : après la lecture de cet article, vous saurez dans quel ordre vérifier ces trois points et quel document consulter à chaque étape. Vous saurez aussi, si l’écart persiste après vérification, quels prix et quels endpoints comparer avant de changer de modèle.
Les points clés quand les benchmarks officiels ne correspondent pas
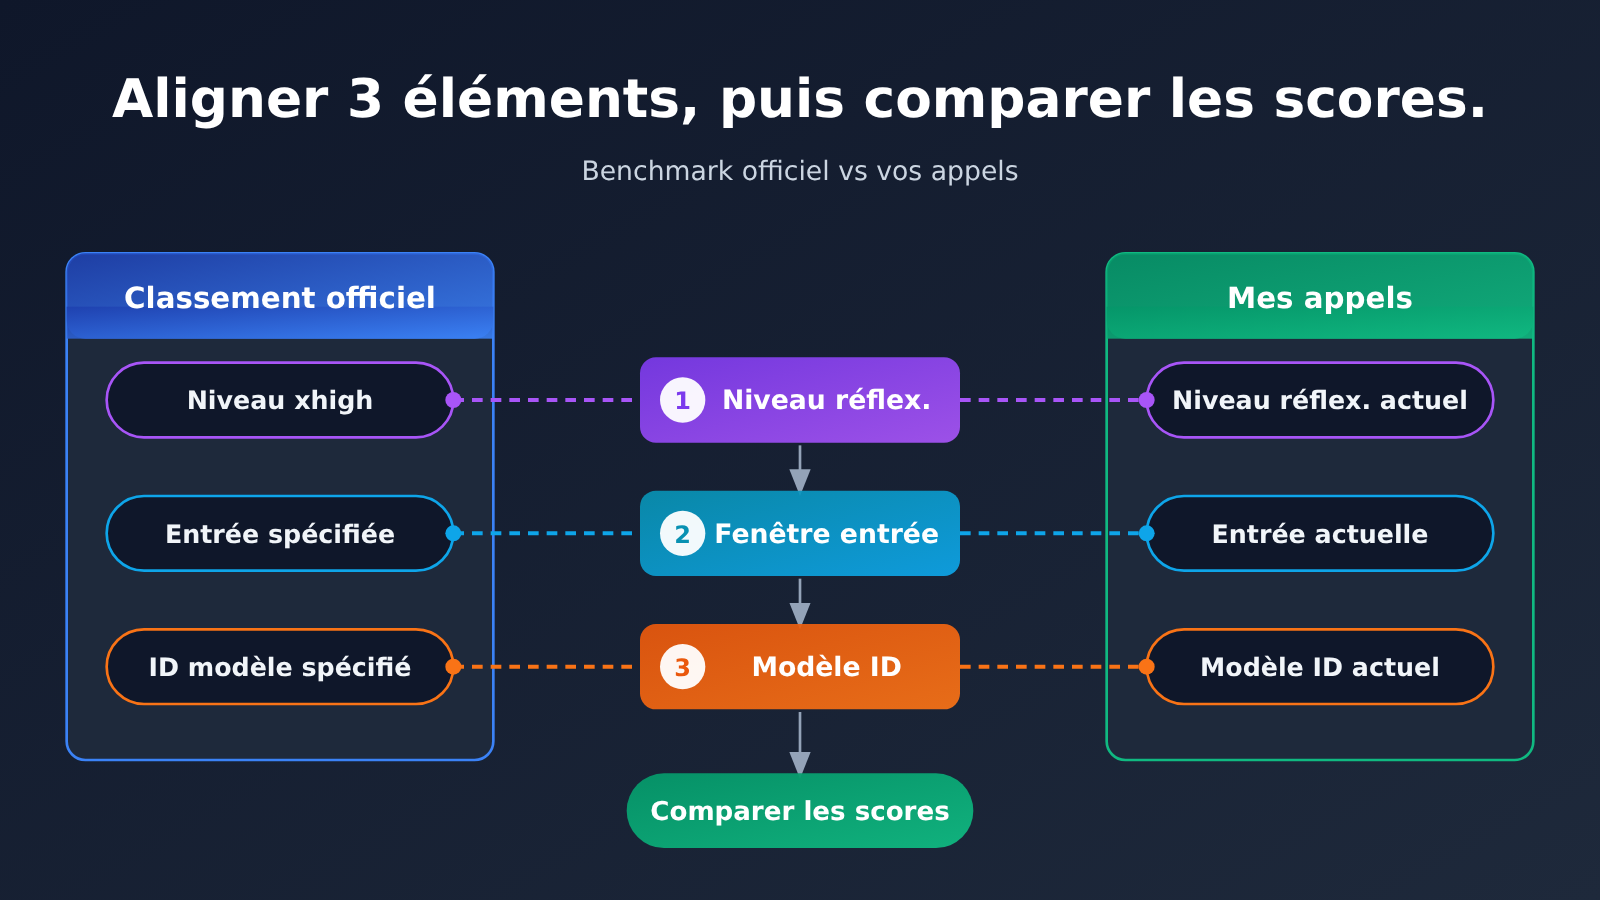
Commençons par la conclusion. Un score de classement n’est jamais celui du « nom du modèle » : c’est celui d’un « ID de modèle précis + un niveau de réflexion précis + des conditions d’accès précises ». Si l’un de ces trois éléments diffère, le résultat que vous obtenez ne peut pas être comparé directement à celui du classement.
| Point de vérification | Écart typique (d’après la documentation publique) | Ce qui se passe en cas de non-correspondance | Priorité |
|---|---|---|---|
| Niveau de réflexion | Neon est par défaut à high sur l’API, avec aussi low, medium, xhigh ; Carbon est par défaut à medium et n’a pas de xhigh |
La longueur de sortie et la profondeur du raisonnement diffèrent, donc les résultats aussi | Première étape |
| Fenêtre du point d’accès | La fenêtre API de Neon est de 1,048,576 token, alors que la documentation Antigravity indique un maximum de 512K |
La capacité de contexte long affichée dans le classement ne tiendra peut-être pas dans votre point d’accès | Deuxième étape |
| ID de modèle | Gemini 4 a au moins quatre variantes : argon, carbon, hydrogen, neon ; les niveaux de réflexion et les prix affichés ne sont pas les mêmes |
Comparer le résultat de A au classement de B, ce n’est pas comparer la même chose | Troisième étape |
Pourquoi le niveau de réflexion arrive en premier dans la vérification des benchmarks officiels
Le niveau de réflexion est la variable la plus facile à oublier, car il a souvent une valeur par défaut : vous pouvez appeler le modèle sans le définir et tout fonctionne. Le problème, c’est que les valeurs par défaut diffèrent selon les modèles. Avec Gemini 4, Neon est par défaut à high sur l’API, tandis que Carbon est par défaut à medium. Pour une même invite, un niveau différent change la longueur de sortie et le résultat final.
Les classements précisent généralement le niveau testé. Les scores cités dans les annonces officielles, par exemple les 61 points de Neon au niveau xhigh chez Artificial Analysis, doivent être lus avec le niveau associé. Si vous comparez le score obtenu avec le high par défaut à celui du xhigh, vous ne parlez pas des mêmes conditions. Attention aussi : Carbon n’a pas du tout de niveau xhigh ; « pousser Carbon au maximum » ne revient donc pas au xhigh de Neon.
Le nom d’un même niveau peut aussi varier selon le point d’accès. Dans Antigravity, le niveau le plus élevé de Neon est affiché comme Extra dans l’interface, alors que la documentation API l’appelle xhigh. Pour vérifier, il faut se référer à la correspondance donnée dans la documentation, pas seulement au libellé affiché.
Pourquoi la fenêtre d’entrée et l’ID du modèle sont tout aussi déterminants
La fenêtre d’entrée détermine la quantité de contexte que vous pouvez fournir au modèle. Lorsque l’on appelle Neon via l’API, la fenêtre atteint 1,048,576 tokens, alors que la documentation d’Antigravity indique un maximum de 512K. Si le classement évalue la recherche dans de longs documents ou la compréhension d’une grande base de code, même en passant par une entrée à fenêtre plus petite avec le même modèle, vous risquez d’obtenir de moins bons résultats parce que le contenu a été tronqué.
L’ID du modèle, lui, est l’élément le plus « inflexible ». La génération Gemini 4 compte au moins quatre ID : argon, carbon, hydrogen et neon, dont les réglages de niveau de réflexion et les tarifs diffèrent. Comparer les résultats de Hydrogen à ceux de Neon sur un classement mesuré au niveau xhigh, et il est parfaitement normal d’observer un écart. Avant d’appeler, mieux vaut vérifier dans le tableau général des modèles d’APIYI (apiyi.com) quel ID vous avez réellement inscrit dans la requête, plutôt que de vous fier à votre mémoire ou à la capture d’écran de quelqu’un d’autre.
Étapes rapides pour s’aligner sur les benchmarks officiels
Cette section met les trois vérifications en pratique. Pour faciliter le copier-coller, les noms de paramètres, les ID de modèles et les adresses sont écrits en ligne de code ; vous pouvez ainsi vérifier votre propre requête point par point.
Étape 1 : Confirmer le point d’entrée et l’endpoint d’appel
Commencez par identifier par quel point d’entrée vous utilisez le modèle : interface web, extension IDE, ou appel direct de l’API. Selon l’entrée, la limite de fenêtre de contexte et le nom des niveaux peuvent différer. Si vous passez par une interface compatible OpenAI, réglez base_url sur https://api.apiyi.com/v1 et renseignez api_key avec la clé générée dans la console APIYI. Ainsi, pour changer de modèle par la suite, il suffit de modifier le champ model ; les conditions d’entrée restent identiques, ce qui rend la comparaison pertinente.
Étape 2 : Écrire l’ID du modèle en entier
Dans la requête, écrivez model avec l’ID complet, par exemple gemini-4-neon ou gemini-4-carbon, et non un « Gemini 4 » vague. Une fois cela fait, revenez au tableau récapitulatif des modèles pour vérifier que cet ID correspond bien à celui testé dans le classement. Si le classement teste Neon alors que vous appelez gemini-4-hydrogen, inutile de poursuivre les comparaisons : commencez par corriger l’ID.
Étape 3 : Définir explicitement le niveau de réflexion
Ne vous fiez pas aux valeurs par défaut : spécifiez explicitement le niveau de réflexion dans la requête. Pour le nom exact du champ, référez-vous à la documentation officielle du modèle concerné. Trois points à surveiller :
- Aligner le niveau sur celui du benchmark : si le classement indique
xhigh, réglezxhigh; s’il indiquehigh, réglezhigh. - Vérifier que le niveau existe : Carbon n’a pas de
xhigh; s’aligner de force sur le classementxhighde Neon n’a aucun sens. - Attention au mappage des noms : dans l’interface Antigravity,
Extracorrespond au niveau le plus élevé de Neon ; lors du passage à l’API, remplacez-le par le nom du niveau indiqué dans la documentation.
Étape 4 : Vérifier que le contexte ne dépasse pas la fenêtre d’entrée
Si votre contenu de test est très long, estimez d’abord le nombre de tokens, puis comparez-le à la limite de l’entrée. En appelant Neon via l’API, la limite est de 1,048,576 tokens ; dans la documentation d’Antigravity, elle est indiquée comme allant jusqu’à 512K. Le contenu dépassant la limite sera tronqué ou renverra une erreur ; dans ce cas, la « mauvaise qualité » observée vient en réalité d’une entrée incomplète.
🚀 Démarrage rapide : si vous souhaitez comparer plusieurs ID de modèles dans les mêmes conditions d’entrée, vous pouvez appeler Gemini, Claude, GPT et d’autres modèles via APIYI apiyi.com avec une seule clé API. Les nouveaux utilisateurs disposent d’un quota de test gratuit, pratique pour d’abord aligner les niveaux et les ID, puis faire une comparaison à petite échelle.
Liste de contrôle des vérifications
| Élément de contrôle | Champ à vérifier dans la requête | Critère de conformité | Erreur fréquente |
|---|---|---|---|
| Entrée | base_url |
Fixer une seule entrée, par ex. https://api.apiyi.com/v1 |
Tester une fois côté web, une fois côté API, et mélanger les comparaisons |
| ID du modèle | model |
ID complet identique à celui du classement | Comparer hydrogen au classement de neon |
| Niveau de réflexion | Paramètre du niveau de réflexion (nom du champ selon la doc) | Identique au niveau testé, et ce niveau existe bien | Se fier aux valeurs par défaut ; régler xhigh pour Carbon |
| Contexte | Nombre de tokens en entrée | Ne dépasse pas la limite de la fenêtre d’entrée | Insérer du contenu de l’ordre du million dans une entrée 512K |
Après vérification des benchmarks officiels, l’écart persiste : prix et endpoints avant de changer de modèle
Si les trois points concordent et que l’écart reste net, c’est seulement là qu’il devient pertinent d’envisager un changement de modèle. Changer de modèle, ce n’est pas juste changer un nom : il faut regarder en même temps le niveau de capacité et le coût, car les prix affichés des différentes ID de Gemini 4 varient sensiblement. Voici les tarifs du catalogue APIYI vérifiés au 2026-11-20, tous exprimés en dollars par million de tokens.
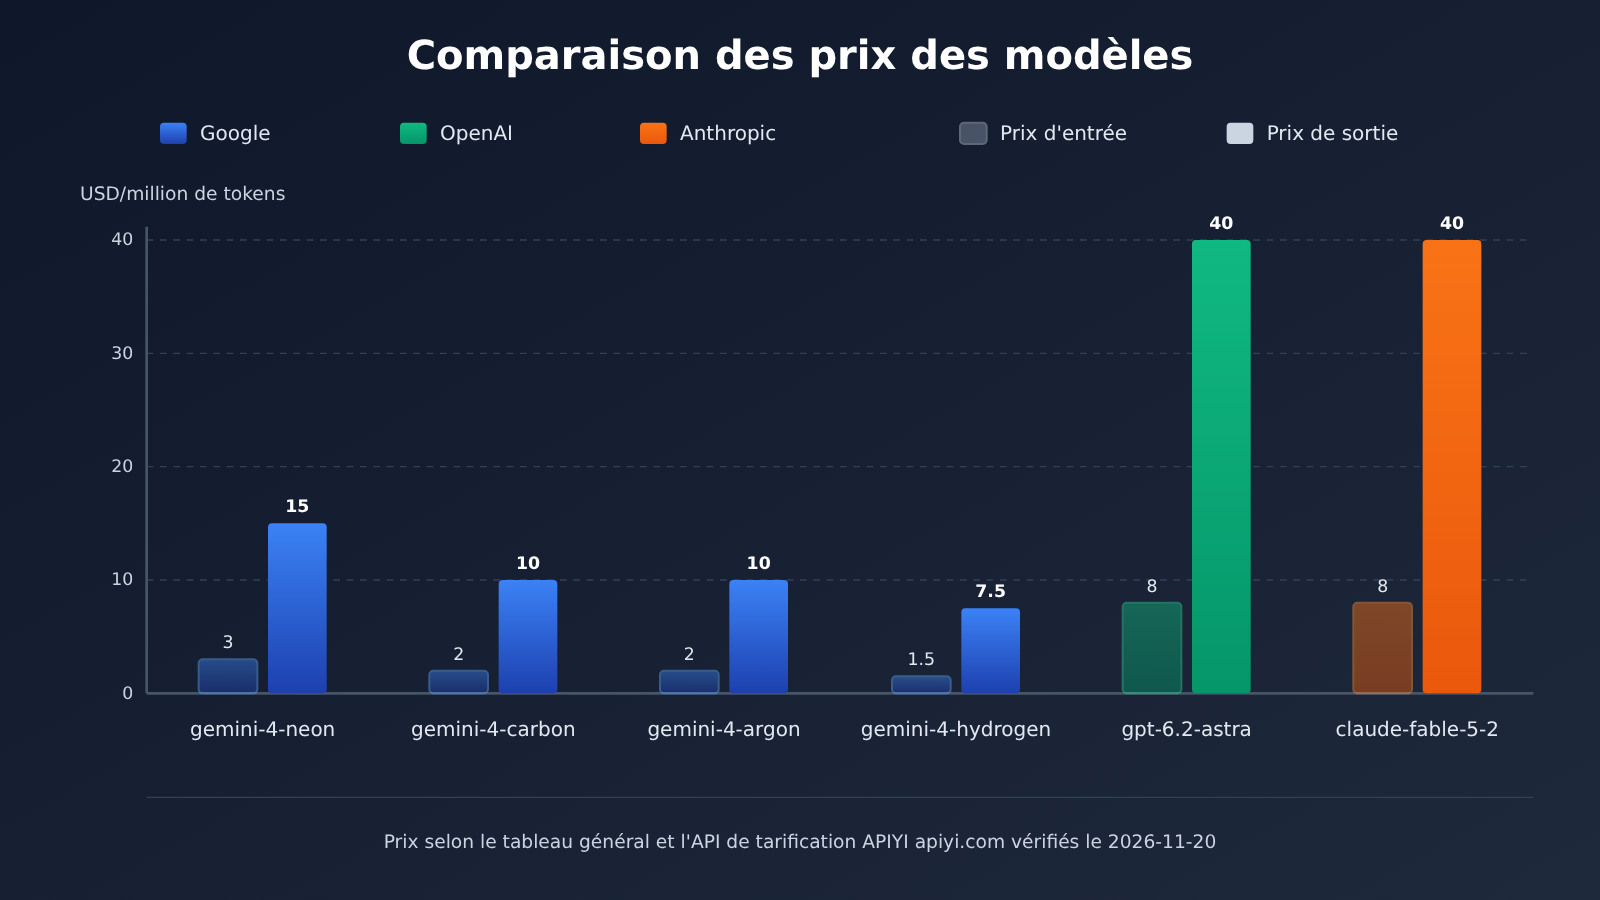
| ID du modèle | Entrée | Lecture cache | Sortie | Remarques |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Selon l’interface de tarification, conforme au tarif Google |
gemini-4-carbon |
2 |
0.1 |
10 |
Correspond au prix de lancement de Google jusqu’au 2026-11-30 |
gemini-4-argon |
2 |
0.1 |
10 |
Issu du tableau général des modèles |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
Prix unitaire le plus bas des quatre |
gpt-6.2-astra |
8 |
0.4 |
40 |
Au-delà de 272000 tokens, l’entrée passe à 16, voir plus bas |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 |
0.2 |
40 |
Les deux ID ont le même prix |
Ce tableau comporte quelques points à préciser séparément, sous peine de mal calculer les coûts :
- Provenance de gemini-4-neon : il n’apparaissait pas dans la version du tableau général des modèles mise à jour le 2026-11-19 à 10:59 (UTC+8), mais il figure dans l’interface de tarification. Celle-ci indique un
model_ratiode1.5, uncompletion_ratiode5et uncache_ratiode0.05. En prenant pour basemodel_ratio=1correspondant à une entrée de2dollars par million de tokens, on obtient une entrée à3, une sortie à15et une lecture cache à0.15. - Validité du prix de gemini-4-carbon : le prix actuel correspond au tarif de lancement de Google jusqu’au 2026-11-30. À partir du 1er décembre, le tarif standard de Google est de
4en entrée et20en sortie ; il faudra intégrer ce changement dans toute budgétisation à long terme. - Paliers de gpt-6.2-astra : le tableau général des modèles indique, pour le premier palier, une entrée à
8, une lecture cache à0.4et une sortie à40, puis une entrée à16au-delà de272000tokens. L’interface de tarification, au-delà de272000tokens, calcule la sortie à60et la lecture cache à0.8. Il convient de croiser les deux sources.
💡 Conseil de choix : lors d’un changement de modèle, placez les ID candidats sous le même
base_urlet comparez avec le même palier de réflexion et les mêmes entrées : c’est à cette condition que la conclusion tiendra. Le tableau général des modèles et l’interface de tarification d’APIYI apiyi.com permettent de consulter les prix actuels de ces ID ; mieux vaut revérifier juste avant l’appel plutôt que de se fier uniquement au tableau de cet article.
Liste de vérification des points d’accès et de la facturation lors du changement de modèle
| Point à vérifier | Où chercher | Pourquoi vérifier |
|---|---|---|
| Existence de l’ID du modèle | Tableau général des modèles docs.apiyi.com/models.md |
La version du tableau peut être en retard, certains ID doivent être revérifiés via l’interface de tarification |
| Prix unitaire actuel et multiplicateur | Interface de tarification api.apiyi.com/api/pricing |
Le multiplicateur se convertit en prix unitaire en dollars, la version est shell-api-modelmak-v1 |
| Découpage du contexte long | Comparer les deux sources : tableau général et interface de tarification | Par exemple, pour gpt-6.2-astra, le prix unitaire change au-delà de 272000 tokens |
| Point d’accès d’invocation | https://api.apiyi.com/v1 |
Format compatible OpenAI, il suffit de modifier model pour changer de modèle |
| Variation des prix en amont | Annonce officielle de tarification | Par exemple, le prix de lancement de Carbon se termine le 2026-11-30 |
FAQ – Questions fréquentes
Q1 : À quoi correspondent exactement les scores de référence officiels ?
Le score du classement correspond à une combinaison précise : « un ID de modèle donné + un niveau de raisonnement donné + un type de conditions d’accès donné », et non à un nom de modèle vague. Par exemple, le score de 61 de Neon est un résultat Artificial Analysis obtenu avec le niveau `xhigh`. Citer ce chiffre sans préciser le niveau de raisonnement prête facilement à confusion.
Q2 : Niveau de raisonnement, fenêtre d’accès et ID de modèle : par quoi commencer ?
L’ordre recommandé est le suivant : vérifier d’abord le niveau de raisonnement, puis la fenêtre d’accès, et enfin l’ID de modèle. Ne comparez les scores qu’une fois que les trois éléments concordent. En pratique, vous pouvez aussi jeter un œil à l’ID en premier, car s’il est faux, les deux autres éléments ne servent à rien. L’intérêt de cet ordre est d’éliminer les erreurs une par une, pas de suivre mécaniquement une procédure figée.
Q3 : Pousser le niveau de raisonnement au maximum suffit-il à atteindre la référence officielle ?
On ne peut pas le garantir. Aligner le niveau garantit seulement que vous comparez dans les mêmes conditions que le classement ; la répartition des tâches, la formulation des invites, la méthode d’échantillonnage et d’autres facteurs peuvent encore créer des écarts. De plus, tous les ID n’ont pas de niveau maximal : Carbon, par exemple, n’a pas de `xhigh`, et son niveau le plus élevé ne correspond pas au `xhigh` de Neon.
Q4 : Pourquoi le même Neon ne donne-t-il pas les mêmes résultats dans un IDE et en appel direct de l’API ?
Les conditions d’accès peuvent différer. Quand Neon passe par l’API, la fenêtre est de `1,048,576` tokens, alors que la documentation d’Antigravity indique un maximum de `512K`. Les noms des niveaux diffèrent aussi : dans l’interface d’Antigravity, le niveau le plus élevé s’appelle `Extra`. Si les tâches à contexte long se comportent moins bien dans une interface avec une fenêtre plus petite, c’est dû à une différence de conditions, pas à une dégradation du modèle lui-même.
Q5 : Comment comparer plusieurs ID de modèle via la même interface ?
Procédez en trois étapes :
1. Inscrivez-vous sur APIYI apiyi.com et générez une clé API ; les nouveaux utilisateurs peuvent recevoir un quota d’essai gratuit.
2. Définissez `base_url` sur `https://api.apiyi.com/v1` pour tous, et changez uniquement le champ `model` pour passer d’un ID à l’autre.
3. Pour chaque ID, définissez explicitement le même niveau de raisonnement et utilisez le même lot d’entrées pour la comparaison.
Ainsi, l’interface et le niveau sont fixés, et les différences proviennent principalement du modèle lui-même.
Q6 : `gemini-4-neon` est introuvable dans le tableau général des modèles : peut-on quand même l’appeler ?
La version du tableau général mise à jour le 2026-11-19 n’inclut pas `gemini-4-neon`, mais l’interface de tarification contient son tarif : après conversion, entrée `3`, sortie `15`, lecture du cache `0.15` dollar par million de tokens, ce qui correspond au prix affiché par Google. Il est conseillé de se fier au résultat en temps réel de l’interface de tarification d’APIYI apiyi.com et de vérifier une dernière fois avant l’appel.
Q7 : Quel élément est le plus facile à mal calculer lorsqu’on change de modèle ?
Les erreurs les plus fréquentes concernent les paliers de contexte long et la validité des prix. Pour `gpt-6.2-astra`, au-delà de `272000` tokens, le prix unitaire d’entrée passe de `8` à `16` ; l’interface de tarification précise aussi qu’à ce stade la sortie est facturée `60` et la lecture du cache `0.8`. Carbon est actuellement au prix de lancement ; à partir du 1er décembre, le prix standard de Google sera de `4` en entrée et `20` en sortie.
Vérification des benchmarks officiels — points clés
- Le score dépend de conditions : un score de benchmark correspond à une combinaison « ID du modèle + niveau de réflexion + point d’entrée », pas au nom du modèle seul.
- Vérifiez d’abord le niveau de réflexion : Neon est à
highpar défaut, Carbon àmediumpar défaut et n’a pas dexhigh— ne vous fiez pas aux valeurs par défaut. - Vérifiez ensuite la fenêtre du point d’entrée : Neon sur l’API dispose de
1,048,576tokens, tandis que la doc Antigravity indique un maximum de512K. - L’ID doit être identique : Gemini 4 a au moins quatre ID ; comparer un résultat Hydrogen avec le classement de Neon n’a aucun sens.
- L’alignement ne garantit pas l’égalité : aligner les conditions rend simplement la comparaison valide, cela ne promet pas de rattraper le score du classement.
- Changer de modèle face au prix du catalogue : sur APIYI apiyi.com, comparez plusieurs ID via un point de terminaison unifié, tout en vérifiant les prix dans le tableau récapitulatif et via l’interface de tarification.
En résumé
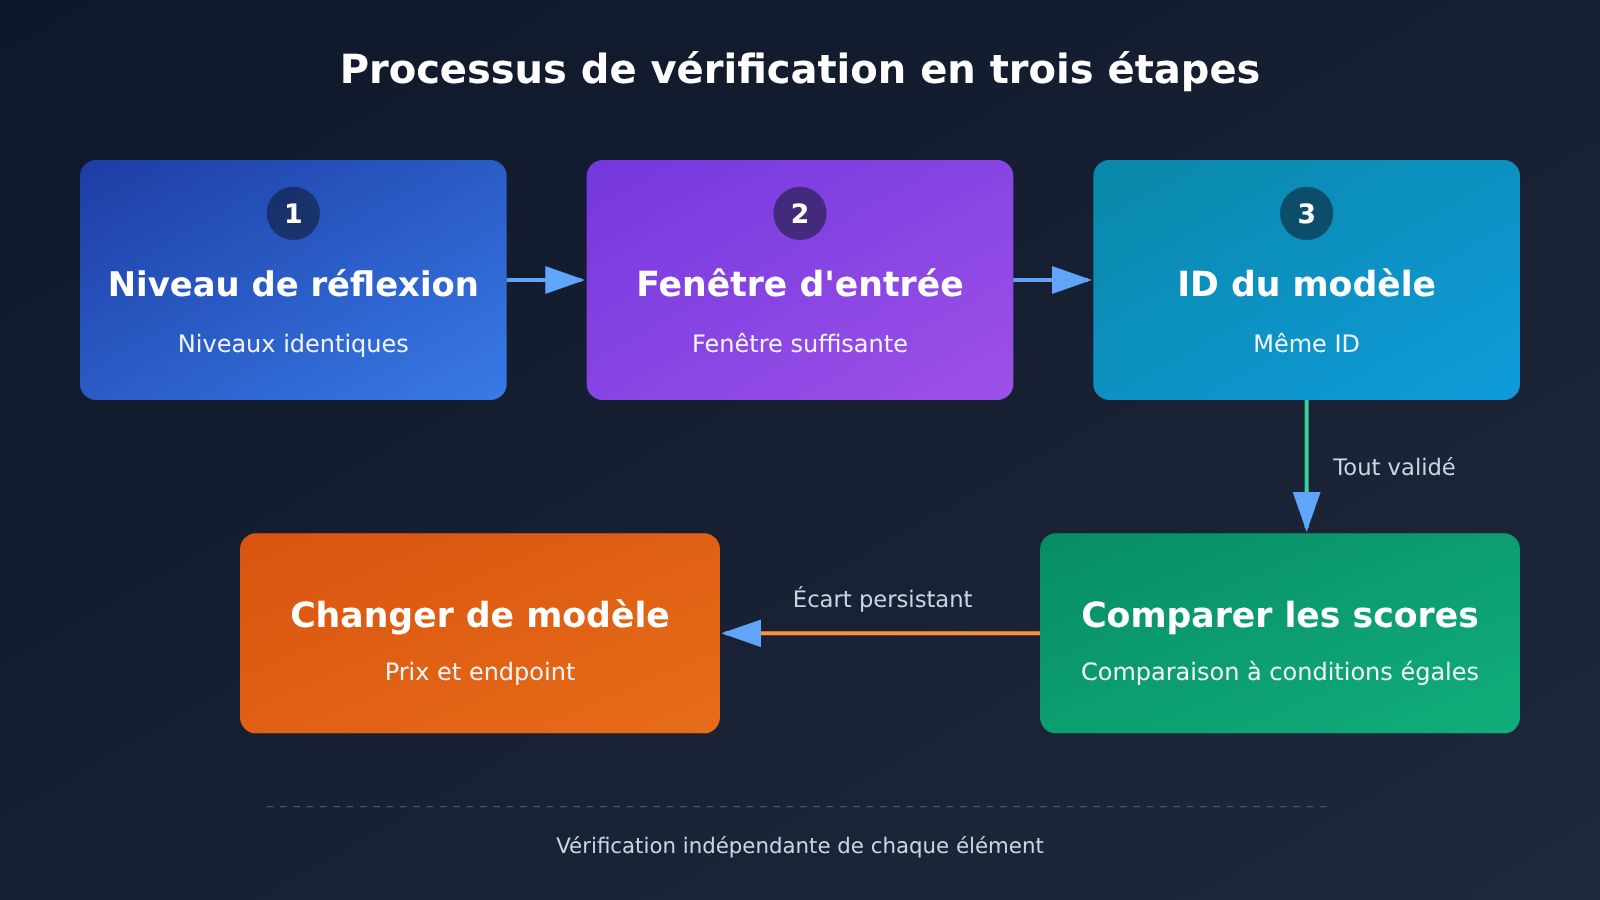
Lorsque les performances d’un modèle sont inférieures au benchmark officiel, l’ordre de vérification est le suivant :
- Aligner le niveau de réflexion : définissez explicitement le niveau utilisé lors du test du classement, et confirmez que cet ID possède bien ce niveau.
- Aligner la fenêtre du point d’entrée : assurez-vous que votre point d’entrée peut contenir le contenu de test, et faites attention aux noms de niveaux selon les points d’entrée.
- Aligner l’ID du modèle : indiquez l’ID complet dans la requête, puis vérifiez mot pour mot dans le tableau récapitulatif des modèles.
Une fois ces trois points alignés, si l’écart persiste, envisagez alors de changer de modèle. Lors d’un changement, comparez simultanément le niveau de capacité, le prix unitaire, le découpage des prix pour le contexte long et la fraîcheur des tarifs. Le jugement doit alors se fonder sur des résultats comparés à conditions égales, et non sur un chiffre de classement cité hors contexte.
Il est recommandé de vérifier plusieurs ID de modèles via APIYI apiyi.com, sous le même point de terminaison https://api.apiyi.com/v1. Une fois le point d’entrée et le niveau fixés, les conclusions comparatives seront bien plus fiables.
📚 Références
-
Tableau récapitulatif des modèles APIYI : synthèse des ID de modèles et des prix catalogue
- Lien :
docs.apiyi.com/models.md - À savoir : la version citée dans cet article est celle mise à jour le 2026-11-19 à 10:59 (UTC+8) ; elle permet de vérifier si un ID de modèle existe bien
- Lien :
-
Interface de tarification APIYI : multiplicateurs et prix unitaires en temps réel
- Lien :
api.apiyi.com/api/pricing - À savoir : version
shell-api-modelmak-v1; quandmodel_ratiovaut1, cela correspond à une entrée facturée 2 dollars par million de tokens, ce qui permet de convertir le prix unitaire de chaque modèle
- Lien :
-
Documentation et tarification officielles de Google Gemini 4 : niveaux de réflexion, fenêtre et prix affichés
- Lien :
ai.google.dev - À savoir : pour chaque ID, on y trouve le niveau de réflexion par défaut, les niveaux disponibles, la limite de fenêtre API et la date des changements de prix
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; vous trouverez davantage de documentation sur les modèles et les interfaces dans le centre de documentation APIYI.


