
Note de l’auteur : un tour d’horizon, en novembre 2026, de Gemini 4 Carbon, Claude Fable 5.2 et FastFrames d’Apple, pour vous aider à distinguer ce qui peut déjà être appelé via une API aujourd’hui de ce qui n’est encore qu’un article de recherche et des poids de modèle.
Les nouveaux modèles d’IA de novembre 2026 sont arrivés en l’espace de deux semaines : Google a ouvert Gemini 4 Carbon aux développeurs payants le 10 novembre, Anthropic a publié Claude Fable 5.2 le 9 novembre, et Apple a mis en ligne le 17 novembre l’article de recherche et les poids de FastFrames, son projet de recherche sur la vidéo. Les noms ne manquent pas, mais pour qui veut passer à l’action tout de suite, la vraie question est la suivante : qu’est-ce qui peut déjà être appelé via une API aujourd’hui, et qu’est-ce qui n’est encore qu’un article de recherche et des poids ?
Ce n’est pas un classement général pour savoir « qui est le premier ». Cet article se contente de recouper les informations concordantes des textes officiels, des articles de recherche et des pages de modèles des plateformes. Il ne tire aucune conclusion de tests pratiques et ne présente pas les capacités « maximales » annoncées officiellement comme des chiffres déjà mesurés.
À retenir : à la fin de cet article, vous aurez un tableau comparatif. Pour les tâches textuelles, vous pourrez basculer entre Gemini 4 Carbon et Claude Fable 5.2 selon vos besoins ; côté vidéo, il faudra d’abord faire la distinction : FastFrames correspond à des poids de recherche, pas à une API que l’on peut appeler.
Aperçu des informations essentielles sur les nouveaux modèles d’IA de novembre 2026
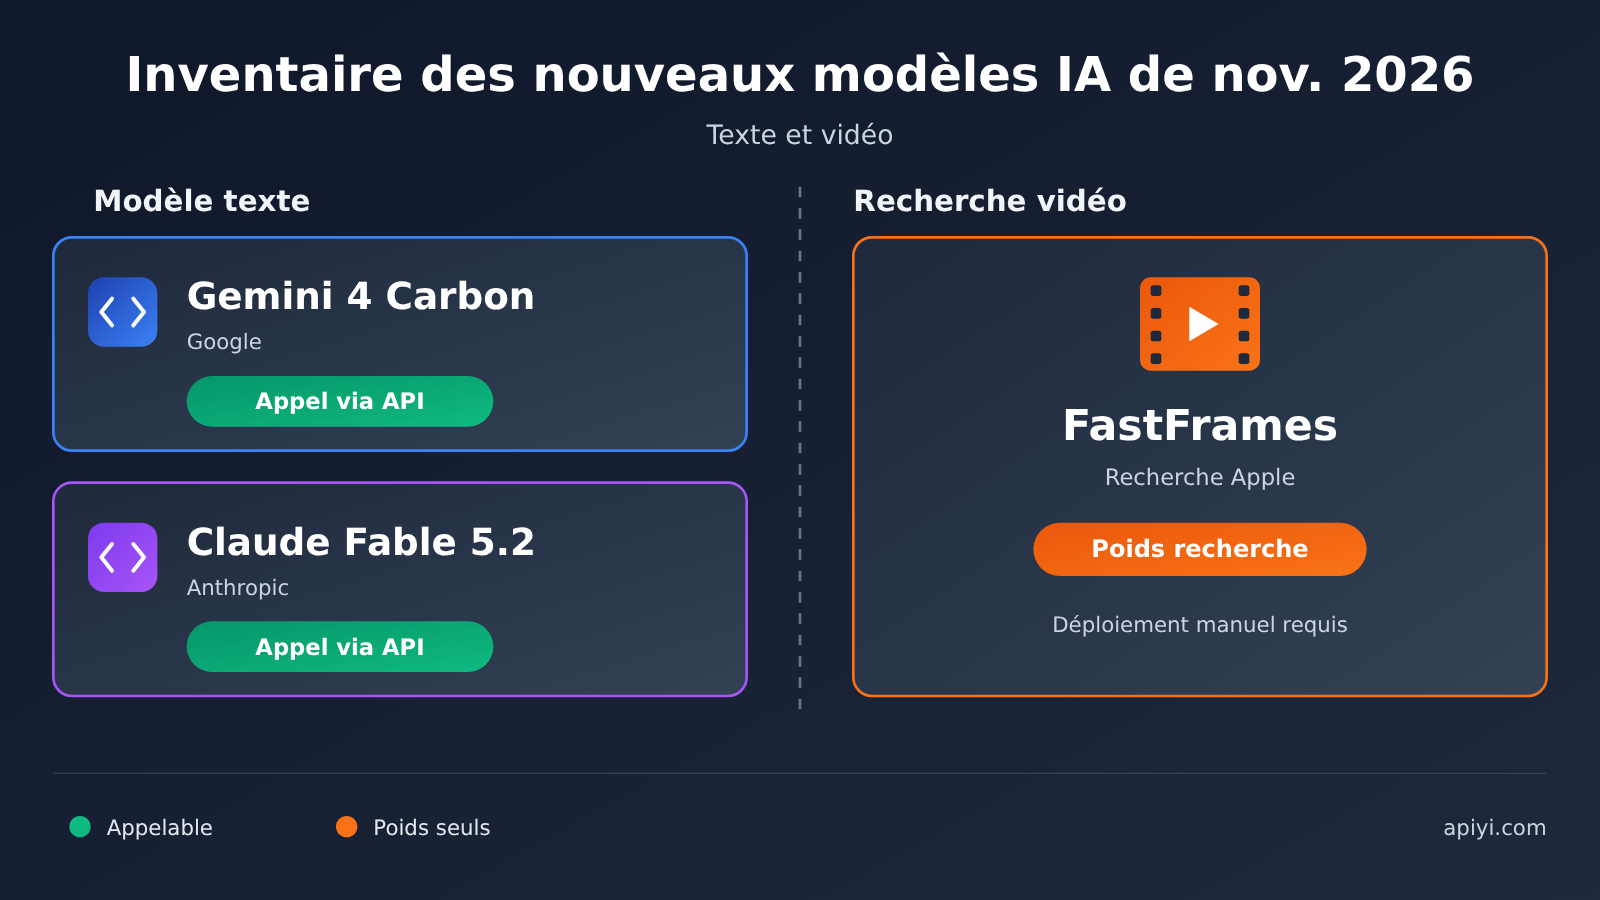
Le tableau ci-dessous répond d’abord aux questions les plus importantes : quel type de modèle est chaque modèle, qui l’a publié et peut-on l’appeler via API dès aujourd’hui ? Les dates suivent les annonces officielles ou la date de version des articles.
| Modèle | Éditeur | Type | Dates clés | Appel API possible aujourd’hui ? |
|---|---|---|---|---|
| Gemini 4 Carbon | Grand modèle de langage texte | 28 octobre : d’abord réservé aux équipes de cybersécurité défensive (Fairwind) ; 10 novembre : ouverture aux développeurs payants et aux entreprises | Oui, ID du modèle gemini-4-carbon |
|
| Claude Fable 5.2 | Anthropic | Grand modèle de langage texte | Publié le 9 novembre | Oui, ID du modèle claude-fable-5-2 |
| FastFrames | Apple Research | Recherche en génération vidéo | Date de la v1 de l’article : 17 novembre | Non : ce n’est pas une API, mais un article scientifique et des poids ouverts |
Les deux modèles texte figurent déjà dans la liste des modèles de la plateforme APIYI et peuvent être appelés directement au format compatible OpenAI. Pour les identifiants de modèles et les tarifs, référez-vous à la liste d’APIYI sur apiyi.com ; les données tarifaires de cet article ont été vérifiées au 2026-11-19.
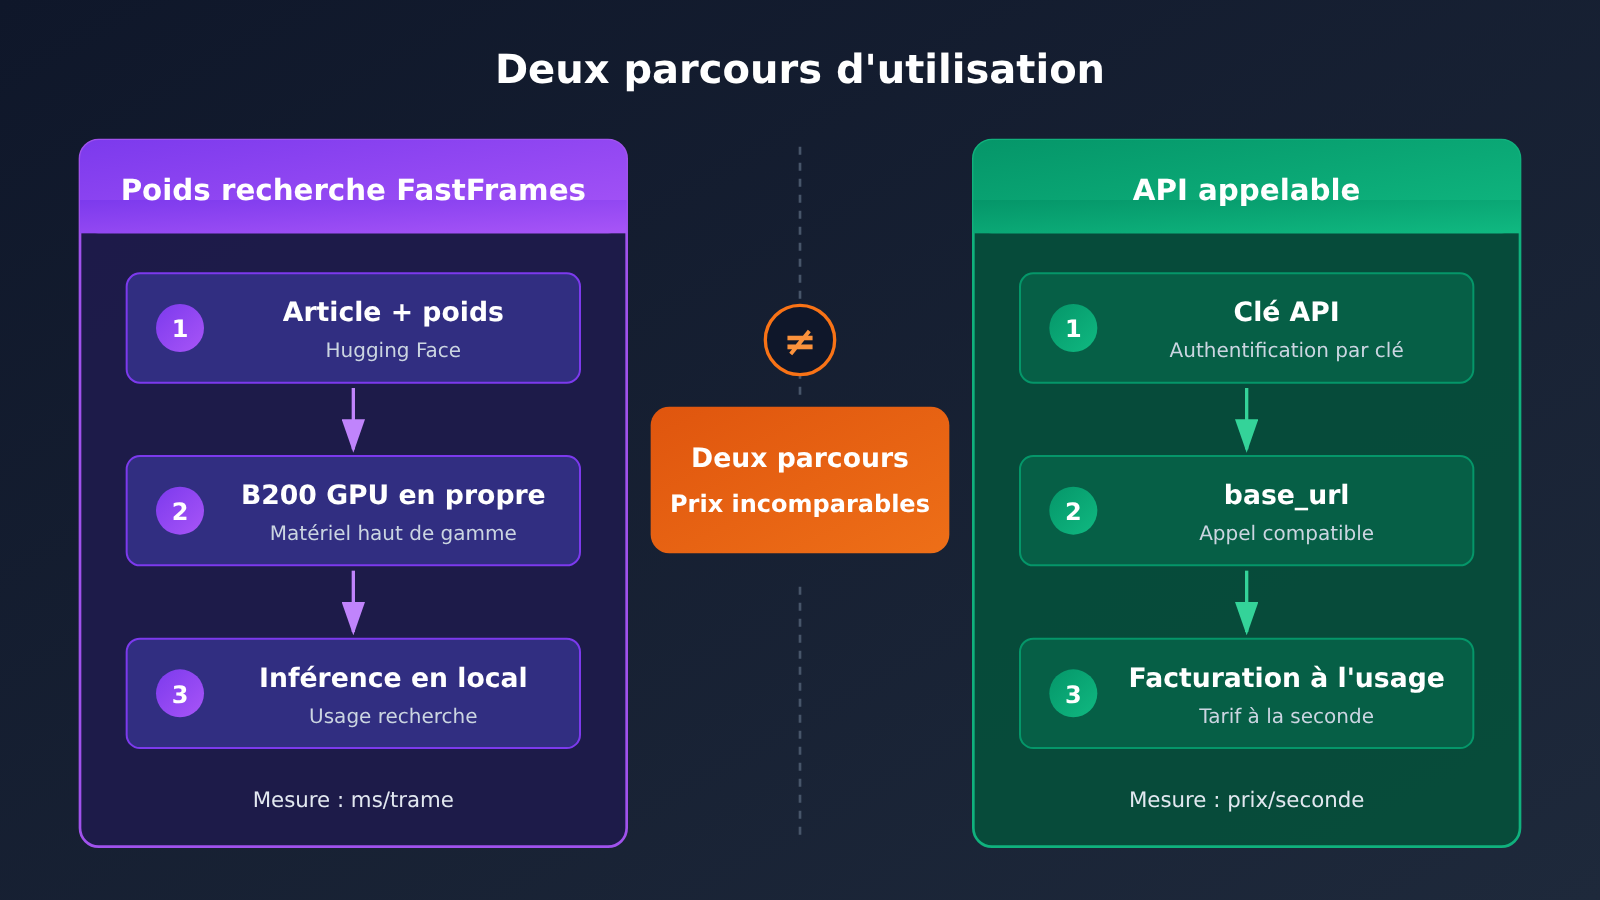
Le cas de FastFrames est tout différent. C’est un article scientifique accompagné d’un ensemble de fichiers de poids sur Hugging Face. Pour l’utiliser, il faut préparer soi-même des GPU et déployer l’inférence ; il n’existe pas de tarif à la requête, et nous y reviendrons plus bas.
Nouveau modèle de texte de novembre 2026 : décryptage de Gemini 4 Carbon
Le calendrier de lancement de Gemini 4 Carbon est assez particulier. Google l’a d’abord ouvert le 28 octobre aux défenseurs de la cybersécurité, puis l’a rendu disponible le 10 novembre aux développeurs payants et aux entreprises. Le prix de présentation officiel est identique à celui de Gemini 4 Argon : 2 dollars en entrée et 10 dollars en sortie par million de tokens.
Comparaison entre les chiffres officiels de Gemini 4 Carbon et la fiche modèle de la plateforme
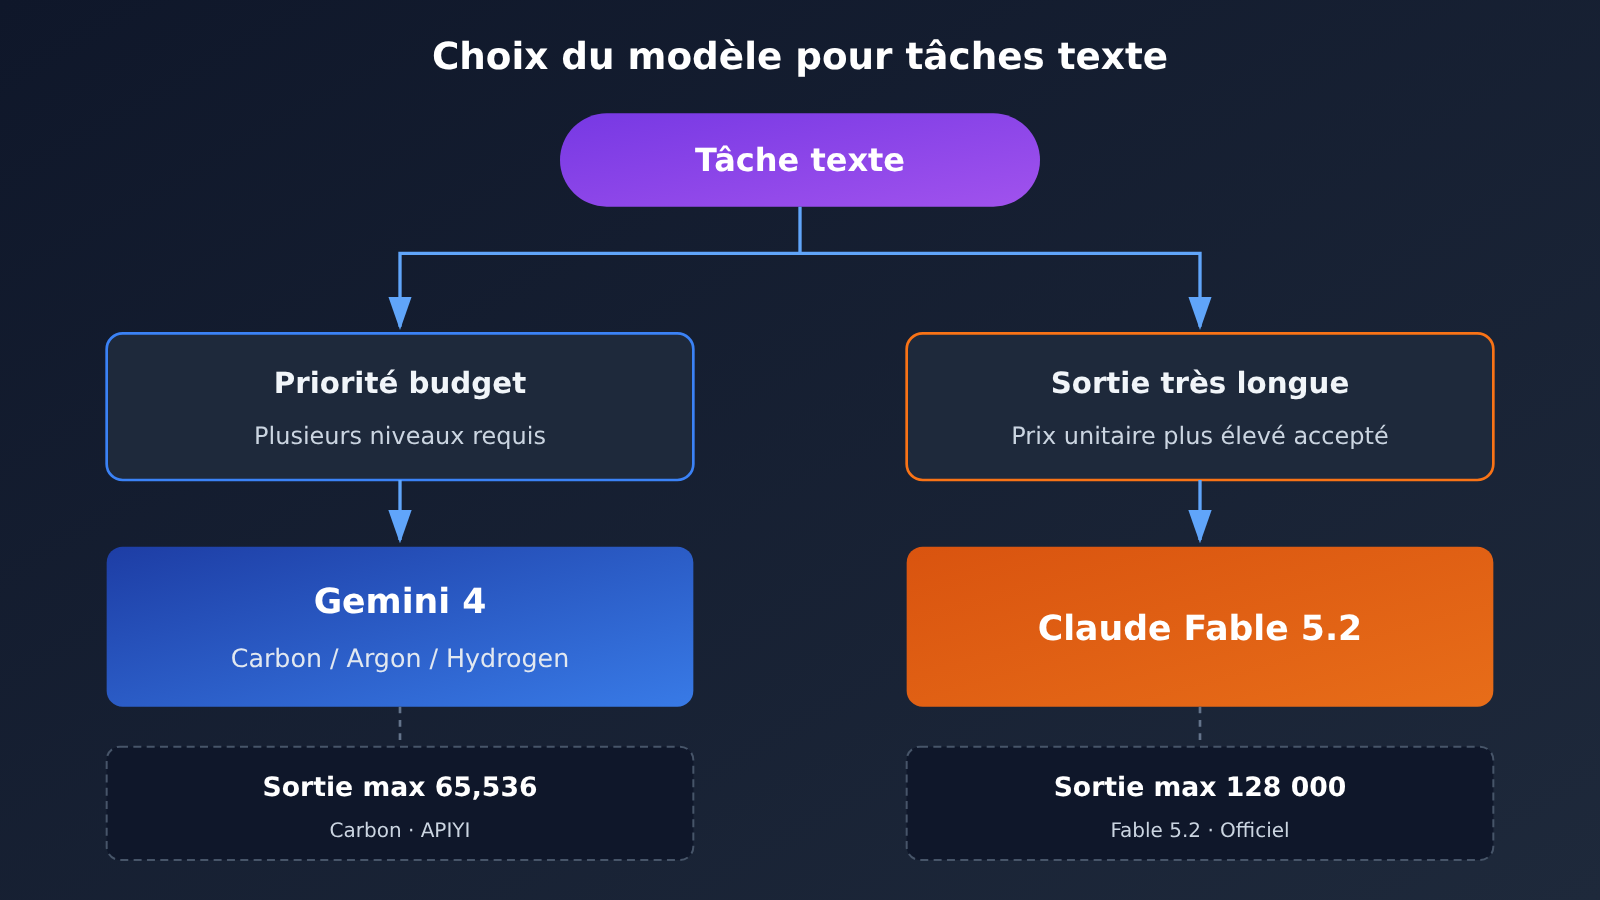
La sortie maximale de Carbon est présentée selon deux sources qu’il faut distinguer. La page d’explication de Google AI Studio indique qu’une réponse unique peut dépasser 64K, jusqu’à 1 million moins la longueur de l’entrée. La fiche modèle d’APIYI indique quant à elle une sortie maximale de 65,536 tokens.
| Paramètre | Source officielle (Google) | Fiche modèle APIYI |
|---|---|---|
| ID du modèle | Gemini 4 Carbon | gemini-4-carbon |
| Date de mise en ligne | Ouverture aux développeurs payants le 10 novembre | 2026-11-11 |
| Longueur du contexte | Environ 1 million | 1,048,576 tokens |
| Sortie maximale | Peut dépasser 64K, jusqu’à 1 million moins l’entrée | 65,536 tokens |
| Prix d’entrée | 2 dollars / million de tokens | 2 dollars / million de tokens |
| Lecture du cache | — | 0.1 dollar / million de tokens |
| Prix de sortie | 10 dollars / million de tokens | 10 dollars / million de tokens |
| Endpoints pris en charge | — | chat et gemini |
En pratique, la conclusion est simple : lorsque vous appelez gemini-4-carbon via APIYI, planifiez la limite de sortie par requête sur les 65,536 tokens indiqués dans la fiche modèle. La sortie ultra-longue officielle relève d’une autre logique et correspond à une indication valable dans l’environnement natif de Google ; il ne faut pas mélanger les deux chiffres. La fiche modèle contient également cette phrase tirée de la documentation : « un long document de 199 000 tokens a été traité avec succès » ; il s’agit d’une mention de la documentation, et non d’une conclusion de test de cet article.
Un prix unitaire identique ne signifie pas un coût identique par tâche
Beaucoup de gens, en voyant que Carbon et Argon ont le même prix unitaire, supposent que leur coût d’utilisation sera identique. Il y a pourtant un détail facile à négliger. Le texte officiel de Google indique clairement que Carbon utilise plus de tokens qu’Argon pour effectuer ses vérifications. Autrement dit, pour une même question soumise à Carbon, les tokens consommés en sortie ou en réflexion peuvent être plus élevés.
Un prix unitaire identique indique donc seulement que la facturation par million de tokens est la même ; cela ne veut pas dire que la facture d’une tâche donnée sera identique. Google ne précise pas l’écart exact, et cet article ne cherche pas non plus à estimer un facteur multiplicateur. Si vous êtes sensible aux coûts, la méthode la plus fiable consiste à exécuter plusieurs fois vos propres tâches réelles avec chaque modèle, puis à comparer la consommation de tokens sur la facture.
Dans la même série, il existe une option moins chère, gemini-4-hydrogen, affichée dans le tableau récapitulatif d’APIYI à 1.5 dollar en entrée, 0.075 dollar en lecture de cache et 7.5 dollars en sortie par million de tokens. Elle convient aux scénarios où l’on n’exige pas une vérification approfondie et où le volume d’appels est important.
Nouveaux modèles texte de novembre 2026 : décryptage de Claude Fable 5.2
Claude Fable 5.2 a été publié par Anthropic le 9 novembre, avec un ID de modèle claude-fable-5-2 indiqué dans la documentation officielle. Les paramètres officiels annoncent une fenêtre de contexte de 1 million de tokens, une sortie maximale de 128 000 tokens, et un tarif de 8 dollars en entrée et 40 dollars en sortie par million de tokens.
Comparaison des tarifs entre Claude Fable 5.2 et la génération précédente
Le tableau récapitulatif d’APIYI liste côte à côte claude-fable-5-2 et claude-fable-5-2-thinking, au même prix. La documentation officielle précise que la lecture de cache de Fable 5.2 représente 2,5 % du prix d’entrée : 2,5 % de 8 dollars font bien 0,2 dollar, ce qui colle au tableau de la plateforme.
| ID du modèle | Entrée (USD/million) | Lecture de cache (USD/million) | Sortie (USD/million) |
|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 |
claude-fable-5-2-thinking |
8 | 0.2 | 40 |
claude-fable-5-1 (génération précédente) |
10 | 0.25 | 50 |
On le voit dans le tableau : les trois tarifs unitaires de Fable 5.2 sont tous inférieurs à ceux de Fable 5.1. Si votre projet tourne aujourd’hui sur 5.1, passer à 5.2 fait baisser le prix unitaire — pour les différences de qualité réelles, mieux vaut les vérifier sur vos propres tâches.
À noter : le tableau d’APIYI ne propose pas de page de détail dédiée à Fable 5.2, donc les données de contexte et de sortie maximale ci-dessus proviennent de la documentation officielle d’Anthropic. Si vous avez besoin de sorties très longues, référez-vous aux indications officielles et définissez explicitement max_tokens dans la requête.
Nouveaux modèles d’IA de novembre 2026 : comparaison des prix et des modes d’appel
En plaçant côte à côte les deux nouveaux modèles textuels et leurs modèles voisins, les écarts de prix apparaissent plus clairement. Les prix unitaires ci-dessous sont exprimés en dollars par million de tokens et proviennent du tableau récapitulatif des modèles d’APIYI du même jour.
| ID du modèle | Entrée | Lecture du cache | Sortie | Plateformes disponibles |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | APIYI apiyi.com, Google officiel |
gemini-4-argon |
2 | 0.1 | 10 | APIYI, Google officiel |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | APIYI, Google officiel |
claude-fable-5-2 |
8 | 0.2 | 40 | APIYI, Anthropic officiel |
claude-fable-5-1 |
10 | 0.25 | 50 | APIYI, Anthropic officiel |
Prenons un scénario hypothétique pour faire le calcul : une tâche avec 100 000 tokens en entrée et 10 000 tokens en sortie. Sur la base des prix unitaires, Carbon revient à environ 0.2 + 0.1 = 0.3 USD, tandis que Fable 5.2 revient à environ 0.8 + 0.4 = 1.2 USD. Il ne s’agit que d’une illustration arithmétique fondée sur les prix unitaires : le coût réel de Carbon pourrait être plus élevé, car il peut consommer davantage de tokens pour la vérification. Seule la facture fait foi pour le montant réel.
Côté mode d’appel, les deux modèles sont accessibles via l’interface compatible OpenAI d’APIYI. Dans les deux cas, renseignez base_url avec https://api.apiyi.com/v1 ; pour changer de modèle, il suffit de modifier le champ model. Une seule clé API suffit pour appeler à la fois gemini-4-carbon et claude-fable-5-2, ce qui facilite les comparaisons A/B dans le même code.
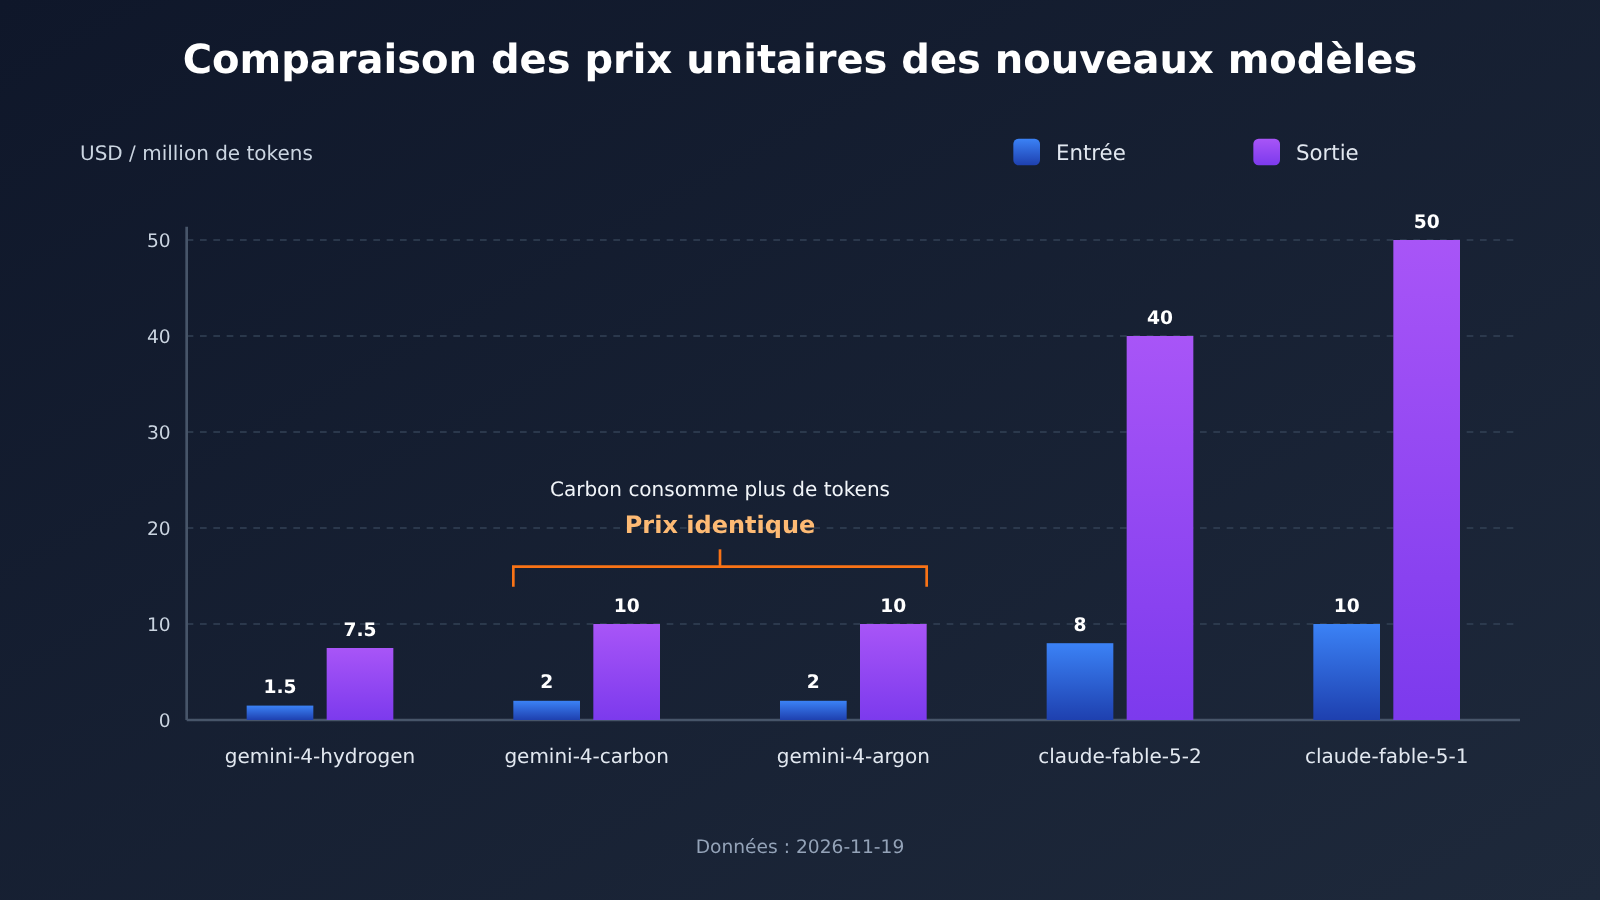
Note sur le graphique : les prix unitaires du graphique proviennent du tableau récapitulatif des modèles d’APIYI apiyi.com du 2026-11-19. La hauteur identique des barres Carbon et Argon signifie uniquement que leur prix unitaire est identique ; le coût d’une tâche doit être évalué en fonction de la consommation réelle de tokens.
Appeler rapidement Gemini 4 Carbon et Claude Fable 5.2 via l’API
Voici la méthode d’appel la plus simple : il suffit de modifier le champ model pour basculer entre les deux nouveaux modèles :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # remplacez par "claude-fable-5-2" pour basculer
    messages=[{"role": "user", "content": "用三句话解释零信任架构"}]
)
print(response.choices[0].message.content)
Voir le code d’appel complet pour la comparaison
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Via APIYI, la sortie maximale de Carbon est planifiée à 65 536 selon la page du modèle
MAX_OUTPUT = {
    "gemini-4-carbon": 65536,
    "claude-fable-5-2": 8192,  # à ajuster selon les besoins, sortie maximale officielle de 128 000
}

def ask(model: str, prompt: str, system: Optional[str] = None) -> dict:
    messages = []
    if system:
        messages.append({"role": "system", "content": system})
    messages.append({"role": "user", "content": prompt})

    resp = client.chat.completions.create(
        model=model,
        messages=messages,
        max_tokens=min(MAX_OUTPUT.get(model, 4096), 8192),
    )
    return {
        "model": model,
        "text": resp.choices[0].message.content,
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
    }

if __name__ == "__main__":
    task = "审查下面这段代码的安全隐患,并给出修复建议:..."
    for m in ["gemini-4-carbon", "claude-fable-5-2"]:
        r = ask(m, task, system="你是资深安全工程师")
        print(m, r["prompt_tokens"], r["completion_tokens"])
        print(r["text"][:300], "\n---")
Le code complet affiche les tokens d’entrée et de sortie à chaque appel, ce qui tombe à point nommé pour vérifier ce que nous évoquions plus haut : « même prix unitaire, coût par appel différent ». Faites tourner plusieurs fois la même tâche sur les deux modèles et comparez les completion_tokens : c’est bien plus fiable que de se contenter de lire la grille tarifaire.
🚀 Conseil pour bien démarrer : si vous voulez comparer ces deux nouveaux modèles sur vos propres tâches, commencez par créer un compte sur APIYI apiyi.com pour obtenir un quota d’essai gratuit, lancez une passe avec le code ci-dessus sur chacun, puis choisissez votre modèle principal en fonction de la consommation de tokens et de la qualité des réponses.
Nouveaux modèles vidéo de novembre 2026 : FastFrames, des poids de recherche
FastFrames vient de l’équipe de recherche d’Apple. L’article porte le numéro arXiv:2611.23226, et la version v1 est datée du 17 novembre 2026. Le projet dispose aussi d’une page dédiée sur GitHub Pages, et deux jeux de poids, FastFrames-S et FastFrames-L, sont disponibles sur Hugging Face.
Les chiffres que l’article FastFrames annonce lui-même
Tous les chiffres ci-dessous sont ceux que l’article annonce : ce ne sont ni des résultats définitifs de benchmarks tiers, ni un quelconque tarif à l’appel d’une API.
| Version | Paramètres | Matériel annoncé dans l’article | Vitesse annoncée dans l’article | Résolution |
|---|---|---|---|---|
| FastFrames-S | 1,3 milliard | Un seul B200 | Environ 36 millisecondes par image | 480p |
| FastFrames-L | 14 milliards | 8 B200 | Environ 45 millisecondes par image | 480p |
Ce tableau montre bien le positionnement de FastFrames : il présente une méthode de recherche pour générer rapidement des vidéos, image par image, sur des GPU haut de gamme. Pour retrouver ces vitesses, il faut se procurer soi-même du matériel de la classe B200 et réaliser le déploiement. C’est très différent d’un « je saisis une clé API et j’appelle le service ».
FastFrames reste par ailleurs un travail de recherche orienté vidéo : ce n’est pas un modèle généraliste qui traite à la fois le texte et la vidéo. Si votre objectif est de générer des vidéos dans votre produit dès aujourd’hui, mieux vaut consulter le tableau général des modèles d’APIYI et y repérer les modèles vidéo déjà facturés à la seconde. Évitez de comparer la vitesse par image de poids de recherche avec le prix d’une interface facturée à la seconde : ce sont deux choses distinctes.
Analyse d’impact des nouveaux modèles d’IA de novembre 2026
Impact pour les développeurs
- Plus de choix pour les modèles textuels, et un coût de bascule plus faible : Carbon et Fable 5.2 prennent tous deux en charge les appels compatibles OpenAI. Avec le même code, il suffit de changer l’ID de modèle pour comparer — idéal pour répartir selon les tâches plutôt que de miser sur un seul modèle.
- L’évaluation des coûts doit tenir compte de la consommation de tokens, pas seulement du prix unitaire : Carbon et Argon ont le même prix unitaire, mais la documentation officielle indique que Carbon consomme davantage de tokens pour la vérification. Le budget doit donc être établi d’après la facture réelle.
- La limite de sortie doit être confirmée selon le canal d’appel : la sortie longue officielle de Carbon et les 65 536 indiqués sur la page du modèle de la plateforme correspondent à deux références différentes. Lors de l’écriture du code, définissez
max_tokensen fonction du canal réel. - Dans le domaine vidéo, il faut d’abord distinguer la recherche de l’API : FastFrames convient aux équipes qui disposent de ressources GPU et souhaitent étudier la génération vidéo en temps réel. Il ne convient pas pour servir directement d’interface vidéo à un produit en ligne.
Impact pour le secteur
- L’ouverture prioritaire aux cas d’usage de sécurité devient un mode de lancement : Carbon est d’abord proposé aux équipes de défense en cybersécurité, puis aux développeurs payants. Cela montre que les éditeurs commencent à dévoiler les nouveaux modèles par étapes, selon les cas d’usage.
- Les prix des modèles haut de gamme baissent : les trois tarifs de Fable 5.2 sont inférieurs à ceux de Fable 5.1, et la tendance à la baisse des prix lors des itérations de modèles de même gamme se poursuit.
- La génération vidéo cherche à devenir temps réel : l’article sur FastFrames vise une vitesse de génération d’une seule frame de l’ordre de la milliseconde. L’attention de la recherche passe de « pouvoir générer » à « générer vite ».
FAQ — Questions fréquentes
Q1 : Quels nouveaux modèles d’IA peut-on appeler directement via API en novembre 2026 ?
Côté texte, Gemini 4 Carbon (`gemini-4-carbon`) et Claude Fable 5.2 (`claude-fable-5-2`, `claude-fable-5-2-thinking`) sont tous deux appelables directement. Côté vidéo, FastFrames est un article de recherche avec des poids publiés, pas une interface appelable.
Q2 : Gemini 4 Carbon et Gemini 4 Argon sont au même prix, lequel choisir ?
Les deux affichent le même tarif unitaire : 2 $ en entrée, 0,1 $ en lecture de cache et 10 $ en sortie par million de tokens. Mais la documentation originale de Google précise que Carbon consomme plus de tokens qu’Argon pour ses vérifications, ce qui peut rendre le coût par tâche plus élevé. Le mieux : lancer plusieurs fois chaque modèle sur vos vraies tâches, puis comparer la consommation de tokens et la qualité des résultats avant de trancher.
Q3 : Quelle est finalement la sortie maximale de Gemini 4 Carbon ?
Ça dépend du canal d’accès. Via APIYI, fiez-vous aux 65 536 tokens indiqués sur la page du modèle. La documentation officielle de Google AI Studio parle d’une réponse unique pouvant dépasser 64K, jusqu’à 1 million moins l’entrée : c’est une autre référence, celle de l’environnement natif de Google.
Q4 : Peut-on utiliser FastFrames pour générer des vidéos dans un produit ?
FastFrames est un travail de recherche d’Apple, qui fournit un article et des poids sur Hugging Face ; la vitesse annoncée dans l’article repose sur un GPU de classe B200. Pour générer des vidéos directement via une interface, choisissez plutôt un modèle vidéo facturé à la seconde dans le tableau général des modèles APIYI, et non des poids de recherche pour comparer les prix.
Q5 : Comment appeler rapidement Gemini 4 Carbon et Claude Fable 5.2 ?
Le plus simple est de tout tester via une plateforme d’agrégation d’API :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte
2. Récupérez votre clé API et le quota d’essai gratuit réservé aux nouveaux utilisateurs
3. Utilisez le code de cet article, avec `https://api.apiyi.com/v1` dans `base_url`, et `gemini-4-carbon` puis `claude-fable-5-2` dans `model`
Une seule clé suffit pour appeler les deux modèles, ce qui facilite les comparaisons et les bascules.
Q6 : Quelles limites faut-il garder en tête avec ces nouveaux modèles ?
Le tarif unitaire de Carbon est identique à celui d’Argon, mais la consommation réelle de tokens peut être plus élevée : le coût demande à être confirmé par des tests. Fable 5.2 coûte quatre fois plus cher que Carbon, et la facture grimpe nettement sur les scénarios à longue sortie. Enfin, les chiffres de vitesse de FastFrames sont tous auto-déclarés dans l’article et supposent de disposer de son propre GPU haut de gamme : ils ne sont pas comparables aux performances d’une API.
Points clés des nouveaux modèles IA de novembre 2026
- Deux modèles texte disponibles par API :
gemini-4-carbonetclaude-fable-5-2peuvent désormais tous deux être invoqués via une interface compatible OpenAI. - Carbon au même tarif unitaire qu’Argon : 2 $ en entrée et 10 $ en sortie par million de tokens pour les deux, mais l’éditeur indique que Carbon consommera davantage de tokens.
- Deux valeurs annoncées pour la sortie de Carbon : côté plateforme, la planification se fait sur 65,536 tokens ; la limite officielle de sortie longue est annoncée avec un autre chiffre.
- Fable 5.2 moins cher que 5.1 : entrée à 8, lecture du cache à 0.2, sortie à 40 ; les trois tarifs unitaires sont inférieurs à ceux de la génération précédente.
- FastFrames, des poids de recherche : un article d’Apple et des poids publiés sur Hugging Face ; la vitesse annoncée vient de l’article, pas d’un tarif d’API.
- Pour commencer : sur APIYI, il suffit de changer l’ID du modèle avec la même clé API pour comparer les deux nouveaux modèles texte.
Résumé
Points essentiels des nouveaux modèles IA de novembre 2026 :
- Deux nouvelles options côté texte : Gemini 4 Carbon a un tarif unitaire bas et plusieurs paliers dans sa gamme ; Claude Fable 5.2 affiche une limite de sortie officielle plus élevée, avec un prix unitaire inférieur à la génération précédente.
- Le coût dépend de la consommation réelle : un tarif unitaire identique ne signifie pas un prix identique par appel ; les vérifications supplémentaires de Carbon se retrouveront dans le nombre de tokens utilisés.
- Côté vidéo, commencez par distinguer la nature du projet : FastFrames consiste en poids de recherche, une option adaptée aux équipes de recherche disposant de ressources GPU ; pour une intégration produit, choisissez un modèle vidéo facturé à la seconde.
Pour les développeurs qui veulent passer à l’action tout de suite, la méthode la plus utile consiste à répartir les tâches : confiez le même lot de tâches réelles à Carbon et à Fable 5.2, puis décidez à partir de la facture et de la qualité des sorties, plutôt que de vous fier à un classement général. Pour mener cette comparaison rapidement, le plus simple est de passer par APIYI apiyi.com avec une seule clé API ; les modèles et les prix de référence sont ceux de la liste des modèles de la plateforme.
📚 Références
-
Blog officiel de Google – Annonce de la disponibilité de Gemini 4 Carbon : date d’ouverture et tarif de lancement officiel
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ - Description : contient les précisions officielles sur le tarif identique à celui d’Argon et sur la vérification de l’usage des tokens
- Lien :
-
Google AI Studio – Notes de mise à jour de Gemini 4 Carbon : position officielle sur les réponses longues
- Lien :
aistudio.google.com/docs/whats-new-gemini-4-carbon - Description : la source officielle indiquant qu’une réponse unique peut dépasser 64K
- Lien :
-
Documentation officielle Anthropic – Aperçu de Claude Fable 5.2 : ID du modèle, fenêtre de contexte et tarifs
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - Description : la source des 128 000 tokens de sortie maximum et de la lecture de cache à 2,5 %
- Lien :
-
Apple Research – Page du projet FastFrames : article de recherche et présentation
- Lien :
apple-aiml-research.github.io/ml-fastframes/ - Description : article arXiv:2611.23226, date de la v1 : 2026-11-17
- Lien :
-
Hugging Face – Poids de FastFrames : deux versions, S et L
- Lien :
huggingface.co/apple/FastFrames-S - Description : point d’entrée pour télécharger les poids de recherche ; le déploiement de l’inférence reste à votre charge
- Lien :
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; les détails des modèles et la documentation d’appel sont disponibles dans le centre de documentation docs.apiyi.com


