
Note de l’auteur : cet article liste séparément la limite de vitesse officielle, le prix promotionnel et le tarif catalogue de GPT-6.2 Sol Ultrafast, puis fournit une méthode de calcul du surcoût de vitesse que vous pouvez appliquer à vos propres tâches.
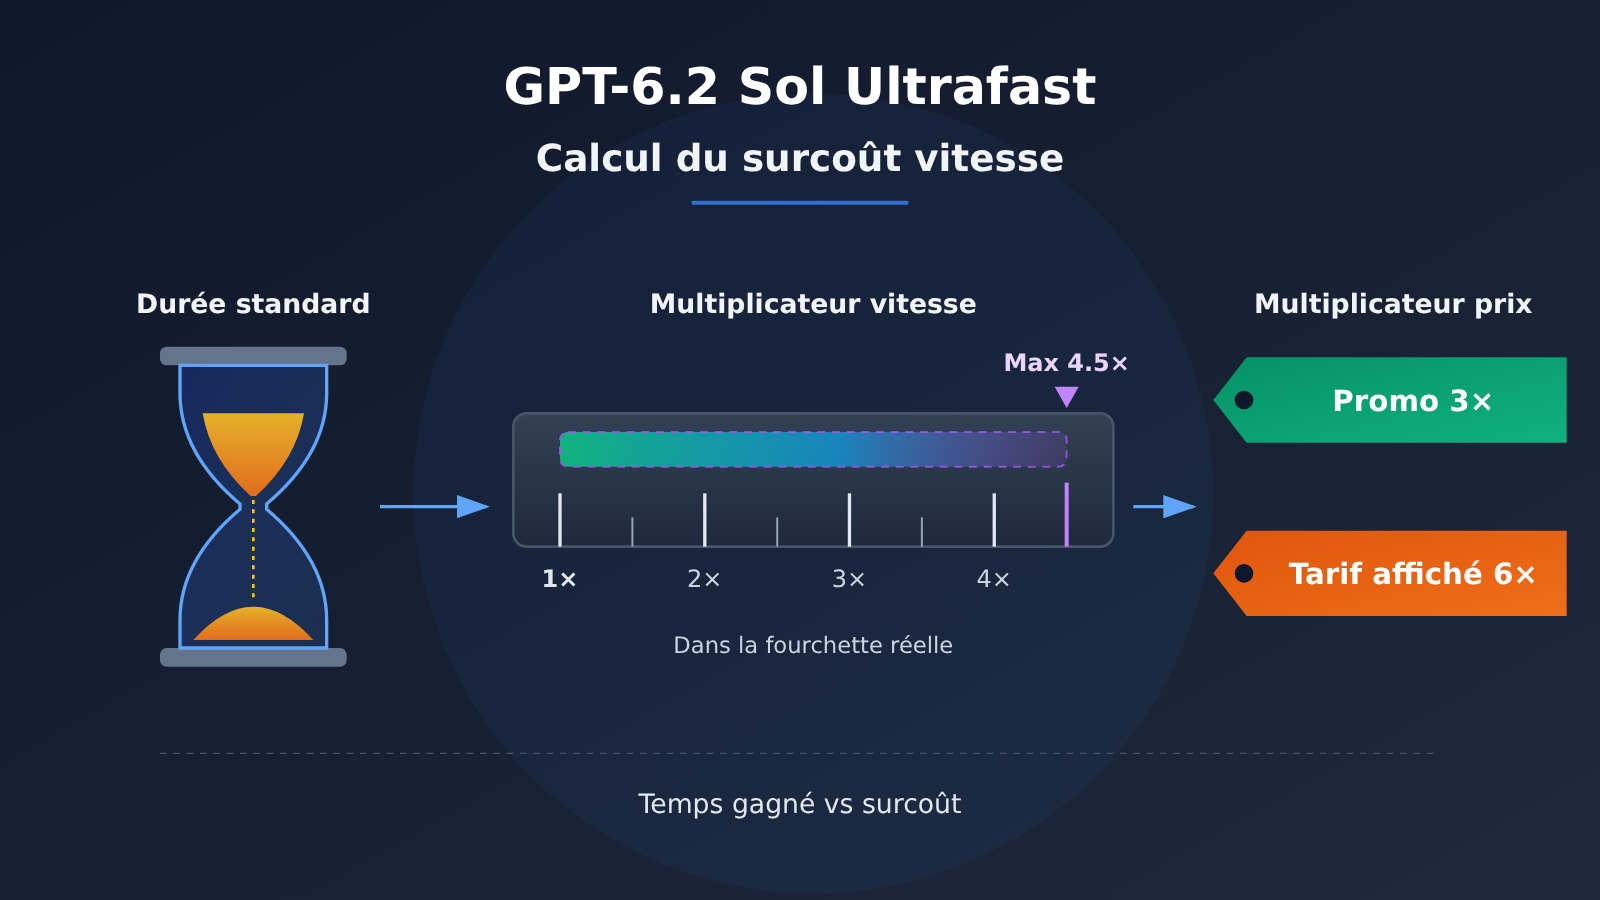
Faut-il activer Ultrafast pour GPT-6.2 Sol ? Tout dépend du temps d’attente que cette tâche permet d’économiser. La vitesse annoncée par la documentation officielle est de jusqu’à 4,5 fois celle du palier standard du même modèle, le prix promotionnel est de 3 fois le prix standard, et le tarif catalogue à partir de mars 2027 est de 6 fois. La vitesse est un plafond, le prix un chiffre certain : leur degré de certitude n’est pas le même, on ne peut donc pas les diviser directement.
Cet article ne répond pas à votre place à la question « faut-il l’acheter ? ». Nous ne tirons aucune conclusion de nos propres tests de vitesse et nous ne présenterons pas un relevé empirique sans groupe de contrôle comme un résultat définitif. Cet article fournit seulement une méthode : mesurez d’abord la durée de votre propre tâche sur le palier standard, utilisez ensuite le multiplicateur « maximal » officiel pour calculer la limite supérieure du temps économisé, puis comparez-la à l’écart de prix.
L’essentiel : après lecture, vous saurez calculer, pour n’importe quelle tâche, « combien vous payez en plus pour chaque minute gagnée », puis décider d’activer ou non le palier de vitesse selon la tâche.
GPT-6.2 Sol Ultrafast : les vraies différences du surcoût de vitesse
Commençons par clarifier un point : Ultrafast est un palier de service, pas un autre modèle. Comme l’indique la documentation officielle de l’API, le champ model de la requête reste gpt-6.2-sol ; il suffit d’ajouter service_tier et de le définir sur ultrafast. À ce jour, ce palier de service est pris en charge par GPT-6.2 Astra, GPT-6.2 Sol, GPT-6 Astra et GPT-6.1 Sol.
Vous comparez donc deux vitesses de service d’un même modèle, et non les capacités de deux modèles différents. On peut laisser de côté la question de la qualité de sortie : il ne reste que deux variables, le temps et le prix.
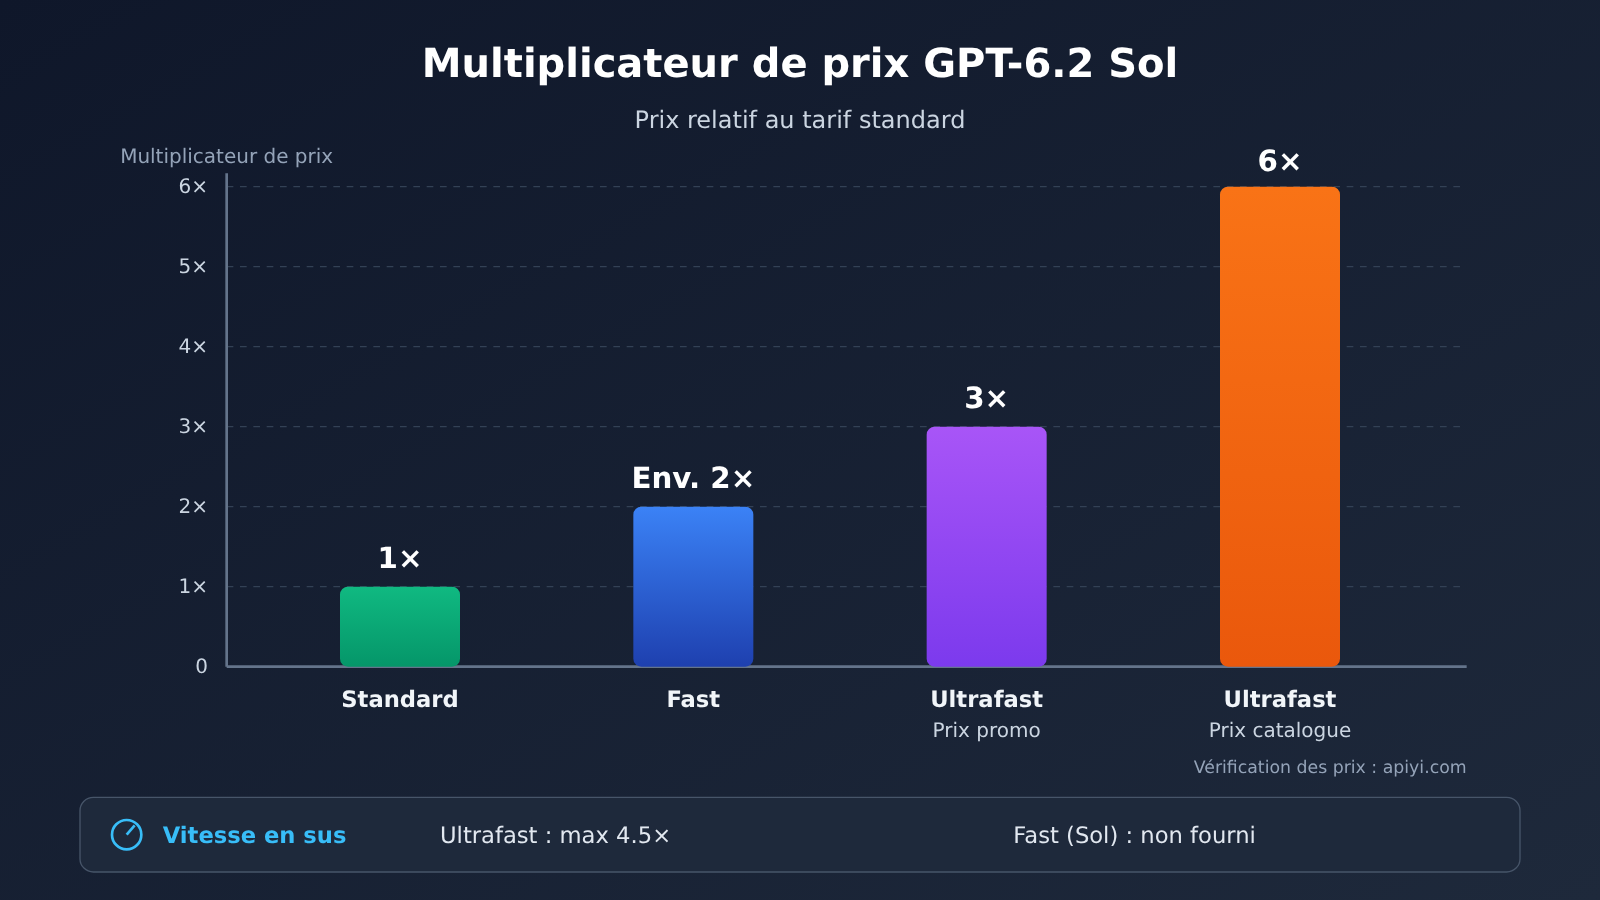
| Niveau (gpt-6.2-sol, contexte court) | Entrée | Lecture du cache | Sortie | Rapport au tarif standard | Mention de vitesse officielle |
|---|---|---|---|---|---|
| Palier standard | 2 | 0.10 | 10 | 1× | Référence |
| Fast | 4 | 0.20 | 20 | environ 2× | La doc n’indique pas de multiple de vitesse pour Sol |
| Ultrafast promotionnel (jusqu’au 2027-02-28, heure du Pacifique) | 6 | 0.30 | 30 | 3× | Jusqu’à 4.5× |
| Ultrafast au tarif catalogue (à partir du 2027-03-01) | 12 | 0.60 | 60 | 6× | Jusqu’à 4.5× |
Les prix du tableau sont en dollars par million de tokens ; « contexte court » désigne une entrée ne dépassant pas 272 000 tokens. Une précision importante pour le palier Fast : la mention « environ 1.5× plus rapide » de la documentation officielle concerne GPT-6.2 Astra et GPT-5.6, et n’est pas indiquée pour GPT-6.2 Sol. Ce multiple ne doit donc pas être appliqué au palier Fast de Sol.
Tarification de GPT-6.2 Sol Ultrafast pour le contexte long
Dès que l’entrée dépasse 272 000 tokens, on bascule sur la tarification contexte long. Pour le niveau standard officiel, le prix contexte long est de 4 en entrée, 0,20 en lecture de cache et 15 en sortie. Le tarif promotionnel Ultrafast est de 12 / 0,60 / 45, et le tarif catalogue de 24 / 1,20 / 90, soit toujours 3 fois et 6 fois le prix standard.
| Poste de facturation (contexte long, USD par million de tokens) | Entrée | Lecture de cache | Sortie |
|---|---|---|---|
| Niveau standard officiel | 4 | 0,20 | 15 |
| Ultrafast promotionnel | 12 | 0,60 | 45 |
| Ultrafast tarif catalogue | 24 | 1,20 | 90 |
Tableau récapitulatif APIYI gpt-6.2-sol (au-delà de 272 000 tokens en entrée) |
3 | Voir la liste de la plateforme | Voir la liste de la plateforme |
Il y a ici une incohérence de chiffres qu’il faut signaler séparément : le tableau récapitulatif des modèles d’APIYI (apiyi.com) indique un palier de 0 à 272 000 tokens en entrée à 2 dollars, puis 3 dollars en entrée au-delà de 272 000, alors que le prix d’entrée du contexte long du niveau standard officiel est de 4 dollars. Ces deux chiffres ne doivent pas être fusionnés : un appel via APIYI est facturé 3 dollars selon le tableau récapitulatif, un appel en direct chez l’officiel est facturé 4 dollars.
GPT-6.2 Sol Ultrafast : d’où vient sa vitesse — plafond officiel et mesures de la communauté
Côté vitesse, on dispose aujourd’hui de deux catégories d’informations dont la fiabilité est très inégale : mieux vaut les traiter séparément.
| Source | Contenu | Nature | Utilisable comme multiplicateur pour votre cas ? |
|---|---|---|---|
| Documentation officielle Codex / API | La vitesse de génération d’Ultrafast atteint jusqu’à 4,5 fois celle du niveau standard du même modèle (up to 4.5 times) | Plafond annoncé officiellement | Uniquement comme plafond |
| Artificial Analysis | Environ 85 tokens de sortie/seconde pour le niveau standard du même modèle | Benchmark public tiers | Uniquement comme référence |
| Relais d’OrcaRouter du 2026-11-18 | Une tâche à environ 126 tokens/seconde en moyenne, avec des pics autour de 252 | Un seul relevé, sans comparaison au niveau standard | Non |
Le texte officiel emploie « up to », c’est-à-dire « jusqu’à » : cela indique un maximum atteignable, sans garantir que chaque requête y parvienne. Dans un calcul, il faut donc le placer dans la colonne « meilleur cas ».
OrcaRouter a relayé le 2026-11-18 le retour d’un monteur sur X à propos d’une tâche unique : Ultrafast tournait en moyenne à environ 126 tokens par seconde, avec des pics autour de 252 ; le temps réel de la tâche était d’environ 27 minutes, dont environ 14 minutes de réponse du modèle. L’auteur du relais compare ce chiffre aux 85 tokens/seconde du niveau standard publiés par Artificial Analysis et en déduit un facteur d’environ 1,5. Or il ne s’agit que d’une seule exécution, sans répétition ni comparaison avec le niveau standard sur la même tâche : c’est un point de données isolé, qui ne peut pas représenter la performance finale de ce palier de vitesse.
Ce relevé met aussi en évidence un fait qu’on oublie facilement : sur 27 minutes de temps réel, la réponse du modèle n’en occupe qu’une quinzaine. Un palier de vitesse n’accélère que la phase de génération du modèle ; les appels d’outils, la lecture et l’écriture de fichiers, les validations humaines et autres étapes ne deviennent pas plus rapides pour autant.
Comment calculer le premium de vitesse de GPT-6.2 Sol Ultrafast : une formule réutilisable
La méthode ci-dessous évite volontairement de s’appuyer sur des multiplicateurs « mesurés par d’autres ». La seule donnée que vous devez fournir vous-même, c’est la durée de cette tâche en mode standard.
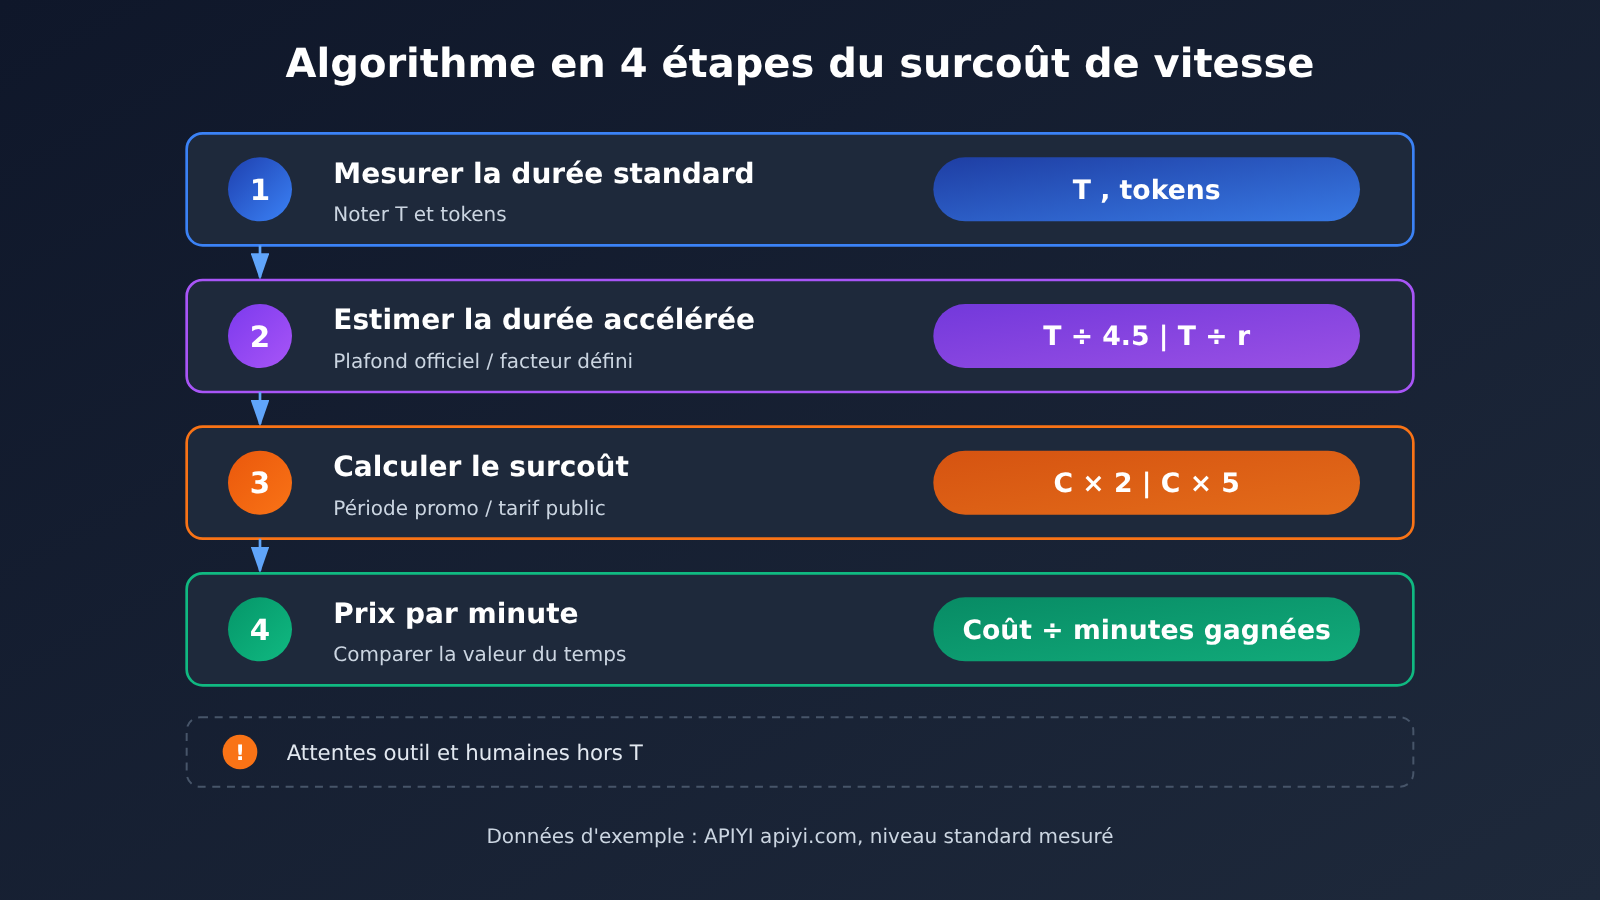
| Étape | Élément de calcul | Formule | Explication |
|---|---|---|---|
| ① | Durée de génération T en mode standard | À mesurer soi-même | On ne compte que la génération du modèle, pas le temps des outils |
| ② | Temps économisé dans le meilleur cas | T × (1 − 1/4,5) ≈ 0,78T | On utilise le plafond officiel |
| ②′ | Temps économisé dans le cas prudent | T × (1 − 1/r) | r est le multiplicateur que vous fixez vous-même, avec r ≤ 4,5 |
| ③ | Coût C en mode standard | entrée × prix unitaire + lecture de cache × prix unitaire + sortie × prix unitaire | On choisit le palier de prix selon la longueur du contexte |
| ④ | Coût supplémentaire en période promo | C × 2 | Le prix Ultrafast en promo est de 3C |
| ④′ | Coût supplémentaire au tarif catalogue | C × 5 | Le prix Ultrafast au tarif catalogue est de 6C |
| ⑤ | Prix par minute économisée | coût supplémentaire ÷ minutes gagnées | À comparer avec la valeur de votre temps |
Exemple de calcul pour GPT-6.2 Sol Ultrafast
Voici une démonstration de l’algorithme avec un ensemble de chiffres hypothétiques ; ces chiffres ne sont pas des résultats de mesure de vitesse. Supposons qu’une tâche ait 200 000 tokens en entrée (contexte court), 50 000 tokens en sortie, sans aucun cache hit ; votre propre vitesse de sortie mesurée avec l’offre standard est de 80 tokens/seconde.
- Coût de l’offre standard C = 0.2 × 2 + 0.05 × 10 = 0.9 dollar.
- Temps de génération de l’offre standard T = 50000 ÷ 80 ≈ 625 secondes, soit environ 10.4 minutes.
- Le prix promotionnel d’Ultrafast est de 2.7 dollars, soit 1.8 dollar de plus ; le prix catalogue est de 5.4 dollars, soit 4.5 dollars de plus.
| Facteur r supposé | Temps de génération | Temps gagné | Prix par minute pendant la promotion | Prix par minute au tarif catalogue |
|---|---|---|---|---|
| 4.5 (plafond officiel) | environ 2.3 minutes | environ 8.1 minutes | environ 0.22 dollar | environ 0.56 dollar |
| 3 | environ 3.5 minutes | environ 6.9 minutes | environ 0.26 dollar | environ 0.65 dollar |
| 2 | environ 5.2 minutes | environ 5.2 minutes | environ 0.35 dollar | environ 0.87 dollar |
| 1.5 | environ 6.9 minutes | environ 3.5 minutes | environ 0.51 dollar | environ 1.29 dollar |
Ce tableau met en évidence deux choses. Premièrement, lorsque le facteur passe de 4.5 à 1.5, le prix par minute environ double ; l’hypothèse sur le facteur est donc plus déterminante que le prix lui-même. Deuxièmement, après l’entrée en vigueur du prix catalogue de mars 2027, gagner la même minute coûtera environ 2.5 fois plus cher ; les conclusions de la période promotionnelle ne pourront donc pas être reconduites telles quelles l’année prochaine.
💰 Conseil pour vérifier les coûts : le prix unitaire de l’offre standard dans l’exemple peut être directement comparé au tarif de
gpt-6.2-soldans le tableau récapitulatif d’APIYI apiyi.com (entrée 2, lecture du cache 0.1, sortie 10). Cette grille tarifaire correspond à celle de l’offre standard officielle pour un contexte court et convient comme source de la valeur C dans l’algorithme.
Mesurez avec du code le temps de traitement de votre GPT-6.2 Sol en mode standard
La première étape de l’algorithme a besoin d’un T réel. Le code ci-dessous s’appuie sur la sortie en streaming pour relever le temps du premier token et le temps total de génération, puis récupère le nombre de tokens dans usage afin de calculer la vitesse de votre type de tâche en mode standard.
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Point d'entrée compatible OpenAI d'APIYI
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "把你的真实任务提示词放在这里"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"首 token {first - start:.1f}s,生成 {gen:.1f}s,"
      f"输出 {usage.completion_tokens} tokens,约 {usage.completion_tokens / gen:.0f} tok/s")
Voir le script de comparaison complet avec service_tier
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # dollars par million de tokens, contexte court
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # Syntaxe officielle : même ID de modèle, on ajoute service_tier
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "把你的真实任务提示词放在这里"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"标准档:生成 {t_std:.1f}s,费用约 ${c_std:.3f},返回档位 {s_std}")

for name, r in [("官方上限", 4.5), ("保守假设", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:省 {saved_min:.1f} 分钟,"
          f"促销每分钟 ${c_std * 2 / saved_min:.3f},刊例每分钟 ${c_std * 5 / saved_min:.3f}")

# Pour mesurer réellement le mode rapide, décommentez les lignes ci-dessous et vérifiez que le champ service_tier renvoyé vaut bien ultrafast
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度档:生成 {t_uf:.1f}s,实际倍数约 {t_std / t_uf:.2f},返回档位 {s_uf}")
À propos de service_tier, une précision s’impose : le tableau général des modèles publié sur APIYI apiyi.com ne liste que gpt-6.2-sol, sans modèle ultrafast distinct, et n’indique pas le champ service_tier ; les prix affichés correspondent au palier standard. Cet article se limite à vérifier la documentation et la grille tarifaire, sans envoyer de requête réelle ; il est donc impossible de dire comment ce paramètre se comporte lors d’un appel via https://api.apiyi.com/v1. Si vous avez besoin du palier de vitesse, fiez-vous au champ de palier renvoyé dans la réponse et à la facturation ; pour le modèle et le prix, référez-vous à la liste des modèles de la plateforme.
🚀 Conseil pour démarrer : commencez par exécuter deux ou trois fois vos propres tâches réelles avec
gpt-6.2-solau palier standard d’APIYI apiyi.com, puis prenez la médiane du temps de génération comme T. Cette étape ne coûte que le prix standard, mais elle détermine la précision de tous les calculs qui suivent.
Scénarios recommandés pour GPT-6.2 Sol Ultrafast
La conclusion dépend de la tâche. Une même personne peut aboutir à des réponses opposées selon la tâche.
Scénarios où activer Ultrafast est pertinent
- Tâches interactives où quelqu’un attend le résultat devant l’écran : par exemple la programmation en binôme en temps réel ou une démonstration en direct. Le temps d’attente est directement un coût de main-d’œuvre ; avec la formule ci-dessus, le prix unitaire suffit généralement à le couvrir.
- Tâches où la génération représente une part élevée de la durée réelle : si T constitue l’essentiel de la durée totale de la tâche, le temps gagné se traduit directement dans le délai de livraison.
- Tâches à contexte court pendant une période promotionnelle : avec un prix multiplié par 3 et un prix unitaire faible grâce au contexte court, le surcoût absolu reste faible.
Scénarios où mieux vaut rester au palier standard
- Traitement par lots en arrière-plan, tâches nocturnes : personne n’attend, donc les minutes gagnées n’ont pas de valeur temporelle associée.
- Tâches d’agent gourmandes en appels d’outils : comme dans le relevé mentionné plus haut, sur 27 minutes de durée réelle, la réponse du modèle ne représente qu’environ 14 minutes ; le palier de vitesse ne peut en compresser qu’une partie.
- Tâches à contexte long et à sortie volumineuse : pendant la période de tarif catalogue, le prix unitaire de sortie en contexte long atteint 90, et le surcoût augmente vite.
| Caractéristique de la tâche | Part du temps de génération | Quelqu’un attend | Tendance |
|---|---|---|---|
| Codage interactif, démonstration en direct | Élevée | Oui | Calculer d’abord selon la formule ; le prix unitaire suffit généralement à couvrir |
| Agent gourmand en outils | Moyenne à faible | Selon le cas | Calculer uniquement sur la partie génération ; le gain est dilué |
| Traitement par lots nocturne | Élevée | Non | Rester au palier standard |
| Contexte long et sortie volumineuse | Élevée | Selon le cas | Calcul prudent nécessaire pendant la période de tarif catalogue |
💡 Conseil de choix : si un même projet comporte les deux types de tâches, vous pouvez décider dans le code d’ajouter ou non
service_tierselon le type de tâche, sans l’activer globalement. Utilisez la même clé API via APIYI apiyi.com pour établir une base au palier standard, puis déterminez quel type de tâche mérite de tester davantage le palier de vitesse.
Conseils de décision pour GPT-6.2 Sol Ultrafast
Voici comment résumer le contenu précédent sous forme de procédure fixe :
- Lancez une tâche réelle sur le niveau standard, notez le temps de génération T et le nombre de tokens consommés, sans reprendre les chiffres de vitesse de quelqu’un d’autre.
- Calculez le meilleur cas avec le plafond officiel de 4.5, puis choisissez un facteur conservateur r que vous jugez raisonnable, et calculez les deux scénarios.
- Calculez le coût supplémentaire avec le tarif promotionnel à 3 fois, puis avec le tarif catalogue à 6 fois, pour obtenir deux « prix par minute ».
- Comparez avec la valeur de votre temps : seules les tâches qui restent rentables avec le facteur conservateur méritent d’être activées.
- Avant l’entrée en vigueur du tarif catalogue, le 2027-03-01, refaites le calcul avec les nouveaux prix.
Le point clé de cette procédure est l’étape 2. Le « jusqu’à 4.5 fois » officiel peut servir de plafond, tandis que la mention d’environ 126 token/s du 2026-11-18 n’est qu’un point de données isolé ; ni l’un ni l’autre ne correspond au facteur réel de votre tâche. Le facteur réel ne peut être obtenu qu’en réalisant un test comparatif sur vos propres tâches.
FAQ
Q1 : GPT-6.2 Sol Ultrafast est-il un nouveau modèle ?
Non. D’après la documentation officielle de l’API, Ultrafast est un niveau de service : dans la requête, `model` reste `gpt-6.2-sol`, on ajoute `service_tier` en le définissant sur `ultrafast` ; le modèle lui-même ne change pas.
Q2 : Activer Ultrafast garantit-il d’atteindre 4.5 fois ?
Pas nécessairement. Le texte officiel dit « up to 4.5 times », ce qui est une formulation de plafond. Pour le calcul, prévoyez aussi un facteur conservateur plus bas et fiez-vous à votre propre test comparatif.
Q3 : Quand se termine le prix promotionnel de GPT-6.2 Sol Ultrafast ?
Le prix promotionnel officiel court jusqu’au 2027-02-28 (heure du Pacifique), à 3 fois le prix standard ; à partir du 2027-03-01, le tarif catalogue s’applique, à 6 fois le prix standard. Le contexte court comme le contexte long suivent ce rapport multiplicatif.
Q4 : Peut-on se référer à ce relevé d’environ 126 token/s ?
On peut le prendre comme point de données, mais pas comme conclusion. Il s’agit d’une tâche relayée par OrcaRouter le 2026-11-18, sans exécution répétée ni comparaison avec le niveau standard sur la même tâche ; la mention d’environ 1.5 fois dans l’article provient d’une comparaison avec les 85 token/s du niveau standard publiés par Artificial Analysis.
Q5 : À quel niveau correspond le prix de gpt-6.2-sol visible sur APIYI ?
C’est le niveau standard. Dans le tableau global d’APIYI apiyi.com, le tarif de `gpt-6.2-sol` est de 2 en entrée, 0.1 en lecture de cache et 10 en sortie, ce qui correspond au niveau standard officiel pour le contexte court ; les endpoints responses et chat sont pris en charge. Le tableau ne comporte pas de modèle ultrafast distinct et n’indique pas non plus `service_tier`.
Q6 : Au-delà de 272 000 tokens d’entrée, comment le niveau standard est-il facturé ?
Les chiffres des deux sources diffèrent et doivent être calculés séparément : le tableau global d’APIYI indique 3 dollars au-delà de 272 000 tokens d’entrée, tandis que le niveau standard officiel facture 4 dollars pour l’entrée en contexte long. Lors d’un appel via https://api.apiyi.com/v1, le calcul suit la liste des modèles de la plateforme ; en connexion directe à l’officiel, comptez 4 dollars.
Points clés du surcoût de vitesse de GPT-6.2 Sol Ultrafast
- Ultrafast est un palier de service : même ID de modèle
gpt-6.2-sol, il suffit d’ajouterservice_tier; les capacités du modèle ne changent pas. - 4,5 fois est le plafond officiel : le texte original dit « up to », il ne faut donc pas le traiter comme un multiplicateur atteint à chaque fois.
- Le prix se divise en deux phases : pendant la promotion, 3 fois le prix standard ; à partir du 2027-03-01, le tarif catalogue passe à 6 fois.
- Seul le temps de génération s’accélère : les appels d’outils et autres temps hors génération ne comptent pas dans la part que l’on peut économiser.
- Un seul relevé ne suffit pas à conclure : la mesure du 2026-11-18 à environ 126 tokens/seconde n’a pas de comparaison avec le palier standard.
- Mesurez d’abord votre propre palier standard : vous pouvez utiliser le palier standard
gpt-6.2-sold’APIYI apiyi.com pour obtenir T, puis le réinjecter dans l’algorithme.
Conclusion
Le calcul du surcoût de vitesse de GPT-6.2 Sol Ultrafast peut se résumer en trois points :
- Prendre deux valeurs de vitesse : le maximum officiel de 4,5 fois pour le meilleur cas, et votre propre multiplicateur prudent dans l’autre colonne.
- Calculer les prix séparément : pendant la promotion, la dépense supplémentaire représente 2 fois le coût standard ; au tarif catalogue, 5 fois. Les deux conclusions ne peuvent pas être mélangées.
- Trancher selon la tâche : ce n’est que si le prix d’une minute économisée est inférieur à la valeur de votre temps que ce palier de vitesse convient à cette tâche.
La réponse à la question du titre dépend des données de votre propre tâche. Je vous conseille de mesurer d’abord une base de référence sur APIYI apiyi.com avec le palier standard, puis d’injecter les chiffres dans le tableau de calcul de cet article.
📚 Références
-
Documentation OpenAI Codex sur les niveaux de vitesse : mention officielle d’un mode Ultrafast jusqu’à 4.5 fois plus rapide
- Lien :
developers.openai.com/codex/agent-configuration/speed - Explication : confirme le texte original « up to 4.5 times » ainsi que les modèles concernés
- Lien :
-
Guide API du mode Ultrafast d’OpenAI : utilisation de
service_tieret modèles pris en charge- Lien :
developers.openai.com/api/docs/guides/ultrafast-mode - Explication : confirme qu’Ultrafast est un niveau de service et que
modelreste inchangé
- Lien :
-
Page tarifs de l’API OpenAI : tarifs promotionnels et tarifs catalogue des niveaux Standard, Fast et Ultrafast
- Lien :
developers.openai.com/api/docs/pricing - Explication : grille tarifaire complète pour les contextes courts et longs
- Lien :
-
Transcription OrcaRouter : données d’une tâche Ultrafast unique du 2026-11-18
- Lien :
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - Explication : une transcription unique, sans comparaison, qui ne peut servir que de point de données
- Lien :
-
Tableau récapitulatif des modèles APIYI : prix standard et paliers tarifaires de
gpt-6.2-sol- Lien :
docs.apiyi.com/models.md - Explication : vérifier le prix unitaire du niveau standard et le tarif au-delà de 272 000 tokens d’entrée
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : pour toute question de calcul ou d’intégration, n’hésitez pas à nous contacter via la page d’accueil du site officiel APIYI. Vous trouverez davantage de documentation sur docs.apiyi.com.


