
Résumé : Les modèles du monde excellent dans la génération d’images d’environnements interactifs ; les moteurs de jeu traditionnels excellent dans l’exécution de règles précises, la simulation physique et la gestion d’état. Ces deux technologies se situent à des niveaux différents, et la direction la plus raisonnable consiste à les combiner.
Verdict d’emblée : les moteurs de jeu traditionnels restent nécessaires. Trois modèles du monde représentatifs — Genie 3, WHAM-RT/WHAMM et Oasis — parviennent déjà à générer en temps réel des images manipulables à une fréquence de 10 à 24 FPS, mais leur cohérence continue se compte en secondes ou en minutes, et ils se trompent sur le plan des règles : mémorisation des objets, résolution des dégâts, comptage des points de vie, etc. Le moteur de jeu, lui, apporte l’exécution déterministe des règles, le calcul physique, la persistance de l’état et la synchronisation multijoueur — précisément le socle sur lequel tournent les jeux commerciaux. À ce stade, les modèles du monde sont adaptés à la génération d’environnements, à la prédiction visuelle et à l’aide à la création de contenu ; le moteur continue de gérer les règles centrales, et les deux forment ensemble une architecture hybride.
La suite explique d’abord la différence de logique de fonctionnement entre les modèles du monde et les moteurs classiques, puis s’appuie sur les indicateurs publics des trois modèles pour situer leur avancement, avant de détailler les cas d’échec concrètement divulgués par WHAMM, d’énumérer les responsabilités d’ingénierie assumées par un moteur mature, et enfin de proposer la répartition des rôles dans une architecture hybride, les choix de scénarios et un exemple de code exécutable.
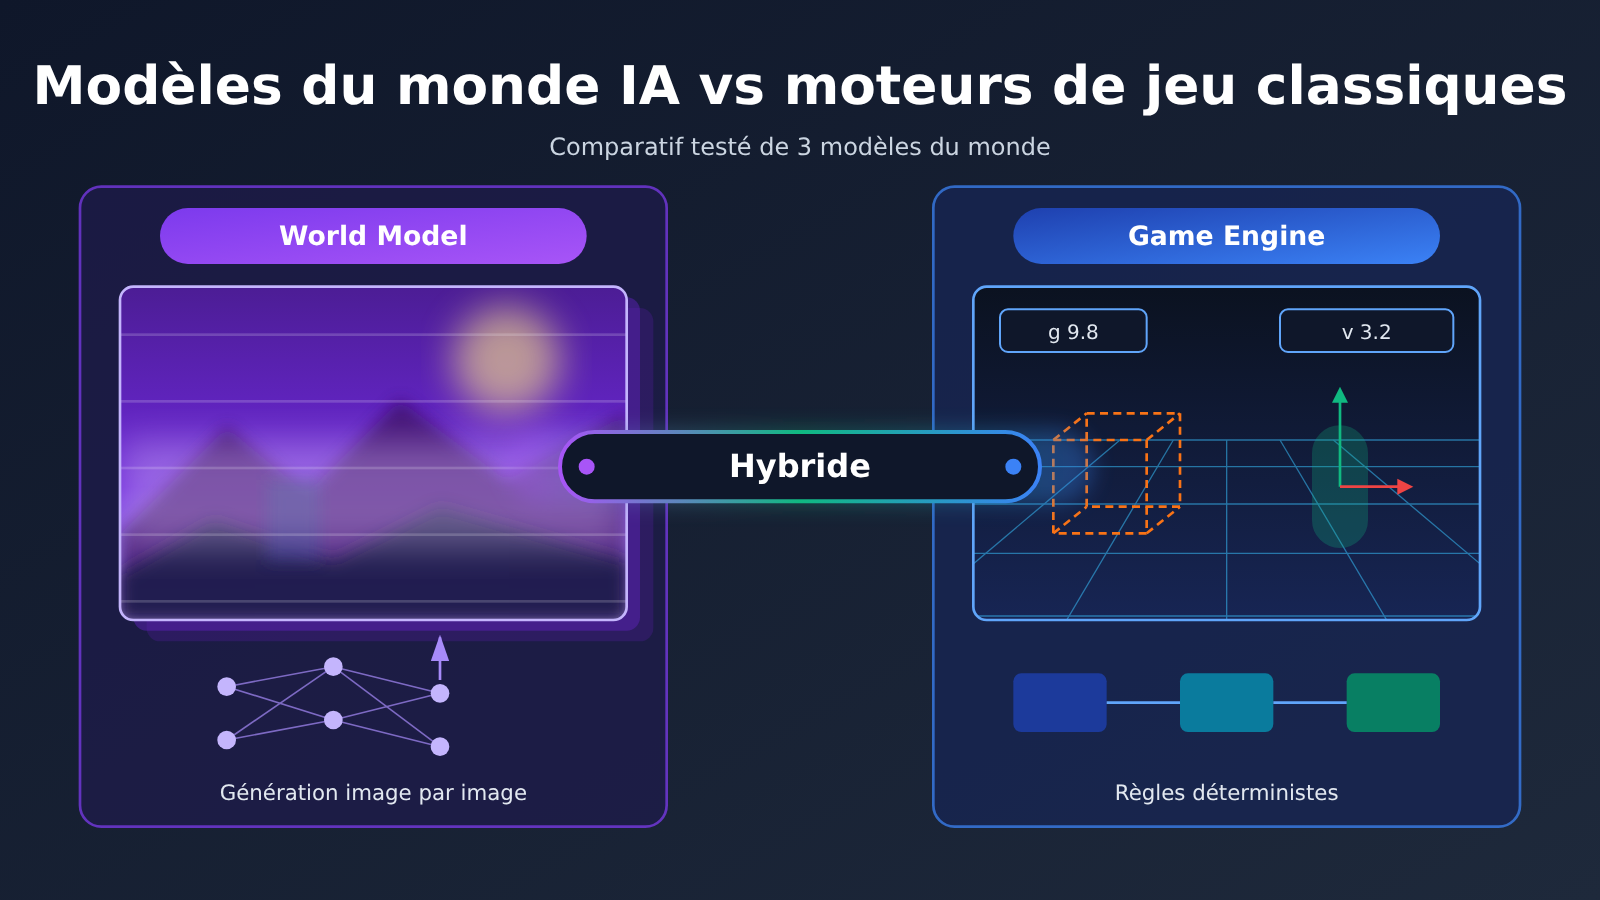
À savoir : préparation du vocabulaire des modèles du monde et des moteurs de jeu
| Terme | Explication |
|---|---|
| Modèle du monde | Modèle d’IA qui, à partir de l’image courante et des actions du joueur, prédit et génère l’état de l’environnement à l’instant suivant |
| FPS | Dans cet article, désigne le nombre d’images affichées par seconde ; dans le contexte du genre de jeu, désigne aussi les jeux de tir à la première personne |
| Résolution | Nombre de pixels en largeur et en hauteur, par exemple 640×360, 720p |
| Fenêtre de contexte | Étendue des informations historiques que le modèle peut consulter pour prédire les états suivants ; dans les modèles du monde, elle se compte souvent en secondes ou en images |
| Génération autorégressive | Chaque image est générée à partir des images produites précédemment, et l’erreur s’accumule image après image |
| Moteur physique | Système qui calcule les contraintes physiques telles que les collisions, le mouvement et les forces |
| Persistance de l’état | Le fait de sauvegarder l’état des joueurs, des quêtes et des objets du monde, pour pouvoir le recharger et reprendre à tout moment |
| Synchronisation multijoueur | Mécanisme qui permet à différents joueurs de voir et de manipuler un même état de jeu cohérent |
| Déterminisme | Des entrées identiques produisent toujours le même résultat ; c’est une condition préalable au débogage, au replay et au jeu en ligne |
| Moteur de jeu | Système de développement et d’exécution qui organise le rendu, les entrées, la physique, l’animation, le réseau et la gestion des ressources |
| Architecture hybride | Approche combinée où un système programmatique classique gère les règles et l’état, tandis qu’un modèle génératif fournit le contenu |
1 Génération en temps réel de mondes de jeu par l’IA : différences de logique de fonctionnement entre modèles du monde et moteurs de jeu
1.1 Les modèles du monde : de la génération d’assets à la génération de mondes
Par le passé, l’IA dans le développement de jeux servait surtout à générer des textures, des modèles 3D, des voix off et autres assets, lesquels finissaient entre les mains du moteur qui les assemblait et les faisait tourner. Les modèles du monde changent cette répartition des tâches : le modèle reçoit directement les entrées clavier ou manette du joueur, prédit l’image de la frame suivante, et recommence en boucle, formant un environnement « jouable ». Genie 3 de Google DeepMind, la série Muse de Microsoft Research (WHAM-RT/WHAMM), et Oasis de Decart et Etched sont les trois représentants de cette direction.
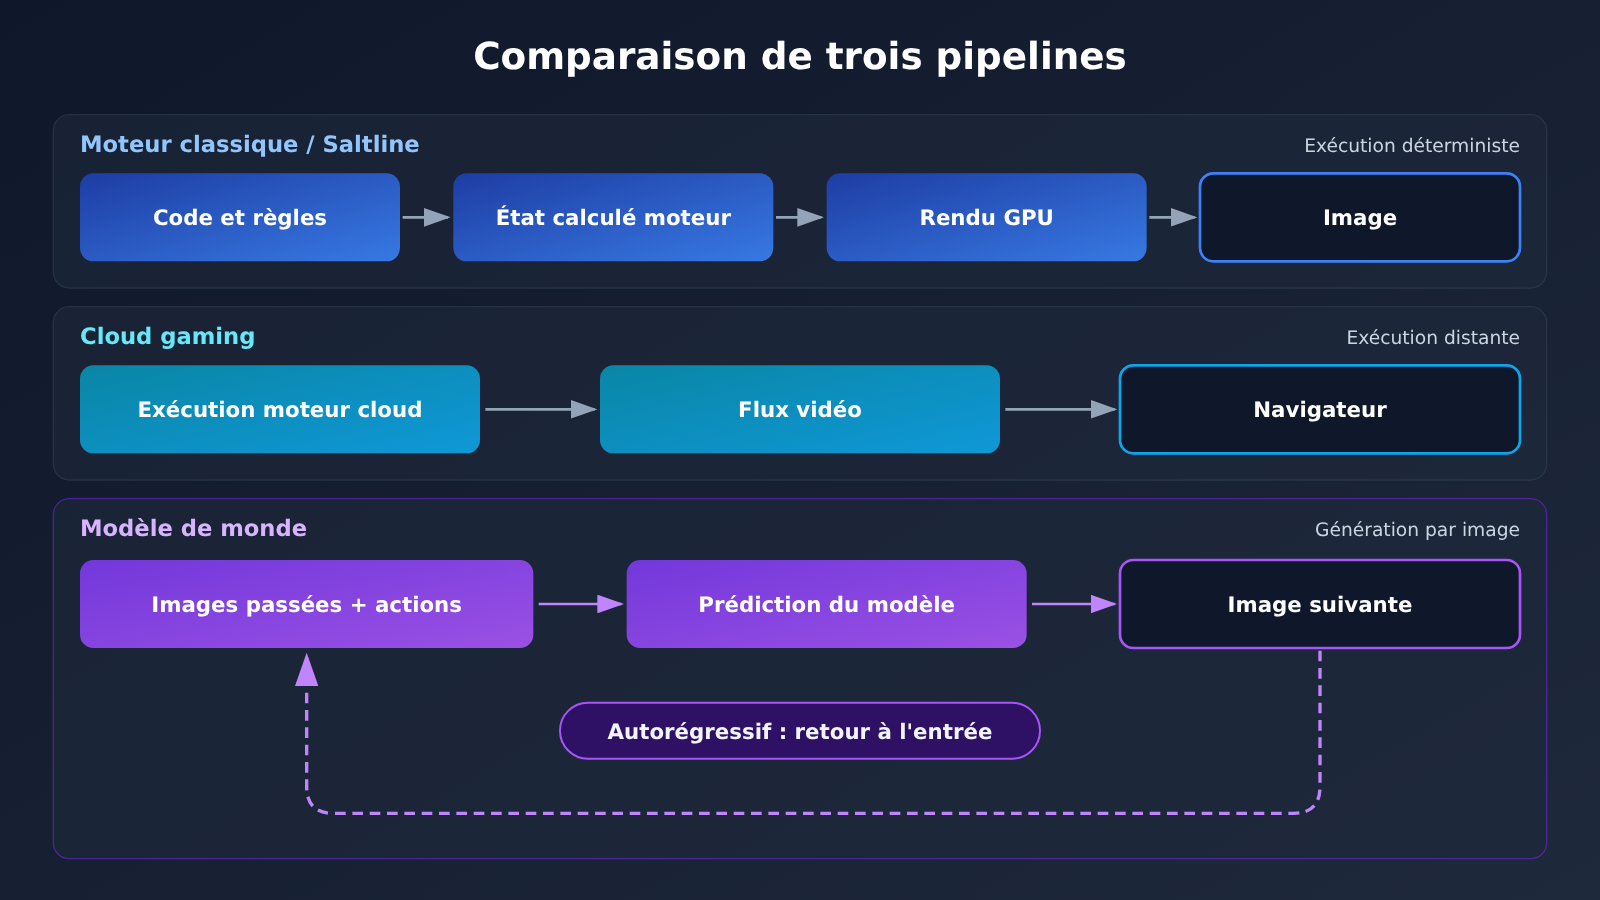
La logique de fonctionnement d’un jeu traditionnel, c’est le développeur qui définit à l’avance les scènes, les modèles, les règles et le système physique ; les actions du joueur déclenchent des logiques préétablies ; le moteur calcule le nouvel état, puis rend l’image. La logique du modèle du monde est « observation + action → prédiction de la frame suivante », les règles restant implicites dans la dynamique visuelle apprise sur les données d’entraînement. Dans le premier cas, l’image découle du calcul d’un état ; dans le second, l’image est elle-même une approximation de l’état produite par le modèle.
1.2 L’IA qui écrit du code et l’IA qui génère des images : deux voies distinctes
Le 9 novembre 2026, Saltline, publié par l’ingénieur Anthropic Felix Rieseberg, est souvent cité aux côtés des modèles du monde. C’est un prototype jouable de FPS à petite échelle qui tourne dans un navigateur : pour décor, un port à conteneurs par une nuit de pluie, avec un niveau à missions. Selon l’estimation de l’auteur lui-même, Claude Fable 5.2 y a passé environ 8 heures, sur une seule invite et sans retour humain, en consommant près de 445 millions de tokens d’entrée (pour une large part des lectures de cache) et environ 2,7 millions de tokens de sortie, soit à peu près 550 dollars au tarif API ; ces chiffres viennent d’un post public du développeur et relèvent donc de sa propre estimation.
Le côté « 3A » de Saltline n’est qu’un objectif d’expérimentation et une analogie visuelle fixés par le développeur. Sa voie technique : l’IA génère environ 1,4 Mo de code HTML/JavaScript, les modèles, textures et sons étant produits de façon procédurale par le code et les shaders, le rendu à l’exécution étant assuré en local par le navigateur via Three.js et WebGL. Dans cette voie, l’IA travaille pendant la phase de développement, mais l’exécution reste un programme déterministe : on reste fondamentalement dans une logique « moteur ». Le modèle du monde, lui, fait générer par l’IA l’image frame par frame au moment de l’exécution ; la structure de coûts et la fiabilité des deux approches n’ont rien à voir.
2 Indicateurs techniques des trois modèles du monde pour la génération en temps réel de mondes de jeu
2.1 Comparaison des indicateurs publics des trois modèles
Les chiffres du tableau ci-dessous sont ceux publiés par chaque équipe dans son environnement de démonstration technique officiel. Les conditions de test étant différentes, ils permettent de juger des ordres de grandeur, pas d’établir un classement horizontal direct.
| Indicateur | Genie 3 (Google DeepMind) | WHAM-RT/WHAMM (Microsoft Research) | Oasis (Decart & Etched) |
|---|---|---|---|
| Date de publication | 5 août 2025 | 2025 | octobre 2024 |
| Environnement de démonstration | Environnement générique généré à partir d’invites textuelles | Environnement interactif de type Quake II | Monde sandbox de type blocs |
| Fréquence d’images | jusqu’à 24 FPS | plus de 10 FPS | 20 FPS |
| Résolution | 720p | 640×360 | non mise en avant comme indicateur clé par l’équipe officielle |
| Cohérence / mémoire | l’environnement reste cohérent pendant plusieurs minutes, la mémoire visuelle remonte à environ une minute | contexte d’environ 0.9 seconde (environ 9 images à 10 FPS) | s’appuie sur des techniques comme le Dynamic Noising pour limiter l’accumulation d’erreurs |
| Taille du modèle / ouverture | poids non publiés | démonstration de recherche | 500M de paramètres, code et poids open source |
| Méthode de génération | génération de monde autorégressive en temps réel | génération basée sur MaskGIT | diffusion dans l’espace latent Transformer + autorégressif |
2.2 Genie 3 : générer des mondes contrôlables pour des environnements généraux
L’ambition de Genie 3, c’est le modèle de monde généraliste : l’utilisateur décrit un monde en texte et peut aussitôt l’explorer en temps réel — il avance, le modèle génère ce qui se trouve devant ; il se retourne, le modèle génère un nouveau point de vue. Genie 3 prend aussi en charge les Promptable World Events, qui permettent de modifier par une invite textuelle des événements du monde : changer la météo, faire apparaître des objets, etc. Google a également présenté une expérience combinant Genie 3 et l’agent SIMA : dans le monde généré, l’agent atteint ses objectifs par des actions de navigation, ce qui suggère que les modèles de monde pourraient devenir des environnements d’entraînement pour les agents.
Le 29 janvier 2026, Project Genie, une application web expérimentale basée sur Genie 3, a été ouverte aux États-Unis aux abonnés Google AI Ultra de plus de 18 ans. Elle propose le croquis de mondes, l’exploration et le remix. La communication officielle précise une limite de 60 secondes par expérience de génération, un possible retard dans le contrôle du personnage, des lois physiques pas nécessairement exactes, et le fait que les Promptable World Events n’étaient pas encore intégrés à ce moment-là.
2.3 WHAM-RT/WHAMM : migrer vers un nouveau jeu avec peu de données
Muse (World and Human Action Model) de Microsoft a d’abord été entraîné sur Bleeding Edge de Ninja Theory, avec plus d’un milliard d’images de jeu et d’actions de manette, soit environ 7 ans de jeu continu. La version temps réel transpose la même technologie sur Quake II : pour ce nouveau jeu, il a suffi d’environ une semaine de données de jeu nettoyées, pour une vitesse de génération supérieure à 10 FPS et une résolution portée à 640×360.
« Une semaine de données » désigne le volume de données utilisé lors de la migration vers un nouveau jeu ; cela n’a rien à voir avec la durée d’entraînement ni avec le coût d’un entraînement depuis zéro. L’important, c’est ceci : un modèle de monde existant peut s’adapter à un nouvel environnement interactif avec relativement peu de nouvelles données. C’est un signal fort que le seuil d’entrée en matière de données baisse.
2.4 Oasis : une expérience interactive en temps réel open source à 20 FPS
Oasis combine un auto-encodeur spatial, un backbone de diffusion dans l’espace latent à base de Transformer, une génération autorégressive et un conditionnement par les entrées du joueur : on peut se déplacer, sauter, ramasser des objets et casser des blocs. La contrainte de temps réel annoncée est très concrète : à 20 FPS, chaque frame dispose de 50 millisecondes ; pour atteindre 25 FPS, il faut générer une frame en environ 0,04 seconde.
Oasis est une démonstration technique, sans licence officielle de Microsoft ni de Mojang pour Minecraft. Les auteurs précisent aussi que pour aller plus vite et réduire les coûts de service à grande échelle, il faudra une infrastructure d’inférence plus efficace. Voilà qui met en lumière la nature économique des modèles du monde : chaque frame est une inférence, et tant que le joueur joue, le GPU doit calculer.
3. Pourquoi les mondes de jeu générés par les modèles du monde comportent des erreurs
3.1 Cas d’échec concrets divulgués publiquement par WHAMM
Microsoft détaille les limites du modèle dans l’article technique WHAMM. Cette liste constitue la preuve de première main la plus précieuse pour juger de la maturité des modèles du monde.
| Phénomène de défaillance | Manifestation concrète | Cause profonde |
|---|---|---|
| Oubli d’objets | Les objets sortis du champ de vision sont oubliés par le modèle | Fenêtre de contexte d’environ 0.9 seconde (9 images) |
| Ennemis qui disparaissent/apparaissent de nulle part | Lorsque le joueur baisse les yeux vers le sol puis les relève, l’ennemi peut disparaître ou réapparaître | Aucun état persistant des objets hors écran |
| Statistiques de points de vie inexactes | Le chiffre des points de vie peut changer de façon erronée | La valeur est « devinée » à partir de l’image, sans logique de comptage |
| Interactions avec les ennemis erronées | Écarts dans le calcul des dégâts et la détection des coups | Les règles sont apprises de manière approximative à partir des données, sans résolution déterministe |
| Gel aux limites du niveau | Seule une partie d’un niveau de Quake II a été entraînée ; une fois la fin des données d’entraînement atteinte, la génération peut se figer | La portée de génération est limitée par la couverture des données d’entraînement |
| Latence à grande échelle | Des latences perceptibles peuvent apparaître lorsque de nombreux utilisateurs sont en ligne simultanément | La pression sur le service liée à l’inférence temps réel à chaque image |
La formulation de Microsoft est juste : il s’agit d’une approximation de l’environnement par un modèle génératif ; le joueur fait l’expérience du modèle, tandis que l’expérience complète du Quake II original reste assurée par le jeu d’origine.
3.2 Les problèmes de cohérence viennent de la structure autorégressive elle-même
3.2.1 La longueur de la mémoire détermine combien de temps le monde peut « se souvenir »
Un modèle du monde ne peut prédire l’avenir qu’à partir des images historiques présentes dans sa fenêtre de contexte. La fenêtre de 0.9 seconde de WHAMM signifie qu’après environ 9 images hors du champ de vision, le modèle perd la base de l’existence d’un ennemi. Genie 3 étend la mémoire visuelle à environ une minute et maintient la cohérence sur plusieurs minutes, ce qui est déjà un progrès notable. Mais un jeu exige souvent que, plusieurs heures plus tard, le joueur revienne dans la même pièce et voie encore la caisse qu’il a ouverte, ce qui demande une échelle de mémoire supérieure de plusieurs ordres de grandeur.
3.2.2 Des règles qui visent à « paraître plausibles »
L’objectif d’entraînement du modèle est de rendre l’image suivante plausible. Les règles comme la perte de points de vie, le comptage des munitions ou la progression des quêtes, qui nécessitent une accumulation précise, n’occupent que quelques pixels à l’écran ; le modèle peut facilement les générer de façon « plausible mais erronée ». Ce qu’une seule ligne hp -= damage garantit correctement dans un moteur demande, dans un modèle du monde, beaucoup de données et une conception structurelle pour être approché.
3.3 Les limites de l’espace d’action et de la durée d’interaction de Genie 3
Les limites officiellement reconnues de Genie 3 incluent : la plage d’actions que l’agent peut exécuter directement est limitée, les interactions complexes entre plusieurs agents indépendants restent difficiles, les localisations géographiques réelles ne peuvent pas être reproduites fidèlement, le rendu du texte est instable et les interactions continues se mesurent principalement en quelques minutes. Un espace d’action limité signifie que les combinaisons de compétences complexes, les opérations d’inventaire et les branches de dialogue sont difficiles à exprimer directement ; la difficulté des interactions multi-agents affecte directement les scénarios multijoueur et d’IA collective.
4 Les capacités fondamentales offertes par les moteurs de jeu traditionnels
4.1 Unreal Chaos Physics : un aperçu de la profondeur d’ingénierie d’un moteur
Le système Chaos Physics d’Unreal Engine couvre la dynamique des corps rigides, les systèmes de destruction, la physique en réseau, la simulation de tissus, les ragdolls, la physique des véhicules, la simulation de fluides, l’animation physique et la simulation de cheveux. L’intérêt de ces modules tient à leur caractère contrôlable, reproductible et débogable : qu’une même balle touche le même mur sous le même angle, et le calcul des fragments peut être reproduit ; les développeurs peuvent localiser un problème image par image ; la physique en réseau permet même de garder des résultats cohérents sur plusieurs machines.
4.2 Les huit catégories de responsabilités système assumées par un moteur de jeu
| Système du moteur | Rôle principal | Capacités actuellement équivalentes des modèles de monde |
|---|---|---|
| Système de scène | Gérer les cartes, les objets et la hiérarchie | Exprimé implicitement par l’image, les objets n’ont pas d’identité propre |
| Système physique | Gérer les collisions, les mouvements et les forces | Appris approximativement à partir des données, précision limitée |
| Système d’animation | Gérer le squelette et les animations des personnages | Génération au niveau de l’image, difficile de contrôler précisément le squelette |
| Système réseau | Gérer la synchronisation multijoueur | Les interactions complexes entre plusieurs agents restent un point délicat |
| Système de ressources | Gérer les modèles, les textures et les effets sonores | Les ressources sont les poids du modèle, difficiles à remplacer individuellement |
| Gestion d’état | Sauvegarder l’état des joueurs, des quêtes et du monde | Limité par la fenêtre de contexte, environ 0,9 seconde pour WHAMM |
| Système de rendu | Produire de manière stable des images à une qualité graphique donnée | De l’ordre de 720p/24 FPS, contraint par la puissance de calcul d’inférence |
| Outils de débogage | Localiser les erreurs et les goulets d’étranglement de performance | La sortie est une génération probabiliste, difficile à déboguer pas à pas avec des points d’arrêt |
4.3 Le déterminisme, condition de survie des jeux commerciaux
Le déterminisme permet d’enregistrer et de rejouer des parties, d’automatiser des tests, de reproduire les bugs signalés par les joueurs ; c’est aussi le socle du multijoueur à synchronisation par trames et de l’anti-triche. Or la sortie d’un modèle de monde comporte une part d’aléatoire : une même entrée peut produire des résultats différents. C’est un atout pour l’exploration créative, mais un obstacle pour les jeux commerciaux qui ont besoin de compétition équitable, de sauvegarde et de chargement, et de réglage de l’équilibrage. De ce point de vue, la différence entre un moteur et un modèle de monde ne réside pas dans la qualité graphique, mais dans la capacité à garantir le résultat.
5 Fusion des modèles du monde et des moteurs de jeu traditionnels : architecture hybride
5.1 Principes de répartition des rôles dans une architecture hybride
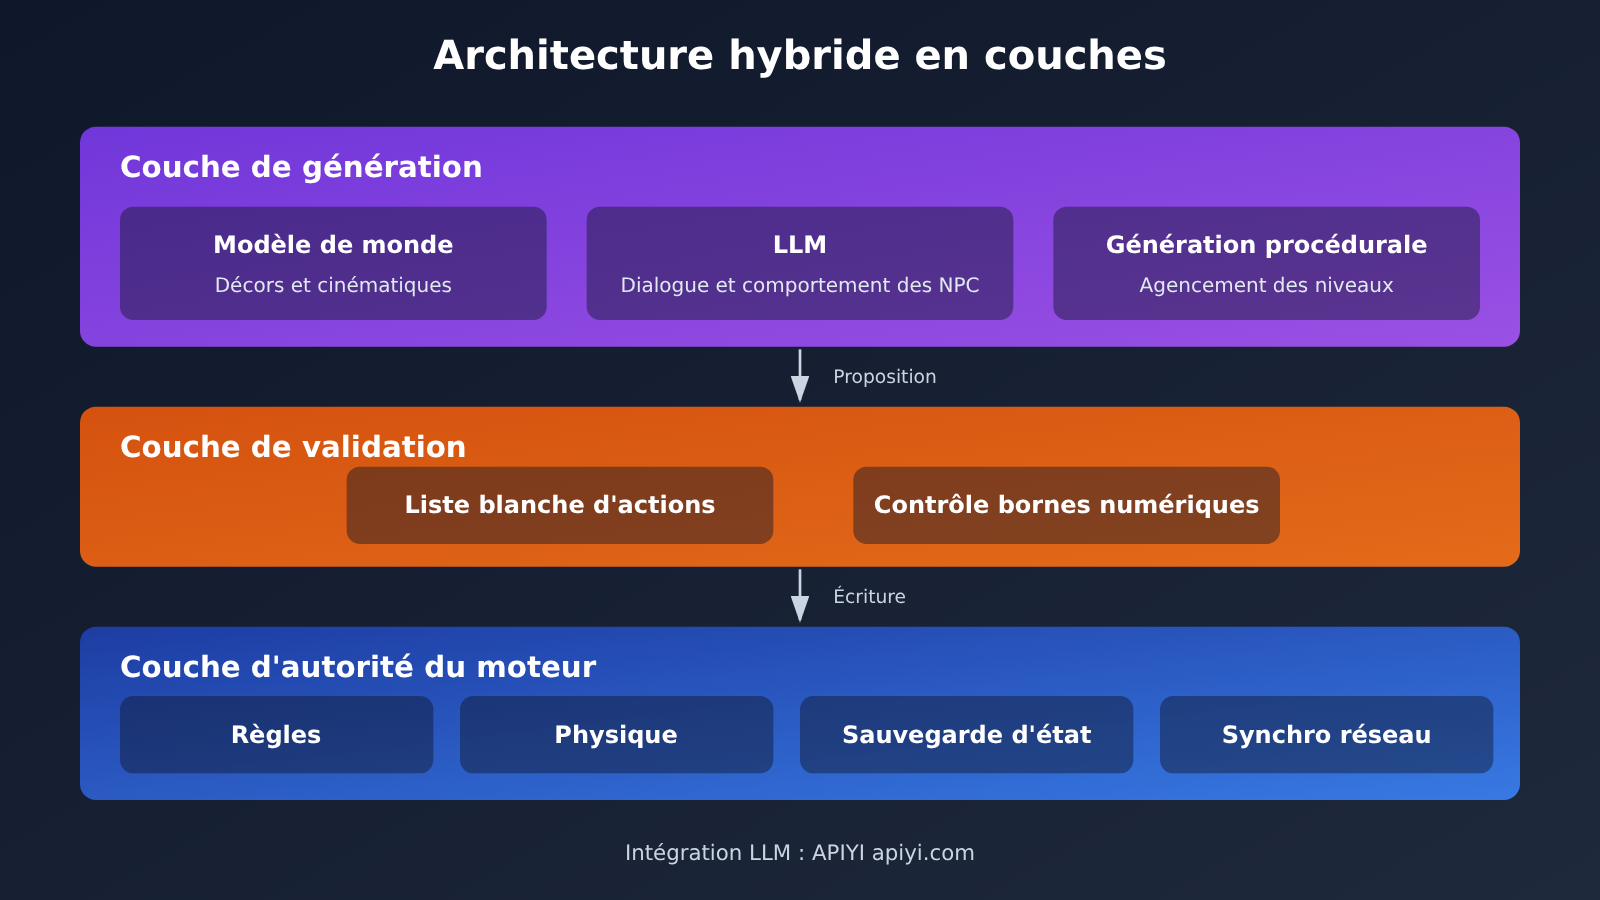
Le principe central de l’architecture hybride est simple : tout ce qui doit être « garanti » revient au moteur ; tout ce qui doit être « varié » et « génératif » revient au modèle. Le moteur conserve l’état de référence (points de vie, inventaire, quêtes, coordonnées, données multijoueur), tandis que le modèle prend en charge l’environnement dynamique, la génération de contenu, le comportement des PNJ et l’assistance à la création. Les sorties du modèle doivent être validées par le moteur avant d’être écrites dans l’état. Saltline a déjà illustré une variante de cette approche : un grand modèle de langage génère l’intégralité du code pendant le développement, puis, à l’exécution, seuls des programmes déterministes tournent.
5.2 Exemple minimal pour piloter le comportement des PNJ avec un LLM
L’exemple ci-dessous montre la brique la plus simple à mettre en place dans une architecture hybride : le moteur conserve l’état de référence du PNJ, le grand modèle de langage se contente de « proposer » l’action suivante, puis le moteur la vérifie par rapport à une liste blanche et à des bornes numériques avant de l’exécuter. L’interface utilise le format compatible OpenAI.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

state = {"npc": "港口守卫", "hp": 80, "player_distance": 12, "alert": False}
prompt = f"根据状态给出NPC下一步行为,只输出JSON,action取值 patrol/chase/talk:{json.dumps(state, ensure_ascii=False)}"

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # Sélectionnez un modèle disponible dans la console
    messages=[{"role": "user", "content": prompt}],
)
print(resp.choices[0].message.content)
Voir l’implémentation complète : boucle de décision PNJ avec validation par le moteur et proposition du modèle
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interface compatible OpenAI, permet de changer de modèle pour comparer les résultats
)

ALLOWED_ACTIONS = {"patrol", "chase", "talk", "retreat"}


class EngineState:
    """État faisant autorité côté moteur : toutes les valeurs numériques sont modifiées uniquement ici"""

    def __init__(self):
        self.npc = {"name": "港口守卫", "hp": 80, "max_hp": 100, "alert": False}
        self.player_distance = 12.0

    def snapshot(self) -> dict:
        return {"npc": self.npc, "player_distance": self.player_distance}


def propose_action(state: dict, model: str) -> dict:
    """Demande au modèle de proposer une action ; le modèle peut seulement lire l'état, pas le modifier directement"""
    system = (
        "你是游戏NPC的决策模块。只输出一个JSON对象,"
        '格式:{"action": "patrol|chase|talk|retreat", "line": "一句台词"}'
    )
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": system},
            {"role": "user", "content": json.dumps(state, ensure_ascii=False)},
        ],
        max_tokens=200,
    )
    text = resp.choices[0].message.content.strip()
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        return {"action": "patrol", "line": ""}  # En cas d'échec de l'analyse, revenir à un comportement par défaut sûr


def validate_and_apply(engine: EngineState, proposal: dict) -> str:
    """Validation côté moteur : liste blanche + contraintes de règles ; toute sortie de modèle invalide est rejetée"""
    action = proposal.get("action")
    if action not in ALLOWED_ACTIONS:
        action = "patrol"
    if action == "chase" and engine.npc["hp"] < 20:
        action = "retreat"  # La règle est définie par le moteur : poursuite interdite à faible niveau de vie
    if action in {"chase", "retreat"}:
        engine.npc["alert"] = True
    line = str(proposal.get("line", ""))[:60]  # Limiter la longueur de la réplique pour éviter tout débordement de l'interface
    return f"{engine.npc['name']} -> {action}:{line}"


if __name__ == "__main__":
    engine = EngineState()
    proposal = propose_action(engine.snapshot(), model="YOUR_MODEL_NAME")
    print(validate_and_apply(engine, proposal))
Ce fonctionnement contraste avec le cas d’échec de WHAMM : les points de vie et l’état d’alerte sont conservés par le moteur, donc même si le modèle « oublie » quelque chose, l’ennemi ne disparaît pas comme par magie ; lorsque le modèle produit une action invalide, le moteur revient à un comportement sûr.
🚀 Démarrage rapide : pour prototyper la prise de décision d’un PNJ, vous pouvez passer par APIYI apiyi.com et appeler OpenAI, Claude, Gemini ou d’autres modèles avec une seule et même clé API. Les nouveaux utilisateurs bénéficient d’un quota d’essai gratuit, pratique pour comparer la qualité des répliques, la latence de réponse et la stabilité de la sortie JSON d’un modèle à l’autre.
5.3 Recommandations par scénario : quand opter pour un modèle du monde, quand s’en tenir au moteur de jeu
5.3.1 Les scénarios adaptés aux modèles du monde
- Preuve de concept et exploration d’idées : générer rapidement à partir de texte un monde dans lequel on peut se déplacer, valider une direction artistique et une ambiance. C’est exactement à ce type de besoin que répondent les fonctions de croquis et de remix de Project Genie.
- Environnements d’entraînement pour agents : les expériences menées avec Genie 3 et SIMA montrent qu’un monde génératif peut offrir à un agent IA un grand nombre de scènes d’entraînement variées.
- Expériences interactives de courte durée : démonstrations interactives d’une minute, expériences marketing, présentations de recherche — en phase avec la limite actuelle de cohérence, de l’ordre de quelques minutes.
5.3.2 Les scénarios qui exigent un moteur de jeu
- Jeux avec sauvegarde et progression sur la durée : quêtes, inventaire, valeurs de progression ont besoin d’une persistance d’état.
- Jeux compétitifs et multijoueurs : il faut une résolution déterministe, une synchronisation multijoueur et de l’anti-triche.
- Jeux portés par un gameplay physique : destruction, véhicules, tissus et autres reposent sur des systèmes débogables comme Chaos Physics.
- Projets commerciaux destinés à être exploités en ligne : tests, analyse de performance et mises à jour de correctifs s’appuient tous sur la chaîne d’outils du moteur.
5.3.3 Les scénarios adaptés à une architecture hybride
- Contenu dynamique d’un monde ouvert : le moteur gère le terrain et les règles, le modèle génère les quêtes secondaires, les dialogues de PNJ et les descriptions d’environnement.
- Développement assisté par IA : à la manière de Saltline, où un grand modèle de langage génère pendant la phase de développement le code, les shaders et la logique de niveau, avant de confier l’exécution à des programmes déterministes.
5.4 Recommandations décisionnelles : évaluer la maturité à partir des indicateurs techniques
| Dimension d’évaluation | Niveau actuel des world models (données officielles) | Exigences typiques d’un jeu commercial | Conclusion |
|---|---|---|---|
| Fréquence d’images | 10 à 24 FPS | généralement plus de 30 FPS, les jeux d’action visent 60 FPS | Le moteur l’emporte |
| Résolution | 640×360 à 720p | 1080p et plus | Le moteur l’emporte |
| Cohérence dans la durée | d’un contexte de 0,9 seconde à plusieurs minutes | des dizaines d’heures de jeu et de sauvegardes | Le moteur l’emporte |
| Vitesse de génération de contenu | génération instantanée d’un monde à partir d’une invite texte | le pipeline classique exige modélisation et création de niveaux | Le world model l’emporte |
| Coût d’exécution | une inférence GPU par image | rendu sur le matériel local du joueur | Le moteur est plus économique |
| Mode de déploiement | prototypes de recherche, produits expérimentaux | exploitable en production | Architecture hybride |
💡 Conseil de choix : si une équipe veut d’abord brancher l’IA sur un moteur existant, le point d’entrée le plus sûr reste la « génération de contenu vérifiable » : dialogues de PNJ, textes de quêtes, descriptions de niveaux. Vous pouvez tester plusieurs modèles en parallèle via une interface unifiée sur APIYI apiyi.com, faire votre sélection selon la qualité des sorties et le coût par appel, puis décider du mode d’intégration.
6 FAQ : modèles du monde et moteurs de jeu
Q1 : Qu’est-ce qu’un modèle du monde IA ? En quoi diffère-t-il d’un modèle de génération vidéo ?
Un modèle du monde prédit et génère l’état de l’environnement à l’instant suivant à partir de l’état actuel de l’environnement et des actions de l’utilisateur. Un modèle de génération vidéo produit une vidéo figée, que l’utilisateur ne peut pas interrompre en cours de lecture ; un modèle du monde reçoit de nouvelles entrées à chaque image, ce qui permet à l’utilisateur de continuer à contrôler la direction et les actions. Genie 3 est un représentant de ce type de modèle.
Q2 : Quelle est la différence fondamentale entre un modèle du monde qui génère en temps réel un monde de jeu et un moteur de jeu traditionnel ?
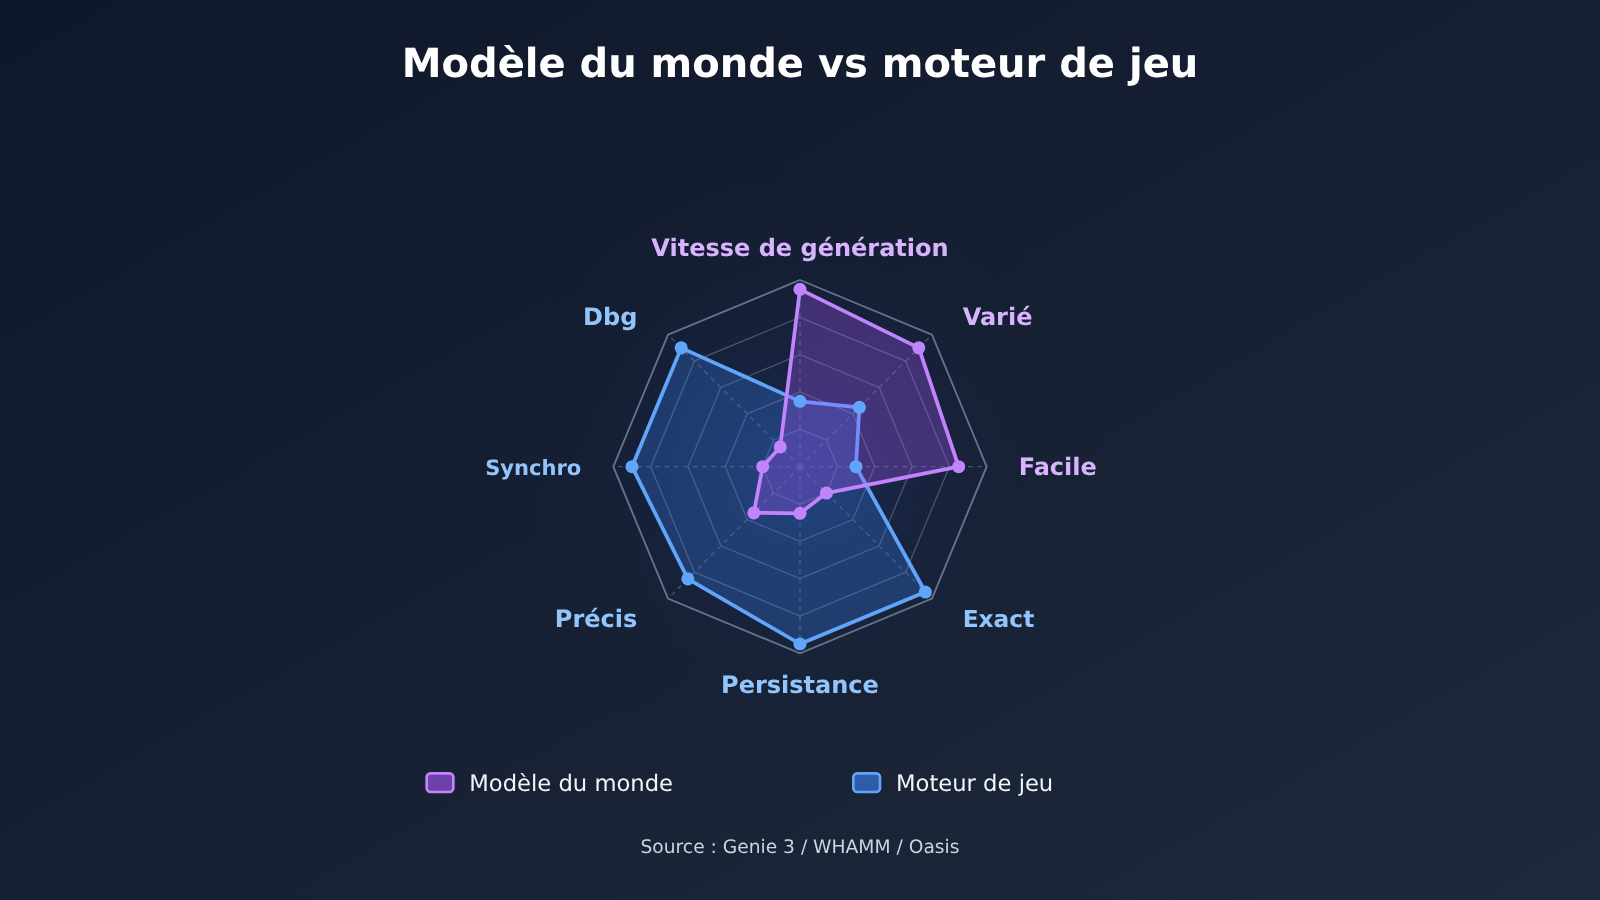
Un moteur calcule l’état à partir de règles explicites, puis rend cet état à l’écran : le résultat est reproductible. Un modèle du monde apprend la dynamique visuelle à partir des données et génère directement les images, avec une part d’aléatoire dans le résultat. Le moteur garde l’avantage en matière de déterminisme, de persistance de l’état, d’exactitude physique et de synchronisation multijoueur ; le modèle du monde l’emporte sur la vitesse de génération de contenu et la facilité de création.
Q3 : Quand Genie 3, WHAM-RT et Oasis ont-ils été annoncés ? Peut-on les tester aujourd’hui ?
Oasis a été dévoilé en octobre 2024, avec du code open source, les poids d’un modèle de 500M de paramètres et une expérience en ligne. Muse a été dévoilé en février 2025, puis sa version temps réel pour Quake II a été publiée. Genie 3 a été lancé le 5 août 2025 ; Project Genie, qui s’appuie dessus, a été ouvert le 29 janvier 2026 aux abonnés Google AI Ultra de 18 ans et plus aux États-Unis, avec une session d’essai limitée à 60 secondes.
Q4 : Où les équipes de jeu dépensent-elles principalement lorsqu’elles intègrent l’IA aujourd’hui ?
Tout dépend de l’étape à laquelle l’IA intervient. Dans un cas comme Saltline, où un grand modèle de langage génère du code pendant la phase de développement, le coût se concentre sur des appels API ponctuels : le développeur estime lui-même la facture à environ 550 dollars, puis, lorsque le jeu tourne ensuite en local chez les joueurs, plus aucun appel au modèle n’est effectué. Un modèle du monde, lui, fait de l’inférence image par image à l’exécution : chaque session de jeu génère donc des coûts GPU en continu. Quand on utilise un grand modèle de langage pour des fonctions à l’exécution comme les dialogues de PNJ, la facturation se fait à l’usage ; on peut d’abord tester à petite échelle avec la facturation à l’usage d’APIYI apiyi.com, puis estimer le coût d’appel par joueur.
Q5 : Comment ajouter rapidement des PNJ pilotés par l’IA à un prototype de jeu existant ?
Nous recommandons de suivre le schéma « proposition du modèle + validation par le moteur » décrit à la section 5.2 de cet article :
1. Créez un compte sur APIYI apiyi.com et récupérez une clé API ainsi qu’un quota de test gratuit ;
2. Réglez le `base_url` du code d’exemple sur `https://api.apiyi.com/v1` et indiquez le nom d’un modèle disponible ;
3. Sérialisez l’état des PNJ du moteur en JSON et transmettez-le au modèle, en n’acceptant que les actions figurant sur une liste blanche ;
4. Comparez plusieurs modèles sur la latence et la stabilité des sorties, puis choisissez la solution de production.
Q6 : Quelles sont les limitations connues des modèles du monde aujourd’hui ?
Le contexte de WHAMM est d’environ 0,9 seconde : il oublie les objets hors de son champ de vision, et le décompte des points de vie comme le calcul des dégâts comportent des erreurs. Une fois la frontière des données d’entraînement atteinte, la génération peut se figer ; pour Genie 3, l’interaction continue se mesure en minutes, l’espace d’action est limité et les interactions complexes entre plusieurs agents restent difficiles ; Oasis indique officiellement qu’il faut une infrastructure d’inférence plus efficace pour gagner en vitesse et réduire le coût du service. Toutes ces limites convergent vers la même conclusion : les modèles du monde conviennent pour l’instant comme couche de contenu, mais la couche de règles a toujours besoin d’un moteur.
7 Modèles du monde vs moteur de jeu : points clés à retenir
- Repères de performance : Genie 3 atteint 720p/24 FPS, WHAM-RT est à 640×360/10 FPS ou plus, Oasis à 20 FPS.
- Faiblesse de la mémoire : le contexte de WHAMM est d’environ 0,9 seconde ; les ennemis et les objets hors du champ de vision sont oubliés.
- Faiblesse des règles : les règles précises comme les points de vie et le règlement des dégâts sont générées de façon approximative à partir de l’image, ce qui entraîne facilement des erreurs.
- Valeur du moteur : la physique, la persistance de l’état, la synchronisation multijoueur et les outils de débogage forment la base d’un jeu commercial.
- Deux approches : Saltline, c’est l’IA qui écrit le code et le programme qui s’exécute ; le modèle du monde, c’est l’IA qui génère les images image par image.
- Axe de convergence : le moteur gère l’état faisant autorité, le modèle se charge de l’environnement, du contenu et des propositions de comportement des personnages NPC.
- Comment démarrer : commencez par des dialogues de NPC faciles à vérifier, et vous pouvez comparer plusieurs modèles grâce à l’interface unifiée d’APIYI apiyi.com.
8 Conclusion : la place du moteur de jeu traditionnel à l’ère des modèles du monde IA
Les modèles du monde IA sont désormais capables de générer en temps réel des mondes de jeu interactifs. Trois modèles représentatifs portent la fréquence d’images à 10-24 FPS et la résolution à 720p, tandis que le volume de données nécessaires pour migrer vers un nouveau jeu tombe à environ une semaine. En parallèle, les problèmes observés avec WHAMM — oubli d’objets, erreurs de points de vie, niveaux figés — montrent que le modèle génère une expérience approximative du jeu : les règles, l’état et le multijoueur restent à la charge du moteur.
La tendance des prochaines années est une architecture hybride : le moteur garantit le déterminisme, le modèle étend l’échelle et la diversité du contenu, et la génération de code par grand modèle de langage en phase de développement continue de réduire les cycles de prototypage. Pour une équipe de développement, l’étape la plus concrète consiste à intégrer l’IA aux points vérifiables du moteur existant, puis à évaluer l’efficacité et le coût sur la base de données d’appels réelles. Nous recommandons de valider rapidement via APIYI apiyi.com ; la plateforme propose une interface unifiée multi-modèles et des crédits gratuits pour les nouveaux utilisateurs.
📚 Références
- Google DeepMind – annonce technique de Genie 3 : fréquence d’images, résolution, cohérence et limites de Genie 3
- Lien :
deepmind.google/blog/genie-3-a-new-frontier-for-world-models -
Description : source primaire des métriques de Genie 3 et des limites officiellement reconnues
-
Google – annonce officielle de Project Genie : application web expérimentale basée sur Genie 3
- Lien :
blog.google/innovation-and-ai/models-and-research/google-deepmind/project-genie -
Description : périmètre d’accès et limite d’expérience de 60 secondes
-
Microsoft Research – modélisation du monde en temps réel WHAMM : démo temps réel de Quake II et limites
- Lien :
microsoft.com/en-us/research/articles/whamm-real-time-world-modelling-of-interactive-environments -
Description : source des cas d’échec tels que le contexte de 0,9 seconde et l’oubli d’objets
-
Microsoft Research – projet Muse / WHAM : modèles du monde et des actions humaines
- Lien :
microsoft.com/en-us/research/project/wham/wham -
Description : échelle des données d’entraînement de Bleeding Edge
-
Decart – page du projet Oasis : modèle du monde interactif en temps réel open source
- Lien :
oasis-model.github.io -
Description : 500M de paramètres, 20 FPS et détails de l’architecture
-
Epic Games – Physics in Unreal Engine : aperçu des fonctionnalités de Chaos Physics
- Lien :
dev.epicgames.com/documentation/unreal-engine -
Description : périmètre des capacités du système physique d’un moteur mature
-
Miroir de code et README de Saltline : explication de l’attribution des données par le développeur
- Lien :
github.com/realcodebear/saltline-fable-5.2 - Description : référence sur la taille des fichiers et la voie du code généré par IA
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI apiyi.com pour partager vos retours d’expérience sur l’intégration de l’IA dans le développement de jeux


