
Note de l’auteur : une application multi-modèles doit gérer les différences d’invocation d’outils, d’état de raisonnement, de sortie en streaming, de données structurées et de cache en s’appuyant sur un format de message unifié, une couche d’adaptation par fournisseur et un registre des capacités.
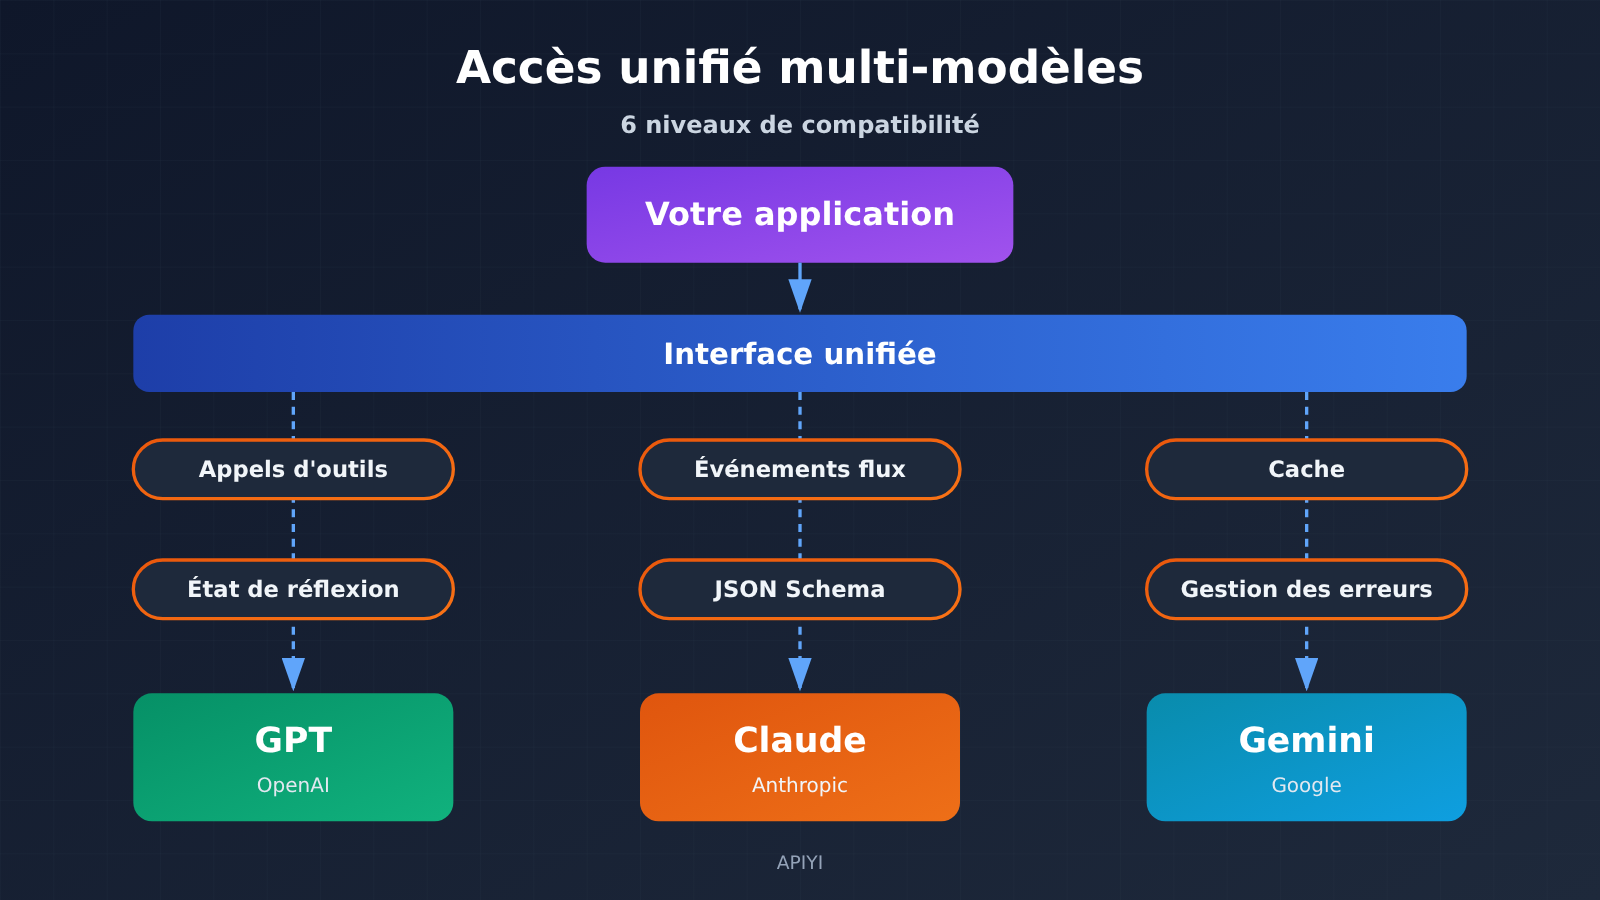
GPT, Claude et Gemini savent tous répondre à un appel de texte ordinaire, et Claude comme Gemini proposent d’ailleurs une passerelle officielle compatible avec le SDK OpenAI. Mais lorsqu’une application de production change de modèle, elle doit résoudre 6 catégories de problèmes de compatibilité : rôles des messages et instructions système, protocole d’invocation d’outils, paramètres de raisonnement et état de réflexion, événements de streaming, sortie structurée et multimodal, facturation du cache et gestion des erreurs. Remplacer uniquement le Model ID suffit pour un question-réponse simple ; en revanche, les invocations d’outils sur plusieurs tours, la reprise après coupure de flux et le calcul des coûts demandent un traitement à part. L’approche d’ingénierie la plus sûre consiste à combiner « une interface métier unifiée + une couche d’adaptation par fournisseur (Provider Adapter) + un registre des capacités des modèles ». Le changement de modèle devient ainsi une fonctionnalité produit que l’on peut maintenir dans la durée.
Nous allons d’abord comparer les différences de structure entre les trois API natives, et voir quels scénarios l’interface compatible OpenAI peut couvrir. Nous détaillerons ensuite, une par une, les pannes bien réelles que provoquent ces 6 catégories de problèmes de compatibilité, avant de proposer une architecture d’intégration en six couches et un code d’appel unifié directement exécutable. Pour finir, nous listerons six tests de compatibilité à passer avant la mise en production, et nous verrons comment se répartissent les rôles entre une passerelle API unifiée et l’adaptation des capacités natives.
À savoir : glossaire des termes de compatibilité API multi-modèles
| Terme | Explication |
|---|---|
| API | Interface permettant à une application d’envoyer des requêtes à un service de modèle et de récupérer les résultats. |
| SDK | Kit de développement logiciel qui encapsule les détails d’appel de l’interface. |
| API native | Interface principale conçue par le fournisseur lui-même, par exemple OpenAI Responses, Claude Messages, Gemini Interactions. |
| Interface compatible | Point d’entrée d’adaptation qui reprend un autre format de requête (généralement le format OpenAI), afin de pouvoir l’appeler avec le même SDK. |
| Appel de fonction (Function Calling) | Le modèle demande à l’application d’exécuter une fonction externe à l’aide de paramètres structurés. |
| ID d’appel | Identifiant qui associe la demande d’outil émise par le modèle au résultat d’exécution renvoyé par l’application. |
| Signature de réflexion (Thought / Thinking Signature) | Données d’état chiffrées que certains modèles utilisent pour conserver le contexte du raisonnement et des appels d’outils ; elles doivent être renvoyées telles quelles. |
| Sortie en flux (Streaming) | Le serveur renvoie les résultats par segments sous forme d’événements, ce qui permet au front-end de les afficher au fur et à mesure. |
| JSON Schema | Spécification qui décrit la structure des données JSON et les règles de validation. |
| Cache d’invites (Prompt Caching) | Réutiliser le résultat de calcul d’un préfixe d’entrée qui revient souvent, afin de réduire la latence et les coûts. |
| TTL | Durée de vie du cache ; une fois expiré, il faut le réécrire. |
| Adaptateur (Provider Adapter) | Composant qui convertit une requête unifiée au format natif d’un fournisseur, puis reconvertit la réponse au format unifié. |
| Registre des capacités | Liste de configuration qui recense, pour chaque modèle et chaque point de terminaison d’accès, les paramètres et fonctionnalités réellement pris en charge. |
| Idempotent | Une même opération exécutée une fois ou plusieurs fois produit le même effet ; cela évite les doubles débits ou les envois en double causés par les nouvelles tentatives. |
1 Compatibilité multi-modèles des API : pourquoi changer de modèle ne se limite pas à changer le Model ID
Les trois fournisseurs permettent tous de spécifier un modèle via un champ model, mais l’organisation du corps de requête, de l’objet de réponse et de l’état du contexte diffère. Pour une simple question-réponse, les écarts se concentrent sur les noms de champs, ce qui rend l’adaptation peu coûteuse. Pour une application de type agent, qui s’appuie sur les appels d’outils, l’état de raisonnement et les événements en streaming, ces écarts se transforment directement en incidents en production.
1.1 Comparaison des API natives de GPT, Claude et Gemini
Le tableau ci-dessous ne décrit que les API natives, sans couche de compatibilité ni point de terminaison passerelle.
| Dimension | OpenAI (natif) | Claude (natif) | Gemini (natif) |
|---|---|---|---|
| Interface principale | API Responses, /v1/responses |
API Messages, /v1/messages |
API Interactions (GA en juin 2026, recommandée officiellement pour les nouveaux projets) ; generateContent reste pris en charge |
| Organisation de l’entrée | model + input |
model + messages + max_tokens, system indépendant du tableau de messages |
structure native Interactions, plus la règle system_instruction |
| Structure de sortie | éléments de sortie de plusieurs types : texte, éléments de raisonnement, function_call, etc. |
blocs de contenu : text, thinking, tool_use, etc. |
steps : sortie du modèle, appels d’outils, raisonnement, etc. |
| Détection de fin | événement de fin de réponse / type d’élément de sortie | stop_reason (fin normale, besoin d’exécuter un outil, etc.) |
type d’étape et état de l’interaction |
| Poursuite du contexte | previous_response_id |
l’application renvoie elle-même l’historique complet des messages | previous_interaction_id, état de session côté serveur en option |
| Outils intégrés | outils de la plateforme + fonctions personnalisées | essentiellement des outils personnalisés | outils intégrés comme Google Search, URL Context, exécution de code ; les outils tiers sont exécutés par l’application |
Comme on le voit dans le tableau, les trois fournisseurs se divisent en deux approches sur la question « qui conserve le contexte ». OpenAI et Gemini prennent en charge la poursuite du contexte côté serveur, tandis qu’avec Claude Messages c’est l’application qui renvoie elle-même l’historique. Si le stockage de session de l’application n’est conçu que pour l’une de ces approches, passer à un autre fournisseur entraîne une perte de contexte ou des envois en double.
1.2 Ce que les interfaces compatibles OpenAI permettent vraiment de résoudre
Claude et Gemini proposent tous deux un point d’entrée compatible avec le SDK OpenAI. Le point de terminaison compatible officiel de Gemini est generativelanguage.googleapis.com/v1beta/openai/ : avec le client OpenAI, il suffit de modifier base_url, la clé API et model. La documentation de compatibilité de Claude, elle, délimite clairement le périmètre pris en charge ; voici les limitations connues au 2026-11-13 :
- le paramètre
strictdes définitions d’outils est ignoré, ce qui invalide la contrainte stricte sur les paramètres d’outils. - la mise en cache des invites (Prompt Caching) n’est pas prise en charge.
- les entrées de type audio et file ne sont pas prises en charge.
- les messages
systemetdevelopersont remontés en tête et fusionnés. - les champs liés à
thinkingdiffèrent de l’API native.
L’interface compatible convient à trois cas d’usage : le chat ordinaire, la génération en un seul tour, et la comparaison rapide de la qualité de réponse entre différents modèles. La migration d’un agent complexe implique des paramètres d’outils stricts, la mise en cache, des entrées de fichiers et un état de raisonnement sur plusieurs tours : ces capacités obligent à revenir à l’API native, ou à les valider point par point avant la mise en production. Un critère pratique : si une fonctionnalité dont dépend l’application n’apparaît que dans la documentation native, on l’inscrit dans un registre des capacités et on la confie à un adaptateur dédié.
2 Les six types de problèmes de compatibilité les plus fréquents lors du changement entre les modèles GPT, Claude et Gemini
2.1 Gestion de la compatibilité des rôles de message et des instructions système
OpenAI distingue des rôles comme developer et system. Chez Claude, les instructions system se trouvent en dehors du tableau de messages. Gemini utilise system_instruction, et le contenu utilisateur et le contenu du modèle obéissent aussi à leurs propres règles structurelles. Les trois expriment la même chose — « priorité des instructions + historique multi-tours » — mais les champs qui les portent n’occupent pas la même position.
Les pannes courantes viennent d’une concaténation paresseuse : on colle ensemble les instructions système, l’historique des messages et les résultats d’outils dans une seule grande chaîne de caractères, qu’on donne au modèle comme entrée utilisateur. Ça fonctionne, mais la priorité des instructions s’en trouve affaiblie, et le modèle peut prendre les sorties d’outils présentes dans l’historique pour de nouvelles exigences de l’utilisateur. La bonne approche consiste à conserver la sémantique des rôles à l’intérieur de l’application, et à laisser l’adaptateur se charger du mapping vers les champs de chaque fournisseur. À noter également : la couche de compatibilité Claude fusionne system et developer, donc une conception d’invite qui repose sur une séparation des deux niveaux doit être testée en conditions réelles.
2.2 Protocole d’appel d’outils et gestion de la compatibilité des ID d’appel
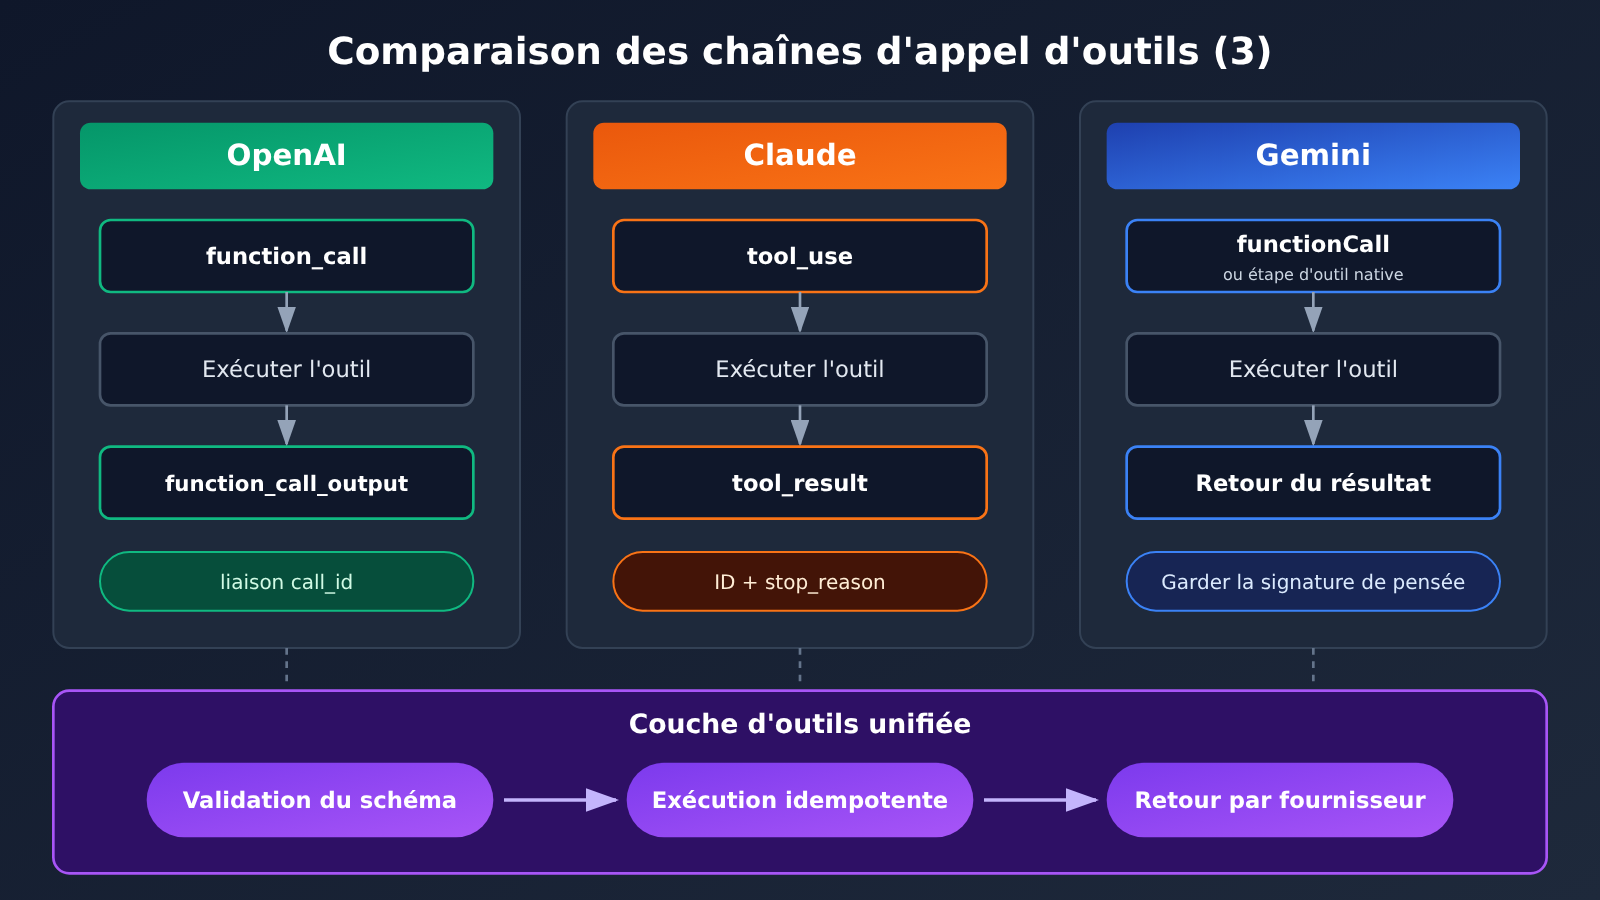
Les trois fournisseurs prennent en charge le Function Calling, et la chaîne d’appel se présente comme suit :
| Étape | OpenAI | Claude | Gemini |
|---|---|---|---|
| Le modèle déclenche l’appel | élément de sortie function_call |
bloc de contenu tool_use |
functionCall / étape d’outil native |
| Identifiant de corrélation | call_id |
ID du tool_use |
identifiant d’appel correspondant |
| Retour de l’application | function_call_output |
bloc de contenu tool_result |
structure de retour du résultat correspondant |
| Faut-il continuer ? | déterminé par l’élément de sortie | stop_reason indique qu’un outil doit être exécuté |
déterminé par l’état de l’étape |
| État de raisonnement | l’élément reasoning peut devoir être transmis avec l’historique | le bloc thinking peut devoir être renvoyé tel quel | le mode stateless doit conserver le bloc thought et la signature |
La couche d’outils doit conserver intégralement six informations : l’ID d’appel, le nom de la fonction, les paramètres JSON, les relations entre appels parallèles, le résultat d’exécution et le fait que le modèle demande ou non de poursuivre le raisonnement. Les appels parallèles sont la partie la plus propice aux erreurs. Lorsque le modèle lance plusieurs requêtes d’outils en une fois et que l’application ne renvoie le résultat que pour l’une d’elles, ou que les résultats sont associés aux mauvais ID, la requête suivante renvoie une erreur de paramètres, ou le modèle continue à répondre sur la base de données erronées.
Il est recommandé que la couche d’outils unifiée valide d’abord les paramètres avec JSON Schema, puis exécute l’opération externe réelle une fois la validation réussie. Les paramètres générés par le modèle ne sont pas toujours valides ; une validation anticipée permet d’intercepter les erreurs avant l’« appel au système externe ».
2.3 Gestion de la compatibilité des modes de réflexion et de l’état du contexte
Les noms et la signification des paramètres de raisonnement ne sont pas équivalents entre ces trois fournisseurs :
- OpenAI : utilise des paramètres comme
reasoning.effort. GPT-6 Astra et GPT-6.1 Sol n’acceptent pasreasoning.effort=none, et les appels d’outils de ces deux modèles exigent l’API Responses. - Claude : les modèles de nouvelle génération s’appuient principalement sur Adaptive Thinking, accompagné de configurations de réflexion comme effort. Certains nouveaux modèles ne prennent plus en charge l’ancien mode de réflexion manuel à
budget_tokensfixe. - Gemini : selon les modèles, on utilise un thinking level ou un budget ; la possibilité de désactiver le raisonnement et les niveaux disponibles varient d’un modèle à l’autre. Les règles de mappage des paramètres diffèrent aussi entre l’API native et l’entrée compatible OpenAI.
Quand l’interface produit propose trois niveaux d’intensité de raisonnement — « rapide, standard, approfondi » —, ces noms traduisent l’intention du produit. L’adaptateur doit les convertir en paramètres réellement pris en charge par chaque modèle, et les ressources de calcul obtenues par les trois fournisseurs pour un même niveau ne sont pas identiques. Par ailleurs, le résumé de réflexion affiché à l’utilisateur peut ne pas correspondre au nombre de tokens de réflexion réellement facturés : les statistiques de coût doivent s’appuyer sur les champs d’usage renvoyés par l’API.
L’état chiffré dans les appels d’outils multi-tours est le problème que les agents de longue durée négligent le plus souvent :
- Les éléments de reasoning et les appels d’outils des OpenAI Responses peuvent devoir être transmis au fil de l’historique.
- Les blocs
thinking/redacted_thinkingde Claude peuvent contenir un état chiffré ; lors du renvoi après exécution d’un outil, leur structure d’origine doit être conservée. - Le mode stateless de Gemini Interactions exige de conserver tels quels les blocs de pensée et les signatures ; en mode stateful, une partie de l’état peut être maintenue côté serveur.
Se contenter de sauvegarder le texte affiché dans la fenêtre de chat ne permet pas de restaurer intégralement l’historique de raisonnement du modèle. Le symptôme typique : l’agent plante brusquement après le troisième tour d’appel d’outils, ou se met à répéter des étapes déjà terminées. La cause est généralement la perte d’un bloc de signature à un tour intermédiaire.
2.4 Uniformisation des événements de streaming
Les trois fournisseurs n’utilisent pas les mêmes types d’événements de streaming, ni le même ordre, ni le même signal de fin. OpenAI Responses peut envoyer response.output_text.delta, des incréments d’appel d’outil ainsi qu’un événement de fin de réponse. Le streaming de Claude Messages repose sur des événements comme message_start, content_block_delta et message_delta. L’API native de Gemini utilise sa propre structure de sortie et d’étapes.
Si le frontend parse directement les événements bruts des fournisseurs, il faut modifier le code frontend à chaque intégration d’un nouveau modèle. Mieux vaut convertir côté backend vers un protocole d’événements interne :
| Événement interne | Signification | Point de traitement |
|---|---|---|
text_delta |
Incrément de texte | À ajouter directement à l’affichage |
reasoning_summary |
Résumé du raisonnement | Affichage repliable ; la facturation se base sur les données d’usage |
tool_call_start |
Début d’un appel d’outil | Enregistrer l’ID d’appel et le nom de la fonction |
tool_call_args |
Fragments de paramètres | Concaténer par ID d’appel ou par index ; attendre d’avoir tout reçu avant de parser |
tool_result |
Résultat d’exécution de l’outil | Correspondre un à un à l’ID d’appel |
usage |
Statistiques de consommation | Distinguer les jetons d’entrée, de cache, de raisonnement et de sortie |
completed |
Fin normale | Un signal de fin explicite doit être reçu |
error |
Erreur ou flux interrompu | Distinguer les erreurs réessayables des non réessayables |
Le traitement en streaming a trois points de défaillance fréquents. Premièrement, les fragments de paramètres de plusieurs appels d’outils arrivent en alternance ; si on les concatène dans l’ordre d’arrivée, on mélange les appels. Deuxièmement, les paramètres JSON peuvent être coupés à n’importe quel caractère ; tenter de les parser à moitié reçus déclenche une exception. Troisièmement, si la connexion se coupe en cours de route sans événement de fin, l’interface reste bloquée sur « génération en cours ». La couche de conversion doit gérer explicitement ces trois cas.
2.5 Sorties structurées JSON Schema et différences de capacités multimodales
Les trois fournisseurs proposent tous des capacités de sortie structurée, mais les fonctionnalités JSON Schema prises en charge, les modes stricts et la façon de les combiner avec l’appel d’outils diffèrent. Claude distingue officiellement deux mécanismes : les JSON outputs contraignent la structure de la réponse finale, tandis que Strict tool use contraint la structure des paramètres d’appel d’outil. Certains modèles génèrent également des surcoûts supplémentaires de compilation ou de mise en cache du Schema lorsqu’ils utilisent le format strict.
La recommandation côté ingénierie est la suivante : l’application maintient son propre JSON Schema de référence et consigne dans un registre de capacités les fonctionnalités de Schema que chaque modèle prend en charge. Pour les fonctionnalités non supportées, l’adaptateur effectue une conversion dégradée. Peu importe à quel point un modèle se prétend strict, l’application doit refaire une validation de son côté et, en cas d’échec, déclencher une procédure de nouvelle tentative contrôlée ou de remontée d’erreur.
Même logique pour le multimodal. « Prend en charge l’entrée image » ne décrit qu’une catégorie de capacité ; il faut encore comparer précisément les points suivants : les types de fichiers acceptés, leur taille et le nombre d’images, les capacités vidéo et audio, le mode de téléversement des fichiers, la limite de fenêtre de contexte longue et la plage réellement exploitable, le nombre maximal de Tokens en sortie, ainsi que la possibilité de combiner appel d’outils et entrées multimodales. Le fait que la couche de compatibilité Claude ne prenne pas en charge les entrées audio et file constitue précisément une limitation concrète à consigner dans le registre.
2.6 Différences entre modèles en matière de cache, de facturation et de gestion des erreurs
Les mécanismes de mise en cache des invites des trois fournisseurs présentent des différences marquées :
- OpenAI : GPT-5.6 et les versions ultérieures prennent en charge le cache implicite et les points de rupture de cache explicite, avec des TTL de 30 minutes et 12 heures.
- Claude : permet de spécifier un cache automatique ou explicite via
cache_control, avec deux modes : 5 minutes et 1 heure ; cette fonctionnalité n’est pas prise en charge dans sa couche de compatibilité OpenAI. - Gemini : les nouveaux modèles proposent un cache implicite automatique ; certaines API et certains modèles permettent de créer explicitement des objets de cache.
Après un changement de modèle, le cache du fournisseur d’origine ne peut généralement pas être réutilisé. Si l’on passe de Claude à Gemini au milieu d’une session, la première requête sera facturée sur la totalité de l’entrée. Si l’estimation des coûts suppose par défaut que « le cache est systématiquement réutilisé », plus la stratégie de bascule est fréquente, plus l’écart sur la facture augmente.
Les tarifs standard unitaires des trois fournisseurs présentent également des écarts notables. Au 2026-11-13, les prix officiels standard sont les suivants (USD / million de Token) :
| Modèle | Entrée | Sortie | Remarque |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Les appels d’outils nécessitent l’API Responses |
| GPT-6.1 Sol | $1 | $5 | Les appels d’outils nécessitent l’API Responses |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | Prix promotionnel jusqu’au 2026-12-31 ; à partir du 2027-01-01, ajustement prévu à $1.50 / $7.50 |
Ce tableau sert à illustrer les différences de facturation. Les capacités et conditions d’utilisation varient d’un modèle à l’autre ; un prix plus ou moins élevé ne permet pas de comparer directement les performances. Le tableau n’inclut pas non plus les coûts d’écriture de cache, d’appel d’outils, de niveau de service ni les majorations de tiers.
💰 Conseil pour le calcul des coûts : La facture d’une application multi-modèles doit être enregistrée par postes : « entrée normale, écriture de cache, lecture de cache, réflexion et sortie, coûts d’outils, supplément de contexte long ». Lorsque vous appelez plusieurs modèles de manière unifiée via APIYI apiyi.com, vous pouvez consulter l’utilisation de chaque modèle au même endroit, ce qui facilite la correspondance entre la stratégie de routage et les coûts réels.
En matière de gestion des erreurs, les limites de requêtes, les limites de Token, les quotas, les délais d’attente et les formats d’erreur diffèrent entre les trois fournisseurs. L’application doit mettre en place une classification unifiée des erreurs : échec d’authentification, modèle non pris en charge, paramètre invalide, requête trop volumineuse ou dépassement de contexte, limitation de débit 429, erreur côté serveur, coupure réseau, interruption du flux de réponse, échec d’appel d’outil.
Le repli vers un autre modèle doit aussi tenir compte de la présence ou non d’effets de bord dans la tâche. Si le modèle principal dépasse le délai d’attente seulement après l’exécution d’un outil et que le système bascule automatiquement vers un modèle de secours pour relancer toute la tâche, des opérations comme le paiement, l’envoi d’e-mails ou la modification de fichiers peuvent être exécutées deux fois. La solution consiste à ajouter une clé d’idempotence aux outils ayant des effets de bord et, en cas de repli, à reprendre uniquement à partir des « étapes qui n’ont pas encore été exécutées ».
3 Comment concevoir une architecture API compatible multi-modèles
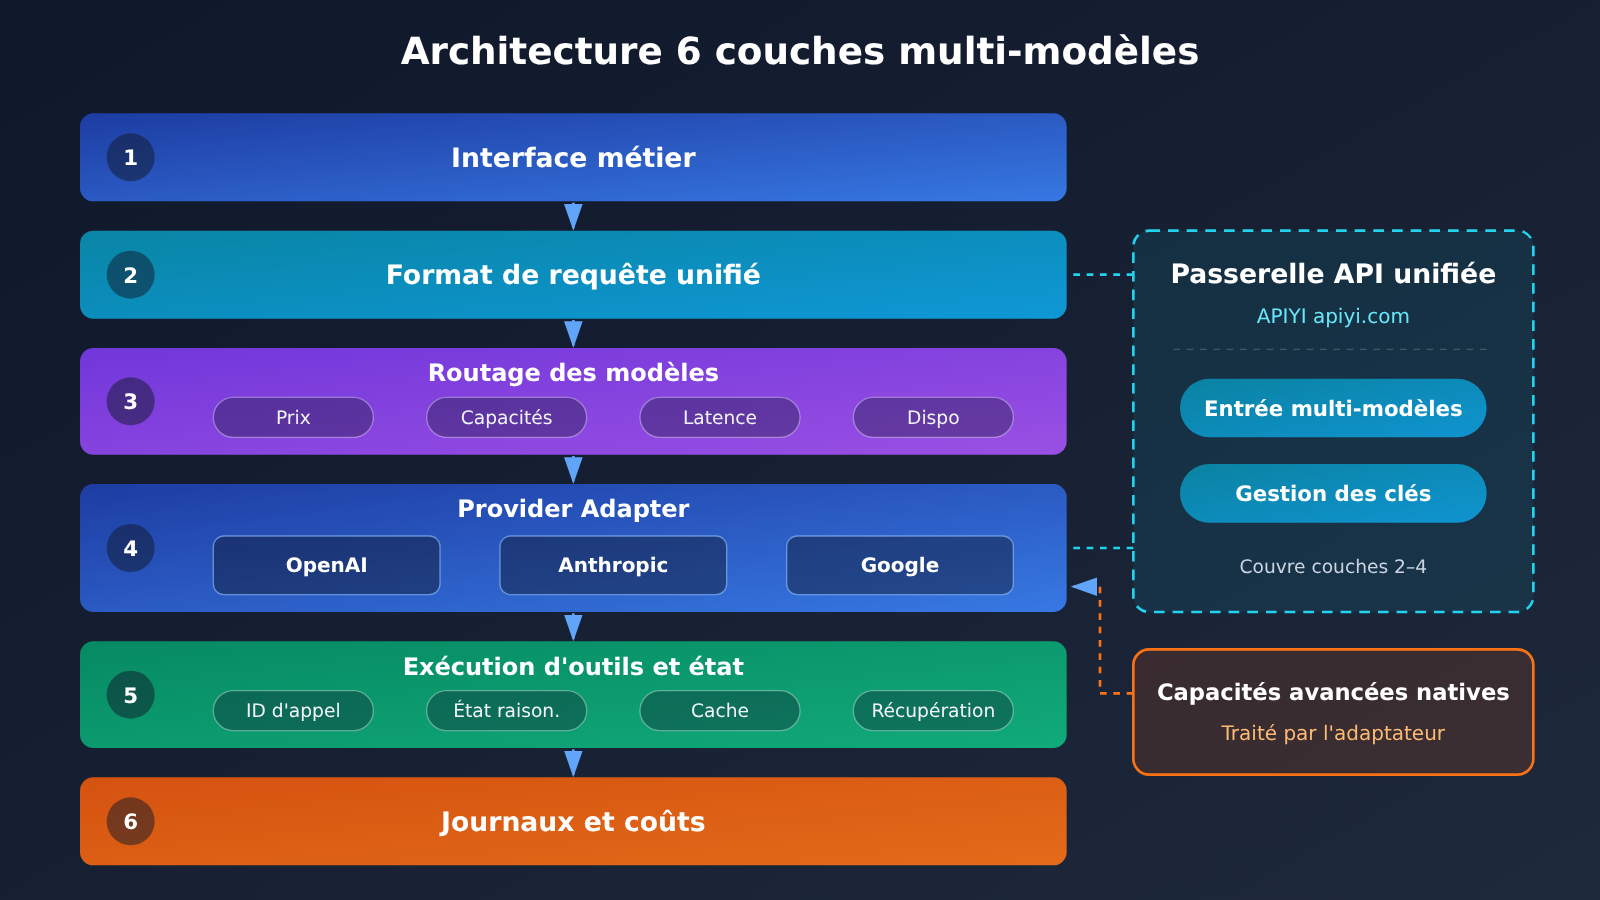
La structure recommandée à six couches est la suivante :
- Interface métier : l’utilisateur pose une question, téléverse des documents, choisit le modèle et la tâche.
- Format de requête unifié : une structure unifiée représente l’historique des messages, les pièces jointes, la liste des outils, les exigences de sortie structurée, l’intensité de raisonnement et l’ID de tâche.
- Routage de modèle : choisit GPT, Claude ou Gemini en fonction du prix, des capacités, de la latence, de la disponibilité et des règles métier.
- Provider Adapter : convertit la requête standard dans le format natif de chaque fournisseur, puis retranscrit le résultat renvoyé dans le format interne.
- Exécution des outils et gestion d’état : maintient les ID d’appel, les journaux d’exécution, le contexte de conversation, l’état de raisonnement du fournisseur, le cache et la récupération après échec.
- Journalisation et calcul des coûts : enregistre pour chaque requête le modèle, les tokens, le coût réel, la latence, le cache, les erreurs et les appels d’outils.
3.1 Établir un format unifié de messages et d’outils
Le principe central du format unifié consiste à stocker l’historique en deux couches. La première couche est un historique standard universel, comprenant les messages utilisateur, la réponse finale du modèle, les requêtes d’outils et les résultats d’outils — bref, tout ce que n’importe quel fournisseur sait lire. La deuxième couche est l’état propre à chaque fournisseur : éléments reasoning, signatures thinking, blocs thought, stockés de façon isolée par fournisseur et renvoyés tels quels uniquement quand on interroge la même maison.
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # ID d'appel unifié ; l'adaptateur gère la correspondance avec l'ID du fournisseur
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # obligatoire pour les outils ayant des effets de bord

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # blocs multimodaux : texte, images, etc.
    tool_calls: list[ToolCall] = field(default_factory=list)
    # état propre au fournisseur : clé = nom du fournisseur, valeur = signature / bloc reasoning conservé tel quel
    vendor_state: dict[str, Any] = field(default_factory=dict)
Lors d’un changement de modèle, l’adaptateur lit les champs standard pour construire la nouvelle requête. Les portions de vendor_state qui appartiennent à d’autres fournisseurs ne sont pas envoyées ; celles qui appartiennent au fournisseur cible sont renvoyées telles quelles.
3.2 Adapter les API natives via un Provider Adapter
Chaque adaptateur assume trois responsabilités :
- Transformation des entrées : mapping des rôles (par exemple déplacer
systemvers le champ dédié de Claude), conversion des définitions d’outils, dégradation de schéma, mapping des niveaux de raisonnement. - Transformation des sorties : convertir les réponses natives et les événements de streaming en événements internes décrits à la section 2.4, et mapper les ID d’appel d’outil en ID unifiés.
- Gestion de l’état : extraire et conserver les états propres au fournisseur, comme les signatures ou les éléments de raisonnement, puis décider s’il faut utiliser la continuation côté serveur (
previous_response_id,previous_interaction_id) ou renvoyer l’historique complet.
Les questions-réponses ordinaires peuvent passer par l’adaptateur public au format compatible OpenAI. Pour les cas qui exigent des paramètres d’outils stricts, un contrôle du cache ou un état de réflexion chiffré, implémentez séparément les adaptateurs natifs. On conserve ainsi la commodité du point d’entrée unique, tout en donnant aux capacités avancées un point d’ancrage bien identifié.
3.3 Utiliser un registre de capacités pour déterminer les fonctionnalités disponibles
Le registre de capacités consigne le support réellement disponible à l’échelle de l’unité « modèle + point de terminaison » : un même modèle appelé via l’API native ou via la couche de compatibilité peut correspondre à deux entrées distinctes. Voici un exemple de structure ; les valeurs concrètes doivent toujours s’appuyer sur la documentation officielle et sur vos propres résultats de test :
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # les appels d'outils exigent l'API Responses
  reasoning_effort: [low, medium, high]   # n'accepte pas none
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # la couche de compatibilité ignore strict
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
La couche de routage interroge le registre avant de choisir un modèle. Si la requête contient un fichier, elle écarte les entrées marquées file_input: false ; si des paramètres d’outils stricts sont nécessaires, elle ne retient que les entrées strict_tools: true. L’interface produit peut également s’appuyer sur ces informations pour masquer les options non prises en charge par le modèle courant, ce qui réduit les erreurs déclenchées par l’utilisateur.
4 Tests et supervision avant le lancement en production d’une API compatible multi-modèles
4.1 Six tests de compatibilité, du simple échange question-réponse à la chaîne d’outils multi-tours
Par ordre croissant de complexité, réalisez les six tests suivants :
- Échange question-réponse simple : envoyez la même invite aux trois modèles et vérifiez que le contenu des réponses ainsi que le décompte des tokens sont corrects.
- Sortie en streaming : assurez-vous que la sortie arrive de façon continue et qu’un signal de fin correct est bien reçu.
- Appel d’outil : le modèle appelle un outil de recherche météo ou de requête de données, l’application exécute l’appel puis renvoie le résultat.
- Boucle multi-outils : enchaînez au moins deux tours d’appels d’outils et vérifiez que l’historique et les ID d’appel sont intacts.
- JSON structuré : produisez une sortie conforme à un même schéma, puis validez la structure avec un validateur côté application.
- Changement de modèle : basculez une même session métier entre GPT, Claude et Gemini, et vérifiez que le contexte, l’historique des outils et la réponse finale sont tous corrects.
Les points 4 et 6 sont ceux qui révèlent le plus les problèmes d’état de raisonnement ; je vous conseille de les intégrer au pipeline d’intégration continue. À chaque montée de version d’un modèle ou changement de point d’accès, relancez-les.
4.2 Mettre en place une supervision unifiée des coûts et de la stabilité
Pour chaque requête, journalisez au minimum les champs suivants : modèle et point d’accès, taux de réussite des requêtes, type d’erreur (selon la classification de la section 2.6), latence du premier token et durée totale de la tâche, tokens détaillés (entrée, écriture de cache, lecture de cache, réflexion, sortie), nombre d’appels d’outils et nombre d’échecs, nombre de nouvelles tentatives et de replis.
Pour évaluer un modèle, regardez la durée totale et le coût total de la tâche complète : les données d’une requête isolée ont peu de valeur. Un modèle au prix unitaire bas, s’il produit souvent des paramètres d’outils erronés et nécessite plusieurs tours de nouvelles tentatives, peut au final coûter plus cher.
5 Le rôle d’une passerelle API unifiée dans la compatibilité multi-modèles
5.1 Coûts d’intégration et de maintenance
Utiliser trois modèles en parallèle, c’est trois ensembles de comptes, trois ensembles de clés, trois systèmes de facturation et trois configurations de SDK. Une passerelle API unifiée ramène tout ce travail à un seul point d’entrée : gestion centralisée des accès aux modèles et des identifiants, moins de configuration à maintenir chez chaque fournisseur, possibilité de choisir et de basculer entre les modèles au niveau de la configuration, et supervision unifiée de l’usage et des coûts. Pour les équipes qui comparent souvent les performances de différents modèles, la barrière à l’essai d’un nouveau modèle baisse d’autant.
5.2 Le positionnement d’APIYI : répartition des rôles entre point d’entrée unifié et adaptation aux capacités natives
APIYI est une plateforme d’agrégation d’API pour grands modèles de langage : une seule clé API suffit pour appeler via une interface compatible OpenAI les principaux modèles tels qu’OpenAI, Claude ou Gemini, avec une facturation à l’usage. Elle est bien adaptée pour porter la couche « point d’entrée d’appel unifié » de l’architecture : questions-réponses simples, sortie en streaming, comparaison de modèles et routage multi-modèles peuvent s’y brancher directement.
Un point d’entrée d’appel unifié et une conformité totale aux capacités natives d’un fournisseur sont deux exigences techniques distinctes. Au moment d’intégrer un modèle précis, il faut encore vérifier une par une dans le registre des capacités la prise en charge de l’appel d’outils, de l’état de réflexion, du multimodal, du cache et de la sortie structurée. Pour les chaînes qui dépendent de capacités natives comme l’API Responses, cache_control ou la signature chiffrée, il faut confirmer que l’endpoint correspondant est réellement disponible avant de passer en production, ou bien conserver pour elles un adaptateur natif dédié.
Prise en main rapide de la compatibilité multi-modèles d’API
Exemple minimal : comparer trois modèles avec la même invite
Le code ci-dessous utilise un même client OpenAI SDK pour appeler successivement trois modèles, ce qui correspond au test n°1 de la section 4.1.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

# Les ID de modèle sont ceux de la liste des modèles de la plateforme
MODELS = ["你的GPT模型ID", "你的Claude模型ID", "你的Gemini模型ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
Voir l’implémentation complète : événements de streaming unifiés + registre de capacités + validation des outils
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

# Registre des capacités : les valeurs ne servent qu'à illustrer la structure, à maintenir selon la doc officielle et vos tests réels
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # L'appel d'outils passe par l'adaptateur Responses
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """Classification unifiée des erreurs, qui détermine si un nouvel essai est possible"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # Nouvel essai possible avec backoff
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # Erreur de paramètre ou dépassement du contexte : ne pas réessayer à l'aveugle
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """Convertit un flux au format compatible OpenAI en événements internes unifiés"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # Concatène par index les fragments d'arguments des appels d'outils parallèles
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # Flux coupé en cours de route

EXECUTED_KEYS: set[str] = set()   # En production, à remplacer par un stockage persistant

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """Valider d'abord les arguments, puis exécuter de manière idempotente"""
    try:
        args = json.loads(call["args"])   # On ne parse qu'une fois tous les fragments reçus
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# Exemple d'utilisation
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 Démarrage rapide : inscrivez-vous sur APIYI apiyi.com pour obtenir un crédit de test gratuit, puis utilisez le code ci-dessus avec la même clé API pour réaliser les deux premiers tests de la section 4.1. Pour les tests liés à l’appel d’outils et au raisonnement multi-tours, vérifiez chaque modèle un par un à l’aide du registre des capacités.
Questions fréquentes (FAQ)
Q1 : Que recouvre principalement le problème de compatibilité des API multi-modèles ?
Il s’agit des différences qu’une même application doit gérer lorsqu’elle bascule entre GPT, Claude et Gemini, en raison de structures d’API natives différentes. On distingue 6 catégories principales : rôles des messages, appels d’outils, état de raisonnement, événements de streaming, sortie structurée et multimodal, facturation du cache et gestion des erreurs.
Q2 : Si j’appelle Claude et Gemini via une interface compatible OpenAI, ai-je encore besoin d’une couche d’adaptation ?
Pour une conversation ordinaire, l’interface compatible suffit. Dès qu’il s’agit de paramètres d’outils stricts, de Prompt Caching, d’entrées de fichiers ou d’états de réflexion chiffrés, une couche d’adaptation devient nécessaire. Prenons l’exemple de la couche de compatibilité officielle de Claude : elle ignore `strict` et ne prend pas en charge le cache ni les entrées audio/file. Ces différences doivent être consignées dans un registre des capacités.
Q3 : Pour un nouveau projet Gemini, faut-il utiliser l’Interactions API ou generateContent ?
L’Interactions API est passée en GA en juin 2026, et Google recommande de la privilégier pour les nouveaux projets. Elle prend en charge l’état de session côté serveur, `previous_interaction_id` et la structure steps. `generateContent` reste pris en charge, et les projets existants peuvent migrer selon leur planning.
Q4 : Comment gérer l’historique lorsqu’on change de modèle en cours de session ?
Les messages utilisateur, les réponses finales, les requêtes d’outils et les résultats d’outils sont stockés comme un historique standard, puis réassemblés par l’adaptateur cible après le changement. Les états propres à un fournisseur, comme les signatures et les éléments de raisonnement, sont conservés séparément et renvoyés tels quels uniquement lors d’une requête au même fournisseur. Par ailleurs, après un changement, le cache du fournisseur précédent n’est généralement pas réutilisable : prévoyez le coût d’entrée complet pour le premier tour.
Q5 : Comment vérifier rapidement la compatibilité des trois modèles dans mon activité ?
Voici les étapes recommandées :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et obtenir une clé API ainsi qu’un quota de test gratuit.
2. Utilisez le code de cet article, définissez base_url sur l’adresse de l’API APIYI et renseignez les trois ID de modèles.
3. Exécutez les six tests de la section 4.1, niveau par niveau, et consignez le taux de réussite, les types d’erreurs, le coût et la durée totale.
Q6 : À quoi faut-il faire attention lors de la mise en place d’un basculement automatique entre modèles ?
Commencez par déterminer si la tâche a des effets de bord. Les outils comme le paiement, l’envoi d’e-mails ou la modification de fichiers doivent impérativement porter une clé d’idempotence ; lors d’un basculement, reprenez à partir de l’étape non terminée plutôt que de relancer toute la tâche. La limitation de débit et les erreurs côté serveur justifient des tentatives avec repli progressif (backoff), tandis que les erreurs de paramètres ou le dépassement de contexte exigent de corriger la requête avant de la renvoyer.
Q7 : Comment maîtriser les coûts lors du routage multi-modèles ?
Enregistrez les coûts par poste de Token et comparez sur la base du coût total d’une tâche complète. Les écarts de prix unitaire entre les trois fournisseurs sont importants : par exemple, la sortie de GPT-6 Astra coûte 50 $ par million de Tokens, contre 3,75 $ pour Gemini 3.8 Flash au tarif promotionnel actuel. Consulter de manière unifiée l’usage de chaque modèle sur APIYI apiyi.com permet de repérer plus vite les chaînes coûteuses, puis d’ajuster les règles de routage en conséquence.
Q8 : Quelles sont les limites d’une passerelle API unifiée ?
La passerelle unifie le point d’entrée des appels, les clés et la facturation. La disponibilité des capacités avancées natives d’un fournisseur (comme l’appel d’outils spécifique à la Responses API, `cache_control`, le renvoi de signatures chiffrées) dépend du support du point de terminaison concerné et doit être vérifiée par des tests un par un. Les chaînes qui reposent sur ces capacités doivent conserver un adaptateur natif comme complément.
Compatibilité API multi-modèles : les points clés à retenir
- Changer de modèle ≠ changer d’ID : les échanges question-réponse classiques se migrent directement, mais une chaîne d’agents doit gérer 6 catégories de différences.
- La couche de compatibilité a ses limites : la couche de compatibilité Claude ignore
strictet ne prend pas en charge le cache ni les entrées de type fichier. - Les signatures doivent être conservées telles quelles : la perte des signatures thinking / thought est une cause fréquente d’erreurs dans les chaînes d’outils multi-tours.
- Uniformiser les événements de streaming : le backend émet 8 types d’événements internes, tandis que le frontend n’est branché que sur un seul protocole.
- Un registre des capacités pilote le routage : on enregistre les fonctionnalités réellement disponibles par unité « modèle + endpoint ».
- Le repli doit être idempotent : on ajoute une clé d’idempotence aux outils qui ont des effets de bord, pour éviter les exécutions en double.
- Tester avant de mettre en ligne : utilisez le quota gratuit d’APIYI apiyi.com pour valider les six tests de compatibilité.
En résumé
Quand une application doit intégrer à la fois GPT, Claude et Gemini, tout l’enjeu consiste à concentrer les différences dans un petit nombre de composants pour les gérer au même endroit :
- Un format unifié pour les messages et les outils : l’historique standard et les états propres à chaque fournisseur sont stockés en couches séparées, pour que le contexte ne soit pas perdu lors d’un changement de modèle.
- Provider Adapter : il gère la conversion des entrées, la conversion des sorties et le traitement de l’état ; c’est là que les capacités avancées natives sont implémentées.
- Le registre des capacités : il consigne fidèlement, pour chaque modèle et chaque endpoint, la prise en charge des outils, du raisonnement, du multimodal, des schémas (Schema) et du cache, et c’est lui qui décide du routage et des options affichées dans l’interface.
Sur cette base, on sécurise la qualité de la mise en production avec les six tests de compatibilité et une observation des coûts poste par poste. Pendant la phase d’appels classiques et de comparaison de modèles, je vous recommande de passer par APIYI apiyi.com pour valider rapidement plusieurs modèles avec une seule clé API, puis de décider, à partir des résultats des tests, quelles chaînes nécessitent une adaptation native.
📚 Références
- OpenAI Function Calling : appels d’outils,
call_idetfunction_call_output - Lien :
developers.openai.com/api/docs/guides/function-calling -
Description : référence officielle du protocole d’appel d’outils de l’API Responses
-
Guide de migration vers les derniers modèles OpenAI : paramètres de raisonnement et exigences d’interface pour la série GPT-6
- Lien :
developers.openai.com/api/docs/guides/latest-model -
Description : limites des valeurs de
reasoning.effortet exigences de l’API Responses -
OpenAI Prompt Caching : points de rupture du cache et TTL
- Lien :
developers.openai.com/api/docs/guides/prompt-caching -
Description : mécanismes de cache implicite et explicite
-
Compatibilité Claude avec le SDK OpenAI : périmètre et limites de la couche de compatibilité
- Lien :
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
Description : différences concernant
strict, le cache, les entrées de fichiers, la fusion des messages system, etc. -
Claude Extended Thinking : Adaptive Thinking et signatures de réflexion
- Lien :
platform.claude.com/docs/en/build-with-claude/extended-thinking -
Description : règles de renvoi des blocs thinking lors d’appels d’outils multi-tours
-
Sorties structurées et cache chez Claude : sorties JSON, usage strict des outils,
cache_control - Liens :
platform.claude.com/docs/en/build-with-claude/structured-outputs - Liens :
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Description : contraintes structurelles et modes de cache
-
API Gemini Interactions et compatibilité OpenAI : nouvelle interface et point d’entrée compatible
- Liens :
ai.google.dev/gemini-api/docs/interactions-overview - Liens :
ai.google.dev/gemini-api/docs/openai -
Description : structure des steps, état de session et correspondance des paramètres compatibles
-
Signatures de réflexion, appels d’outils et cache Gemini
- Liens :
ai.google.dev/gemini-api/docs/thought-signatures - Liens :
ai.google.dev/gemini-api/docs/function-calling - Liens :
ai.google.dev/gemini-api/docs/caching -
Description : conservation des signatures en mode stateless, protocole d’outils et cache explicite
-
Pages tarifaires officielles des trois fournisseurs
- Liens :
developers.openai.com/api/docs/pricing - Liens :
platform.claude.com/docs/en/models/sonnet-5-5/overview - Liens :
ai.google.dev/gemini-api/docs/pricing - Description : sources des données du tableau des prix de cet article, vérifiées le 2026-11-13
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com


