
Note de l’auteur : toutes les limites de capacités décrites dans cet article ont été vérifiées par rapport à la documentation des modèles APIYI, relue selon la version de novembre 2026 ; les conclusions se fondent sur cette documentation.
Une image de portrait, un fichier audio, et vous voulez que la personne à l’écran se mette à parler : c’est la demande la plus fréquente en image vers vidéo. Beaucoup de gens ont alors le réflexe de passer driving_audio en même temps que happyhorse-1.1-i2v — et là, la conduite audio ne prend pas effet. On commence alors à douter des fichiers fournis, de l’ordre des paramètres, voire de sa propre façon d’appeler l’API.
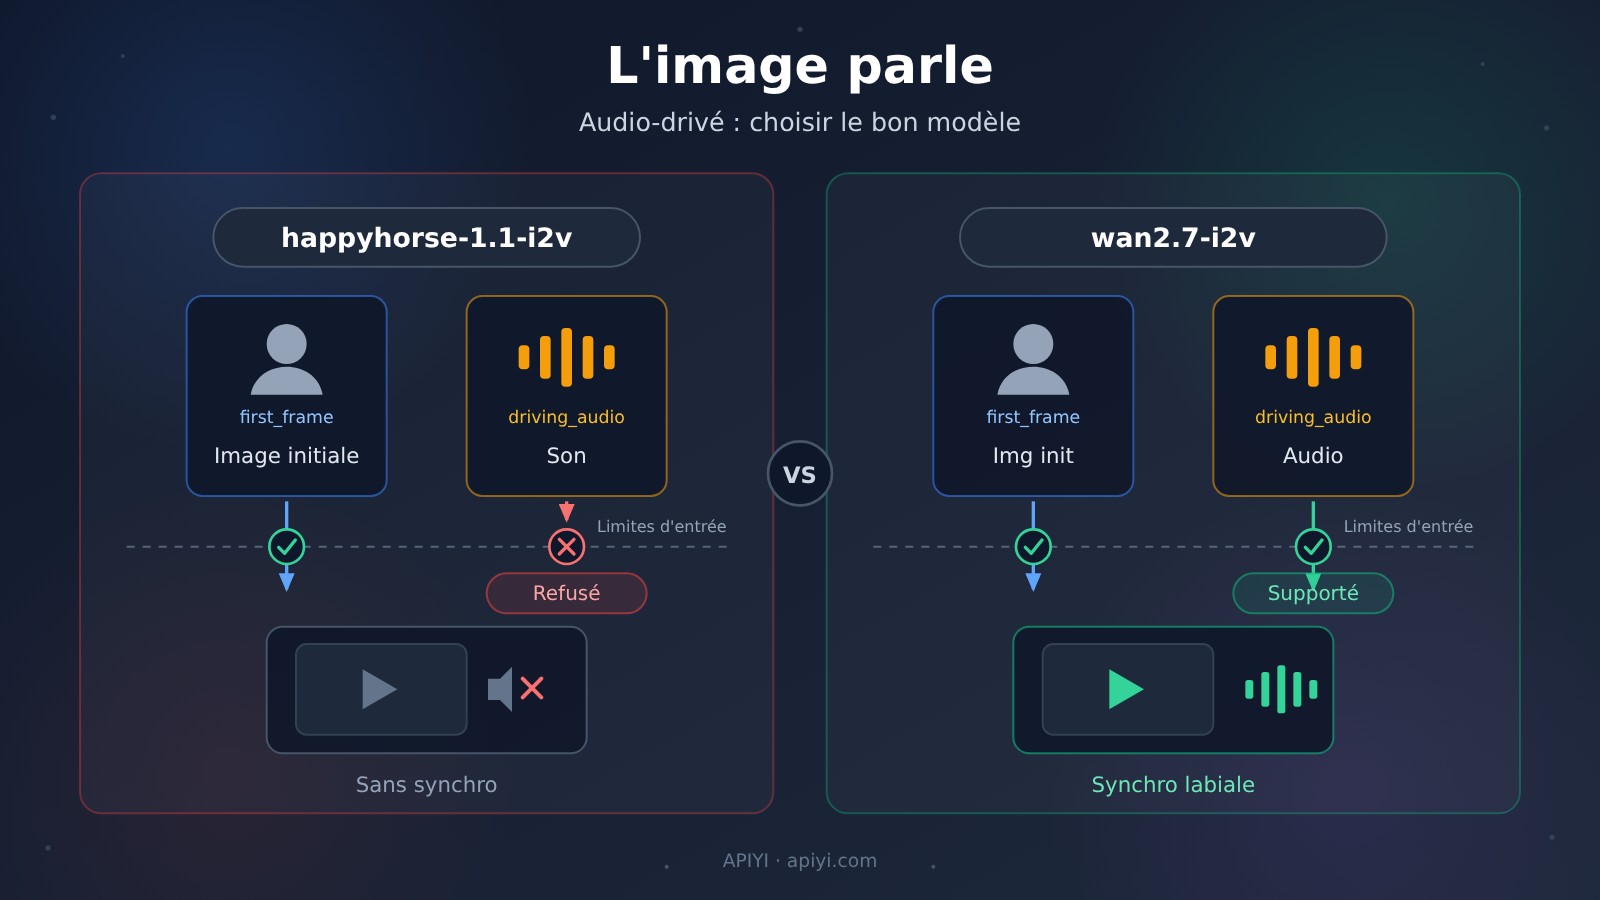
Ce n’est ni un bug mystérieux, ni un problème de qualité des fichiers. La documentation est très claire là-dessus : happyhorse-1.1-i2v n’accepte que first_frame et ne prend pas en charge driving_audio. Pour faire de la synchronisation labiale ou du lip-sync chanté, la documentation oriente vers wan2.7-i2v.
L’essentiel : après lecture, vous saurez exactement où se situe la frontière entre happyhorse-1.1-i2v et wan2.7-i2v, à qui transmettre les paramètres quand vous voulez « faire parler une image », et vous réussirez du premier coup.
happyhorse-1.1-i2v : les points essentiels
Commençons par la conclusion, les détails viendront ensuite :
| Point clé | Ce que dit la documentation | Ce que ça implique pour vous |
|---|---|---|
| Ne reconnaît que l’image de la première frame | happyhorse-1.1-i2v accepte une entrée first_frame |
L’image est son seul point d’entrée de pilotage |
| Pas de pilotage audio | Le modèle ne prend pas en charge driving_audio |
Vous pouvez toujours la passer, ça ne fera rien : inutile de réessayer en boucle |
| La synchronisation labiale passe ailleurs | La doc recommande wan2.7-i2v pour les scénarios de synchro labiale |
Changer de modèle règle le problème plus vite que de changer de paramètres |
Le premier point est celui qui prête le plus à confusion. driving_audio n’est pas un paramètre caché de happyhorse-1.1-i2v, et ce n’est pas non plus une capacité qu’il faudrait attendre d’une future version. La documentation du modèle l’indique explicitement comme non pris en charge, et l’entrée « image vers vidéo » de la page de présentation arrive à la même conclusion. Autrement dit, le problème ne vient pas de votre façon d’appeler l’API : la limite de capacité du modèle se situe simplement là.
Deuxième point, la voie de repli. La documentation le précise : le pilotage audio est une capacité réservée à wan2.7-i2v, et l’i2v de HappyHorse ne prend pas ce type de tâche en charge. Donc quand un personnage doit se mettre à parler, le bon réflexe n’est pas de continuer à ajuster les paramètres, mais de changer de modèle directement.
Différences clés entre happyhorse-1.1-i2v et wan2.7-i2v
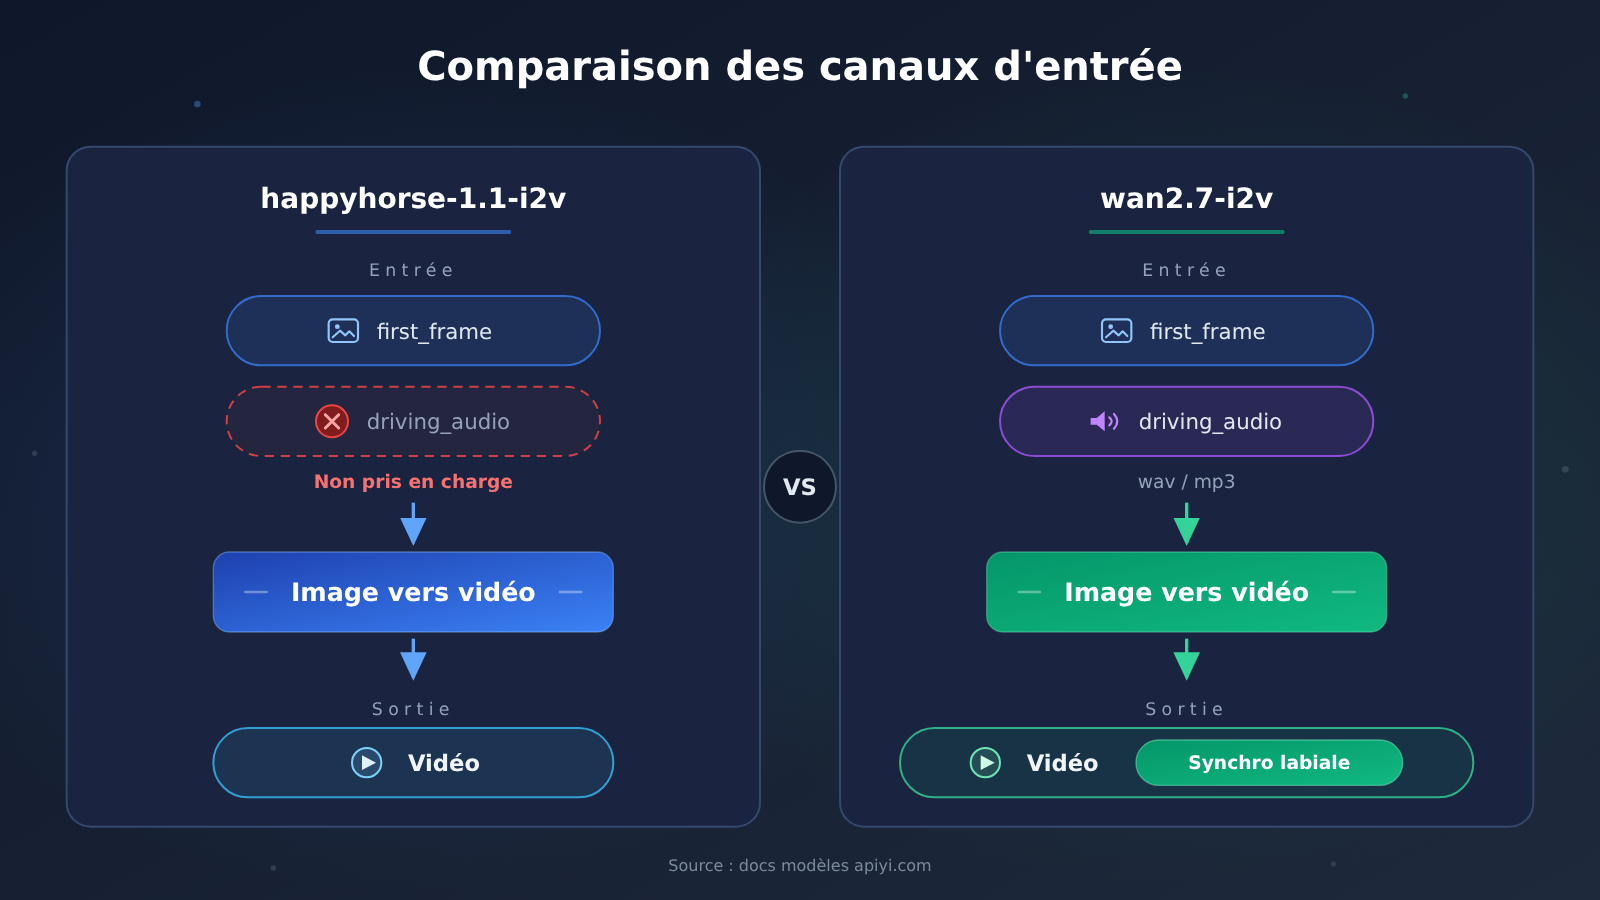
Les deux modèles servent tous deux à générer une vidéo à partir d’une image de première frame, leurs positionnements se chevauchent, et c’est la ligne sur l’entrée audio qui creuse vraiment l’écart :
| Dimension de comparaison | happyhorse-1.1-i2v |
wan2.7-i2v |
Conclusion sur la différence |
|---|---|---|---|
| Type de tâche | Génération de vidéo à partir d’une image de première frame | Génération de vidéo à partir d’une image de première frame | Positionnements qui se chevauchent, ne départagez pas sur le nom |
first_frame |
Accepté | Doit en avoir exactement 1 | L’entrée image est indispensable des deux côtés |
driving_audio |
Non pris en charge | Pris en charge, 1 facultatif | La ligne de partage de la synchronisation labiale |
| Format audio | Non applicable | wav ou mp3 |
Vérifiez le format avant de passer les paramètres |
| Scénario de synchronisation labiale | La documentation recommande d’utiliser wan2.7-i2v à la place |
La documentation désigne ce modèle pour ce scénario | Cette ligne suffit pour choisir |
Le tableau ci-dessus et le schéma sont tous deux établis à partir de la documentation des modèles APIYI (apiyi.com), et non de suppositions empiriques.
happyhorse-1.1-i2v est la voie à suivre pour « faire bouger une première frame statique » : donnez-lui une first_frame, et il se charge de faire jouer l’image. Mais l’audio ne figure pas dans sa liste d’entrées, la documentation indique que la capacité de pilotage par l’audio n’a pas été ouverte à l’i2v de HappyHorse. En comparaison, wan2.7-i2v ouvre une porte supplémentaire en plus de la même entrée de première frame, driving_audio, et le rythme des mouvements du personnage peut suivre l’audio.
Les contraintes de wan2.7-i2v sont aussi plus précises : les médias doivent contenir exactement 1 first_frame, au plus 1 driving_audio, et le format audio est limité à wav ou mp3. Ces contraintes sont écrites de manière stricte, et l’avantage, c’est qu’en assemblant selon la documentation, ça fonctionne du premier coup, sans avoir à deviner.
Pourquoi happyhorse-1.1-i2v n’accepte pas driving_audio
En recoupant les indices de la documentation, au moins quatre éléments pointent vers la même conclusion :
- La page du modèle l’indique noir sur blanc :
happyhorse-1.1-i2vest un modèle image vers vidéo qui génère à partir de la première image, et n’accepte quefirst_frame. - La même page précise explicitement que
driving_audion’est pas pris en charge. - Dans la page d’aperçu, l’entrée image vers vidéo porte elle aussi la mention « pas d’audio de pilotage ».
- Pour les besoins de synchronisation labiale ou de rap, la documentation donne directement une recommandation de migration : passer à
wan2.7-i2v.
On en revient donc au scénario classique : vous avez glissé driving_audio dans votre requête, le résultat ne correspond pas à ce que vous attendiez, et vous commencez à vérifier un par un les médias et les paramètres. Quelle que soit la forme du retour de l’API, la cause racine est toujours la même : ce champ ne fait pas partie des entrées acceptées par happyhorse-1.1-i2v. La documentation ne laisse aucune porte de sortie du genre « il suffit de l’écrire autrement » ; réessayer ou changer de média ne déplace pas les limites d’entrée.
Si vous avez lancé l’appel via APIYI (apiyi.com), commencez par comparer un à un l’ID du modèle et les noms de champs de votre requête avec la documentation, puis vérifiez les autres étapes. La plupart des problèmes du type « l’audio ne prend pas effet » se règlent à ce stade, sans avoir à chercher midi à quatorze heures.
Une fois le passage à wan2.7-i2v confirmé, le processus ne compte plus que quatre étapes, et l’essentiel repose sur l’assemblage des médias :
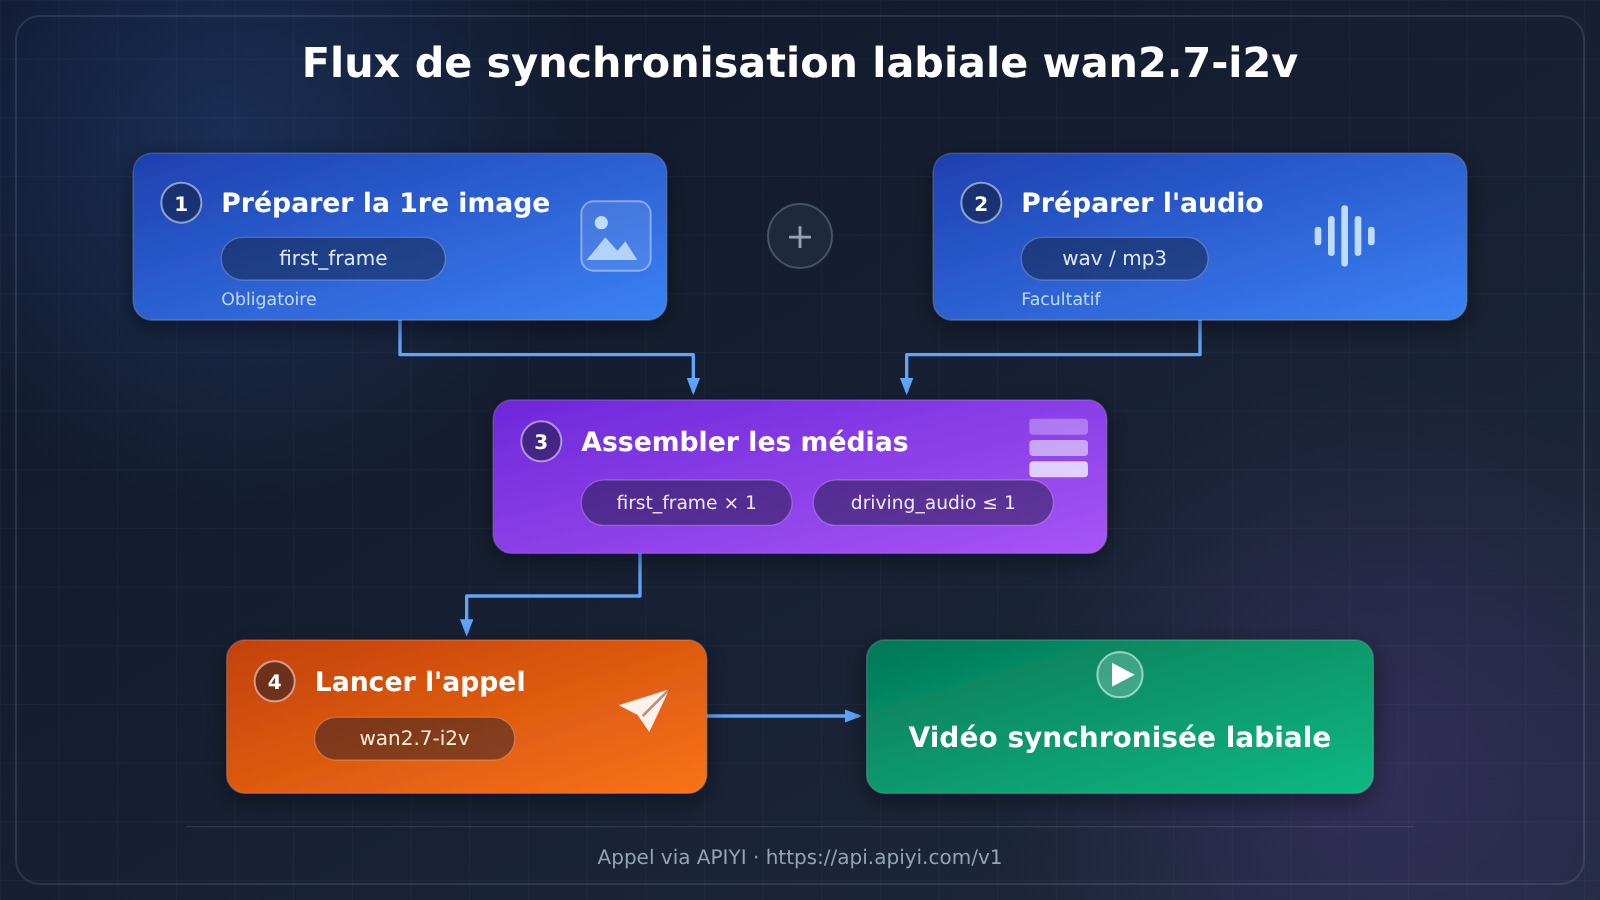
- Préparer l’image de première frame : une image avec une personne nette et une composition stable, à utiliser comme
first_frame. - Préparer l’audio : au format
wavoump3, à utiliser commedriving_audiopour piloter la synchronisation labiale et le rythme. - Assembler les médias : exactement 1
first_frame, au maximum 1driving_audio, n’en ajoutez pas davantage. - Lancer l’appel : renseignez le modèle
wan2.7-i2v; pour un appel via APIYI, l’adresse de base de l’interface esthttps://api.apiyi.com/v1.
| Champ | Obligatoire | Contrainte de quantité | Format requis |
|---|---|---|---|
first_frame |
Obligatoire | Exactement 1 | Image de première frame |
driving_audio |
Facultatif | Au maximum 1 | wav ou mp3 |
Les deux premières étapes ne posent pas de difficulté ; c’est vraiment la 3e qui décide de la réussite. La documentation est très stricte sur les quantités : first_frame doit être présent et exactement au nombre de 1, driving_audio est facultatif et au maximum 1. Envoyer plus d’images ou d’audios que prévu peut rendre la requête non conforme ; ne transposez pas l’intuition du « plus il y en a, mieux c’est » dans l’assemblage des paramètres.
🚀 Démarrage rapide : nous vous recommandons de valider ce processus directement via APIYI apiyi.com. La plateforme regroupe les API des principaux modèles comme OpenAI, Claude et Gemini ; une seule clé permet d’appeler plusieurs modèles, la facturation se fait à l’usage, et les nouveaux utilisateurs disposent d’un crédit de test gratuit : faire fonctionner la synchronisation labiale avec
wan2.7-i2vne coûte presque rien.
happyhorse-1.1-i2v ou wan2.7-i2v : recommandations par scénario
| Votre besoin | Modèle recommandé | Entrées clés |
|---|---|---|
| Personnage qui parle, lèvres synchronisées avec l’audio | wan2.7-i2v |
first_frame plus driving_audio |
| Rap, dialogues et autres performances rythmées | wan2.7-i2v |
first_frame plus driving_audio |
| Faire bouger naturellement une image fixe, sans son | happyhorse-1.1-i2v |
first_frame uniquement |
Les cas où vous restez sur happyhorse-1.1-i2v
Pour les tâches d’animation sans audio, happyhorse-1.1-i2v reste un choix tout à fait légitime. Son rôle : transformer une image de première frame en une vidéo avec du mouvement. L’entrée est simple, il ne connaît que first_frame. Si votre montage final est doublé en post-production, ou si vous n’avez pas besoin de son du tout, rester ici est même plus pratique.
- Mouvement piloté par la première frame : faire bouger naturellement des personnages ou des paysages à partir d’une image fixe.
- Production de contenu muet : doublage en post-production, ou affichage dans des contextes sans son.
Les cas où passer à wan2.7-i2v
Dès que la vidéo finale doit montrer un personnage « qui bouge au rythme du son », la réponse est wan2.7-i2v. Sa capacité de pilotage par l’audio, documentée officiellement, en fait la seule des deux options à accepter driving_audio : la synchronisation des lèvres et le rythme sont directement entraînés par la piste audio.
- Synchronisation labiale : un portrait plus une voix, et vous obtenez une vidéo où la personne parle.
- Performance pilotée par l’audio : rap, dialogues et autres contenus rythmés, où les mouvements suivent l’audio.
Si vous avez les deux types de besoins, vous pouvez exécuter le même jeu de fichiers une fois sur chaque modèle via APIYI : changer de modèle ne demande pas de changer de clé API. Rien ne vous empêche de comparer, puis de répartir les rôles.
Recommandations de décision entre happyhorse-1.1-i2v et wan2.7-i2v
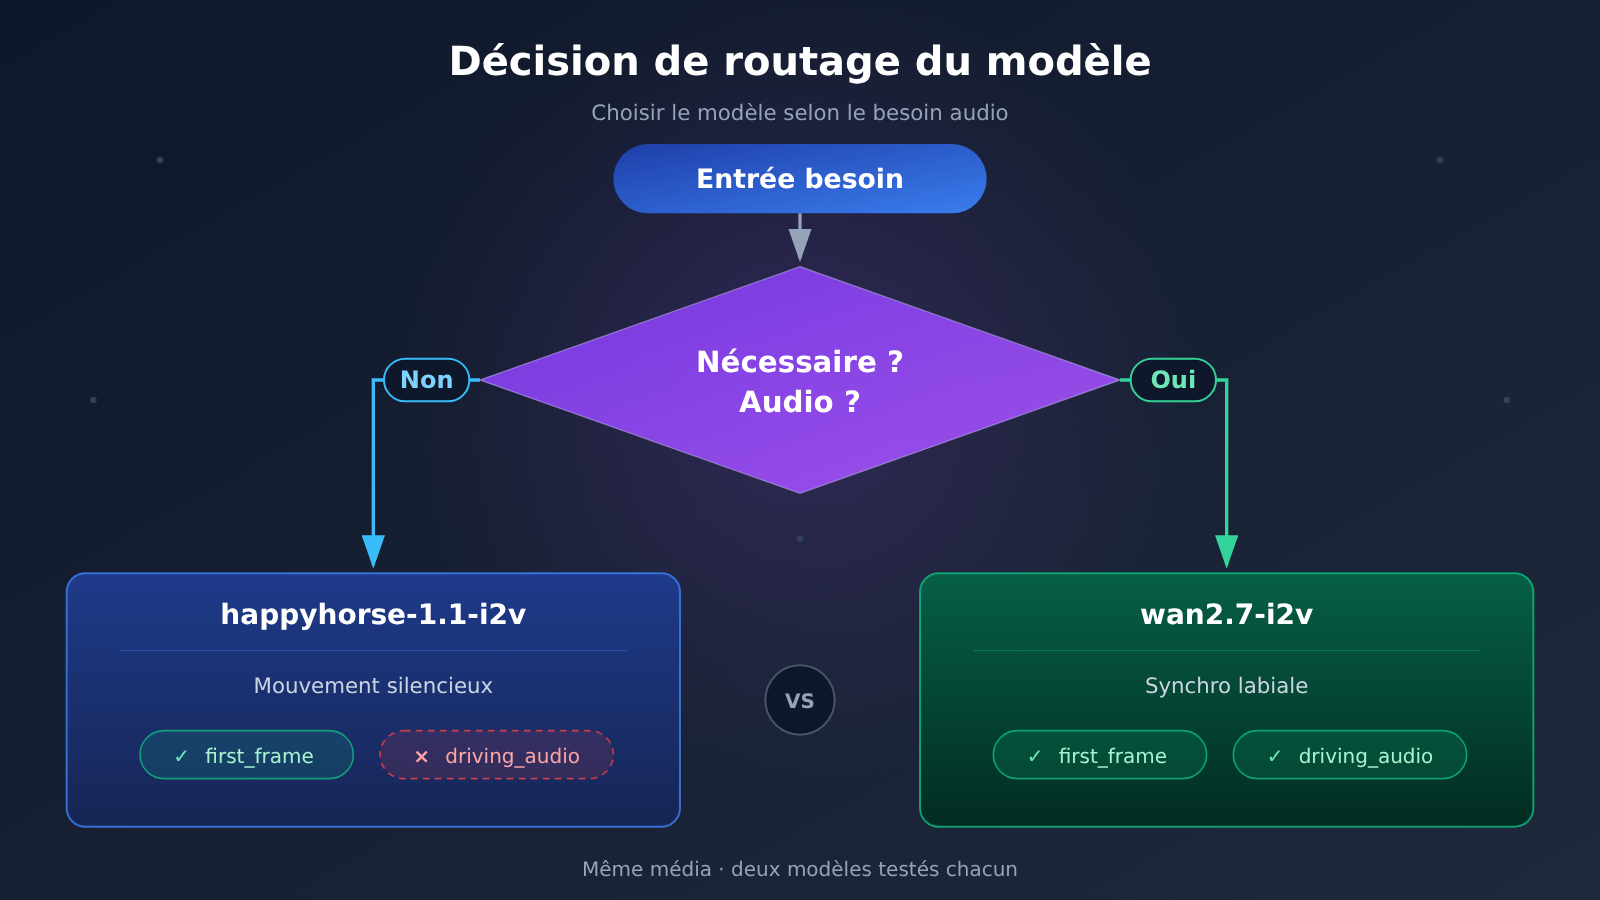
| État actuel | Action recommandée |
|---|---|
| La synchronisation labiale est une exigence stricte | Passez directement à wan2.7-i2v avec driving_audio |
| Vous voulez juste que l’image bouge | Restez sur happyhorse-1.1-i2v, en ne transmettant que first_frame |
Vous avez déjà transmis l’audio à happyhorse-1.1-i2v sans effet |
Arrêtez de réessayer, passez à wan2.7-i2v : ce n’est pas un problème de paramètres |
Le cœur de la décision tient en une seule question : « cette vidéo doit-elle parler ? » Si le son participe au jeu, la réponse est wan2.7-i2v ; sinon, happyhorse-1.1-i2v reste parfaitement capable de générer une vidéo à partir d’une image de première frame. Confier l’audio au bon modèle fait gagner plus de temps que de s’acharner sur les paramètres de n’importe quel modèle.
💡 Conseil de choix : si vous n’êtes pas sûr du rendu, ne restez pas au niveau du raisonnement théorique sur la doc — lancez plutôt directement sur APIYI apiyi.com un cas d’usage minimal pour chaque modèle, et tranchez à partir de deux résultats réels : c’est la méthode la plus fiable.
FAQ : questions fréquentes sur driving_audio
Q1 : qu’est-ce que happyhorse-1.1-i2v ?
Un modèle de génération vidéo à partir de l’image de première frame : son entrée n’accepte que `first_frame`. La documentation indique explicitement qu’il ne prend pas en charge `driving_audio` — le pilotage audio n’entre pas dans son périmètre de capacités.
Q2 : quelle différence entre happyhorse-1.1-i2v et wan2.7-i2v côté pilotage audio ?
La documentation présente le pilotage audio comme une capacité réservée à `wan2.7-i2v`, tout en précisant que l’i2v de HappyHorse ne le prend pas en charge. Autrement dit, `wan2.7-i2v` accepte `driving_audio`, et `happyhorse-1.1-i2v` non. Pour savoir si d’autres modèles le prennent en charge, référez-vous à leur documentation respective : ne généralisez pas à partir du nom de la série.
Q3 : que se passe-t-il si on envoie `driving_audio` à happyhorse-1.1-i2v ?
La réponse de la documentation est sans détour : non pris en charge, seul `first_frame` est accepté. Plutôt que d’étudier les détails des différents retours, mieux vaut réorienter ce jeu de ressources vers `wan2.7-i2v` : la même image et le même audio y trouvent immédiatement leur utilité.
Q4 : quelles contraintes de format et de quantité pour `driving_audio` ?
Format audio : `wav` ou `mp3` ; le média doit contenir exactement 1 `first_frame` et au plus 1 `driving_audio`. En construisant la requête selon ces contraintes, on maximise ses chances de passer du premier coup.
Q5 : comment appeler rapidement wan2.7-i2v via l’API ?
Le plus simple est de passer par une plateforme d’agrégation :
1. S’inscrire sur APIYI apiyi.com et récupérer une clé API — les nouveaux utilisateurs disposent d’un quota d’essai gratuit ;
2. Utiliser comme adresse de base de l’interface `https://api.apiyi.com/v1` ;
3. Assembler le média selon le principe « 1 `first_frame` plus 1 `driving_audio` », et renseigner le modèle `wan2.7-i2v`.
Q6 : tous les modèles de la série Wan peuvent-ils recevoir de l’audio de cette façon ?
On ne peut pas généraliser ainsi. La documentation réserve le pilotage audio à `wan2.7-i2v` ; pour les autres modèles, la prise en charge dépend de leur documentation respective — ne devinez pas les capacités à partir du nom de la série.
Q7 : où vérifier les capacités de ces deux modèles ?
APIYI documente les limites de capacités dans la documentation des modèles : il suffit de consulter docs.apiyi.com pour vérifier point par point. Jeter un œil à la documentation avant de choisir coûte bien moins cher que de déboguer après s’être cassé les dents.
happyhorse-1.1-i2v et driving_audio : les points clés à retenir
- Périmètre de capacités :
happyhorse-1.1-i2vn’accepte quefirst_frame;driving_audione fait pas partie de ses entrées. - Capacité dédiée : la synchronisation audio est le domaine de
wan2.7-i2v— c’est lui qu’il faut utiliser pour la synchro labiale. - Contraintes médias : exactement 1
first_frame, au plus 1driving_audio, et l’audio doit être enwavoump3. - Guide de migration : la doc recommande de passer de
happyhorse-1.1-i2vàwan2.7-i2vpour les scènes de synchro labiale ou de rap. - Méthode de validation : exécutez un cas minimal avec le même jeu de ressources sur chacun des deux modèles, et deux résultats suffisent à trancher le choix.
En résumé
Quand on veut « faire parler une image », trois conclusions méritent d’être retenues :
- Limites d’entrée :
happyhorse-1.1-i2vn’accepte pasdriving_audio, il ne reconnaît quefirst_frame— c’est la limite de capacités clairement écrite dans la doc. - Le bon modèle : la synchro labiale et la synchronisation audio sont des capacités exclusives à
wan2.7-i2v; une image et un fichierwavoump3suffisent à démarrer. - Réflexe de dépannage : si l’audio ne prend pas effet, vérifiez d’abord la correspondance entre le modèle et les champs plutôt que de réessayer en boucle.
Si vous hésitez sur le choix, exécutez un cas minimal sur chaque modèle, puis décidez. Je vous recommande de valider rapidement via APIYI apiyi.com : la plateforme offre un quota de test gratuit et un accès unifié à plusieurs modèles — changer de modèle ne nécessite pas de changer de clé.
📚 Références
- Documentation APIYI · HappyHorse, image vers vidéo
- Lien :
docs.apiyi.com/api-capabilities/happyhorse/image-to-video.md -
Description : définition des entrées de
happyhorse-1.1-i2vet emplacement original de la mention «driving_audionon pris en charge ». -
Documentation APIYI · Wan, image vers vidéo
- Lien :
docs.apiyi.com/api-capabilities/wan/image-to-video.md -
Description : contraintes de nombre et de format de
wan2.7-i2vpourfirst_frameetdriving_audio. -
Documentation APIYI · Aperçu de HappyHorse
- Lien :
docs.apiyi.com/api-capabilities/happyhorse/overview.md - Description : indication générale sur la capacité de pilotage audio pour l’entrée image vers vidéo.
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com.


