
Resumen: este artículo explica cómo determinar la cuota de prueba gratuita de un producto de IA y presenta un método para estimar el presupuesto a partir del costo real de las invocaciones y ajustarlo según lo observado en los datos.
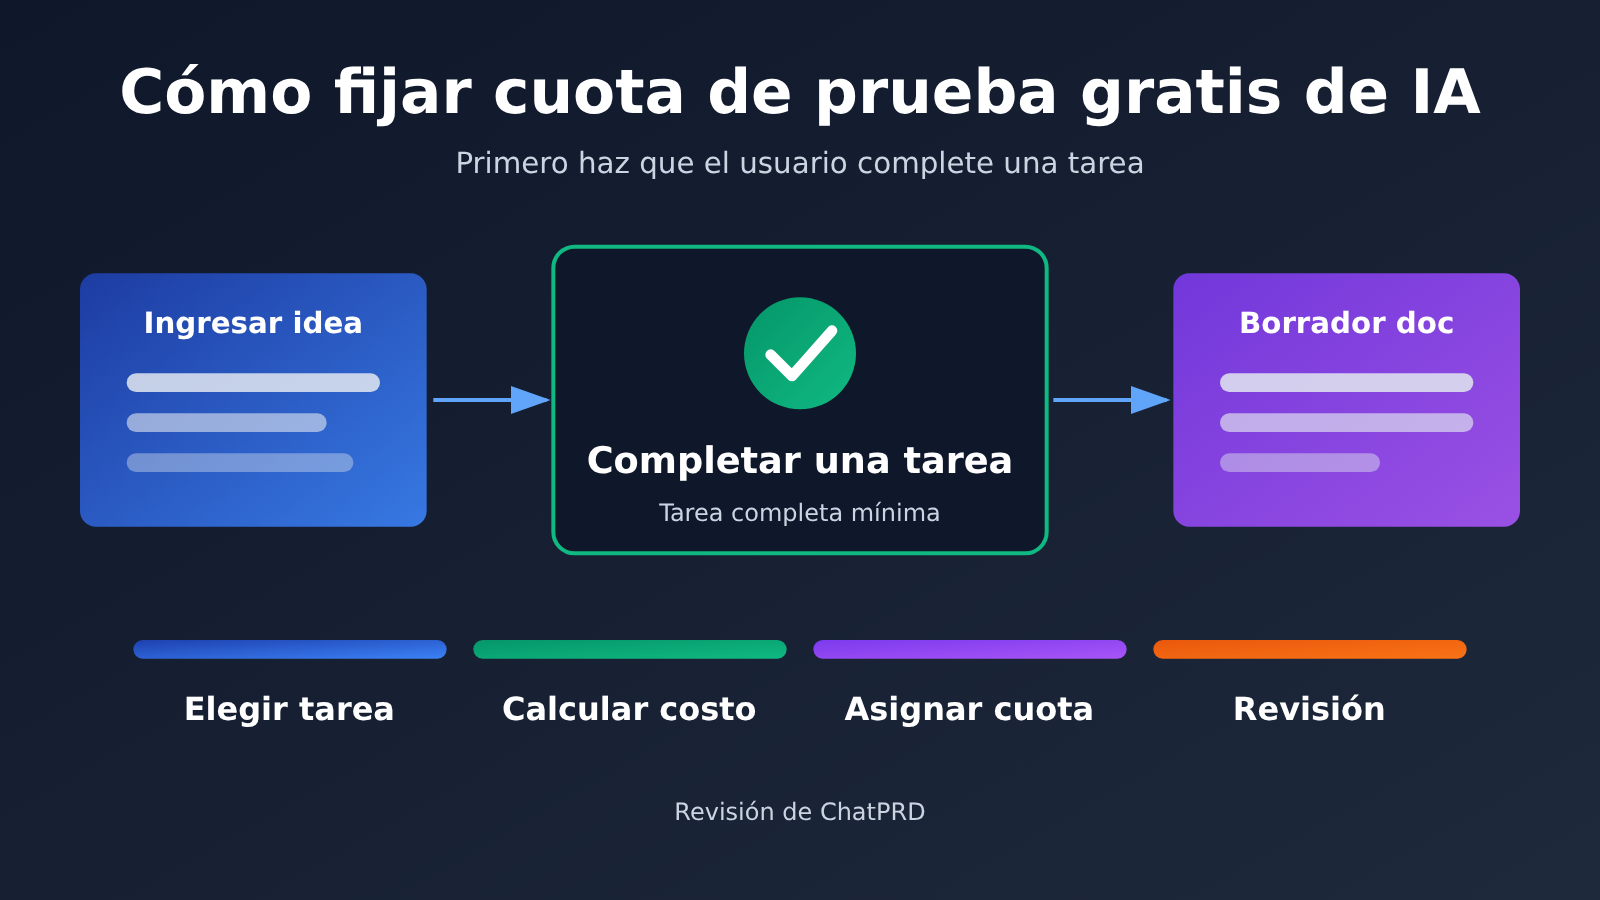
Conclusión inicial: la cuota de prueba gratuita de un producto de IA debe definirse en torno a una sola tarea
La cuota de prueba gratuita de un producto de IA no puede empezar a definirse a partir de la cantidad de tokens o de “cuántos créditos dar”. Primero hay que establecer la única tarea que el usuario debe completar durante el periodo de prueba. El equipo del producto debe identificar una tarea mínima completa en la que el usuario perciba valor de inmediato, medir con muestras reales cuánto cuesta de invocación completarla y, por último, multiplicar ese costo por un número razonable de tareas de prueba para obtener la cuota por cuenta y el presupuesto total.
Esta respuesta depende de tres condiciones. La primera es si la tarea realmente puede completarse dentro del alcance de la prueba; por muchas invocaciones que se den a una tarea que no se puede terminar, la conversión será difícil. La segunda es si el costo proviene de muestras reales, incluidos entrada, salida, reintentos y, cuando corresponda, costos de caché o de herramientas. La tercera es si, cuando se agota la cuota, el usuario tiene claro qué obtuvo y qué puede hacer a continuación.
La revisión de ChatPRD ofrece una referencia realista: una cuota de prueba mal definida genera pérdidas de costo, pero cerrar la prueba de forma indiscriminada también perjudica la captación de clientes. Por eso, la prueba debe diseñarse como algo calculable y revisable, en lugar de elegir entre “todo abierto” y “todo cerrado”.
Mapa de conocimiento e índice para el diseño de la cuota de prueba gratuita
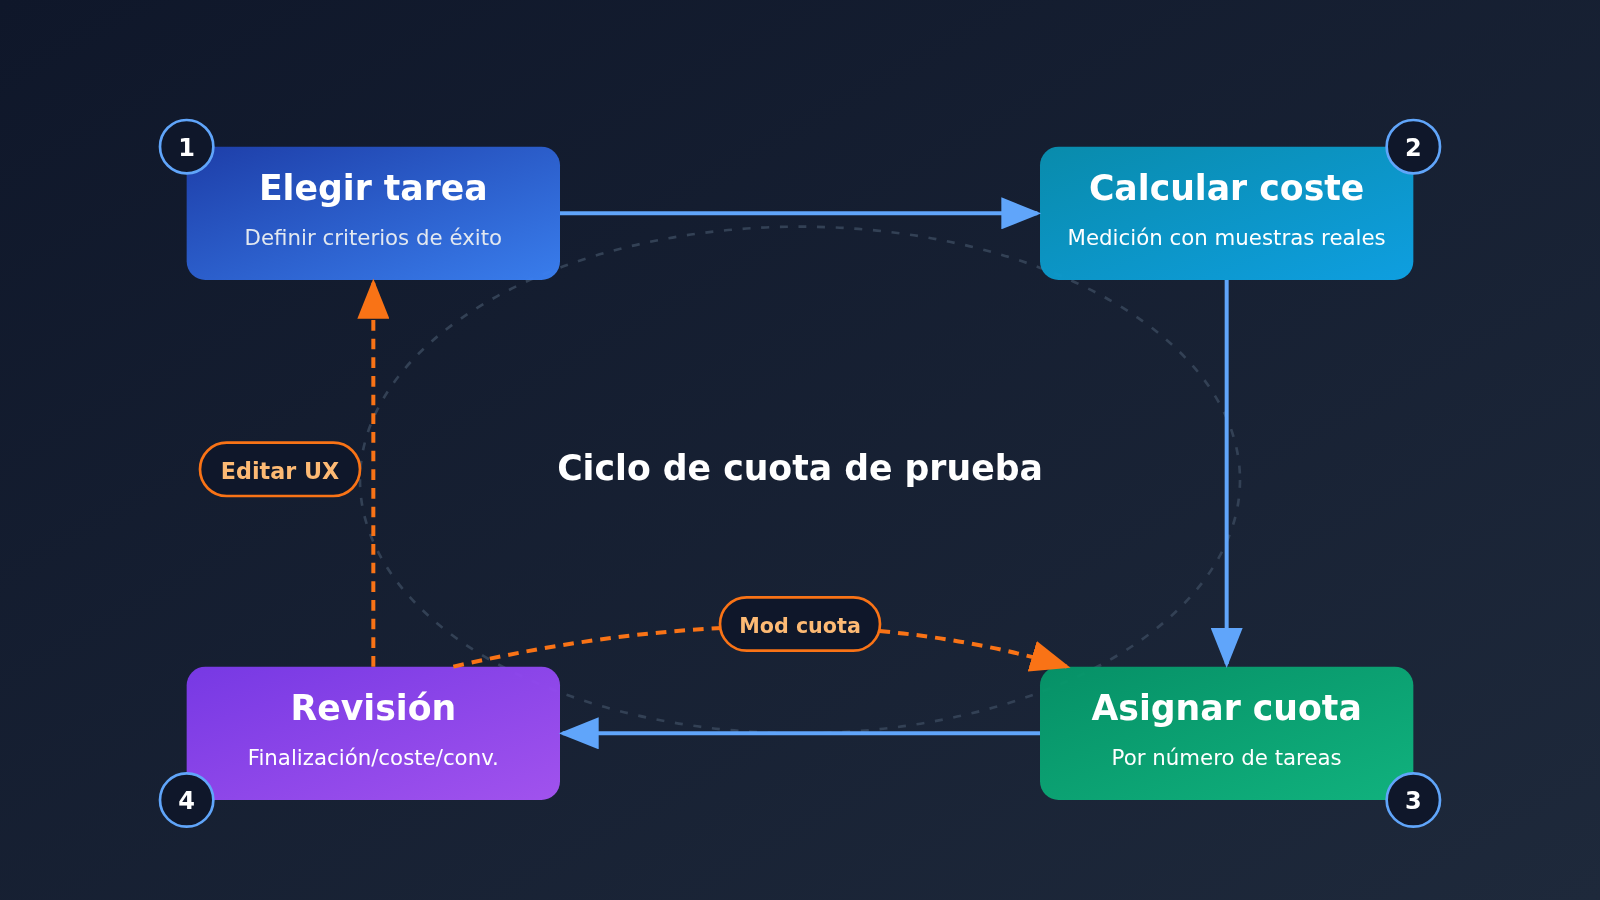
La siguiente tabla funciona a la vez como mapa de conocimiento e índice de lectura. Las cuatro etapas siguen el orden de ejecución: la salida de cada paso es la entrada del siguiente.
| Etapa | Secciones correspondientes | Por qué hacerlo | Qué necesitas | Qué obtienes |
|---|---|---|---|---|
| Elegir la tarea | 2, 2.1, 2.2 | La cuota solo tiene sentido si se usa para completar algo valioso | El valor central del producto y la primera necesidad de un usuario típico | Una tarea mínima con un criterio de finalización claro, además de los límites funcionales disponibles durante la prueba |
| Calcular el costo | 3, 3.1, 3.2 | Sin un costo por uso, tanto la cuota como el presupuesto se definen a ojo | Muestras reales de invocación, precio unitario del modelo, costos de reintento y cargos adicionales | Costo por finalización, costo por cuenta y límite máximo de presupuesto total |
| Asignar la cuota | 3.3, 4 | El usuario necesita entender cuántas tareas permite la cuota, no cuántos tokens | Costo por cuenta, número de tareas y texto del aviso al agotarse | Una cuota expresada en “número de tareas” y un aviso claro de agotamiento |
| Retrospectiva | 4.1 | El efecto de la cuota debe validarse con datos para decidir si cambiar la experiencia o la cuota | Tasa de finalización, costo por cada usuario que completa y datos de conversión a pago | Dirección de ajuste para la siguiente ronda |
El orden de lectura recomendado es ir de la sección 1 a la sección 4. La sección 1 presenta el contexto del problema y te ayuda a evitar una mala interpretación del caso ChatPRD. La sección 2 ofrece una tarea de ejemplo, y todos los cálculos de la sección 3 se basan en esa tarea. A su vez, las métricas de retrospectiva de la sección 4 corrigen los supuestos de las secciones 2 y 3, formando un ciclo. Si ya tienes clara tu tarea central, puedes empezar directamente en la sección 3.
Para saber: los términos imprescindibles para calcular la cuota de prueba gratuita
| Término | Explicación breve |
|---|---|
| Token | Unidad con la que los Modelos de Lenguaje Grande miden la longitud del texto de entrada y salida. La mayoría de las API de modelos cobran por separado los tokens de entrada y los de salida. |
| Tarea mínima completa | Algo que el usuario puede completar por su cuenta durante la prueba y que le permite percibir directamente el valor del producto. Es la unidad básica para diseñar la cuota. |
| Reintento | Cuando el usuario no queda satisfecho con el resultado y vuelve a generarlo, o cuando solicita de nuevo después de un fallo, se generan costos adicionales. |
| Costo de completar una vez | Costo promedio de invocación para completar una vez la tarea mínima completa, incluidos los reintentos y los cargos adicionales aplicables. |
| Tasa de finalización efectiva de la primera tarea | Proporción de usuarios de la prueba que completan al menos una vez la tarea central de principio a fin. |
1. Análisis retrospectivo de ChatPRD: qué ocurrió cuando falló la cuota de prueba gratuita
1.1 Hechos clave del análisis retrospectivo
Claire Vo, fundadora de ChatPRD, publicó el 2026-11-16 un análisis retrospectivo sobre cómo el fraude de tokens está erosionando los márgenes de los productos de IA. Ella misma cuenta que durante casi un año gastó decenas de miles de dólares por este problema e incluso llegó a cerrar la prueba gratuita, lo que perjudicó la adquisición de clientes y la captación de oportunidades de venta empresariales.
En el análisis también hay otra cifra que se presta a malentendidos: casi 200.000 dólares. Es el monto de los intentos de pago fallidos, no el de la pérdida real. Al citar este caso, hay que distinguir entre “las decenas de miles de dólares ya gastados” y “casi 200.000 dólares en intentos de pago fallidos”; de lo contrario, se exagera seriamente la escala del problema.
1.2 No saques de este caso la conclusión de “eliminar la prueba”
La página de precios pública actual de ChatPRD sigue incluyendo un plan gratuito, y los planes Pro y Teams también ofrecen 14 días de prueba. Por eso, este análisis no debe interpretarse como que ChatPRD ya eliminó todas las pruebas gratuitas, y mucho menos como que la experiencia de un solo producto se puede extrapolar a toda la industria.
La lección realmente valiosa de este caso tiene dos caras. El abuso de la cuota de prueba se come directamente los márgenes, pero cerrar la prueba también hace perder usuarios potenciales reales y clientes empresariales. Lo que necesitan los equipos de producto es un método de diseño de cuotas que permita tanto que los usuarios reales perciban valor como calcular con claridad el costo del subsidio. Las siguientes secciones giran en torno a ese objetivo.
2. Diseñar la cuota de la prueba gratuita con «generar un borrador editable de PRD»
Para que los cálculos posteriores tengan un objeto concreto, aquí usamos una tarea de ejemplo: el usuario introduce una idea de producto y al final obtiene un borrador de PRD que puede seguir editando. La elegimos porque está muy cerca del trabajo real de un product manager: en cuanto recibe el resultado, el usuario puede juzgar al instante si «esto sirve o no».
Cabe aclarar que esta es solo una tarea de demostración para ilustrar el método y no representa el diseño real de la prueba gratuita de ChatPRD. En tu producto puedes sustituirla por «generar un análisis de la competencia», «reescribir un texto de marketing» o «completar una revisión de código»; el método no cambia.
2.1 Definir el criterio de finalización de la tarea de prueba gratuita
El criterio de finalización debe poder comprobarse y, a ser posible, determinarse mediante eventos instrumentados en los datos del producto. Para «generar un borrador editable de PRD» se puede definir así:
- El usuario envió una idea de producto y respondió a las preguntas de aclaración necesarias.
- El sistema generó un borrador con una estructura completa que incluye al menos las secciones de contexto, usuarios objetivo, requisitos centrales y criterios de aceptación.
- El usuario editó el borrador al menos una vez o pidió modificaciones, lo que indica que el contenido entró en su flujo de trabajo real.
- El usuario exportó, copió o guardó este borrador.
Los puntos 3 y 4 son la clave para distinguir entre «lo vio» y «lo usó». Si solo se genera, sin editar y sin guardar, normalmente significa que el resultado no convenció al usuario; contar este tipo de prueba como completada distorsionaría los datos del análisis posterior.
2.2 Elegir las funciones y los límites disponibles en la prueba gratuita
El límite de funcionalidades determina qué capacidades hay que invocar para completar la tarea y también define directamente la estructura de costes. Las funciones disponibles durante la prueba deberían cubrir justo lo necesario para cumplir el criterio de finalización; no hace falta abrir todas las capacidades avanzadas a la vez.
- Conviene abrir: el diálogo de aclaración, la generación del borrador, las modificaciones basadas en la conversación y la exportación o copia. Son pasos obligatorios para completar la tarea; si falta uno, el usuario no puede terminarla.
- Se pueden limitar: la carga de documentos largos, la búsqueda en internet, la comparación de varios documentos y otras capacidades de alto coste o no imprescindibles. Pueden reservarse para el plan de pago como motivo para mejorar de plan.
- Hay que poner topes: la longitud de una entrada individual y el número de rondas de modificación por borrador. La función del tope es hacer que el coste sea predecible, no complicarle la vida al usuario.
Una vez definidos los límites, se puede enumerar la ruta de invocación típica para completar una tarea; el cálculo de costes de la sección 3 se va acumulando paso a paso siguiendo esa ruta.
3. Estimar el presupuesto de subsidio para la prueba gratuita basándose en el uso real
En esta sección solo hay una fórmula central: el presupuesto de la prueba equivale al coste de invocación necesario para completar la tarea objetivo, multiplicado por un número razonable de tareas de prueba; el coste de invocación debe calcularse a partir de muestras reales, contabilizando entrada, salida, caché o tarifas de herramientas aplicables y reintentos. El límite superior del presupuesto global y el mensaje cuando se agota la cuota los define aparte el lado del producto.
3.1 Calcular el coste de una finalización a partir de muestras reales
Primero dejemos claro el criterio: los números de tokens, tasas de reintento y precios unitarios de la tabla siguiente son todos valores hipotéticos establecidos para el cálculo demostrativo; no son el precio público de ningún modelo ni datos medidos. En la práctica, deberías sustituir estas cifras con los registros reales de invocación de pruebas internas o de usuarios en despliegue gradual.
Si tus invocaciones del modelo pasan por una plataforma de agregación, puedes consultar los datos desde la página pública de precios de modelos y la función de consulta de registros de invocación, por ejemplo, la documentación de precios de modelos y la documentación de consulta de registros de APIYI. Ten en cuenta que este tipo de plataformas solo proporcionan datos de coste; la política de prueba en sí sigue siendo diseñada por el lado de la aplicación.
Hipótesis de ejemplo: precio unitario de entrada de 2 USD por millón de tokens, precio unitario de salida de 8 USD por millón de tokens, sin uso de herramientas como búsqueda web, descuento de caché contabilizado como 0.
| Paso | Tokens de entrada (hipótesis) | Tokens de salida (hipótesis) | Coste por vez (USD) |
|---|---|---|---|
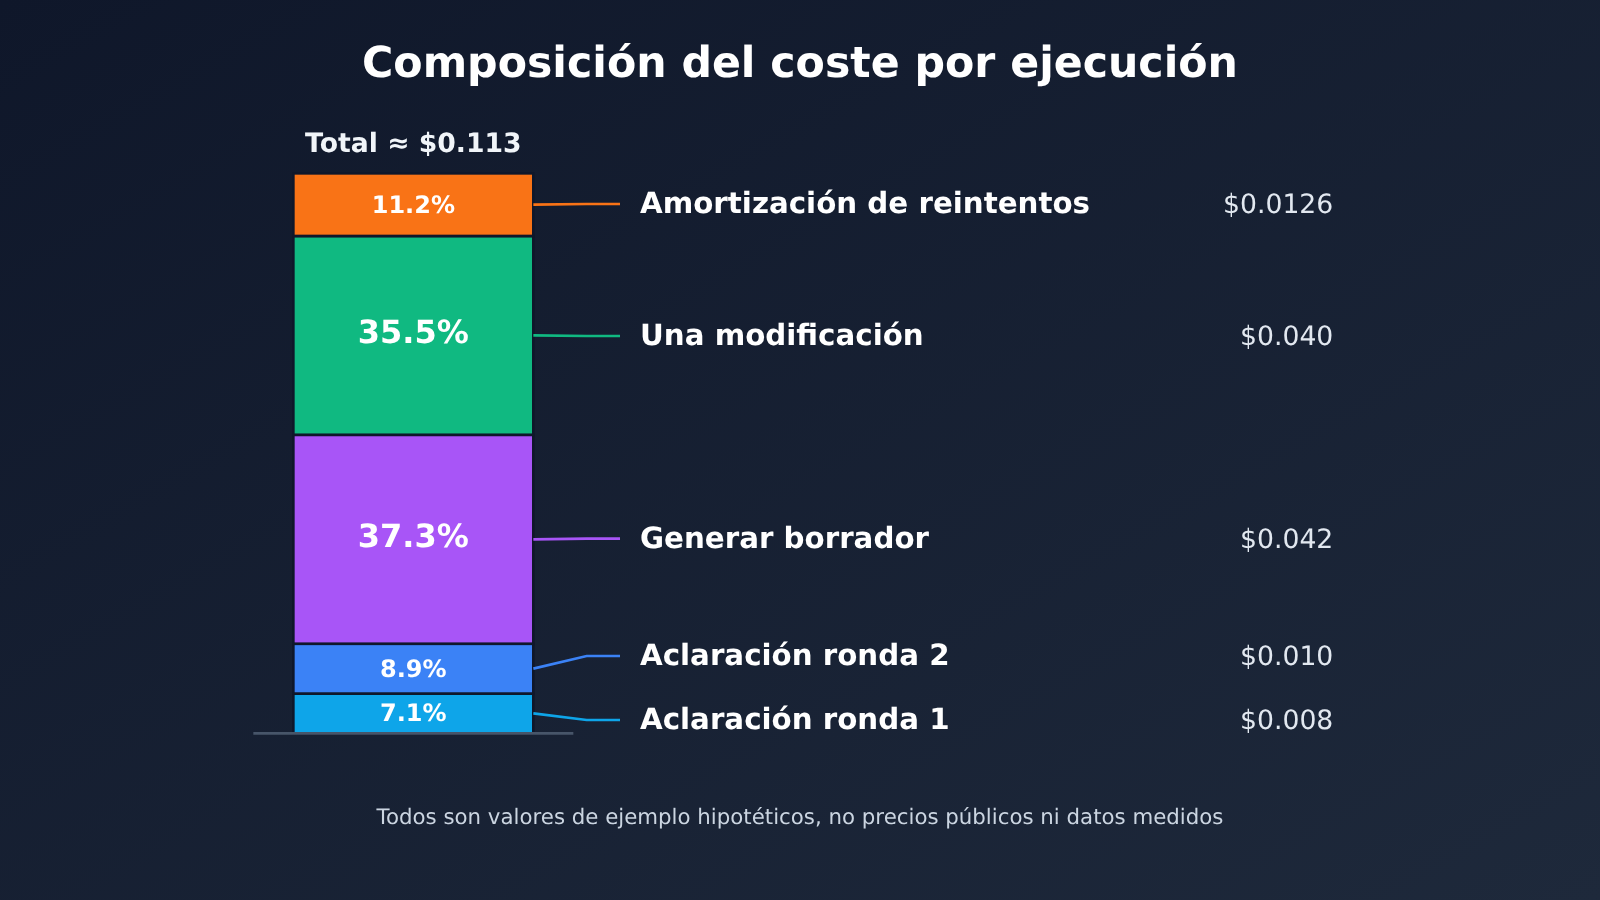
| Ronda 1 de diálogo de aclaración | 2,000 | 500 | 0.008 |
| Ronda 2 de diálogo de aclaración | 3,000 | 500 | 0.010 |
| Generación del borrador | 5,000 | 4,000 | 0.042 |
| Una modificación | 10,000 | 2,500 | 0.040 |
| Subtotal | 20,000 | 7,500 | 0.100 |
| Reintento (suponiendo que el 30% de los usuarios regenera el borrador una vez) | — | — | 0.0126 |
| Coste de una finalización | — | — | Aprox. 0.113 |
El cálculo es bastante directo: el coste de cada paso equivale a los tokens de entrada multiplicados por el precio unitario de entrada, más los tokens de salida multiplicados por el precio unitario de salida. La entrada del paso de modificación es claramente mayor porque debe arrastrar toda la conversación anterior y el borrador completo; esta es una característica habitual del coste en tareas de múltiples turnos. En el reintento solo se contabiliza el paso de generación de borrador, que es el más frecuente, prorrateando 0.042 USD multiplicado por 30%.
3.2 Del costo por tarea completada al presupuesto por cuenta y total
Una vez que tenemos el costo por tarea completada, toca decidir cuántas tareas permitimos que complete cada cuenta de prueba. En el ejemplo lo fijamos en 3: la primera sirve para probar, y las dos siguientes para que el usuario lo use en sus propios proyectos reales. Ese número también es un valor supuesto, y depende de cuántas veces suelen necesitar tus usuarios para formarse una opinión.
| Rubro de presupuesto | Forma de cálculo | Resultado de ejemplo (supuesto) |
|---|---|---|
| Costo por tarea completada | De las estadísticas de muestra del 3.1 | Aprox. 0.113 USD |
| Tareas de prueba por cuenta | Definido por el producto según los hábitos de decisión de los usuarios | 3 |
| Límite de costo por cuenta | Costo por tarea completada × número de tareas | Aprox. 0.34 USD |
| Cuentas de prueba nuevas mensuales estimadas | Del plan de adquisición de usuarios | 5,000 |
| Límite de presupuesto mensual | Límite de costo por cuenta × número de cuentas | Aprox. 1,690 USD |
Lo que calculamos aquí es el límite superior para cuando todos los usuarios agotan su cuota. El gasto real suele quedar por debajo, porque no pocos usuarios se van tras usarlo una o dos veces, o directamente pagan. El equipo de producto puede fijar un presupuesto global sobre la base de este límite; si el gasto real se dispara claramente por encima de lo esperado, significa que hay un uso anómalo o que algo falla en el criterio de la muestra, y toca volver a 3.1 para revisarlo.
3.3 Plantilla de presupuesto de cuota de prueba gratuita que puedes completar
Combina los pasos anteriores en una plantilla en blanco para que el equipo pueda rellenarla directamente con sus propios datos:
| Campo a completar | Tus datos | Fuente de los datos |
|---|---|---|
| Nombre de la tarea mínima completa | Definición de tarea de la sección 2 | |
| Tokens de entrada promedio por paso | Registros reales de invocación | |
| Tokens de salida promedio por paso | Registros reales de invocación | |
| Precio unitario de entrada y salida | Página de precios públicos del modelo utilizado | |
| Costes de caché o herramientas aplicables | Factura o documentación de precios | |
| Proporción habitual de reintentos y pasos implicados | Datos de telemetría | |
| Coste de completar una tarea | Suma de los elementos anteriores | |
| Número de tareas de prueba por cuenta | Decisión de producto | |
| Número estimado de cuentas de prueba | Plan de adquisición de clientes | |
| Límite máximo del presupuesto total y forma de actuar si se supera | Decisión conjunta de producto y finanzas |
Una vez completada, la cuota que se muestra al exterior debe expresarse en «número de tareas», no en tokens ni créditos; por ejemplo, «durante el periodo de prueba se pueden generar 3 borradores de PRD». Así, el usuario entiende directamente para cuántas cosas le sirve la cuota, y el equipo de producto hace internamente el cálculo con el límite de coste.
4. Un aviso claro para cuando se agotan los créditos de prueba gratuita
El momento en que se acaban los créditos es clave: es cuando el usuario decide si va a pagar o no. Si el aviso es ambiguo, puede pensar que el producto falló; si es brusco, sentirá que la experiencia anterior solo era un anzuelo. Un aviso que cumpla su función debería incluir tres tipos de información:
- Lo que ya has conseguido: por ejemplo, «Has completado 3 borradores de PRD, todos guardados en el proyecto», para que el usuario confirme que lo obtenido durante la prueba sigue disponible.
- Lo que ahora no puedes hacer: deja claro qué operación requiere créditos, para evitar que el usuario se tope con el bloqueo a mitad de la operación.
- Qué opciones tienes para continuar: seguir usando las funciones básicas del plan gratuito, activar un plan de pago o contactar al equipo para conocer la solución empresarial.
Hay otro detalle que vale la pena diseñar desde el principio: intenta que los créditos no se agoten a mitad de una tarea. Puedes comprobar, antes de empezar una tarea nueva, si los créditos restantes alcanzan para completarla; si no alcanzan, avisa antes de que empiece. Así el usuario siente que «ya ha terminado varias cosas», en lugar de «me interrumpieron a mitad de camino».
4.1 Revisar los créditos de prueba gratuita: ¿cambiar la experiencia o ajustar los créditos?
Después de lanzar la prueba, usa tres indicadores para detectar dónde está el problema:
- Tasa de finalización de la primera tarea válida: proporción de usuarios de la prueba que completan al menos una tarea de principio a fin según el criterio de 2.1; refleja si la experiencia de prueba fluye con facilidad.
- Costo por usuario que completa: costo total de la prueba dividido entre quienes completan; refleja cuánto subsidio se dedica a cada usuario que «percibe valor».
- Conversión a pago: proporción de quienes completan que acaban pagando; refleja si el valor basta para respaldar la decisión de compra.
Solo mirando los tres indicadores en conjunto puedes decidir qué conviene ajustar:
| Datos observados | Posible causa | Hacia dónde ajustar |
|---|---|---|
| Tasa de finalización baja y costo por usuario que completa alto | Los usuarios se atascan a mitad de la tarea y el subsidio se gasta en quienes no la completan | Cambiar la experiencia: simplificar pasos, mejorar la guía y revisar si los límites de las funciones dejan fuera alguna capacidad necesaria |
| Tasa de finalización baja y muchos usuarios agotan los créditos a mitad de la tarea | Se subestimó el costo por tarea y los créditos no alcanzan para completar una sola cosa | Cambiar los créditos: recalcular el costo por finalización con una muestra nueva o reducir el alcance de la tarea |
| Tasa de finalización alta y conversión a pago baja | La tarea se completa, pero el valor no basta para pagar, o hay demasiados créditos y el usuario no necesita pasar a un plan superior | Primero revisa el valor de la tarea; luego considera reducir el número de tareas |
| Tasa de finalización alta, conversión normal y costo por usuario que completa en aumento constante | Hay más reintentos o las entradas son más largas | Vuelve a 3.1 para investigar las causas de los reintentos y la longitud del contexto |
Para juzgar, te sugiero este orden: primero la tasa de finalización, luego el costo y al final la conversión. Cuando la tasa de finalización no alcanza el objetivo, ajustar los créditos normalmente no sirve de nada: si el usuario no termina ni una sola cosa, darle más créditos solo amplifica el desperdicio. Cuando la tasa de finalización se estabilice, usa el costo y la conversión para afinar el número de tareas y el presupuesto total; después vuelve a la sección 2 para revisar si la definición de la tarea necesita actualizarse.
Cuando este método esté implementado, deberías poder responder una pregunta concreta: cuánto le cuesta al producto cada usuario de prueba adicional que realmente percibe valor, y cuánto ingreso por pagos genera ese dinero. Si logras calcular esta cuenta, los créditos de prueba gratuita dejan de ser un gasto difícil de controlar y se convierten en un eslabón de adquisición de clientes que puedes optimizar de forma continua.
Un viaje de mil millas comienza con un solo paso. — Laozi
Referencias
-
Artículo de retrospectiva de Claire Vo, fundadora de ChatPRD: sobre cómo el fraude de tokens está erosionando los márgenes de IA y cómo combatirlo
- Enlace:
chatprd.ai/how-i-ai/token-fraud-is-eating-ai-margins-here-s-how-claire-vo-is-fighting-it - Descripción: Fuente de los hechos del caso de la sección 1 de este artículo.
- Enlace:
-
Página de precios de ChatPRD: información sobre el plan gratuito vigente y la prueba de 14 días de Pro y Teams
- Enlace:
chatprd.ai/pricing - Descripción: Se usa para confirmar la política de prueba vigente del producto.
- Enlace:
-
Documentación de precios de modelos de APIYI: precios públicos de cada modelo
- Enlace:
docs.apiyi.com/models - Descripción: Se puede usar para consultar el precio unitario y completar la tabla de presupuesto 3.3.
- Enlace:
-
Documentación de consulta de logs de invocación de APIYI: registros de invocaciones y consulta de uso
- Enlace:
docs.apiyi.com/api-capabilities/log-query - Descripción: Se puede usar para contabilizar los tokens de entrada y salida, y los reintentos, en muestras reales.
- Enlace:


