
Nota del autor: este artículo enumera por separado el límite oficial de velocidad, el precio de promoción y el precio de lista de GPT-6.2 Sol Ultrafast, y presenta un método para calcular la prima por velocidad que puedes aplicar a tus propias tareas.
Activar Ultrafast para GPT-6.2 Sol depende de cuánta espera puede ahorrar esta tarea concreta. La velocidad que indica la documentación oficial es hasta 4,5 veces la del modo estándar del mismo modelo; el precio durante la promoción es 3 veces el precio estándar, y el precio de lista a partir de marzo de 2027 es 6 veces. La velocidad es un límite superior; el precio es una cifra concreta. No tienen el mismo grado de certeza, así que no se pueden dividir directamente.
Este artículo no responde por ti a la pregunta “¿vale la pena comprarlo?”. No sacamos nuestras propias conclusiones a partir de pruebas de velocidad ni tomamos un registro anecdótico sin grupo de control como resultado definitivo. Este artículo solo ofrece un método: primero mide el tiempo que tarda tu propia tarea en el modo estándar, luego usa el multiplicador “máximo” oficial para calcular el límite superior de tiempo que puedes ahorrar y, por último, compáralo con la diferencia de precio.
Valor central: al terminar de leer, podrás calcular, para cualquier tarea, “cuánto más pagas por cada minuto ahorrado” y luego decidir según la tarea si activas el modo de velocidad.
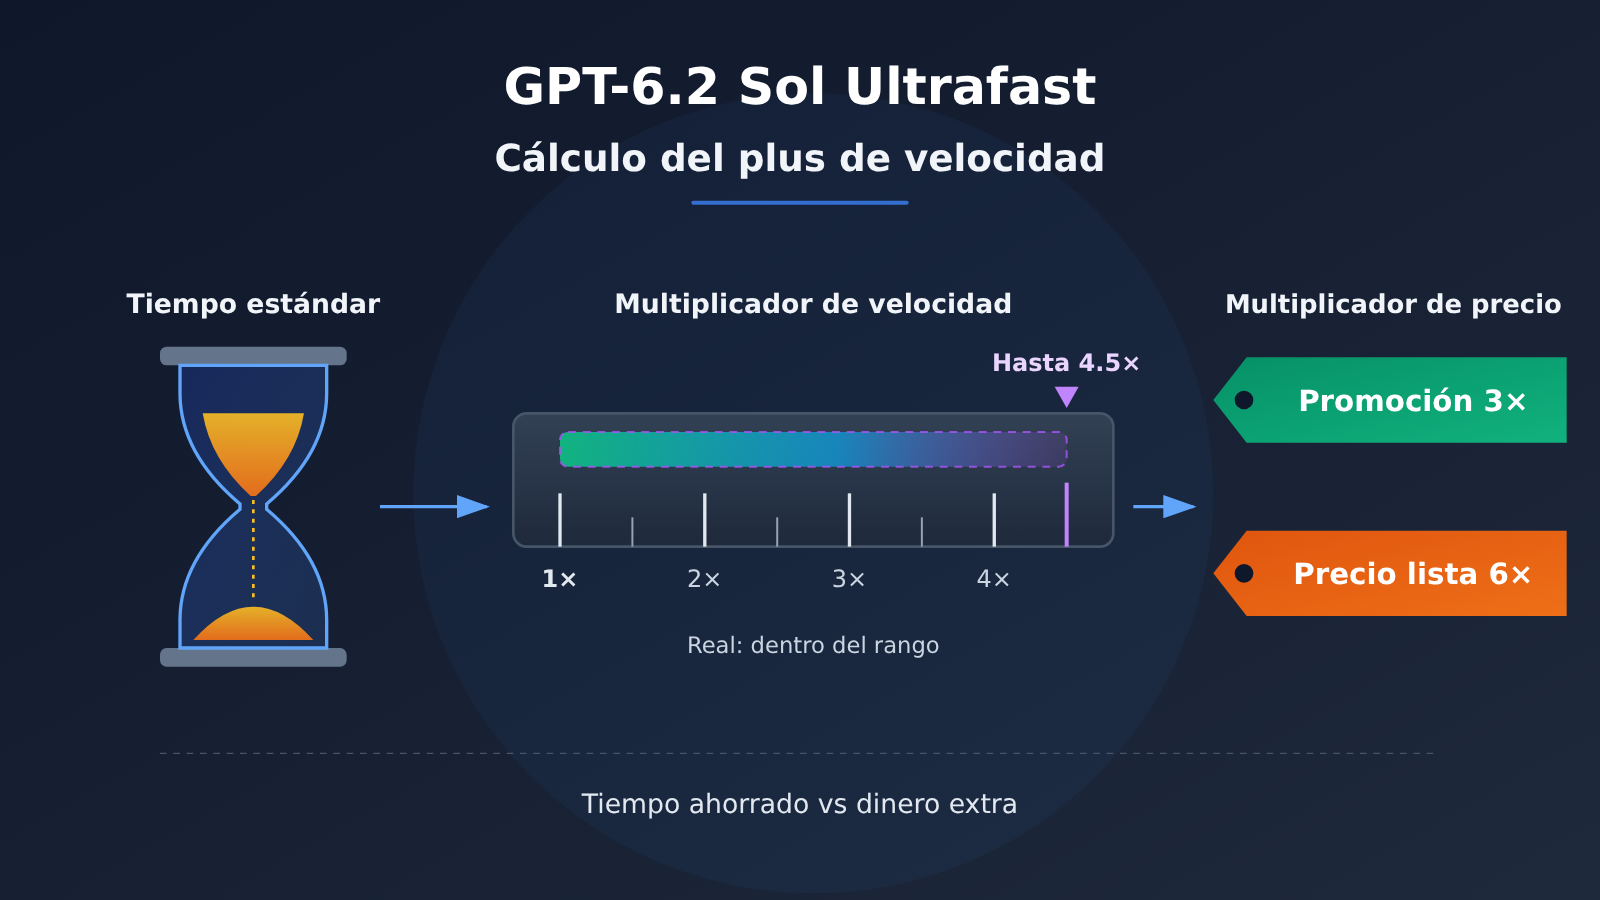
La diferencia clave en el sobreprecio de velocidad de GPT-6.2 Sol Ultrafast
Primero hay que aclarar un concepto: Ultrafast es un nivel de servicio, no otro modelo. Según la documentación oficial de la API, el model de la solicitud sigue siendo gpt-6.2-sol; solo hay que añadir service_tier y configurarlo como ultrafast. Actualmente, los modelos que admiten este nivel de servicio son GPT-6.2 Astra, GPT-6.2 Sol, GPT-6 Astra y GPT-6.1 Sol.
Por lo tanto, lo que estás comparando son dos velocidades de entrega del mismo modelo, no la diferencia de capacidades entre dos modelos. La cuestión de la calidad de salida puede quedar de lado: aquí solo quedan dos variables, tiempo y precio.
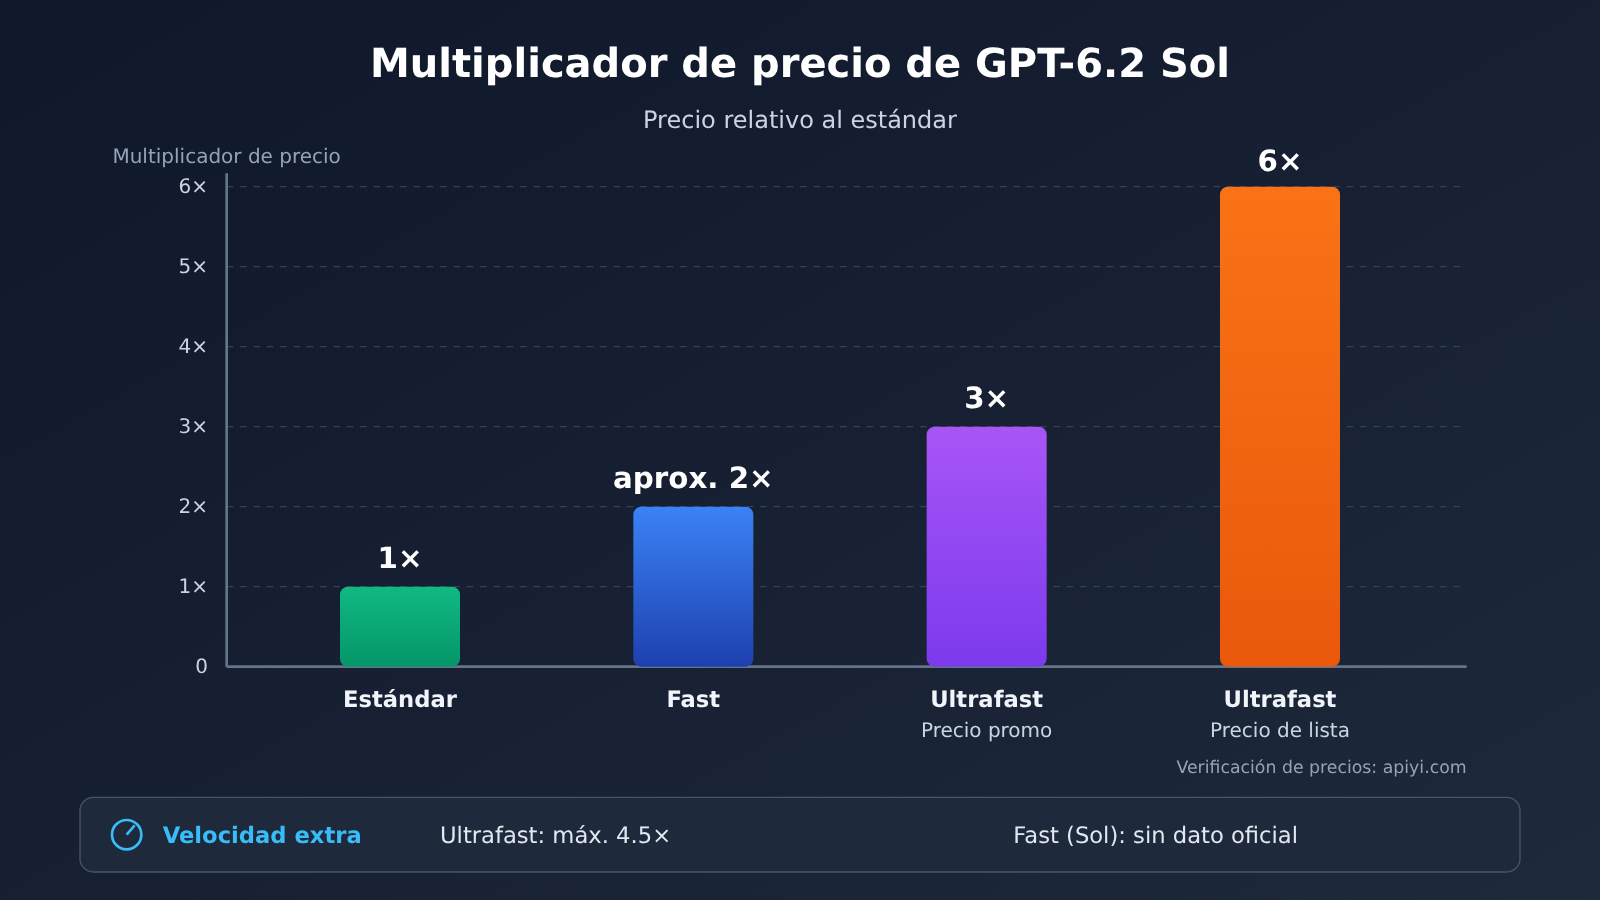
| Nivel (gpt-6.2-sol, contexto corto) | Entrada | Lectura de caché | Salida | Precio relativo al estándar | Velocidad según documentación oficial |
|---|---|---|---|---|---|
| Estándar | 2 | 0.10 | 10 | 1× | Referencia |
| Fast | 4 | 0.20 | 20 | aprox. 2× | La documentación no indica un múltiplo de velocidad para Sol |
| Ultrafast promocional (hasta 2027-02-28, hora del Pacífico) | 6 | 0.30 | 30 | 3× | Hasta 4.5× |
| Ultrafast tarifa de lista (a partir de 2027-03-01) | 12 | 0.60 | 60 | 6× | Hasta 4.5× |
Los precios de la tabla están en USD por millón de tokens; contexto corto significa una entrada de no más de 272 mil tokens. Cabe advertir por separado sobre el nivel Fast: el “aprox. 1.5× de velocidad” que aparece en la documentación oficial corresponde a GPT-6.2 Astra y GPT-5.6, no está indicado para GPT-6.2 Sol, así que no se puede aplicar ese múltiplo al nivel Fast de Sol.
Precio de contexto largo de GPT-6.2 Sol Ultrafast
Si la entrada supera los 272 000 tokens, se aplica la tarifa de contexto largo. En el nivel estándar oficial, el precio de contexto largo es entrada 4, lectura de caché 0.20, salida 15. El precio promocional de Ultrafast es 12 / 0.60 / 45, y el precio de lista es 24 / 1.20 / 90; sigue siendo 3 veces y 6 veces el precio estándar.
| Concepto de tarifa (contexto largo, USD/millón de tokens) | Entrada | Lectura de caché | Salida |
|---|---|---|---|
| Nivel estándar oficial | 4 | 0.20 | 15 |
| Ultrafast promocional | 12 | 0.60 | 45 |
| Ultrafast precio de lista | 24 | 1.20 | 90 |
Tabla general de APIYI gpt-6.2-sol (entrada superior a 272 000) |
3 | Según la lista de la plataforma | Según la lista de la plataforma |
Hay una inconsistencia numérica que conviene aclarar por separado: la tabla general de modelos de APIYI apiyi.com establece el tramo en 2 USD para entradas de 0 a 272 000 tokens, y en 3 USD para entradas superiores a 272 000, mientras que el precio de entrada de contexto largo en el nivel estándar oficial es 4 USD. No hay que mezclar estas dos cifras: al llamar a través de APIYI se calcula según los 3 USD de la tabla general, y al conectar directamente con el oficial se calcula según los 4 USD.
De dónde viene la velocidad de GPT-6.2 Sol Ultrafast: límite oficial y registros de la comunidad
En lo que respecta a la velocidad, ahora mismo hay dos tipos de información con niveles de fiabilidad muy distintos. Conviene tratarlos por separado.
| Fuente | Contenido | Naturaleza | ¿Se puede usar como tu multiplicador? |
|---|---|---|---|
| Documentación oficial de Codex / API | La velocidad de generación de Ultrafast llega hasta 4.5 veces la del nivel estándar del mismo modelo (up to 4.5 times) | Afirmación de límite oficial | Solo como límite superior |
| Artificial Analysis | El nivel estándar del mismo modelo ronda los 85 tokens de salida/segundo | Benchmark público de terceros | Solo como referencia |
| Transcripción de OrcaRouter (2026-11-18) | En una tarea, un promedio de unos 126 tokens/segundo y un pico de unos 252 | Transcripción de una sola ejecución, sin comparación con el nivel estándar | No |
El texto oficial usa “up to”, que significa que como máximo puede llegar a esa cifra, pero no promete que cada solicitud alcance 4.5 veces. A la hora de hacer estimaciones, conviene colocarlo en el apartado de “mejor caso”.
OrcaRouter, en una transcripción del 2026-11-18, recogió una tarea puntual de un editor de video en X: Ultrafast promedió unos 126 tokens por segundo, con picos de unos 252; el tiempo total de la tarea fue de unos 27 minutos, de los cuales la respuesta del modelo ocupó unos 14 minutos. El autor de la transcripción comparó esta cifra con los 85 tokens/segundo del nivel estándar que publica Artificial Analysis y concluyó que era unas 1.5 veces más rápido. Este registro corresponde a una sola ejecución, sin repeticiones y sin una comparación con el nivel estándar en la misma tarea, así que solo sirve como un punto de datos y no representa el rendimiento final de este nivel de velocidad.
Este registro también deja ver un hecho que se suele pasar por alto: de los 27 minutos de tiempo total, la respuesta del modelo solo ocupa unos 14 minutos. El nivel de velocidad solo acelera la parte de generación del modelo; las llamadas a herramientas, la lectura y escritura de archivos, la confirmación manual y otras etapas no se vuelven más rápidas por ello.
Cómo calcular la prima de velocidad de GPT-6.2 Sol Ultrafast: un algoritmo que puedes aplicar tal cual
Este algoritmo evita a propósito cualquier «multiplicador medido por terceros». El único dato que necesitas aportar tú es el tiempo que tarda esta tarea en el modo estándar.
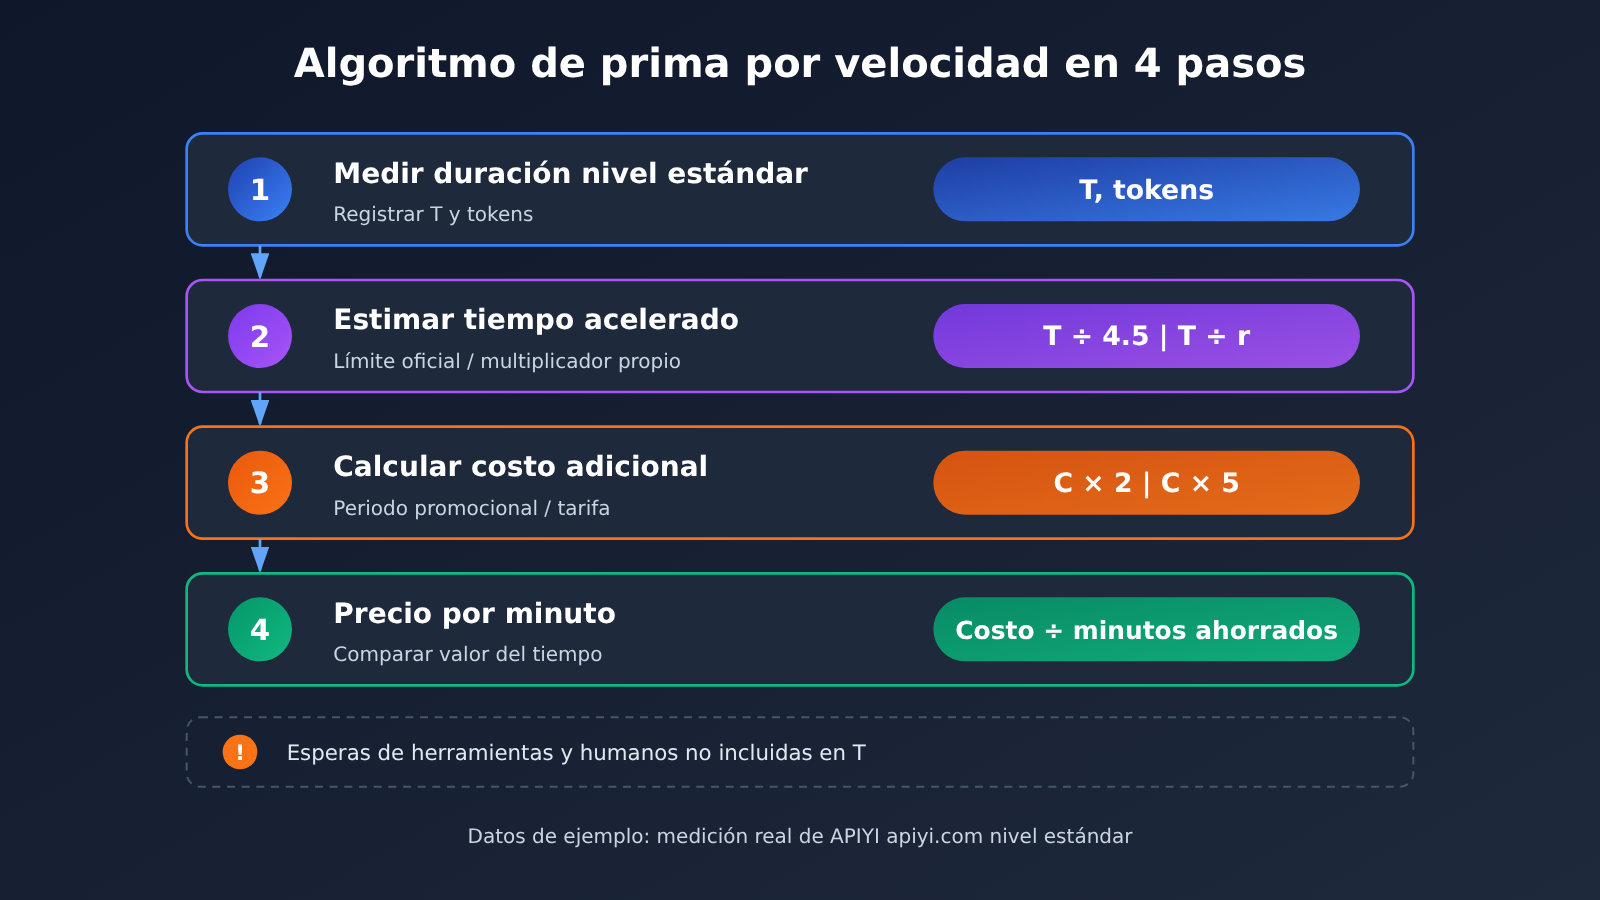
| Paso | Elemento de cálculo | Fórmula | Explicación |
|---|---|---|---|
| ① | Tiempo de generación T en modo estándar | Medido por ti | Solo cuenta la generación del modelo, no el tiempo de herramientas |
| ② | Tiempo ahorrado en el mejor caso | T × (1 − 1/4.5) ≈ 0.78T | Usa el límite oficial |
| ②′ | Tiempo ahorrado en el caso conservador | T × (1 − 1/r) | r es el multiplicador que definas, con r ≤ 4.5 |
| ③ | Costo C en modo estándar | entrada × precio unitario + lectura de caché × precio unitario + salida × precio unitario | Elige el nivel de precio según la longitud del contexto |
| ④ | Costo adicional en promoción | C × 2 | El precio promocional de Ultrafast es 3C |
| ④′ | Costo adicional con tarifa de lista | C × 5 | El precio de lista de Ultrafast es 6C |
| ⑤ | Precio por cada minuto ahorrado | costo adicional ÷ minutos ahorrados | Compáralo con el valor de tu tiempo |
Cálculo de ejemplo de GPT-6.2 Sol Ultrafast
A continuación, usamos un conjunto de cifras hipotéticas para mostrar el algoritmo; estas cifras no son resultados de pruebas de velocidad. Supongamos que una tarea tiene una entrada de 200 000 tokens (contexto corto) y una salida de 50 000 tokens, sin aciertos de caché; la velocidad de salida que obtuviste con el nivel estándar es de 80 tokens/segundo.
- Costo en el nivel estándar C = 0.2 × 2 + 0.05 × 10 = 0.9 dólares.
- Tiempo de generación en el nivel estándar T = 50000 ÷ 80 ≈ 625 segundos, aproximadamente 10.4 minutos.
- El precio promocional de Ultrafast es 2.7 dólares, con un costo adicional de 1.8 dólares; el precio de lista es 5.4 dólares, con un costo adicional de 4.5 dólares.
| Multiplicador supuesto r | Tiempo de generación | Tiempo ahorrado | Precio por minuto en promoción | Precio por minuto a tarifa de lista |
|---|---|---|---|---|
| 4.5 (límite oficial) | Aprox. 2.3 minutos | Aprox. 8.1 minutos | Aprox. 0.22 dólares | Aprox. 0.56 dólares |
| 3 | Aprox. 3.5 minutos | Aprox. 6.9 minutos | Aprox. 0.26 dólares | Aprox. 0.65 dólares |
| 2 | Aprox. 5.2 minutos | Aprox. 5.2 minutos | Aprox. 0.35 dólares | Aprox. 0.87 dólares |
| 1.5 | Aprox. 6.9 minutos | Aprox. 3.5 minutos | Aprox. 0.51 dólares | Aprox. 1.29 dólares |
Esta tabla permite observar dos cosas. Primero, cuando el multiplicador baja de 4.5 a 1.5, el precio por minuto aproximadamente se duplica, así que el multiplicador supuesto es más decisivo que el precio en sí. Segundo, cuando entre en vigor el precio de lista en marzo de 2027, ahorrar el mismo minuto costará aproximadamente 2.5 veces más; por lo tanto, las conclusiones del periodo promocional no se pueden trasladar directamente al año que viene.
💰 Sugerencia para verificar costos: Los precios unitarios del nivel estándar usados en el ejemplo se pueden comparar directamente con los precios de lista de
gpt-6.2-solen la tabla general de APIYI apiyi.com (entrada 2, lectura de caché 0.1, salida 10). Esta combinación de precios coincide con la del nivel estándar oficial para contexto corto y sirve como fuente del valor C en el algoritmo.
Mide con código el tiempo de ejecución de tu GPT-6.2 Sol en el tier estándar
El primer paso del algoritmo necesita la T real. El siguiente bloque de código usa la salida en streaming para registrar el tiempo hasta el primer token y el tiempo total de generación, y lee el número de tokens del campo usage para calcular la velocidad de este tipo de tareas en el tier estándar.
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI, punto de acceso compatible con OpenAI
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "把你的真实任务提示词放在这里"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"首 token {first - start:.1f}s,生成 {gen:.1f}s,"
      f"输出 {usage.completion_tokens} tokens,约 {usage.completion_tokens / gen:.0f} tok/s")
Ver el script completo de comparación con service_tier
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # USD por millón de tokens, contexto corto
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # Enfoque oficial: al mismo ID de modelo se le añade service_tier
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "把你的真实任务提示词放在这里"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"标准档:生成 {t_std:.1f}s,费用约 ${c_std:.3f},返回档位 {s_std}")

for name, r in [("官方上限", 4.5), ("保守假设", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:省 {saved_min:.1f} 分钟,"
          f"促销每分钟 ${c_std * 2 / saved_min:.3f},刊例每分钟 ${c_std * 5 / saved_min:.3f}")

# Si quieres medir el tier de velocidad, descomenta las líneas de abajo y comprueba
# si el campo service_tier devuelto es ultrafast
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度档:生成 {t_uf:.1f}s,实际倍数约 {t_std / t_uf:.2f},返回档位 {s_uf}")
Sobre service_tier hay que aclarar algo: la tabla general de modelos de APIYI apiyi.com solo incluye gpt-6.2-sol; no hay un modelo ultrafast independiente ni aparece el campo service_tier, y el precio que figura en la lista corresponde al nivel estándar. En este artículo solo revisé la documentación y la lista de precios; no envié solicitudes reales, así que no puedo afirmar cómo se comporta este parámetro al invocar mediante https://api.apiyi.com/v1. Si necesitas el nivel de velocidad, guíate por el campo de nivel que devuelve la respuesta y por la facturación; el modelo y el precio son los que figuran en la lista de modelos de la plataforma.
🚀 Consejo para empezar: primero ejecuta dos o tres veces tus tareas reales con el nivel estándar
gpt-6.2-solde APIYI apiyi.com y toma la mediana del tiempo de generación como T. Este paso solo cuesta el precio estándar, pero determina la precisión de todos los cálculos posteriores.
Recomendaciones de escenarios para GPT-6.2 Sol Ultrafast
La conclusión depende de la tarea. Una misma persona puede llegar a respuestas opuestas según la tarea de que se trate.
Situaciones en las que conviene activar Ultrafast
- Tareas interactivas en las que alguien espera frente a la pantalla: por ejemplo, programación en pareja en tiempo real o demostraciones en vivo. El tiempo de espera es directamente costo de personal; según la fórmula anterior, el precio unitario normalmente cubre ese costo.
- Tareas en las que la generación ocupa una proporción alta del tiempo total transcurrido: si T representa la mayor parte de la duración total de la tarea, el tiempo ahorrado se refleja directamente en el plazo de entrega.
- Tareas de contexto corto durante el periodo de promoción: con un precio 3 veces mayor y el bajo precio unitario de un contexto corto, el importe absoluto del gasto adicional es menor.
Situaciones en las que conviene quedarse en el nivel estándar
- Procesamiento por lotes en segundo plano y tareas nocturnas: no hay nadie esperando, así que los minutos ahorrados no tienen un valor de tiempo asociado.
- Tareas de Agent con muchas llamadas a herramientas: como en el registro citado antes, de 27 minutos de tiempo total la respuesta del modelo solo ocupa unos 14 minutos; el nivel de velocidad solo puede recortar una parte.
- Tareas de contexto largo y salida grande: en la tarifa de lista, el precio unitario de salida con contexto largo llega a 90, y el gasto adicional crece muy rápido.
| Característica de la tarea | Proporción del tiempo de generación | ¿Hay alguien esperando? | Tendencia |
|---|---|---|---|
| Codificación interactiva, demostraciones en vivo | Alta | Sí | Calcular primero con la fórmula; el precio unitario normalmente puede cubrirlo |
| Agent intensivo en herramientas | Media-baja | Depende | Calcular solo la parte de generación; el beneficio se diluye |
| Procesamiento por lotes nocturno | Alta | No | Quedarse en el nivel estándar |
| Contexto largo y salida grande | Alta | Depende | En la tarifa de lista hay que calcular con cuidado |
💡 Consejo de elección: si en un mismo proyecto hay tareas de ambos tipos, puedes decidir en el código si incluir
service_tiersegún el tipo de tarea, sin necesidad de activarlo de forma global. Con APIYI apiyi.com, usa la misma clave API para ejecutar una línea base en el nivel estándar y después decide qué tipo de tareas merece la pena probar más a fondo con el nivel de velocidad.
Recomendaciones de decisión para GPT-6.2 Sol Ultrafast
Convierte lo anterior en un proceso fijo:
- Ejecuta tareas reales con el nivel estándar, anota el tiempo de generación T y el consumo de tokens; no uses cifras de velocidad de otros.
- Calcula el mejor caso usando el límite oficial de 4.5, luego elige un multiplicador conservador r que consideres razonable y calcula ambos escenarios.
- Calcula el gasto adicional según el precio promocional (3 veces) y el precio de tarifa (6 veces), y obtén dos «precios por minuto».
- Compáralo con el valor de tu tiempo: solo las tareas que siguen siendo rentables con el multiplicador conservador merecen activarse.
- Antes de que entre en vigor el precio de tarifa el 2027-03-01, recalcula todo con los nuevos precios.
La clave de este proceso es el paso 2. El «hasta 4.5 veces» oficial puede servir como límite superior, mientras que ese dato de aproximadamente 126 tokens/segundo del 2026-11-18 es solo un punto de datos aislado; ninguno de los dos es el multiplicador real de tu tarea. El multiplicador real solo se puede obtener mediante pruebas comparativas sobre tus propias tareas.
Preguntas frecuentes (FAQ)
Q1: ¿GPT-6.2 Sol Ultrafast es un modelo nuevo?
No. Según la documentación oficial de la API, Ultrafast es un nivel de servicio; el `model` de la solicitud sigue siendo `gpt-6.2-sol`, solo se añade `service_tier` configurado como `ultrafast`. El modelo en sí no cambia.
Q2: ¿Activar Ultrafast garantiza alcanzar 4.5 veces?
No necesariamente. El texto oficial dice «up to 4.5 times», que es una expresión de límite superior. Al calcular, conviene preparar también un multiplicador conservador más bajo y guiarse por tus propias pruebas comparativas.
Q3: ¿Cuándo termina el precio promocional de GPT-6.2 Sol Ultrafast?
El precio promocional oficial se mantiene hasta el 2027-02-28 (hora del Pacífico), a 3 veces el precio estándar; a partir del 2027-03-01 se aplica el precio de tarifa, 6 veces el precio estándar. Tanto el contexto corto como el contexto largo siguen esta relación de multiplicadores.
Q4: ¿Se puede tomar como referencia ese registro de aproximadamente 126 tokens/segundo?
Puede servir como un punto de datos, pero no como conclusión. Es una tarea reportada por OrcaRouter el 2026-11-18, sin ejecuciones repetidas ni una comparación con el nivel estándar en la misma tarea; la mención de aproximadamente 1.5 veces en el texto surge de compararlo con los 85 tokens/segundo del nivel estándar publicados por Artificial Analysis.
Q5: ¿A qué nivel corresponde el precio de gpt-6.2-sol que se ve en APIYI?
Es el nivel estándar. En la tabla general de APIYI apiyi.com, el precio de `gpt-6.2-sol` es 2 para entrada, 0.1 para lectura de caché y 10 para salida, lo que coincide con el nivel estándar oficial de contexto corto; admite los endpoints responses y chat. En la tabla general no aparece un modelo ultrafast aparte ni se indica `service_tier`.
Q6: Cuando se superan 272 000 tokens de entrada, ¿cómo se calcula en el nivel estándar?
Las cifras de las dos fuentes difieren, así que hay que calcularlas por separado: la tabla general de APIYI indica 3 USD para entradas superiores a 272 000 tokens, mientras que el nivel estándar oficial de contexto largo cobra 4 USD por la entrada. Al llamar a través de https://api.apiyi.com/v1 se calcula según la lista de modelos de la plataforma; en conexión directa con el oficial, se calcula a 4 USD.
Puntos clave de la prima de velocidad de GPT-6.2 Sol Ultrafast
- Ultrafast es un nivel de servicio: basta con el mismo ID de modelo
gpt-6.2-solmásservice_tier; la capacidad del modelo no cambia. - 4.5x es el límite oficial: el texto original dice “up to” (hasta), así que al calcular no debes tomarlo como un multiplicador que se alcanza siempre.
- El precio se divide en dos tramos: durante la promoción es 3 veces el precio estándar; a partir del 2027-03-01, el precio de lista es 6 veces.
- Solo el tiempo de generación se acelera: los tiempos que no son de generación, como las llamadas a herramientas, no entran en la parte que se puede ahorrar.
- Un único reporte aislado no representa el resultado: el registro de aproximadamente 126 tokens/s del 2026-11-18 no tiene comparación con el nivel estándar.
- Primero mide tu propio nivel estándar: puedes usar el nivel estándar
gpt-6.2-solde APIYI apiyi.com para medir T y luego introducirlo en el algoritmo.
Resumen
El cálculo de la prima de velocidad de GPT-6.2 Sol Ultrafast se puede resumir en tres puntos:
- La velocidad se toma con dos valores: el límite superior y uno conservador. El máximo oficial de 4.5x se coloca en el mejor de los casos; el multiplicador conservador que definas, en otra columna.
- El precio se calcula por separado: en promoción, el gasto adicional es 2 veces la tarifa estándar; en tarifa de lista, es 5 veces. Las dos conclusiones no se deben mezclar.
- La conclusión depende de la tarea: solo si el precio por cada minuto ahorrado es menor que el valor que le das a tu tiempo, vale la pena activar el nivel de velocidad para esa tarea.
La respuesta a la pregunta del título depende de los datos de tu propia tarea. Te sugiero medir primero una línea base con el nivel estándar en APIYI apiyi.com y luego introducir los números en la tabla de cálculo de este artículo.
📚 Referencias
-
Descripción de los niveles de velocidad de OpenAI Codex: la afirmación oficial de hasta 4,5 veces con Ultrafast
- Enlace:
developers.openai.com/codex/agent-configuration/speed - Nota: confirma el texto original de “up to 4.5 times” y los modelos compatibles
- Enlace:
-
Guía de API del modo Ultrafast de OpenAI: uso de
service_tiery modelos compatibles- Enlace:
developers.openai.com/api/docs/guides/ultrafast-mode - Nota: confirma que Ultrafast es un nivel de servicio y que
modelno cambia
- Enlace:
-
Página de precios de la API de OpenAI: precios promocionales y de tarifa de lista para el nivel estándar, Fast y Ultrafast
- Enlace:
developers.openai.com/api/docs/pricing - Nota: precios completos para contexto corto y contexto largo
- Enlace:
-
Registro de paráfrasis de OrcaRouter: datos de una única tarea con Ultrafast del 2026-11-18
- Enlace:
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - Nota: se trata de una paráfrasis de una sola ejecución y sin grupo de control, por lo que solo puede tomarse como un punto de datos
- Enlace:
-
Tabla general de modelos de APIYI: precio de lista y escala del nivel estándar de
gpt-6.2-sol- Enlace:
docs.apiyi.com/models.md - Nota: verifica el precio unitario del nivel estándar y el precio cuando la entrada supera los 272.000 tokens
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: si tienes dudas sobre cálculos o integración, puedes contactarnos a través de la página principal del sitio web oficial de APIYI. Encontrarás más materiales en el centro de documentación docs.apiyi.com.


