
Nota del autor: dos ejemplos calculados a mano para dejar claro cómo se tarifica GPT-6.2 Astra en contexto corto y en contexto largo, además de los multiplicadores de Batch, Fast y Ultrafast.
OpenAI lanzó el 17 de noviembre de 2026 GPT-6.2 Astra y GPT-6.2 Sol, con los IDs de modelo gpt-6.2-astra y gpt-6.2-sol respectivamente. A primera vista, el precio estándar de contexto corto que muestra la página oficial de modelos parece muy directo, pero a la hora de estimar la factura de verdad, el precio estándar de contexto corto no se puede aplicar directamente al contexto largo, a Fast ni a Ultrafast. En cuanto la entrada de una sola solicitud supera los 272K tokens, cambia el precio unitario de toda la solicitud; y si además eliges Fast o Ultrafast, hay que volver a multiplicar por un factor en el tramo de contexto correspondiente.
Esto no es una repetición de la lista de precios, sino un conjunto de reglas que puedes calcular a mano con papel y lápiz: primero se desglosan los tokens en cuatro categorías (entrada, lectura de caché, escritura de caché y salida), después se determina si la solicitud corresponde a contexto corto o largo, y por último se aplican los multiplicadores del nivel de servicio.
Valor clave: al terminar de leer este artículo, podrás estimar por tu cuenta el costo de una sola solicitud y de tareas por lotes con GPT-6.2 Astra, y sabrás qué cifras son precios oficiales y cuáles provienen de evaluaciones de terceros, sin mezclar ambas.
Puntos clave de la tarificación de GPT-6.2 Astra
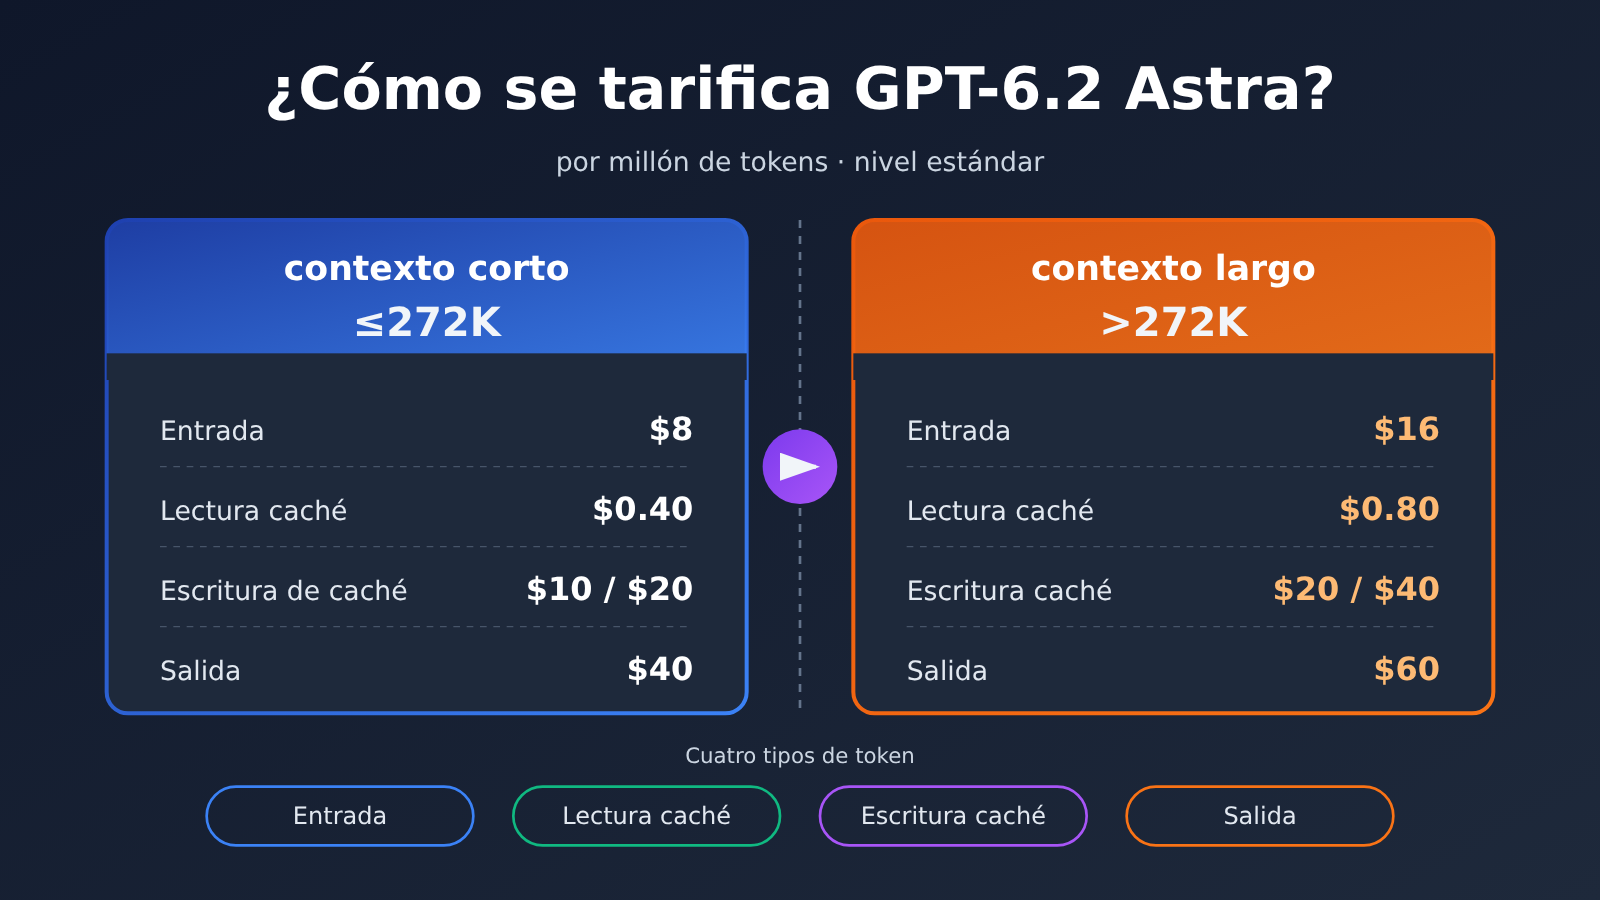
Antes que nada, dejemos claras las reglas. La siguiente tabla se elaboró a partir de la página oficial de modelos de OpenAI (precios declarados por la propia empresa); todas las cifras son por cada 1 millón de tokens, nivel estándar.
| Concepto de facturación | Contexto corto (entrada ≤272K) | Contexto largo (entrada >272K, toda la solicitud) | Notas |
|---|---|---|---|
| Entrada | $8 | $16 | La entrada en contexto largo se duplica |
| Lectura de caché | $0.40 | $0.80 | El precio unitario de caché también se duplica |
| Escritura en caché (retención de 30 minutos) | $10 | $20 | Pertenece a la categoría de caché, se duplica |
| Escritura en caché (retención de 12 horas) | $20 | $40 | Pertenece a la categoría de caché, se duplica |
| Salida | $40 | $60 | La salida se cobra a 1.5 veces la tarifa de contexto corto |
La columna de contexto largo se dedujo del texto original de la página del modelo: cuando la entrada de la solicitud supera los 272K tokens, las tarifas de entrada y de caché se duplican, la salida se cobra a 1.5 veces la tarifa de contexto corto, y todo se calcula sobre la totalidad de la solicitud. Es decir, no se trata de que «solo la parte que excede los 272K se duplique», sino de que todos los tokens de esa solicitud pasan a las tarifas unitarias de la columna de la derecha.
gpt-6.2-astra y gpt-6.2-sol todavía no figuran ni en la tabla general de modelos de APIYI (datos al 2026-11-17 15:54, UTC+8) ni en la interfaz pública de precios: aún no están disponibles y los incorporaremos lo antes posible; el nombre del modelo y los precios están sujetos a la lista de modelos de la plataforma. Antes de hacer la integración formal, conviene confirmar en la lista de modelos de apiyi.com el estado de disponibilidad y los precios reales, y luego aplicar el método de cálculo de este artículo.
Por qué los cuatro tipos de token de GPT-6.2 Astra se calculan por separado
La factura de una solicitud normalmente se compone de cuatro partes. La entrada normal es la parte de la indicación que en esta ocasión no coincidió con la caché ni se escribió en ella; la lectura de caché es la parte que sí coincide con la caché ya existente, con un precio unitario de solo la vigésima parte del de la entrada; la escritura en caché es la parte de la indicación que en esta ocasión se guarda en la caché, con dos niveles según el tiempo de retención: 30 minutos y 12 horas; y la salida es el contenido generado por el modelo. GPT-6.2 Astra admite tokens de razonamiento, y los tokens generados durante el proceso de razonamiento normalmente se contabilizan en el lado de la salida; el desglose exacto debe regirse por el usage que aparece en la factura.
Las diferencias entre los cuatro precios unitarios son enormes: la lectura de caché cuesta $0.40, la entrada $8, la escritura en caché $10 o $20, y la salida $40. Si calculamos todos los tokens al precio de entrada, subestimaremos las tareas intensivas en salida; si ignoramos la escritura en caché, el costo de la primera invocación quedará por debajo de lo real. Por eso, al hacer estimaciones hay que desglosar primero y multiplicar cada parte por separado.
Cómo determinar el umbral de 272K de GPT-6.2 Astra
El criterio de evaluación es el total de tokens de entrada de esta solicitud; la parte que coincide con la caché también cuenta como entrada, y se recomienda atenerse a la documentación oficial y al usage real. La ventana de contexto del modelo es de 1,050,000, la entrada máxima es de 922,000 y la salida máxima de 128,000, por lo que las solicitudes con contexto largo se pueden enviar sin ningún problema; solo hay que pagarlas con otra tabla de precios.
Un método práctico para determinarlo es: suma la indicación del sistema, el historial de conversación, los documentos recuperados y los resultados devueltos por las herramientas; si el total se acerca a 272K, tendrás que decidir por adelantado si comprimir el contexto, dividir la tarea en varias solicitudes o aceptar que toda la solicitud cambie de tarifa.
Cómo aplicar los multiplicadores de niveles de servicio de GPT-6.2 Astra
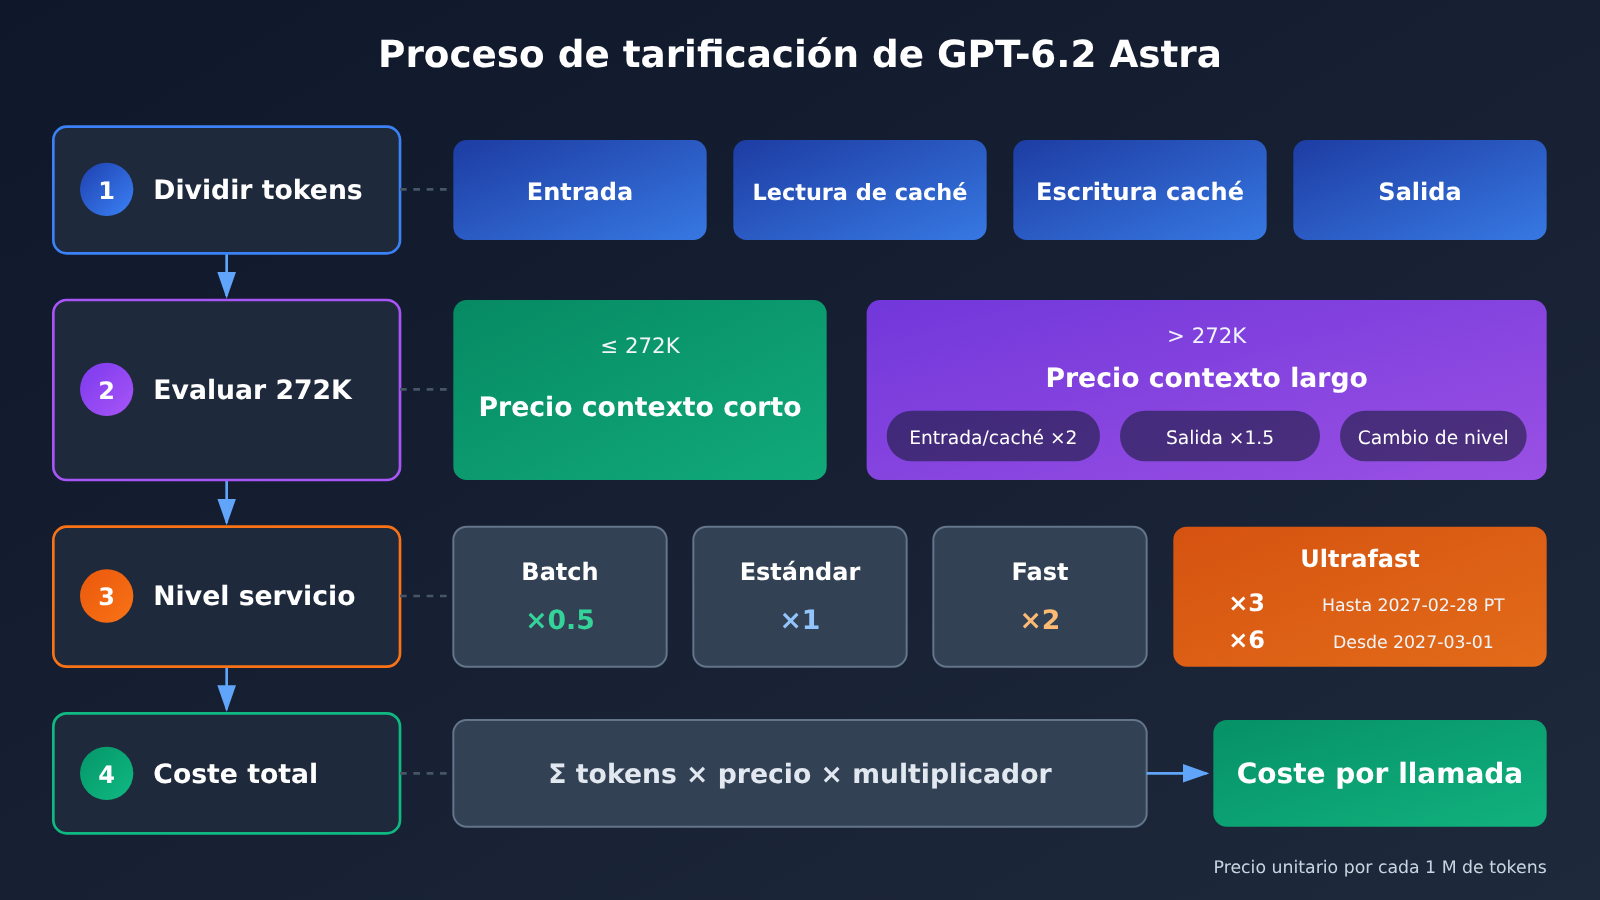
El nivel de longitud de contexto determina el precio unitario base, mientras que el nivel de servicio determina por cuánto se multiplica ese precio base. La siguiente tabla también proviene de la página oficial de modelos.
| Nivel de servicio | Multiplicador | Criterio aplicable | Notas |
|---|---|---|---|
| Batch | 50% del precio estándar | Procesamiento por lotes asíncrono | Ideal para tareas masivas sin prisa |
| Estándar | 1x | Predeterminado | Base de los dos ejemplos de este artículo |
| Fast | 2x | Precio estándar de la misma longitud de contexto | Las solicitudes de contexto largo usan el precio unitario de contexto largo multiplicado por 2 |
| Ultrafast | 3x | Hasta 2027-02-28 (hora del Pacífico) | Tiene fecha límite |
| Ultrafast | 6x | A partir de 2027-03-01 | El presupuesto debe recalcularse con el nuevo multiplicador |
El criterio de Fast está muy claro en la página de modelos: es 2 veces el «precio estándar de la misma longitud de contexto». Así, si activas Fast para una solicitud de contexto largo, la entrada sale $16 × 2 = $32 y la salida $60 × 2 = $120. El multiplicador de Ultrafast se aplica con la misma lógica, pero hay que prestar especial atención al tiempo: si el presupuesto de tu proyecto cubre más allá de marzo de 2027, la parte correspondiente a Ultrafast debe volver a estimarse con el multiplicador de 6x; no puedes seguir usando la cifra de 3x.
Hay además una restricción relacionada indirectamente con los costos: la API no permite establecer el reasoning effort en none. Esto significa que los tokens de razonamiento siempre estarán presentes, así que al estimar el volumen de salida hay que dejar margen para el razonamiento y no calcular únicamente según la longitud de la respuesta final.
Guía rápida de GPT-6.2 Astra: dos ejemplos de cálculo manual
Los dos ejemplos siguientes solo usan multiplicaciones y sumas, y los precios unitarios están expresados «por cada 1 millón de tokens», así que el cálculo de cada línea es «número de tokens × precio unitario ÷ 1,000,000».
Ejemplo 1: solicitud de contexto corto en GPT-6.2 Astra
El escenario es un asistente de preguntas y respuestas con una indicación del sistema larga. Cada solicitud tiene una entrada total de 100,000 tokens, de los cuales 60,000 corresponden a la indicación del sistema fija y a fragmentos de conocimiento, que conviene guardar en caché; los otros 40,000 son contenido del usuario que cambia en cada solicitud; y la salida (incluido el razonamiento) ronda los 5,000 tokens. La entrada total es de 100K, por debajo de 272K, por lo que se aplica la tarifa de contexto corto.
| Concepto de facturación | Primera solicitud (escritura en caché de 30 minutos) | Solicitudes posteriores (con acierto de caché) |
|---|---|---|
| Entrada normal 40,000 × $8 | $0.32 | $0.32 |
| Escritura en caché 60,000 × $10 | $0.60 | — |
| Lectura de caché 60,000 × $0.40 | — | $0.024 |
| Salida 5,000 × $40 | $0.20 | $0.20 |
| Total por solicitud | $1.12 | $0.544 |
Como se puede ver, una vez que la caché acierta, el costo por solicitud se reduce casi a la mitad, mientras que la primera escritura en caché resulta más cara que no usar caché (sin caché serían 100,000 × $8 = $0.80, y con la salida, $1.00 en total). Si en lugar de eso se usa la escritura en caché de 12 horas, esa línea pasa a ser 60,000 × $20 = $1.20, y solo compensa si hay varios aciertos de caché dentro de esas 12 horas.
Tomando como referencia los $0.544 por solicitud con acierto de caché, 1,000 solicitudes rondarían los $544. Si además aplicamos los multiplicadores por nivel: Batch unos $272, Fast unos $1,088, Ultrafast unos $1,632 antes del 2027-02-28 y unos $3,264 a partir del 2027-03-01. En cuanto a cómo se calcula exactamente el cobro cuando Batch se combina con la caché, lo recomendable es atenerse a la explicación oficial de facturación; aquí solo se trata de una estimación aproximada hecha con los multiplicadores.
Ejemplo 2: solicitud de contexto largo de GPT-6.2 Astra que supera los 272K
El escenario es cargar un repositorio de código completo o un lote de contratos en el contexto para analizarlos. En una sola solicitud, la entrada total es de 400,000 tokens: 300,000 corresponden a lectura de caché, 100,000 son entrada normal y la salida ronda los 8,000 tokens. Como la entrada total supera los 272K, toda la solicitud pasa a la tarifa de contexto largo.
| Concepto facturado | Cálculo correcto (toda la solicitud a contexto largo) | Cálculo incorrecto (todo a contexto corto) |
|---|---|---|
| Entrada normal 100,000 | × $16 = $1.60 | × $8 = $0.80 |
| Lectura de caché 300,000 | × $0.80 = $0.24 | × $0.40 = $0.12 |
| Salida 8,000 | × $60 = $0.48 | × $40 = $0.32 |
| Total por solicitud | $2.32 | $1.24 |
Entre ambos cálculos hay una diferencia de casi el doble. Otro error habitual es «duplicar solo los 128K que exceden los 272K», algo que tampoco encaja con lo que la página del modelo especifica al decir «se calcula por solicitud completa». Solo hay una manera correcta de hacerlo: en cuanto se cruza el umbral, la entrada, la lectura de caché y la escritura en caché de esa solicitud se cobran al doble, y la salida a 1.5 veces.
Encima de esto se aplican los niveles de servicio: Fast queda en $2.32 × 2 = $4.64; Ultrafast cuesta $6.96 hasta el 2027-02-28 y $13.92 a partir del 2027-03-01; Batch ronda los $1.16. Si esta tarea se ejecuta 200 veces al día, el nivel estándar supone unos $464 diarios, mientras que con Ultrafast (después de marzo de 2027) serían unos $2,784 al día: una diferencia suficiente para cambiar el planteamiento técnico.
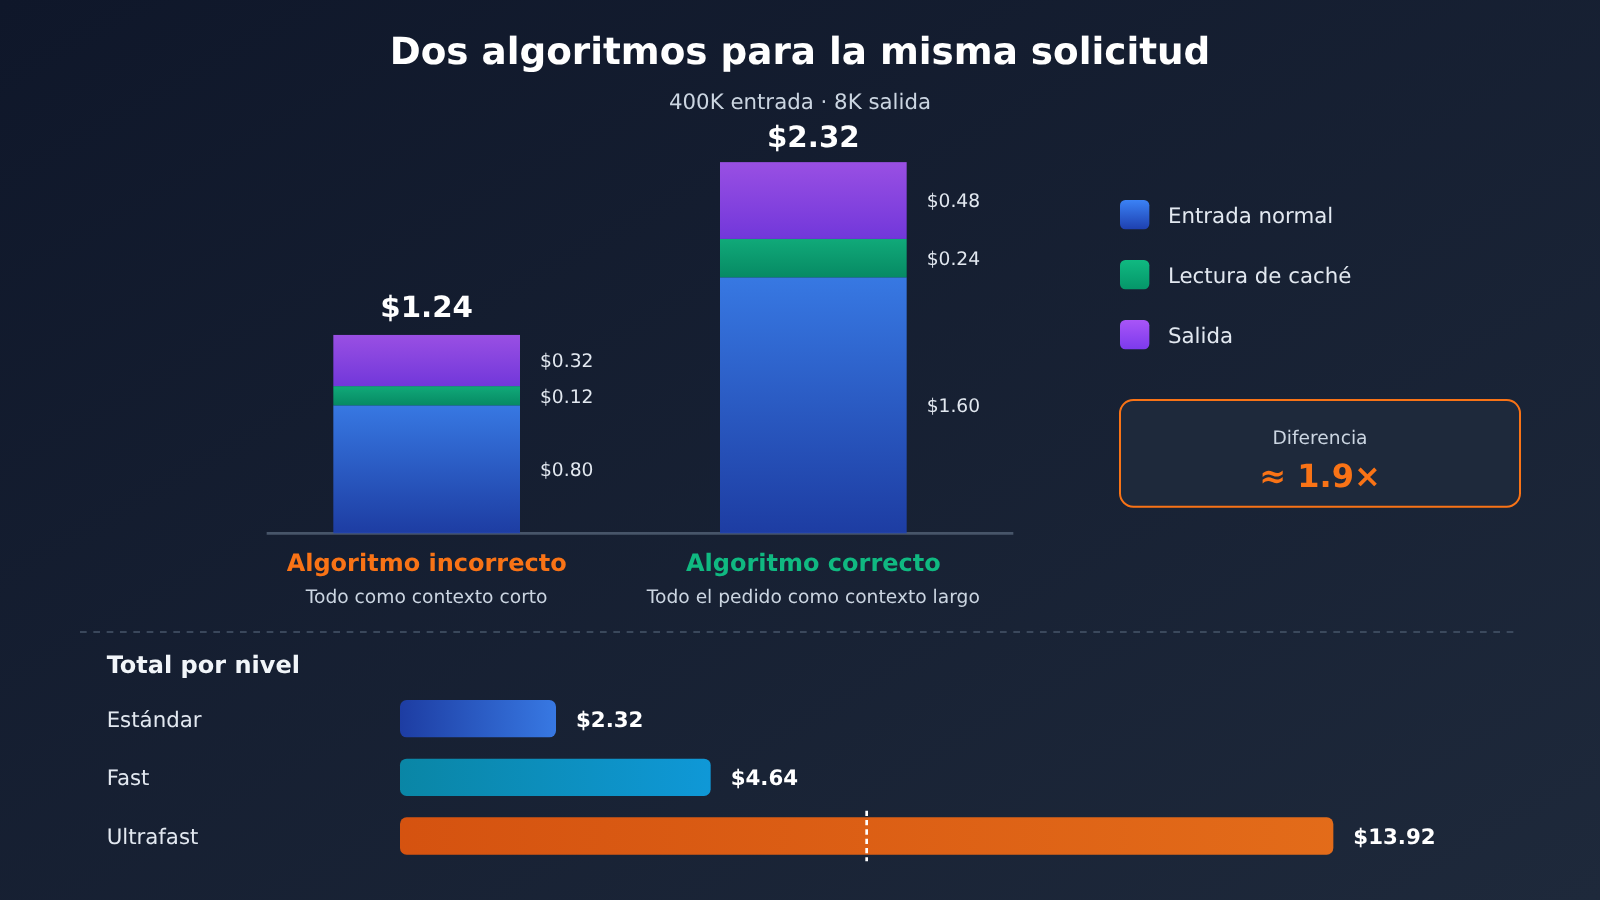
🎯 Consejo de tarificación: sustituye los valores de tokens de los dos ejemplos anteriores por tus cifras reales y obtendrás un primer borrador de presupuesto. Las cifras de la gráfica se calculan a partir de los precios publicados en la página oficial del modelo de OpenAI; cuando GPT-6.2 Astra esté disponible en APIYI, el precio unitario real será el que figure en la lista de modelos de apiyi.com.
Pasos de preparación para la invocación en APIYI
gpt-6.2-astra todavía no está disponible en la plataforma; lo publicaremos lo antes posible. El nombre del modelo y el precio deben confirmarse con la lista de modelos de la plataforma. Una vez publicado, la forma de integrarlo será idéntica a la de otros modelos compatibles con OpenAI, así que puedes prepararte con estos pasos:
- Crea una clave API en la consola de APIYI y usa el crédito de prueba gratuito para usuarios nuevos para ejecutar primero muestras pequeñas.
- En tu cliente, configura base_url como
https://api.apiyi.com/v1y escribegpt-6.2-astracomo ID del modelo. - La página oficial del modelo indica que es compatible con los endpoints Chat Completions y Responses, además de Batch; no es compatible con Realtime, Assistants, ajuste fino, generación de imágenes, video ni voz, por lo que los flujos que necesiten estas capacidades deberán recurrir a otro modelo.
- No establezcas el nivel de razonamiento en
none, porque la API lo rechazará; puedes empezar probando con un nivel bajo y observar cómo cambian los tokens de salida. - Después de cada invocación, lee el campo usage de la respuesta y registra por separado los tokens de entrada, los aciertos de caché y los de salida; luego sustitúyelos en las tablas de este artículo para verificar los costos.
🚀 Inicio rápido: mientras llega el lanzamiento, puedes usar el modelo anterior
gpt-6-astra, que ya está disponible, para validar el flujo de la API y la lógica de estadísticas de usage; cuando salga el 6.2, solo tendrás que reemplazar el ID del modelo.
Comparación de precios de GPT-6.2 Astra y modelos relacionados
La siguiente tabla reúne los precios oficiales de lista y los precios del listado general de los modelos ya disponibles en APIYI, para que puedas compararlos de un vistazo. Ten en cuenta que las dos fuentes no son lo mismo: el precio oficial lo fija el fabricante, mientras que el precio de la plataforma corresponde al listado general de APIYI (17 de noviembre de 2026, 15:54, UTC+8).
| Modelo | Entrada / Salida / Lectura de caché (por cada millón de tokens) | Fuente del precio | Disponibilidad |
|---|---|---|---|
| gpt-6.2-astra | $8 / $40 / $0.40 | Precio oficial de OpenAI | Aún no disponible en APIYI; consulta la lista de modelos de la plataforma |
| gpt-6.2-sol | $2 / $10 / $0.10 | Precio oficial de OpenAI | Aún no disponible en APIYI; consulta la lista de modelos de la plataforma |
| gpt-6-astra (modelo anterior) | $10 / $50 / $1; entradas superiores a 272 000, $20 | Listado general de APIYI | Disponible en APIYI (apiyi.com) |
| gpt-6.1-sol | $2 / $10 / $0.1; entradas superiores a 272 000, $4 | Listado general de APIYI | Disponible en APIYI |
| gemini-4-carbon | $2 / $10 / $0.1 (precio de lanzamiento) | Listado general de APIYI | Disponible en APIYI |
Sobre GPT-6.2 Sol: el precio estándar oficial para contexto corto es de $2 en entrada, $0.10 en lectura de caché, $2.50 en escritura de caché de 30 minutos, $5 en escritura de caché de 12 horas y $10 en salida; las reglas de pedido completo a partir de 272K y los multiplicadores por niveles son los mismos que los de Astra. Todavía no está en la plataforma, pero lo incorporaremos lo antes posible; el modelo y los precios definitivos son los que indique la lista de modelos de la plataforma.
Al comparar con gpt-6-astra, ten claro que se trata del modelo anterior: en el listado general de APIYI figura con $10 de entrada, $50 de salida y $1 de lectura de caché. Según la nota de lanzamiento oficial, la entrada y la salida de GPT-6.2 Astra cuestan un 20% menos que las de GPT-6 Astra, y la entrada en caché un 60% menos, cifras que encajan con los $8 / $40 / $0.40. No tomes el precio de plataforma de gpt-6-astra o de gpt-6.1-sol como el precio de la versión 6.2.
Gemini 4 Carbon tiene además un detalle temporal: según la tarifa estándar oficial de Google, hasta el 30 de noviembre de 2026 el precio es de $2 en entrada y $10 en salida, y a partir del 1 de diciembre pasa a $4 y $20 respectivamente. La página de información de APIYI indica por ahora el precio de lanzamiento, así que después del 1 de diciembre conviene confirmar el precio real en la lista de modelos de la plataforma. Por otro lado, la tarifa de Google no incluye la regla de «duplicar el precio de todo el pedido al superar los 272K», de modo que no puedes aplicar la regla de contexto largo de GPT-6.2 al comparar entre proveedores.
💡 Recomendación: el consumo de tokens de una misma carga de trabajo no es igual en todos los modelos, y un precio unitario más bajo no significa una factura más baja. Te sugiero invocar por separado varios de los modelos ya disponibles en APIYI con el mismo lote de muestras, calcular el costo total según el usage real y decidir después.
Cómo interpretar los datos oficiales y de terceros de GPT-6.2 Astra
Para estimar tu factura solo necesitas el precio de lista, pero mucha gente cita de pasada el «costo por tarea», y aquí conviene distinguir bien las fuentes.
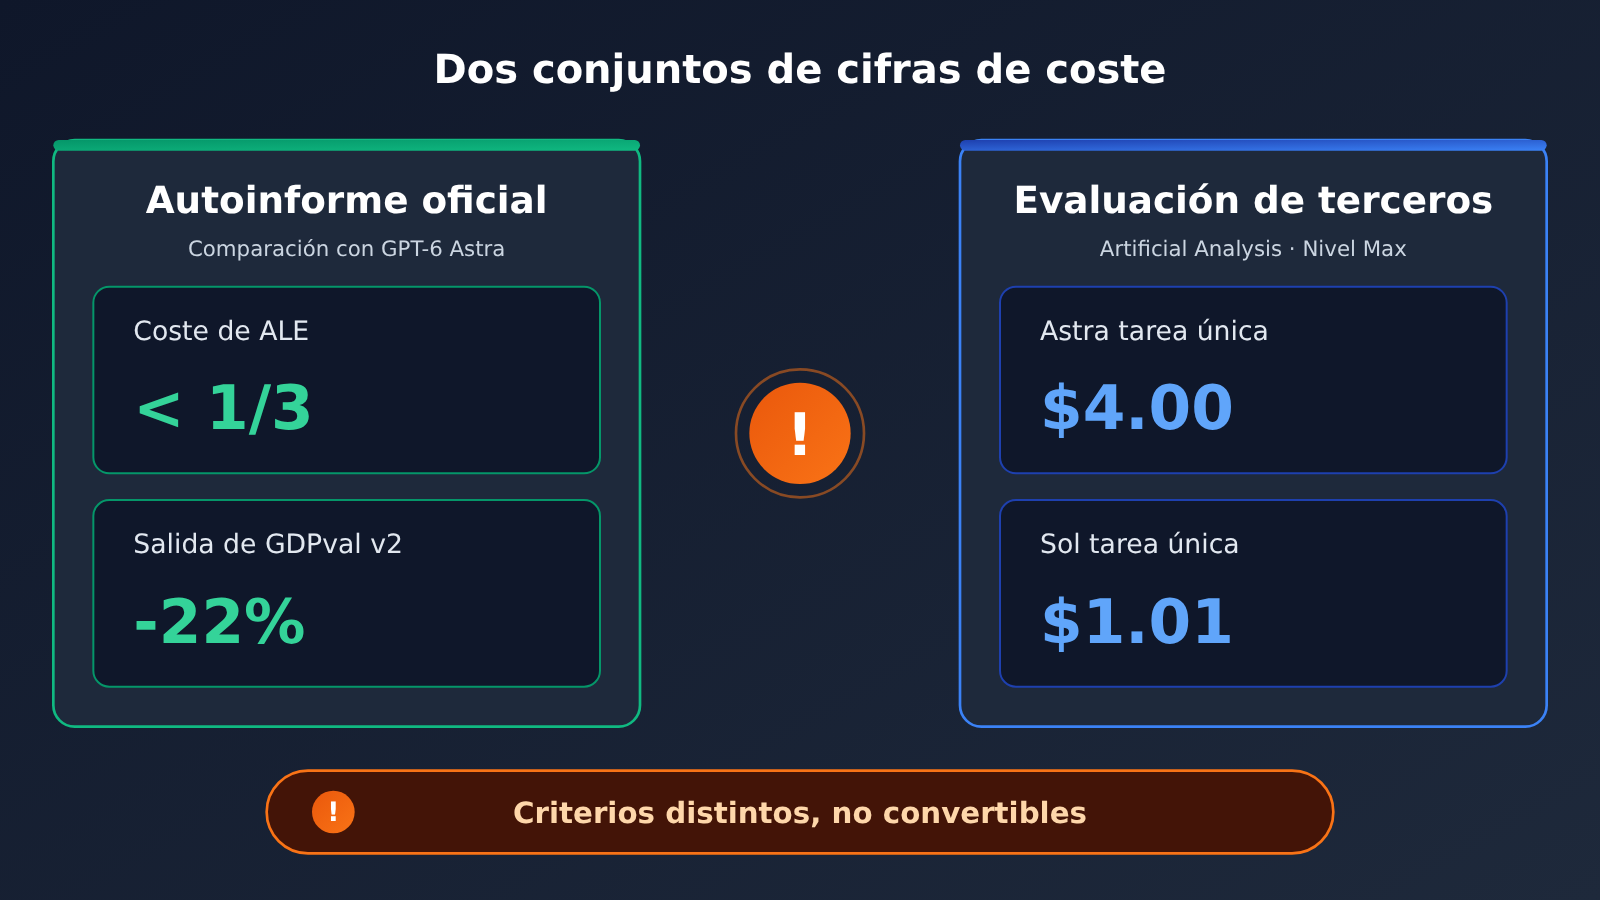
Autoinforme oficial: en su nota de lanzamiento, OpenAI afirma que en Agents’ Last Exam GPT-6.2 Astra supera a GPT-6 Astra por 5.2 puntos con menos de un tercio del costo, y que en el GDPval v2 interno lo supera por 6.2 puntos porcentuales usando un 22% menos de tokens de salida. Son cifras que el propio OpenAI reporta sobre tareas que él mismo eligió; indican que en esas tareas el consumo de tokens bajó, pero no se pueden traducir directamente al costo de tu negocio.
Fuentes de terceros: Artificial Analysis midió en Intelligence Index v5.0.1 que el costo por tarea del índice compuesto de GPT-6.2 Astra (nivel de razonamiento Max) ronda los $4.00, y el de GPT-6.2 Sol (nivel de razonamiento Max), unos $1.01. Se trata del promedio bajo su propio conjunto de tareas de evaluación y en el nivel de razonamiento más alto: no es el precio unitario de GPT-6.2 Astra ni implica que tu tarea cueste $4.00 cada vez. Bajar el nivel de razonamiento cambia notablemente el consumo de tokens, y las puntuaciones que el mismo tercero publica para los niveles High, Medium y Low también difieren entre sí.
Las dos series de cifras difieren en tareas, nivel de razonamiento y método de cálculo, así que no conviene convertirlas entre sí ni fusionarlas en una sola conclusión. Para estimar tu propia factura, vuelve a los tres pasos: «desglosar los tokens, identificar el umbral y multiplicar por la tarifa».
Preguntas frecuentes (FAQ)
P1: ¿Cuál es el precio estándar de GPT-6.2 Astra?
Según la página oficial de modelos de OpenAI, el precio estándar para contexto corto por cada 1 millón de tokens es: entrada $8, lectura de caché $0.40, escritura de caché de 30 minutos $10, escritura de caché de 12 horas $20 y salida $40. Por ahora no está disponible en la plataforma; lo publicaremos lo antes posible. El identificador y los precios del modelo deben confirmarse con la lista de modelos de la plataforma.
P2: ¿El recargo por superar los 272K solo aplica a la parte excedente?
No. La página del modelo indica que el cálculo se hace por solicitud completa: cuando la entrada de una solicitud supera los 272K tokens, los precios unitarios de entrada y de caché de toda la solicitud se duplican, y la salida se cobra a 1.5 veces la tarifa de contexto corto. En el ejemplo dos, la misma solicitud calculada con el algoritmo correcto cuesta $2.32, mientras que si todo se calculara con tarifas de contexto corto saldría solo $1.24.
P3: ¿Cuándo cambian los multiplicadores de Ultrafast?
Hasta el 2027-02-28 (hora del Pacífico) será 3 veces el precio estándar, y a partir del 2027-03-01 pasará a ser 6 veces. Al hacer el presupuesto de un proyecto a largo plazo, el uso de Ultrafast a partir de marzo debe calcularse por separado con el multiplicador de 6x.
P4: ¿En qué escenarios es más fácil calcular mal los costos de GPT-6.2 Astra?
– **Análisis de repositorios de código**: si metes el repositorio completo en una sola llamada, es muy fácil superar los 272K y cambiar de tarifa toda la solicitud.
– **Tareas de Agent con múltiples turnos**: el historial de conversación y los resultados de las herramientas se acumulan constantemente; las solicitudes posteriores pueden cruzar el umbral sin que te des cuenta.
– **Primera escritura de caché**: el precio de escritura de caché de la primera solicitud es más alto que el de la entrada normal; el costo de arranque en frío debe calcularse aparte.
– **Solicitudes de contexto largo con Fast o Ultrafast activados**: los dos factores de recargo se multiplican entre sí.
P5: ¿Cómo invocar GPT-6.2 Astra a través de APIYI?
`gpt-6.2-astra` todavía no está disponible en la plataforma; lo publicaremos lo antes posible. El identificador y los precios del modelo deben confirmarse con la lista de modelos de la plataforma. Antes del lanzamiento, puedes registrarte en apiyi.com y reclamar créditos de prueba gratuitos, y usar el modelo ya disponible `gpt-6-astra` (entrada $10, salida $50, lectura de caché $1) para dejar listas las invocaciones mediante Responses o Chat Completions y las estadísticas de usage; cuando se publique el nuevo modelo, solo tendrás que reemplazar el ID del modelo.
P6: ¿Se puede usar el $4.00 de Artificial Analysis como precio unitario?
No. Es el costo promedio por tarea calculado por un tercero con el conjunto de tareas del Intelligence Index en el nivel de razonamiento Max, y solo refleja el consumo promedio de ese grupo de tareas. La longitud de tus tareas, tu tasa de aciertos de caché y tu nivel de razonamiento son distintos; los costos deben desglosarse por tu cuenta según los precios oficiales.
P7: ¿Qué limitaciones conocidas de GPT-6.2 Astra afectan los costos?
La intensidad de razonamiento no se puede establecer en `none`, así que no es posible eliminar por completo los tokens de razonamiento; solo admite entrada de texto e imágenes y salida de texto, sin soporte para audio ni video; no es compatible con Realtime, Assistants ni fine-tuning. La tarjeta oficial del sistema también señala que en algunas pruebas tiende más a omitir el reporte de problemas bloqueantes (como archivos faltantes); en los flujos de Agent, cada reintento adicional implica una facturación adicional, por lo que en la indicación conviene pedirle al modelo que reporte explícitamente este tipo de situaciones.
Puntos clave de la tarificación de GPT-6.2 Astra (Key Takeaways)
- Cuatro categorías, cálculo por separado: los precios unitarios de entrada, lectura de caché, escritura de caché y salida varían mucho; hay que multiplicar cada uno por separado.
- 272K es un umbral que aplica a toda la solicitud: al superarlo, entrada y caché se multiplican ×2 y salida ×1.5; no cambia solo la parte que excede.
- Los niveles se apilan multiplicándose: Batch sale a mitad de precio, Fast multiplica ×2 sobre la misma longitud de contexto y Ultrafast se calcula aparte.
- Ultrafast tiene fecha límite: ×3 hasta el 2027-02-28 (PT) y ×6 a partir del 2027-03-01.
- Con la caché se paga más al inicio y se ahorra después: la primera escritura cuesta más que el precio de entrada, pero tras un acierto el costo por consulta puede quedar casi a la mitad.
- No mezcles las bases de cálculo: ni las cifras que el propio proveedor autoreporta ni los costos de terceros de una sola tarea son precios unitarios.
- La disponibilidad se rige por la lista de modelos: los dos modelos 6.2 todavía no están en APIYI; mientras tanto, puedes usar el modelo anterior para validar el flujo.
Resumen
La tarificación de GPT-6.2 Astra se puede resumir en tres pasos:
- Desglosa los tokens: separa la solicitud en entrada normal, lectura de caché, escritura de caché y salida; los tokens de razonamiento se contabilizan del lado de la salida.
- Comprueba el umbral: si el total de tokens de entrada de la solicitud supera los 272K, toda la solicitud pasa a los precios unitarios de contexto largo, con entrada y caché ×2 y salida ×1.5.
- Aplica el multiplicador: elige el factor según Batch, estándar, Fast o Ultrafast; con Ultrafast, ten en cuenta que a partir del 2027-03-01 pasa a ser 6 veces.
Al hacer el presupuesto, empieza sustituyendo tus propios números de tokens en las tablas del ejemplo uno y del ejemplo dos, y calcula una vez con el nivel estándar y otra con el nivel acelerado que planeas usar; la diferencia suele ser mayor de lo que imaginas. GPT-6.2 Astra y GPT-6.2 Sol aún no están disponibles en APIYI; los publicaremos lo antes posible. En cuanto a nombres de modelo y precios, manda la lista de modelos de la plataforma. Hasta entonces, en apiyi.com puedes usar el crédito gratuito y los modelos ya publicados para dejar montado el proceso de verificación de las estadísticas de usage y de los costos.
📚 Referencias
-
Anuncio oficial de OpenAI: Notas de lanzamiento de GPT-6.2 Astra y Sol
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol - Descripción: Resumen de precios estándar y datos de capacidades autodeclarados oficialmente
- Enlace:
-
Página del modelo de OpenAI – gpt-6.2-astra: Especificaciones y reglas completas de precios
- Enlace:
platform.openai.com/docs/models/gpt-6.2-astra - Descripción: El precio de escritura en caché, la regla de pedido completo de 272K y los multiplicadores Batch/Fast/Ultrafast se rigen por esta fuente
- Enlace:
-
Página del modelo de OpenAI – gpt-6.2-sol: Especificaciones de Sol y precios de lista
- Enlace:
platform.openai.com/docs/models/gpt-6.2-sol - Descripción: Precio estándar de Sol para contextos cortos y las mismas reglas de precios
- Enlace:
-
Tarjeta del sistema de OpenAI: Evaluaciones de seguridad y alineación
- Enlace:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descripción: Limitaciones conocidas, como los problemas de omisiones que interrumpen el flujo
- Enlace:
-
Artículo de evaluación de Artificial Analysis (terceros): Resultados del Intelligence Index
- Enlace:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descripción: Datos de terceros, como el costo por tarea del nivel de razonamiento Max
- Enlace:
-
Tabla general de modelos y API de precios de APIYI: Modelos disponibles y precios de la plataforma
- Enlace:
docs.apiyi.com/models.mdyapi.apiyi.com/api/pricing - Descripción: El estado de disponibilidad de los dos modelos 6.2 y los precios de los modelos de comparación se rigen por esta fuente
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: Puede contactarnos desde la página de inicio del sitio web de APIYI; para más material de integración, visite el centro de documentación en docs.apiyi.com


