
Nota del autor: este artículo desglosa las pruebas ciegas de la página de investigación de Tencent, los benchmarks del apéndice y los testimonios del equipo de producto para comparar Hy4 flash y GLM-5.3-Flash en tareas cotidianas, codificación en terminal, costo y protocolos de integración, y aclara cuál se puede invocar hoy en APIYI.
Tencent Hunyuan lanzó Hy4 flash el 2026-11-16, y la empresa lo posiciona como «el modelo más barato para la productividad diaria». Muchos están eligiendo entre GLM-5.3-Flash y Hy4 flash como su modelo principal para el día a día. La página de investigación de Tencent ofrece tres tipos de materiales: pruebas ciegas humanas, tablas de benchmark en el apéndice y testimonios del equipo de producto. Las conclusiones de esos tres apartados no apuntan exactamente en la misma dirección.
Este no es un artículo de compromiso del tipo «cada uno tiene sus virtudes». A continuación presento los datos de los tres apartados por separado, y cada cifra va acompañada de su fuente. Al final, doy una elección clara según el escenario y también aclaro cuál modelo se puede invocar directamente hoy en APIYI.
Valor clave: al terminar este artículo sabrás dónde gana Hy4 flash en las pruebas ciegas, dónde gana GLM-5.3-Flash en el benchmark del apéndice y qué protocolos de integración y criterios de precio conviene tener en cuenta.
Diferencias clave entre Hy4 flash y GLM 5.3 Flash
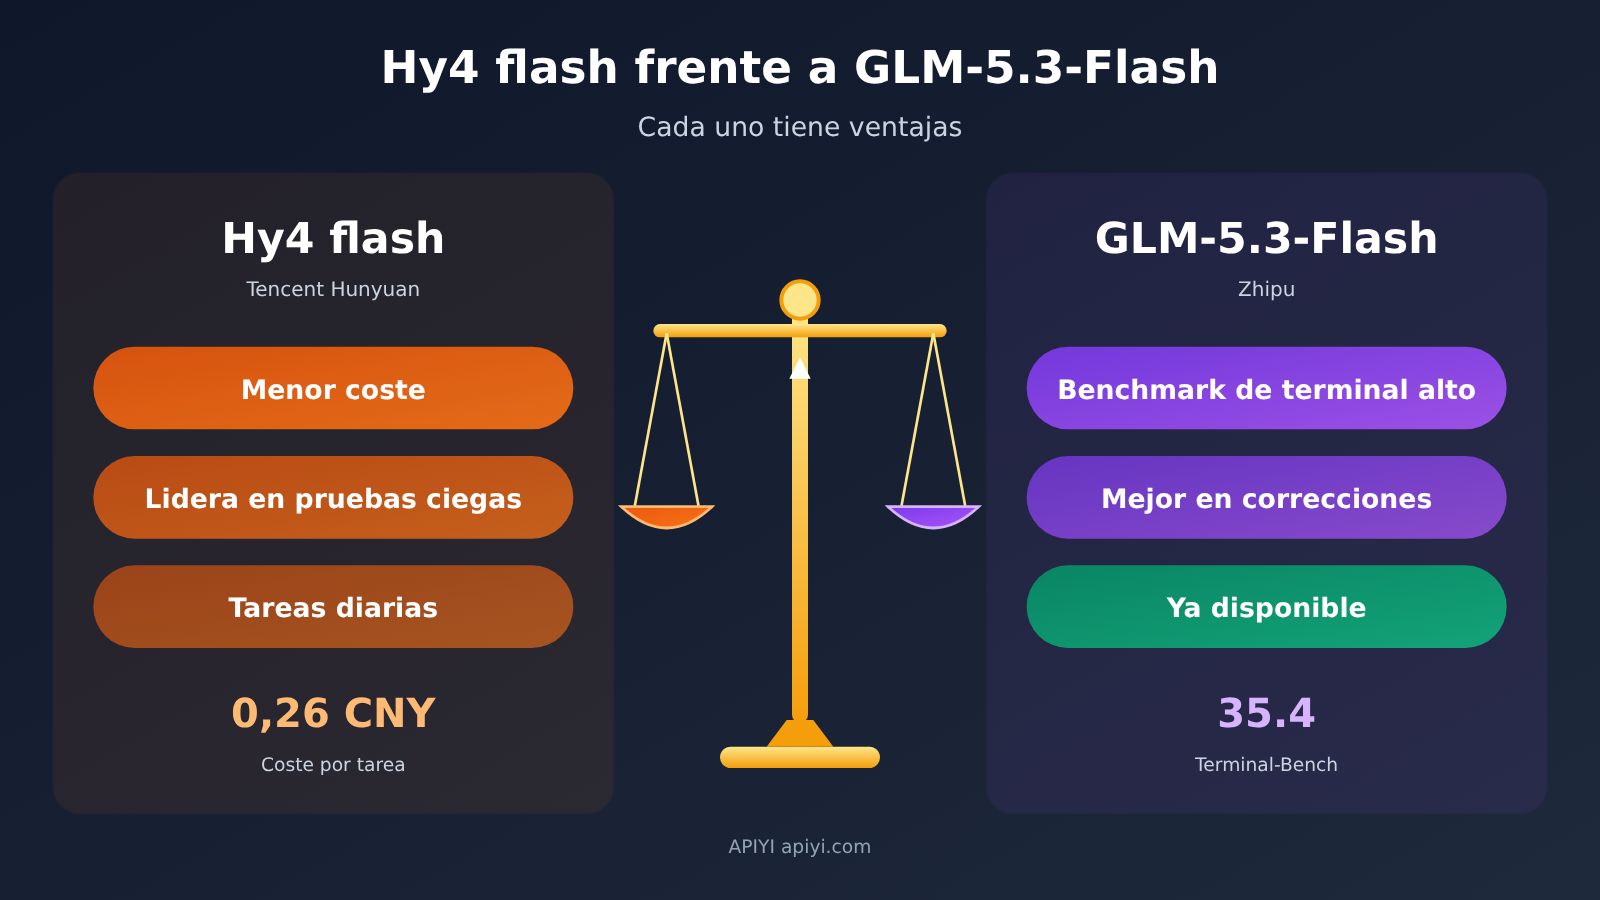
Para ir directo a la conclusión: ninguno de los dos gana en todo. En la prueba a ciegas de Tencent, Hy4 flash tiene mejor satisfacción, es más rápido y más barato. En el apéndice, en ítems como Terminal-Bench 4.0 y PPTFixBench, más orientados a “reparación y operaciones de terminal”, GLM-5.3-Flash obtiene mejores puntuaciones.
| Dimensión de comparación | Hy4 flash | GLM-5.3-Flash | Fuente de datos |
|---|---|---|---|
| Satisfacción en prueba a ciegas (escala de 4 puntos) | 2.79 | 2.53 | Tabla de prueba a ciegas de la página de investigación de Tencent (autoinforme oficial) |
| Tiempo mediano de extremo a extremo | 6.7 minutos | 7.6 minutos | Ídem |
| Costo por tarea en prueba a ciegas | 0.26 yuanes | 0.81 yuanes | Ídem, yuanes |
| Terminal-Bench 4.0 | 19.2 | 35.4 | Apéndice de la página de investigación de Tencent |
| PPTFixBench | 23.7 | 28.6 | Apéndice de la página de investigación de Tencent |
| MdCoEditBench (coescritura de Markdown) | 56.9 | 32.3 | Apéndice de la página de investigación de Tencent |
| Especificaciones | 224B de parámetros totales (incluidos 64B de Engram), 12B activos, contexto de 1M | 320B de parámetros totales, 18B activos, contexto de 1M, salida máxima de 128,000 | Página de investigación / página de modelos de APIYI |
| Plataformas disponibles | Tencent Cloud TokenHub, WorkBuddy, etc.; APIYI aún no lo tiene listado | APIYI apiyi.com ya lo tiene listado como glm-5.3-flash |
Página de investigación / lista de modelos de APIYI |
Todas las puntuaciones de esta tabla vienen del lado de Tencent; GLM no aparece para defenderse. Al leerla, conviene recordar: tanto la prueba a ciegas como el apéndice son autoinformes oficiales de Tencent, y la mayoría de los conjuntos de evaluación son internos de Tencent, no posiciones de una clasificación final pública.
Tres criterios de medición de datos en la comparación entre Hy4 flash y GLM 5.3 Flash
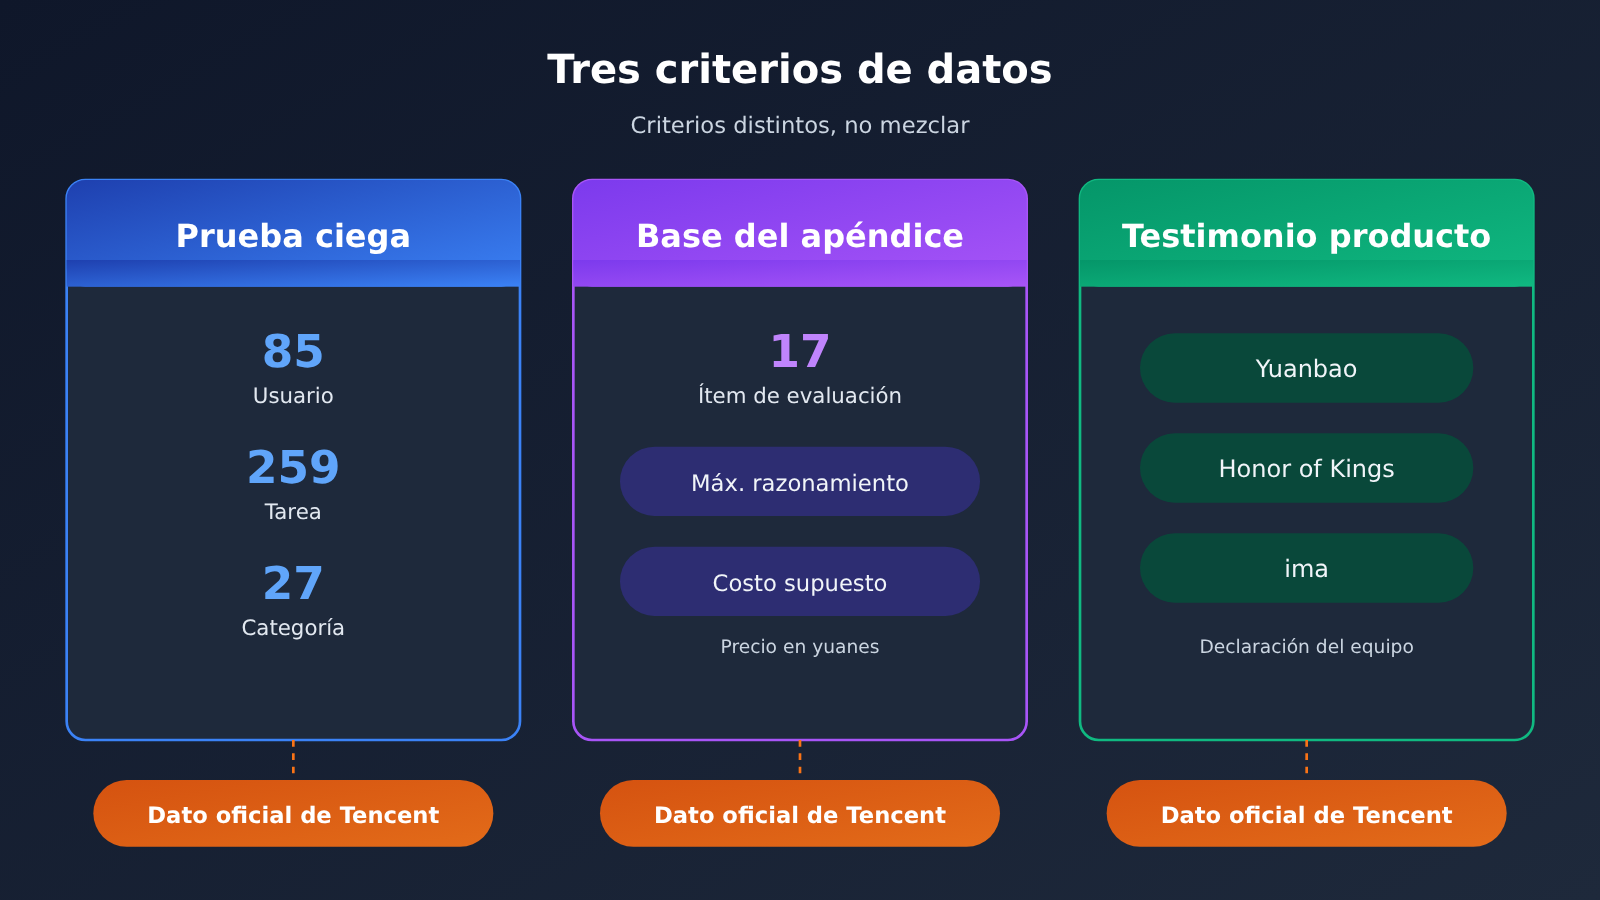
Las tres fuentes emplean criterios completamente distintos; mezclarlas al leer puede llevar fácilmente a conclusiones equivocadas:
- Prueba a ciegas: 85 usuarios internos de WorkBuddy, 259 tareas, 27 categorías. Los modelos externos (incluido GLM) usan el nivel high; la fila de Hy4 flash no especifica el nivel.
- Tabla del apéndice: 17 ítems de evaluación; todos los modelos usan su nivel de razonamiento más alto. Cada celda incluye el costo por tarea, calculado con el precio fijo en yuanes definido por Tencent.
- Testimonios de los equipos de producto: cifras autoinformadas por equipos como Yuanbao, Honor of Kings e ima; cada una responde a su propio escenario y su propia línea base, y no deben compararse directamente entre sí.
Resultados de la prueba a ciegas: Hy4 flash vs GLM 5.3 Flash
La prueba a ciegas es la evidencia más favorable para Hy4 flash. La tabla completa de la prueba a ciegas en la página del estudio tiene cuatro filas y se reproduce tal cual a continuación (según datos de la propia Tencent):
| Modelo | Satisfacción (escala de 4 puntos) | Tiempo mediano de extremo a extremo | Costo por tarea (RMB) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 (high) | 3.09 | 10.3 minutos | 1.20 yuanes |
| Hy4 flash (nivel no especificado) | 2.79 | 6.7 minutos | 0.26 yuanes |
| Claude-Haiku-5.5 (high) | 2.81 | 6.8 minutos | 4.73 yuanes |
| GLM-5.3-Flash (high) | 2.53 | 7.6 minutos | 0.81 yuanes |
Si nos fijamos solo en las filas de Hy4 flash y GLM-5.3-Flash, Hy4 flash obtiene 0.26 puntos más de satisfacción, tarda unos 0.9 minutos menos y su costo por tarea es aproximadamente un tercio del de GLM. Esta es la base directa para la afirmación de que «las pruebas a ciegas cotidianas resultan más económicas».
Hay tres puntos que conviene interpretar correctamente. Primero, la satisfacción más alta es la de DeepSeek, con 3.09, no la de Hy4 flash. Segundo, Hy4 flash está 0.02 puntos por debajo de Haiku; la página del estudio usa la palabra «cercano» (close to), no «superior». Tercero, la «reducción de 18 veces en el costo por tarea» que aparece en la publicación oficial proviene de dividir 4.73 yuanes entre 0.26 yuanes, y la comparación es con Haiku, no con GLM.
¿De dónde sale el costo de la prueba a ciegas de Hy4 flash frente a GLM 5.3 Flash?
El costo en yuanes de la tabla de la prueba a ciegas lo calculó Tencent según su propio criterio de tarificación. Refleja «quién gasta menos con el mismo conjunto de tareas», y no equivale a la factura real que tendrías en cualquier plataforma. El bajo costo de Hy4 flash proviene en parte de un precio de lista más bajo y en parte de lo que indica la página del estudio: el aprendizaje por refuerzo redujo en un 50 % la salida media de tokens de extremo a extremo.
La página del estudio también incluye un conjunto de conclusiones de WorkIndex: el costo promedio por tarea es 1/13 del de Hy4 preview y 1/20 del de Hy4. Estas afirmaciones pertenecen solo a WorkIndex; no deben usarse para reemplazar las cifras en yuanes de la tabla de la prueba a ciegas, y tampoco tienen relación con GLM.
Hy4 flash frente a GLM 5.3 Flash: benchmarks del apéndice
El apéndice es donde GLM-5.3-Flash recupera terreno. La siguiente tabla está copiada de la imagen completa del Appendix de la página de investigación de Tencent, conservando solo estas dos columnas, con el formato «puntuación / costo por tarea (RMB)»:
| Prueba | Hy4 flash | GLM-5.3-Flash | Mayor puntuación |
|---|---|---|---|
| PPTGenBench | 54.2 / 0.169 | 53.6 / 1.460 | Hy4 flash |
| PPTCoEditBench | 74.0 / 0.105 | 67.3 / 0.489 | Hy4 flash |
| PPTFixBench | 23.7 / 0.253 | 28.6 / 2.517 | GLM |
| MdCoEditBench | 56.9 / 0.057 | 32.3 / 0.133 | Hy4 flash |
| WordEditBench | 46.2 / 0.629 | 47.6 / 2.840 | GLM |
| ExcelFixBench | 15.6 / 0.310 | 9.9 / 2.879 | Hy4 flash |
| AudioVideoBench | 17.8 / 0.344 | 11.9 / 3.370 | Hy4 flash |
| BuddyVQA Atlas (sin herramientas) | 48.5 / 0.007 | 50.1 / 0.019 | GLM |
| DeepSWE v1.1 | 64.6 / 0.290 | 67.8 / 3.230 | GLM |
| ProgramBench | 16.0 / 0.561 | 13.0 / 17.959 | Hy4 flash |
| Terminal-Bench 4.0 | 19.2 / 0.558 | 35.4 / 5.597 | GLM |
| APEX-Agents v1.1 | 63.1 / 0.087 | 51.5 / 0.485 | Hy4 flash |
| AutomationBench v1.0.6 | 52.2 / 0.038 | 48.4 / 0.104 | Hy4 flash |
| HLE-Full (con herramientas) | 55.2 / 0.060 | 52.2 / 0.616 | Hy4 flash |
| OSWorld 2.1 | 68.1 / 0.451 | 64.0 / 3.803 | Hy4 flash |
| MMMU-Pro | 75.8 / 0.010 | 77.0 / 0.013 | GLM |
| ZeroBench-main (con herramientas) | 45.8 / 0.077 | 35.3 / 1.861 | Hy4 flash |
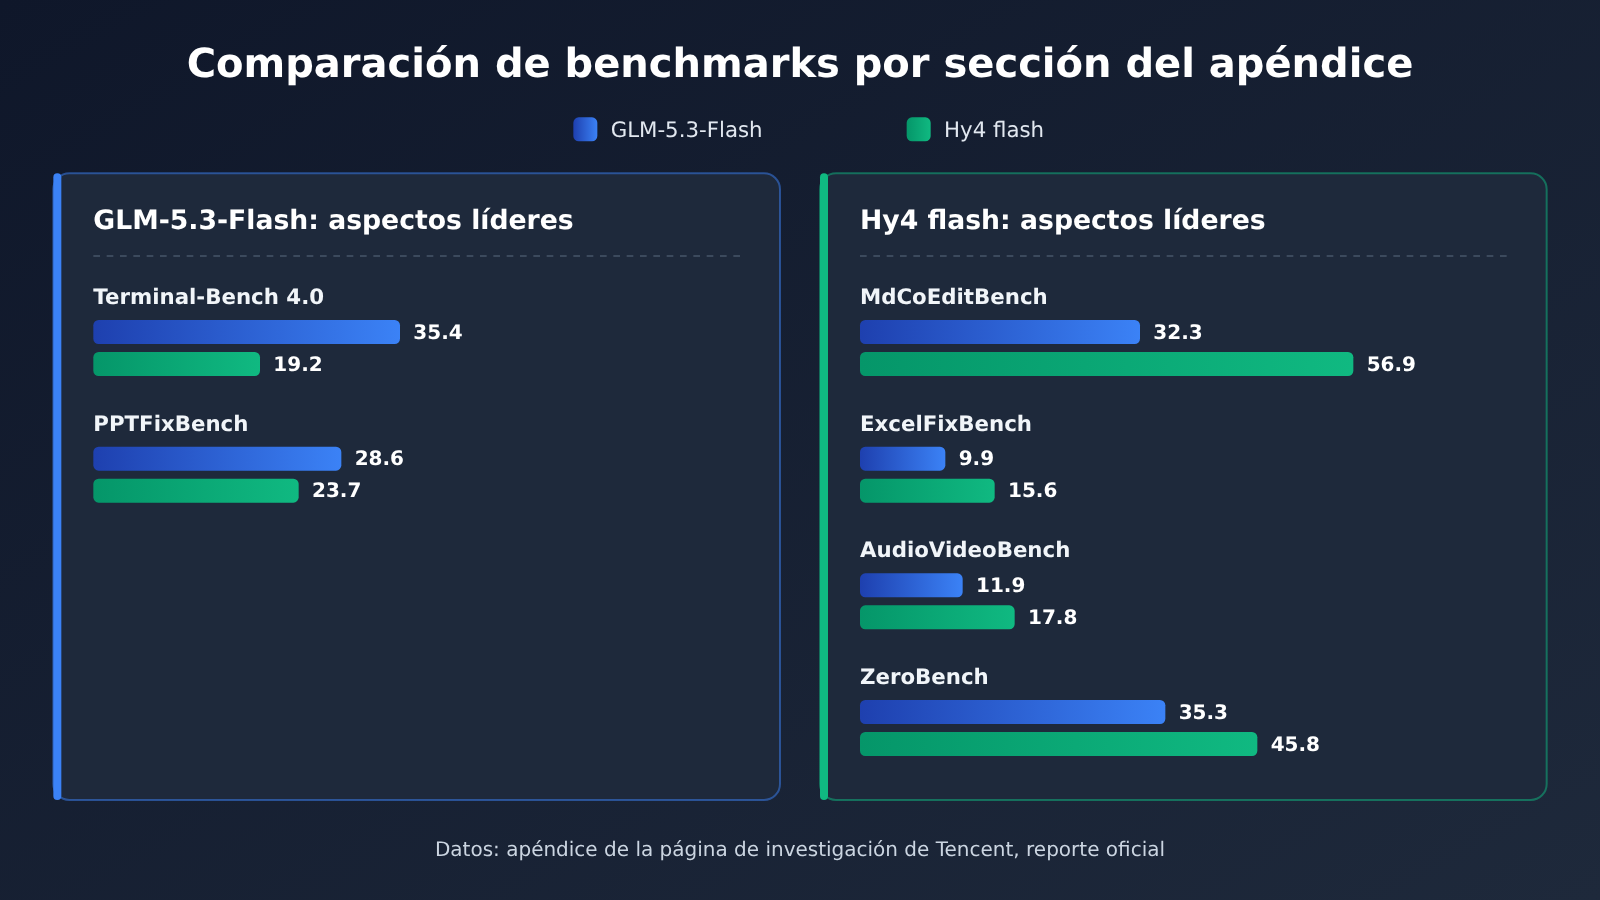
La diferencia más grande está en Terminal-Bench 4.0: GLM 35.4 frente a Hy4 flash 19.2, casi el doble. Este benchmark usa el harness de Claude Code, con hasta 500 turnos y una duración máxima de 13 horas por ejecución, y evalúa operaciones de terminal de larga duración. En PPTFixBench, GLM también aventaja por unos 5 puntos. Además, GLM lidera ligeramente en DeepSWE, WordEditBench, BuddyVQA y MMMU-Pro.
Donde Hy4 flash marca la diferencia es en la coescritura de Markdown (56.9 frente a 32.3), la corrección de tablas, el procesamiento de audio y vídeo y ZeroBench. Estas pruebas se acercan más al trabajo diario de «escribir documentos, corregir tablas y procesar material». Esto coincide con la recomendación de la página de investigación: para ingeniería de software de largo recorrido, seguir usando Hy4 en lugar de Hy4 flash.
La columna de costos del apéndice es una suposición de Tencent, no tu factura en la plataforma
El apéndice original lo explica así: los costos se calculan con el precio oficial de la API de cada modelo y con un tipo de cambio de 7.2 yuanes por dólar. Para GLM-5.3-Flash se usó un precio fijo de 0.8 yuanes por millón de tokens de entrada, 0.23 yuanes por acierto de caché y 2.8 yuanes por millón de tokens de salida, marcado como «precio estándar de API». Es una suposición que Tencent hizo al armar la tabla del apéndice, no es el precio publicado por APIYI, y tampoco sirve para calcular tu factura en APIYI.
Testimonios de los equipos de producto: Hy4 flash frente a GLM 5.3 Flash
La página de investigación también incluye testimonios de varios equipos de producto de Tencent, y tres de ellos mencionan directamente a GLM-5.3-Flash. Todos son declaraciones de la propia parte que desarrolla el producto, con escenarios y líneas base distintos:
- Yuanbao (según el propio equipo de producto): en conversación general supera a GLM-5.3-Flash en un 2.52 %, y la diferencia se nota sobre todo en conversaciones multiturno. Es una evaluación interna del equipo de Yuanbao, no un ranking público.
- Honor of Kings (según el propio equipo de producto): frente a DeepSeek-V4.1-Flash-1017 y GLM-5.3-Flash, la localización de la causa raíz queda en un nivel parecido. El modelo hace entre un 22.0 % y un 39.1 % menos solicitudes, consume entre un 40.5 % y un 61.2 % menos tokens y, en cambio, realiza un 51.2 % y un 7.7 % más llamadas a herramientas.
- ima (según el propio equipo de producto): frente a los dos anteriores, la espera media es entre un 18 % y un 35 % menor, la puntuación de las respuestas es un 1.8 % más alta y la calidad del contenido un 8.1 % mejor.
Lo que estos tres casos tienen en común: Hy4 flash gana en «gastar menos tokens y esperar menos», y en calidad está a la par o ligeramente por delante. Respaldan la conclusión de la prueba a ciegas, pero no pueden rebatir la diferencia en Terminal-Bench que aparece en el apéndice, simplemente porque no son el mismo tipo de tarea.
Hy4 flash frente a GLM 5.3 Flash: precios y acceso
El precio es la parte más fácil de equivocar. No conviene mezclar cifras de distintas fuentes; la siguiente tabla separa el origen de cada precio (todas las unidades están en USD por millón de tokens):
| Modelo / fuente | Entrada | Salida | Lectura de caché | Notas |
|---|---|---|---|---|
| Hy4 flash (tarifa de lista de la página de investigación de Tencent) | 0.070 | 0.281 | 0.003 | No es precio publicado por APIYI; TokenHub aplica 50% de descuento hasta el 2026-11-30 |
glm-5.3-flash (página de modelos de APIYI en apiyi.com) |
0.15 | 0.50 | 0.03 | Ya disponible; grupos CodexResponses, Default y SVIP; multiplicador 1x |
glm-5-3-flash-260828 (tabla general de APIYI) |
0.15 | 0.499995 | 0.03 | Otro canal; no entra en conflicto con la fila anterior |
hy4 (tabla general de APIYI) |
0.85 | 2.55 | 0.045 | Este es Hy4, no Hy4 flash |
| Hy4 (tarifa de lista de la página de investigación de Tencent) | 0.834 | 2.501 | 0.042 | Tarifa de lista de la página de investigación; se consulta por separado del precio de APIYI |
El 50% de descuento de Hy4 flash corresponde a una tarifa promocional por tiempo limitado de TokenHub. La página de investigación no publica una tabla aparte con el precio con descuento; si haces la estimación dividiendo entre 2, recuerda que después del 30 de noviembre se vuelve a la tarifa de lista.
Hy4 flash todavía no está disponible; incorporaremos este modelo lo antes posible. Los modelos y precios se rigen por la lista de modelos de la plataforma. Por ahora, APIYI solo tiene hy4; no hay ninguna versión flash de Hunyuan. Si necesitas la versión de Tencent Hunyuan con el límite superior más alto, puedes usar hy4 por ahora; si lo que quieres es específicamente Hy4 flash, en esta etapa solo puedes recurrir a canales oficiales como Tencent Cloud TokenHub o WorkBuddy. La página de investigación tampoco proporciona un ID de modelo de API; antes de invocar, guíate por el nombre que aparece en la consola de TokenHub.
Cómo invocar GLM-5.3-Flash en APIYI
glm-5.3-flash ya se puede invocar hoy. En APIYI solo es compatible con OpenAI Chat Completions; no es compatible con Anthropic Messages ni con Responses. Esto determina si puedes conectarlo directamente a determinados clientes:
- Crea una clave API en la consola de apiyi.com.
- Configura el base_url del cliente como
https://api.apiyi.com/v1; la ruta de la solicitud es/chat/completions. - En el cuerpo de la solicitud, asigna
glm-5.3-flashamodely envíamessagesen formato OpenAI. - El modo de razonamiento está activado por defecto; la entrada puede ser texto, imagen o video, y la salida es texto.
Si tu herramienta solo envía solicitudes en formato Anthropic Messages, glm-5.3-flash no se puede usar directamente. En esos casos, cambia a un cliente compatible con Chat Completions o usa un modelo que ofrezca tanto el endpoint chat como el endpoint messages. La ventana de contexto, la salida máxima, el endpoint y otros parámetros se rigen por la página de modelos de APIYI.
🚀 Recomendación de integración: para los modelos que ya están disponibles en APIYI, usa una clave de apiyi.com y envía las solicitudes a
https://api.apiyi.com/v1; con un cliente compatible con OpenAI, basta cambiar dos ajustes para que funcione. Los nuevos usuarios tienen una cuota de prueba gratuita, así que puedes probarglm-5.3-flashcon tus tareas habituales.
Hy4 flash frente a GLM 5.3 Flash: escenarios recomendados
Cuándo elegir Hy4 flash
- Escritura conjunta de documentos y Markdown: en el apéndice, MdCoEditBench da 56.9 frente a 32.3, una diferencia clara.
- Reparación de tablas y tratamiento de material de audio y vídeo: Hy4 flash va por delante en ExcelFixBench y AudioVideoBench.
- Tareas diarias de alta frecuencia y sensibles al coste: en la prueba a ciegas, 0.26 yuanes por tarea frente a 0.81 yuanes (según lo que publica la propia Tencent).
- Productos de conversación multiturno: el equipo de Yuanbao afirma que la conversación general es un 2.52% mejor, y la diferencia se nota sobre todo en multiturno.
Cuándo elegir GLM-5.3-Flash
- Operación de terminal y tareas de línea de comandos de largo recorrido: Terminal-Bench 4.0 marca 35.4 frente a 19.2, la brecha más grande de todas.
- Tareas de reparación de diapositivas: PPTFixBench 28.6 frente a 23.7.
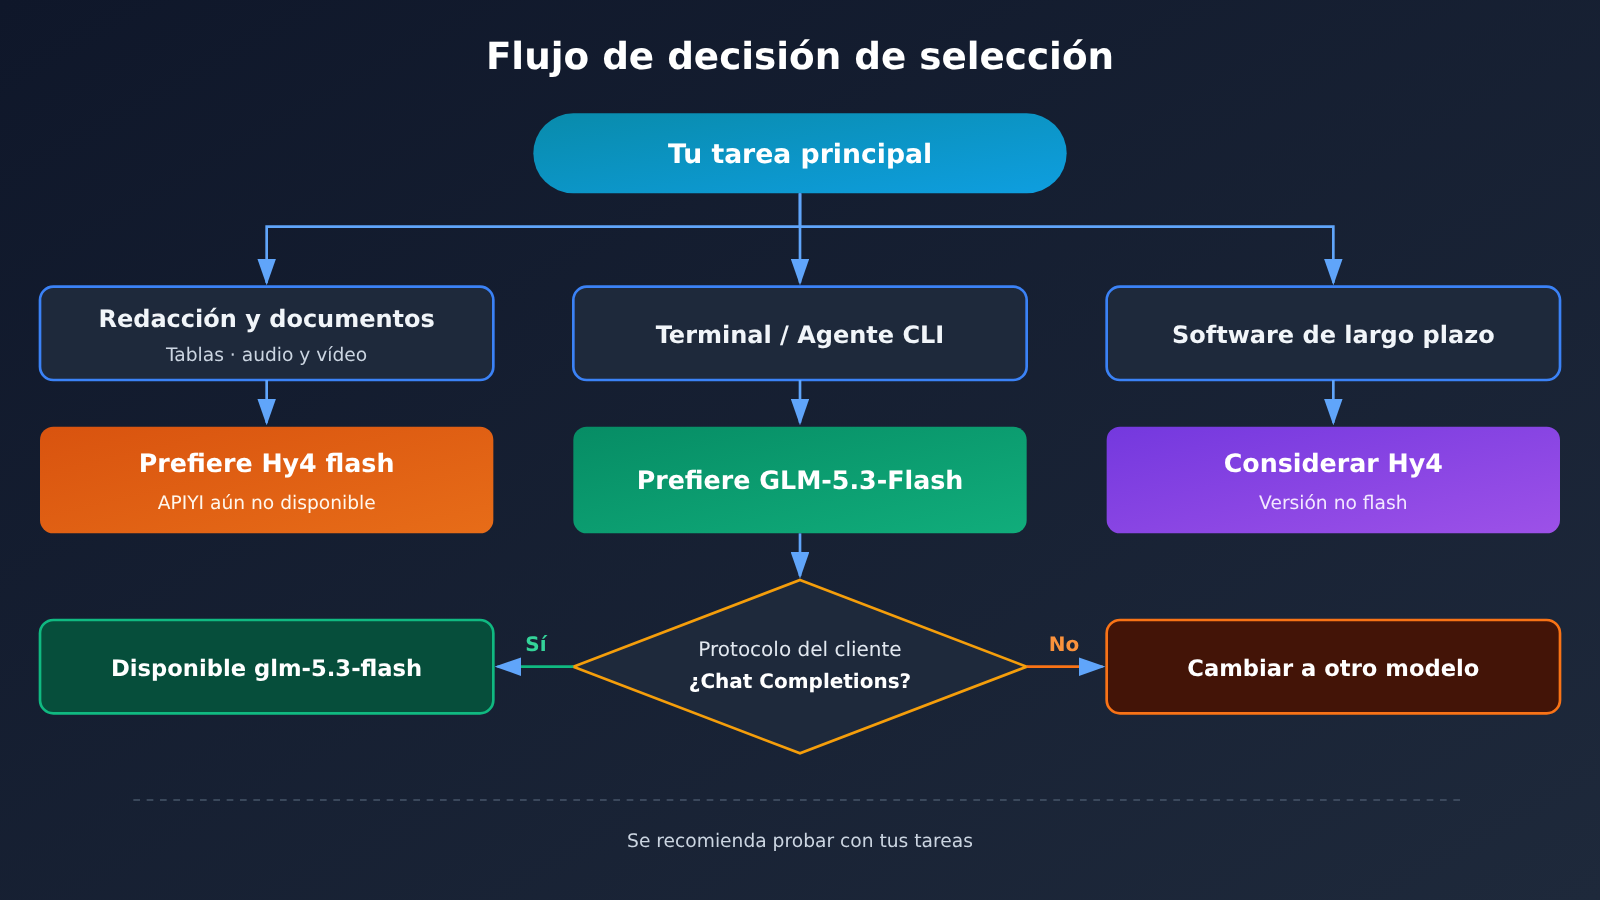
- Cuando hay que salir hoy mismo:
glm-5.3-flashya está disponible en APIYI; Hy4 flash todavía no. - Cuando tu stack se apoya en Chat Completions: los clientes con formato OpenAI se conectan directamente.
Hy4 flash frente a GLM 5.3 Flash: recomendaciones para decidir
| Tu situación | Recomendación |
|---|---|
| Te dedicas sobre todo a escritura, documentos, tablas y tratamiento de material | Espera a que Hy4 flash esté disponible, o pruébalo primero por el canal oficial de Tencent |
| Te dedicas sobre todo a operación de terminal y agentes de línea de comandos | Elige GLM-5.3-Flash |
| Necesitas salir hoy en APIYI | Elige glm-5.3-flash, vía Chat Completions |
| Tu cliente solo admite Anthropic Messages | glm-5.3-flash no te sirve; busca un modelo que admita messages |
| Ingeniería de software de largo recorrido | Ninguno de los dos es la primera opción; la página de investigación recomienda Hy4 |
💡 Recomendación: la prueba a ciegas y el apéndice apuntan en direcciones distintas, así que lo más prudente es lanzar un lote de tus propias tareas con cada uno.
glm-5.3-flashpuedes validarlo ahora mismo en APIYI apiyi.com; cuando Hy4 flash esté disponible, basta cambiar el parámetromodelpara compararlos sobre el mismo código.
Preguntas frecuentes (FAQ)
P1: ¿Qué son Hy4 flash y GLM-5.3-Flash?
Hy4 flash es el modelo para tareas cotidianas que Tencent Hunyuan lanzó el 2026-11-16: 224B de parámetros totales, 12B activos y 1M de contexto. Según la página de modelos de APIYI, GLM-5.3-Flash tiene 320B de parámetros totales, 18B activos y 1M de contexto; el fabricante lo publicó el 2026-08-26.
P2: En la comparación entre Hy4 flash y GLM 5.3 Flash, ¿cuál es realmente mejor?
Depende del tipo de tarea. En las pruebas ciegas de Tencent, la satisfacción de Hy4 flash es 2.79 frente a 2.53 de GLM; en el apéndice, Terminal-Bench 4.0 y PPTFixBench favorecen a GLM, mientras que la coescritura con Markdown, las tablas, el audio y vídeo y ZeroBench favorecen a Hy4 flash. Todos los datos son autoinformados por Tencent.
P3: Yuanbao dice que la conversación general supera a GLM-5.3-Flash en 2.52%. ¿Es creíble?
Esta es una evaluación autoinformada por el equipo de producto de Yuanbao, no una clasificación pública, y tampoco se han publicado detalles del método. Puede servir como indicio de que «Hy4 flash podría llevar ventaja en conversación multiturno», pero no conviene tomarlo como conclusión definitiva.
P4: ¿Los 0.8 yuanes, 0.23 yuanes y 2.8 yuanes de GLM en el apéndice son precios de APIYI?
No. Son suposiciones de precio fijo en yuanes (RMB) que Tencent utilizó al elaborar la tabla del apéndice. En la página de modelos de APIYI, el precio de `glm-5.3-flash` es 0.15 USD de entrada, 0.50 USD de salida y 0.03 USD de lectura de caché por millón de tokens; prevalece lo que indique la lista de modelos de la plataforma.
P5: ¿Ya se puede invocar Hy4 flash en APIYI?
Hy4 flash aún no está disponible; lo publicaremos lo antes posible. El modelo y el precio se rigen por la lista de modelos de la plataforma. Por ahora, en APIYI se pueden invocar `glm-5.3-flash` y `hy4`; ojo, `hy4` no es la versión flash. Puedes consultar las novedades de disponibilidad en la lista de modelos de apiyi.com.
P6: ¿Se puede conectar `glm-5.3-flash` a un cliente que solo admite el formato de Anthropic?
No. En APIYI, `glm-5.3-flash` solo ofrece el endpoint OpenAI Chat Completions y no admite Messages ni Responses. El cliente debe poder apuntar `base_url` a `/v1` y enviar solicitudes a Chat Completions.
P7: ¿Cuáles son las limitaciones conocidas de ambos modelos?
Hy4 flash solo obtiene 19.2 puntos en Terminal-Bench 4.0; la página de investigación también admite que en ingeniería de software de largo alcance está por detrás de Hy4, y por ahora solo está previsto abrir sus pesos. GLM-5.3-Flash queda por detrás en satisfacción en pruebas ciegas y en coescritura con Markdown, y además solo funciona mediante Chat Completions. Los datos comparativos de ambos provienen de Tencent.
Hy4 flash frente a GLM 5.3 Flash: puntos clave
- En las pruebas ciegas, Hy4 flash lleva ventaja: satisfacción de 2.79 frente a 2.53, 6.7 minutos frente a 7.6 minutos, 0.26 yuanes frente a 0.81 yuanes.
- En los benchmarks de terminal, GLM es superior: Terminal-Bench 4.0 marca 35.4 frente a 19.2, y PPTFixBench también se inclina hacia GLM.
- En las tareas de oficina diarias, Hy4 flash obtiene mejores resultados: escritura colaborativa en Markdown, corrección de tablas, audio y vídeo, y puntuaciones más altas en ZeroBench.
- Las declaraciones son solo autodeclaraciones: el «2.52% más» de Yuanbao lo afirma el propio fabricante; no es una clasificación pública.
- Aclara el origen de los precios: los yuanes del apéndice son una suposición de Tencent; los dólares de la página del estudio son tarifas de lista; ninguno es el precio de APIYI.
- Lo que se puede invocar hoy es GLM:
glm-5.3-flashya está disponible en APIYI apiyi.com y solo admite Chat Completions.
Resumen
Conclusiones clave de Hy4 flash frente a GLM 5.3 Flash:
- Para tareas diarias, Hy4 flash es la referencia: en las pruebas ciegas de Tencent resulta más satisfactorio, más rápido y más barato, y también puntúa más alto en benchmarks de documentos y tablas.
- Para tareas de terminal, GLM-5.3-Flash es la referencia: la diferencia en Terminal-Bench 4.0 es de casi el doble; para tareas de línea de comandos de largo recorrido no deberías elegir Hy4 flash.
- Para llevarlo a producción, mira disponibilidad y protocolo: hoy lo que se puede invocar en APIYI es
glm-5.3-flash, y solo mediante Chat Completions; Hy4 flash aún no está disponible.
Si tus tareas se centran en redacción y documentos, puedes seguir la disponibilidad de Hy4 flash; si te inclinas más por operaciones de terminal o necesitas lanzarlo de inmediato, glm-5.3-flash es la opción más directa. Te recomiendo usar el crédito de prueba gratuito de apiyi.com y ejecutar una ronda con tus tareas reales antes de decidir.
📚 Referencias
-
Página de investigación de Tencent Hunyuan Hy4 flash: tabla de pruebas ciegas, benchmarks del apéndice, testimonios del lado del producto y precio de lista
- Enlace:
hy.tencent.ai/research/hy4-flash - Nota: todas las pruebas ciegas, puntuaciones del apéndice y testimonios citados en este artículo provienen de esta página y son datos autodeclarados oficialmente por Tencent.
- Enlace:
-
Publicación oficial de Tencent Hunyuan: lanzamiento de Hy4 flash y precio de lista de la API
- Enlace:
x.com/TencentHunyuan/status/2122217770314301469 - Nota: aquí se origina la afirmación de la «reducción del costo por tarea de 18 veces», y el objeto de comparación es Claude Haiku 5.5.
- Enlace:
-
Página del modelo GLM-5.3-Flash en APIYI: parámetros, contexto, endpoints y precios
- Enlace:
docs.apiyi.com/models/glm-5-3-flash - Nota: las especificaciones y el protocolo de
glm-5.3-flashse rigen por esta página.
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal del sitio de APIYI; para más modelos e instrucciones de integración, visita el centro de documentación docs.apiyi.com.


