
Nota del autor: las aplicaciones multimodelo deberían gestionar las diferencias en llamadas a herramientas, estado de razonamiento, salida en streaming, datos estructurados y caché mediante un formato de mensaje unificado, una capa de adaptación por proveedor y un registro de capacidades.
GPT, Claude y Gemini pueden realizar invocaciones de texto convencionales, y Claude y Gemini también ofrecen endpoints oficiales compatibles con el SDK de OpenAI. Al cambiar de modelo en una aplicación de nivel producción, hay que resolver 6 clases de problemas de compatibilidad: roles de mensaje e instrucciones de sistema, protocolo de llamada a herramientas, parámetros de razonamiento y estado de pensamiento, eventos de streaming, salida estructurada y multimodal, facturación de caché y manejo de errores. Cambiar solo el Model ID permite resolver preguntas y respuestas simples, pero las llamadas a herramientas de varios turnos, la recuperación tras cortes de stream y el cálculo de costos requieren un tratamiento aparte. Una solución de ingeniería bastante sólida es “interfaz de negocio unificada + capa de adaptación por proveedor (Provider Adapter) + registro de capacidades del modelo”. Así, el cambio de modelo puede gestionarse como una funcionalidad de producto mantenible.
A continuación se comparan las diferencias estructurales de las tres API nativas y se explica qué escenarios puede cubrir la interfaz compatible con OpenAI. Después se desglosan, una por una, las fallas reales que pueden provocar las 6 clases de problemas de compatibilidad, y se presenta una arquitectura de integración de seis capas y código de invocación unificado que se puede ejecutar. Por último, se enumeran seis pruebas de compatibilidad antes del lanzamiento y se explica cómo dividir responsabilidades entre un gateway de API unificado y la adaptación de capacidades nativas.
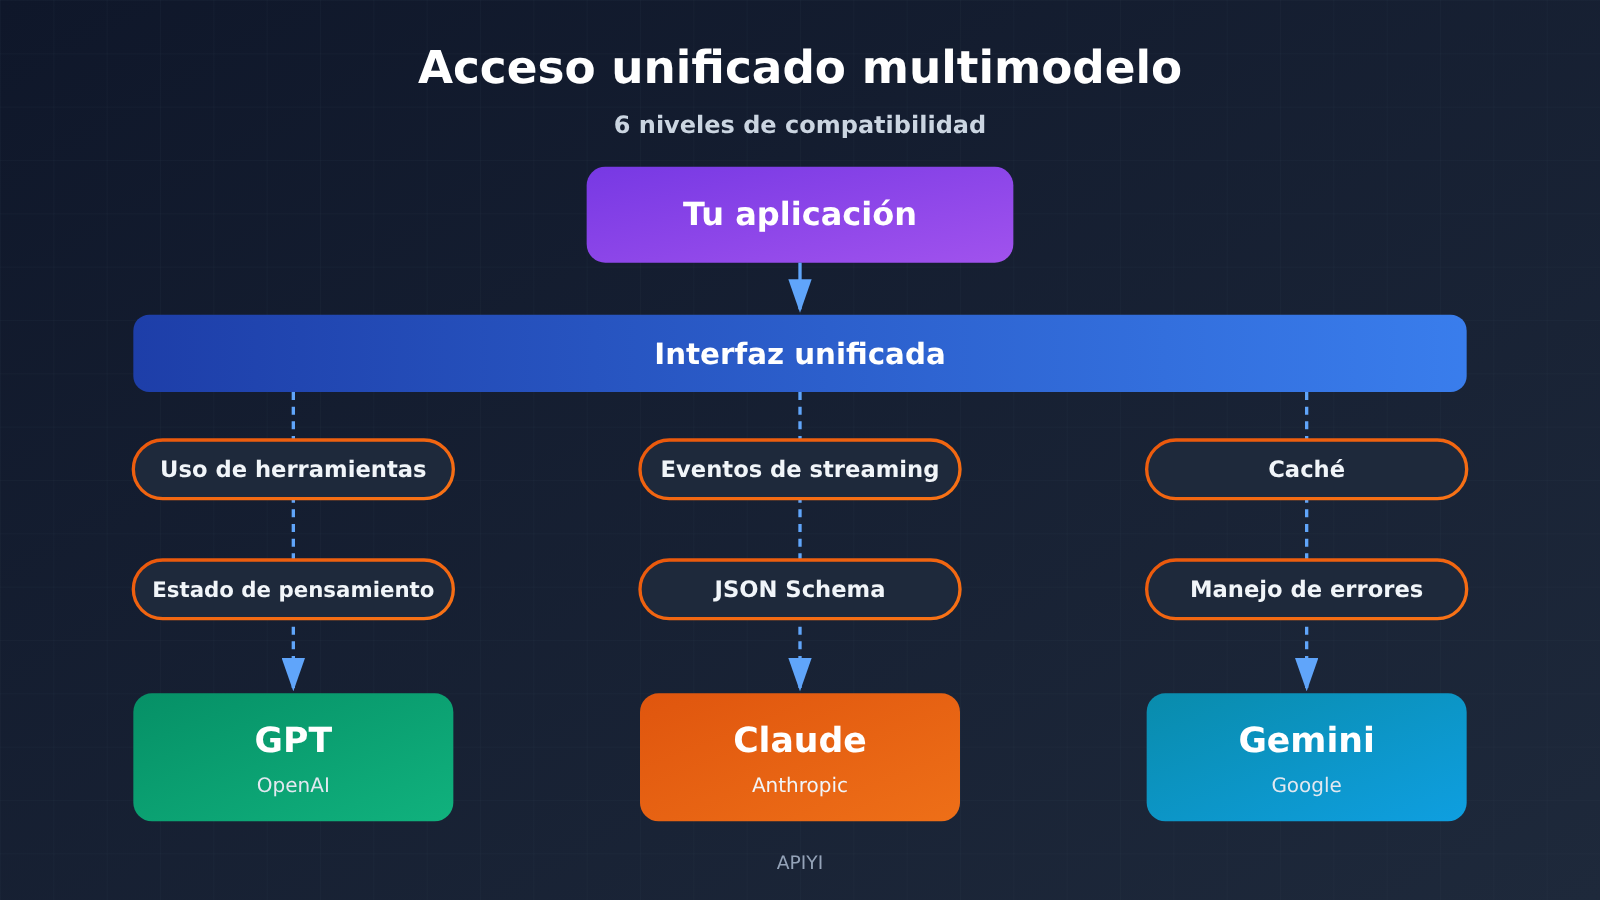
Para saber: Glosario de compatibilidad de API multimodelo
| Término | Explicación |
|---|---|
| API | Interfaz que permite a una aplicación enviar solicitudes al servicio del modelo y recibir resultados. |
| SDK | Kit de desarrollo de software que encapsula los detalles de las llamadas a la interfaz. |
| API nativa | Interfaz principal diseñada por el propio proveedor, como OpenAI Responses, Claude Messages o Gemini Interactions. |
| Interfaz compatible | Punto de acceso adaptado que reutiliza el formato de solicitud de otra plataforma (normalmente el de OpenAI), para poder invocarla con el mismo SDK. |
| Llamada a funciones (Function Calling) | El modelo solicita a la aplicación, mediante parámetros estructurados, que ejecute una función externa. |
| ID de llamada | Identificador que vincula la solicitud de herramienta iniciada por el modelo con el resultado de ejecución devuelto por la aplicación. |
| Firma de pensamiento (Thought / Thinking Signature) | Datos de estado cifrados que algunos modelos usan para conservar el contexto de razonamiento y de llamadas a herramientas; deben devolverse tal cual. |
| Salida en streaming (Streaming) | El servidor devuelve el resultado por eventos, segmento a segmento, para que el frontend pueda mostrarlo a medida que lo recibe. |
| JSON Schema | Especificación que describe la estructura de datos JSON y las reglas de validación. |
| Caché de indicaciones (Prompt Caching) | Reutiliza el resultado del cálculo de prefijos de entrada que se repiten, para reducir la latencia y el coste. |
| TTL | Tiempo de vida de la caché; una vez caducada, hay que volver a escribirla. |
| Adaptador (Provider Adapter) | Componente que convierte una solicitud unificada al formato nativo de un proveedor y luego transforma la respuesta de vuelta al formato unificado. |
| Registro de capacidades | Lista de configuración que indica qué parámetros y funciones admite realmente cada modelo y cada endpoint de acceso. |
| Idempotente | Una misma operación produce el mismo efecto tanto si se ejecuta una vez como si se ejecuta varias; se usa para evitar cobros duplicados o envíos repetidos por reintentos. |
1 Compatibilidad multi-modelo de API: por qué cambiar de modelo no es solo cambiar el Model ID
Las tres API permiten especificar un modelo con un único campo model, pero la forma de organizar el cuerpo de la solicitud, el objeto de respuesta y el estado del contexto es distinta en cada caso. En preguntas y respuestas normales, las diferencias se concentran en los nombres de campos y el coste de adaptación es bajo. Las aplicaciones tipo agente dependen de llamadas a herramientas, estado de razonamiento y eventos en streaming, así que esas diferencias se convierten directamente en fallos en producción.
1.1 Comparación de las API nativas de GPT, Claude y Gemini
La siguiente tabla describe solo las API nativas y no incluye ninguna capa de compatibilidad ni endpoint de gateway.
| Dimensión | OpenAI (API nativa) | Claude (API nativa) | Gemini (API nativa) |
|---|---|---|---|
| Interfaz principal | Responses API, /v1/responses |
Messages API, /v1/messages |
Interactions API (GA en junio de 2026, recomendada oficialmente para proyectos nuevos); generateContent sigue siendo compatible |
| Organización de la entrada | model + input |
model + messages + max_tokens; system independiente del arreglo de mensajes |
Estructura nativa de Interactions, además de reglas de system_instruction |
| Estructura de salida | Elementos de salida de varios tipos: texto, elementos de razonamiento, function_call, etc. |
content blocks: text, thinking, tool_use, etc. |
steps: pasos como salida del modelo, llamadas a herramientas, razonamiento, etc. |
| Determinación del final | Evento de finalización de respuesta / tipo de elemento de salida | stop_reason (finalización normal, necesidad de ejecutar herramientas, etc.) |
Tipo de paso y estado de interacción |
| Continuidad del contexto | previous_response_id |
La aplicación devuelve por su cuenta el historial completo de mensajes | previous_interaction_id, estado de sesión del lado del servidor opcional |
| Herramientas integradas | Herramientas de plataforma + funciones personalizadas | Principalmente herramientas personalizadas | Herramientas integradas como Google Search, URL Context y ejecución de código; las herramientas de terceros las ejecuta la aplicación |
Como se ve en la tabla, las tres API se dividen en dos enfoques en cuanto a “quién guarda el contexto”. OpenAI y Gemini permiten continuar el contexto del lado del servidor, mientras que en Claude Messages la aplicación debe reenviar el historial por su cuenta. Si el almacenamiento de sesiones de la aplicación está diseñado pensando en solo una de estas formas, al cambiar a otra API se perderá el contexto o se enviarán mensajes duplicados.
1.2 ¿Cuántos problemas resuelve realmente la interfaz compatible con OpenAI?
Claude y Gemini ofrecen un acceso compatible con el SDK de OpenAI. El endpoint compatible oficial de Gemini es generativelanguage.googleapis.com/v1beta/openai/; al usar el cliente de OpenAI, basta con cambiar base_url, la clave API y model. En cambio, la documentación de compatibilidad de Claude delimita claramente el alcance de soporte; a fecha de 2026-11-13, las limitaciones conocidas son las siguientes:
- El parámetro
stricten la definición de herramientas se ignora, por lo que la validación estricta de los parámetros de herramientas deja de funcionar. - No se admite Prompt Caching.
- No se admiten entradas de tipo audio o file.
- Los mensajes
systemydeveloperse mueven al principio y se combinan. - Los campos relacionados con
thinkingdifieren de los de la API nativa.
La interfaz compatible encaja en tres escenarios: chat normal, generación de un solo turno y comparación rápida de la calidad de respuesta de distintos modelos. La migración de agentes complejos implica parámetros estrictos de herramientas, caché, entrada de archivos y estado de razonamiento multiturno; esas capacidades obligan a volver a la API nativa o a validarlas punto por punto antes de pasar a producción. Un criterio práctico es este: si una funcionalidad de la que depende la aplicación aparece solo en la documentación nativa, anótala en el registro de capacidades y deja que un adaptador específico se ocupe de ella.
2 Seis clases de problemas de compatibilidad que más fácilmente aparecen al cambiar entre los modelos GPT, Claude y Gemini
2.1 Compatibilidad de los roles de mensaje y de las instrucciones de sistema
OpenAI distingue roles como developer y system. En Claude, las instrucciones system van fuera del array de mensajes. Gemini usa system_instruction, y el contenido del usuario y del modelo también sigue sus propias reglas estructurales. Los tres expresan lo mismo —»prioridad de instrucciones + historial multi-turno»—, pero los campos que lo portan están en posiciones distintas.
Los fallos habituales vienen de un empalme perezoso: juntar las instrucciones de sistema, los mensajes históricos y los resultados de las herramientas en una sola cadena de texto y pasársela al modelo como si fuera entrada del usuario. Eso funciona, pero la prioridad de las instrucciones queda debilitada, y el modelo puede tomar las salidas de herramientas que aparecen en el historial como nuevas peticiones del usuario. Lo correcto es conservar la semántica de roles dentro de la aplicación y dejar que el adaptador se encargue de mapearla a los campos de cada proveedor. Además, conviene tener en cuenta que la capa de compatibilidad de Claude fusiona system y developer, así que los diseños de indicaciones que dependen de que ambos estén separados por capas necesitan verificarse en la práctica.
2.2 Protocolo de invocación de herramientas y manejo de compatibilidad con los ID de invocación
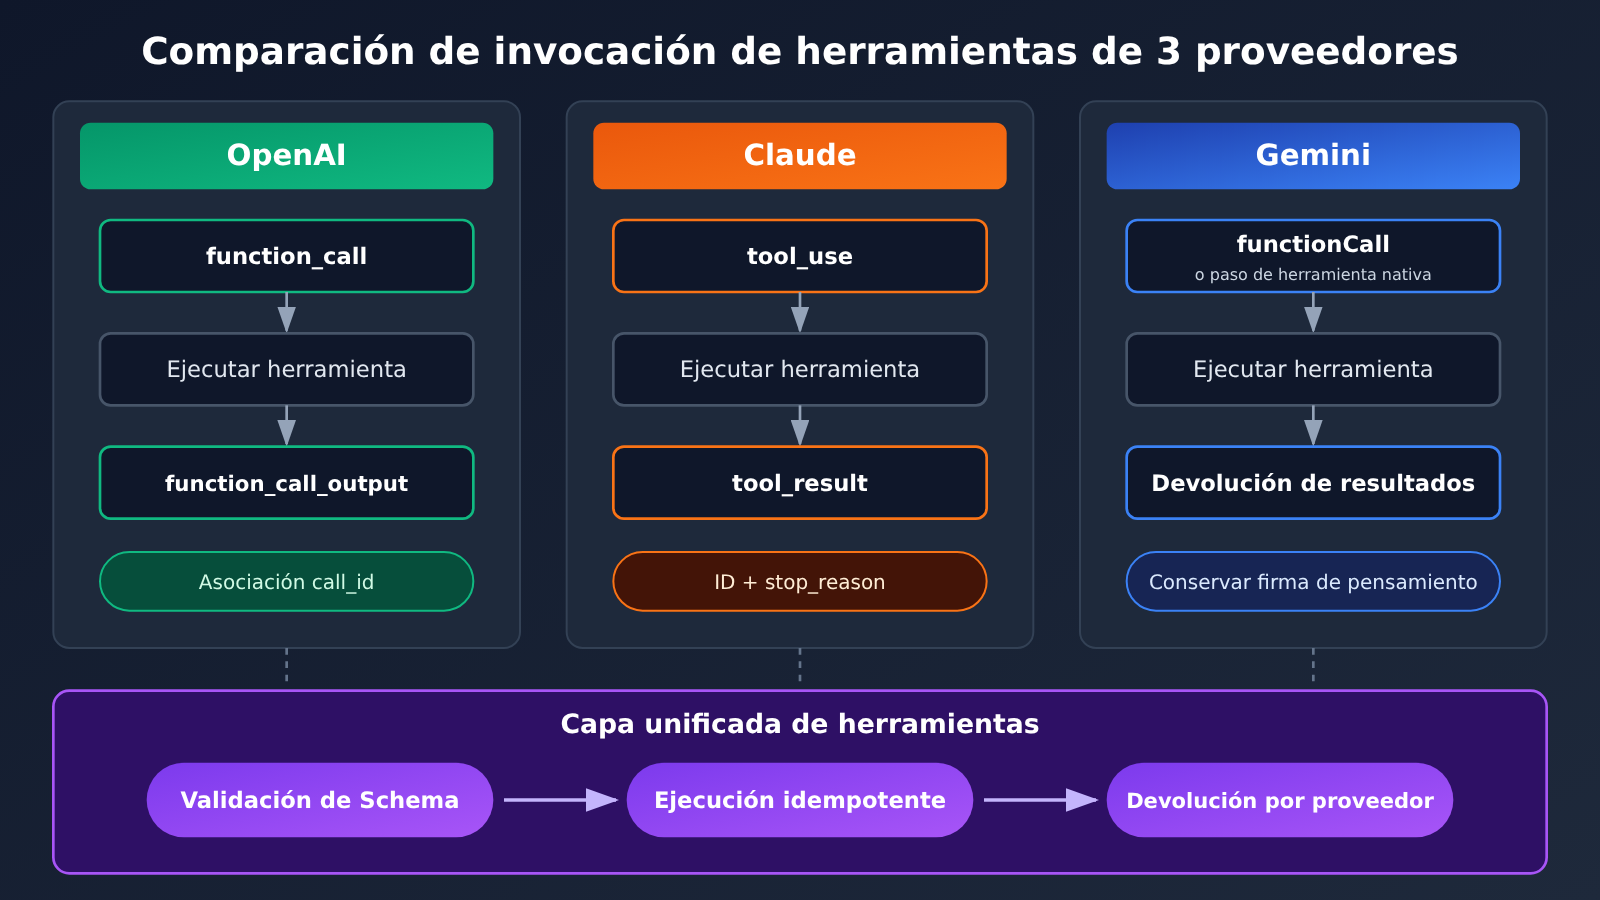
Los tres proveedores admiten Function Calling, y la estructura de la cadena de invocación es la siguiente:
| Etapa | OpenAI | Claude | Gemini |
|---|---|---|---|
| El modelo inicia la invocación | elemento de salida function_call |
bloque de contenido tool_use |
functionCall / paso de herramienta nativo |
| Identificador de asociación | call_id |
ID del tool_use |
identificador de invocación correspondiente |
| Retorno desde la aplicación | function_call_output |
bloque de contenido tool_result |
estructura de retorno de resultado correspondiente |
| ¿Se necesita continuar? | Se determina según el elemento de salida | stop_reason indica que se debe ejecutar la herramienta |
Se determina según el estado del paso |
| Estado de razonamiento | el elemento reasoning puede necesitar transmitirse junto con el historial | el bloque thinking puede necesitar devolverse tal cual | en modo stateless se deben conservar el bloque thought y la firma |
La capa de herramientas necesita guardar seis elementos de información de forma completa: el ID de invocación, el nombre de la función, el JSON de parámetros, la relación de invocaciones paralelas, el resultado de ejecución y si el modelo requiere continuar razonando. Las invocaciones paralelas son el punto donde más fácilmente se producen errores. Cuando el modelo inicia varias solicitudes de herramientas a la vez y la aplicación solo devuelve uno de los resultados, o cuando el resultado y el ID no coinciden, la siguiente ronda de solicitudes dará un error de parámetros, o el modelo continuará respondiendo basándose en datos erróneos.
Se recomienda que la capa de herramientas unificada valide los parámetros primero con JSON Schema, y solo después de que pasen la validación ejecute las operaciones externas reales. Los parámetros generados por el modelo no siempre son válidos; validarlos de antemano permite interceptar los errores antes de «invocar el sistema externo».
2.3 Compatibilidad del modo de razonamiento y del estado de contexto
Los nombres y el significado de los parámetros de razonamiento no son equivalentes entre los tres proveedores:
- OpenAI: usa parámetros como
reasoning.effort. GPT-6 Astra y GPT-6.1 Sol no aceptanreasoning.effort=none, y la invocación de herramientas en estos dos modelos también exige usar la Responses API. - Claude: los modelos de nueva generación apuestan principalmente por Adaptive Thinking, junto con configuraciones de razonamiento como effort. Algunos modelos nuevos ya no admiten el modo de razonamiento manual antiguo con
budget_tokensfijo. - Gemini: cada modelo usa thinking level o budget; si se puede desactivar el razonamiento y qué niveles existen depende del modelo. Las reglas de mapeo de parámetros también difieren entre la API nativa y el endpoint compatible con OpenAI.
Cuando en la interfaz del producto se diseñan tres niveles de intensidad de razonamiento (“rápido, estándar, profundo”), el nombre del nivel expresa la intención del producto. El adaptador tiene que convertirlo en los parámetros que cada modelo realmente admite, y los tres proveedores tampoco obtienen los mismos recursos de cómputo en un mismo nivel. Además, el resumen de razonamiento que ve el usuario puede no coincidir con la cantidad de tokens de razonamiento que se factura realmente, así que las estadísticas de coste deben basarse en los campos de uso que devuelve la interfaz.
El estado cifrado en las invocaciones de herramientas de múltiples turnos es el problema que los Agent de largo recorrido pasan por alto con más facilidad:
- Los elementos reasoning y las invocaciones de herramientas de OpenAI Responses pueden tener que seguir transmitiéndose junto con el historial.
- Los bloques
thinking/redacted_thinkingde Claude pueden incluir estado cifrado; al devolverlos después de ejecutar la herramienta hay que mantener la estructura original. - El modo stateless de Gemini Interactions exige conservar tal cual los bloques thought y las firmas; con el modo stateful, parte del estado puede quedar a cargo del servidor.
Guardar solo el texto que aparece en la ventana de chat no permite recuperar por completo el historial de razonamiento del modelo. El fallo típico es este: el Agent de repente da error después de la invocación de herramientas del tercer turno, o empieza a repetir pasos que ya había completado. La causa habitual es que en alguno de los turnos intermedios se perdió el bloque de firma.
2.4 Unificación de los eventos de streaming
Los tres proveedores tienen tipos de eventos de streaming, órdenes y señales de finalización completamente distintos. OpenAI Responses puede emitir response.output_text.delta, incrementos de llamadas a herramientas y eventos de finalización de la response. El streaming de Claude Messages usa eventos como message_start, content_block_delta y message_delta. La API nativa de Gemini, por su parte, utiliza su propia estructura de salida y de pasos.
Si el frontend parsea directamente los eventos sin procesar del proveedor, habrá que modificar el código del frontend cada vez que se integre un modelo nuevo. La recomendación es que el backend convierta todo a un protocolo interno de eventos:
| Evento interno | Significado | Puntos clave de manejo |
|---|---|---|
text_delta |
Incremento de texto | Añadir directamente a la visualización |
reasoning_summary |
Resumen del razonamiento | Mostrar de forma plegable; la facturación se basa en el usage |
tool_call_start |
Inicio de llamada a herramienta | Registrar el ID de llamada y el nombre de la función |
tool_call_args |
Fragmentos de parámetros | Concatenar por ID de llamada o índice; solo se puede parsear cuando estén todos reunidos |
tool_result |
Resultado de ejecución de la herramienta | Correspondencia uno a uno con el ID de llamada |
usage |
Estadísticas de consumo | Distinguir tokens de entrada, caché, razonamiento y salida |
completed |
Finalización normal | Debe recibirse una señal de finalización explícita |
error |
Error o corte del stream | Distinguir si es reintentable o no |
En el procesamiento de streaming hay tres puntos de fallo muy frecuentes. Primero, los fragmentos de parámetros de varias llamadas a herramientas llegan de forma intercalada, y concatenarlos en el orden de llegada provoca que se mezclen entre sí. Segundo, los parámetros JSON se cortan en cualquier carácter, y parsearlos cuando solo se ha recibido la mitad lanza una excepción. Tercero, la conexión se interrumpe a mitad de camino sin recibir el evento de finalización, y la interfaz se queda atascada en «generando». La capa de conversión debe manejar explícitamente estos tres casos.
2.5 Salida estructurada con JSON Schema y diferencias en capacidades multimodales
Los tres ofrecen capacidad de salida estructurada, pero difieren en las características de JSON Schema que admiten, en los modos estrictos y en cómo se combinan con la invocación de herramientas. La documentación oficial de Claude distingue dos mecanismos: JSON outputs, que restringe la estructura de la respuesta final, y Strict tool use, que restringe la estructura de los parámetros de invocación de herramientas. Algunos modelos, cuando usan formato estricto, también generan una sobrecarga adicional de compilación o almacenamiento en caché del Schema.
Desde el punto de vista de ingeniería, la recomendación es que la aplicación mantenga su propio JSON Schema estándar y registre, en un registro de capacidades, qué características de Schema admite cada modelo. Para las características no admitidas, el adaptador debe hacer una conversión degradada. No importa cuán estricto declare ser el modelo: la propia aplicación debe validar de nuevo, y si la validación falla, debe pasar a un flujo controlado de reintento o de notificación de errores.
Lo mismo ocurre con lo multimodal. “Admite entrada de imágenes” solo indica la categoría de capacidad; en concreto, también hay que comparar los siguientes puntos: los tipos de archivo aceptados, su tamaño y la cantidad de imágenes; las capacidades de video y audio; el método de carga de archivos; el límite máximo de contexto largo y el rango realmente utilizable; el máximo de tokens de salida; y si la invocación de herramientas puede combinarse con entradas multimodales. Que la capa de compatibilidad de Claude no admita entradas de tipo audio y file es una limitación concreta que debe quedar escrita en el registro.
2.6 Diferencias entre modelos en caché, facturación y manejo de errores
Los mecanismos de caché de indicaciones de los tres proveedores presentan diferencias notables:
- OpenAI: GPT-5.6 y los modelos posteriores admiten caché implícita y puntos de control de caché explícitos, con TTL de 30 minutos y 12 horas.
- Claude: mediante
cache_controlse especifica caché automática o explícita, con modos de 5 minutos y 1 hora; esta capacidad no está soportada en su capa compatible con OpenAI. - Gemini: los modelos nuevos ofrecen caché implícita automática, y algunas API y modelos admiten la creación explícita de objetos de caché.
Tras cambiar de modelo, la caché del proveedor original normalmente no se puede reutilizar. Si a mitad de una conversación pasas de Claude a Gemini, la primera ronda de solicitudes se factura según la entrada completa. Si la estimación de costos asume por defecto que “la caché siempre acierta”, cuanto más frecuente sea el cambio de estrategia, mayor será la desviación en la factura.
También hay diferencias claras en los precios unitarios estándar de cada proveedor. Los precios oficiales estándar a fecha 2026-11-13 son los siguientes (USD / millón de tokens):
| Modelo | Entrada | Salida | Notas |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | la invocación de herramientas requiere usar la API Responses |
| GPT-6.1 Sol | $1 | $5 | la invocación de herramientas requiere usar la API Responses |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | precio promocional hasta 2026-12-31; a partir de 2027-01-01 se planea ajustar a $1.50 / $7.50 |
Esta tabla sirve para ilustrar las diferencias de facturación; las capacidades y condiciones de uso de cada modelo son distintas, y un precio más alto o más bajo no se traduce directamente en una comparación de rendimiento. La tabla tampoco incluye costos como escritura de caché, invocación de herramientas, niveles de servicio ni recargos de terceros.
💰 Sugerencia para el cálculo de costos: la factura de una aplicación multimodelo debe registrarse por partidas: “entrada normal, escritura de caché, acierto de caché, razonamiento y salida, costos de herramientas, recargo por contexto largo”. Cuando se invocan varios modelos de forma unificada a través de APIYI apiyi.com, se puede consultar el uso de cada modelo en un mismo lugar, lo que facilita correlacionar la estrategia de enrutamiento con el costo real.
En cuanto al manejo de errores, los tres proveedores difieren en límites de velocidad de solicitudes, velocidad de Tokens, cuota, tiempos de espera y formato de errores. La aplicación debería establecer una clasificación unificada de errores: fallo de autenticación, modelo no soportado, parámetros inválidos, solicitud demasiado grande o que excede el contexto, limitación 429, error del servidor, desconexión de red, interrupción del flujo de respuesta, fallo en la invocación de herramientas.
La reversión a otro modelo también debe considerar si la tarea tiene efectos secundarios. Si el modelo principal agota el tiempo de espera después de ejecutar una herramienta, y el sistema cambia automáticamente al modelo de respaldo y vuelve a ejecutar toda la tarea, operaciones como pagos, envío de correos o modificación de archivos podrían ejecutarse dos veces. La solución es añadir claves de idempotencia a las herramientas con efectos secundarios y, al revertir, continuar solo desde “los pasos aún no ejecutados”.
3 Cómo debería diseñarse una arquitectura compatible con API para múltiples modelos
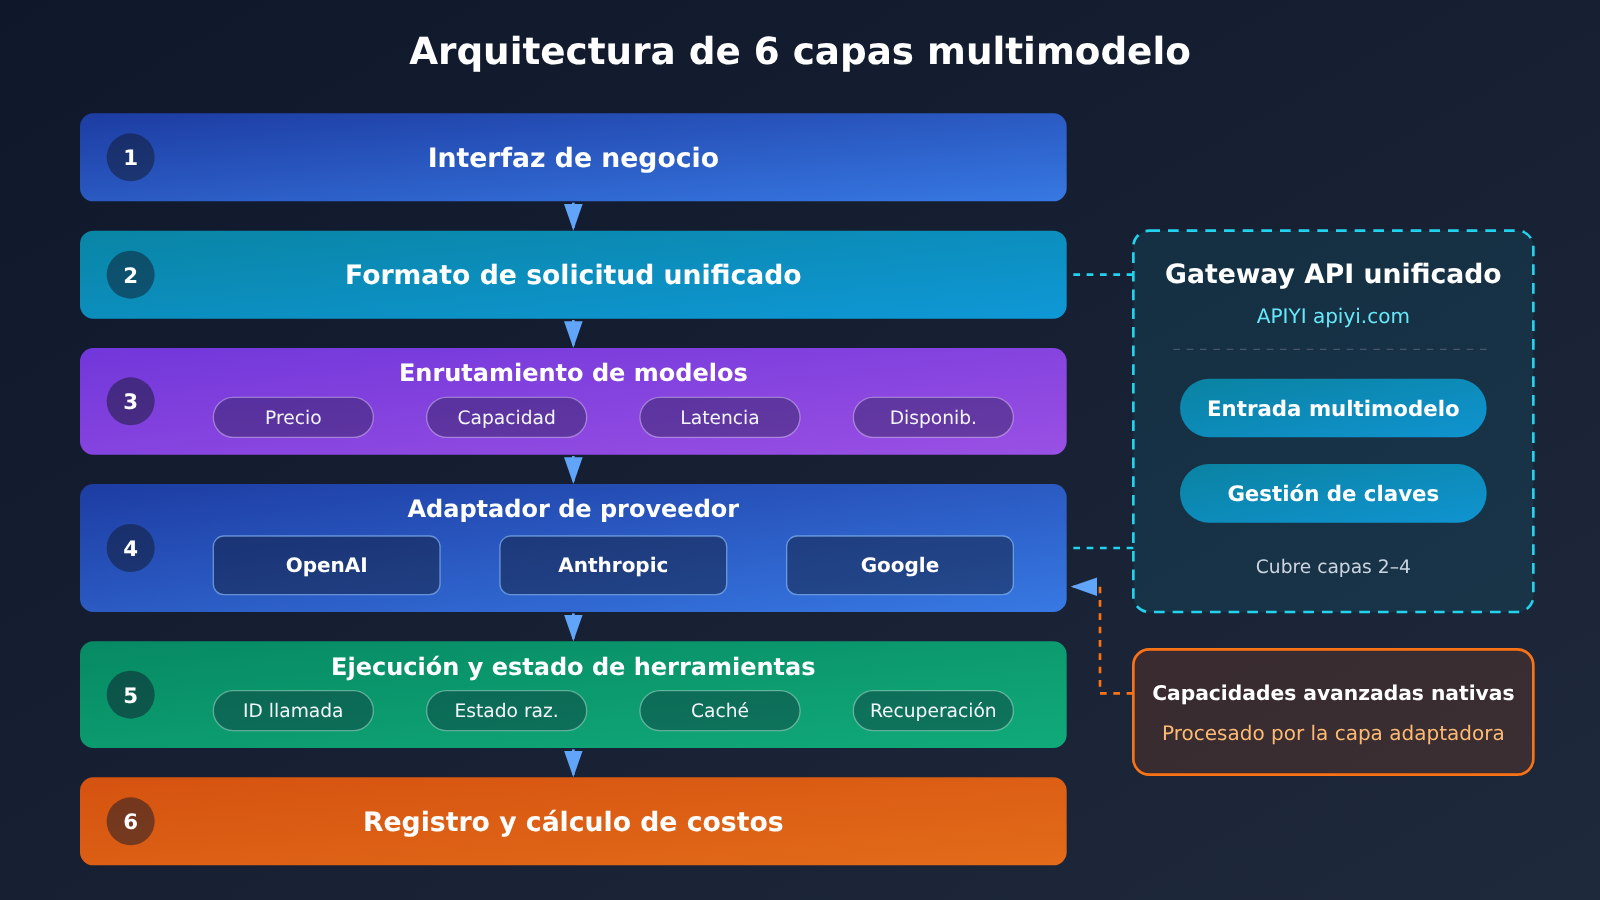
La estructura recomendada de seis capas es la siguiente:
- Interfaz de negocio: el usuario formula preguntas, sube materiales y selecciona el modelo y la tarea.
- Formato de solicitud unificado: representar con una estructura unificada el historial de mensajes, los adjuntos, la lista de herramientas, los requisitos de salida estructurada, la intensidad de razonamiento y el ID de tarea.
- Enrutamiento de modelos: seleccionar GPT, Claude o Gemini según precio, capacidades, latencia, disponibilidad y reglas de negocio.
- Provider Adapter: convertir la solicitud estándar al formato nativo de cada proveedor y luego mapear los resultados devueltos al formato interno.
- Ejecución de herramientas y gestión de estado: mantener los ID de llamada, el registro de ejecución, el contexto de la conversación, el estado de razonamiento del proveedor, la caché y la recuperación de fallos.
- Registro y cálculo de costos: registrar, para cada solicitud, el modelo, los tokens, el costo real, la latencia, la caché, los errores y las llamadas a herramientas.
3.1 Crear un formato unificado de mensajes y herramientas
El principio central del formato unificado es almacenar el historial en dos capas. La primera capa es el historial estándar universal, que incluye los mensajes del usuario, la respuesta final del modelo, las solicitudes de herramientas y los resultados de las herramientas; cualquier proveedor puede interpretarlo. La segunda capa es el estado específico del proveedor, como los elementos de reasoning, las firmas de thinking y los bloques thought, que se guardan aislados por proveedor y solo se devuelven tal cual cuando se hace una solicitud al mismo proveedor.
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # ID de llamada unificado; el adaptador se encarga de mapearlo bidireccionalmente con el ID del proveedor
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # Las herramientas con efectos secundarios deben establecerlo obligatoriamente

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # Bloques multimodales como texto e imágenes
    tool_calls: list[ToolCall] = field(default_factory=list)
    # Estado específico del proveedor: la clave es el nombre del proveedor y el valor son las firmas / bloques de reasoning guardados tal cual
    vendor_state: dict[str, Any] = field(default_factory=dict)
Al cambiar de modelo, el adaptador lee los campos estándar para generar una nueva solicitud. Las partes de vendor_state que pertenecen a otros proveedores no se envían, mientras que las que pertenecen al proveedor de destino se devuelven tal cual.
3.2 Adaptar la API nativa mediante Provider Adapter
Cada adaptador asume tres responsabilidades:
- Transformación de entrada: mapeo de roles (por ejemplo, mover el
systemal campo independiente de Claude), transformación de definiciones de herramientas, degradación de Schema, mapeo de niveles de razonamiento. - Transformación de salida: convertir las respuestas nativas y los eventos de streaming en los eventos internos de la sección 2.4, y mapear los ID de llamadas de herramientas a ID unificados.
- Gestión de estado: extraer y guardar estados del proveedor como firmas e ítems de reasoning, y decidir si se usa continuidad del lado del servidor (
previous_response_id,previous_interaction_id) o el reenvío completo del historial.
Las preguntas y respuestas normales pueden usar el adaptador público en formato compatible con OpenAI. En escenarios que requieren parámetros estrictos de herramientas, control de caché o estados de pensamiento cifrados, implementa adaptadores nativos por separado. Así se conserva la comodidad de una entrada unificada y, al mismo tiempo, las capacidades avanzadas tienen un punto de implementación claro.
3.3 Usar el registro de capacidades para determinar las funcionalidades disponibles
El registro de capacidades documenta el soporte real tomando como unidad «modelo + endpoint de acceso»; un mismo modelo puede corresponder a dos registros distintos si va por API nativa o por capa de compatibilidad. A continuación, un ejemplo de estructura; los valores concretos deben basarse en la documentación oficial y en tus propias pruebas:
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # La invocación de herramientas requiere usar la API de Responses
  reasoning_effort: [low, medium, high]   # No acepta none
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # La capa de compatibilidad ignora strict
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
La capa de enrutamiento consulta el registro antes de seleccionar un modelo. Si la solicitud trae archivos, se excluyen las entradas con file_input: false; si se necesitan parámetros estrictos de herramientas, solo se seleccionan las entradas con strict_tools: true. La interfaz del producto también puede ocultar, en función de esto, las opciones que el modelo actual no admite, reduciendo así los errores que provocan los usuarios.
4 Pruebas y observabilidad antes del lanzamiento de la compatibilidad multi-modelo de API
4.1 Seis pruebas de compatibilidad, desde la pregunta simple hasta la cadena de herramientas multi-turno
En orden creciente de complejidad, completa las siguientes seis pruebas:
- Pregunta-respuesta normal: envía la misma indicación a los tres modelos y comprueba que el contenido de la respuesta y las estadísticas de tokens sean correctos.
- Salida en streaming: confirma que la salida llega de forma continua y que se recibe la señal de finalización correcta.
- Llamada a herramientas: el modelo invoca la herramienta de consulta meteorológica o de consulta de datos, la aplicación la ejecuta y devuelve el resultado.
- Ciclo con múltiples herramientas: encadena dos o más rondas de llamadas a herramientas y confirma que el historial y los ID de llamada estén completos.
- JSON estructurado: genera la salida según el mismo Schema y valida la estructura con el validador del lado de la aplicación.
- Cambio de modelo: cambia la misma sesión de negocio entre GPT, Claude y Gemini, y confirma que el contexto, el registro de herramientas y la respuesta final funcionen correctamente.
Las pruebas 4 y 6 son las que mejor exponen problemas en el estado de razonamiento; conviene incluirlas en el flujo de integración continua. Cada vez que actualices la versión del modelo o cambies el endpoint de acceso, vuelve a ejecutarlas.
4.2 Establecer una observabilidad unificada de costes y estabilidad
Registra al menos los siguientes campos en cada solicitud: modelo y endpoint, tasa de éxito de la solicitud, tipo de excepción (según la clasificación de la sección 2.6), latencia del primer token y duración total de la tarea, tokens desglosados (entrada, escritura de caché, aciertos de caché, pensamiento, salida), número de llamadas a herramientas y de fallos, número de reintentos y de fallbacks.
Al evaluar un modelo, hay que fijarse en la duración total y el coste total de la tarea completa; los datos de una sola solicitud tienen un valor de referencia limitado. Si un modelo barato por unidad tiene una alta tasa de errores en los parámetros de las herramientas y necesita varios reintentos, su coste global puede acabar siendo mayor.
5. El papel de un gateway de API unificado en la compatibilidad con API de múltiples modelos
5.1 Costos de integración y mantenimiento
Usar tres modelos a la vez implica tres conjuntos de cuentas, tres conjuntos de claves, tres sistemas de facturación y tres configuraciones de SDK. Un gateway de API unificado concentra todo esto en un único punto de entrada: gestiona de forma centralizada la integración de modelos y las credenciales, reduce la carga de configuración y mantenimiento de cada proveedor, permite seleccionar y cambiar de modelo desde la capa de configuración, y unifica la observación del consumo y los costos. Para los equipos que necesitan comparar con frecuencia el rendimiento de distintos modelos, también baja el umbral para probar modelos nuevos.
5.2 El posicionamiento de APIYI: punto de entrada unificado y adaptación de capacidades nativas
APIYI es una plataforma de agregación de API de Modelos de Lenguaje Grande. Con una sola clave API, puedes invocar OpenAI, Claude, Gemini y otros modelos principales a través de una interfaz compatible con OpenAI, con facturación por uso. Encaja bien como la capa de “punto de entrada de invocación unificado” de la arquitectura: las consultas y respuestas generales, la salida en streaming, la comparación de modelos y el enrutamiento entre múltiples modelos se pueden integrar directamente.
Tener un punto de entrada de invocación unificado y lograr que sea totalmente coherente con las capacidades nativas de cada proveedor son dos requisitos técnicos diferentes. Al integrar un modelo específico, todavía hay que verificar punto por punto en el registro de capacidades qué alcance de soporte tienen la invocación de herramientas, el estado de razonamiento, el soporte multimodal, el almacenamiento en caché y la salida estructurada. Las rutas que dependen de capacidades nativas como Responses API, cache_control o las firmas criptográficas deben confirmar que el endpoint correspondiente está realmente disponible antes de pasar a producción, o bien conservar para ellas un adaptador nativo específico.
Inicio rápido con la compatibilidad de API multi-modelo
Ejemplo minimalista: comparar tres modelos con la misma indicación
El siguiente código utiliza un mismo cliente OpenAI SDK para invocar de forma secuencial tres modelos, lo que corresponde a la primera prueba de la sección 4.1.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

# Los ID de modelo se toman según la lista de modelos de la plataforma
MODELS = ["你的GPT模型ID", "你的Claude模型ID", "你的Gemini模型ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
Ver la implementación completa: eventos de streaming unificados + registro de capacidades + validación de herramientas
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

# Registro de capacidades: los valores son solo ejemplos de estructura,
# consérvelos según la documentación oficial y los resultados de tus pruebas
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # la invocación de herramientas debe pasar por el adaptador de Responses
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """Clasificación unificada de errores, para decidir si se puede reintentar"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # se puede reintentar con retroceso
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # error de parámetros o contexto excedido; no reintentar a ciegas
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """Convierte un flujo en formato compatible con OpenAI en eventos internos unificados"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # concatena por índice los fragmentos de argumentos de las llamadas paralelas a herramientas
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # flujo cortado a mitad de camino

EXECUTED_KEYS: set[str] = set()   # en producción, cámbialo por un almacenamiento persistente

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """Primero valida los argumentos y después ejecuta de forma idempotente"""
    try:
        args = json.loads(call["args"])   # parsear solo cuando todos los fragmentos estén reunidos
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# Ejemplo de uso
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 Inicio rápido: regístrate en APIYI apiyi.com y obtén crédito de prueba gratis; con el código de arriba y una sola clave API puedes completar las dos primeras pruebas de la sección 4.1. Para lo relacionado con la invocación de herramientas y el razonamiento multi-turno, ve validando modelo por modelo con ayuda del registro de capacidades.
Preguntas frecuentes (FAQ)
Q1: ¿A qué se refieren principalmente los problemas de compatibilidad de API entre múltiples modelos?
Se refieren a las diferencias que una misma aplicación debe gestionar al cambiar entre GPT, Claude y Gemini, debido a las distintas estructuras de sus API nativas. Abarcan principalmente 6 categorías: roles de mensaje, invocación de herramientas, estado de razonamiento, eventos de streaming, salida estructurada y multimodal, facturación de caché y gestión de errores.
Q2: ¿Sigue siendo necesario un adaptador para invocar Claude y Gemini mediante la interfaz compatible con OpenAI?
El chat normal puede usar directamente la interfaz compatible. Cuando se trata de parámetros estrictos de herramientas, Prompt Caching, entrada de archivos o estado de pensamiento cifrado, sí se necesita una capa de adaptación. Tomemos como ejemplo la capa de compatibilidad oficial de Claude: ignora `strict` y tampoco admite caché ni entradas `audio/file`. Estas diferencias deben registrarse en la tabla de capacidades.
Q3: ¿Los nuevos proyectos de Gemini deberían usar Interactions API o generateContent?
Interactions API entró en GA en junio de 2026, y Google recomienda que los nuevos proyectos la adopten de forma prioritaria. Admite estado de sesión del lado del servidor, `previous_interaction_id` y la estructura de steps. `generateContent` sigue siendo compatible, y los proyectos existentes pueden migrar según lo planificado.
Q4: ¿Cómo se debe gestionar el historial al cambiar de modelo a mitad de una conversación?
Los mensajes del usuario, las respuestas finales, las solicitudes de herramientas y los resultados de herramientas se guardan como historial estándar; tras el cambio, el adaptador de destino los vuelve a ensamblar. Los estados exclusivos del proveedor, como firmas y elementos de reasoning, se guardan por separado y solo se devuelven tal cual cuando se solicita al mismo proveedor. Además, después del cambio, la caché del proveedor original normalmente no se puede reutilizar, por lo que conviene reservar el costo de entrada completo del primer turno.
Q5: ¿Cómo validar rápidamente la compatibilidad de los tres modelos en mi negocio?
Se recomienda seguir estos pasos:
1. Visite APIYI en apiyi.com, registre una cuenta y obtenga una clave API y crédito de prueba gratuito.
2. Use el código de este artículo, configure base_url con la dirección de la interfaz de APIYI e introduzca los ID de los tres modelos.
3. Ejecute de forma escalonada las seis pruebas de la sección 4.1 y registre la tasa de éxito, los tipos de excepción, el costo y el tiempo total.
Q6: ¿Qué se debe tener en cuenta al configurar el fallback automático de modelos?
Primero determine si la tarea tiene efectos secundarios. Las herramientas como pagos, envío de correos o modificación de archivos deben incluir una clave de idempotencia; al hacer fallback, se debe continuar desde el paso no completado para evitar volver a ejecutar toda la tarea. Los errores de límite de tasa y del servidor son adecuados para reintentos con backoff; los errores de parámetros y los casos en que se supera la ventana de contexto requieren corregir la solicitud antes de reenviarla.
Q7: ¿Cómo controlar los costos al enrutar entre múltiples modelos?
Registre los costos desglosados por token y compárelos usando el costo total de la tarea completa. Los precios unitarios de los tres proveedores difieren bastante; por ejemplo, el precio de salida de GPT-6 Astra es de $50 por millón de tokens, mientras que el de Gemini 3.8 Flash está en $3.75 como precio promocional actual. Consultar de forma unificada el uso de cada modelo en APIYI apiyi.com permite detectar más rápido las rutas de alto costo y ajustar las reglas de enrutamiento en consecuencia.
Q8: ¿Qué limitaciones tiene un gateway de API unificado?
El gateway unifica el punto de entrada de las llamadas, las claves y la facturación. La disponibilidad de capacidades avanzadas nativas del proveedor (como la invocación de herramientas exclusiva de Responses API, `cache_control` o la devolución de firmas cifradas) depende del soporte de cada endpoint y debe probarse elemento por elemento. Las rutas que dependen de estas capacidades deben conservar adaptadores nativos como complemento.
Puntos clave de compatibilidad de API multimodelo
- Cambiar de modelo ≠ cambiar de ID: las preguntas y respuestas normales se pueden migrar directamente, pero las cadenas de agentes deben gestionar 6 tipos de diferencias.
- La capa de compatibilidad tiene límites: la capa de compatibilidad de Claude ignora
stricty no admite caché ni entrada de archivos. - Las firmas deben conservarse tal cual: la pérdida de firmas de thinking / thought es una causa frecuente de errores en cadenas de herramientas multiturno.
- Unificación de eventos en streaming: el backend emite 8 tipos de eventos internos y el frontend solo se integra con un único protocolo.
- Enrutamiento basado en un registro de capacidades: registra las funcionalidades realmente compatibles por unidad de «modelo + endpoint».
- El fallback debe ser idempotente: añade claves de idempotencia a las herramientas con efectos secundarios para evitar ejecuciones duplicadas.
- Probar antes de lanzar: usa la cuota gratuita de APIYI apiyi.com para completar con éxito las seis pruebas de compatibilidad.
Resumen
Para que una aplicación se conecte a GPT, Claude y Gemini al mismo tiempo, la clave está en centralizar las diferencias en unos pocos componentes y gestionarlas desde allí:
- Formato unificado de mensajes y herramientas: el historial estándar y el estado específico de cada proveedor se almacenan por capas, de modo que el contexto no se pierde al cambiar de modelo.
- Provider Adapter: se encarga de la conversión de entrada, la conversión de salida y la gestión de estado; las capacidades avanzadas nativas se implementan aquí.
- Registro de capacidades: registra fielmente el soporte de herramientas, razonamiento, multimodalidad, Schema y caché de cada modelo y endpoint, y determina el enrutamiento y las opciones de la interfaz.
Sobre esta base, utiliza las seis pruebas de compatibilidad y la observación de costos desglosados para garantizar la calidad del lanzamiento. En la fase de invocaciones normales y comparación de modelos, se recomienda usar una sola clave de APIYI apiyi.com para validar rápidamente varios modelos y, después, decidir según los resultados de las pruebas qué cadenas necesitan adaptación nativa.
📚 Referencias
- OpenAI Function Calling: invocación de herramientas,
call_idyfunction_call_output - Enlace:
developers.openai.com/api/docs/guides/function-calling -
Descripción: explicación autorizada del protocolo de invocación de herramientas de la Responses API
-
Guía de migración a los modelos más recientes de OpenAI: parámetros de razonamiento y requisitos de interfaz de la serie GPT-6
- Enlace:
developers.openai.com/api/docs/guides/latest-model -
Descripción: límites de los valores de
reasoning.efforty requisitos de la Responses API -
OpenAI Prompt Caching: puntos de control de caché y TTL
- Enlace:
developers.openai.com/api/docs/guides/prompt-caching -
Descripción: mecanismos de caché implícita y explícita
-
Compatibilidad del SDK de OpenAI con Claude: alcance y limitaciones de la capa de compatibilidad
- Enlace:
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
Descripción: diferencias en
strict, caché, entrada de archivos, fusión del system, etc. -
Claude Extended Thinking: Adaptive Thinking y firmas de pensamiento
- Enlace:
platform.claude.com/docs/en/build-with-claude/extended-thinking -
Descripción: reglas para reenviar los bloques de thinking en la invocación de herramientas de varios turnos
-
Salidas estructuradas y caché en Claude: JSON outputs, Strict tool use,
cache_control - Enlace:
platform.claude.com/docs/en/build-with-claude/structured-outputs - Enlace:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Descripción: restricciones estructuradas y modos de caché
-
Gemini Interactions API y compatibilidad con OpenAI: nueva interfaz y punto de entrada compatible
- Enlace:
ai.google.dev/gemini-api/docs/interactions-overview - Enlace:
ai.google.dev/gemini-api/docs/openai -
Descripción: estructura de steps, estado de sesión y mapeo de parámetros de compatibilidad
-
Firmas de pensamiento, invocación de herramientas y caché en Gemini
- Enlace:
ai.google.dev/gemini-api/docs/thought-signatures - Enlace:
ai.google.dev/gemini-api/docs/function-calling - Enlace:
ai.google.dev/gemini-api/docs/caching -
Descripción: conservación de firmas en modo stateless, protocolo de herramientas y caché explícita
-
Páginas de precios oficiales de los tres proveedores
- Enlace:
developers.openai.com/api/docs/pricing - Enlace:
platform.claude.com/docs/en/models/sonnet-5-5/overview - Enlace:
ai.google.dev/gemini-api/docs/pricing - Descripción: fuente de los datos de la tabla de precios de este artículo; fecha de verificación 2026-11-13
Autor: Equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página de inicio del sitio web de APIYI; para más materiales, visita el centro de documentación docs.apiyi.com


